Warum Fehler nach der Extraktion
schlimmer sind, als die meisten Teams glauben
Der Engpass bei der Dokumentextraktion ist nicht das Übertragen von Daten in eine Tabelle. Die KI, die 42 Positionen aus einer Lieferantenrechnung in sechs Sekunden liest, hat dieses Problem bereits gelöst. Der Engpass ist das Erkennen von Fehlern, die nicht wie Fehler aussehen – Summen, die um genau die letzte Zeile abweichen, eine Spalte mit Daten, wo Rechnungsnummern stehen sollten, leere Zellen, wo auf der Seite Dollar-Beträge erschienen. Diese Fehler haben kein Warnlicht. Sie fließen in Ihr ERP, in Ihre Monatsabschlüsse, in Ihre Lieferantenzahlungsläufe, und niemand bemerkt sie, bis ein Abgleich zwei Wochen später scheitert.
Wichtige Erkenntnisse
- Bei 99 % Feldgenauigkeit trägt etwa jede siebte Rechnung in Ihrem Batch einen stillen Datenfehler – und Ihr ERP importiert jeden einzelnen ohne Warnung.
- Die Formatvalidierung erkennt Syntax, ist aber blind für Beziehungen zwischen Zellen – eine Zwischensumme, die nicht mit der Summe ihrer Positionen übereinstimmt, besteht jede automatisierte Prüfung, und das Nachverfolgen dieser Abweichung beim Abgleich kostet das Drei- bis Fünffache der Überzahlung selbst.
- 30 Sekunden mechanischer Verifizierung nach der Extraktion fangen alle sieben Fehlerklassen, bevor sie Ihr ERP erreichen – keine neuen Tools, nur fünf Prüfungen, die die Lücke zwischen „die Zellen sehen gut aus“ und „die Zahlen stimmen tatsächlich“ schließen.
Summen, die nicht aufgehen: Der Fehler, den niemand zu prüfen denkt
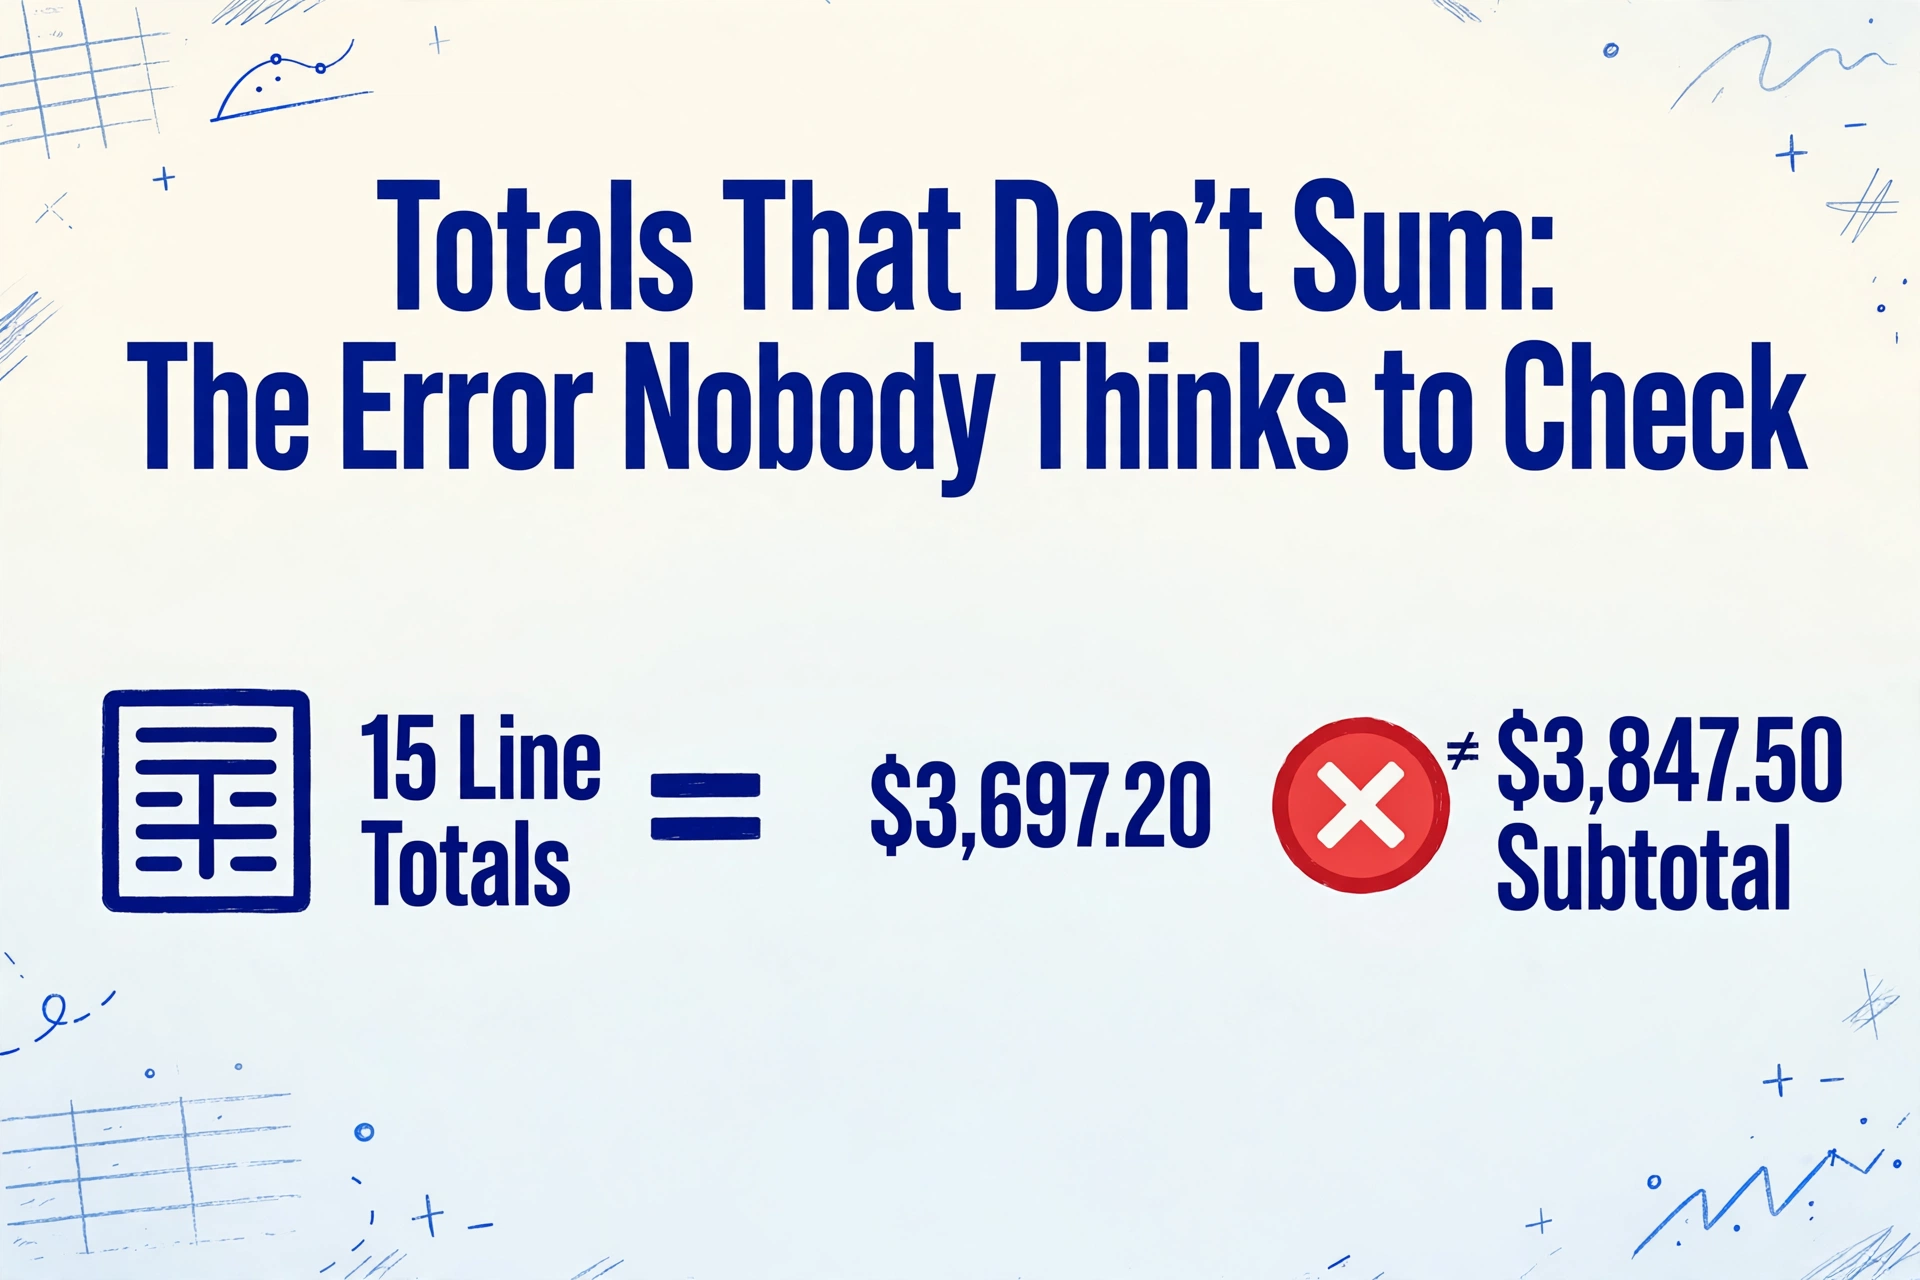
Der häufigste Fehler nach der Extraktion ist auch der unsichtbarste. Eine Rechnung kommt von einem Sanitärgroßhändler – drei Seiten, 15 Positionen, eine Zwischensumme von $3.847,50, $307,80 Steuern, eine Gesamtsumme von $4.155,30. Die KI liest jede Zeile korrekt. Menge: 12. Einzelpreis: $47,25. Positionssumme: $567,00. Alle fünfzehn Positionssummen werden korrekt extrahiert. Die Zwischensumme wird korrekt mit $3.847,50 extrahiert. Die Gesamtsumme wird korrekt mit $4.155,30 extrahiert. Jeder einzelne Wert in der Tabelle sieht richtig aus. Aber niemand hat überprüft, ob die fünfzehn Positionssummen tatsächlich $3.847,50 ergeben. In diesem speziellen Fall ergeben sie $3.697,20 – genau eine Position zu wenig.
Das ist das Kennzeichen eines Fehlers nach der Extraktion: Jede Zelle sieht isoliert korrekt aus, aber die Beziehungen zwischen den Zellen sind gestört. Die KI hat jedes Feld unabhängig extrahiert – sie las „Menge: 12“ und „Einzelpreis: $47,25“ und „Positionssumme: $567,00“ als getrennte Fakten auf der Seite. Sie hat die Beziehung zwischen ihnen nicht berechnet. Das ist kein Fehler der KI. Es ist die Natur der semantischen Extraktion: Das Modell liest, was geschrieben steht, nicht, was logisch folgen sollte.
Die Position, die nicht in die Summe einfloss, befand sich zufällig am Seitenumbruch – Zeile 11 von 15, ganz unten auf Seite zwei gedruckt, während der Rest der Tabelle auf Seite drei weitergeht. Die KI las die Daten von Zeile 11 korrekt. Sie las die Zeilen 12 bis 15 korrekt. Aber als die Ausgabe in eine Tabelle zusammengestellt wurde, wurde die Zwischensummenzelle zu einem statischen extrahierten Wert – keine SUMME-Formel, die auf die darüberliegenden Zeilen verweist. Die Abweichung zwischen $3.847,50 (extrahierte Zwischensumme) und $3.697,20 (tatsächliche Summe der Positionssummen) blieb drei Wochen lang in der Tabelle, bis der AP-Sachbearbeiter bemerkte, dass die Lieferantenabrechnung einen anderen Saldo zeigte.
Warum das passiert. Extraktionstools geben statische Werte aus, keine Formeln. Das Zwischensummenfeld auf der Rechnung ist eine Zahl, die die KI liest, keine Berechnung, die sie durchführt. Wenn eine Position falsch extrahiert wird – die Dezimalstelle fehlt, dupliziert oder ganz weggelassen – stimmt der von der Seite extrahierte Zwischensummenwert nicht mit dem überein, was die Positionen tatsächlich ergeben. Aber nichts im Extraktionsprozess kennzeichnet diese Abweichung. Das Tool wurde erfolgreich abgeschlossen. Die Ausgabe sieht normal aus. Der Fehler existiert nur in der Lücke zwischen dem, was die Positionen ergeben, und dem, was das Summenfeld angibt – eine Lücke, die keine automatisierte Prüfung füllt.
So fangen Sie ihn ab. Widmen Sie nach der Extraktion einen Prüfdurchgang der arithmetischen Abschlussprüfung: Summieren Sie alle Positionssummen und vergleichen Sie das Ergebnis mit der extrahierten Zwischensumme. Machen Sie dasselbe für die Steuern – multiplizieren Sie die Zwischensumme mit dem angegebenen Steuersatz und vergleichen Sie das Ergebnis mit dem extrahierten Steuerbetrag. Wenn die beiden Zahlen um mehr als eine Rundungstoleranz abweichen, kennzeichnen Sie das Dokument. Das ist eine 10-Sekunden-Prüfung pro Rechnung, die die häufigste Fehlerklasse nach der Extraktion abfängt, bevor sie in Ihr AP-System gelangt. Die QA-Checkliste für extrahierte Dokumentdaten behandelt diesen Verifizierungsschritt im Detail, zusammen mit dem vollständigen Verifizierungsablauf.
Fehlende Zeilen: Wenn aus 15 plötzlich 14 wird und der Unterschied eine Lieferantenzahlung ist
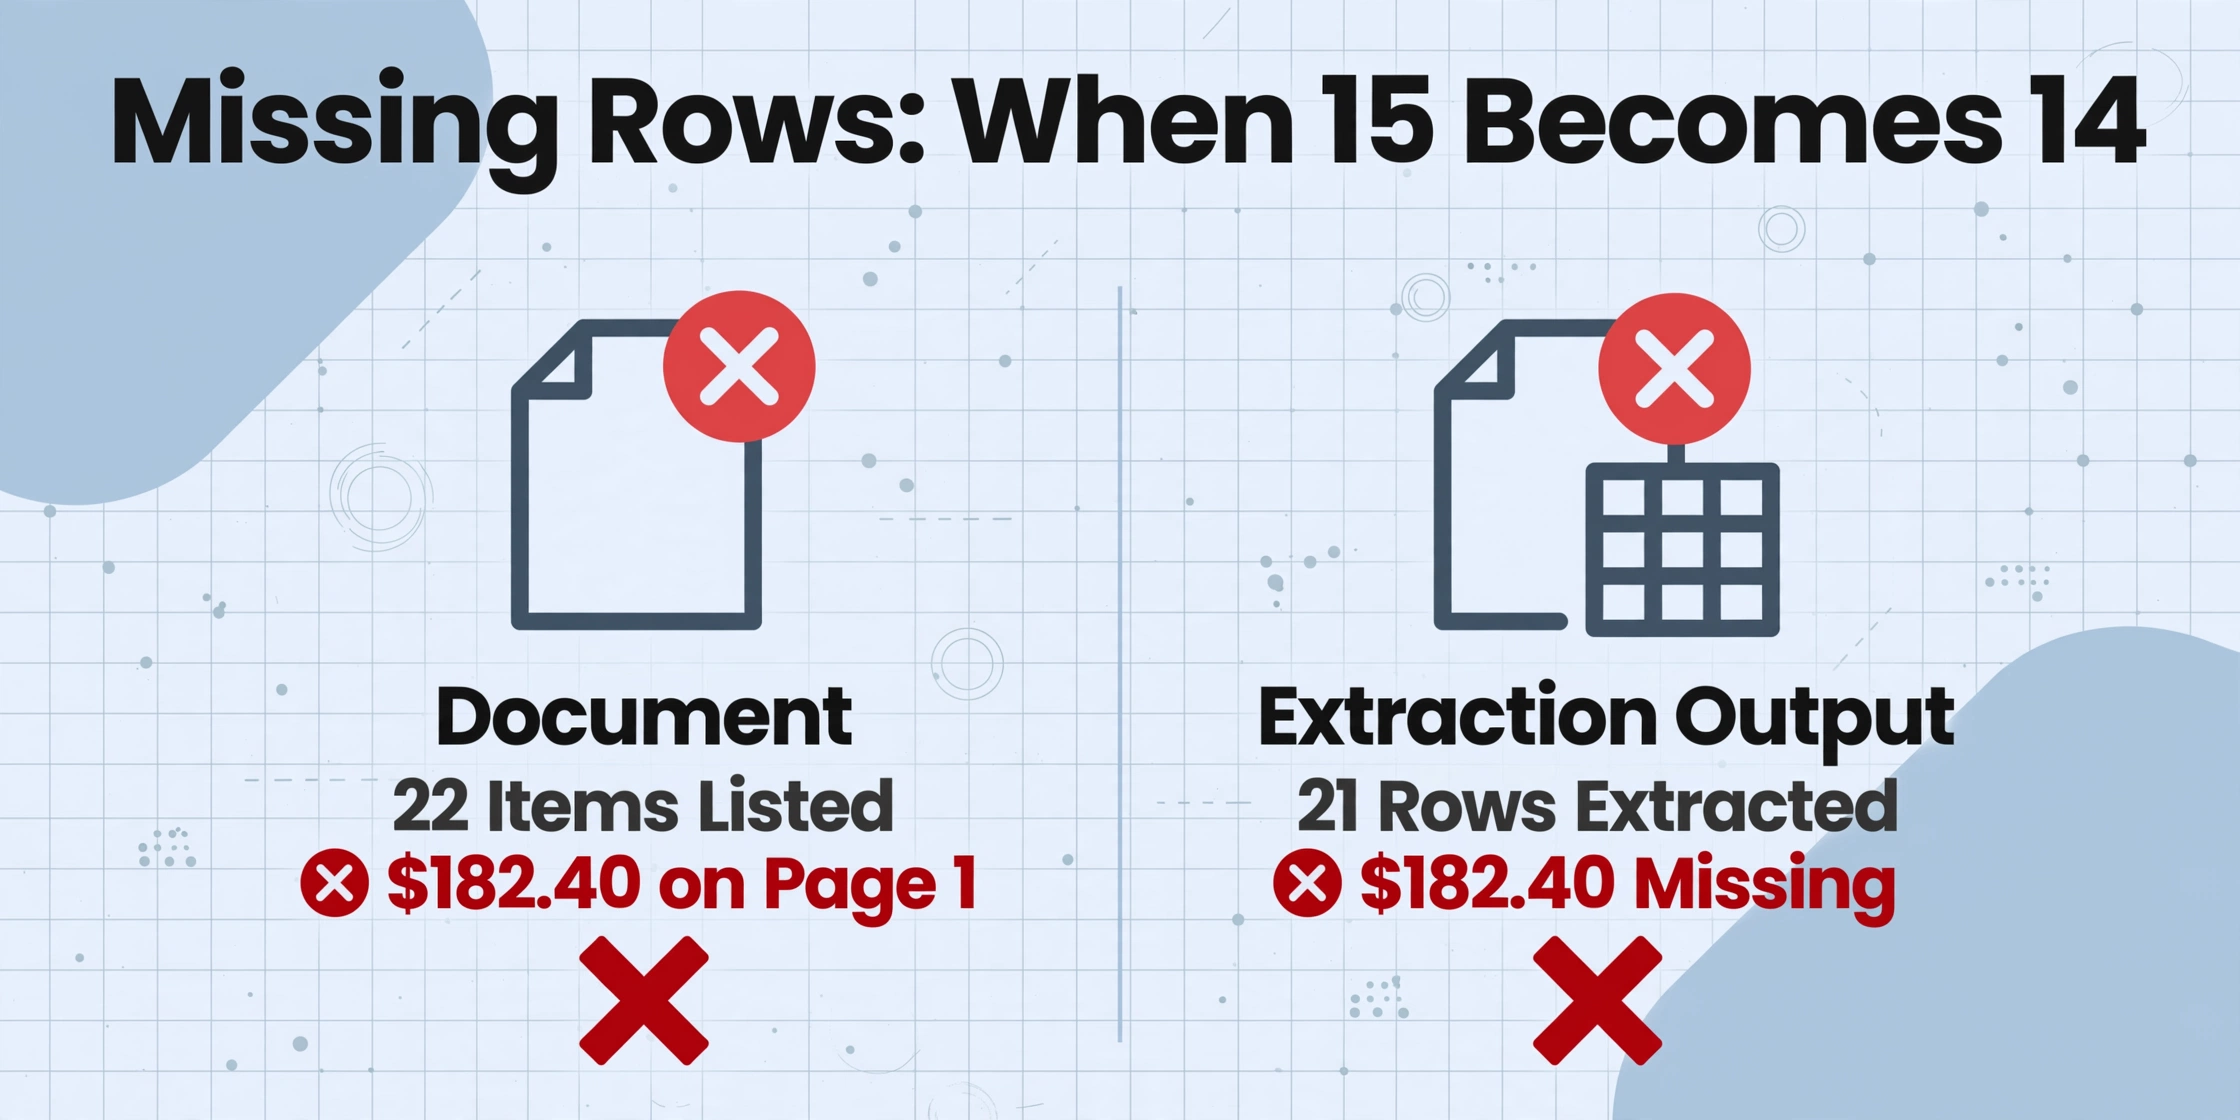
Eine Baustoffrechnung listet 22 Positionen auf — Schnittholz, Betonmischung, Bewehrungsstahl, Befestigungsmaterial — verteilt auf zwei Seiten. Die KI extrahiert 21 Zeilen. Die fehlende Zeile ist die letzte Zeile auf Seite eins, direkt unterhalb einer Kopfzeilenbox, die die Layout-Analyse der KI als strukturelles Element und nicht als Datenzeile identifiziert hat. Die Zeile existiert im Dokument. Der Wert in der Zeile beträgt $182,40. Die Zeilennummer ist 22. Aber das Extraktionsergebnis zeigt 21 Zeilen, und $182,40 taucht einfach nirgendwo in der Tabelle auf.
Bei einer Rechnung über $4.200 sind $182,40 4,3 %. Das wird den Monatsabschluss nicht sprengen. Aber es wird sechs Wochen später im Lieferantenabgleich auftauchen, woraufhin drei verschiedene Personen — der AP-Sachbearbeiter, der Einkaufsleiter und der AR-Kontakt des Lieferanten — zusammen 45 Minuten damit verbringen werden, es zurückzuverfolgen. Die Kosten für das Finden des Fehlers übersteigen die Kosten des Fehlers selbst.
Fehler durch fehlende Zeilen häufen sich an drei strukturellen Grenzen: Seitenumbrüche in mehrseitigen PDFs, Tabellenabschnitte, denen dicke Trennlinien oder umrahmte Kopfbereiche vorausgehen, und Seiten, auf denen die letzte Zeile einer Tabelle ganz am unteren Rand liegt. In jedem Fall behandelt das Layout-Verständnis der KI die Grenze als strukturelles Trennzeichen — Ende der Tabelle, Beginn eines neuen Abschnitts — statt die angrenzende Zeile als weiterhin zum Datenbereich gehörend zu erkennen. Die Ironie ist, dass die KI die Zeile korrekt als datenhaltig identifiziert; sie klassifiziert die Daten nur als zu einem anderen Bereich des Dokuments gehörend, und das Extraktionsschema fängt das nicht ab, weil das Schema definiert, welche Felder extrahiert werden sollen, nicht wie viele Zeilen vorhanden sein sollten.
Die Erkennungsmethode ist einfach, wird aber selten in Extraktions-Workflows eingebaut: zählen. Zählen Sie die Zeilen im Ergebnis. Vergleichen Sie sie mit einer schnellen visuellen Prüfung des Quelldokuments — oder, bei der Verarbeitung in großem Maßstab, mit einem bekannten Zeilenanzahlbereich für das typische Rechnungsformat jedes Lieferanten. Ein Lieferant, der immer 12-zeilige Rechnungen sendet und plötzlich eine 11-zeilige Extraktion liefert, ist eine Flagge, die es wert ist, untersucht zu werden, selbst wenn jeder extrahierte Wert korrekt aussieht.
Falsche Spaltenzuordnung: Rechnungsnummern, wo Rechnungsdaten sein sollten
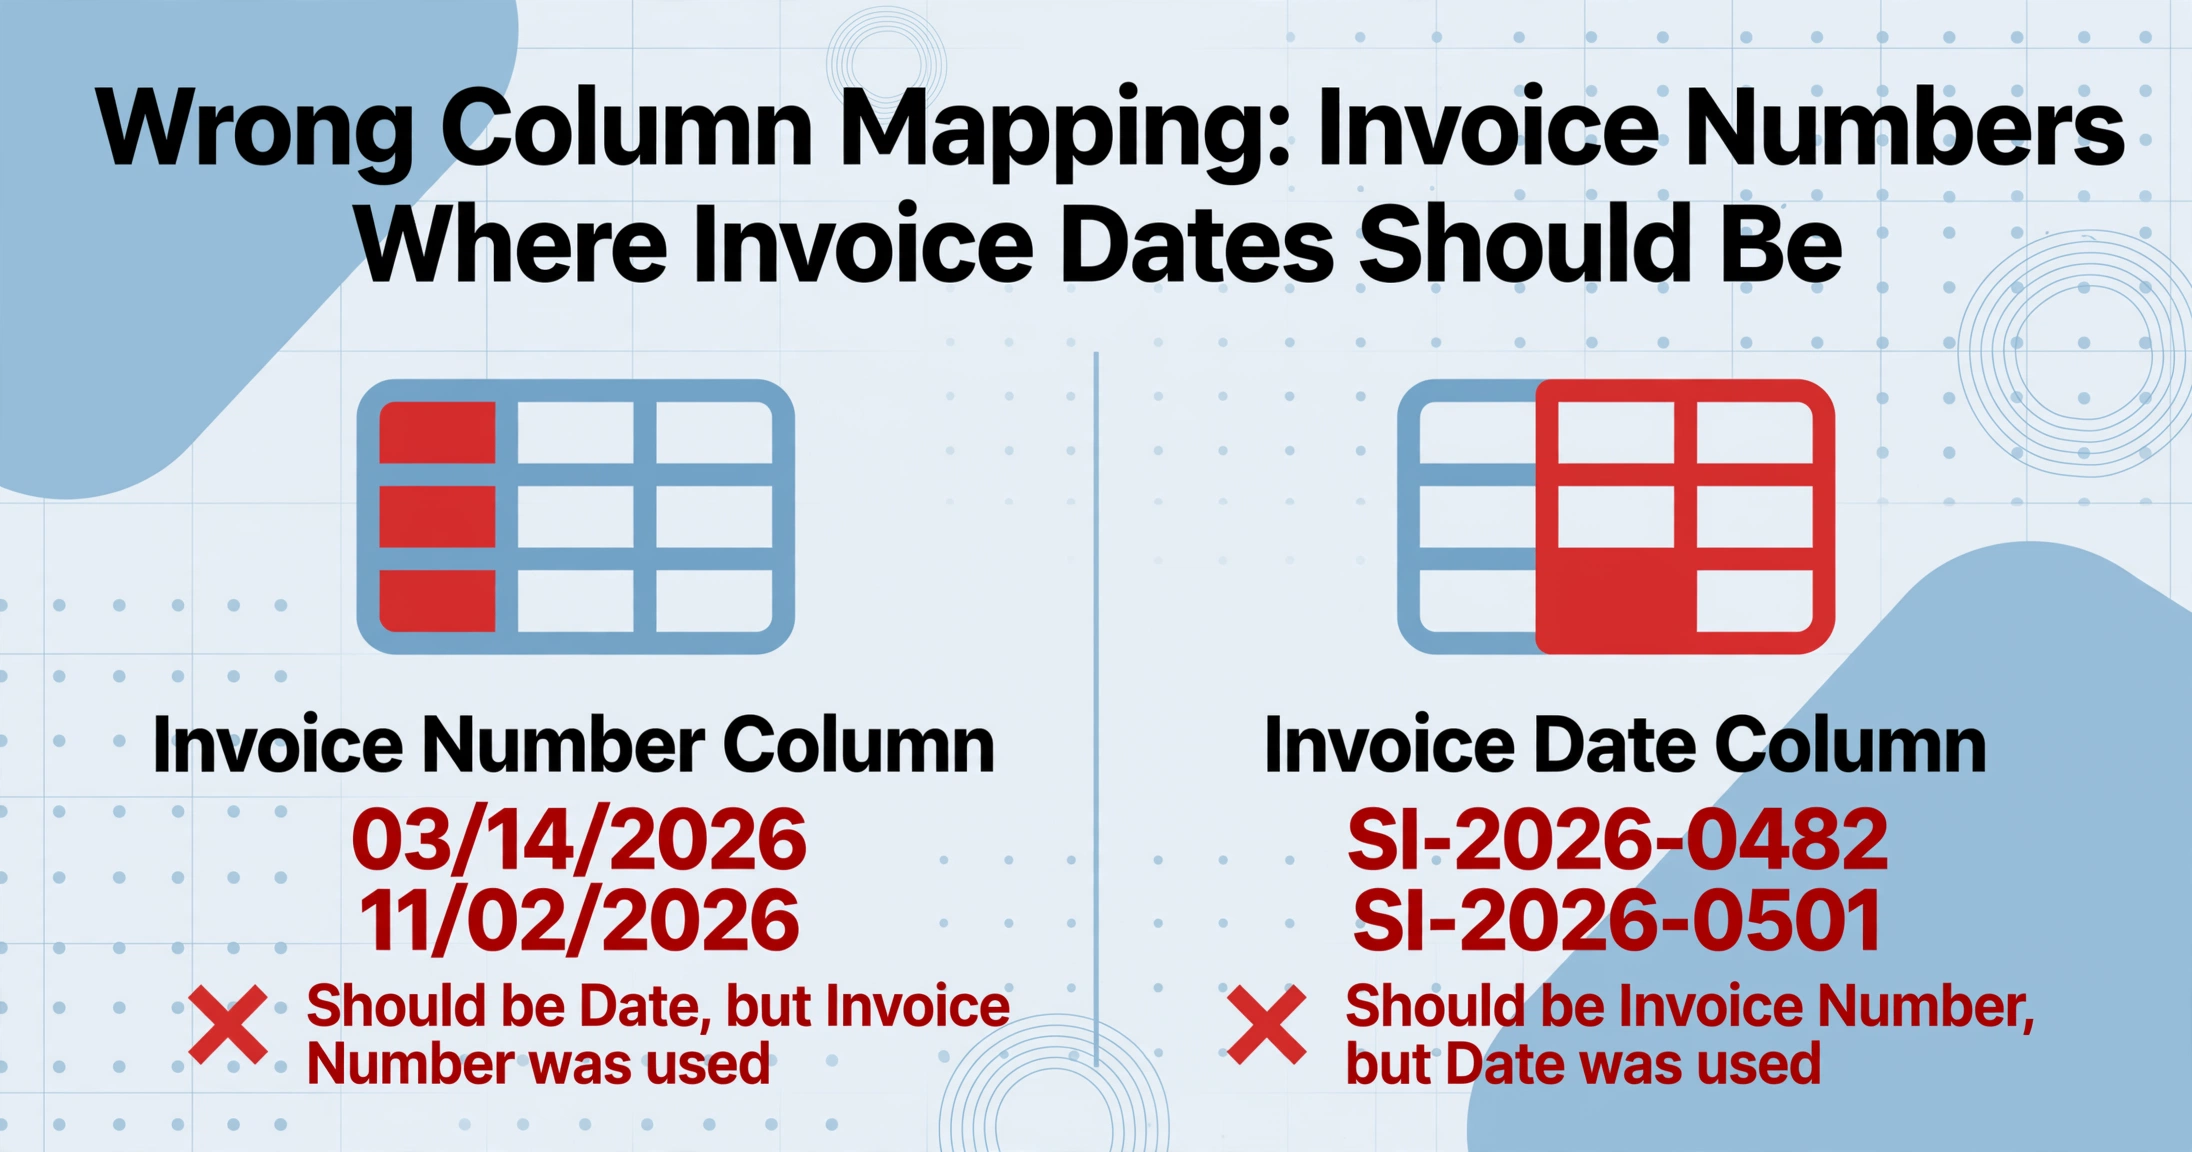
Ein Kollege beschrieb diesen Fehler als „den, der dich an deinen eigenen Augen zweifeln lässt.“ Die Tabellenspalte mit der Bezeichnung „Rechnungsnummer“ enthielt Werte wie „03/14/2026“ und „11/02/2026.“ Die Spalte mit der Bezeichnung „Rechnungsdatum“ enthielt Werte wie „SI-2026-0482“ und „SI-2026-0501.“ Jede Zelle hatte einen korrekt formatierten Wert. Jeder Wert stammte aus dem richtigen Dokument. Sie standen nur in den falschen Spalten – ein Vertauschungsfehler auf semantischer Ebene.
Diese Fehlerklasse ist besonders gefährlich, weil sie jede automatisierte Validierungsprüfung besteht. Die Rechnungsnummerspalte enthält Zeichenfolgen. Die Datumsspalte enthält Daten. Ein Datentyp-Validator erkennt nichts Falsches. Ein Nullwert-Prüfer findet keine Lücken. Ein Format-Validator bestätigt, dass jeder Wert dem erwarteten Format seiner Spalte entspricht. Die Tabelle wird ohne eine einzige Fehlermeldung in das ERP importiert. Der Schaden zeigt sich erst drei Wochen später, wenn das AP-Team feststellt, dass es Zahlungen gegen Daten statt gegen Rechnungsnummern abgeglichen hat.
Spaltenzuordnungsfehler entstehen im Extraktionsschema. Wenn Sie Spalten als „Rechnungsnummer“ und „Rechnungsdatum“ definieren, lokalisiert die KI beide Werte auf dem Dokument und weist sie ihren jeweiligen Spalten zu. Bei den meisten Rechnungen funktioniert das einwandfrei – die Felder sind klar beschriftet und die semantische Zuordnung ist eindeutig. Bei Dokumenten, in denen Rechnungsnummer und Rechnungsdatum nebeneinander in einem kleinen, unbeschrifteten Kopfblock liegen – häufig bei Stromrechnungen, einigen behördlichen Rechnungen und Kontoauszügen kleiner Lieferanten – kann die semantische Zuordnung der KI vertauscht werden. Das Modell sieht zwei Werte in einem engen Cluster, weiß, dass sie eine Kennung und ein Datum darstellen, hat aber kein explizites Layoutsignal, welches welches ist. In 1–3 % der Fälle über ein großes und vielfältiges Rechnungskorpus rät es falsch.
So erkennen Sie es. Führen Sie nach der Extraktion eine spaltenübergreifende Formatprüfung durch. Eine Spalte „Rechnungsnummer“, in der mehr als 5 % der Werte einem Datumsmuster entsprechen, sollte ein Prüfflag auslösen. Ebenso verdient eine „Datums“-Spalte mit alphanumerischen Mustern, die Rechnungsnummernkonventionen entsprechen, einen zweiten Blick. Dies ist keine Prüfung, die Sie für jede Zeile ausführen – es ist eine Plausibilitätsprüfung für neue Batch-Ausgaben, die 15 Sekunden dauert und die stille Fehlerklasse erfasst, die automatisierte Validierung übersehen soll.
Währungs- und Dezimalfehler: Das Komma, das drei Größenordnungen kostet
Europäische und lateinamerikanische Rechnungsformate verwenden Kommas als Dezimaltrennzeichen und Punkte als Tausendertrennzeichen – umgekehrt zu den US- und UK-Konventionen. Eine Rechnung eines deutschen Lieferanten lautet „1.250,00“ – also eintausendzweihundertfünfzig Euro und null Cent. Extrahieren Sie dies als „$1.250,00“ und Sie haben den korrekten Wert. Extrahieren Sie es als „$1250.00“ – ohne das Tausendertrennzeichen – und Sie haben immer noch den korrekten numerischen Wert. Extrahieren Sie es als „$12.50“ – indem Sie das Komma fälschlich als Dezimaltrennzeichen interpretieren – und der extrahierte Wert weicht um zwei Größenordnungen ab.
Der Fehler wird von der Formatvalidierung nicht erkannt, da „$12.50“ ein völlig gültiger Währungsbetrag ist. Er löst keinen Bereichscheck aus, es sei denn, jemand hat explizite Grenzen pro Lieferant festgelegt. Er wird sauber in das ERP importiert. Und der eigentliche Schaden wird erst sichtbar, wenn der Lieferant anruft und fragt, warum ihm $12.50 auf einer Rechnung über €1.250,00 gezahlt wurden.
Die Dezimalpunktverschiebung tritt in mehreren Formen auf. Die europäische Komma-Punkt-Umkehrung – der bekannteste Fall – macht etwa ein Drittel aller numerischen Fehler nach der Extraktion in der internationalen Rechnungsverarbeitung aus. Ein weiteres Drittel entsteht, wenn die KI eine nachgestellte Null verwirft: $1.250,00 wird zu $125.00, weil das Modell „1250“ korrekt geparst, aber den Dezimalpunkt an die falsche Position gesetzt hat. Das verbleibende Drittel umfasst OCR-Artefakte – ein Fleck oder eine Falte, die den Dezimalpunkt verdeckt, sodass $1.250,00 als $125000 oder $12.5000 gelesen wird, was beides nicht sauber auf ein Standardwährungsformat abbildbar ist.
So erkennen Sie es. Fügen Sie für Dokumente mit bekannten Währungskonventionen eine Dezimalpositions-Validierungsregel hinzu: Wenn der extrahierte Betrag um mehr als eine Größenordnung vom erwarteten Bereich für diesen Lieferanten abweicht, markieren Sie ihn. Vergleichen Sie bei der Stapelverarbeitung die Größenordnung jedes Betrags mit der historischen Verteilung des Lieferanten – eine einzelne €1.250-Rechnung von einem Lieferanten, dessen letzte 50 Rechnungen zwischen €800 und €3.200 liegen, ist in Ordnung. Eine €12.50-Rechnung desselben Lieferanten ist es wert, geprüft zu werden, bevor sie in den Zahlungslauf gelangt. Der Genauigkeitsleitfaden für Dokumentenextraktion behandelt, wie feldgenaue Metriken mit realen Finanzdaten interagieren – einschließlich der spezifischen Fehlermodi, die allgemeine Genauigkeitsraten verbergen.
Datumsformat-Chaos: MM/TT trifft auf TT/MM in derselben Spalte
Eine Charge von 200 Rechnungen wird für den Monatsabschluss der Kreditorenbuchhaltung (AP) verarbeitet. Die Extraktionsausgabe zeigt eine Spalte „Rechnungsdatum“, in der einige Zeilen „03/05/2026“ und andere „05/08/2026“ lesen. Der erste Wert steht für den 5. März 2026 (von einem US-Lieferanten). Der zweite für den 8. Mai 2026 (von einem britischen Lieferanten). Aber es gibt keine Möglichkeit, allein aus der Tabelle zu erkennen, welcher welcher ist – beide Formate sind gültige Daten, beide lassen sich problemlos in das ERP importieren, und beide wirken für einen Prüfer, der schnell scannt, normal. Die KI hat die Datumszeichenfolgen so extrahiert, wie sie auf jedem Dokument erschienen, ohne eine Normalisierung über die Charge hinweg anzuwenden.
Gemischte Datumsformate in einer einzigen Spalte sind in puncto Datenqualität das Äquivalent einer tickenden Uhr. Die Spalte sortiert falsch – 03/05/2026 sortiert in einem MM/TT/JJJJ-System vor 05/08/2026, aber in TT/MM/JJJJ danach. Aus diesen Daten erstellte Alterungsberichte liefern falsche Ergebnisse. Aus Rechnungsdaten berechnete Zahlungsbedingungen verschieben sich um Tage oder Wochen, je nachdem, welche Konvention die Formel annimmt. Und die Fehler entstehen nicht durch schlechte Extraktion, sondern durch das Fehlen eines Normalisierungsschritts zwischen Extraktion und ERP-Import – ein Schritt, der so einfach ist, dass er selten formalisiert wird.
Das Worst-Case-Szenario: eine Spalte, die US-amerikanische und nicht-US-amerikanische Datumsformate verschiedener Lieferanten mischt, ohne Metadaten darüber, welche Quelle welcher Konvention folgt. Die KI, die ein einzelnes Dokument liest, kann die Locale des Lieferanten nicht kennen – sie kann nur die Zeichenfolge so extrahieren, wie sie geschrieben steht. Die Normalisierung muss als bewusster Schritt nach der Extraktion erfolgen: die Datumskonvention pro Lieferant identifizieren, alle Daten in das ISO-Format (JJJJ-MM-TT) umwandeln und validieren, dass kein Datum außerhalb eines angemessenen Bereichs für diesen Dokumenttyp liegt.
So erkennen Sie es. Scannen Sie nach der Extraktion die Datumsspalte auf Werte, bei denen das erste Segment 12 überschreitet – das sind TT/MM-Daten (oder Fehler). Bei mehrdeutigen Werten (beide Segmente ≤ 12) gleichen Sie diese mit der bekannten Locale des Lieferanten oder den Sprachmetadaten des Dokuments ab. Legen Sie eine Regel fest: Jedes Datum in der Ausgabe muss einem einzigen deklarierten Format entsprechen, bevor die Charge für den ERP-Import freigegeben wird. Dies ist kein KI-Problem. Es ist ein Workflow-Problem mit einer deterministischen Lösung.
Doppelte Zeilen: Dieselben Daten, zweimal extrahiert
Eine Rechnung eines Catering-Lieferanten enthält eine Positionstabelle, die sich über zwei Seiten erstreckt. Der Seitenumbruch schneidet durch Zeile 9 von 18. Auf Seite eins extrahiert die KI die Zeilen 1 bis 9. Auf Seite zwei stößt die Layout-Analyse der KI auf das, was sie als neue Tabelle interpretiert – gleiche Spaltenstruktur, gleiche Kopfzeilen am Anfang der Seitenfortsetzung – und extrahiert die Zeilen 9 bis 18 erneut. Zeile 9 erscheint nun zweimal in der Ausgabe: einmal aus der Tabelle von Seite eins, einmal aus der Fortsetzung von Seite zwei.
Die doppelte Zeile wird normalerweise beim Drei-Wege-Abgleich entdeckt – Bestellung, Wareneingang und Rechnung –, wenn die summierten Mengen auf der Rechnung die Bestellmengen um genau die Menge der doppelten Zeile überschreiten. Die Entdeckung erfordert jedoch, dass jemand den Drei-Wege-Abgleich durchführt. In Organisationen, in denen AP Rechnungen ohne automatisierte Bestellabstimmung verarbeitet, gelangt die Duplikatzeile bis zur Zahlung. Eine $340-Position, die auf einer $5.000-Rechnung doppelt bezahlt wird, ist eine 6,8%ige Überzahlung, die der Lieferant möglicherweise gutschreibt – oder auch nicht.
Fehler durch doppelte Zeilen sind mechanisch einfach zu erkennen: Hashen Sie den Inhalt jeder Zeile und suchen Sie nach identischen Hashes innerhalb der Ausgabe desselben Dokuments. Die meisten Extraktions-Workflows enthalten jedoch keine Deduplizierungsprüfung, weil die Annahme ist, dass die KI-Extraktion eine Zeile pro Quellzeile erzeugt – eine Annahme, die in 98 % der Fälle zutrifft und genau in dem Szenario scheitert, in dem eine Tabelle einen Seitenumbruch überschreitet. Die Lösung ist eine Deduplizierungsregel, die auf die Ausgabe angewendet wird, nicht eine Änderung am Extraktionsmodell.
Leere Zellen, obwohl Daten im Dokument vorhanden sind
Ein medizinischer EOB (Explanation of Benefits) einer Versicherung listet acht Datenspalten pro Zeile auf: Leistungsdatum, Verfahrenscode, abgerechneter Betrag, zulässiger Betrag, von der Versicherung gezahlt, Eigenanteil des Patienten, angewandter Selbstbehalt und Anmerkungen. Nach der Extraktion zeigt die Spalte „Eigenanteil des Patienten“ leere Zellen für vier der zwölf Ansprüche auf der Seite. Die KI hat die anderen sieben Spalten korrekt gelesen. Sie hat lediglich keinen Wert für den Eigenanteil des Patienten identifiziert – möglicherweise, weil das Feld in diesem speziellen EOB-Format als „You Owe“ beschriftet war, nicht als „Patient Responsibility“, und die semantische Übereinstimmung zwischen der Beschriftung im Dokument und dem Spaltennamen im Extraktionsschema zu schwach war.
Leere Zellen sind die stillen Killer der Datenqualität nach der Extraktion, weil sie nicht wie Fehler aussehen. Eine Zeile mit acht gefüllten Spalten und einer leeren wirkt normal – besonders in einer Spalte wie „Eigenanteil des Patienten“, in der Nullwerte tatsächlich häufig vorkommen. Ein Prüfer, der die Ausgabe mit einer Geschwindigkeit von 2 Sekunden pro Zeile scannt, sieht „leer“ und nimmt „$0“ an – eine vernünftige, aber falsche Schlussfolgerung. Der tatsächliche Wert war $47,30. Nicht viel. Aber über 42 Ansprüche in einem Batch hinweg repräsentieren vier leere Zellen für den Eigenanteil des Patienten $189,20 an fehlender Patientenabrechnung, die bis zum nächsten Abrechnungszyklus unbemerkt bleibt.
So erkennen Sie es. Scannen Sie nach der Extraktion jede Zeile auf das Vorhandensein von Leerstellen in nicht-optionalen Spalten. Definieren Sie, welche Spalten für einen bestimmten Dokumenttyp niemals leer sein sollten – Rechnungssummen, Daten, Lieferanten-IDs – und markieren Sie Zeilen, in denen diese Spalten leer sind. Für Spalten, die legitimerweise Nullwerte enthalten, verlangen Sie, dass die KI explizit „N/A“ oder „$0“ ausgibt, anstatt die Zelle leer zu lassen, damit fehlende Daten immer von Nullwertdaten („$0“) unterscheidbar sind. Dies ist eine Felddefinitions-Disziplin, keine Modellverbesserung. Der Leitfaden zur Korrektur falsch extrahierter Zahlen erklärt, wie Spaltenbenennung und Felddefinition direkt bestimmen, ob die KI einen Wert findet oder nichts zurückgibt.
Die sieben oben genannten Fehlerarten haben eines gemeinsam: Bei jedem einzelnen handelt es sich um einen Wert, der für sich betrachtet korrekt aussieht und alle automatisierten Formatprüfungen besteht. Kein Fehler löst einen Alarm aus. Kein Fehler bringt die Extraktionspipeline zum Absturz. Kein Fehler ist für einen Prüfer, der mit operativer Geschwindigkeit scannt, offensichtlich falsch. Das sind keine Extraktionsfehler – es sind Verifizierungsfehler. Und die Kosten, die durch das Übersehen entstehen, skalieren mit der Größe des Batches.
Warum sich diese Fehler still anhäufen – und warum die Verzögerung zwischen Fehler und Erkennung die eigentlichen Kosten verursacht
In einem traditionellen manuellen Datenerfassungs-Workflow hat die Person, die von einer Papierrechnung in einen ERP-Bildschirm tippt, eine visuelle Referenz. Sie kann sehen, dass die Spalte mit den Positionssummen nicht befüllt wird. Sie bemerkt, wenn die letzte Zeile einer Tabelle durch eine Seitenfußzeile abgeschnitten wird. Die Feedback-Schleife ist unmittelbar – der Fehler tritt im selben Moment auf, in dem die Dateneingabe erfolgt, weil der Mensch, der die Eingabe durchführt, gleichzeitig eine kontinuierliche, unbewusste Verifizierung durchführt.
Automatisierte Extraktion unterbricht diese Feedback-Schleife. Die KI liest das Dokument, erstellt die Ausgabe und übergibt sie an das ERP – alles ohne menschlichen Blick auf das Zwischenergebnis. Die Feedback-Schleife schrumpft von „sofort" auf „bei der nächsten Abstimmung". Und Abstimmungen finden wöchentlich, monatlich oder vierteljährlich statt – ein Zeitfenster, in dem sich Fehler unentdeckt ansammeln.
Eine einzelne fehlende Zeile auf einer einzelnen Rechnung ist ein 200-Dollar-Problem. Zwanzig fehlende Zeilen auf zwanzig Rechnungen in einem Monat sind ein 4.000-Dollar-Problem. Aber die Kosten für die Diagnose von zwanzig fehlenden Zeilen – jede einzelne zurück zum Quelldokument verfolgen, den Lieferanten identifizieren, den korrekten Betrag bestätigen, eine korrigierte Zahlung ausstellen und das Hauptbuch aktualisieren – übersteigen 4.000 Dollar bei weitem. Die Arbeitskosten für das Auffinden von Fehlern nach der Extraktion betragen typischerweise das 3- bis 5-fache des Werts des Fehlers selbst. Deshalb ist die effektivste Verifizierungsstrategie nicht „Fehler schneller finden" – sondern „Fehler abfangen, bevor sie ins System gelangen". Eine 30-Sekunden-Prüfung vor dem Import, die eine fehlende Zeile erkennt, verwandelt eine 25-minütige Abstimmungsuntersuchung in eine 2-minütige erneute Extraktion.
Der Ardent-Partners-AP-Metriken-Bericht 2025 ergab, dass ein durchschnittliches Unternehmen 9,40 $ für die End-to-End-Verarbeitung einer einzelnen Rechnung ausgibt, wobei 14 % der Rechnungen eine Ausnahme enthalten, die manuelles Eingreifen erfordert. Der Bericht trennt nicht zwischen „Extraktionsfehler", „Richtlinienausnahme" oder „Genehmigungsrouting-Problem", aber die Überschneidung ist groß: Ein erheblicher Teil dieser manuellen Eingriffe wird durch Daten ausgelöst, die nicht korrekt im ERP gelandet sind – dieselbe Fehlerklasse, die dieser Artikel beschreibt. Jeder Fehler nach der Extraktion, der ins ERP gelangt, verwandelt eine maschinenschnelle Eingabe in eine Ausnahme mit menschlicher Geschwindigkeit, und die Kosten dieser Ausnahme werden in Arbeitszeit bezahlt, nicht in Technologie.
Die Verifizierungsgewohnheit: Fünf Checks, die 30 Sekunden dauern
Einen Verifizierungsschritt in Ihren Extraktions-Workflow einzubauen, erfordert keine Datenqualitätsplattform oder ein dediziertes Validierungsteam. Fünf mechanische Checks, konsequent angewendet, fangen die sieben oben beschriebenen Fehlertypen ab, bevor sie Ihr ERP erreichen:
Die zentrale Erkenntnis hinter diesen fünf Checks ist, dass sie kein erneutes Lesen von Dokumenten oder manuelles Vergleichen der Ausgabe mit der Quelle erfordern. Sie sind statistisch und mechanisch – ein 30-Sekunden-Scan für einen Batch beliebiger Größe – und sie fangen die Fehler ab, die einer visuellen Prüfung entgehen, weil sie sich in Daten verstecken, die für das menschliche Auge korrekt aussehen.
Für eine vertiefte Behandlung des Verifizierungs-Workflows – einschließlich der Strukturierung eines wiederkehrenden QA-Prozesses, der Stichprobengröße für Stichprobenprüfungen und der Integration der Verifizierung in einen Team-Workflow statt als Ein-Personen-Gate – bietet die QA-Checkliste zur Verifizierung KI-extrahierter Daten einen vollständigen operativen Rahmen. Diese fünf Checks sind der Ausgangspunkt. Die QA-Checkliste ist der fortlaufende Prozess.
Die Diskussion über Extraktionsgenauigkeit hat eine wichtige Dimension, die die meisten Benchmarks nicht erfassen und die der praktische Genauigkeitsvergleich für Dokumentextraktionstools im Detail untersucht: Feldgenauigkeit und Straight-Through-Processing-Raten erzählen grundlegend unterschiedliche Geschichten über dasselbe Tool. Das Verständnis der Kluft zwischen beiden ist entscheidend, um einen Verifizierungs-Workflow aufzubauen, der vor den richtigen Fehlern schützt.
FAQ
Kann ich diese Fehler nicht einfach mit Excel-Formeln abfangen?
Können Sie — und viele Teams tun das. Eine SUM-Formel, die extrahierte Positionssummen mit der extrahierten Zwischensumme vergleicht, fängt arithmetische Abschlussfehler ab. Eine COUNT-Formel fängt fehlende Zeilen ab, wenn die erwartete Anzahl bekannt ist. Eine bedingte Formatierungsregel, die Zellen mit Datumsmustern in Nicht-Datums-Spalten hervorhebt, deckt Spaltenzuordnungsprobleme auf. Das Problem ist, dass diese Formeln für jedes Batch-Layout neu erstellt werden müssen und jemand daran denken muss, sie anzuwenden. Bei der Verifizierungsgewohnheit geht es nicht um die Fähigkeit — es geht darum, sie zum Standard-Workflow zu machen, damit sie nicht von der Sorgfalt einer einzelnen Person an einem hektischen Dienstag abhängt.
Wie oft treten diese Fehler tatsächlich auf?
Die Fehlerraten auf Feldebene variieren je nach Dokumenttyp und -qualität. Bei sauberen, standardformatierten Geschäftsrechnungen erreicht moderne KI-Extraktion eine Feldgenauigkeit von 98–99 % — das bedeutet 1–2 falsche Felder pro 100. Bei heterogenen Dokumentensätzen mit gemischten Formaten, Handschrift und unterschiedlicher Scanqualität sinkt die Feldgenauigkeit auf 90–95 %. Entscheidend ist: Selbst bei 99 % Feldgenauigkeit bei einer Rechnung mit 15 Feldern enthält etwa jede siebte Rechnung mindestens einen Fehler. Bei 500 Rechnungen pro Monat sind das etwa 70 Rechnungen mit mindestens einem Fehler. Die Fehlerrate ist niedrig. Die Fehleranzahl in großem Maßstab ist es nicht.
Fängt das ERP diese nicht ab, wenn es den Import validiert?
Die ERP-Validierung prüft Datenformat und Vollständigkeit — sie stellt sicher, dass Datumsfelder Daten enthalten, Zahlenfelder Zahlen und Pflichtfelder ausgefüllt sind. Sie prüft nicht die arithmetische Abschlussprüfung (ergeben Positionssummen die Zwischensumme?), die spaltenübergreifende Konsistenz (ist die Rechnungsnummernspalte tatsächlich voller Daten?) oder die Zeilenvollständigkeit (sollten hier 15 Zeilen statt 14 sein?). Die ERP-Validierung fängt Syntaxfehler ab. Fehler nach der Extraktion sind semantische Fehler. Sie bestehen jeden Syntaxcheck.
Sollte ich jedes Dokument prüfen oder Stichproben verwenden?
Bei den fünf mechanischen Prüfungen — arithmetische Abschlussprüfung, Zeilenanzahl-Plausibilität, spaltenübergreifendes Format, Größenordnungsbereich, Null-Scan — prüfen Sie jedes Dokument. Diese Prüfungen sind automatisierbar und schnell; es gibt keinen Grund für Stichproben. Bei der visuellen Verifikation — Vergleich der extrahierten Ausgabe mit dem Quelldokumentbild — prüfen Sie 5–10 % der Dokumente pro Batch, geschichtet nach Lieferant und Dokumentkomplexität. Reservieren Sie die 100 %-visuelle Verifikation für den ersten Batch eines neuen Lieferanten oder eines neuen Dokumentformats. Sobald Sie bestätigt haben, dass das Extraktionsmuster für diese Quelle stabil ist, reduzieren Sie auf Stichproben.
Wie sieht es mit Handschrift aus? Sind die Fehlermuster anders?
Ja — Handschrift führt zu einem anderen Fehlerprofil. Zeichenverwechslungen (1 vs. 7, 0 vs. 6, S vs. 5) sind häufiger, besonders bei Zahlen. Fehlende Zeilen treten öfter auf, da handschriftliche Tabellen weniger konsistente Zeilenabstände und Ausrichtung aufweisen, was die Layout-Analyse verwirrt. Spaltenzuordnungsfehler sind seltener, da handschriftliche Formulare tendenziell weniger Felder und klarere Beschriftungen haben. Die hier beschriebenen Prüfungen gelten weiterhin, aber bei handschriftlichen Dokumenten ist mit mehr Fehlern auf Zeichenebene zu rechnen — arithmetische Abschlussprüfung und Größenordnungsprüfung werden als Sicherheitsnetz besonders wichtig.
Kann das Extraktionstool diese Prüfungen automatisch durchführen?
Einige Tools bieten berechnete Spalten oder Validierungsregeln, die arithmetische Abschlussprüfung und spaltenübergreifende Prüfungen während der Extraktion durchführen können. ImageToTable.ai's Computed Columns — eine Funktion, mit der Sie Berechnungen wie „Summe aller Positionssummen und Vergleich mit der extrahierten Zwischensumme“ direkt in Ihrem Extraktionsschema definieren können — führt die arithmetische Validierung zum Zeitpunkt der Extraktion durch, sodass die Ausgabe bereits vorverifiziert ankommt. Aber selbst wenn Ihr Tool dies nicht bietet, sind die fünf oben beschriebenen Prüfungen Tabellenkalkulationsoperationen, die 30 Sekunden pro Batch dauern. Die Verifizierungsgewohnheit hängt nicht von Tool-Funktionen ab — sie hängt davon ab, die Prüfungen in den Workflow zu integrieren.
Fehler nach der Extraktion sind kein Versagen der KI. Sie sind eine Lücke im Prozess zwischen Extraktion und ERP – eine Lücke, die existiert, weil Extraktionstools darauf ausgelegt sind, Daten zu erzeugen, nicht sie zu prüfen. Die sieben hier beschriebenen Fehler haben eine gemeinsame Ursache: Sie bestehen jede automatisierte Prüfung, weil die Prüfungen die falschen Dinge prüfen. Formatvalidierung erkennt schlechtes Format. Arithmetische Validierung erkennt schlechte Mathematik. Die Lücke liegt dazwischen – und sie zu schließen kostet 30 Sekunden pro Batch, nicht ein neues Tool oder ein größeres Team.
Wenn Sie Dokumentdaten verarbeiten und die Verifizierung direkt in Ihren Extraktions-Workflow integrieren möchten, ImageToTable.ai führt eine verifizierungszentrierte Extraktions-Pipeline aus – das Tool extrahiert nach Feldsemantik, nicht nach Vorlagenkoordinaten, und unterstützt berechnete Spalten, die Zeilensummen abgleichen, Steuerarithmetik prüfen und Größenordnungs-Anomalien während der Extraktion markieren, statt danach. Der vollständige QA-Verifizierungs-Workflow beschreibt, wie Sie die fünf oben genannten Prüfungen in einen nachhaltigen Teamprozess operationalisieren.
Laden Sie Ihre eigenen Dokumente hoch – sehen Sie, was extrahiert wird, und führen Sie dann die fünf Prüfungen durch, um die Ausgabe zu verifizieren.
Mit eigenen Dokumenten testen