Por que Erros de Dados Pós-Extração São
Piores do que a Maioria das Equipes Imagina
O gargalo na extração de documentos não é colocar os dados em uma planilha. A IA que lê 42 itens de linha de uma fatura de fornecedor em seis segundos já resolveu esse problema. O gargalo é detectar os erros que não parecem erros — os totais que estão errados exatamente pela última linha, a coluna de datas onde deveriam estar os números da fatura, as células em branco onde valores em dólar apareciam na página. Esses erros não têm luz de aviso. Eles alimentam seu ERP, seus relatórios de fechamento mensal, seus pagamentos a fornecedores, e ninguém os percebe até que uma conciliação quebre duas semanas depois.
Principais Conclusões
- Com 99% de precisão de campo, aproximadamente uma em cada sete faturas no seu lote carrega um erro de dados silencioso — e seu ERP importará cada uma delas sem aviso.
- A validação de formato detecta sintaxe, mas é cega às relações entre células — um subtotal que não corresponde à soma de seus itens de linha passa em todas as verificações automatizadas, e rastrear essa lacuna durante a conciliação custa de três a cinco vezes o valor do pagamento a maior.
- 30 segundos de verificação mecânica após a extração detectam todas as sete classes de erro antes que cheguem ao seu ERP — sem novas ferramentas, apenas cinco verificações que fecham a lacuna entre "as células parecem corretas" e "os números realmente somam".
Totais Que Não Fecham: O Erro Que Ninguém Pensa em Verificar
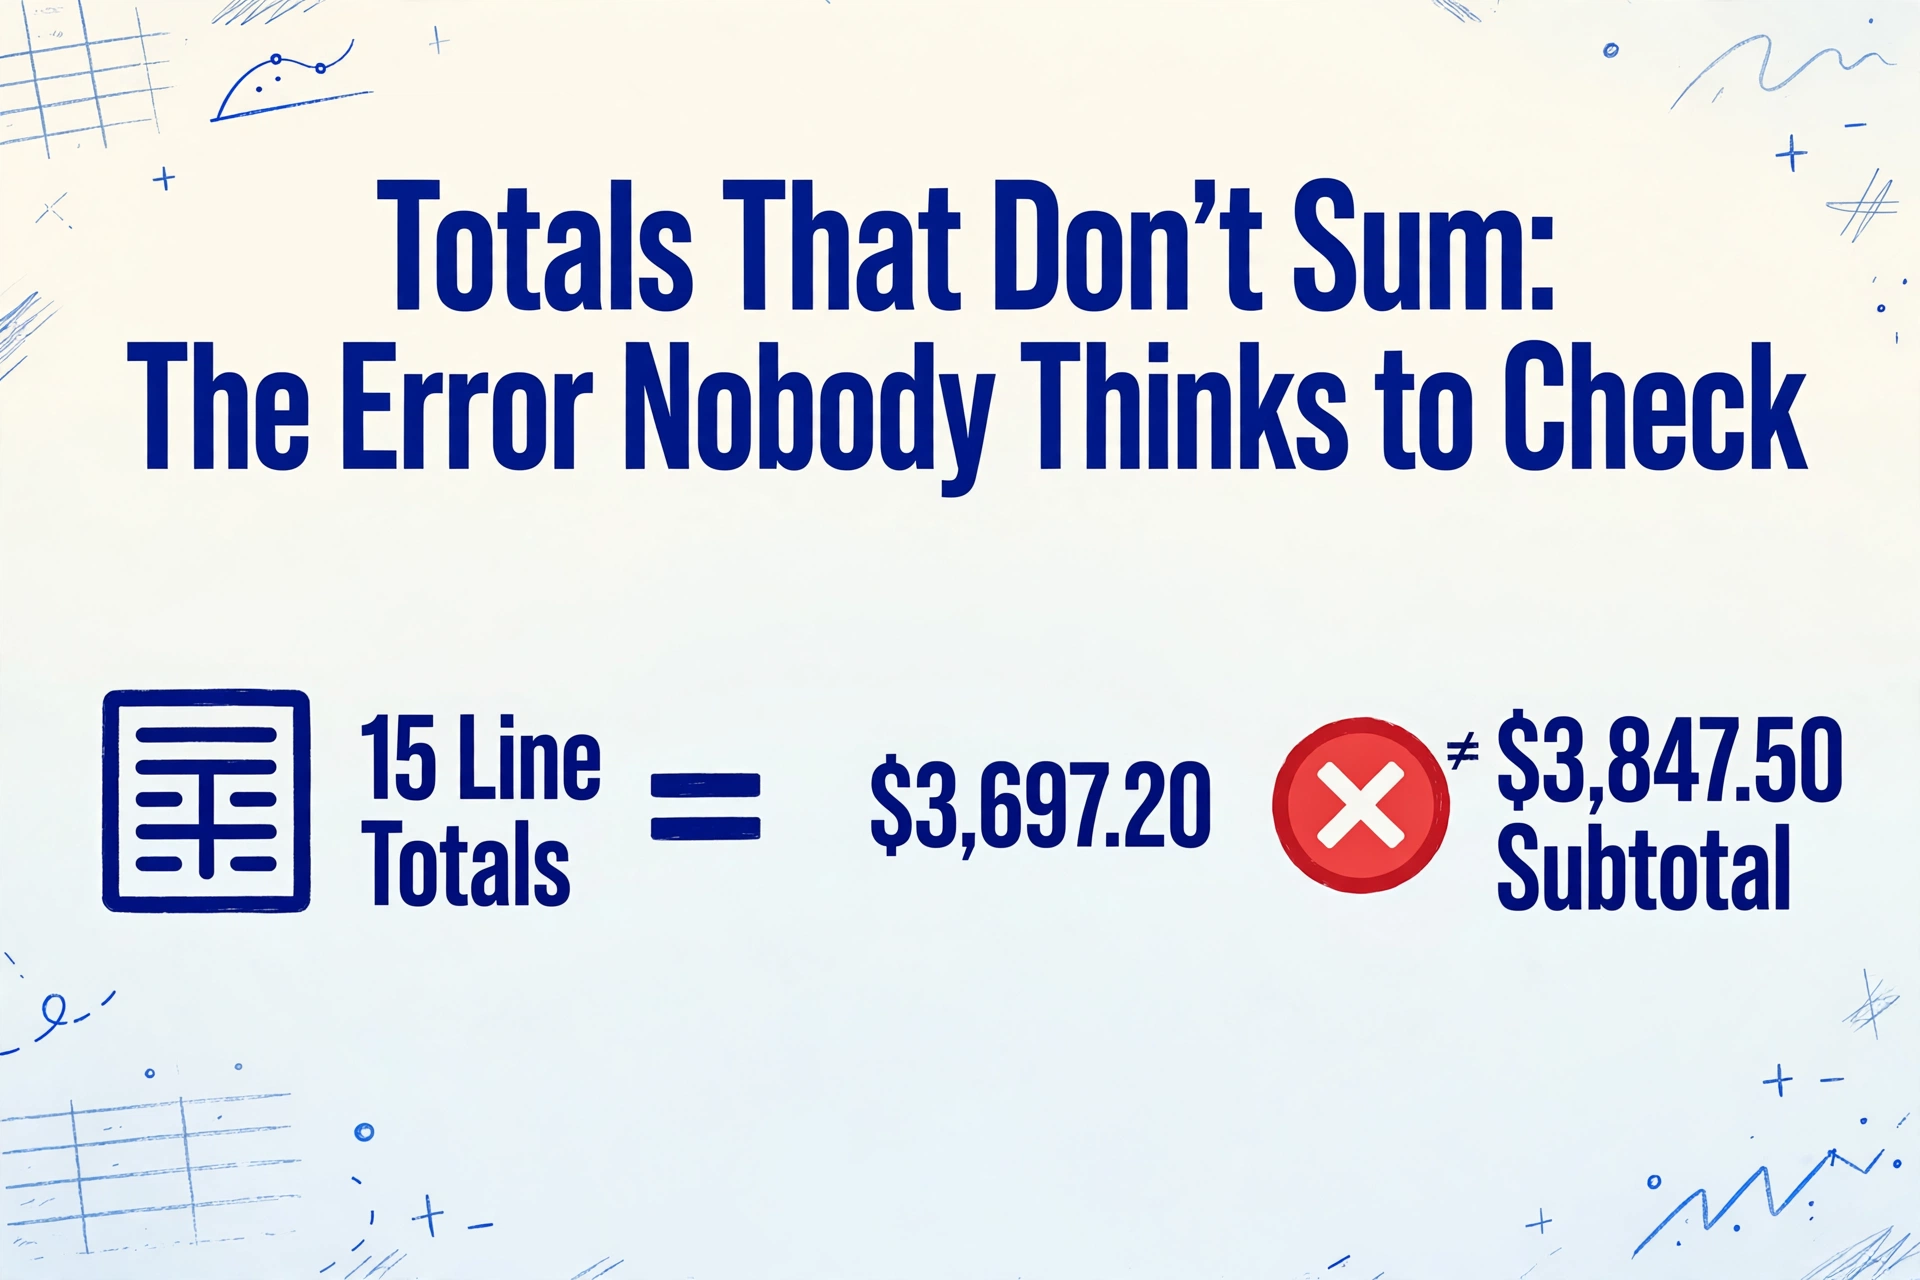
O erro pós-extração mais comum também é o mais invisível. Uma fatura chega de um fornecedor de encanamento — três páginas, 15 itens de linha, um subtotal de $3.847,50, $307,80 em impostos, um total geral de $4.155,30. A IA lê cada linha corretamente. Quantidade: 12. Preço unitário: $47,25. Total da linha: $567,00. Todos os quinze totais de linha são extraídos corretamente. O subtotal é extraído corretamente em $3.847,50. O total geral é extraído corretamente em $4.155,30. Cada valor individual na planilha parece certo. Mas ninguém verificou se os quinze totais de linha realmente somam $3.847,50. Neste caso específico, eles somam $3.697,20 — exatamente um item de linha a menos.
Esta é a assinatura de um erro pós-extração: cada célula parece correta isoladamente, mas as relações entre as células estão quebradas. A IA extraiu cada campo de forma independente — ela leu "Qtd: 12" e "Preço unitário: $47,25" e "Total da linha: $567,00" como fatos separados na página. Ela não calculou a relação entre eles. Isso não é uma falha da IA. É a natureza da extração semântica: o modelo lê o que está escrito, não o que logicamente deveria seguir.
O item de linha que não entrou no total estava na virada de página — linha 11 de 15, impressa no rodapé da página dois, com o restante da tabela continuando na página três. A IA leu corretamente os dados da linha 11. Leu corretamente as linhas 12 a 15. Mas quando a saída foi montada em uma planilha, a célula do subtotal tornou-se um valor estático extraído — não uma fórmula SOMA referenciando as linhas acima. A discrepância entre $3.847,50 (subtotal extraído) e $3.697,20 (soma real dos totais de linha) permaneceu na planilha por três semanas até que o funcionário de AP notou que o extrato do fornecedor mostrava um saldo diferente.
Por que isso acontece. Ferramentas de extração geram valores estáticos, não fórmulas. O campo de subtotal na fatura é um número que a IA lê, não um cálculo que ela executa. Se um item de linha for mal extraído — sem a vírgula decimal, duplicado ou omitido completamente — o valor do subtotal extraído da página não corresponderá ao que os itens de linha realmente somam. Mas nada no processo de extração sinaliza essa incompatibilidade. A ferramenta concluiu com sucesso. A saída parece normal. O erro existe apenas na lacuna entre o que os itens de linha somam e o que o campo de total indica — uma lacuna que nenhuma verificação automatizada preenche.
Como detectar. Após a extração, dedique uma passada de verificação ao fechamento aritmético: some todos os totais de linha e compare o resultado com o subtotal extraído. Faça o mesmo para impostos — multiplique o subtotal pela taxa de imposto declarada e compare com o valor de imposto extraído. Se os dois números diferirem além de uma tolerância de arredondamento, sinalize o documento. Esta é uma verificação de 10 segundos por fatura que captura a classe mais comum de erro pós-extração antes que ele entre no seu sistema de AP. A lista de verificação de QA para dados extraídos de documentos cobre esta etapa de verificação em detalhes, junto com o fluxo de trabalho completo de verificação.
Linhas Ausentes: Quando 15 Vira 14 e a Diferença é um Pagamento a Fornecedor
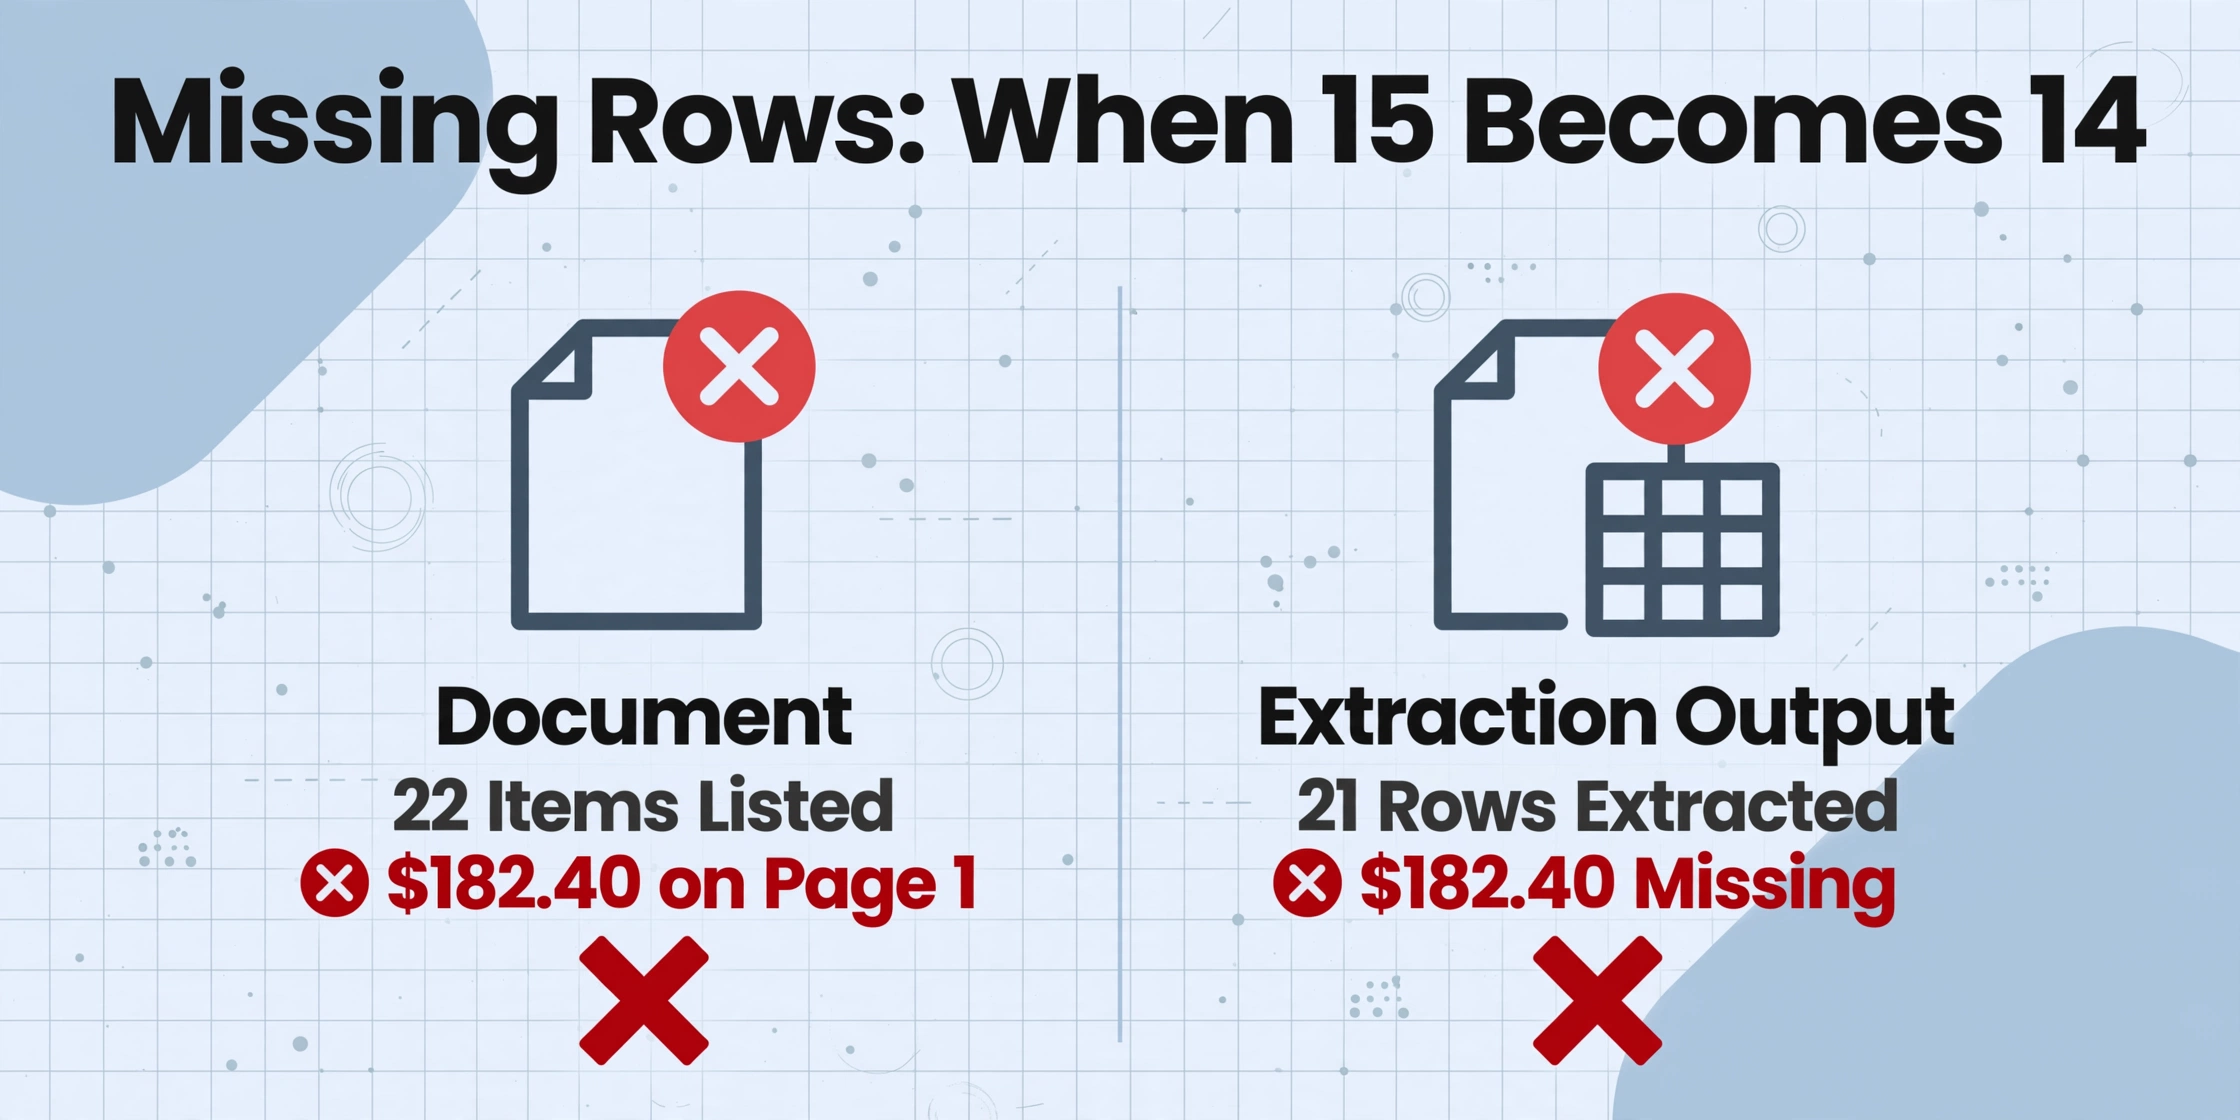
Uma fatura de materiais de construção lista 22 itens — madeira dimensional, concreto, vergalhão, fixadores — distribuídos em duas páginas. A IA extrai 21 linhas. A linha ausente é a última da página um, imediatamente abaixo de um cabeçalho de página que a análise de layout da IA identificou como um elemento estrutural, em vez de uma linha de dados. A linha existe no documento. O valor na linha é $182.40. O número da linha é 22. Mas a saída da extração mostra 21 linhas, e $182.40 simplesmente não aparece em nenhum lugar da planilha.
Em uma fatura de $4.200, $182.40 representa 4,3%. Não vai quebrar o fechamento do mês. Mas vai aparecer na reconciliação com o fornecedor seis semanas depois, quando três pessoas diferentes — o funcionário de AP, o gerente de compras e o contato de AR do fornecedor — gastarão juntos 45 minutos rastreando o problema. O custo de encontrar o erro supera o custo do erro em si.
Erros de linhas ausentes se concentram em três fronteiras estruturais: quebras de página em PDFs de múltiplas páginas, seções de tabela precedidas por linhas separadoras grossas ou regiões de cabeçalho em caixa, e páginas onde a última linha de uma tabela fica na margem inferior. Em cada caso, a compreensão de layout da IA trata a fronteira como um delimitador estrutural — fim da tabela, início de nova seção — em vez de reconhecer a linha adjacente como ainda pertencente à região de dados. A ironia é que a IA identifica corretamente a linha como contendo dados; ela apenas classifica esses dados como pertencentes a uma região diferente do documento, e o esquema de extração não captura isso porque o esquema define quais campos extrair, não quantas linhas devem existir.
O método de detecção é simples, mas raramente incorporado aos fluxos de extração: conte. Conte as linhas na saída. Compare com uma verificação visual rápida do documento de origem — ou, ao processar em escala, com uma faixa conhecida de contagem de linhas para o formato típico de fatura de cada fornecedor. Um fornecedor que sempre envia faturas de 12 linhas e de repente produz uma extração de 11 linhas é um sinal que vale investigar, mesmo que todos os valores extraídos pareçam corretos.
Mapeamento Incorreto de Colunas: Números de Nota Fiscal Onde Deveriam Estar as Datas das Notas Fiscais
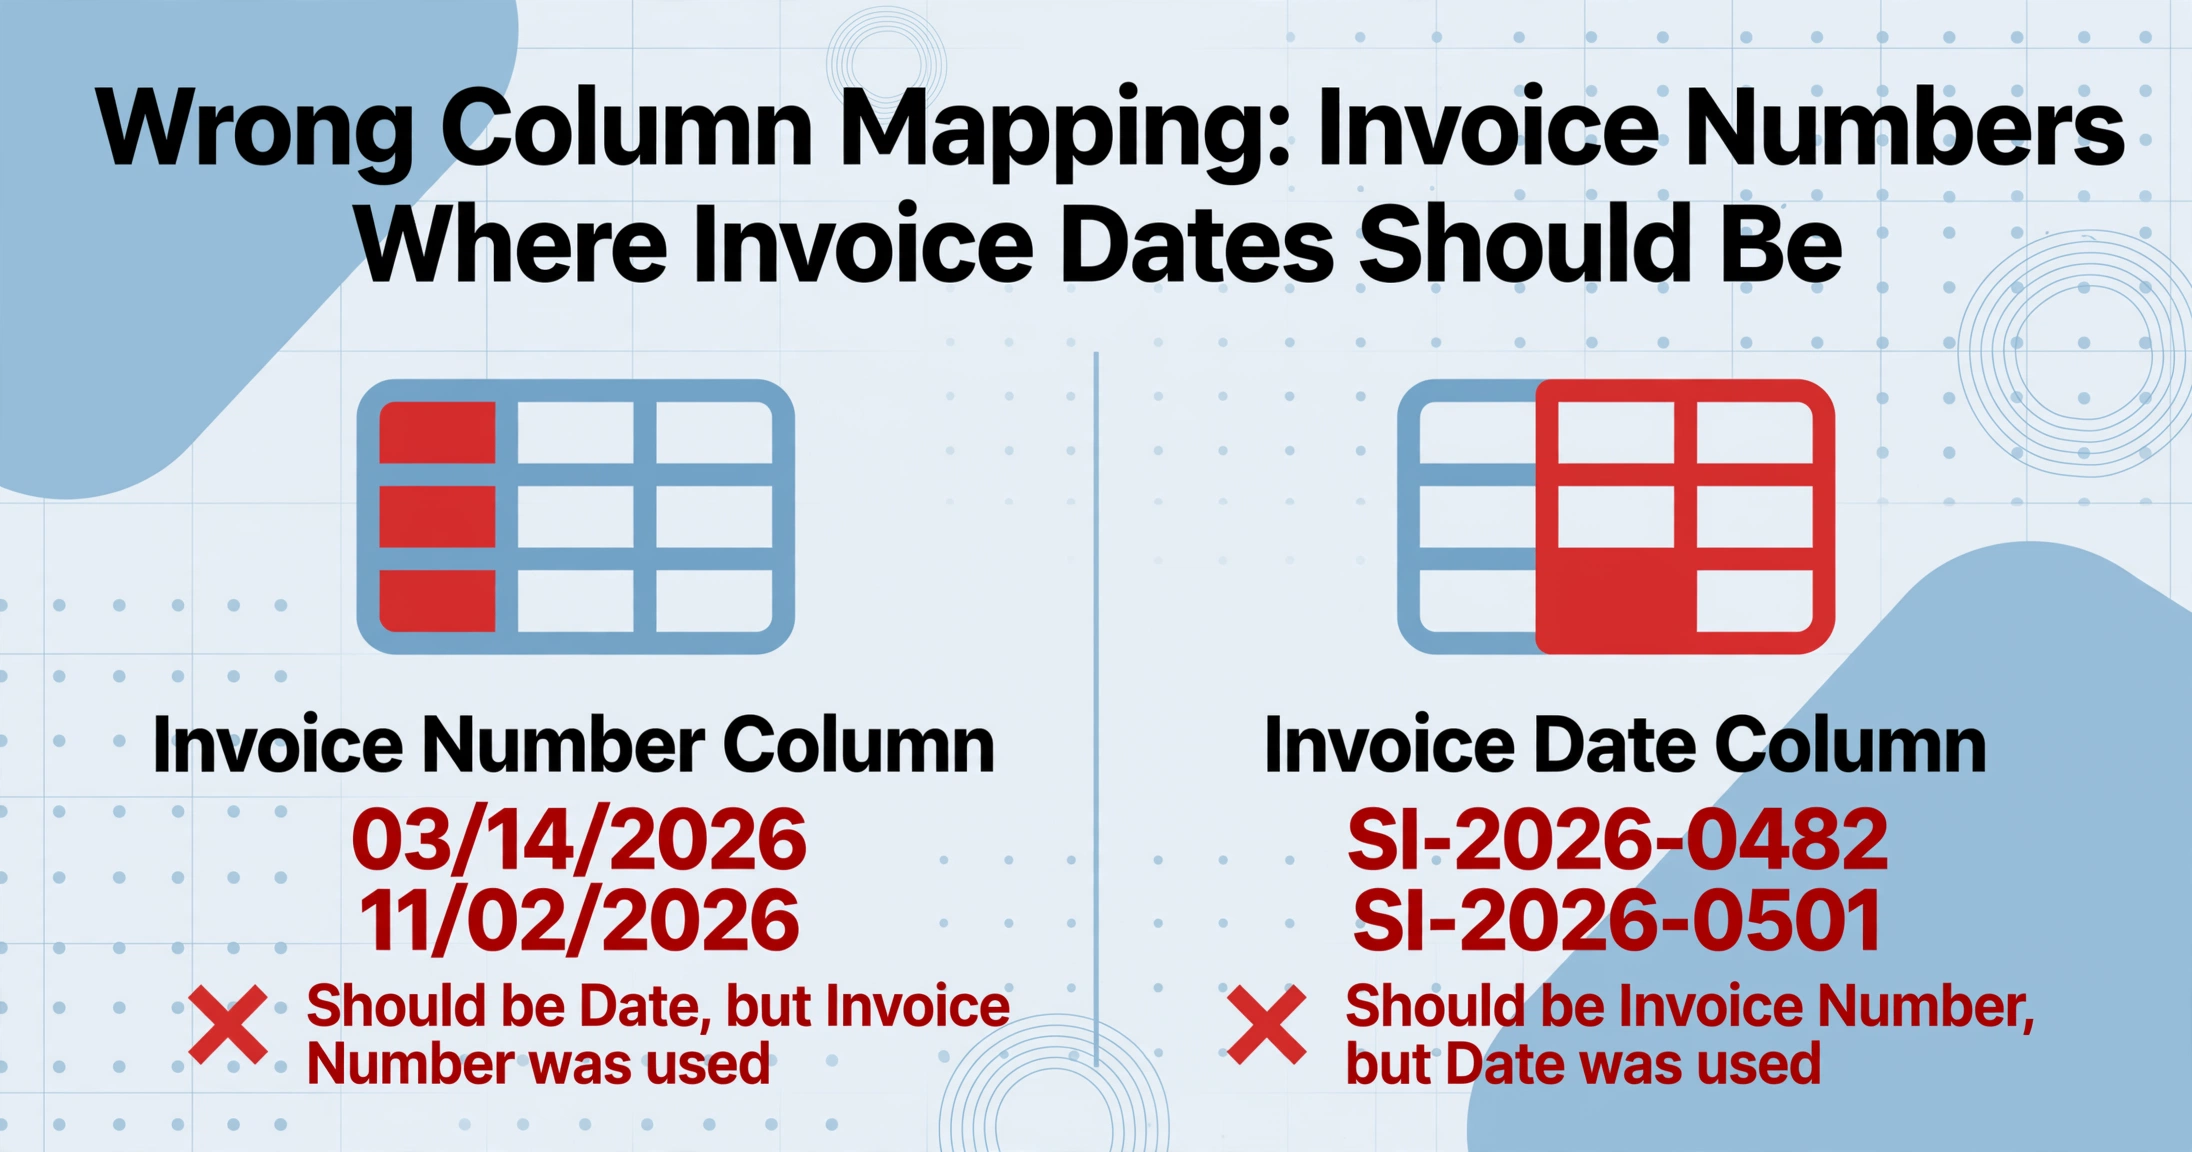
Um colega descreveu esse erro como "aquele que faz você duvidar dos próprios olhos." A coluna da planilha rotulada como "Número da Nota Fiscal" continha valores como "03/14/2026" e "11/02/2026." A coluna rotulada como "Data da Nota Fiscal" continha valores como "SI-2026-0482" e "SI-2026-0501." Cada célula tinha um valor formatado corretamente. Cada valor veio do documento correto. Eles estavam simplesmente nas colunas erradas — um erro de transposição no nível semântico.
Essa classe de erro é particularmente perigosa porque passa em todas as verificações de validação automatizadas. A coluna de número da nota fiscal contém strings. A coluna de data contém datas. Um validador de tipo de dados não vê nada errado. Um verificador de valores nulos não vê espaços em branco. Um validador de formato confirma que cada valor está em conformidade com o formato esperado da sua coluna. A planilha é importada para o ERP sem uma única mensagem de erro. O dano só aparece três semanas depois, quando a equipe de AP descobre que está conciliando pagamentos com datas em vez de números de nota fiscal.
Erros de mapeamento de colunas têm origem no esquema de extração. Se você define colunas como "Número da Nota Fiscal" e "Data da Nota Fiscal", a IA localiza ambos os valores no documento e os atribui às respectivas colunas. Na maioria das notas fiscais, isso funciona perfeitamente — os campos estão claramente rotulados e a correspondência semântica é inequívoca. Mas em documentos onde o número e a data da nota fiscal ficam adjacentes em um pequeno bloco de cabeçalho sem rótulos — comum em contas de serviços públicos, algumas notas fiscais emitidas pelo governo e extratos de pequenos fornecedores — a atribuição semântica da IA pode se transpor. O modelo vê dois valores em um agrupamento compacto, sabe que representam um identificador e uma data, mas não tem nenhum sinal explícito de layout sobre qual é qual. Em 1–3% dos casos em um corpus grande e variado de notas fiscais, ele erra.
Como detectar. Execute uma verificação de formato entre colunas após a extração. Uma coluna "Número da Nota Fiscal" onde mais de 5% dos valores correspondem a um padrão de data deve acionar um sinal de revisão. Da mesma forma, uma coluna "Data" contendo padrões alfanuméricos consistentes com convenções de numeração de notas fiscais merece uma segunda olhada. Esta não é uma verificação que você executa em cada linha — é uma verificação de sanidade em novas saídas em lote que leva 15 segundos e captura a classe de erro silenciosa que a validação automatizada foi projetada para não detectar.
Erros de Moeda e Decimais: A Vírgula que Custa Três Ordens de Grandeza
Formatos de fatura europeus e latino-americanos usam vírgulas como separadores decimais e pontos como separadores de milhares — o inverso das convenções dos EUA e do Reino Unido. Uma fatura de um fornecedor alemão mostra "1.250,00" — significando mil duzentos e cinquenta euros e zero centavos. Extraia isso como "$1.250,00" e você tem o valor correto. Extraia como "$1250,00" — perdendo o separador de milhares — e você ainda tem o valor numérico correto. Extraia como "$12,50" — interpretando mal a vírgula como decimal — e o valor extraído fica errado por duas ordens de grandeza.
O erro não é detectado pela validação de formato porque "$12,50" é um valor monetário perfeitamente válido. Não acionará uma verificação de faixa, a menos que alguém defina limites explícitos por fornecedor. Ele é importado sem problemas no ERP. E o dano real só aparece quando o fornecedor liga para perguntar por que recebeu $12,50 em uma fatura de €1.250,00.
O deslocamento do ponto decimal assume várias formas. A inversão europeia de vírgula e ponto — o caso mais famoso — responde por cerca de um terço dos erros numéricos pós-extração no processamento internacional de faturas. Outro terço vem da IA descartando um zero final: $1.250,00 vira $125,00 porque o modelo interpretou "1250" corretamente, mas colocou o decimal na posição errada. O terço restante inclui artefatos de OCR — uma mancha ou dobra que obscurece o ponto decimal, fazendo $1.250,00 ser lido como $125000 ou $12,5000, nenhum dos quais mapeia limpo para um formato de moeda padrão.
Como detectar. Para documentos com convenções de moeda conhecidas, adicione uma regra de validação de posição decimal: se o valor extraído diferir em mais de uma ordem de grandeza da faixa esperada para aquele fornecedor, sinalize. Para processamento em lote, compare a ordem de grandeza de cada valor com a distribuição histórica do fornecedor — uma única fatura de €1.250 de um fornecedor cujas últimas 50 faturas variam de €800 a €3.200 está ok. Uma fatura de €12,50 do mesmo fornecedor merece verificação antes de chegar ao lote de pagamento. O guia de precisão para extração de documentos aborda como métricas de precisão em nível de campo interagem com dados financeiros do mundo real — incluindo os modos de falha específicos que taxas de precisão genéricas ocultam.
Caos de Formato de Data: MM/DD Encontra DD/MM na Mesma Coluna
Um lote de 200 faturas é processado para o AP de fim de mês. A saída da extração mostra uma coluna "Data da Fatura" onde algumas linhas mostram "03/05/2026" e outras mostram "05/08/2026." O primeiro valor representa 5 de março de 2026 (de um fornecedor dos EUA). O segundo representa 8 de maio de 2026 (de um fornecedor do Reino Unido). Mas não há como saber qual é qual apenas pela planilha — ambos os formatos são datas válidas, ambos importam corretamente no ERP, e ambos parecem normais para um revisor que examina rapidamente. A IA extraiu as strings de data como apareciam em cada documento, sem aplicar normalização no lote.
Formatos de data mistos em uma única coluna são o equivalente, em qualidade de dados, a um relógio em contagem regressiva. A coluna classifica incorretamente — 03/05/2026 é classificado antes de 05/08/2026 em um sistema MM/DD/AAAA, mas depois dele em DD/MM/AAAA. Relatórios de aging criados a partir desses dados produzem resultados incorretos. Condições de pagamento calculadas a partir das datas das faturas mudam em dias ou semanas, dependendo de qual convenção a fórmula assume. E os erros surgem não de uma extração ruim, mas da ausência de uma etapa de normalização entre a extração e a importação no ERP — uma etapa tão simples que raramente é formalizada.
O pior cenário: uma coluna que mistura formatos de data dos EUA e de fora dos EUA de diferentes fornecedores, sem metadados sobre qual fonte segue qual convenção. A IA que lê um único documento não pode saber a localidade do fornecedor — ela só pode extrair a string como escrita. A normalização precisa acontecer como uma etapa consciente de pós-extração: identificar a convenção de data por fornecedor, converter todas as datas para o formato ISO (AAAA-MM-DD) e validar que nenhuma data fica fora de um intervalo razoável para aquele tipo de documento.
Como detectar. Após a extração, examine a coluna de datas em busca de valores onde o primeiro segmento excede 12 — estes são datas DD/MM (ou erros). Para valores ambíguos (ambos os segmentos ≤ 12), faça referência cruzada com a localidade conhecida do fornecedor ou os metadados de idioma do documento. Defina uma regra: toda data na saída deve estar em conformidade com um único formato declarado antes que o lote seja aprovado para importação no ERP. Isso não é um problema de IA. É um problema de fluxo de trabalho com uma solução determinística.
Linhas Duplicadas: Os Mesmos Dados, Extraídos Duas Vezes
Uma fatura de fornecedor de artigos para catering tem uma tabela de itens que abrange duas páginas. A quebra de página corta a linha 9 de 18. Na página um, a IA extrai as linhas 1 a 9. Na página dois, a análise de layout da IA encontra o que interpreta como uma nova tabela — mesma estrutura de colunas, mesmos rótulos de cabeçalho aparecendo no topo da continuação da página — e reextrai as linhas 9 a 18. A linha 9 agora aparece duas vezes na saída: uma vez da tabela da página um, uma vez da continuação da página dois.
A linha duplicada normalmente é descoberta durante a conciliação tripla — pedido de compra, recebimento de mercadorias e fatura — quando as quantidades somadas na fatura excedem as quantidades do pedido de compra exatamente pela quantidade da linha duplicada. Mas a descoberta exige que alguém realize a conciliação tripla. Em organizações onde o AP processa faturas sem reconciliação automatizada de pedidos de compra, a duplicata passa para o pagamento. Um item de linha de $340 pago duas vezes em uma fatura de $5.000 é um pagamento a mais de 6,8% que o fornecedor pode ou não creditar de volta.
Erros de linhas duplicadas são mecanicamente simples de detectar: gere um hash do conteúdo de cada linha e procure hashes idênticos dentro da saída do mesmo documento. Mas a maioria dos fluxos de extração não inclui uma verificação de deduplicação porque a premissa é que a extração por IA produz uma linha por linha de origem — uma premissa que se sustenta 98% das vezes e falha exatamente no cenário em que uma tabela cruza uma quebra de página. A correção é uma regra de deduplicação aplicada à saída, não uma mudança no modelo de extração.
Células Vazias Onde Existem Dados no Documento
Um EOB (Explicação de Benefícios) de seguro médico lista oito colunas de dados de sinistros por linha: data do serviço, código do procedimento, valor cobrado, valor permitido, valor pago pelo plano, responsabilidade do paciente, franquia aplicada e observações. Após a extração, a coluna "responsabilidade do paciente" mostra células vazias para quatro dos doze sinistros na página. A IA leu as outras sete colunas corretamente. Ela simplesmente não identificou um valor para responsabilidade do paciente — possivelmente porque o campo estava rotulado como "You Owe" neste formato específico de EOB, não "Patient Responsibility", e a correspondência semântica entre o rótulo no documento e o nome da coluna no esquema de extração era fraca demais.
Células vazias são as assassinas silenciosas da qualidade de dados pós-extração porque não parecem erros. Uma linha com oito colunas preenchidas e uma vazia parece normal — especialmente em uma coluna como "responsabilidade do paciente", onde valores zero são genuinamente comuns. Um revisor examinando a saída a uma velocidade de 2 segundos por linha vê "vazio" e assume "$0" — uma inferência razoável, mas errada. O valor real era $47,30. Não é muito. Mas em 42 sinistros em um lote, quatro células vazias de responsabilidade do paciente representam $189,20 de cobrança de paciente ausente que passa despercebida até o próximo ciclo de cobrança.
Como detectar. Após a extração, examine cada linha para verificar a presença de células vazias em colunas não opcionais. Defina quais colunas nunca devem ficar vazias para um determinado tipo de documento — totais de fatura, datas, IDs de fornecedor — e sinalize linhas onde essas colunas estão vazias. Para colunas que legitimamente contêm valores zero, exija que a IA produza um "N/A" ou "$0" explícito em vez de deixar a célula vazia, para que dados ausentes (vazio) sejam sempre distinguíveis de dados com valor zero ("$0"). Isso é uma disciplina de definição de campos, não uma melhoria de modelo. O guia para corrigir números extraídos incorretamente explica como a nomeação de colunas e a definição de campos determinam diretamente se a IA encontra um valor ou retorna nada.
Os sete tipos de erro acima compartilham um traço comum: todos envolvem um valor que parece correto isoladamente e passa em todas as verificações automatizadas de formato. Nenhum erro dispara um alerta. Nenhum erro interrompe o pipeline de extração. Nenhum erro é obviamente errado para um revisor que examina em velocidade operacional. Estas não são falhas de extração — são falhas de verificação. E o custo de não detectá-las aumenta com o tamanho do lote.
Por que Esses Erros se Acumulam Silenciosamente — e por que o Atraso Entre o Erro e a Descoberta É o Custo Real
Em um fluxo de trabalho tradicional de entrada manual de dados, a pessoa que digita a partir de uma fatura em papel em uma tela de ERP tem uma referência visual. Ela consegue ver que a coluna de total da linha não está sendo preenchida. Ela percebe quando a última linha de uma tabela é cortada por um rodapé de página. O ciclo de feedback é imediato — o erro surge no mesmo momento em que a entrada de dados acontece, porque o humano que executa a entrada também executa uma verificação contínua e inconsciente.
A extração automatizada quebra esse ciclo de feedback. A IA lê o documento, monta a saída e a envia ao ERP — tudo sem um olhar humano sobre o resultado intermediário. O ciclo de feedback encolhe de "instantâneo" para "na próxima conciliação". E a conciliação acontece semanal, mensal ou trimestralmente — uma janela durante a qual os erros se acumulam sem detecção.
Uma única linha ausente em uma única fatura é um problema de $200. Vinte linhas ausentes em vinte faturas em um mês é um problema de $4.000. Mas o custo de diagnosticar vinte linhas ausentes — rastreando cada uma até o documento de origem, identificando o fornecedor, confirmando o valor correto, emitindo um pagamento corrigido e atualizando o razão — excede em muito $4.000. O custo de mão de obra para encontrar erros pós-extração é tipicamente 3-5x o valor do próprio erro. É por isso que a estratégia de verificação mais eficaz não é "encontrar erros mais rápido" — é "capturar erros antes que entrem no sistema". Uma verificação de 30 segundos antes da importação que captura uma linha ausente transforma uma investigação de conciliação de 25 minutos em uma reextração de 2 minutos.
O relatório de métricas de AP da Ardent Partners 2025 descobriu que a organização média gasta $9,40 para processar uma única fatura de ponta a ponta, com 14% das faturas contendo uma exceção que exige intervenção manual. O relatório não separa "erro de extração" de "exceção de política" ou "problema de roteamento de aprovação", mas a sobreposição é grande: uma parcela significativa dessas intervenções manuais é acionada por dados que não chegaram corretamente ao ERP — a mesma classe de erros que este artigo descreve. Cada erro pós-extração que entra no ERP converte uma entrada em velocidade de máquina em uma exceção em velocidade humana, e o custo dessa exceção é pago em mão de obra, não em tecnologia.
O Hábito de Verificação: Cinco Verificações Que Levam 30 Segundos
Incluir uma etapa de verificação no seu fluxo de extração não exige uma plataforma de qualidade de dados nem uma equipe dedicada de validação. Cinco verificações mecânicas, aplicadas de forma consistente, capturam os sete tipos de erro descritos acima antes que cheguem ao seu ERP:
A principal percepção por trás dessas cinco verificações é que elas não exigem reler documentos ou comparar manualmente a saída com a fonte. São estatísticas e mecânicas — uma varredura de 30 segundos em um lote de qualquer tamanho — e capturam os erros que sobrevivem à revisão visual porque se escondem dentro de dados que parecem corretos ao olho humano.
Para um tratamento mais aprofundado do fluxo de verificação — incluindo como estruturar um processo recorrente de QA, qual tamanho de amostra usar para verificações pontuais e como integrar a verificação ao fluxo de trabalho da equipe em vez de tratá-la como uma etapa individual — a lista de verificação de QA para verificar dados extraídos por IA fornece uma estrutura operacional completa. Essas cinco verificações são o ponto de partida. A lista de verificação de QA é o processo contínuo.
A conversa sobre precisão de extração tem uma dimensão importante que a maioria dos benchmarks não captura, que a comparação prática de precisão para ferramentas de extração de documentos explora em detalhes: a precisão de campos e as taxas de processamento direto contam histórias fundamentalmente diferentes sobre a mesma ferramenta, e entender a diferença entre elas é essencial para construir um fluxo de verificação que proteja contra os erros certos.
FAQ
Não posso simplesmente usar fórmulas do Excel para detectar esses erros?
Pode — e muitas equipes fazem isso. Uma fórmula SUM que compara os totais das linhas extraídas com o subtotal extraído detectará erros de fechamento aritmético. Uma fórmula COUNT detectará linhas ausentes se você souber a contagem esperada. Uma regra de formatação condicional que destaca células com padrões de data em colunas que não são de data revelará problemas de mapeamento de colunas. O problema é que essas fórmulas precisam ser reconstruídas para cada layout de lote e dependem de alguém lembrar de aplicá-las. O hábito de verificação não se trata de ter a capacidade — trata-se de torná-la parte do fluxo de trabalho padrão para que não dependa da diligência de uma pessoa em uma terça-feira corrida.
Com que frequência esses erros realmente acontecem?
As taxas de erro em nível de campo variam conforme o tipo e a qualidade do documento. Em faturas comerciais limpas e com formato padrão, a extração moderna por IA alcança 98–99% de precisão por campo — ou seja, 1–2 campos errados a cada 100. Em conjuntos de documentos heterogêneos, com formatos mistos, manuscritos e qualidade de digitalização variável, a precisão por campo cai para 90–95%. O ponto-chave é que, mesmo com 99% de precisão por campo em uma fatura de 15 campos, cerca de 14% das faturas contêm pelo menos um erro. Em 500 faturas por mês, isso representa aproximadamente 70 faturas com pelo menos um erro. A taxa de erro é baixa. O número de erros, em escala, não é.
O ERP não detecta isso ao validar a importação?
A validação do ERP verifica o formato e a completude dos dados — garante que campos de data contenham datas, campos numéricos contenham números e campos obrigatórios estejam preenchidos. Ela não verifica o fechamento aritmético (os totais das linhas somam o subtotal?), a consistência entre colunas (a coluna de número da fatura está realmente cheia de datas?) ou a completude das linhas (deveria haver 15 linhas aqui em vez de 14?). A validação do ERP detecta erros de sintaxe. Os erros pós-extração são erros semânticos. Eles passam nas verificações de sintaxe todas as vezes.
Devo verificar todos os documentos ou usar amostragem?
Para as cinco verificações mecânicas — fechamento aritmético, sanidade da contagem de linhas, formato entre colunas, faixa de magnitude e varredura de nulos — verifique todos os documentos. Essas verificações são automatizáveis e rápidas; não há motivo para amostragem. Para a verificação visual — comparar a saída extraída com a imagem do documento de origem — faça amostragem de 5–10% dos documentos por lote, estratificada por fornecedor e complexidade do documento. Reserve a verificação visual de 100% para o primeiro lote de um novo fornecedor ou de um novo formato de documento. Depois de confirmar que o padrão de extração está estável para aquela fonte, reduza para amostragem.
E quanto à caligrafia? Os padrões de erro são diferentes?
Sim — a caligrafia introduz um perfil de erro diferente. A confusão de caracteres (1 vs 7, 0 vs 6, S vs 5) é mais comum, especialmente em números. Linhas ausentes acontecem com mais frequência porque tabelas manuscritas têm espaçamento e alinhamento de linhas menos consistentes, o que confunde a análise de layout. Erros de mapeamento de colunas são mais raros porque formulários manuscritos tendem a ter menos campos e rótulos mais claros. As verificações descritas aqui ainda se aplicam, mas espere mais erros em nível de caractere em documentos manuscritos — o fechamento aritmético e a verificação de faixa de magnitude tornam-se especialmente importantes como salvaguardas.
A ferramenta de extração pode fazer essas verificações automaticamente?
Algumas ferramentas oferecem coluna calculada ou regras de validação que podem realizar o fechamento aritmético e verificações entre colunas durante a extração. O recurso Computed Columns do ImageToTable.ai — que permite definir cálculos como "somar todos os totais de linha e comparar com o subtotal extraído" diretamente no seu esquema de extração — realiza validação aritmética no momento da extração, então a saída chega pré-verificada. Mas mesmo que sua ferramenta não ofereça isso, as cinco verificações descritas acima são operações de planilha que levam 30 segundos por lote. O hábito de verificação não depende dos recursos da ferramenta — depende de tornar as verificações parte do fluxo de trabalho.
Erros pós-extração não são uma falha da IA. São uma lacuna no processo entre extração e ERP — uma lacuna que existe porque as ferramentas de extração são projetadas para produzir dados, não para auditá-los. Os sete erros descritos aqui compartilham uma única causa raiz: eles passam em todas as verificações automatizadas porque as verificações estão checando as coisas erradas. A validação de formato detecta formato ruim. A validação aritmética detecta matemática errada. A lacuna está entre elas — e fechá-la custa 30 segundos por lote, não uma nova ferramenta ou uma equipe maior.
Se você processa dados de documentos e quer construir verificação diretamente no seu fluxo de extração, o ImageToTable.ai executa um pipeline de extração centrado em verificação — a ferramenta extrai por semântica de campos, não por coordenadas de modelo, e suporta colunas calculadas que reconciliam totais de linhas, verificam a aritmética de impostos e sinalizam anomalias de faixa de magnitude durante a extração, em vez de depois. O fluxo completo de verificação de QA cobre como operacionalizar as cinco verificações acima em um processo de equipe sustentável.
Envie seus próprios documentos — veja o que é extraído e execute as cinco verificações para validar a saída.
Teste em Seus Próprios Documentos