O fluxo de trabalho de IA para faturas que você criou
é mais lento do que digitar
Um pipeline de faturas que funciona e um pipeline de faturas que economiza tempo são duas coisas diferentes. O primeiro pode ser montado em uma tarde com n8n, Make ou Zapier: monitorar uma caixa de entrada, enviar cada anexo por um modelo de OCR, entregar o texto a um LLM e gravar uma linha em uma planilha. O segundo precisa sobreviver aos documentos que nunca apareceram na demonstração.
Essa lacuna é estrutural, não uma questão de habilidade de engenharia. Benchmarks colocam a taxa de exceção de faturas em 18,4% (State of ePayables 2025 da Ardent Partners). Quase uma em cada cinco faturas recusa o caminho em torno do qual um fluxo de trabalho foi desenhado. Um pipeline construído para o caminho limpo gasta suas horas reais nesse quinto, e essas horas saem direto do seu dia.
Principais conclusões
- Seu pipeline funciona na demonstração e fica mais lento em um mês real, e a lacuna é estrutural, não uma falha na forma como você o construiu.
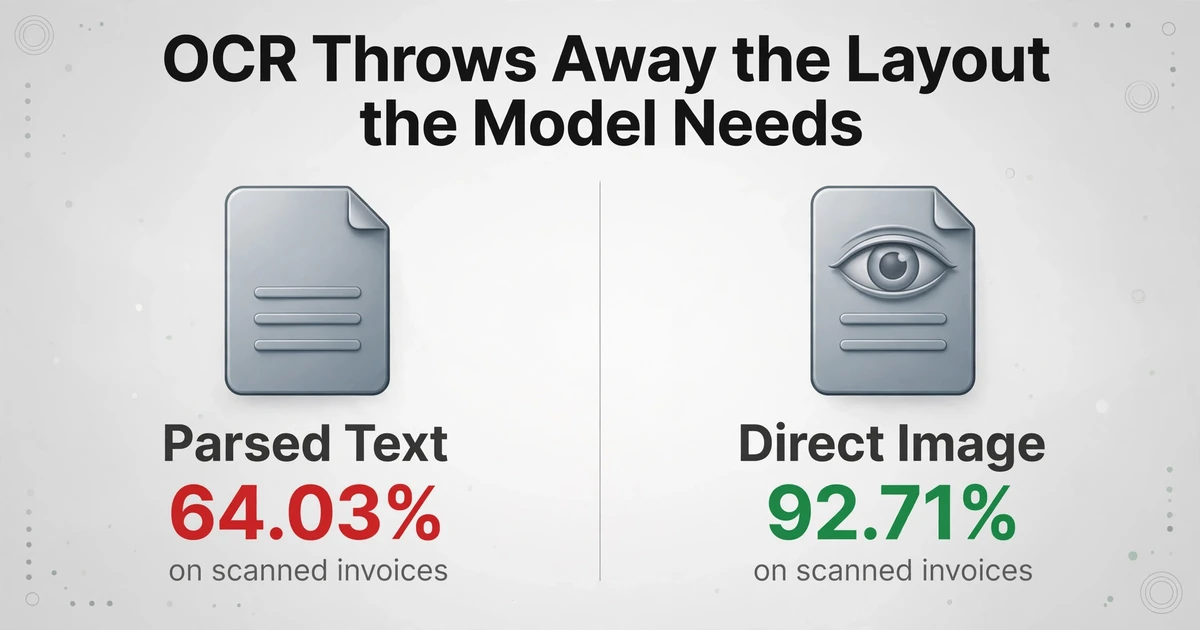
- 92,71% para leituras diretas de imagem em faturas digitalizadas contra 64,03% para a rota de OCR para texto, porque achatar a página destrói o layout que o modelo precisa.
- Faça cada valor extraído apontar de volta para a região da página de onde veio, para que a revisão custe segundos por campo e o julgamento permaneça com você.
O Pipeline Funciona no Primeiro Dia e Custa Seu Tempo na Sexta Semana
Um fluxo de trabalho de fatura DIY inverte a tendência usual. Softwares normalmente se tornam mais úteis conforme você os usa. Este tipo fica mais lento, porque cada novo fornecedor adiciona um formato que a etapa de leitura nunca viu, e o fluxo de trabalho não tem como perceber que agora está apenas adivinhando.
A inversão é fácil de explicar e difícil de sentir antecipadamente. O n8n torna a parte da conexão genuinamente simples, então a primeira execução bem-sucedida parece uma prova de que a parte difícil está feita. O gatilho e o anexo na planilha foram as partes fáceis. As partes difíceis são compreensão de documentos e saber o que fazer quando a compreensão falha. A versão conectada do pipeline responde silenciosamente "nada" a ambas, e é por isso que uma comunidade de construtores continua chegando ao mesmo lugar. A correção que eles recebem é sempre a mesma: OCR imperfeito, sem tratamento de erros, e o lembrete de que a área financeira precisa ser efetivamente perfeita.
O detalhe que pega as pessoas é que uma extração com falha raramente parece uma falha. Um construtor descreveu isso com precisão em um tópico sobre bot de fatura: "no momento em que um cliente escaneia algo no celular a 150dpi, ou pior, uma digitalização de fax, a precisão cai rápido e você não vê isso chegando porque as pontuações de confiança ainda parecem boas." O pipeline relata sucesso. Os números estão errados. Ninguém percebe até a conciliação.
Orquestração é um problema resolvido e barato. Precisão de extração e tratamento de exceções não são, e uma ferramenta de fluxo de trabalho só vende a primeira.
O que o pipeline DIY realmente faz
Quase todo fluxo de trabalho de faturas construído por conta própria é a mesma máquina de três etapas. Nomear as etapas deixa claro onde o tempo é gasto e por quê.
Recebimento e orquestração
Um gatilho monitora uma pasta do Gmail ou Outlook, um drive compartilhado ou um formulário, e roteia cada arquivo. n8n, Make e Zapier são excelentes aqui. Esta camada é confiável porque move bytes; ela não os lê.
Leitura da página
Um OCR ou parser de documentos transforma a imagem em texto. Opções comuns são Tesseract.js, Mistral OCR, LlamaParse, Mindee, AWS Textract ou ABBYY. A saída é um fluxo de texto, às vezes com coordenadas, às vezes em markdown.
Estruturação do texto
Um LLM é instruído a retornar JSON, geralmente com campos como fornecedor, número da fatura, data, totais e itens de linha. Os valores são mapeados para colunas e anexados a uma planilha ou enviados para Xero, QuickBooks ou Sage.
Cada etapa é individualmente razoável. O problema está nas emendas. A etapa dois é perda de dados, e a etapa três confia que a etapa um capturou as exceções que ela nunca verificou. O guia completo para extração de dados de faturas cobre os tipos de campos e formatos em detalhes; a questão aqui é por que essa cadeia específica quebra onde quebra.
A Primeira Barreira: o OCR Descarta o Layout que o Modelo Precisa
O OCR converte uma página de marcas posicionadas em um fluxo plano de palavras, e essa conversão é perda de informação exatamente onde as faturas mais importam. Um item de linha de fatura não é uma sequência de palavras. É uma relação entre uma descrição, uma quantidade, um preço unitário e um valor que fica na mesma linha e se alinha sob a mesma coluna. Ao achatar a página, a relação vira adivinhação: layouts de várias colunas concatenam textos não relacionados, tabelas viram sequências de números e cabeçalhos se desprendem das linhas que rotulam.
Isso não é uma pequena penalidade que você pode contornar com prompts. Um benchmark de 2025 comparou o envio direto de imagens de faturas a um modelo de visão com a abordagem de primeiro analisar o documento em texto e depois entregar esse texto a um LLM. Em faturas escaneadas, o processamento direto de imagem atingiu 92,71% de precisão, enquanto a rota de texto analisado chegou no máximo a 64,03%. Em faturas limpas, a etapa de análise comprimiu todos os modelos em uma faixa de 84% a 85%, um forte sinal de que a conversão por OCR e markdown, e não o modelo de linguagem, havia se tornado o gargalo. O mesmo estudo descobriu que campos alfanuméricos como IBANs foram os mais afetados, com o OCR confundindo rotineiramente um zero com a letra O.
Os desenvolvedores descobrem isso empiricamente antes de conseguir nomear o problema. As falhas que não conseguem corrigir com regex são sempre as mesmas: Total vs Subtotal, Fornecedor vs Cobrança, número da fatura dividido entre linhas. Cada uma delas é um problema de layout disfarçado de problema de texto, e quanto mais esforço é dedicado a corrigi-las com regex, mais claro fica que a etapa de transcrição é o lugar errado para resolvê-las.
Se o layout é descartado antes de o modelo ver a página, nenhum prompt o recupera. Você está pedindo a um LLM para reconstruir uma tabela a partir de uma única coluna de palavras.
Para ver como as duas famílias de ferramentas abordam os mesmos documentos confusos, a comparação entre OCR tradicional e extração por IA executa as mesmas faturas em ambas. A versão resumida: a abordagem mais nova vence ao ler a imagem da página em vez de uma transcrição dela.
A Segunda Ruptura: Faturas Longas Falham Silenciosamente no Meio
Quando uma fatura longa entra em um único prompt, o modelo presta atenção ao início e ao final e passa rapidamente pelo que está no meio. Esta é uma propriedade medida dos modelos de linguagem de contexto longo, documentada em Lost in the Middle: How Language Models Use Long Contexts. Aplicada a uma fatura de várias páginas, a falha tem uma forma reconhecível: o cabeçalho na primeira página é extraído corretamente, o total na última página é extraído corretamente, e uma parte dos itens de linha nas páginas do meio desaparece.
Desaparecer é o caso melhor. O peor é o inventado. Um modelo que perde o rastro do que realmente viu pode preencher uma lacuna com algo plausível: uma quantidade para um campo vazio, um item de linha para um salto de numeración, um ID fiscal de aspecto realista que não aparece em nenhum lugar da página. Os fluxos de trabalho financeiros tratam estes como os erros mais perigosos precisamente porque passam todas as verificações posteriores que apenas perguntam "há um valor aqui?".
A confianza auto-reportada não resgata isto, que é a parte que os pipelines DIY mais frequentemente erram. Um modelo pode estar confiadamente errado na mesma direção todas as vezes, por isso uma puntuación baseada na sua própria certeza permanece verde enquanto o valor é mau. A distinción que importa é a precisión a nível de campo nos seus documentos em lugar de uma percentaxe headline, que o guía práctico para a precisión da extracción de faturas trata em detalhe. O problema central é a falha silenciosa: uma cela em branco parece exatamente como um campo que estava legitimamente vazio.
A consequência prática já é visível nas equipas financeiras que adotaron a extracción sem resolver a verificación. O resultado é predecible: as capas de validación são acrescentadas porque o modelo continua a perder os termos de pagamento ou a misturar os itens de linha em faturas de várias páginas, e alguém acaba ainda a supervisar cada extracción. Isto é extracción a funcionar e confianza a falhar. O desglose de erros de datos post-extracción cataloga os erros específicos que sobreviven a um primeiro olhar.
Um número errado que se lee limpiamente é mais perigoso que um em branco, porque só o em branco se anuncia a si mesmo.
A Terceira Ruptura: Não Existe Caminho para a Fatura que Não se Encaixa
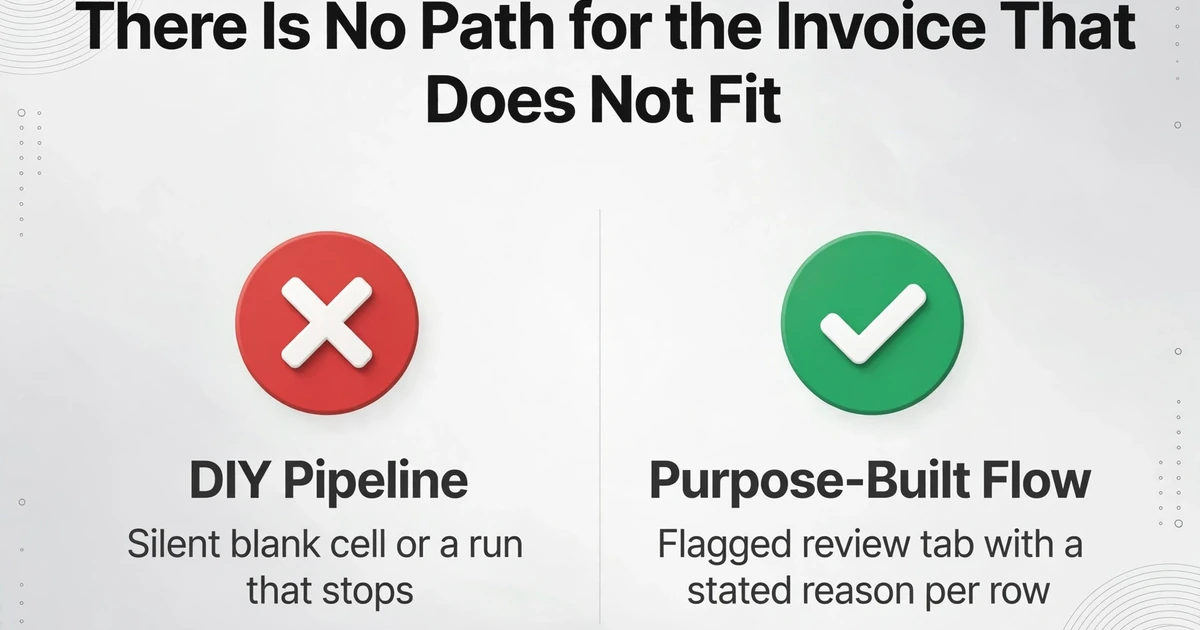
Em um pipeline construído internamente, todo problema se torna uma de duas coisas: uma célula em branco silenciosa ou uma execução que para. Nenhuma das duas é um fluxo de exceção. E as exceções são onde o trabalho realmente está. Com cerca de 18,4% das faturas falhando no processamento direto, o valor de qualquer sistema de AP é decidido por quão bem ele lida com o quinto que se comporta mal, não com os quatro quintos que passam sem problemas.
A maioria das construções DIY tenta corrigir isso com um limite: se a confiança do OCR estiver abaixo de algum número, encaminhe o arquivo para uma fila de revisão. Parece certo e na maioria das vezes não funciona, por um motivo abordado acima. O sinal de confiança não é confiável, então a fila ou fica vazia enquanto linhas ruins passam, ou se enche de tudo e se torna uma segunda caixa de entrada. De qualquer forma, o humano acaba re verificando o trabalho que a automação afirmou ter concluído.
As pessoas que convivem com isso descrevem o mesmo ciclo. Carregar as faturas, verificar se tudo está correto, preencher os dados ausentes, corrigir os erros, aprovar e depois corrigir os problemas de mapeamento entre os sistemas. O trabalho não diminui; ele muda de forma.
Esse é o custo real, e explica por que a entrada manual pode vencer. Se o fluxo de trabalho não consegue dizer quais linhas ele errou, sua única opção segura é verificar cada linha, e verificar cada linha leva quase o mesmo tempo que digitá-las em primeiro lugar. O motivo pelo qual as equipes de AP ainda digitam faturas manualmente muitas vezes não é teimosia. É que um fluxo de trabalho que não consegue sinalizar seus próprios erros moveu o trabalho em vez de removê-lo.
Se o pipeline não consegue dizer quais linhas ele errou, verificar cada linha é racional. E essa verificação é a entrada manual que você tentava eliminar.
O que um Fluxo de Extração Especializado Faz de Diferente
Uma melhor instrução ou um terceiro motor de OCR acoplado à cadeia não vai resolver isso. A resposta duradoura é remover o intermediário com perda de dados e tornar a verificação parte da extração, em vez de uma etapa manual posterior. Três capacidades correspondem diretamente às três falhas.
A primeira é a Extração de Colunas Personalizadas. Em vez de transcrever a página para texto e torcer para que o layout sobreviva, o modelo de visão lê a imagem da página diretamente. Você digita os nomes das colunas que deseja, como Fornecedor, Número da Fatura, Data da Fatura, Descrição da Linha, Quantidade, Total da Linha, Imposto e Valor Devido, e a IA localiza cada valor entendendo o que ele significa, em vez de onde ele está. Os nomes que você digita se tornam os cabeçalhos da sua planilha de saída. Essa é a diferença arquitetônica por trás do resultado de 92,71% versus 64,03%: o modelo mantém a relação bidimensional entre uma descrição e sua linha, então "Total vs. Subtotal" e "número da fatura dividido entre linhas" deixam de ser problemas de regex. Se você ainda está avaliando se vale a pena a mudança, o guia sobre quando migrar de OCR para extração com IA apresenta a compensação.
A segunda é o Modo de revisão com verificação Bbox, e ele ataca diretamente a falha silenciosa. Na tela de revisão, passe o mouse ou clique em qualquer célula extraída e a região de onde ela veio é destacada no documento original. O vínculo funciona nos dois sentidos: clicar em uma região volta para a célula, e um valor editado pode ser revertido para a leitura original da IA. Isso não promete que todo valor está correto. Isso transforma um valor incorreto invisível em algo verificável, que é o que a reclamação de "supervisionar cada extração" realmente precisa: revisão medida em segundos por campo, em vez de redigitar uma fatura inteira.
A terceira é o nível de modelo. Caligrafia densa, layouts complexos e digitalizações difíceis são exatamente onde um leitor padrão degrada, então as contas podem operar nos níveis Standard, Advanced ou Premium, com níveis mais altos usando um modelo de visão subjacente mais forte. O nível Standard cobre a maioria dos documentos tabulares impressos, e um lote é cobrado e reembolsado de acordo com o nível ativo no momento do envio. Isso é importante para o caso da digitalização por celular a 150dpi: a solução é um leitor mais forte para documentos difíceis, não uma segunda pilha de OCR sobreposta.
Duas peças de suporte impedem que o restante da cadeia reintroduza trabalho manual. O processamento em lote executa muitos arquivos de uma vez e os mescla em uma única saída do Excel, então um mês de faturas vira uma planilha em vez de um arquivo por vez. E a Caixa de entrada de e-mail dá a cada conta um endereço dedicado: encaminhe ou direcione faturas para ele, ative o processamento automático com um modelo vinculado, e os anexos chegam à fila sozinhos, com uma lista de remetentes permitidos para manter e-mails não relacionados fora. Se você preferir chamar a extração do seu próprio código em vez de executá-la no navegador, a API v1 existe para isso, enquanto o caminho web ainda atende quem quer começar com uma pasta. Para ver o fluxo de extração para um caso de uso de AP de ponta a ponta, o fluxo de trabalho de automação de contas a pagar o percorre. Para equipes que comparam a extração especializada com as alternativas, a comparação de ferramentas de extração de faturas para equipes financeiras as organiza por arquitetura, em vez de lista de recursos.
Os arquivos são processados com segurança e não são armazenados.
Se Você Mantiver o Pipeline, Quatro Verificações São Inegociáveis
Muitas equipes manterão sua construção no n8n, e essa pode ser a decisão certa para uma carga de trabalho restrita e com poucas exceções. Se você fizer isso, a durabilidade vem de quatro acréscimos, nenhum dos quais diz respeito à camada de orquestração.
Leia a imagem, não apenas o texto do OCR. Mantenha a página original no fluxo e execute pelo menos os campos difíceis por um modelo de visão, para que um valor nunca seja confiado apenas a uma transcrição achatada. Valide a aritmética que a própria nota fiscal implica. Some os itens de linha e compare com o subtotal; adicione os impostos e compare com o total; sinalize as divergências em vez de registrá-las. Notas fiscais são documentos autoverificáveis, e essas regras capturam uma grande parcela dos erros silenciosos. Fundamente cada valor em sua origem. Armazene a página e a região de onde um número veio, para que um revisor possa confirmá-lo ou rejeitá-lo com um clique, em vez de reabrir o PDF. Torne o caminho de exceção uma saída real. Uma aba de revisão sinalizada com um motivo declarado por linha vale mais do que um limite de confiança, porque o motivo diz a uma pessoa onde olhar.
Essas são as mesmas propriedades que uma ferramenta criada para esse fim oferece por padrão. Se você já construiu as três primeiras, a pergunta honesta é se mantê-las é mais barato do que não possuir essa manutenção, o que é uma questão sobre sua equipe, e não sobre o software.
O que um fluxo criado para esse fim ainda não faz
Ele extrai; não orquestra. O ImageToTable.ai não executará seu fluxo de trabalho no n8n, Make ou Zapier, nem publicará dados no seu ERP. Ele produz dados estruturados a partir de um documento, e a integração com outros sistemas permanece onde deve estar. A API v1 está disponível se você quiser chamar a extração de dentro do seu próprio pipeline, mas a ferramenta não é um mecanismo de fluxo de trabalho e não finge ser um.
Ele não compara documentos entre si. Ele não decidirá que esta fatura pertence a um pedido de compra específico, nem fará uma comparação campo a campo entre dois documentos para declará-los correspondentes. A conciliação tripla é uma etapa separada que uma busca em planilha ou o seu ERP deve assumir. O que a ferramenta oferece são dados limpos e organizados em colunas que tornam essa conciliação possível.
A precisão é alta, não perfeita. Até 99% de reconhecimento em dados tabulares impressos é o nosso próprio número para um tipo específico de entrada, não uma garantia para um scan ruim ou caligrafia densa, e é exatamente por isso que o Modo de revisão com verificação Bbox existe. Em campos com peso financeiro, como valores, impostos e números de conta, a etapa de verificação não é opcional.
Um humano ainda é responsável pelo julgamento e pelas exceções. A ferramenta elimina a transcrição e a busca pela origem de um número. Ela não decide se uma variação de preço deve ser contestada, se uma duplicidade é genuína ou se uma fatura deve ser paga antecipadamente. Isso permanece com a equipe de AP, que é a divisão pretendida: o julgamento mantém seu lugar, e a digitação rotineira deixa de consumir a semana.
Perguntas Frequentes
O n8n é o motivo pelo qual meu pipeline não é confiável?
Não. O n8n, o Make e o Zapier fazem orquestração bem, e essa é uma função diferente de ler um documento. As partes não confiáveis são a conversão de OCR para texto, que perde o layout, e a ausência de um caminho de exceção ao redor dela. Você pode reconstruir o mesmo fluxo de trabalho em qualquer ferramenta e levar os dois problemas com você.
Posso corrigir isso adicionando um modelo de OCR melhor ou uma segunda passada de LLM?
Ajuda marginalmente, mas não muda a arquitetura. Uma segunda passada ainda parte de uma transcrição que já perdeu o layout, então você está empilando custo e latência sobre uma etapa com perdas. O maior gancio vem de deixar que um modelo de visão leia a imagem da página, o que elimina a etapa com perdas em vez de adicionar outro lector atrás dela.
ImageToTable.ai substituye meu fluxo de trabalho n8n?
Não. Ele substituye as capas de extração e verificação, não a orquestração. Se você quiser chamar a extração de dentro do seu pipeline existente, a API v1 suporta isso. Se você preferir não manter um pipeline, pode usar o upload web e o fluxo em lote, ou apuntar faturas a uma Caixa de entrada de e-mail e deixar que elas se enfileirem automaticamente.
Como posso confiar na saída se não posso verificar cada linha?
Você verifica as linhas que têm peso financeiro. O Modo de revisão com verificação Bbox permite que você passe o mouse sobre uma célula e veja sua região de origem no original em uma única etapa, então a verificação é rápida o suficiente para ser feita seletivamente em vez de exaustivamente. Combine isso com os checks aritméticos acima, já que uma discrepância entre itens de linha e total é um forte indicador de que um valor merece uma olhada mais de perto.
E sobre faturas que têm muitas páginas?
Documentos mais longos e densos são onde um nível de modelo superior justifica seu custo, porque o modelo de visão mais forte retiene detalhes que um lector padrão perde. Separadamente, se um único documento lógico é enviado como várias páginas ou imagens, mesclagem de várias páginas pode dobrar essas peças de volta em uma única linha. Ler uma fatura longa e remontar uma dividida são dois problemas diferentes, e a ferramenta os aborda com duas configurações diferentes.
Vale a pena cambiar se já construí o pipeline?
Depende de onde vai seu tempo. Se a maior parte do seu volume são faturas limpas, digitais, de uma página e as excepciones são raras, fortalecer o que você já tem é razoable. Se uma parte significativa de cada semana é gasta verificando linhas que o fluxo de trabalho não pudo garantir, a capa de extração e verificação é por onde esse tempo está vazando, e é a parte que vale a pena substituir primeiro.
O pipeline não quebrou porque você o construiu
O fluxo de trabalho de faturas construído por conta própria falha por um motivo nada glamouroso. Ele removeu uma etapa humana sem substituir a função que essa etapa desempenhava, que era capturar os documentos que não se encaixavam no padrão. Digitar sempre fazia três coisas ao mesmo tempo: ler, notar e corrigir. Remova a digitação e a ação de notar precisa ser reconstruída em algum lugar, ou ela recai sobre a pessoa, uma célula errada silenciosa de cada vez. Um fluxo de extração criado para um propósito específico não promete o fim da revisão. Ele torna a revisão barata o suficiente para ser mantida, e mantém o layout, a localização da fonte e a aritmética em vista, para que a verificação leve segundos em vez de uma redigitação.