El flujo de trabajo de facturas con IA que creó
es más lento que escribir
Una canalización de facturas que funciona y una canalización de facturas que ahorra tiempo son dos cosas distintas. La primera se puede armar en una tarde con n8n, Make o Zapier: vigilar una bandeja de entrada, enviar cada archivo adjunto a un modelo de OCR, entregar el texto a un LLM y escribir una fila en una hoja de cálculo. La segunda tiene que sobrevivir a los documentos que nunca aparecieron en la demostración.
Esa brecha es estructural, no una cuestión de habilidad técnica. Los puntos de referencia sitúan la tasa de excepciones de facturas en el 18,4% (State of ePayables 2025 de Ardent Partners). Casi una de cada cinco facturas se niega a seguir el camino en torno al cual se diseñó un flujo de trabajo. Una canalización construida para el camino limpio gasta sus horas reales en ese quinto, y esas horas salen directamente de su día.
Conclusiones clave
- Su canalización funciona en la demostración y se ralentiza en un mes real, y la brecha es estructural, no un defecto en la forma en que la construyó.
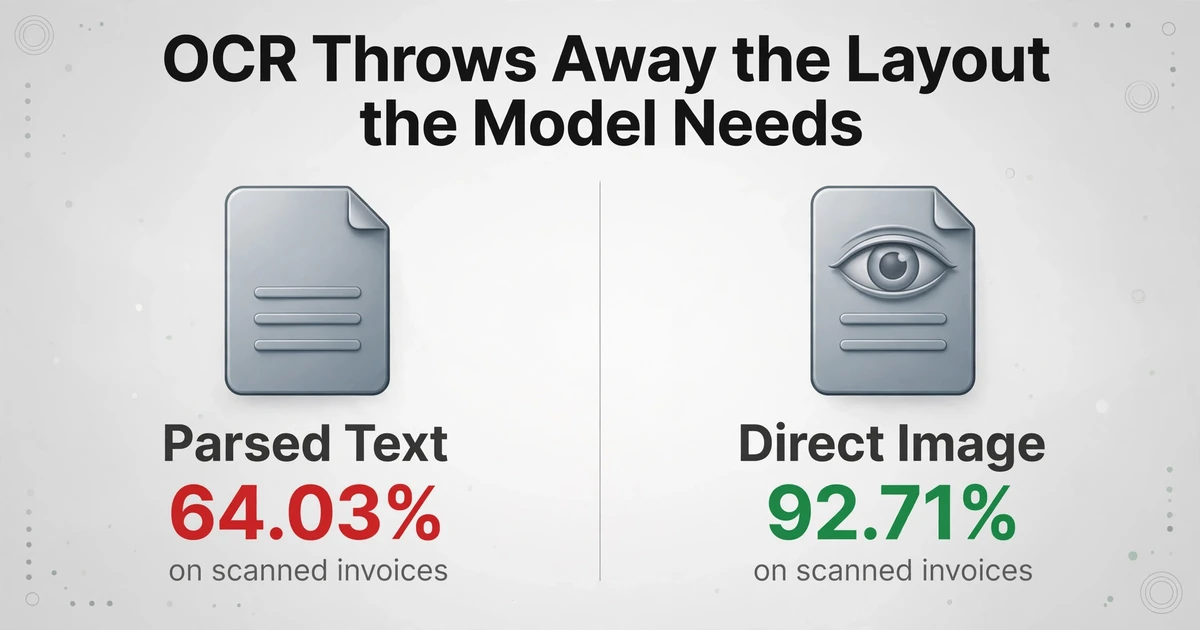
- 92,71% para lecturas directas de imagen en facturas escaneadas frente al 64,03% para la ruta de OCR a texto, porque aplanar la página destruye el diseño que el modelo necesita.
- Haga que cada valor extraído apunte a la región de la página de la que proviene, para que la revisión cueste segundos por campo y el criterio siga siendo suyo.
El pipeline funciona desde el primer día y te cuesta tiempo para la sexta semana
Un flujo de trabajo de facturas hecho por uno mismo invierte la tendencia habitual. El software normalmente se vuelve más útil cuanto más lo usas. Este tipo se vuelve más lento, porque cada nuevo proveedor añade un formato que el paso de lectura nunca ha visto, y el flujo de trabajo no tiene forma de notar que ahora está adivinando.
La inversión es fácil de explicar y difícil de sentir de antemano. n8n hace que la parte de conexión sea genuinamente simple, así que la primera ejecución exitosa se siente como una prueba de que la parte difícil ya está hecha. El disparador y la anexión a la hoja de cálculo fueron las partes fáciles. Las partes difíciles son la comprensión del documento y saber qué hacer cuando la comprensión falla. La versión conectada del pipeline responde silenciosamente "nada" a ambas, razón por la cual una comunidad de creadores sigue llegando al mismo lugar. La corrección que reciben es siempre la misma: OCR imperfecto, sin gestión de errores, y el recordatorio de que finanzas tiene que ser efectivamente perfecta.
El detalle que atrapa a la gente es que una extracción fallida rara vez parece un fallo. Un creador lo describió con precisión en un hilo sobre bots de facturas: "en el momento en que un cliente escanea algo en su teléfono a 150dpi, o peor, un escaneo de un fax, la precisión cae rápido y no lo ves venir porque las puntuaciones de confianza todavía se ven bien." El pipeline reporta éxito. Los números están mal. Nadie se da cuenta hasta la conciliación.
La orquestación es un problema resuelto y barato. La precisión de extracción y el manejo de excepciones no lo son, y una herramienta de flujo de trabajo solo te vende lo primero.
Qué está haciendo realmente el pipeline de bricolaje
Casi todo flujo de trabajo de facturas autoconstruido es la misma máquina de tres etapas. Nombrar las etapas deja claro dónde se va el tiempo y por qué.
Recepción y orquestación
Un disparador vigila una carpeta de Gmail u Outlook, una unidad compartida o un formulario, y enruta cada archivo. n8n, Make y Zapier son excelentes aquí. Esta capa es confiable porque mueve bytes; no los lee.
Lectura de la página
Un OCR o analizador de documentos convierte la imagen en texto. Las opciones comunes son Tesseract.js, Mistral OCR, LlamaParse, Mindee, AWS Textract o ABBYY. La salida es un flujo de texto, a veces con coordenadas, a veces como markdown.
Estructuración del texto
Se le pide a un LLM que devuelva JSON, generalmente con campos como proveedor, número de factura, fecha, totales y partidas. Los valores se asignan a columnas y se agregan a una hoja de cálculo o se envían hacia Xero, QuickBooks o Sage.
Cada etapa es razonable por sí sola. El problema está en las uniones. La etapa dos es con pérdida, y la etapa tres confía en que la etapa uno haya capturado las excepciones que nunca verificó. La guía completa de extracción de datos de facturas cubre los tipos de campos y formatos en detalle; la pregunta aquí es por qué esta cadena en particular se rompe donde lo hace.
La primera barrera: el OCR descarta el diseño que el modelo necesita
El OCR convierte una página de marcas posicionadas en un flujo plano de palabras, y esa conversión es deficiente justamente en el aspecto donde las facturas importan más. Una línea de artículo de factura no es una secuencia de palabras. Es una relación entre una descripción, una cantidad, un precio unitario y un importe que se ubica en la misma fila y se alinea bajo la misma columna. Al aplanar la página, la relación se convierte en una suposición: los diseños de varias columnas concatenan texto no relacionado, las tablas se convierten en secuencias de números y los encabezados se separan de las filas que etiquetan.
Esto no es una penalización menor que pueda resolverse con un prompt. Un estudio comparativo de 2025 evaluó alimentar imágenes de facturas directamente a un modelo de visión frente a primero analizar el documento en texto y luego entregar ese texto a un LLM. En facturas escaneadas, el procesamiento directo de imágenes alcanzó un 92.71% de precisión, mientras que la ruta de texto analizado se limitó a un 64.03%. En facturas limpias, el paso de análisis comprimió a todos los modelos en un rango del 84% al 85%, lo cual es una señal contundente de que la conversión OCR y markdown, no el modelo de lenguaje, se había convertido en el cuello de botella. El mismo estudio encontró que los campos alfanuméricos como los IBAN eran los más afectados, con el OCR confundiendo rutinariamente un cero con la letra O.
Los desarrolladores descubren esto empíricamente antes de poder nombrarlo. Los fallos que no pueden corregir con regex son siempre el mismo conjunto: Total vs Subtotal, Proveedor vs Destinatario, número de factura dividido entre líneas. Cada uno de ellos es un problema de diseño disfrazado de problema de texto, y cuanto más esfuerzo se invierte en parchearlos con regex, más claro resulta que el paso de transcripción es el lugar equivocado para corregirlos.
Si el diseño se descarta antes de que el modelo vea la página, ningún prompt lo recupera. Se le está pidiendo a un LLM que reconstruya una tabla a partir de una sola columna de palabras.
Para ver cómo las dos familias de herramientas abordan los mismos documentos complejos, la comparación entre OCR tradicional y extracción con IA procesa las mismas facturas con ambas. La versión breve: el enfoque más nuevo gana al leer la imagen de la página en lugar de una transcripción de la misma.
La segunda ruptura: las facturas largas fallan silenciosamente en el medio
Cuando una factura larga se envía en un solo prompt, el modelo presta atención al principio y al final y pasa por alto lo que está en medio. Esta es una propiedad medida de los modelos de lenguaje de contexto largo, documentada en Lost in the Middle: How Language Models Use Long Contexts. Aplicada a una factura de varias páginas, la falla tiene una forma reconocible: el encabezado de la primera página se extrae correctamente, el total de la última página se extrae correctamente, y una parte de las líneas de detalle de las páginas intermedias desaparece.
Que falten datos es el mejor de los casos. El peor es que se inventen. Un modelo que pierde el rastro de lo que realmente vio puede llenar un vacío con algo plausible: una cantidad para un campo vacío, una línea de detalle para un salto en la numeración, un ID fiscal de apariencia realista que no aparece en ninguna parte de la página. Los flujos de trabajo financieros consideran estos los errores más peligrosos precisamente porque superan todas las verificaciones posteriores que solo preguntan "¿hay un valor aquí?".
La confianza autodeclarada no resuelve esto, que es la parte que los pipelines de bricolaje suelen hacer mal. Un modelo puede estar equivocado con confianza en la misma dirección cada vez, por lo que una puntuación basada en su propia certeza se mantiene en verde mientras el valor es incorrecto. La distinción que importa es la precisión a nivel de campo en sus documentos, más que un porcentaje general, que la guía práctica sobre la precisión de la extracción de facturas trata en detalle. El problema central es la falla silenciosa: una celda en blanco se ve exactamente igual que un campo que estaba legítimamente vacío.
La consecuencia práctica ya es visible en los equipos financieros que adoptaron la extracción sin resolver la verificación. El resultado es predecible: se añaden capas de validación porque el modelo sigue omitiendo las condiciones de pago o mezclando líneas de detalle en facturas de varias páginas, y alguien termina supervisando cada extracción. Eso es extracción funcionando y confianza fallando. El desglose de errores de datos posteriores a la extracción cataloga los errores específicos que sobreviven a una primera revisión.
Un número incorrecto que se lee con claridad es más peligroso que uno en blanco, porque solo el en blanco se anuncia a sí mismo.
La tercera ruptura: no existe una ruta para la factura que no encaja
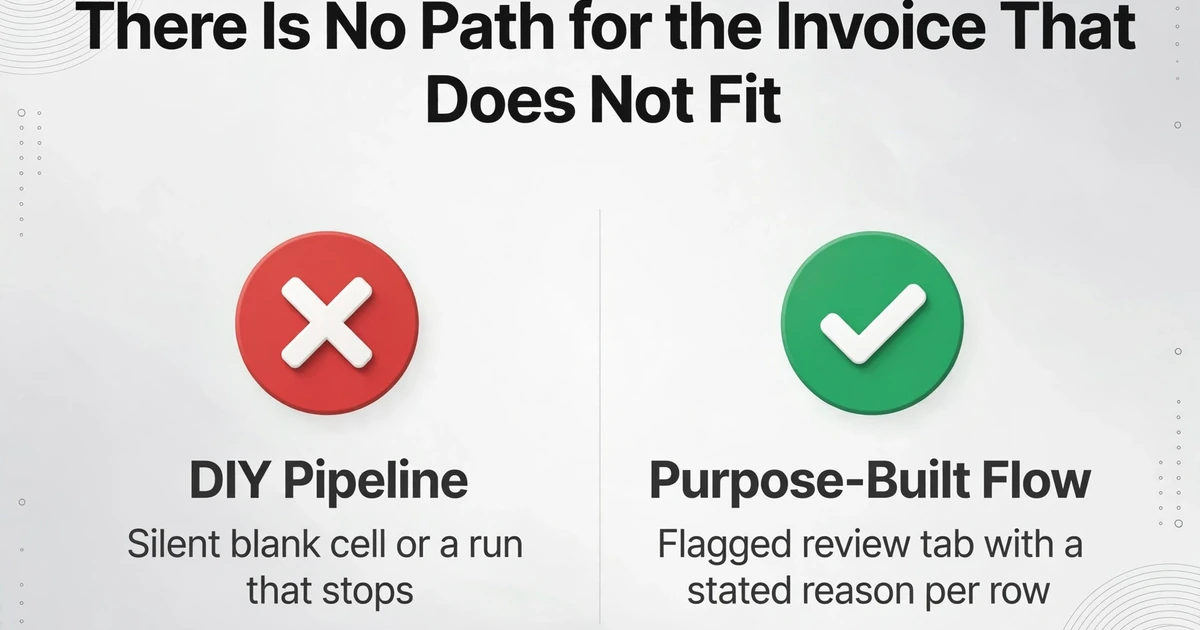
En un proceso construido manualmente, cada problema se convierte en una de dos cosas: una celda en blanco silenciosa o una ejecución que se detiene. Ninguna de las dos es un flujo de excepciones. Y las excepciones son donde realmente está el trabajo. Con aproximadamente el 18.4% de las facturas que no se procesan de principio a fin, el valor de cualquier sistema de AP se decide por cómo maneja el quinto que falla, no por los cuatro quintos que pasan sin problemas.
La mayoría de los procesos manuales intentan solucionar esto con un umbral: si la confianza del OCR está por debajo de cierto número, se envía el archivo a una cola de revisión. Suena correcto y en su mayoría no funciona, por una razón ya mencionada. La señal de confianza no es fiable, por lo que la cola o bien permanece vacía mientras pasan filas incorrectas, o se llena con todo y se convierte en una segunda bandeja de entrada. En cualquier caso, la persona termina re verificando el trabajo que la automatización afirmó haber completado.
Las personas que viven con esto describen el mismo ciclo. Cargar las facturas, verificar que todo esté correcto, completar los datos faltantes, corregir los errores, aprobar y luego arreglar los problemas de mapeo entre sistemas. El trabajo no se reduce; cambia de forma.
Ese es el costo real, y explica por qué la entrada manual puede ganar. Si el flujo de trabajo no puede indicarle qué filas obtuvo mal, su única opción segura es verificar cada fila, y verificar cada fila toma casi el mismo tiempo que escribirlas en primer lugar. La razón por la que los equipos de AP aún ingresan facturas a mano a menudo no es terquedad. Es que un flujo de trabajo que no puede señalar sus propios errores ha movido el trabajo en lugar de eliminarlo.
Si el proceso no puede indicarle qué filas obtuvo mal, verificar cada fila es racional. Y esa verificación es la entrada manual que intentaba eliminar.
Qué hace diferente un flujo de extracción diseñado para este fin
Una mejor indicación o un tercer motor de OCR añadido a la cadena no solucionará esto. La respuesta duradera es eliminar el intermediario con pérdida de información y hacer que la verificación forme parte de la extracción, en lugar de ser un paso manual posterior. Tres capacidades se corresponden directamente con las tres fallas.
La primera es Extracción de Columnas Personalizadas. En lugar de transcribir la página a texto y esperar que el diseño sobreviva, el modelo de visión lee directamente la imagen de la página. Usted escribe los nombres de las columnas que desea, como Proveedor, Número de Factura, Fecha de Factura, Descripción de la Línea, Cantidad, Total de la Línea, Impuesto y Monto Adeudado, y la IA localiza cada valor comprendiendo lo que significa en lugar de dónde se encuentra. Los nombres que usted escribe se convierten en los encabezados de su hoja de salida. Esta es la diferencia arquitectónica detrás de ese resultado de 92.71% frente a 64.03%: el modelo conserva la relación bidimensional entre una descripción y su fila, por lo que "Total vs. Subtotal" y "número de factura dividido entre líneas" dejan de ser problemas de expresiones regulares. Si todavía está evaluando si vale la pena el cambio, la guía sobre cuándo pasar de OCR a extracción con IA plantea el equilibrio.
La segunda es Modo de revisión con verificación Bbox, y aborda directamente la falla silenciosa. En la pantalla de revisión, pase el cursor o haga clic en cualquier celda extraída y la región de donde proviene se resaltará en el documento original. El vínculo funciona en ambos sentidos, por lo que al hacer clic en una región se salta de vuelta a su celda, y un valor editado puede revertirse a la lectura original de la IA. Esto no promete que cada valor sea correcto. Cambia un valor incorrecto invisible por uno comprobable, que es lo que realmente necesita la queja de "supervisar cada extracción": revisión medida en segundos por campo en lugar de volver a escribir una factura completa.
La tercera es nivel de modelo. La escritura densa, los diseños complejos y los escaneos difíciles son exactamente donde un lector estándar se degrada, por lo que las cuentas pueden operar en Estándar, Avanzado o Premium, con niveles superiores que utilizan un modelo de visión subyacente más potente. Estándar cubre la mayoría de los documentos tabulares impresos, y un lote se factura y reembolsa según el nivel activo cuando se envió. Esto es importante para el caso del escaneo telefónico a 150 ppp: la solución es un lector más potente para los documentos difíciles, no una segunda pila de OCR superpuesta.
Dos elementos de apoyo evitan que el resto de la cadena reintroduzca trabajo manual. Procesamiento por lotes ejecuta muchos archivos a la vez y los fusiona en una sola salida de Excel, por lo que un mes de facturas se convierte en una sola hoja en lugar de un archivo a la vez. Y Bandeja de entrada de correo le da a cada cuenta una dirección dedicada: reenvíe o enrute facturas a ella, active el procesamiento automático con una plantilla vinculada, y los archivos adjuntos llegarán a la cola por sí solos, con una lista blanca de remitentes para mantener fuera el correo no relacionado. Si prefiere llamar a la extracción desde su propio código en lugar de ejecutarla en un navegador, la API v1 existe para eso, mientras que la ruta web sigue siendo adecuada para cualquiera que quiera comenzar con una carpeta. Para ver la ruta de extracción para un caso de uso de AP de principio a fin, el flujo de trabajo de automatización de cuentas por pagar lo recorre. Para equipos que evalúan la extracción diseñada para este fin frente a las alternativas, la comparación de herramientas de extracción de facturas para equipos financieros las organiza por arquitectura en lugar de por lista de funciones.
Los archivos se procesan de forma segura y no se almacenan.
Si Mantiene el Pipeline, Cuatro Comprobaciones Son Innegociables
Muchos equipos conservarán su construcción en n8n, y esa puede ser la decisión correcta para una carga de trabajo limitada y con pocas excepciones. Si lo hace, la durabilidad proviene de cuatro adiciones, ninguna de las cuales tiene que ver con la capa de orquestación.
Lea la imagen, no solo el texto del OCR. Conserve la página original en el flujo y pase al menos los campos difíciles por un modelo de visión, para que un valor nunca se confíe únicamente a una transcripción aplanada. Valide la aritmética que la propia factura implica. Sume las partidas y compárelas con el subtotal; añada los impuestos y compare con el total; marque las discrepancias en lugar de registrarlas. Las facturas son documentos que se autocontrolan, y estas reglas detectan una gran parte de los errores silenciosos. Fundamente cada valor en su origen. Almacene la página y la región de donde proviene un número, para que un revisor pueda confirmarlo o rechazarlo con un clic en lugar de volver a abrir el PDF. Convierta la ruta de excepción en un resultado real. Una pestaña de revisión marcada con un motivo declarado por fila vale más que un umbral de confianza, porque el motivo le indica a una persona dónde mirar.
Estas son las mismas propiedades que una herramienta especializada incluye de forma predeterminada. Si ya ha construido las tres primeras, la pregunta honesta es si mantenerlas es más barato que no ser dueño de ese mantenimiento, lo cual es una cuestión sobre su equipo más que sobre el software.
Lo que un flujo especializado aún no hace
Extrae; no orquesta. ImageToTable.ai no ejecutará tu flujo de n8n, Make o Zapier, ni publicará en tu ERP por ti. Produce datos estructurados a partir de un documento, y la conexión con otros sistemas permanece donde corresponde. La API v1 está disponible si deseas llamar a la extracción desde tu propio pipeline, pero la herramienta no es un motor de flujos de trabajo ni pretende serlo.
No compara documentos entre sí. No decidirá que esta factura pertenece a una orden de compra determinada, ni realizará una comparación campo por campo entre dos documentos para declararlos coincidentes. La conciliación a tres bandas es un paso aparte que debe gestionar una búsqueda en hoja de cálculo o tu ERP. Lo que la herramienta te ofrece son datos limpios y en columnas que hacen posible esa conciliación.
La precisión es alta, no perfecta. Hasta un 99% de reconocimiento en datos tabulares impresos es nuestra propia cifra para un tipo de entrada específico, no una garantía ante un escaneo deficiente o caligrafía compleja, que es exactamente la razón por la que existen el Modo de revisión con verificación Bbox. En campos con peso financiero, como importes, impuestos y números de cuenta, el paso de verificación no es opcional.
Una persona sigue siendo responsable del criterio y las excepciones. La herramienta elimina la transcripción y la búsqueda del origen de un número. No decide si una variación de precio debe impugnarse, si un duplicado es genuino o si una factura debe pagarse anticipadamente. Eso permanece en el equipo de AP, que es la división prevista: el criterio conserva su lugar y el tecleo rutinario deja de consumir la semana.
Preguntas frecuentes
¿Es n8n la razón por la que mi pipeline no es fiable?
No. n8n, Make y Zapier hacen bien la orquestación, y esa es una tarea distinta de leer un documento. Las partes poco fiables son la conversión de OCR a texto que pierde el diseño y la ausencia de una ruta de excepciones a su alrededor. Puedes reconstruir el mismo flujo en cualquier herramienta y llevar ambos problemas contigo.
¿Puedo solucionarlo añadiendo un mejor modelo de OCR o una segunda pasada de LLM?
Ayuda en los márgenes, pero no cambia la arquitectura. Una segunda pasada sigue partiendo de una transcripción que ya ha perdido el diseño, por lo que se apilan coste y latencia sobre un paso con pérdida. La mayor ganancia viene de dejar que un modelo de visión lea la imagen de la página, lo que elimina el paso con pérdida en lugar de añadir otro lector detrás.
¿Reemplaza ImageToTable.ai mi flujo de trabajo en n8n?
No. Reemplaza las capas de extracción y verificación, no la orquestación. Si quieres que la extracción se invoque desde dentro de tu pipeline existente, la API v1 lo admite. Si prefieres no mantener ningún pipeline, puedes usar la carga web y el flujo por lotes, o dirigir las facturas a una Bandeja de entrada de correo y dejar que se pongan en cola automáticamente.
¿Cómo confío en el resultado si no puedo revisar cada fila?
Revisas las filas que tienen peso financiero. El Modo de revisión con verificación Bbox te permite pasar el cursor sobre una celda y ver su región de origen en el original en un solo paso, por lo que la verificación es lo bastante rápida como para hacerla de forma selectiva en lugar de exhaustiva. Combínalo con las comprobaciones aritméticas anteriores, ya que un desajuste entre partidas y total es una señal fuerte de que un valor merece una mirada más atenta.
¿Qué pasa con las facturas de muchas páginas?
Los documentos más largos y densos son donde un nivel de modelo superior justifica su coste, porque el modelo de visión más potente conserva detalles que un lector estándar pierde. Por separado, si un único documento lógico se sube como varias páginas o imágenes, la fusión de varias páginas puede recomponer esas piezas en una sola fila. Leer una factura larga y reensamblar una dividida son dos problemas distintos, y la herramienta los aborda con dos ajustes diferentes.
¿Merece la pena cambiar si ya he construido el pipeline?
Depende de dónde vaya tu tiempo. Si la mayor parte de tu volumen son facturas limpias, digitales y de una sola página, y las excepciones son raras, consolidar lo que ya tienes es razonable. Si una parte significativa de cada semana se gasta revisando filas que el flujo de trabajo no podía garantizar, la capa de extracción y verificación es por donde se fuga ese tiempo, y es la parte que merece la pena reemplazar primero.
El flujo no se rompió porque usted lo construyó
El flujo de facturas autoconstruido falla por una razón poco glamorosa. Eliminó un paso humano sin reemplazar la función que ese paso estaba realizando, que era detectar los documentos que no se ajustaban al patrón. Escribir siempre hacía tres cosas a la vez: leer, notar y corregir. Elimine la escritura y la acción de notar debe reconstruirse en algún lugar, o recae en la persona, una celda incorrecta y silenciosa a la vez. Un flujo de extracción diseñado para un propósito no promete el fin de la revisión. Hace que la revisión sea lo suficientemente económica como para mantenerla, y mantiene el diseño, la ubicación de la fuente y la aritmética a la vista para que la verificación tome segundos en lugar de volver a escribir.