Le flux de travail IA pour factures que vous avez créé
est plus lent que la saisie manuelle
Un pipeline de factures qui fonctionne et un pipeline de factures qui fait gagner du temps sont deux choses différentes. Le premier peut être assemblé en un après-midi avec n8n, Make ou Zapier : surveiller une boîte mail, pousser chaque pièce jointe dans un modèle OCR, transmettre le texte à un LLM et écrire une ligne dans une feuille de calcul. Le second doit survivre aux documents qui ne sont jamais apparus dans la démo.
Cet écart est structurel, pas une question de compétence technique. Les benchmarks situent le taux d'exceptions sur factures à 18,4 % (State of ePayables 2025 d'Ardent Partners). Près d'une facture sur cinq refuse le chemin autour duquel un flux de travail a été conçu. Un pipeline bâti pour le chemin propre passe ses heures réelles sur ce cinquième, et ces heures sont directement prélevées sur votre journée.
Points clés à retenir
- Votre pipeline fonctionne en démo et ralentit sur un mois réel, et cet écart est structurel plutôt qu'un défaut de votre conception.
- 92,71 % pour les lectures directes d'images sur factures scannées contre 64,03 % pour la voie OCR-vers-texte, car aplatir la page détruit la mise en page dont le modèle a besoin.
- Faites pointer chaque valeur extraite vers la région de la page dont elle provient, afin que la révision coûte quelques secondes par champ et que le jugement reste entre vos mains.
Le pipeline fonctionne dès le premier jour et vous fait perdre du temps à la sixième semaine
Un flux de travail de facturation fait maison inverse la tendance habituelle. Les logiciels deviennent généralement plus utiles à mesure que vous les utilisez. Ce type-ci ralentit, car chaque nouveau fournisseur ajoute une forme que l'étape de lecture n'a jamais vue, et le flux de travail n'a aucun moyen de remarquer qu'il est en train de deviner.
Ce renversement est facile à expliquer mais difficile à anticiper. n8n rend la partie câblage vraiment simple, si bien que la première exécution réussie donne l'impression que le plus dur est fait. Le déclencheur et l'ajout à la feuille de calcul étaient les parties faciles. Les parties difficiles sont la compréhension des documents et le fait de savoir quoi faire quand la compréhension échoue. La version câblée du pipeline répond tranquillement « rien » à ces deux questions, ce qui explique pourquoi une communauté de créateurs aboutit toujours au même point. La correction qu'ils reçoivent est toujours la même : OCR imparfait, aucune gestion des erreurs, et le rappel que la finance doit être pratiquement parfaite.
Le détail qui piège les gens, c'est qu'une extraction défaillante ressemble rarement à un échec. Un créateur l'a décrit avec précision dans un fil de discussion sur les bots de facturation : « dès qu'un client scanne un document sur son téléphone à 150 dpi, ou pire, scanne un fax, la précision chute rapidement et vous ne le verrez pas venir parce que les scores de confiance semblent toujours corrects. » Le pipeline signale un succès. Les chiffres sont faux. Personne ne s'en aperçoit avant le rapprochement.
L'orchestration est un problème résolu et peu coûteux. La précision de l'extraction et la gestion des exceptions ne le sont pas, et un outil de flux de travail ne vous vend que la première.
Ce que fait réellement le pipeline DIY
Presque tous les flux de travail de facturation auto-construits reposent sur la même machine en trois étapes. Nommer ces étapes permet de comprendre clairement où va le temps et pourquoi.
Réception et orchestration
Un déclencheur surveille un dossier Gmail ou Outlook, un lecteur partagé ou un formulaire, et achemine chaque fichier. n8n, Make et Zapier sont excellents ici. Cette couche est fiable car elle déplace des octets ; elle ne les lit pas.
Lecture de la page
Un OCR ou un analyseur de documents transforme l'image en texte. Les choix courants sont Tesseract.js, Mistral OCR, LlamaParse, Mindee, AWS Textract ou ABBYY. Le résultat est un flux de texte, parfois avec des coordonnées, parfois au format markdown.
Structuration du texte
Un LLM est invité à renvoyer du JSON, généralement avec des champs comme le fournisseur, le numéro de facture, la date, les totaux et les lignes d'articles. Les valeurs sont mappées vers des colonnes et ajoutées à une feuille de calcul ou poussées vers Xero, QuickBooks ou Sage.
Chaque étape est raisonnable individuellement. Le problème se situe aux jonctions. L'étape deux est avec perte, et l'étape trois fait confiance à l'étape un pour avoir attrapé les exceptions qu'elle n'a jamais vérifiées. Le guide complet de l'extraction de données de factures couvre les types de champs et les formats en détail ; la question ici est de savoir pourquoi cette chaîne particulière casse là où elle casse.
Première rupture : l'OCR jette la mise en page dont le modèle a besoin
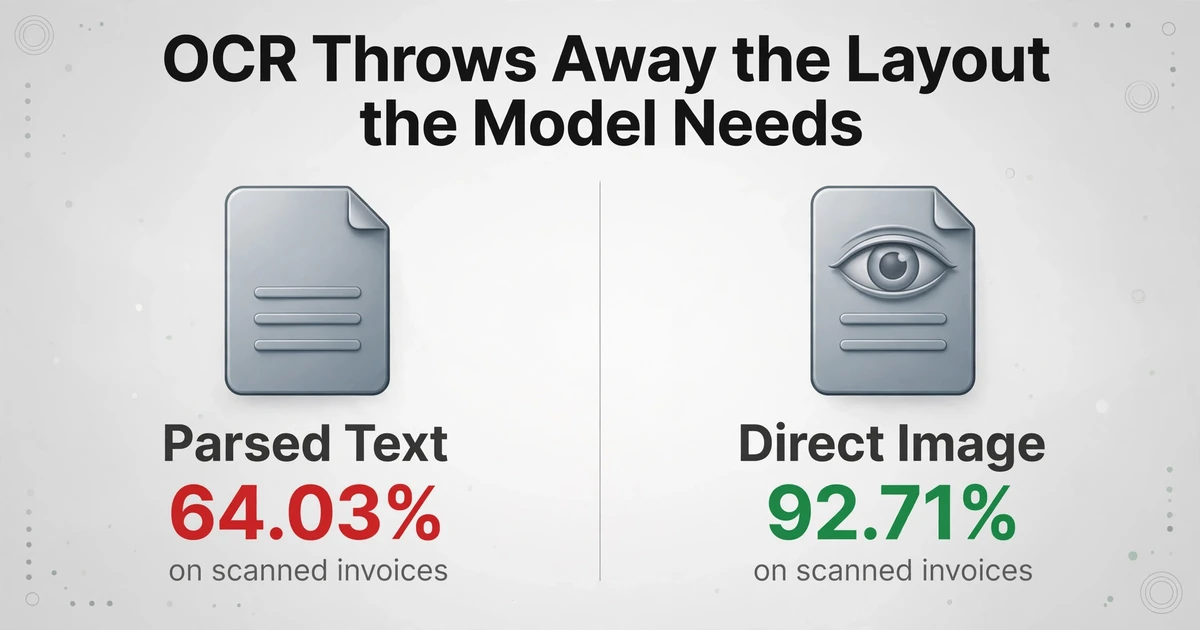
L'OCR convertit une page de marques positionnées en un flux plat de mots, et cette conversion est dégradante précisément là où les factures comptent le plus. Une ligne d'article de facture n'est pas une séquence de mots. C'est une relation entre une description, une quantité, un prix unitaire et un montant qui se trouve sur la même ligne et s'aligne sous la même colonne. Aplatissez la page et la relation devient une devinette : les mises en page multi-colonnes concatènent des textes sans rapport, les tableaux deviennent des suites de nombres, et les en-têtes se détachent des lignes qu'ils désignent.
Ce n'est pas une petite pénalité que vous pouvez contourner par des invites. Un benchmark de 2025 a comparé l'envoi direct d'images de factures à un modèle de vision à une approche consistant d'abord à analyser le document en texte, puis à transmettre ce texte à un LLM. Sur les factures scannées, le traitement direct de l'image a atteint 92,71 % de précision, tandis que la voie du texte analysé plafonnait à 64,03 %. Sur les factures propres, l'étape d'analyse a compressé tous les modèles dans une fourchette de 84 % à 85 %, ce qui est un signal fort que l'OCR et la conversion en markdown, et non le modèle de langage, étaient devenus le goulot d'étranglement. La même étude a constaté que les champs alphanumériques tels que les IBAN étaient les plus touchés, l'OCR confondant régulièrement le zéro avec la lettre O.
Les développeurs découvrent cela de manière empirique avant de pouvoir le nommer. Les échecs qu'ils ne peuvent pas corriger avec des regex sont toujours les mêmes : Total vs Sous-total, Fournisseur vs Facturé à, numéro de facture scindé sur plusieurs lignes. Chacun d'eux est un problème de mise en page déguisé en problème de texte, et plus on s'efforce de les corriger avec des regex, plus il devient évident que l'étape de transcription n'est pas le bon endroit pour les corriger.
Si la mise en page est écartée avant que le modèle ne voie la page, aucune invite ne peut la récupérer. Vous demandez à un LLM de reconstruire un tableau à partir d'une seule colonne de mots.
Pour voir comment les deux familles d'outils abordent les mêmes documents complexes, la comparaison entre l'OCR traditionnel et l'extraction par IA fait passer les mêmes factures dans les deux. En bref : l'approche plus récente gagne en lisant l'image de la page plutôt qu'une transcription de celle-ci.
La deuxième rupture : les factures longues échouent silencieusement au milieu
Lorsqu'une facture longue est envoyée dans une seule requête, le modèle prête attention au début et à la fin, et survole ce qui se trouve entre les deux. Il s'agit d'une propriété mesurée des modèles de langage à contexte long, documentée dans Lost in the Middle: How Language Models Use Long Contexts. Appliquée à une facture multipage, la défaillance prend une forme reconnaissable : l'en-tête de la première page est extrait correctement, le total de la dernière page est extrait correctement, et une tranche de lignes d'articles sur les pages du milieu disparaît.
La disparition est le cas le plus favorable. Le pire, c'est l'invention. Un modèle qui perd la trace de ce qu'il a réellement vu peut combler un vide avec quelque chose de plausible : une quantité pour un champ vide, une ligne d'article pour un saut de numérotation, un numéro d'identification fiscale d'apparence réaliste qui n'apparaît nulle part sur la page. Les flux de travail financiers considèrent ces erreurs comme les plus dangereuses, précisément parce qu'elles passent tous les contrôles en aval qui ne demandent que « y a-t-il une valeur ici ».
La confiance auto-déclarée ne sauve pas la situation, et c'est ce que les pipelines DIY comprennent souvent mal. Un modèle peut se tromper avec assurance dans la même direction à chaque fois, de sorte qu'un score fondé sur sa propre certitude reste au vert alors que la valeur est erronée. La distinction qui compte est la précision au niveau des champs sur vos documents, plutôt qu'un pourcentage global, ce que le guide pratique de la précision de l'extraction de factures traite en détail. Le problème central est l'échec silencieux : une cellule vide ressemble exactement à un champ légitimement vide.
La conséquence pratique est déjà visible dans les équipes financières qui ont adopté l'extraction sans résoudre la vérification. Le résultat est prévisible : des couches de validation sont ajoutées parce que le modèle ne cesse de manquer les conditions de paiement ou de mélanger les lignes d'articles sur les factures multipages, et quelqu'un finit toujours par surveiller chaque extraction. C'est une extraction qui fonctionne et une confiance qui échoue. La ventilation des erreurs de données après extraction catalogue les erreurs spécifiques qui survivent à un premier examen.
Un chiffre erroné qui se lit clairement est plus dangereux qu'un chiffre vide, car seul le vide s'annonce de lui-même.
La troisième rupture : aucune solution pour la facture qui ne correspond pas
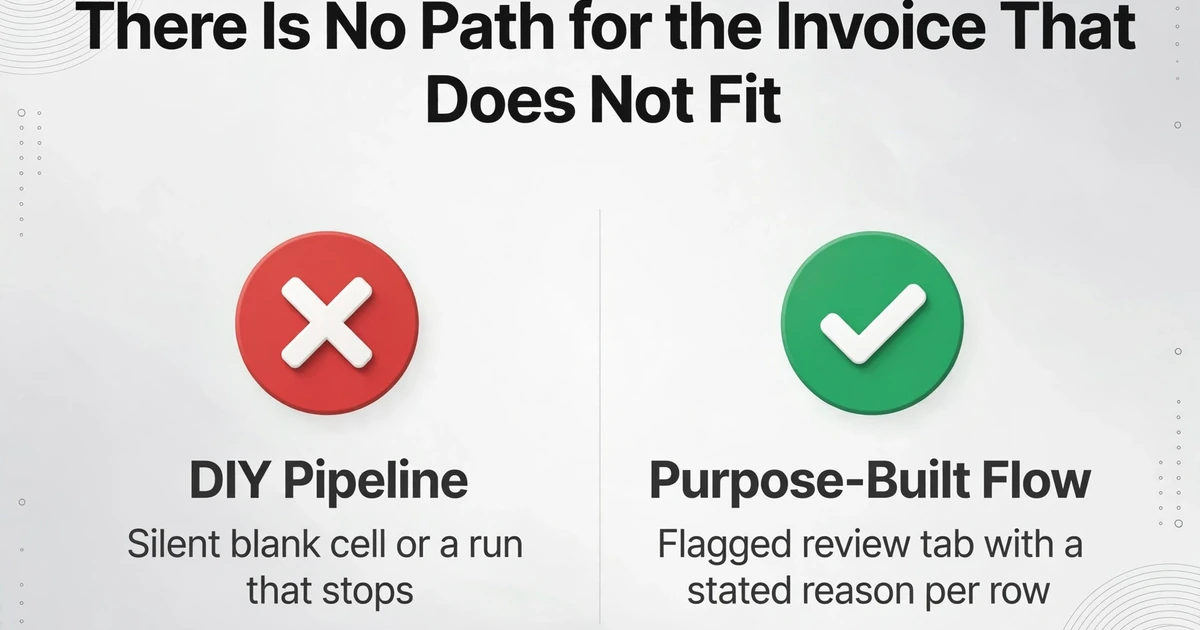
Dans un pipeline maison, chaque problème devient l'une de ces deux choses : une cellule vide silencieuse ou une exécution qui s'arrête. Ni l'un ni l'autre n'est un flux de gestion des exceptions. Or, c'est là que se trouve le vrai travail. Avec environ 18,4 % des factures qui ne parviennent pas à être traitées directement, la valeur d'un système AP se mesure à sa capacité à gérer le cinquième qui pose problème, et non les quatre cinquièmes qui passent sans encombre.
La plupart des solutions maison tentent de contourner ce problème avec un seuil : si la confiance OCR est inférieure à un certain nombre, acheminer le fichier vers une file de révision. Cela semble logique, mais cela ne fonctionne généralement pas, pour une raison évoquée plus haut. Le signal de confiance n'est pas fiable : soit la file reste vide pendant que des lignes erronées passent, soit elle se remplit de tout et devient une seconde boîte de réception. Dans les deux cas, l'humain finit par revérifier un travail que l'automatisation prétendait avoir terminé.
Les personnes concernées décrivent le même cycle. Charger les factures, vérifier que tout est correct, compléter les données manquantes, corriger les erreurs, approuver, puis corriger les problèmes de mappage entre les systèmes. Le travail ne diminue pas ; il change de forme.
C'est là le véritable coût, et cela explique pourquoi la saisie manuelle peut l'emporter. Si le flux ne peut pas vous indiquer quelles lignes il a mal traitées, votre seule option sûre est de vérifier chaque ligne, et vérifier chaque ligne prend à peu près autant de temps que de les saisir au départ. La raison pour laquelle les équipes AP saisissent encore les factures à la main n'est souvent pas l'entêtement. C'est qu'un flux qui ne peut pas signaler ses propres erreurs a déplacé le travail plutôt que de l'éliminer.
Si le pipeline ne peut pas vous indiquer quelles lignes il a mal traitées, vérifier chaque ligne est rationnel. Et cette vérification, c'est la saisie manuelle que vous cherchiez à supprimer.
Ce qu’un flux d’extraction spécialisé fait différemment
Une meilleure invite ou un troisième moteur OCR ajouté à la chaîne ne résoudra pas le problème. La solution durable consiste à supprimer l’intermédiaire avec perte et à intégrer la vérification à l’extraction plutôt que d’en faire une étape manuelle ultérieure. Trois capacités correspondent directement aux trois points de rupture.
La première est l’Extraction de colonnes personnalisées. Au lieu de transcrire la page en texte et d’espérer que la mise en page survive, le modèle de vision lit directement l’image de la page. Vous saisissez les noms de colonnes souhaités, tels que Fournisseur, Numéro de facture, Date de facture, Description de ligne, Quantité, Total de ligne, Taxe et Montant dû, et l’IA localise chaque valeur en comprenant ce qu’elle signifie plutôt que l’endroit où elle se trouve. Les noms que vous saisissez deviennent les en-têtes de votre feuille de sortie. C’est la différence architecturale derrière ce résultat de 92,71 % contre 64,03 % : le modèle conserve la relation bidimensionnelle entre une description et sa ligne, de sorte que « Total vs Sous-total » et « numéro de facture réparti sur plusieurs lignes » cessent d’être des problèmes de regex. Si vous vous demandez encore si le changement en vaut la peine, le guide sur quand passer de l’OCR à l’extraction par IA présente le compromis.
La deuxième est le Mode de révision avec vérification Bbox, et elle cible directement l’échec silencieux. Dans l’écran de révision, survolez ou cliquez sur n’importe quelle cellule extraite et la région d’origine est mise en surbrillance sur le document original. Le lien fonctionne dans les deux sens : cliquer sur une région ramène à sa cellule, et une valeur modifiée peut être rétablie à la lecture initiale de l’IA. Cela ne garantit pas que chaque valeur est correcte. Cela transforme une valeur erronée invisible en une valeur vérifiable, ce qui répond précisément à la plainte concernant la « surveillance de chaque extraction » : une révision mesurée en secondes par champ au lieu d’une ressaisie complète par facture.
La troisième est le niveau de modèle. L’écriture manuscrite dense, les mises en page complexes et les scans difficiles sont précisément là où un lecteur standard se dégrade, de sorte que les comptes peuvent fonctionner en Standard, Avancé ou Premium, les niveaux supérieurs utilisant un modèle de vision sous-jacent plus puissant. Le niveau Standard couvre la plupart des documents tabulaires imprimés, et un lot est facturé et remboursé selon le niveau actif au moment de sa soumission. Cela compte pour le cas du scan de téléphone à 150 dpi : la solution est un lecteur plus puissant sur les documents difficiles, et non une deuxième pile OCR superposée.
Deux éléments complémentaires empêchent le reste de la chaîne de réintroduire du travail manuel. Le Traitement par lots exécute plusieurs fichiers à la fois et les fusionne en une seule sortie Excel, de sorte qu’un mois de factures devient une seule feuille au lieu d’un fichier à la fois. Et la Boîte de réception e-mail donne à chaque compte une adresse dédiée : transférez ou acheminez les factures vers celle-ci, activez le traitement automatique avec un modèle lié, et les pièces jointes arrivent dans la file d’attente d’elles-mêmes, avec une liste blanche d’expéditeurs pour exclure les courriers non pertinents. Si vous préférez appeler l’extraction depuis votre propre code plutôt que de l’exécuter dans un navigateur, l’API v1 existe pour cela, tandis que la voie web convient toujours à ceux qui souhaitent commencer avec un dossier. Pour voir le parcours d’extraction pour un cas d’utilisation AP de bout en bout, le flux de travail d’automatisation de la comptabilité fournisseurs le détaille. Pour les équipes qui comparent l’extraction spécialisée aux alternatives, la comparaison des outils d’extraction de factures pour les équipes financières les organise par architecture plutôt que par liste de fonctionnalités.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Si vous conservez le pipeline, quatre vérifications sont incontournables
De nombreuses équipes conserveront leur build n8n, et cela peut être le bon choix pour une charge de travail étroite avec peu d'exceptions. Si c'est votre cas, la durabilité vient de quatre ajouts, dont aucun ne concerne la couche d'orchestration.
Lisez l'image, pas seulement le texte OCR. Conservez la page d'origine dans le flux et faites passer au moins les champs difficiles par un modèle de vision, afin qu'une valeur ne soit jamais validée sur la seule base d'une transcription aplatie. Validez l'arithmétique implicite de la facture. Faites la somme des lignes et comparez-la au sous-total ; ajoutez la taxe et comparez au total ; signalez les écarts au lieu de les écrire. Les factures sont des documents auto-vérifiables, et ces règles détectent une grande part des erreurs silencieuses. Ancrez chaque valeur à sa source. Stockez la page et la région d'où provient un chiffre, afin qu'un réviseur puisse le confirmer ou le rejeter en un clic plutôt que de rouvrir le PDF. Faites du chemin d'exception une véritable sortie. Un onglet de révision signalé avec une raison indiquée par ligne vaut plus qu'un seuil de confiance, car la raison indique à une personne où chercher.
Ce sont les mêmes propriétés qu'un outil spécialisé fournit par défaut. Si vous avez déjà construit les trois premières, la question honnête est de savoir si leur maintenance coûte moins cher que de ne pas posséder cette maintenance, ce qui est une question sur votre équipe plutôt que sur le logiciel.
Ce qu'un flux dédié ne fait toujours pas
Il extrait ; il n'orchestre pas. ImageToTable.ai n'exécutera pas votre workflow n8n, Make ou Zapier, et il ne publiera pas non plus dans votre ERP à votre place. Il produit des données structurées à partir d'un document, et la connexion vers d'autres systèmes reste là où elle doit être. L'API v1 est là si vous souhaitez appeler l'extraction depuis votre propre pipeline, mais l'outil n'est pas un moteur de workflow et ne prétend pas en être un.
Il ne fait pas correspondre les documents entre eux. Il ne décidera pas que cette facture appartient à un bon de commande particulier, et il n'effectuera pas de comparaison champ par champ entre deux documents pour déclarer qu'ils correspondent. Le rapprochement à trois volets est une étape distincte qu'une recherche dans un tableur ou votre ERP doit prendre en charge. Ce que l'outil vous donne, ce sont des données propres et columnisées qui rendent ce rapprochement possible.
La précision est élevée, pas parfaite. Jusqu'à 99 % de reconnaissance sur les données tabulaires imprimées est notre propre chiffre pour un type d'entrée spécifique, et non une garantie sur un scan de mauvaise qualité ou une écriture manuscrite dense, ce qui explique précisément pourquoi le Mode de révision avec vérification Bbox existe. Sur les champs à poids financier, tels que les montants, la taxe et les numéros de compte, l'étape de vérification n'est pas facultative.
Un humain conserve le jugement et la gestion des exceptions. L'outil élimine la transcription et la recherche de l'origine d'un chiffre. Il ne décide pas si un écart de prix doit être contesté, si un doublon est authentique, ou si une facture doit être payée par anticipation. Ces décisions restent à l'équipe AP, ce qui constitue la répartition prévue : le jugement garde sa place, et la saisie routinière cesse de consommer la semaine.
Questions fréquemment posées
n8n est-il la raison pour laquelle mon pipeline n'est pas fiable ?
Non. n8n, Make et Zapier font bien l'orchestration, et c'est un travail différent de la lecture d'un document. Les parties peu fiables sont la conversion OCR-texte qui perd la mise en page et l'absence de chemin de gestion des exceptions autour de celle-ci. Vous pouvez reconstruire le même workflow dans n'importe quel outil et emporter les deux problèmes avec vous.
Puis-je y remédier en ajoutant un meilleur modèle OCR ou un second passage LLM ?
Cela aide à la marge, mais ne change pas l'architecture. Un second passage part toujours d'une transcription qui a déjà perdu la mise en page, vous empilant donc coût et latence sur une étape avec perte. Le gain le plus important vient de laisser un modèle de vision lire l'image de la page, ce qui supprime l'étape avec perte au lieu d'ajouter un autre lecteur derrière elle.
ImageToTable.ai remplace-t-il mon workflow n8n ?
Non. Il remplace les couches d'extraction et de vérification, pas l'orchestration. Si vous souhaitez appeler l'extraction depuis votre pipeline existant, l'API v1 le prend en charge. Si vous préférez ne pas maintenir de pipeline du tout, vous pouvez utiliser le flux d'upload web et de traitement par lots, ou pointer les factures vers une Boîte de réception e-mail et les laisser se mettre en file d'attente automatiquement.
Comment puis-je faire confiance au résultat si je ne peux pas vérifier chaque ligne ?
Vous vérifiez les lignes qui ont un poids financier. Le Mode de révision avec vérification Bbox vous permet de survoler une cellule et de voir sa région source sur l'original en une seule étape, rendant la vérification assez rapide pour être faite de manière sélective plutôt qu'exhaustive. Associez-le aux contrôles arithmétiques ci-dessus, car un écart entre les lignes et le total est un signal fort qu'une valeur mérite un examen plus approfondi.
Qu'en est-il des factures qui s'étendent sur plusieurs pages ?
Les documents plus longs et plus denses sont ceux où un niveau de modèle supérieur justifie son coût, car le modèle de vision plus puissant conserve des détails qu'un lecteur standard perd. Par ailleurs, si un seul document logique est téléchargé en plusieurs pages ou images, fusion multipage peut rassembler ces éléments en une seule ligne. Lire une longue facture et réassembler une facture scindée sont deux problèmes différents, et l'outil les traite avec deux paramètres différents.
Est-ce que cela vaut le coup de changer si j'ai déjà construit le pipeline ?
Cela dépend de là où va votre temps. Si la majeure partie de votre volume est constituée de factures propres, numériques, sur une seule page, et que les exceptions sont rares, consolider ce que vous avez est raisonnable. Si une part significative de chaque semaine est consacrée à vérifier des lignes que le workflow ne pouvait pas garantir, c'est dans la couche d'extraction et de vérification que ce temps se perd, et c'est la partie qu'il vaut la peine de remplacer en premier.
Le pipeline n'a pas cassé parce que vous l'avez construit
Le flux de travail de facturation auto-construit échoue pour une raison peu glorieuse. Il a supprimé une étape humaine sans remplacer la fonction que cette étape remplissait, qui était de détecter les documents qui ne correspondaient pas au modèle. La saisie faisait toujours trois choses à la fois : lire, remarquer et corriger. Supprimez la saisie et la détection doit être reconstruite ailleurs, ou elle retombe sur la personne, une cellule erronée silencieuse à la fois. Un flux d'extraction conçu sur mesure ne promet pas la fin de la révision. Il rend la révision suffisamment peu coûteuse pour être conservée, et il garde la mise en page, l'emplacement source et l'arithmétique en vue afin que la vérification prenne des secondes plutôt qu'une ressaisie.