Obtenir des données fiables à partir de factures désordonnées,
incohérentes : un guide pratique sur la précision
Chaque fournisseur d'extraction de factures par IA promet une précision de 99 %. Mais lorsque vous téléchargez vos factures réelles — celles avec des annotations manuscrites dans les marges, des tampons dans trois langues et des tableaux qui se prolongent en page 2 — le résultat est plus proche de 85 %. Cet écart n'est pas une fraude. C'est la différence entre la précision au niveau de la page (le chiffre marketing) et la précision au niveau des champs (le chiffre qui détermine si votre collaborateur AP fait confiance à la sortie ou retape tout). Voici comment comprendre cette différence, la mesurer sur vos propres documents et combler l'écart.
Points clés à retenir
- La « précision de 99 % » sur le tableau de bord du fournisseur compte les caractères, pas les champs — trois chiffres mal lus peuvent signifier un total de facture erroné, une date d'échéance manquée et une correspondance PO cassée simultanément, pendant que le compteur affirme que tout va bien.
- Numériser vos factures à 300 DPI en couleur au lieu de 150 DPI en noir et blanc fait varier la précision au niveau des champs de 5 à 10 points de pourcentage — plus que l'écart entre deux fournisseurs d'IA concurrents.
- Téléchargez d'abord vos trois factures les plus difficiles — celles avec des tampons couvrant les totaux et des écritures manuscrites dans les marges — car si ImageToTable.ai les gère, il gère tout ; commencer par les factures propres revient à mesurer la performance de démonstration, pas la précision en production.
« 99 % de précision » est un chiffre marketing. Voici ce que cela signifie réellement.
Il existe deux chiffres de précision dans l'extraction de factures, et ils signifient des choses complètement différentes. La confusion entre les deux est la plus grande source de déception lorsque les équipes passent des démonstrations des fournisseurs aux factures réelles.
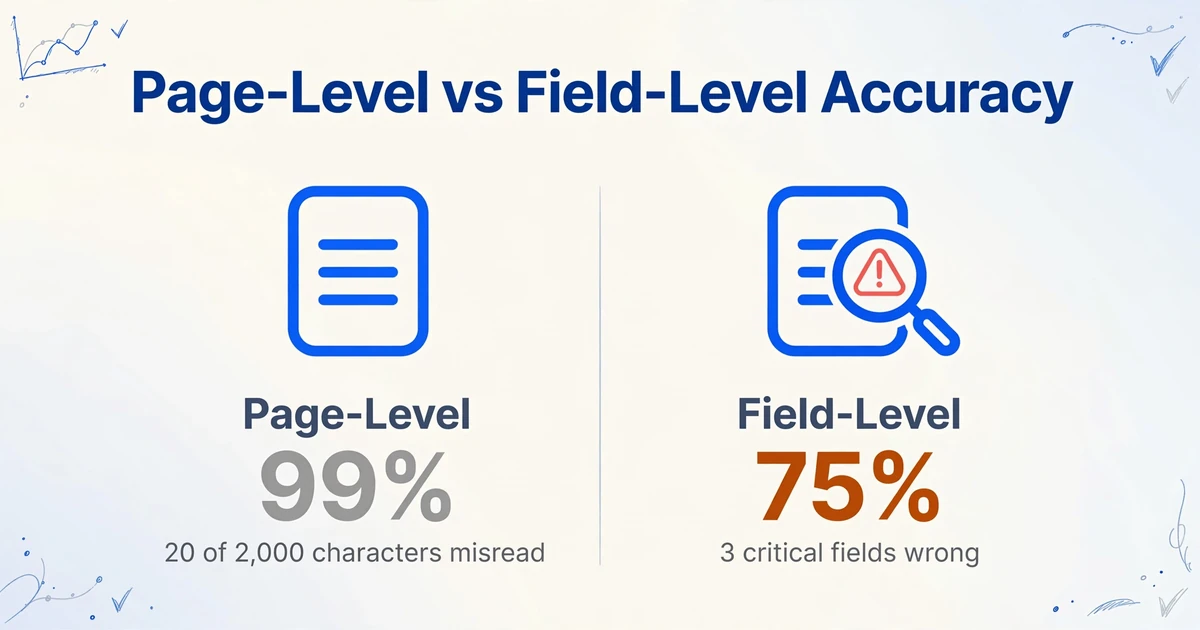
Précision au niveau de la page — les 98-99 % que vous voyez sur les sites des fournisseurs — mesure combien de caractères individuels ont été lus correctement parmi tous les caractères de la page. Si une facture contient 2 000 caractères et que l'OCR en lit mal 20, la précision au niveau de la page est de 99 %. Ça semble excellent. Mais si ces 20 caractères se trouvent être le numéro de facture (INV-2456 lu comme INV-2465), le total de la facture ($17 820 lu comme $17 280) et les conditions de paiement (Net 30 lu comme Net 3), vous avez trois échecs au niveau du champ qui entraîneront des erreurs de paiement — tandis que le tableau de bord du fournisseur affiche toujours 99 % de précision.
La précision au niveau du champ est ce qui compte réellement. Elle mesure si chaque champ de données individuel — numéro de facture, date, total, lignes d'articles, montant de la taxe, nom du fournisseur — a été extrait correctement, dans son intégralité. Un seul chiffre mal lu dans un numéro de facture de 10 caractères rend ce champ incorrect. La précision au niveau du champ est toujours inférieure à la précision au niveau de la page, et l'écart se creuse considérablement sur les factures désordonnées. Un score de 99 % au niveau de la page peut masquer un score de 75 % au niveau du champ si les erreurs d'OCR se concentrent sur les champs financièrement significatifs.
Pourquoi les fournisseurs utilisent la précision au niveau de la page : C'est un chiffre plus élevé, plus facile à comparer de manière cohérente (chaque système OCR le produit), et cela ne nécessite pas de savoir quels champs comptent pour votre entreprise. La précision au niveau du champ exige de tester avec vos documents réels et vos définitions de champs réelles. C'est plus difficile à faire — c'est pourquoi la plupart des équipes ne le font jamais, et pourquoi la plupart des implémentations « précises à 99 % » produisent des résultats décevants en production.
Le seul chiffre de précision qui compte pour votre flux de travail AP est la précision au niveau du champ, mesurée sur vos factures réelles avec vos champs d'extraction réels. Tout le reste est une approximation grossière qui sera erronée dans le sens de l'optimisme.
De quoi dépend la précision — Ce que vous contrôlez vs. Ce que l'IA contrôle
La précision d'extraction est le produit de deux systèmes en interaction : la qualité physique du document entrant dans l'IA et la capacité du modèle d'IA à interpréter ce qu'il voit. La plupart des guides sur la précision se concentrent uniquement sur le second système en ignorant le premier — alors que c'est celui que vous pouvez améliorer dès cet après-midi sans changer d'outils.
Facteurs que vous contrôlez — le pipeline documentaire :
- Résolution. En dessous de 200 DPI, les caractères se fondent les uns dans les autres et les moteurs d'OCR commencent à deviner. L'analyse de la reconnaissance d'écriture manuscrite par PDFExcel recommande 400-600 DPI pour le contenu manuscrit. Pour les factures imprimées, 300 DPI est le minimum pratique. Les PDF scannés à 150 DPI — courants pour les documents d'archives plus anciens — produiront des résultats sensiblement moins bons, quelle que soit la qualité de l'IA.
- Mode couleur. Les scans en noir et blanc (bitonaux) suppriment les subtiles différences de nuances qui distinguent des caractères similaires. Les recherches OCR sur l'écriture manuscrite de Grooper confirment que les scans couleur donnent de meilleurs résultats que le noir et blanc — l'IA a besoin de ces données supplémentaires, surtout pour les annotations manuscrites, les tampons et les filigranes qui chevauchent les champs financiers.
- État du document. Les plis, les ombres, l'inclinaison (pages penchées) et les artefacts de compression dégradent la reconnaissance. Un scan à plat d'une facture imprimée impeccable est une entrée quasi parfaite. Une photo de la même facture prise en angle avec un téléphone sous un éclairage de bureau est nettement moins bonne. Les documents re-scannés — copies de copies — aggravent le problème. La plupart des équipes AP ne contrôlent pas l'état dans lequel les factures arrivent, mais elles peuvent contrôler si elles scannent à 150 DPI en N&B ou à 300 DPI en couleur.
- Cohérence du format. Une page unique vs. plusieurs pages, tableaux intégrés vs. pièces jointes ajoutées, PDF natif vs. image scannée enregistrée en PDF — tout cela modifie ce que l'IA voit. Un PDF natif contient du texte sélectionnable que l'IA peut lire directement. Un PDF scanné est une image de texte qui doit d'abord être reconnue, puis interprétée. La même facture fournisseur arrivant un mois en PDF natif et le mois suivant en image scannée produira une précision différente, même si le contenu est identique.
Facteurs que l'IA contrôle — la couche de reconnaissance :
- Extraction par modèle vs sans modèle. Les systèmes basés sur des modèles recherchent les données à des positions fixes (« le numéro de facture se trouve aux coordonnées x:420, y:180 »). Ils échouent lorsque le fournisseur modifie sa mise en page — et les fournisseurs changent constamment de mise en page, comme le documente l'analyse de LlamaIndex sur la variabilité des factures réelles. L'IA sans modèle lit de manière sémantique — elle comprend que « la valeur à côté du libellé 'N° de facture' est le numéro de facture », peu importe où il apparaît. L'approche par modèle est plus rapide et moins chère, mais ne fonctionne que pour des formats stables. L'approche sans modèle gère la variabilité, mais coûte plus cher par page.
- OCR vs modèles vision-langage. L'OCR traditionnel convertit l'image en texte, mais ne comprend pas le texte. Un modèle vision-langage (VLM) lit le document comme un humain : il voit la mise en page, comprend quels champs sont sémantiquement liés, et sait que « Total dû » et « Montant à payer » signifient la même chose sur différentes factures. Pour les factures imprimées et structurées, l'OCR seul peut atteindre une haute précision. Pour les factures avec des annotations manuscrites, des tampons chevauchant le texte, du contenu multilingue ou des mises en page irrégulières — des éléments invisibles pour l'OCR — un VLM est nécessaire pour atteindre une précision >95 % au niveau des champs.
- Apprentissage spécifique au fournisseur. La précision s'améliore avec la répétition. Precoro note qu'après avoir traité 10 à 20 factures du même fournisseur, les systèmes d'IA développent des schémas d'extraction fiables pour ce format. La première facture d'un nouveau fournisseur peut être extraite avec une précision de 90 %. La vingtième du même fournisseur peut atteindre 98 %. C'est pourquoi les benchmarks de précision sur des « factures diverses aléatoires » sont inférieurs à la précision en production stable — et pourquoi les équipes qui évaluent des outils sur 5 factures de test doivent s'attendre à des chiffres inférieurs à ceux qu'elles obtiendront après 3 mois d'utilisation en production.
Précision par type de facture — à quoi s'attendre avec les PDF propres, les notes manuscrites, les copies carbone et les formats mixtes
Toutes les factures ne se valent pas, et appliquer une même attente de précision à toutes est le moyen le plus rapide de mal évaluer un outil. Voici à quoi vous attendre selon le type de facture, sur la base de ce qui est techniquement réalisable aujourd'hui — et non de ce que prétend le marketing des fournisseurs :
| Type de facture | Précision réaliste au niveau des champs | Ce qui la limite | Meilleure approche d'extraction |
|---|---|---|---|
| PDF natif propre (numérique) | 97–99 % | Libellés de champs inhabituels, structure multipage inattendue | VLM sans modèle ou OCR entraîné |
| PDF scanné propre (imprimé) | 95–98 % | Résolution du scan, légère inclinaison, confusions de caractères OCR sur les petites polices | VLM avec prétraitement OCR |
| Imprimé + annotations manuscrites | 88–95 % | Écriture manuscrite sur/à côté des champs imprimés, tampons, notes en marge | VLM (l'OCR seul tombe à <70 % sur l'écriture manuscrite) |
| Entièrement manuscrit | 75–90 % | Variabilité de la formation des caractères, écriture cursive, espacement irrégulier, faible contraste | VLM — prévoir une relecture humaine pour les champs critiques |
| Copies carbone / matrice de points | 80–92 % | Faible contraste, caractères cassés, transparence du fond | Scan haute résolution + VLM ; envisager un re-scan à 600 DPI |
| Multilingue / écritures mixtes | 85–95 % | Modèles linguistiques OCR entraînés sur une seule langue, libellés de champs dans une écriture peu familière | VLM avec capacité multilingue |
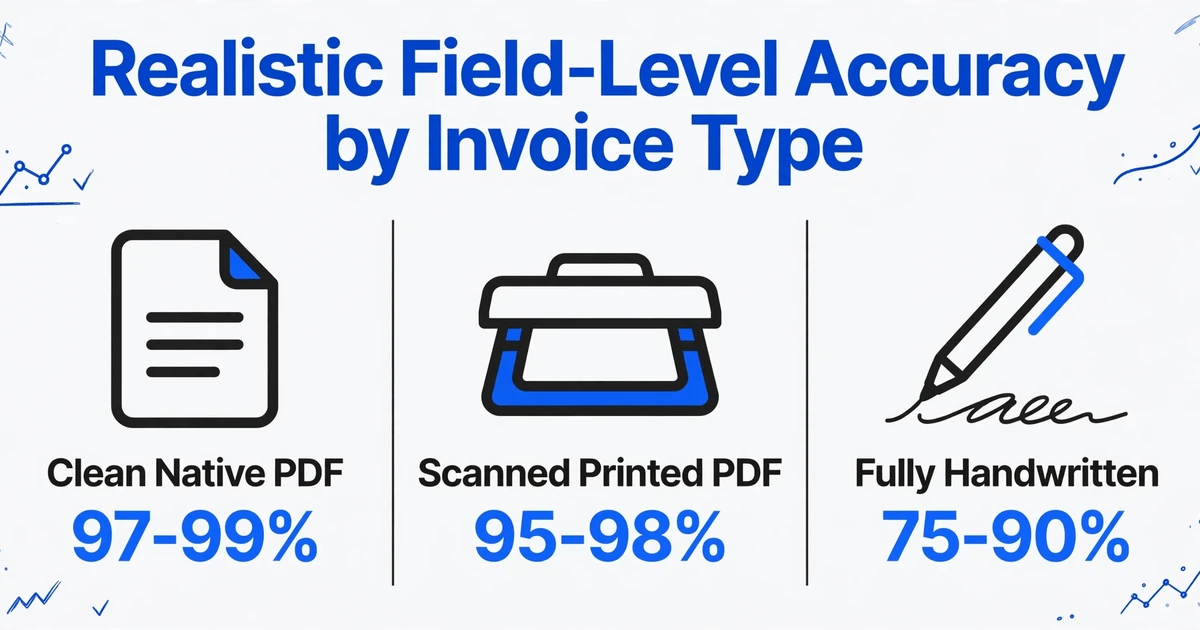
Deux mises en garde importantes concernant ce tableau. Premièrement, la précision est par document, et non par lot. Un lot de 100 factures contiendra des valeurs aberrantes — la facture avec un code QR imprimé directement sur le total, le fournisseur qui a changé sa mise en page en cours de mois — qui obtiendront un score inférieur à la moyenne du lot. Deuxièmement, la précision se cumule entre les champs. Si votre facture comporte 10 champs et que chaque champ a 98 % de chances d'être correct indépendamment, la probabilité que les 10 soient corrects est d'environ 82 % — et ce, avant même de considérer que certains champs sont interdépendants (un mauvais numéro de PO signifie que le rapprochement à trois voies échoue, même si tous les autres champs sont corrects).
Comment réaliser votre propre test de précision — 20 factures, un après-midi
Les promesses de précision des fournisseurs reposent sur les factures des autres. Le seul chiffre de précision auquel vous devriez faire confiance est celui que vous avez mesuré vous-même. Voici un protocole pratique qui prend un après-midi et produit un chiffre sur lequel agir :
Étape 1 : Sélectionnez 20 factures. Pas vos 20 plus propres. Pas vos 20 plus récentes. Choisissez un échantillon représentatif : 10 de vos fournisseurs les plus importants (ceux que vous traitez chaque mois), 5 de fournisseurs occasionnels aux formats variés, 3 avec annotations manuscrites ou tampons, et 2 qui ont historiquement posé problème. Incluez au moins une facture multipage et au moins une facture en langue étrangère si elles existent dans votre flux. L'objectif est un échantillon représentatif de votre mix réel de factures, pas un jeu de démonstration trié sur le volet.
Étape 2 : Définissez votre vérité terrain. Pour chaque facture, saisissez manuellement toutes les valeurs de champs à extraire : numéro de facture, date, date d'échéance, montant total, montant de la TVA, sous-total, nom du fournisseur, numéro de bon de commande, et tout détail de ligne (description, quantité, prix unitaire, total ligne). Faites-le dans un tableur — une ligne par facture, une colonne par champ. C'est votre vérité terrain. Faites vérifier 5 des 20 factures par une deuxième personne pour confirmer l'exactitude. La vérité terrain doit être juste avant de pouvoir mesurer l'extraction.
Étape 3 : Lancez l'extraction. Importez les 20 factures dans l'outil, en spécifiant les mêmes noms de champs que dans votre vérité terrain. Exportez les résultats. Ne nettoyez ni ne modifiez la sortie avant la comparaison — c'est tout l'intérêt du test.
Étape 4 : Comparez champ par champ. Pour chaque facture, comparez chaque champ extrait à la vérité terrain. Un champ est correct si la valeur extraite correspond exactement à la vérité terrain — même format, même contenu. « 17 820 » vs « 17820 » compte comme correct si votre système gère les variations de format en aval. Si cela provoque des échecs d'import, comptez-le comme faux. « 15 janv. 2025 » vs « 2025-01-15 » — même règle. Suivez : quels champs ont échoué, sur quels types de factures, et si l'échec était un manque total (champ vide), un manque partiel (mauvaise valeur), ou une incompatibilité de format (bonne valeur, mauvais format).
Étape 5 : Calculez la précision par champ. Précision par champ = nombre de champs correctement extraits ÷ nombre total de champs sur toutes les factures. Si vos 20 factures ont 10 champs chacune (200 champs au total) et que 15 champs sont faux, votre précision par champ est de 92,5 %. C'est le chiffre qui compte. Calculez aussi le rappel — parmi tous les champs qui auraient dû être extraits, quel pourcentage a été trouvé ? (Un champ vide alors qu'il ne devrait pas l'être est un échec de rappel.) Et la précision — parmi tous les champs extraits, quel pourcentage était correct ?
Le test qui change tout : importez d'abord vos 3 factures historiquement problématiques. Si un outil les gère bien, il gérera les factures propres. S'il échoue sur les factures problématiques, vous découvrez le mode d'échec avant de vous engager. La plupart des processus d'évaluation font l'inverse — commencer par des factures propres, voir 99 %, prendre la décision d'achat, puis découvrir les factures problématiques plus tard. Inversez l'ordre.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Quand « assez bon » suffit — seuils de précision selon le volume de factures
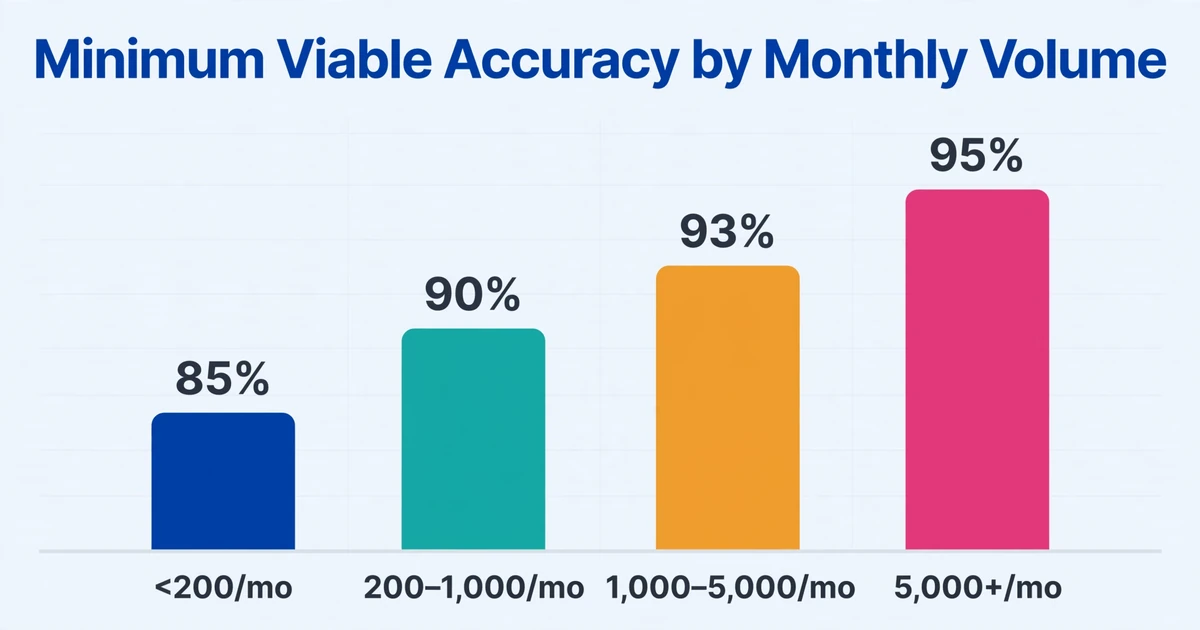
La précision dont vous avez besoin dépend de votre volume. À 100 factures par mois, un seul employé AP peut vérifier manuellement chaque champ extrait — même 85 % de précision fait donc gagner un temps considérable, car l'employé relit au lieu de saisir. À 5 000 factures par mois, une précision de 85 % au niveau des champs signifie que 750 factures comportent au moins une erreur. L'équipe ne peut pas toutes les vérifier. Les erreurs qui passent deviennent des paiements, et les corrections coûtent plus cher que ce que l'extraction a permis d'économiser.
Seuils de précision selon le volume (au niveau des champs) :
| Volume mensuel | Précision minimale viable | Précision cible | Stratégie |
|---|---|---|---|
| <200 | 85 % | 95 % | Extraction + vérification ponctuelle des champs critiques uniquement. Les erreurs sont faciles à détecter. |
| 200–1 000 | 90 % | 96 % | Extraction + vérification de tous les totaux et numéros de facture. Tolérer les erreurs de format mineures. |
| 1 000–5 000 | 93 % | 97 % | Extraction + règles de validation automatisées. Revue humaine uniquement sur les exceptions signalées. |
| 5 000+ | 95 % | 98 %+ | Extraction + validation automatisée + intégration ERP. Les erreurs se cumulent à ce volume. |
L'asymptote des 98 %. Au-delà de 98 % de précision au niveau des champs, chaque gain supplémentaire exige un investissement exponentiellement plus important — un meilleur équipement de numérisation, des exigences de format fournisseur plus strictes, des règles de validation intégrées, des gestionnaires d'exceptions dédiés. Viser 99,5 % n'en vaut presque jamais la peine, sauf si vous traitez plus de 10 000 factures par mois et que la conformité réglementaire exige une quasi-perfection. Le coût des 1,5 % de précision restants dépasse généralement le coût de la gestion des erreurs qu'ils permettraient d'éviter.
Ce qui importe plus que d'atteindre un chiffre absolu, c'est de tendre dans la bonne direction. Une équipe qui passe de 88 % à 94 % de précision des champs en trois mois gagne. Une équipe bloquée à 99 % de précision au niveau de la page avec 20 % de champs erronés perd — elle ne le sait tout simplement pas encore parce qu'elle mesure le mauvais indicateur.
Améliorer la précision sans acheter un autre outil
Si votre précision est inférieure à celle attendue, changer d'outil est rarement la première solution. La plupart des problèmes de précision peuvent être résolus en modifiant ce qui entre dans l'outil et la façon dont vous demandez les données — le côté entrée et le côté instructions. Ces changements ne coûtent rien et fonctionnent avec n'importe quel système d'extraction.
Côté entrée — améliorez ce que l'IA voit :
- Numérisez à 300 DPI minimum en couleur. À lui seul, ce réglage peut faire varier la précision au niveau des champs de 5 à 10 points de pourcentage sur les factures numérisées. De nombreux services AP numérisent à 150-200 DPI en noir et blanc pour des raisons de taille de fichier. La différence de taille de fichier (5 Mo contre 1 Mo) est négligeable par rapport au coût de main-d'œuvre lié à la correction des erreurs d'extraction.
- Redressez et alignez. Si les factures arrivent de travers (courant avec les photos prises au téléphone et les numérisations rapides), l'IA doit faire pivoter et réinterpréter la géométrie de la page. Une image redressée élimine cette surcharge. La plupart des logiciels de numérisation incluent un redressement automatique ; activez-le.
- Évitez les re-numérisations. Une facture qui a été imprimée, numérisée, envoyée par e-mail, imprimée à nouveau, puis numérisée à nouveau accumule les artefacts de chaque génération. Si vous avez accès au PDF numérique d'origine, utilisez-le. Le document de première génération s'extrait toujours mieux que le Nième.
- Séparez correctement les factures multipages. Si la page 1 d'une facture de 3 pages est séparée des pages 2-3 lors du téléversement, l'IA voit un document partiel. La page 1 peut contenir l'en-tête, mais la page 3 contient les totaux. Les outils de téléversement par lot qui combinent les fichiers en une seule unité de traitement gèrent cela automatiquement.
Côté instructions — demandez les données plus précisément :
- Utilisez des noms de champs explicites. « Invoice Number » est extrait plus fiablement que « Inv # » car l'IA recherche des libellés sémantiquement correspondants. « Total Amount » est préférable à « Total ». « Tax Amount » est préférable à « Tax ». Des noms ambigus forcent l'IA à deviner quel champ vous voulez dire, et deviner introduit des erreurs.
- Décomposez les champs complexes en champs atomiques. Au lieu de demander « Vendor Address » comme un seul champ, demandez « Vendor Street », « Vendor City », « Vendor State », « Vendor ZIP » séparément. L'IA peut localiser chaque composant avec précision plutôt que de deviner où un champ se termine et où le suivant commence.
- Utilisez le calcul par nom de colonne pour les valeurs dérivées. Si le document affiche un « Total » qui inclut la taxe, mais que vous avez besoin d'un sous-total hors taxe qui n'est pas imprimé, un nom de colonne comme « Subtotal (Total − Tax Amount) » indique à l'IA de calculer le champ manquant à partir des données disponibles. C'est plus fiable que d'attendre de l'IA qu'elle devine une valeur non libellée — et transforme les échecs d'extraction (champ manquant) en succès (champ calculé).
- Standardisez le nommage des fournisseurs. Si votre outil d'extraction peut apprendre de l'historique, utilisez toujours le même nom de fournisseur pour le même prestataire. « Acme Corp », « Acme Corporation » et « Acme Corp. » sont trois fournisseurs différents pour un système de correspondance de modèles. La cohérence de vos noms de champs et de vos données de référence améliore la cohérence de l'extraction.
L'effet cumulé de ces changements est souvent plus important que la différence de précision de base entre le fournisseur A et le fournisseur B. Une équipe qui optimise la qualité des entrées et les définitions de champs peut atteindre 95 % de précision des champs avec un outil médiocre. Une équipe qui envoie des photos brutes prises au téléphone au meilleur outil du marché peut obtenir 85 %. L'outil compte — mais la façon dont vous l'alimentez compte davantage.
Pour vous aider à choisir la bonne approche d'extraction pour votre mix de factures, consultez notre comparaison des outils d'extraction de factures par IA. Pour le contexte plus large de la façon dont la saisie manuelle des données est devenue le goulot d'étranglement structurel qui rend la précision si critique, consultez notre analyse de pourquoi les équipes AP comptent encore sur la saisie manuelle des factures.