Cómo obtener datos fiables de facturas desordenadas,
inconsistentes: una guía práctica de precisión
Todo proveedor de extracción de facturas con IA promete un 99 % de precisión. Pero cuando usted sube sus facturas reales —las que tienen notas manuscritas en los márgenes, sellos en tres idiomas y tablas que continúan en la página 2—, el resultado se acerca más al 85 %. La diferencia no es un fraude. Es la diferencia entre la precisión a nivel de página (la cifra de marketing) y la precisión a nivel de campo (la cifra que determina si su empleado de AP confía en el resultado o vuelve a teclear todo). A continuación le explicamos cómo entender esa diferencia, medirla en sus propios documentos y cerrar la brecha.
Conclusiones clave
- El «99 % de precisión» del panel del proveedor cuenta caracteres, no campos: tres dígitos mal leídos pueden significar un total de factura incorrecto, una fecha de vencimiento omitida y una coincidencia de PO fallida a la vez, mientras el medidor indica que todo está bien.
- Escanear sus facturas a 300 DPI en color en lugar de 150 DPI en blanco y negro desplaza la precisión a nivel de campo entre 5 y 10 puntos porcentuales, más que la diferencia entre dos proveedores de IA competidores.
- Sube primero sus tres facturas más difíciles —las que tienen sellos que cubren los totales y escritura a mano en los márgenes— porque si ImageToTable.ai maneja esas, maneja todo; si empieza con las limpias, estará midiendo el rendimiento de la demostración, no la precisión de producción.
«99% de precisión» es un número de marketing. Esto es lo que realmente significa.
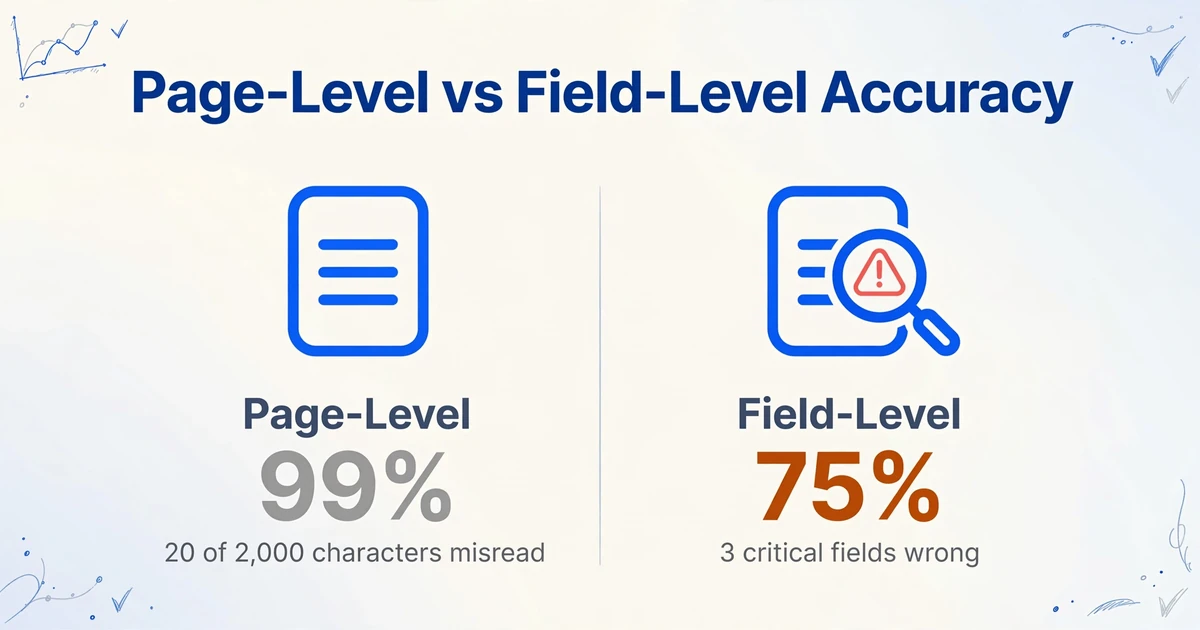
Existen dos números de precisión en la extracción de facturas, y significan cosas completamente distintas. La confusión entre ambos es la mayor fuente de decepción cuando los equipos pasan de las demostraciones de los proveedores a las facturas reales.
Precisión a nivel de página — el 98-99% que ve en los sitios web de los proveedores — mide cuántos caracteres individuales se leyeron correctamente de todos los caracteres de la página. Si una factura tiene 2.000 caracteres y el OCR lee mal 20 de ellos, la precisión a nivel de página es del 99%. Suena genial. Pero si esos 20 caracteres resultan ser el número de factura (INV-2456 leído como INV-2465), el total de la factura ($17.820 leído como $17.280) y las condiciones de pago (Net 30 leído como Net 3), usted tiene tres fallos a nivel de campo que causarán errores de pago — mientras que el panel del proveedor aún reporta un 99% de precisión.
Precisión a nivel de campo es lo que realmente importa. Mide si cada campo de datos individual — número de factura, fecha, total, partidas, monto de impuestos, nombre del proveedor — se extrajo correctamente y por completo. Un solo dígito mal leído en un número de factura de 10 caracteres hace que ese campo sea incorrecto. La precisión a nivel de campo siempre es menor que la precisión a nivel de página, y la brecha se amplía drásticamente en facturas desordenadas. Una puntuación del 99% a nivel de página puede ocultar una puntuación del 75% a nivel de campo si los errores del OCR se agrupan en los campos financieramente significativos.
Por qué los proveedores usan la precisión a nivel de página: Es un número más alto, es más fácil de comparar de manera consistente (todo sistema de OCR lo genera) y no requiere saber qué campos son importantes para su negocio. La precisión a nivel de campo requiere probar con sus documentos reales y sus definiciones de campos reales. Eso es más difícil de hacer — por eso la mayoría de los equipos nunca lo hacen, y por eso la mayoría de las implementaciones «99% precisas» producen resultados decepcionantes en producción.
El único número de precisión que importa para su flujo de trabajo de AP es la precisión a nivel de campo medida en sus facturas reales con sus campos de extracción reales. Todo lo demás es una aproximación aproximada que fallará en la dirección del optimismo.
De qué depende la precisión — lo que tú controlas vs. lo que controla la IA
La precisión de la extracción es el resultado de dos sistemas que interactúan: la calidad física del documento que ingresa a la IA y la capacidad del modelo de IA para interpretar lo que ve. La mayoría de las guías de precisión se centran exclusivamente en el segundo sistema, ignorando el primero, que es el que puedes mejorar esta misma tarde sin cambiar de herramientas.
Factores que controlas tú — el flujo del documento:
- Resolución. Por debajo de 200 DPI, los caracteres se difuminan entre sí y los motores de OCR empiezan a adivinar. El análisis de PDFExcel sobre reconocimiento de escritura a mano recomienda 400-600 DPI para contenido manuscrito. Para facturas impresas, 300 DPI es el mínimo práctico. Los PDF escaneados a 150 DPI — común en documentos archivados antiguos — producirán resultados notablemente peores, sin importar lo buena que sea la IA.
- Modo de color. Los escaneos en blanco y negro (bitonales) eliminan las sutiles diferencias de sombreado que distinguen caracteres similares. La investigación de Grooper sobre OCR de escritura a mano confirma que los escaneos a color producen mejores resultados que los de blanco y negro: la IA necesita los datos adicionales, especialmente para anotaciones manuscritas, sellos y marcas de agua que se superponen con campos financieros.
- Estado del documento. Los pliegues, sombras, inclinación (páginas torcidas) y artefactos de compresión degradan el reconocimiento. Un escaneo de superficie plana de una factura impresa impecable es una entrada casi perfecta. Una foto de la misma factura tomada en ángulo con un teléfono bajo luz de oficina es sustancialmente peor. Los documentos reescaneados — copias de copias — agravan el problema. La mayoría de los equipos de cuentas por pagar no controlan el estado en que llegan las facturas, pero sí pueden controlar si escanean a 150 DPI en blanco y negro o a 300 DPI a color.
- Consistencia del formato. Una página vs. varias páginas, tablas incrustadas vs. anexos adjuntos, PDF nativo vs. imagen escaneada guardada como PDF — todo esto cambia lo que ve la IA. Un PDF nativo contiene texto seleccionable que la IA puede leer directamente. Un PDF escaneado es una imagen de texto que primero debe reconocerse y luego interpretarse. La misma factura de un proveedor que llega como PDF nativo un mes y como imagen escaneada al siguiente producirá una precisión diferente, aunque el contenido sea idéntico.
Factores que controla la IA — la capa de reconocimiento:
- Extracción con plantilla vs. sin plantilla. Los sistemas basados en plantillas buscan datos en posiciones fijas ("el número de factura está en las coordenadas x:420, y:180"). Fallan cuando el proveedor cambia su diseño — y los proveedores cambian diseños constantemente, como documenta el análisis de LlamaIndex sobre la variabilidad real de las facturas. La IA sin plantilla lee semánticamente: entiende que "el valor junto a la etiqueta 'Factura N°' es el número de factura" sin importar dónde aparezca. El método con plantilla es más rápido y barato, pero solo funciona con formatos estables. El método sin plantilla maneja la variabilidad, pero cuesta más por página.
- OCR vs. modelos de lenguaje visual. El OCR tradicional convierte imagen → texto, pero no comprende el texto. Un modelo de lenguaje visual (VLM) lee el documento como un humano: ve el diseño, entiende qué campos están relacionados semánticamente y sabe que "Total a Pagar" y "Monto Adeudado" significan lo mismo en distintas facturas. Para facturas impresas y estructuradas, el OCR solo puede lograr alta precisión. Para facturas con notas manuscritas, sellos que superponen montos, contenido multilingüe o diseños irregulares — elementos adicionales invisibles para el OCR — se necesita un VLM para alcanzar >95% de precisión a nivel de campo.
- Aprendizaje específico por proveedor. La precisión mejora con la repetición. Precoro señala que después de procesar 10-20 facturas del mismo proveedor, los sistemas de IA desarrollan patrones de extracción confiables para ese formato. La primera factura de un nuevo proveedor puede extraerse con un 90% de precisión. La vigésima del mismo proveedor puede alcanzar el 98%. Por eso los puntos de referencia de precisión con "facturas diversas aleatorias" son más bajos que la precisión en producción estable — y por qué los equipos que evalúan herramientas con 5 facturas de prueba deben esperar números más bajos que los que verán tras 3 meses de uso en producción.
Precisión por tipo de factura: qué esperar de PDF limpios, notas manuscritas, copias carbón y formatos mixtos
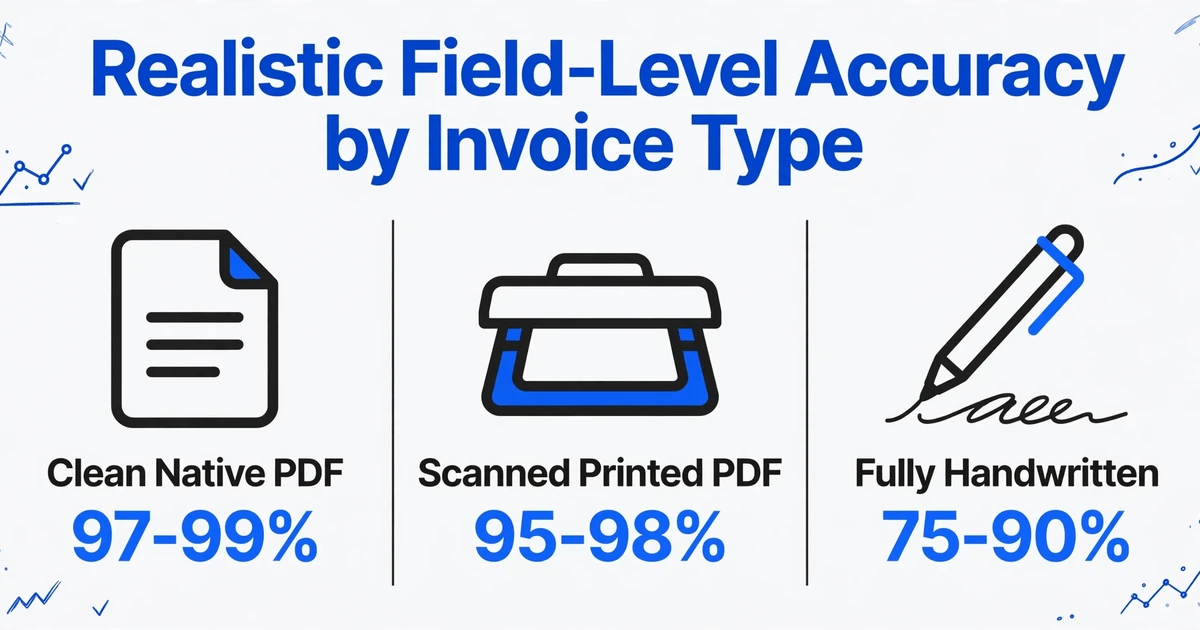
No todas las facturas son iguales, y aplicar una única expectativa de precisión a todas ellas es la forma más rápida de juzgar mal una herramienta. Esto es lo que puede esperar según el tipo de factura, basado en lo que técnicamente es alcanzable hoy en día, no en lo que afirma el marketing de los proveedores:
| Tipo de factura | Precisión realista a nivel de campo | Qué la limita | Mejor enfoque de extracción |
|---|---|---|---|
| PDF nativo limpio (digital) | 97–99% | Etiquetas de campo inusuales, estructura inesperada de varias páginas | VLM sin plantilla u OCR entrenado |
| PDF escaneado limpio (impreso) | 95–98% | Resolución de escaneo, ligera inclinación, confusión de caracteres OCR en fuentes pequeñas | VLM con preprocesamiento OCR |
| Impreso + anotaciones manuscritas | 88–95% | Escritura a mano sobre o junto a campos impresos, sellos, notas al margen | VLM (el OCR solo cae a <70% en escritura a mano) |
| Totalmente manuscrito | 75–90% | Variabilidad en la formación de caracteres, cursiva, espaciado inconsistente, bajo contraste | VLM: acepte revisión humana para campos críticos |
| Copias carbón / matriz de puntos | 80–92% | Bajo contraste, caracteres rotos, sangrado del fondo | Escaneo de alta resolución + VLM; considere reescanear a 600 DPI |
| Multilingüe / escritura mixta | 85–95% | Modelos de lenguaje OCR entrenados en un solo idioma, etiquetas de campo en escritura desconocida | VLM con capacidad multilingüe |
Dos advertencias importantes sobre esta tabla. Primero, la precisión es por documento, no por lote. Un lote de 100 facturas contendrá valores atípicos — la factura con un código QR impreso directamente sobre el total, el proveedor que cambió su diseño a mitad de mes — que puntúan más bajo que el promedio del lote. Segundo, la precisión se acumula entre campos. Si su factura tiene 10 campos y cada campo tiene un 98% de probabilidad de ser correcto de forma independiente, la probabilidad de que los 10 sean correctos es aproximadamente del 82% — y eso antes de considerar que algunos campos son interdependientes (un número de PO incorrecto significa que la conciliación de tres vías falla incluso si todos los demás campos son correctos).
Cómo hacer tu propia prueba de precisión — 20 facturas, una tarde
Las afirmaciones de precisión de los proveedores se basan en facturas ajenas. El único número de precisión en el que deberías confiar es el que tú mismo midas. Aquí tienes un protocolo práctico que te llevará una tarde y te dará un número sobre el que actuar:
Paso 1: Selecciona 20 facturas. No las 20 más limpias ni las 20 más recientes. Elige una muestra representativa: 10 de tus proveedores de mayor volumen (los que procesas cada mes), 5 de proveedores ocasionales con formatos variados, 3 con anotaciones manuscritas o sellos, y 2 que históricamente hayan dado problemas. Incluye al menos una factura de varias páginas y al menos una en otro idioma si existen en tu flujo de trabajo. El objetivo es una muestra que refleje tu mezcla real de facturas, no un conjunto de demostración seleccionado.
Paso 2: Define tu verdad absoluta. Para cada factura, registra manualmente todos los campos que quieras extraer: número de factura, fecha, fecha de vencimiento, importe total, importe de impuestos, subtotal, nombre del proveedor, número de OC y cualquier detalle de líneas (descripción, cantidad, precio unitario, total de línea). Hazlo en una hoja de cálculo — una fila por factura, una columna por campo. Esta es tu verdad absoluta. Pide a otra persona que verifique 5 de las 20 para asegurarse de que la verdad absoluta es correcta. La verdad absoluta debe ser correcta antes de medir la extracción.
Paso 3: Ejecuta la extracción. Sube las 20 facturas a la herramienta, especificando los mismos nombres de campo que definiste en tu verdad absoluta. Exporta los resultados. No limpies ni modifiques la salida antes de comparar — ese es el objetivo de la prueba.
Paso 4: Compara campo por campo. Para cada factura, compara cada campo extraído con la verdad absoluta. Un campo es correcto si el valor extraído coincide exactamente con la verdad absoluta — mismo formato, mismo contenido. "17,820" vs "17820" cuenta como correcto si tu sistema puede manejar variaciones de formato en el procesamiento posterior. Si causa errores de importación, considéralo incorrecto. "15 ene 2025" vs "2025-01-15" — misma regla. Registra: qué campos fallaron, en qué tipos de factura, y si el fallo fue una omisión total (campo vacío), parcial (valor incorrecto) o de formato (valor correcto, formato incorrecto).
Paso 5: Calcula la precisión a nivel de campo. Precisión por campo = número de campos extraídos correctamente ÷ número total de campos en todas las facturas. Si tus 20 facturas tienen 10 campos cada una (200 campos en total) y 15 son incorrectos, tu precisión por campo es del 92.5%. Ese es el número que importa. También calcula la exhaustividad — de todos los campos que debían extraerse, ¿qué porcentaje se encontró? (Un campo en blanco cuando no debería serlo es un fallo de exhaustividad). Y la precisión — de todos los campos extraídos, ¿qué porcentaje fue correcto?
La prueba que lo cambia todo: sube primero tus 3 facturas problemáticas. Si una herramienta las maneja bien, manejará las limpias. Si falla en las problemáticas, aprendes el modo de fallo antes de comprometerte. La mayoría de las evaluaciones hacen lo contrario — empiezan con facturas limpias, ven un 99%, toman la decisión de compra, y luego descubren las facturas problemáticas. Invierte el orden.
Los archivos se procesan de forma segura y no se almacenan.
Cuándo «suficientemente bueno» es suficiente: umbrales de precisión según el volumen de facturas
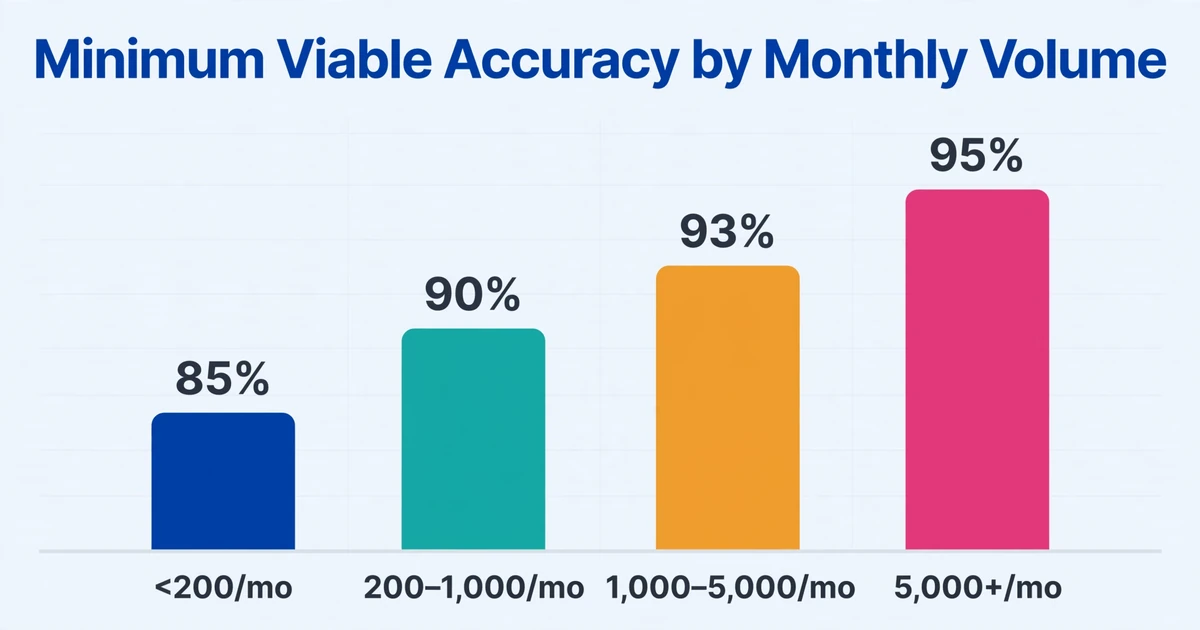
La precisión que necesita depende de su volumen. Con 100 facturas al mes, un solo auxiliar de AP puede verificar manualmente cada campo extraído; incluso una precisión del 85% ahorra tiempo significativo porque el auxiliar está revisando, no transcribiendo. Con 5,000 facturas al mes, una precisión del 85% a nivel de campo significa que 750 facturas tienen al menos un error. El equipo no puede revisarlas todas. Los errores que pasan se convierten en pagos, y las correcciones cuestan más de lo que ahorró la extracción.
Umbrales de precisión según el volumen (a nivel de campo):
| Volumen mensual | Precisión mínima viable | Precisión objetivo | Estrategia |
|---|---|---|---|
| <200 | 85% | 95% | Extraer y verificar por muestreo solo los campos críticos. Los errores son fáciles de detectar. |
| 200–1,000 | 90% | 96% | Extraer y verificar todos los totales y números de factura. Aceptar errores menores de formato. |
| 1,000–5,000 | 93% | 97% | Extraer con reglas de validación automatizadas. Revisión humana solo de excepciones marcadas. |
| 5,000+ | 95% | 98%+ | Extraer con validación automatizada e integración con ERP. Los errores a este volumen se acumulan. |
La asíntota del 98%. Por encima del 98% de precisión a nivel de campo, mayores avances requieren una inversión exponencialmente mayor: mejor equipo de escaneo, requisitos de formato de proveedor más estrictos, reglas de validación integradas, manejadores de excepciones dedicados. Perseguir el 99,5% casi nunca vale la pena a menos que procese más de 10.000 facturas al mes y el cumplimiento normativo exija una precisión casi perfecta. El costo del último 1,5% de precisión generalmente supera el costo de manejar los errores que evitaría.
Lo que importa más que alcanzar un número absoluto es tender en la dirección correcta. Un equipo que pasa del 88% al 94% de precisión de campos en tres meses está ganando. Un equipo estancado en el 99% de precisión a nivel de página con el 20% de los campos incorrectos está perdiendo; simplemente aún no lo sabe porque está midiendo el número equivocado.
Mejorar la precisión sin comprar otra herramienta
Si su precisión es más baja de lo esperado, cambiar de herramienta rara vez es la primera solución. La mayoría de los problemas de precisión pueden mejorarse cambiando lo que entra en la herramienta y cómo solicita los datos: el lado de entrada y el lado de instrucción. Estos cambios no cuestan nada y funcionan con cualquier sistema de extracción.
En el lado de entrada: mejore lo que ve la IA:
- Escanee a 300 DPI como mínimo y a color. Solo esto puede desplazar la precisión a nivel de campo entre 5 y 10 puntos porcentuales en facturas escaneadas. Muchos departamentos de AP escanean a 150-200 DPI en blanco y negro por razones de tamaño de archivo. La diferencia de tamaño de archivo (5MB frente a 1MB) es irrelevante en comparación con el costo laboral de corregir errores de extracción.
- Enderece y alinee. Si las facturas llegan torcidas (algo común con fotos de teléfono y escaneos rápidos), la IA tiene que rotar y reinterpretar la geometría de la página. Una imagen enderezada elimina esta sobrecarga. La mayoría del software de escaneo incluye enderezado automático; actívelo.
- Evite los reescaneos. Una factura que se ha impreso, escaneado, enviado por correo, impreso de nuevo y escaneado de nuevo lleva los artefactos acumulados de cada generación. Si tiene acceso al PDF digital original, úselo. El documento de primera generación siempre se extrae mejor que el de la enésima.
- Separe correctamente las facturas de varias páginas. Si la página 1 de una factura de 3 páginas se separa de las páginas 2-3 durante la carga, la IA ve un documento parcial. La página 1 puede tener el encabezado, pero la página 3 tiene los totales. Las herramientas de carga por lotes que combinan archivos en una sola unidad de procesamiento manejan esto automáticamente.
En el lado de instrucción: solicite los datos con más precisión:
- Utilice nombres de campos explícitos. "Invoice Number" se extrae de manera más confiable que "Inv #" porque la IA busca etiquetas con coincidencia semántica. "Total Amount" es mejor que "Total". "Tax Amount" es mejor que "Tax". Los nombres ambiguos obligan a la IA a adivinar qué campo quiere decir, y adivinar introduce errores.
- Divida los campos complejos en campos atómicos. En lugar de solicitar "Vendor Address" como un solo campo, solicite "Vendor Street", "Vendor City", "Vendor State" y "Vendor ZIP" por separado. La IA puede localizar cada componente con precisión en lugar de adivinar dónde termina un campo y comienza el siguiente.
- Utilice el cálculo por nombre de columna para valores derivados. Si el documento muestra un "Total" que incluye impuestos, pero usted necesita un subtotal antes de impuestos que no está impreso, un nombre de columna como "Subtotal (Total − Tax Amount)" le indica a la IA que calcule el campo faltante a partir de los datos disponibles. Esto es más confiable que esperar que la IA adivine un valor sin etiqueta, y convierte los fallos de extracción (campo faltante) en éxitos (campo calculado).
- Estandarice el nombre del proveedor. Si su herramienta de extracción puede aprender del historial, use siempre el mismo nombre de proveedor para el mismo suministrador. "Acme Corp", "Acme Corporation" y "Acme Corp." son tres proveedores diferentes para un sistema de coincidencia de patrones. La consistencia en los nombres de sus campos y en los datos de referencia mejora la consistencia en la extracción.
El efecto acumulativo de estos cambios suele ser mayor que la diferencia entre la precisión base del proveedor A y la del proveedor B. Un equipo que optimiza la calidad de entrada y las definiciones de campos puede extraer un 95% de precisión de campos con una herramienta mediocre. Un equipo que lanza fotos de teléfono sin procesar a la mejor herramienta del mercado puede obtener un 85%. La herramienta importa, pero cómo la alimenta importa más.
Para obtener ayuda para seleccionar el enfoque de extracción adecuado para su combinación de facturas, consulte nuestra comparación de herramientas de extracción de facturas con IA. Para el contexto más amplio de cómo la entrada manual de datos se convirtió en el cuello de botella estructural que hace que la precisión sea tan crítica, consulte nuestro análisis de por qué los equipos de AP todavía dependen de la entrada manual de facturas.