Zuverlässige Daten aus unübersichtlichen,
inkonsistenten Rechnungen: Ein praktischer Leitfaden zur Genauigkeit
Jeder KI-Rechnungsextraktionsanbieter verspricht 99 % Genauigkeit. Doch wenn Sie Ihre tatsächlichen Rechnungen hochladen – die mit handschriftlichen Randnotizen, Stempeln in drei Sprachen und Tabellen, die sich auf Seite 2 erstrecken – liegt das Ergebnis eher bei 85 %. Diese Lücke ist kein Betrug. Es ist der Unterschied zwischen Seitengenauigkeit (die Marketing-Kennzahl) und Feldgenauigkeit (die Kennzahl, die darüber entscheidet, ob Ihre AP-Sachbearbeiter der Ausgabe vertrauen oder alles neu eingeben). Hier erfahren Sie, wie Sie den Unterschied verstehen, ihn an Ihren eigenen Dokumenten messen und die Lücke schließen.
Wichtigste Erkenntnisse
- „99 % Genauigkeit“ auf einem Anbieter-Dashboard zählt Zeichen, nicht Felder – drei falsch gelesene Ziffern können gleichzeitig eine falsche Rechnungssumme, ein übersehenes Fälligkeitsdatum und einen fehlerhaften PO-Abgleich bedeuten, während der Zähler anzeigt, dass alles in Ordnung ist.
- Wenn Sie Ihre Rechnungen mit 300 DPI in Farbe statt mit 150 DPI in Schwarzweiß scannen, verschiebt sich die Feldgenauigkeit um 5–10 Prozentpunkte – mehr als der Unterschied zwischen zwei konkurrierenden KI-Anbietern.
- Laden Sie zuerst Ihre drei unansehnlichsten Rechnungen hoch – die mit Stempeln über den Summen und Handschrift in den Rändern – denn wenn ImageToTable.ai diese bewältigt, bewältigt es alles; wenn Sie mit den sauberen beginnen, messen Sie Demo-Leistung, nicht Produktionsgenauigkeit.
„99 % Genauigkeit“ ist eine Marketing-Zahl. Das bedeutet sie tatsächlich.
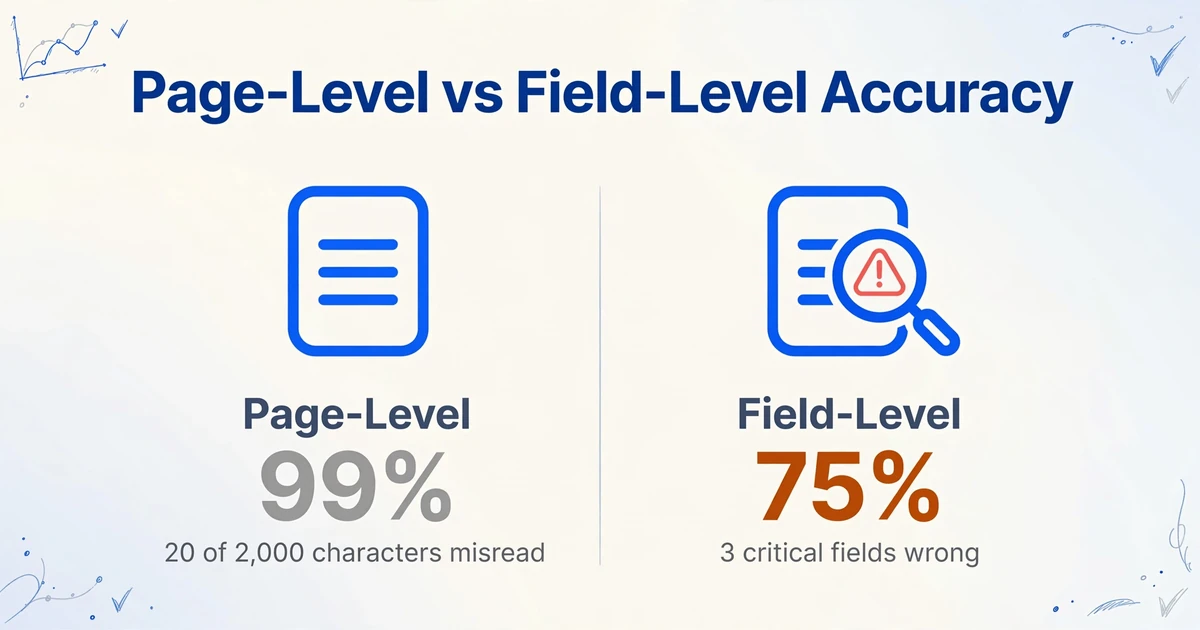
Es gibt zwei Genauigkeitszahlen bei der Rechnungsextraktion, und sie bedeuten völlig unterschiedliche Dinge. Die Verwechslung zwischen ihnen ist die größte Quelle der Enttäuschung, wenn Teams von Verkäufer-Demos zu echten Rechnungen wechseln.
Seitenebene Genauigkeit – die 98-99 %, die Sie auf Verkäufer-Websites sehen – misst, wie viele einzelne Zeichen von allen Zeichen auf der Seite korrekt gelesen wurden. Wenn eine Rechnung 2.000 Zeichen hat und die OCR 20 davon falsch liest, beträgt die Seitenebene-Genauigkeit 99 %. Klingt großartig. Aber wenn diese 20 Zeichen zufällig die Rechnungsnummer (INV-2456 gelesen als INV-2465), die Rechnungssumme ($17.820 gelesen als $17.280) und die Zahlungsbedingungen (Netto 30 gelesen als Netto 3) sind, haben Sie drei Feldebene-Fehler, die Zahlungsfehler verursachen – während das Dashboard des Verkäufers weiterhin 99 % Genauigkeit meldet.
Feldebene Genauigkeit ist das, was tatsächlich zählt. Sie misst, ob jedes einzelne Datenfeld – Rechnungsnummer, Datum, Summe, Positionen, Steuerbetrag, Lieferantenname – vollständig und korrekt extrahiert wurde. Eine einzelne falsch gelesene Ziffer in einer 10-stelligen Rechnungsnummer macht dieses Feld falsch. Die Feldebene-Genauigkeit ist immer niedriger als die Seitenebene-Genauigkeit, und die Lücke wird bei unübersichtlichen Rechnungen dramatisch größer. Ein Seitenebene-Wert von 99 % kann einen Feldebene-Wert von 75 % überdecken, wenn die OCR-Fehler sich zufällig auf die finanziell bedeutenden Felder konzentrieren.
Warum Verkäufer die Seitenebene-Genauigkeit verwenden: Sie ist eine höhere Zahl, sie lässt sich konsistent benchmarken (jedes OCR-System gibt sie aus), und sie erfordert nicht zu wissen, welche Felder für Ihr Unternehmen wichtig sind. Die Feldebene-Genauigkeit erfordert Tests mit Ihren tatsächlichen Dokumenten und Ihren tatsächlichen Felddefinitionen. Das ist schwieriger umzusetzen – weshalb die meisten Teams es nie tun und weshalb die meisten Implementierungen mit „99 % Genauigkeit“ in der Produktion enttäuschende Ergebnisse liefern.
Die einzige Genauigkeitszahl, die für Ihren AP-Workflow zählt, ist die Feldebene-Genauigkeit, gemessen an Ihren tatsächlichen Rechnungen mit Ihren tatsächlichen Extraktionsfeldern. Alles andere ist eine grobe Annäherung, die in Richtung Optimismus falsch liegt.
Wovon die Genauigkeit abhängt – Was Sie beeinflussen können vs. was die KI steuert
Die Extraktionsgenauigkeit ist das Ergebnis zweier zusammenwirkender Systeme: der physischen Qualität des eingehenden Dokuments und der Fähigkeit des KI-Modells, das Gesehene zu interpretieren. Die meisten Ratgeber zur Genauigkeit konzentrieren sich ausschließlich auf das zweite System und ignorieren das erste – dabei können Sie Letzteres noch heute Nachmittag verbessern, ohne Ihre Werkzeuge zu wechseln.
Von Ihnen beeinflussbare Faktoren – die Dokumenten-Pipeline:
- Auflösung. Unter 200 DPI verschwimmen Zeichen ineinander und OCR-Engines beginnen zu raten. PDFExcels Analyse der Handschrifterkennung empfiehlt 400–600 DPI für handschriftliche Inhalte. Für gedruckte Rechnungen sind 300 DPI das praktische Minimum. Mit 150 DPI gescannte PDFs – üblich bei älteren archivierten Dokumenten – liefern unabhängig von der KI-Güte messbar schlechtere Ergebnisse.
- Farbmodus. Schwarz-Weiß-Scans (bitonal) entfernen die feinen Schattierungsunterschiede, die ähnliche Zeichen voneinander unterscheiden. Groopers Forschung zur Handschrift-OCR bestätigt, dass Farbscans bessere Ergebnisse liefern als Schwarz-Weiß – die KI benötigt die zusätzlichen Daten, insbesondere bei handschriftlichen Anmerkungen, Stempeln und Wasserzeichen, die Finanzfelder überlagern.
- Dokumentenzustand. Knicke, Schatten, Schräglage (gekippte Seiten) und Komprimierungsartefakte beeinträchtigen die Erkennung. Ein Flachbettscan einer makellosen gedruckten Rechnung ist nahezu perfekte Eingabe. Ein Foto derselben Rechnung, schräg mit dem Handy unter Bürobeleuchtung aufgenommen, ist deutlich schlechter. Erneut gescannte Dokumente – Kopien von Kopien – verstärken das Problem. Die meisten AP-Teams haben keinen Einfluss auf den Zustand eingehender Rechnungen, aber sie können entscheiden, ob sie mit 150 DPI in S/W oder mit 300 DPI in Farbe scannen.
- Formatkonsistenz. Einseitig vs. mehrseitig, eingebettete Tabellen vs. angehängte Anhänge, natives PDF vs. als PDF gespeichertes Scanbild – all dies verändert, was die KI sieht. Ein natives PDF enthält auswählbaren Text, den die KI direkt lesen kann. Ein gescanntes PDF ist ein Textbild, das erst erkannt und dann interpretiert werden muss. Dieselbe Lieferantenrechnung, die einen Monat als natives PDF und im nächsten als Scanbild eingeht, liefert unterschiedliche Genauigkeit, obwohl der Inhalt identisch ist.
Von der KI gesteuerte Faktoren – die Erkennungsebene:
- Vorlagenbasierte vs. vorlagenfreie Extraktion. Vorlagenbasierte Systeme suchen Daten an festen Positionen („Rechnungsnummer befindet sich an Koordinaten x:420, y:180“). Sie scheitern, wenn der Anbieter sein Layout ändert – und Anbieter ändern Layouts ständig, wie die Analyse von LlamaIndex zur realen Rechnungsvarianz belegt. Vorlagenfreie KI liest semantisch – sie versteht, dass „der Wert neben der Bezeichnung ‚Rechnungsnr.‘ die Rechnungsnummer ist“, unabhängig davon, wo er erscheint. Vorlagenbasiert ist schneller und günstiger, funktioniert aber nur bei stabilen Formaten. Vorlagenfrei bewältigt Variabilität, kostet aber mehr pro Seite.
- OCR vs. Vision-Language-Modelle. Herkömmliche OCR wandelt Bild → Text um, versteht den Text aber nicht. Ein Vision-Language-Modell (VLM) liest das Dokument wie ein Mensch: Es erkennt das Layout, versteht, welche Felder semantisch zusammenhängen, und weiß, dass „Gesamtbetrag“ und „Zahlbetrag“ auf verschiedenen Rechnungen dasselbe bedeuten. Bei gedruckten, strukturierten Rechnungen kann OCR allein hohe Genauigkeit erzielen. Bei Rechnungen mit handschriftlichen Notizen, überlappenden Stempeln, mehrsprachigen Inhalten oder unregelmäßigen Layouts – Zusätze, die für OCR unsichtbar sind – ist ein VLM nötig, um eine Feldgenauigkeit von >95 % zu erreichen.
- Anbieterspezifisches Lernen. Die Genauigkeit verbessert sich mit Wiederholung. Precoro stellt fest, dass KI-Systeme nach der Verarbeitung von 10–20 Rechnungen desselben Anbieters zuverlässige Extraktionsmuster für dieses Format entwickeln. Die erste Rechnung eines neuen Anbieters wird möglicherweise mit 90 % Genauigkeit extrahiert. Die zwanzigste desselben Anbieters kann mit 98 % extrahiert werden. Deshalb sind Genauigkeitsbenchmarks bei „zufälligen, unterschiedlichen Rechnungen“ niedriger als die Genauigkeit im stabilen Produktionsbetrieb – und warum Teams, die Tools mit 5 Testrechnungen bewerten, niedrigere Werte erwarten sollten, als sie nach 3 Monaten Produktionseinsatz sehen werden.
Genauigkeit nach Rechnungstyp – Was Sie bei sauberen PDFs, handschriftlichen Notizen, Durchschlägen und gemischten Formaten erwarten können
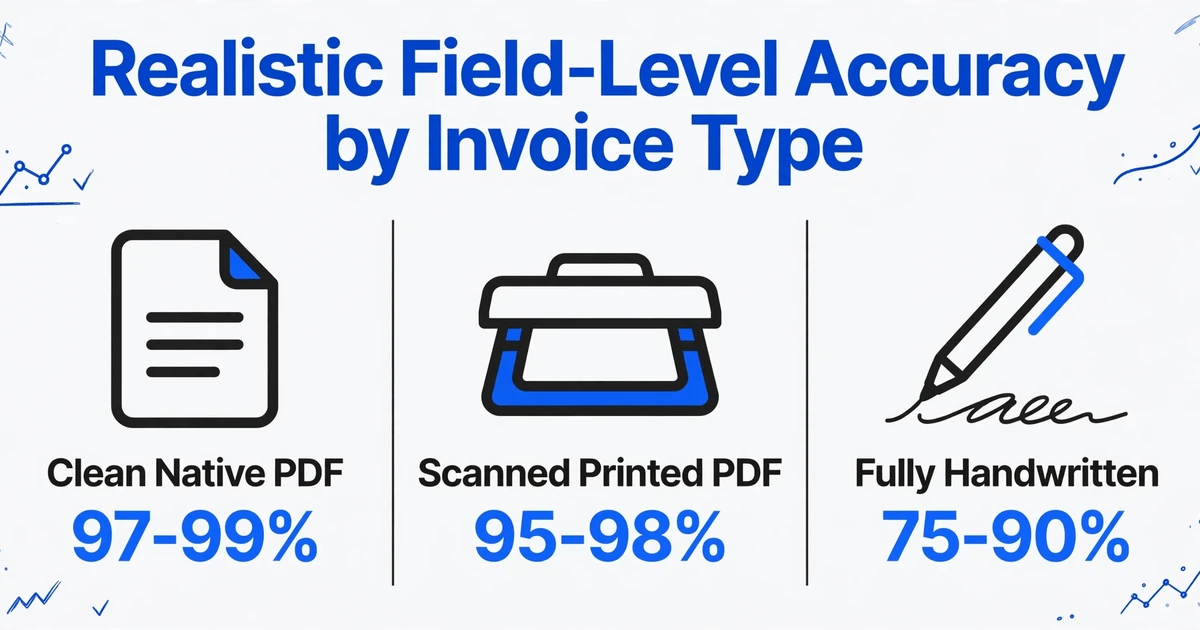
Nicht alle Rechnungen sind gleich, und eine einzige Genauigkeitserwartung auf alle anzuwenden ist der schnellste Weg, ein Tool falsch zu beurteilen. Hier ist, was Sie nach Rechnungstyp erwarten können, basierend auf dem, was heute technisch machbar ist – nicht auf den Behauptungen des Anbieter-Marketings:
| Rechnungstyp | Realistische Feldgenauigkeit | Was die Genauigkeit begrenzt | Bester Extraktionsansatz |
|---|---|---|---|
| Sauberes natives PDF (digital) | 97–99 % | Ungewöhnliche Feldbezeichnungen, unerwartete mehrseitige Struktur | VLM ohne Vorlage oder trainiertes OCR |
| Sauberes gescanntes PDF (gedruckt) | 95–98 % | Scanauflösung, leichte Schräglage, OCR-Zeichenverwechslung bei kleinen Schriftarten | VLM mit OCR-Vorverarbeitung |
| Gedruckt + handschriftliche Anmerkungen | 88–95 % | Handschrift über/neben gedruckten Feldern, Stempel, Randnotizen | VLM (OCR allein fällt bei Handschrift auf <70 %) |
| Vollständig handschriftlich | 75–90 % | Variabilität der Zeichenbildung, Schreibschrift, inkonsistente Abstände, geringer Kontrast | VLM – menschliche Prüfung für kritische Felder einplanen |
| Durchschläge / Nadeldruck | 80–92 % | Geringer Kontrast, unterbrochene Zeichen, durchscheinender Hintergrund | Hochauflösender Scan + VLM; erneutes Scannen mit 600 DPI erwägen |
| Mehrsprachig / gemischte Schriften | 85–95 % | OCR-Sprachmodelle nur für einzelne Sprachen trainiert, Feldbezeichnungen in unbekannter Schrift | VLM mit Mehrsprachfähigkeit |
Zwei wichtige Einschränkungen zu dieser Tabelle. Erstens ist die Genauigkeit pro Dokument und nicht pro Batch zu verstehen. Ein Batch mit 100 Rechnungen enthält Ausreißer – die eine Rechnung mit einem QR-Code, der direkt über der Summe gedruckt ist, der Lieferant, der sein Layout mitten im Monat geändert hat – die niedriger abschneiden als der Batch-Durchschnitt. Zweitens summiert sich die Genauigkeit über die Felder. Wenn Ihre Rechnung 10 Felder hat und jedes Feld unabhängig eine 98-prozentige Chance hat, korrekt zu sein, liegt die Wahrscheinlichkeit, dass alle 10 korrekt sind, bei etwa 82 % – und das bevor berücksichtigt wird, dass einige Felder voneinander abhängig sind (eine falsche PO-Nummer führt dazu, dass der Drei-Wege-Abgleich fehlschlägt, selbst wenn jedes andere Feld stimmt).
So führen Sie Ihren eigenen Genauigkeitstest durch – 20 Rechnungen, ein Nachmittag
Die Genauigkeitsangaben von Anbietern basieren auf fremden Rechnungen. Die einzige Genauigkeitszahl, der Sie vertrauen sollten, ist die, die Sie selbst gemessen haben. Hier ist ein praktischer Ablauf, der einen Nachmittag dauert und eine Zahl liefert, mit der Sie arbeiten können:
Schritt 1: Wählen Sie 20 Rechnungen aus. Nicht Ihre 20 saubersten. Nicht Ihre 20 aktuellsten. Wählen Sie einen repräsentativen Querschnitt: 10 von Ihren umsatzstärksten Lieferanten (die Sie jeden Monat verarbeiten), 5 von gelegentlichen Lieferanten mit unterschiedlichen Formaten, 3 mit handschriftlichen Anmerkungen oder Stempeln und 2, die in der Vergangenheit Probleme bereitet haben. Nehmen Sie mindestens eine mehrseitige Rechnung und mindestens eine nicht-deutsche Rechnung auf, falls diese in Ihrem Workflow vorkommen. Ziel ist eine Stichprobe, die Ihren tatsächlichen Rechnungsmix abbildet, keine herausgesuchte Demogruppe.
Schritt 2: Definieren Sie Ihre Ground Truth. Erfassen Sie für jede Rechnung manuell alle Feldwerte, die Sie extrahieren möchten: Rechnungsnummer, Datum, Fälligkeitsdatum, Gesamtbetrag, Steuerbetrag, Zwischensumme, Lieferantenname, Bestellnummer sowie alle Positionsdetails (Beschreibung, Menge, Einzelpreis, Positionssumme). Tun Sie dies in einer Tabelle – eine Zeile pro Rechnung, eine Spalte pro Feld. Das ist Ihre Ground Truth. Lassen Sie eine zweite Person 5 der 20 Rechnungen stichprobenartig prüfen, um sicherzustellen, dass die Ground Truth korrekt ist. Die Ground Truth muss stimmen, bevor Sie die Extraktion daran messen können.
Schritt 3: Führen Sie die Extraktion durch. Laden Sie die 20 Rechnungen in das Tool hoch und geben Sie dieselben Feldnamen an, die Sie in Ihrer Ground Truth definiert haben. Exportieren Sie die Ergebnisse. Bereinigen oder ändern Sie die Ausgabe vor dem Vergleich nicht – das ist der Sinn des Tests.
Schritt 4: Vergleichen Sie Feld für Feld. Vergleichen Sie für jede Rechnung jedes extrahierte Feld mit der Ground Truth. Ein Feld ist korrekt, wenn der extrahierte Wert exakt mit der Ground Truth übereinstimmt – gleiches Format, gleicher Inhalt. „17.820" vs. „17820" gilt als korrekt, wenn Ihr System Formatabweichungen in der Weiterverarbeitung toleriert. Falls es zu Importfehlern führt, zählen Sie es als falsch. „15. Jan. 2025" vs. „2025-01-15" – gleiche Regel. Verfolgen Sie: Welche Felder sind fehlgeschlagen, bei welchen Rechnungstypen, und war der Fehler ein Totalausfall (leeres Feld), ein Teilausfall (falscher Wert) oder ein Formatfehler (richtiger Wert, falsches Format).
Schritt 5: Berechnen Sie die feldbezogene Genauigkeit. Feldbezogene Genauigkeit = Anzahl korrekt extrahierter Felder ÷ Gesamtzahl der Felder über alle Rechnungen. Wenn Ihre 20 Rechnungen jeweils 10 Felder haben (insgesamt 200 Felder) und 15 Felder falsch sind, beträgt Ihre feldbezogene Genauigkeit 92,5 %. Das ist die Zahl, die zählt. Berechnen Sie auch den Recall – wie viel Prozent der Felder, die hätten extrahiert werden sollen, wurden gefunden? (Ein Feld, das leer ist, obwohl es nicht leer sein sollte, ist ein Recall-Fehler.) Und die Präzision – wie viel Prozent der extrahierten Felder waren korrekt?
Der Test, der alles verändert: Laden Sie zuerst Ihre 3 historisch problematischen Rechnungen hoch. Wenn ein Tool diese gut verarbeitet, wird es auch die sauberen schaffen. Wenn es bei den Problemrechnungen scheitert, erkennen Sie die Fehlerart, bevor Sie sich festlegen. Die meisten Evaluierungsprozesse machen das Gegenteil – beginnen mit sauberen Rechnungen, sehen 99 %, treffen die Kaufentscheidung und entdecken die Problemrechnungen später. Drehen Sie die Reihenfolge um.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wann „gut genug" wirklich gut genug ist – Genauigkeitsschwellen nach Rechnungsvolumen
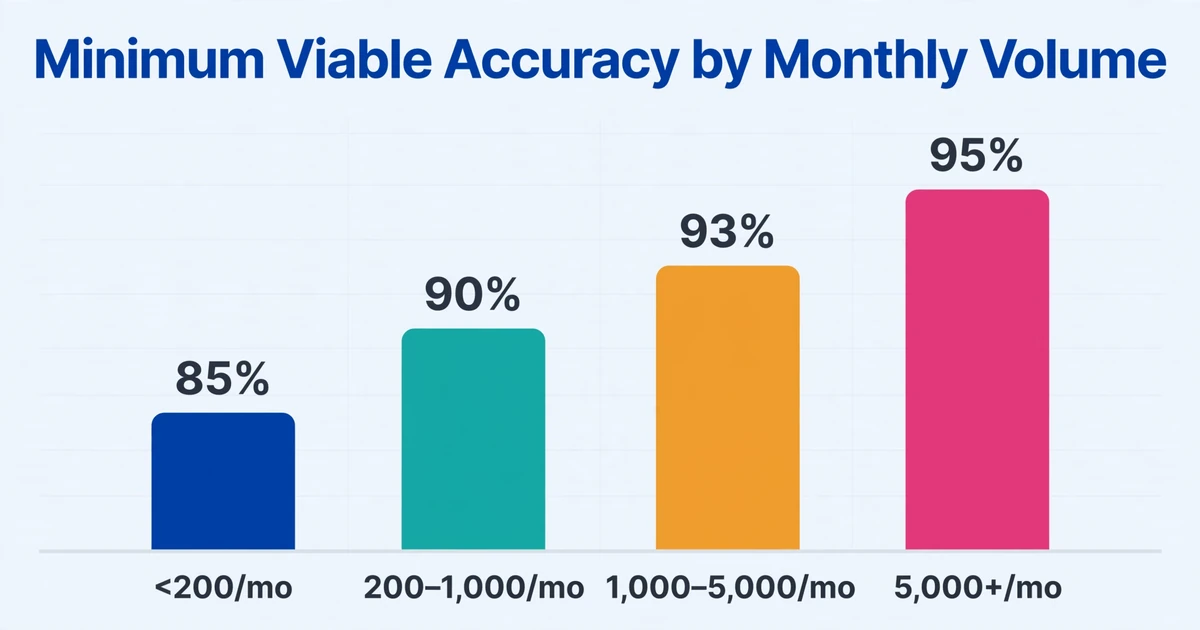
Die benötigte Genauigkeit hängt von Ihrem Volumen ab. Bei 100 Rechnungen pro Monat kann ein einzelner AP-Sachbearbeiter jedes extrahierte Feld manuell überprüfen – selbst 85 % Genauigkeit sparen also erheblich Zeit, da der Sachbearbeiter prüft und nicht transkribiert. Bei 5.000 Rechnungen pro Monat bedeutet eine Feldgenauigkeit von 85 %, dass 750 Rechnungen mindestens einen Fehler aufweisen. Das Team kann nicht alle überprüfen. Die übersehenen Fehler werden zu Zahlungen, und die Korrekturen kosten mehr, als die Extraktion eingespart hat.
Volumenbasierte Genauigkeitsschwellen (feldebene):
| Monatliches Volumen | Mindestgenauigkeit | Zielgenauigkeit | Strategie |
|---|---|---|---|
| <200 | 85% | 95% | Extrahieren + nur kritische Felder stichprobenartig prüfen. Fehler sind günstig zu erkennen. |
| 200–1.000 | 90% | 96% | Extrahieren + alle Summen und Rechnungsnummern prüfen. Geringfügige Formatfehler akzeptieren. |
| 1.000–5.000 | 93% | 97% | Extrahieren + automatisierte Validierungsregeln. Nur markierte Ausnahmen manuell prüfen. |
| 5.000+ | 95% | 98%+ | Extrahieren + automatisierte Validierung + ERP-Integration. Fehler summieren sich bei diesem Volumen. |
Die 98-Prozent-Asymptote. Oberhalb einer Feldgenauigkeit von 98 % erfordern weitere Verbesserungen exponentiell mehr Investitionen – bessere Scan-Ausrüstung, strengere Lieferantenformatvorgaben, integrierte Validierungsregeln, dedizierte Ausnahmebearbeiter. Das Anstreben von 99,5 % lohnt sich fast nie, es sei denn, Sie verarbeiten über 10.000 Rechnungen pro Monat und regulatorische Anforderungen verlangen nahezu Perfektion. Die Kosten für die letzten 1,5 % Genauigkeit übersteigen in der Regel die Kosten für die Bearbeitung der Fehler, die dadurch verhindert würden.
Wichtiger als das Erreichen einer absoluten Zahl ist es, in die richtige Richtung zu tendieren. Ein Team, das sich über drei Monate von 88 % auf 94 % Feldgenauigkeit verbessert, gewinnt. Ein Team, das bei 99 % Seitengenauigkeit feststeckt, während 20 % der Felder falsch sind, verliert – es weiß es nur noch nicht, weil es die falsche Kennzahl misst.
Genauigkeit verbessern, ohne ein anderes Tool zu kaufen
Wenn Ihre Genauigkeit niedriger ist als erwartet, ist der Wechsel des Tools selten die erste Lösung. Die meisten Genauigkeitsprobleme lassen sich beheben, indem man ändert, was in das Tool eingegeben wird und wie Sie Daten anfordern – die Eingabeseite und die Anweisungsseite. Diese Änderungen kosten nichts und funktionieren mit jedem Extraktionssystem.
Auf der Eingabeseite – verbessern Sie, was die KI sieht:
- Scannen Sie mit mindestens 300 DPI in Farbe. Allein das kann die Feldgenauigkeit bei gescannten Rechnungen um 5–10 Prozentpunkte verbessern. Viele AP-Abteilungen scannen aus Dateigründen mit 150–200 DPI in Schwarzweiß. Der Dateigrößenunterschied (5 MB vs. 1 MB) ist im Vergleich zu den Arbeitskosten für die Korrektur von Extraktionsfehlern irrelevant.
- Schräglage korrigieren und ausrichten. Wenn Rechnungen schief ankommen (häufig bei Handyfotos und schnellen Scans), muss die KI das Bild drehen und die Seitengeometrie neu interpretieren. Ein ausgerichtetes Bild macht diesen Aufwand überflüssig. Die meisten Scanner-Software enthält eine automatische Schräglagenkorrektur; aktivieren Sie sie.
- Nachscans vermeiden. Eine Rechnung, die gedruckt, gescannt, per E-Mail versendet, erneut gedruckt und erneut gescannt wurde, trägt die angesammelten Artefakte jeder Generation in sich. Wenn Sie Zugriff auf das ursprüngliche digitale PDF haben, verwenden Sie es. Das Dokument der ersten Generation lässt sich immer besser extrahieren als das der N-ten.
- Mehrseitige Rechnungen richtig trennen. Wenn Seite 1 einer 3-seitigen Rechnung beim Hochladen von den Seiten 2–3 getrennt wird, sieht die KI ein unvollständiges Dokument. Seite 1 enthält möglicherweise den Kopf, aber Seite 3 die Summen. Batch-Upload-Tools, die Dateien zu einer einzigen Verarbeitungseinheit zusammenfassen, erledigen dies automatisch.
Auf der Anweisungsseite – Daten präziser anfordern:
- Verwenden Sie eindeutige Feldnamen. „Invoice Number“ lässt sich zuverlässiger extrahieren als „Inv #“, da die KI nach semantisch passenden Beschriftungen sucht. „Total Amount“ ist besser als „Total“. „Tax Amount“ ist besser als „Tax“. Mehrdeutige Namen zwingen die KI dazu, zu raten, welches Feld Sie meinen – und Raten führt zu Fehlern.
- Zerlegen Sie komplexe Felder in atomare Felder. Fragen Sie statt nach „Vendor Address“ als einem Feld separat nach „Vendor Street“, „Vendor City“, „Vendor State“ und „Vendor ZIP“. Die KI kann jede Komponente präzise lokalisieren, anstatt zu raten, wo ein Feld endet und das nächste beginnt.
- Nutzen Sie die Spaltennamen-Berechnung für abgeleitete Werte. Wenn das Dokument eine „Total“ inklusive Steuer zeigt, Sie aber eine nicht ausgewiesene Zwischensumme ohne Steuer benötigen, teilt ein Spaltenname wie „Subtotal (Total − Tax Amount)“ der KI mit, das fehlende Feld aus den verfügbaren Daten zu berechnen. Das ist zuverlässiger, als von der KI zu erwarten, einen unbeschrifteten Wert zu erraten – und verwandelt Extraktionsfehler (fehlendes Feld) in Erfolge (berechnetes Feld).
- Vereinheitlichen Sie die Lieferantenbenennung. Wenn Ihr Extraktionstool aus der Historie lernen kann, verwenden Sie für denselben Lieferanten immer denselben Namen. „Acme Corp“, „Acme Corporation“ und „Acme Corp.“ sind für ein musterabgleichendes System drei verschiedene Lieferanten. Konsistenz bei Feldnamen und Referenzdaten verbessert die Konsistenz der Extraktion.
Die kumulative Wirkung dieser Änderungen ist oft größer als der Unterschied zwischen der Basisgenauigkeit von Anbieter A und Anbieter B. Ein Team, das Eingabequalität und Felddefinitionen optimiert, kann mit einem mittelmäßigen Tool eine Feldgenauigkeit von 95 % erzielen. Ein Team, das unverarbeitete Handyfotos in das beste Tool auf dem Markt einspeist, erreicht vielleicht 85 %. Das Tool ist wichtig – aber wie Sie es füttern, ist wichtiger.
Hilfe bei der Auswahl des richtigen Extraktionsansatzes für Ihren Rechnungsmix finden Sie in unserem Vergleich von KI-Rechnungsextraktionstools. Für den größeren Kontext, wie die manuelle Dateneingabe zum strukturellen Engpass wurde, der die Genauigkeit so kritisch macht, lesen Sie unsere Analyse, warum AP-Teams weiterhin auf manuelle Rechnungserfassung angewiesen sind.