乱雑で不整合な請求書から信頼できるデータを取得する:
実践的な精度ガイド
どのAI請求書抽出ベンダーも99%の精度を約束します。しかし、実際の請求書(手書きの余白メモ、3言語のスタンプ、2ページ目に続く表)をアップロードすると、結果は85%程度に落ちます。この差は不正によるものではありません。ページレベルの精度(マーケティング上の数字)とフィールドレベルの精度(AP担当者が出力を信頼するか、すべて再入力するかを左右する数字)の違いです。ここでは、その違いを理解し、自社の文書で測定し、その差を埋める方法を説明します。
重要なポイント
- ベンダーのダッシュボード上の「99%精度」は文字数をカウントしており、フィールドをカウントしていません。3桁の数字の誤読は、請求書の合計金額の誤り、支払期限の見逃し、PO照合の失敗を同時に引き起こす可能性がありますが、メーターはすべて問題ないと表示します。
- 請求書を150 DPIの白黒ではなく、300 DPIのカラーでスキャンすると、フィールドレベルの精度が5〜10ポイント向上します。これは、競合する2つのAIベンダー間の差よりも大きいものです。
- まず最も見苦しい3枚の請求書(合計金額を覆うスタンプや余白の手書きがあるもの)をアップロードしてください。ImageToTable.aiがそれらを処理できれば、すべてを処理できるからです。きれいな請求書から始めると、本番の精度ではなくデモのパフォーマンスを測定していることになります。
「99%精度」はマーケティング用語です。実際の意味はこうです。
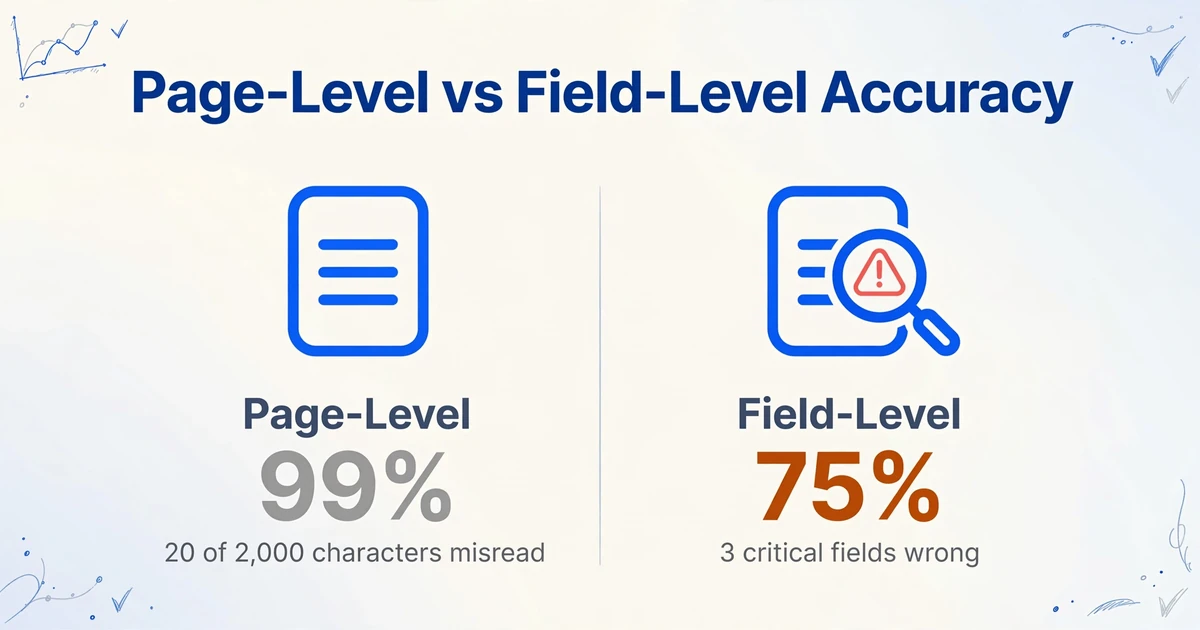
請求書抽出には2種類の精度数値があり、それぞれ意味がまったく異なります。この混同こそが、ベンダーのデモから実際の請求書へ移行する際に、チームが最も失望する原因となっています。
ページレベル精度 — ベンダーのウェブサイトに記載されている98〜99% — は、ページ上の全文字のうち、正しく読み取れた個々の文字の割合を測定します。請求書に2,000文字あり、OCRが20文字を誤読した場合、ページレベル精度は99%です。素晴らしく聞こえます。しかし、その20文字がたまたま請求書番号(INV-2456 が INV-2465 と誤読)、請求合計額($17,820 が $17,280 と誤読)、支払条件(Net 30 が Net 3 と誤読)だった場合、支払いエラーを引き起こす3つのフィールドレベル障害が発生しているのに、ベンダーのダッシュボードは依然として99%の精度を報告します。
フィールドレベル精度 こそが実際に重要な指標です。これは、請求書番号、日付、合計、明細項目、税額、ベンダー名など、個々のデータフィールドがそれぞれ完全に正しく抽出されたかどうかを測定します。10文字の請求書番号で1桁の誤読があれば、そのフィールドは誤りとなります。フィールドレベル精度は常にページレベル精度よりも低く、その差は煩雑な請求書では劇的に拡大します。99%のページレベルスコアは、OCRエラーがたまたま金銭的に重要なフィールドに集中した場合、75%のフィールドレベルスコアを隠蔽する可能性があります。
ベンダーがページレベル精度を使用する理由: 数値が高く、一貫したベンチマークが容易で(すべてのOCRシステムが出力する)、ビジネスにとって重要なフィールドを知る必要がないためです。フィールドレベル精度には、実際のドキュメントと実際のフィールド定義を使用したテストが必要です。それは困難であり、だからこそほとんどのチームは実施せず、ほとんどの「99%精度」の実装が本番環境で期待外れの結果をもたらすのです。
APワークフローにとって重要な唯一の精度数値は、実際の請求書と実際の抽出フィールドで測定したフィールドレベル精度です。それ以外はすべて、楽観的な方向に誤る大まかな近似値にすぎません。
精度を左右するもの — あなたがコントロールできる要素とAIがコントロールする要素
抽出精度は、AIに入力される書類の物理的な品質と、AIモデルがそれを解釈する能力という、相互作用する2つのシステムの産物です。ほとんどの精度ガイドは後者のシステムに焦点を当て、前者を無視しています。しかし、前者こそ、ツールを変えずに今日の午後から改善できるものです。
あなたがコントロールできる要素 — 書類パイプライン:
- 解像度。200 DPIを下回ると、文字が互いににじみ、OCRエンジンは推測を始めます。手書き文字認識に関するPDFExcelの分析では、手書きコンテンツには400~600 DPIを推奨しています。印刷された請求書の場合、300 DPIが実用的な最低限です。古いアーカイブ文書によく見られる150 DPIでスキャンされたPDFは、AIがどれだけ優れていても、測定可能なほど結果が悪化します。
- カラーモード。白黒(2値)スキャンでは、類似した文字を区別する微妙な陰影の違いが失われます。Grooperの手書きOCRに関する研究では、カラースキャンが白黒よりも優れた結果を生むことが確認されています。特に手書きの注釈、スタンプ、財務項目に重なる透かしなどには、AIは追加のデータを必要とします。
- 書類の状態。折れ目、影、傾き(傾いたページ)、圧縮によるアーティファクトは認識を低下させます。フラットベッドスキャンによる印刷されたきれいな請求書は、ほぼ完璧な入力です。同じ請求書をオフィスの照明下でスマートフォンで斜めから撮影したものは、かなり劣ります。コピーのコピーを再スキャンすると、問題がさらに悪化します。ほとんどのAPチームは請求書が届く状態をコントロールできませんが、150 DPIの白黒でスキャンするか、300 DPIのカラーでスキャンするかはコントロールできます。
- フォーマットの一貫性。単一ページか複数ページか、埋め込みテーブルか添付ファイルか、ネイティブPDFかスキャン画像をPDFとして保存したものか — これらはすべて、AIが見るものを変えます。ネイティブPDFにはAIが直接読み取れる選択可能なテキストが含まれています。スキャンPDFはテキストの画像であり、最初に認識され、次に解釈される必要があります。同じベンダーの請求書が、ある月はネイティブPDFで、次の月はスキャン画像で届くと、内容が同一であっても異なる精度が生じます。
AIがコントロールする要素 — 認識レイヤー:
- テンプレート抽出 vs テンプレート不要抽出。テンプレートベースのシステムは、データを固定位置(「請求書番号は座標x:420、y:180にある」)で探します。ベンダーがレイアウトを変更すると機能しなくなりますが、ベンダーは頻繁にレイアウトを変更します(LlamaIndexの実請求書の多様性分析参照)。テンプレート不要のAIは意味的に読み取ります。「請求書番号」というラベルの横にある値が請求書番号であると、場所に関係なく理解します。テンプレートベースは高速で低コストですが、安定した形式でのみ機能します。テンプレート不要は多様性に対応できますが、1ページあたりのコストが高くなります。
- OCR vs 視覚言語モデル。従来のOCRは画像→テキストに変換しますが、テキストを理解しません。視覚言語モデル(VLM)は人間のように文書を読みます。レイアウトを認識し、意味的に関連するフィールドを理解し、「Total Due」と「Amount Payable」が異なる請求書で同じ意味であることを認識します。印刷された構造化された請求書では、OCR単体でも高い精度を達成できます。手書きのメモ、金額に重なるスタンプ、多言語コンテンツ、不規則なレイアウトなど、OCRでは見えない要素がある請求書では、95%以上のフィールド精度を達成するためにVLMが必要です。
- ベンダー固有の学習。繰り返し処理により精度は向上します。Precoroの指摘によると、同じベンダーから10~20件の請求書を処理した後、AIシステムはその形式に対して信頼性の高い抽出パターンを開発します。新しいベンダーの最初の請求書は90%の精度で抽出されるかもしれません。同じベンダーからの20件目は98%で抽出される可能性があります。これが、「ランダムな多様な請求書」での精度ベンチマークが、安定した本番環境での精度よりも低い理由であり、5件のテスト請求書でツールを評価するチームは、3ヶ月の本番運用後に見られる数字よりも低い数字を想定すべき理由です。
請求書タイプ別の精度 — クリーンなPDF、手書きメモ、カーボンコピー、混合フォーマットで期待できること
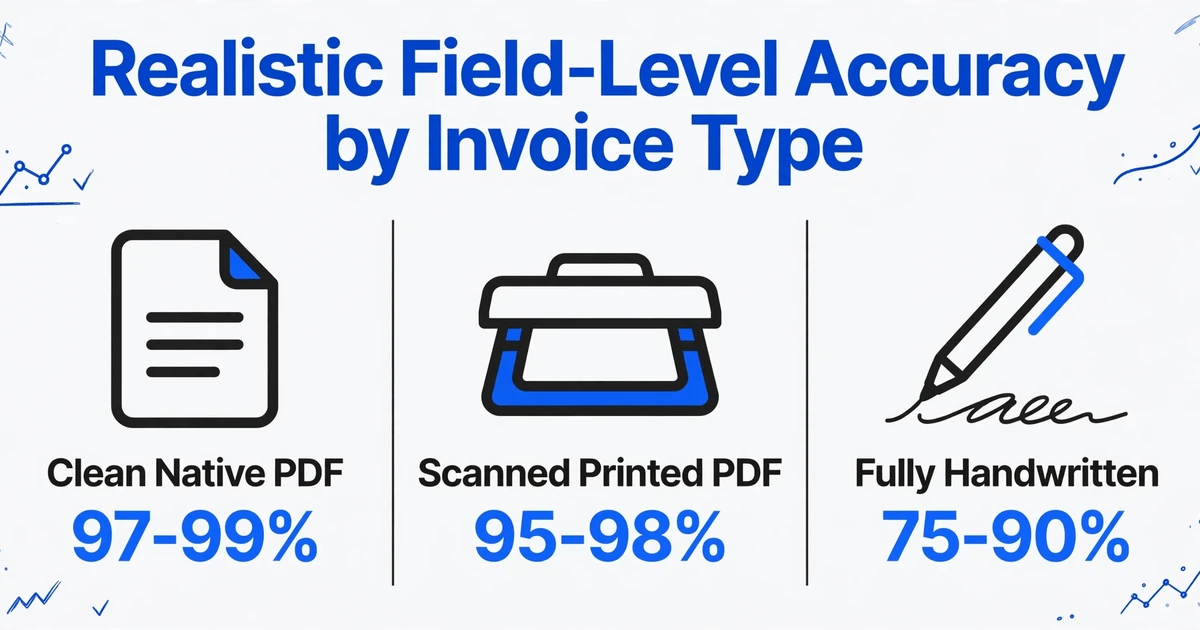
すべての請求書が同じように作られているわけではなく、すべての請求書に単一の精度期待値を適用することは、ツールを誤判定する最も早い方法です。ここでは、ベンダーのマーケティング主張ではなく、今日技術的に達成可能なことに基づいた、請求書タイプ別の期待値を示します:
| 請求書タイプ | 現実的なフィールドレベル精度 | 精度を妨げる要因 | 最適な抽出アプローチ |
|---|---|---|---|
| クリーンなネイティブPDF(デジタル) | 97–99% | 珍しいフィールドラベル、予期しない複数ページ構造 | テンプレート不要のVLMまたはトレーニング済みOCR |
| クリーンなスキャンPDF(印刷) | 95–98% | スキャン解像度、わずかな傾き、小さなフォントでのOCR文字誤認識 | OCR前処理を伴うVLM |
| 印刷物+手書き注釈 | 88–95% | 印刷フィールド上または隣接する手書き、スタンプ、余白のメモ | VLM(OCR単独では手書きで70%未満に低下) |
| 完全手書き | 75–90% | 文字形成のばらつき、筆記体、不規則な間隔、低コントラスト | VLM — 重要なフィールドは人間によるレビューを受け入れる |
| カーボンコピー/ドットマトリックス | 80–92% | 低コントラスト、文字欠け、背景の透け | 高解像度スキャン+VLM;600 DPIでの再スキャンを検討 |
| 多言語/混在スクリプト | 85–95% | 単一言語でトレーニングされたOCR言語モデル、馴染みのないスクリプトのフィールドラベル | 多言語対応のVLM |
この表に関する2つの重要な注意点。 まず、精度はバッチ単位ではなくドキュメント単位です。100件の請求書のバッチには外れ値が含まれます — 合計金額の上に直接QRコードが印刷された請求書、月の途中でレイアウトを変更したサプライヤーなど — これらはバッチ平均よりも低いスコアになります。次に、精度はフィールド間で複合的に作用します。請求書に10個のフィールドがあり、各フィールドが独立して正しい確率が98%の場合、10個すべてが正しい確率はおよそ82%です — そして、一部のフィールドが相互依存していることを考慮する前の話です(PO番号が間違っていれば、他のすべてのフィールドが正しくても三者照合は失敗します)。
精度テストの実施方法 — 請求書20件、半日で完了
ベンダーの精度主張は他人の請求書に基づいています。信頼すべき精度数値は、自分で測定したものだけです。以下は半日で完了し、行動に移せる数値を得る実践的な手順です。
ステップ1:請求書20件を選ぶ。 最もきれいなものや最新のものではなく、代表性のあるサンプルを選びます。毎月処理する取引量の多いベンダーから10件、フォーマットが多様な不定期ベンダーから5件、手書き注釈や印鑑があるもの3件、過去に問題を起こしたもの2件。複数ページの請求書と、ワークフローに存在する場合は非英語の請求書をそれぞれ1件以上含めます。目標は、実際の請求書構成を反映したサンプルであり、選りすぐりのデモセットではありません。
ステップ2:正解データを定義する。 各請求書について、抽出したいフィールド値を手動で記録します:請求書番号、日付、支払期日、合計金額、税額、小計、ベンダー名、PO番号、明細項目(説明、数量、単価、行合計)。これをスプレッドシートに記録(1行=1請求書、1列=1フィールド)。これが正解データです。別の担当者が20件中5件をスポットチェックし、正解データが正しいことを確認します。正解データが正しくなければ、抽出精度を測定できません。
ステップ3:抽出を実行する。 20件の請求書をツールにアップロードし、正解データで定義したフィールド名と同じものを指定します。結果をエクスポートします。比較前に出力をクリーニングや修正しないでください — それがテストの本質です。
ステップ4:フィールドごとに比較する。 各請求書について、抽出された各フィールドを正解データと比較します。抽出値が正解データと完全に一致(同じ形式、同じ内容)していれば正解です。「17,820」と「17820」は、後続処理で形式のばらつきを処理できるなら正解とみなします。インポートエラーになるなら不正解とします。「2025年1月15日」と「2025-01-15」も同様です。記録する内容:どのフィールドが、どの請求書タイプで失敗したか、失敗の種類(空フィールド=完全ミス、誤った値=部分ミス、形式不一致=値は正しいが形式が間違い)。
ステップ5:フィールドレベル精度を計算する。 フィールドレベル精度=正しく抽出されたフィールド数 ÷ 全請求書の全フィールド数。20件の請求書に各10フィールド(計200フィールド)あり、15フィールドが間違っていた場合、フィールドレベル精度は92.5%です。これが重要な数値です。また、再現率(抽出されるべきフィールドのうち、実際に見つかった割合。空白であるべきでないフィールドが空白は再現率低下)と適合率(抽出されたフィールドのうち、正しかった割合)も計算します。
すべてを変えるテスト: まず、過去に問題のあった請求書3件をアップロードします。ツールがそれらをうまく処理できれば、きれいな請求書も問題ありません。問題のある請求書で失敗した場合、コミットする前に失敗モードを学べます。ほとんどの評価プロセスは逆を行います — きれいな請求書から始め、99%を見て購入を決定し、後で問題のある請求書を発見します。順序を逆にしましょう。
ファイルは安全に処理され、保存されることはありません。
「十分」が十分となる基準 — 請求書件数別の精度閾値
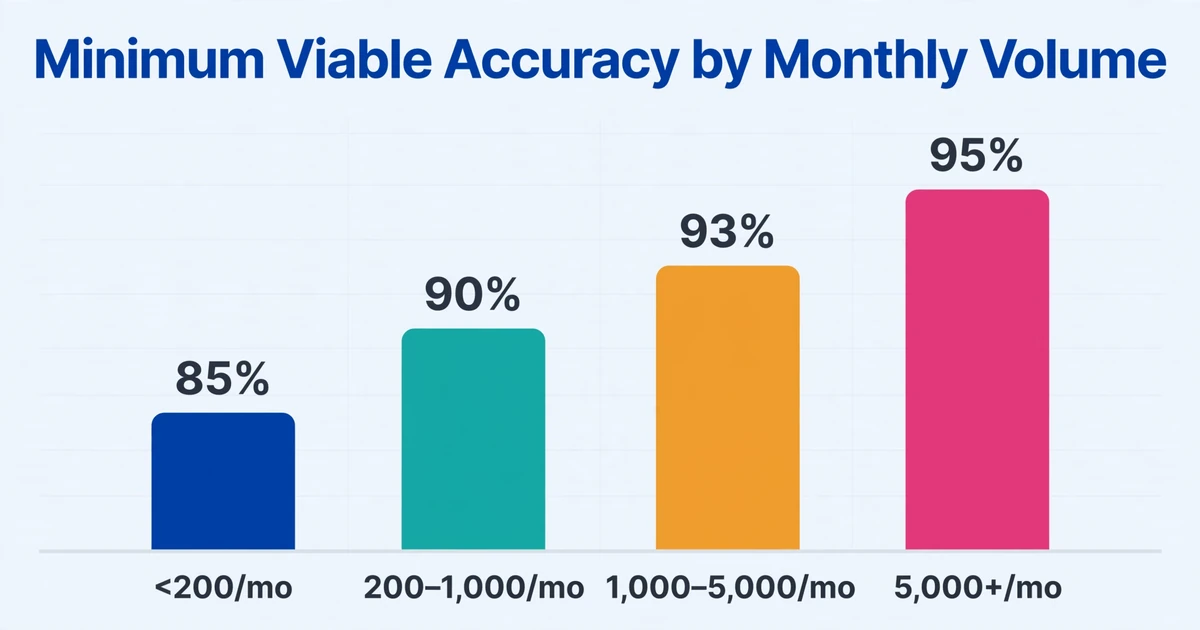
必要な精度は処理件数によって異なります。月100件の請求書であれば、AP担当者1名で全抽出フィールドを手動確認できます。そのため、精度85%でも転記ではなく確認作業になるため、大幅な時間削減になります。月5,000件の場合、フィールド精度85%では750件の請求書に少なくとも1件のエラーが含まれることになります。チームですべてを確認することはできません。見逃したエラーは支払いにつながり、修正コストは抽出による削減効果を上回ります。
件数別の精度閾値(フィールドレベル):
| 月間処理件数 | 最低限必要な精度 | 目標精度 | 戦略 |
|---|---|---|---|
| <200 | 85% | 95% | 抽出+重要フィールドのみスポットチェック。エラーは低コストで発見可能。 |
| 200–1,000 | 90% | 96% | 抽出+すべての合計金額と請求書番号を検証。軽微な形式エラーは許容。 |
| 1,000–5,000 | 93% | 97% | 抽出+自動検証ルール。フラグが付いた例外のみ人間が確認。 |
| 5,000+ | 95% | 98%+ | 抽出+自動検証+ERP連携。この件数ではエラーが複合的に影響する。 |
98%の漸近線。フィールドレベルの精度が98%を超えると、それ以上の向上には指数関数的な投資が必要になります。より良いスキャン機器、厳格なベンダーのフォーマット要件、統合された検証ルール、専任の例外処理担当者などです。99.5%を追い求めることは、月に10,000枚以上の請求書を処理しており、規制遵守が完璧に近い精度を要求する場合を除いて、ほとんど価値がありません。最後の1.5%の精度にかかるコストは、通常、それが防ぐであろうエラーを処理するコストを上回ります。
絶対的な数値を達成することよりも重要なのは、正しい方向へのトレンドです。3ヶ月でフィールド精度を88%から94%に向上させたチームは勝利しています。ページレベルの精度が99%でも、フィールドの20%が間違っているチームは敗北しています。彼らは間違った数値を測定しているため、まだ気づいていないだけです。
別のツールを購入せずに精度を向上させる
精度が期待値より低い場合、ツールを切り替えることはめったに最初の対策にはなりません。ほとんどの精度問題は、ツールに入力するものとデータの要求方法、つまり入力側と指示側を変えることで改善できます。これらの変更はコストがかからず、どの抽出システムでも機能します。
入力側 — AIが見るものを改善する:
- 最低300 DPI、カラーでスキャンする。これだけで、スキャンされた請求書のフィールドレベルの精度を5〜10ポイント向上させることができます。多くのAP部門は、ファイルサイズの理由で150〜200 DPIの白黒でスキャンしています。ファイルサイズの違い(5MB対1MB)は、抽出エラーの修正にかかる人件費に比べれば無関係です。
- 傾き補正と位置合わせ。請求書が傾いて届く場合(スマホの写真やクイックスキャンでよくある)、AIはページのジオメトリを回転させて再解釈する必要があります。傾き補正された画像はこのオーバーヘッドを排除します。ほとんどのスキャナーソフトウェアには自動傾き補正が含まれています。有効にしてください。
- 再スキャンを避ける。印刷、スキャン、メール送信、再印刷、再スキャンを経た請求書には、各世代の蓄積されたアーティファクトが含まれています。元のデジタルPDFにアクセスできる場合は、それを使用してください。初世代のドキュメントは、常にN世代目よりも抽出精度が高くなります。
- マルチページの請求書を適切に分離する。3ページの請求書の1ページ目がアップロード中に2〜3ページ目から分離されると、AIは部分的なドキュメントを見ることになります。1ページ目にヘッダーがあり、3ページ目に合計があるかもしれません。ファイルを単一の処理単位に結合するバッチアップロードツールは、これを自動的に処理します。
指示側 — データをより正確に要求する:
- 明確なフィールド名を使用する。「Invoice Number」は「Inv #」よりも確実に抽出できます。これは、AIが意味的に一致するラベルを探すためです。「Total Amount」は「Total」よりも優れています。「Tax Amount」は「Tax」よりも優れています。曖昧な名前はAIにどのフィールドを意味しているのか推測させ、推測はエラーを生みます。
- 複雑なフィールドは原子的なものに分割する。「Vendor Address」を1つのフィールドとして要求する代わりに、「Vendor Street」「Vendor City」「Vendor State」「Vendor ZIP」を個別に要求します。AIは各構成要素を正確に特定でき、あるフィールドが終わり、次のフィールドが始まる場所を推測する必要がなくなります。
- 派生値には列名計算を使用する。ドキュメントに税込みの「Total」が表示されているが、印刷されていない税抜きの小計が必要な場合、「Subtotal (Total − Tax Amount)」のような列名は、AIに利用可能なデータから欠落しているフィールドを計算するように指示します。これは、AIにラベルのない値を推測させるよりも信頼性が高く、抽出の失敗(フィールド欠落)を成功(計算フィールド)に変えます。
- ベンダー名を標準化する。抽出ツールが履歴から学習できる場合、同じサプライヤーには常に同じベンダー名を使用します。「Acme Corp」「Acme Corporation」「Acme Corp.」は、パターンマッチングシステムにとっては3つの異なるベンダーです。フィールド名と参照データの一貫性は、抽出の一貫性を向上させます。
これらの変更による累積効果は、ベンダーAとベンダーBの基本精度の差よりも大きいことがよくあります。入力品質とフィールド定義を最適化するチームは、平凡なツールから95%のフィールド精度を抽出できます。生の電話写真を市場で最高のツールに投入するチームは、85%を得るかもしれません。ツールは重要ですが、それをどう使うかがより重要です。
請求書の構成に適した抽出アプローチの選択については、AI請求書抽出ツールの比較をご覧ください。手動データ入力が精度をこれほど重要にする構造的なボトルネックとなった背景については、APチームが今も手動の請求書入力に依存する理由の分析をご覧ください。