手作業 vs AIによるベンダー見積比較:
実際のワークフローの違い
中堅メーカー、建設会社、物流企業の調達チームは、SAP Ariba、Coupa、JAGGAERが20年以上にわたってRFQ自動化を販売してきたのに、なぜ今もスプレッドシートでベンダー見積を比較しているのでしょうか?その答えは、この比較が検証するギャップにあります。ほとんどの調達ソフトウェアは、見積がシステムに入った後のプロセスに対応しています。しかし、見積をシステムに取り込むことには対応していないのです。
重要なポイント
- ベンダー見積比較にかかる時間の85%は、調達判断が始まる前に消えていきます。5つの異なる形式のPDFから単価を探し出し、35個の値をExcelに入力し直し、あるサプライヤーがケース単位で見積もる一方で別のサプライヤーがユニット単位で見積もる場合の単位を正規化する作業です。
- 月15件のRFQを超えると、手作業による見積比較は単なる面倒な作業ではなくなり、チームの調達能力の上限になります。ボトルネックは調達の専門知識ではありません。データ入力に費やされる時間であり、そのコストは評価されることのないサプライヤーです。
- ImageToTable.aiはデータ抽出と同等性の判断を分離します。レビュー担当者は5つの開かれたPDFではなく、データが入力された比較表から作業を開始します。レビューモードでは、各値が元の見積のどこから来たのかがハイライト表示されるため、「これらは同じ品目か?」という判断がすべて明示的で検証可能になり、スプレッドシートのセルに埋もれた暗黙の前提ではなくなります。
5社のRFQで5種類の文書構造——そして共通する1つのボトルネック
5社のサプライヤーに標準的な見積依頼書(RFQ)を送ると、返ってくる回答は次のようにバラバラです。ERPからエクスポートされた整形済みPDF、価格が段落に埋め込まれたWord文書のPDF変換、手書き署名付きの印刷フォームのスキャンコピー、サプライヤーごとにカラム構成が異なるExcelファイル、そして時には添付ファイルすらないメール本文のみ——という具合です。これは珍しいことではなく、単一のサプライヤーポータルを義務付けていない組織における調達の標準的な状態です。APQCのオープンスタンダードベンチマークデータによると、組織は1件の発注書(PO)の処理に14ドルから54ドル以上を費やしており、上位企業はPOの98%を電子的に承認している一方、中央値は約80%にとどまっています。この2つの数字の差こそが、手作業による比較が生み出すデータ入力の摩擦です。
手作業による比較で実際に何が起きているのか、ステップごとに見ていきましょう。
各PDFを開いて項目を探す
サプライヤーAの単価は「Unit Rate (500+)」という表の中にあります。サプライヤーBは文の途中に「our unit cost for volumes exceeding 40 units per month would be $4.20」と記載。サプライヤーCは「Price Each」と書かれたフォーム欄に手書きで記入しています。5つの文書から同じデータを見つけ出すのは、比較シートの列ごとに繰り返される視覚的な検索作業です。
比較スプレッドシートに値を転記する
サプライヤー5社×比較項目7列(サプライヤー名、単価、最小発注数量(MOQ)、リードタイム、支払条件、見積有効期限、保証)で、手入力は35件になります。それぞれウィンドウの切り替え、値の検索、入力、正しいセルに入ったかの確認が必要です。300行の建設工事数量明細書では、1,500件以上に膨れ上がります。
単位や形式の違いを統一する
サプライヤーAは24個入りのケース単位、サプライヤーBは単品単位、サプライヤーCは120個入りのパレット単位で見積もっています。アナリストは暗算や補助列を使って共通の基準に揃えますが、1桁でも間違えればコスト比較の結果が桁違いに変わってしまう判断作業です。
サプライヤー間で品目を照合する
ベンダーAは「SSD-500-SATA」、ベンダーBは「Solid State Drive, 500 Gigabytes」と記載。これらは同等でしょうか? アナリストが判断しますが、締切当日の午後4時に行われるその判断が、どちらのサプライヤーが安いかを左右します。スプレッドシートは判断箇所としてフラグを立てないため、後から誰も見直しません。
スコアリング計算を適用して推奨案をまとめる
スプレッドシートの計算は数分で終わります。加重スコアリング、条件付き書式、ピボットテーブルもすべて一瞬です。テンプレート作業はプロセス全体で最も速い部分であり、それまでの工程が1日を費やしていたのです。
比較ロジックはタスク全体の約15%を占めるにすぎません。残りの85%はデータロジスティクス、つまりドキュメントから値を特定し、転送し、正規化して、比較を開始できる構造に整える作業です。 この内訳は上記のステップごとの所要時間に表れており、理論上は単純なプロセスを、調達チームが毎回のRFQサイクルで直面するボトルネックに変えているのです。
5社のRFQは手作業で3.25〜6.5時間かかる。抽出ステップはファイルをアップロードするのと同じ時間で完了できる。
The Hackett Groupのベンチマークによると、Digital World Classの調達チームは、一般的な組織と比較して要求から発注書までのサイクルタイムが58%短縮されています。両者の差を生むのは、5社のRFQが生み出す管理作業、つまり見積もりの再フォーマット、比較表の作成、ドキュメント間での値の追跡です。突破口は抽出の障壁を取り除き、比較に労力を集中させることです。
標準的な5社・7列のRFQについて、タスクごとに測定した結果は以下のとおりです。
| タスク | 手動ワークフロー | AI抽出ワークフロー |
|---|---|---|
| ドキュメントを開き、フィールドを特定 | 30〜60分 | 不要 — AIがドキュメントを直接読み取ります |
| スプレッドシートに値を転記 | 60〜120分 | 不要 — 抽出がテーブルを生成します |
| 単位と形式を正規化 | 30〜60分 | 5〜10分(必要に応じて確認・調整) |
| サプライヤー間でライン項目を整合 | 45〜90分 | 15〜30分(AIのデータを確認し、等価関係を明示的にマッピング) |
| スコアリングを適用し、推奨案を作成 | 30〜60分 | 30〜60分(変更なし — 人間の判断が依然として必要) |
| RFQサイクルあたりの合計 | 3.25〜6.5時間 | 1.3〜2.7時間 |
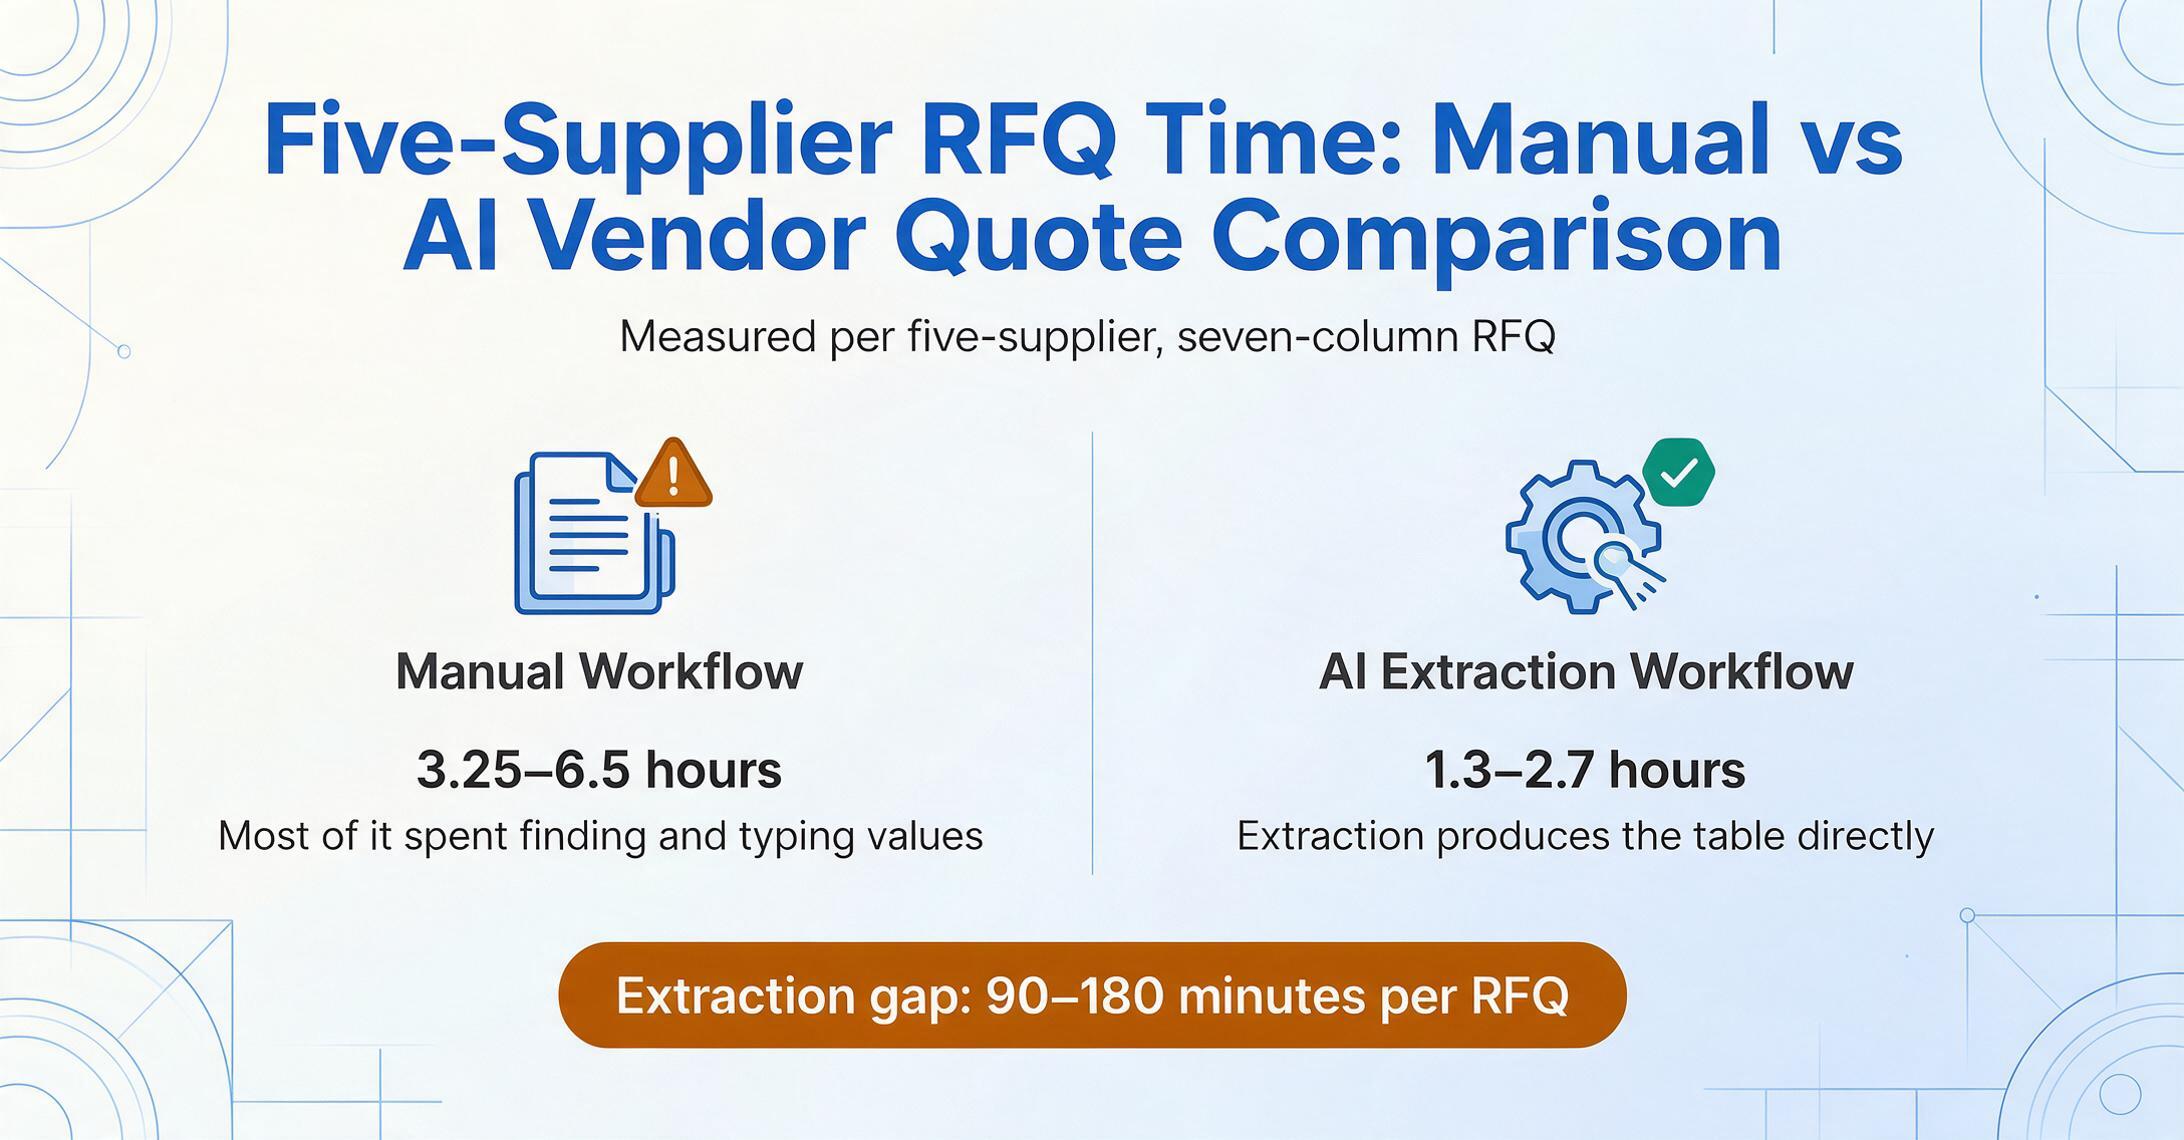
抽出ギャップ(文書内の値を探してテーブルに移す作業)は、5社のRFQあたり90〜180分かかります。調達業務の人件費を$85/時間とすると、RFQあたり$127〜$255の人件費削減になります。これは、スプレッドシート作成中に遅延した意思決定や失効した見積もりの下流コストを考慮する前の数字です。月に10件のRFQがある場合、回収された時間だけで抽出ツールのコストを賄えます。比較・意思決定の段階(調達の専門知識を要する作業)は、時間も品質も変わりません。
このスピードを可能にするのは、文書の読み取りに対する根本的に異なるアプローチです。手作業では、各PDFを開き、単価を探し、見つけて入力し、それをMOQ、リードタイム、支払い条件などについて繰り返します。カラム名抽出を使用したAI支援ワークフローでは、抽出したいものを定義します(「単価」「MOQ」「リードタイム(日数)」などのカラム名)。AIは、以前の文書でフィールドがどこにあったかを記憶するのではなく、意味を理解することで、ページ上のどこにある値でも特定します。同じカラム定義が、ベンダーごとの設定なしに、すべてのサプライヤーの形式で機能します。
ファイルは安全に処理され、保存されません。
1ページあたり5〜10秒の処理時間(手作業の1ページあたり約3分と比較)は、文書量が増えるほど速度の利点が大きくなることを意味します。ただし、これは抽出ステップに限った話です。意思決定ステップは加速しません。その必要がないからです。調達プロフェッショナルの判断こそが価値であり、ボトルネックではないのです。
手作業での比較は、明細項目全体に波及する3種類のエラーを生み出す。AI抽出はそのうち2つを排除する。
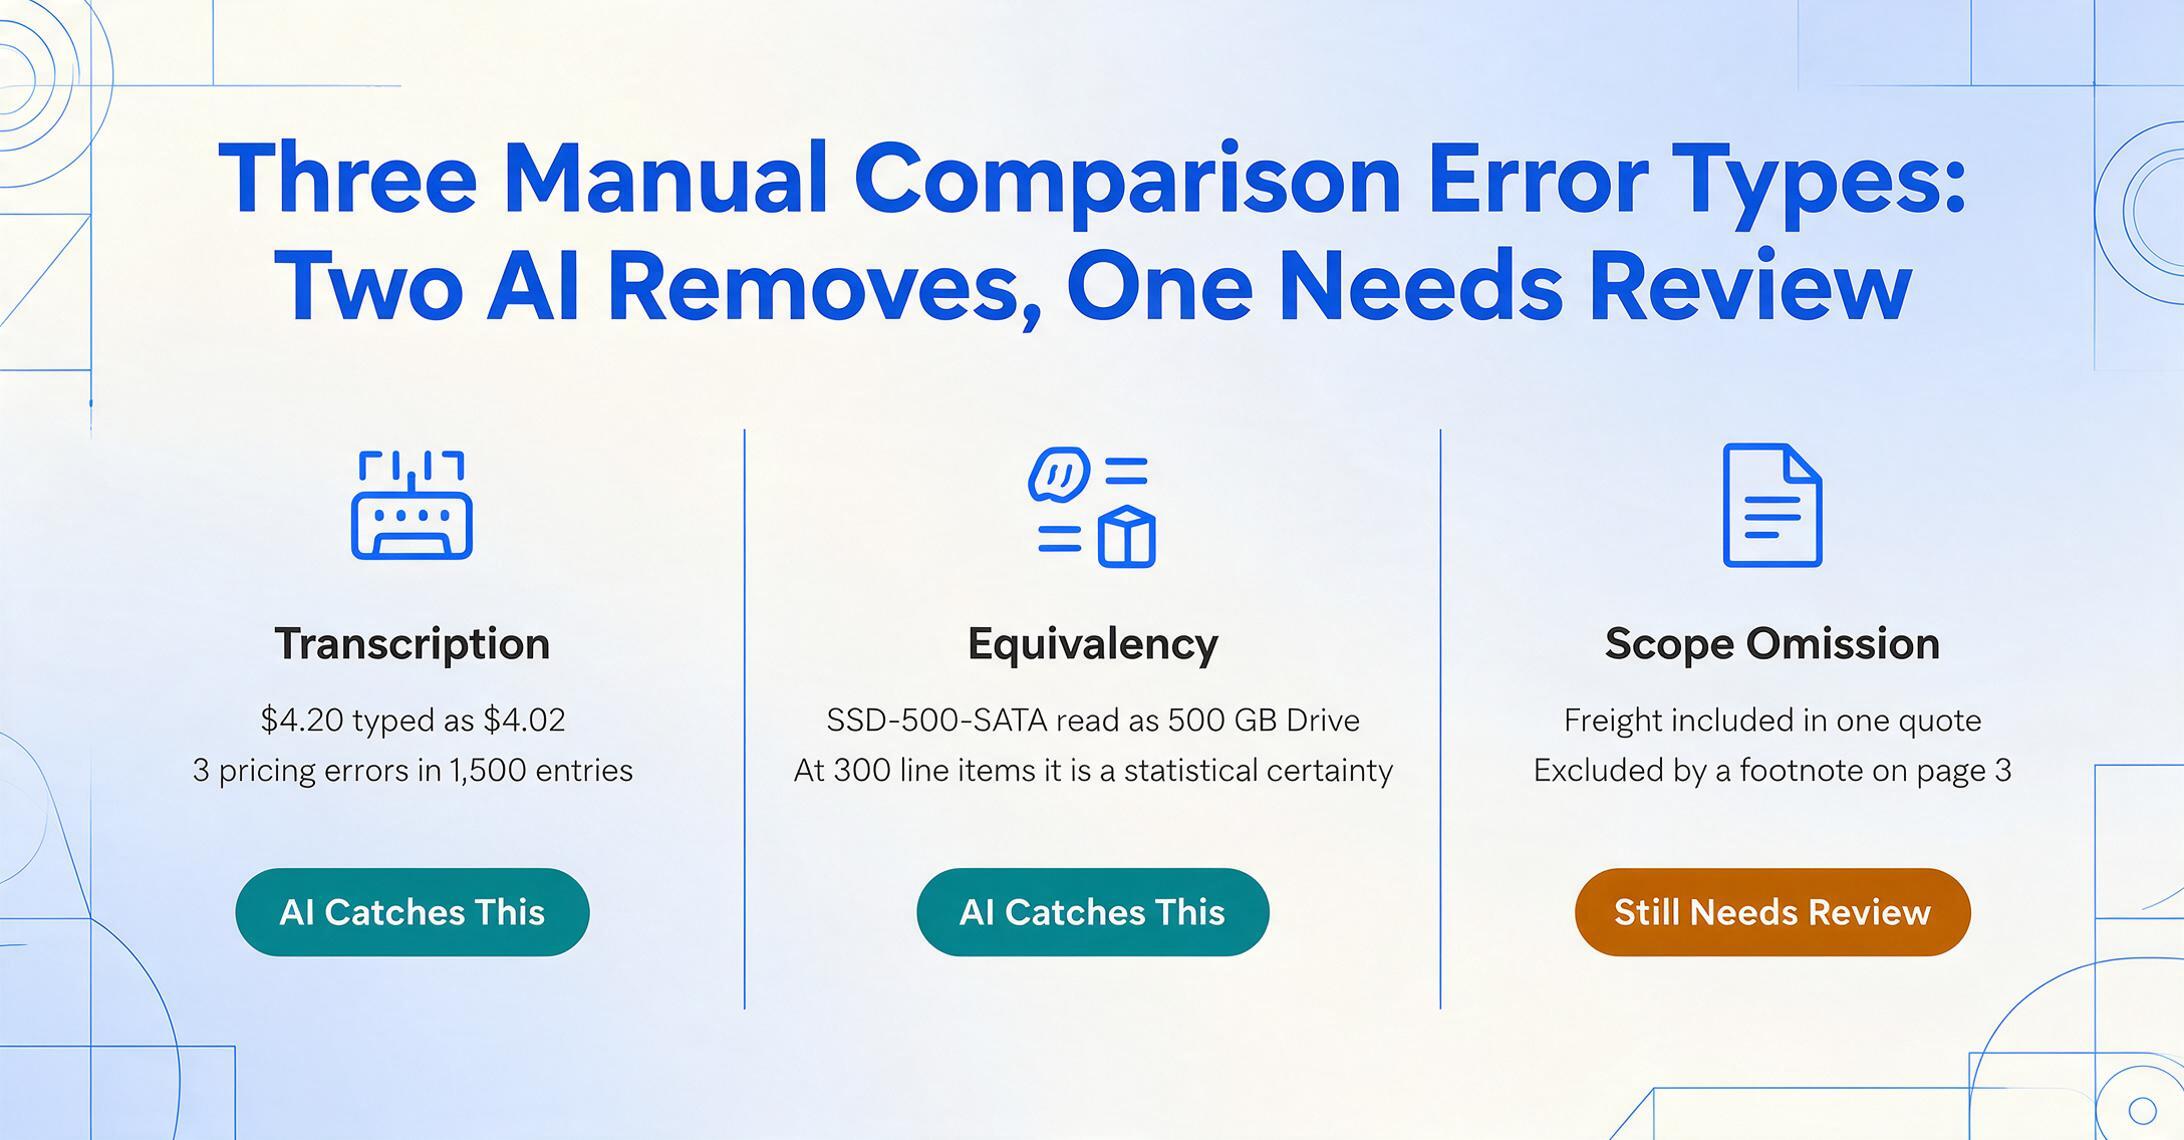
見積比較の精度に関する議論は、通常「タイプミス」—桁の入れ違いや小数点の見落とし—に焦点が当てられます。しかし、手作業での比較においてより高くつくエラーは、タイプミスではなく構造的なものであり、次の3つのカテゴリに分類されます:
転記エラー。PDF上の値は$4.20。スプレッドシート上の値は$4.02。$500,000の資材契約における1回の桁の入れ違いだけで、どちらのサプライヤーが安く見えるかが変わります。また、300行の数量明細書では、レビュー担当者が1,500の値を手入力することになります。補助なしの手入力におけるエラー率はフィールドあたり数パーセント程度であり、その方法で構築された比較は、誰かがレビューする前に複数の誤った数値を含んでいることになります。CAPS Researchの2022年クロスインダストリー調査では、PO処理コストの上位と下位の差は14倍($53〜$741)とされています。手戻りは、その範囲の高額側を押し上げるコスト要因の1つです。
等価性エラー。アナリストが「SSD-500-SATA」と「ソリッドステートドライブ、500ギガバイト」を同じ品目と判断し、同じ行に入れます。実際には異なる製品構成(一方はエンタープライズグレード、もう一方はコンシューマーグレード)である場合、明細項目全体の比較は無効になり、スプレッドシートが等価性の主張を事実として扱うため、そのエラーは見えません。これは、手作業プロセスがアナリストのスキルではなく明細項目数に比例した割合で生み出すエラータイプです。300明細項目では、統計的に確実に発生します。
範囲漏れエラー。サプライヤーAの見積には送料が含まれています。サプライヤーBは3ページ目の脚注で送料を除外しています。アナリストが脚注を見落とし、基本価格を直接比較します。「安い」サプライヤーは、送料請求書が別途届いた後で割高であることが判明します—しかし、決定はすでにスプレッドシートに基づいて下されています。Redditのr/procurementのある調達マネージャーは、このパターンを率直に表現しています:「あるサプライヤーが時間単価で見積もり、別のサプライヤーが固定価格で見積もる場合、評価ではなく変換に半分の時間を費やすことになります。」変換ステップが時間を消費しますが、その中に埋もれた範囲の前提がコストを生むのです。
| エラーの種類 | 手動ワークフロー | AI抽出ワークフロー |
|---|---|---|
| 転記 | 発生する — 手動入力には常にタイプミスや転記ミスのリスク(> 0)が伴う | 解消 — AIがドキュメントを直接読み取るため、人の再入力ステップが不要 |
| 等価性 | 発生する — データ入力中に暗黙的に行われ、記録に残らない | 依然として発生 — ただし、抽出後の独立した確認可能なステップに移行 |
| 範囲の見落とし | 発生する — 手動スキャンでは脚注や除外事項を見落としやすい | 軽減 — AIが脚注を含むドキュメント全体を読み取り、空のセルが欠落データを示す |
AI抽出は等価性エラーを完全には排除しません。説明が異なる2つの製品が同じものかどうかの判断は、依然として人間が必要です。しかし、生データの抽出と等価性の判断を分離します。アナリストは、各サプライヤーの値がすでに入力されたテーブルを確認し、整合性の判断は明示的で検証可能です。ウィンドウを切り替えながら行う暗黙の仮定ではありません。手動見積比較に潜む欠陥の分析で詳述したように、この分離こそが比較を監査可能にするのです。
検証こそが、この分離を実際に価値あるものにします。ImageToTable.aiにはレビューモードが搭載されています。抽出されたセルにホバーまたはクリックすると、元の見積書の該当箇所がハイライトされ、ソースドキュメント上の領域をクリックすると対応するセルにジャンプします。フィールドを編集しましたか?ワンクリックでAIの元の読み取り値を表示し、元に戻すことができます。5社のサプライヤーを確認するバイヤーにとって、「この単価は本当にベンダーBが見積もったものか?」という確認が、PDFを探し回る作業から、ハイライトされた行を一目見る作業に変わります。Auto-annotateを使えば、バッチ内のすべてのファイルに同じチェックを実行できるため、レビュー開始前からトレースが準備されています。制限も明確に述べておきます。レビューモードは値の出所を確認するものであり、比較に含めるべきかどうかを判断するものではありません。等価性の判断はあなたに委ねられています。
月3件のRFQなら手動比較は小さな手間。月15件になれば、チームの処理能力の限界になる。
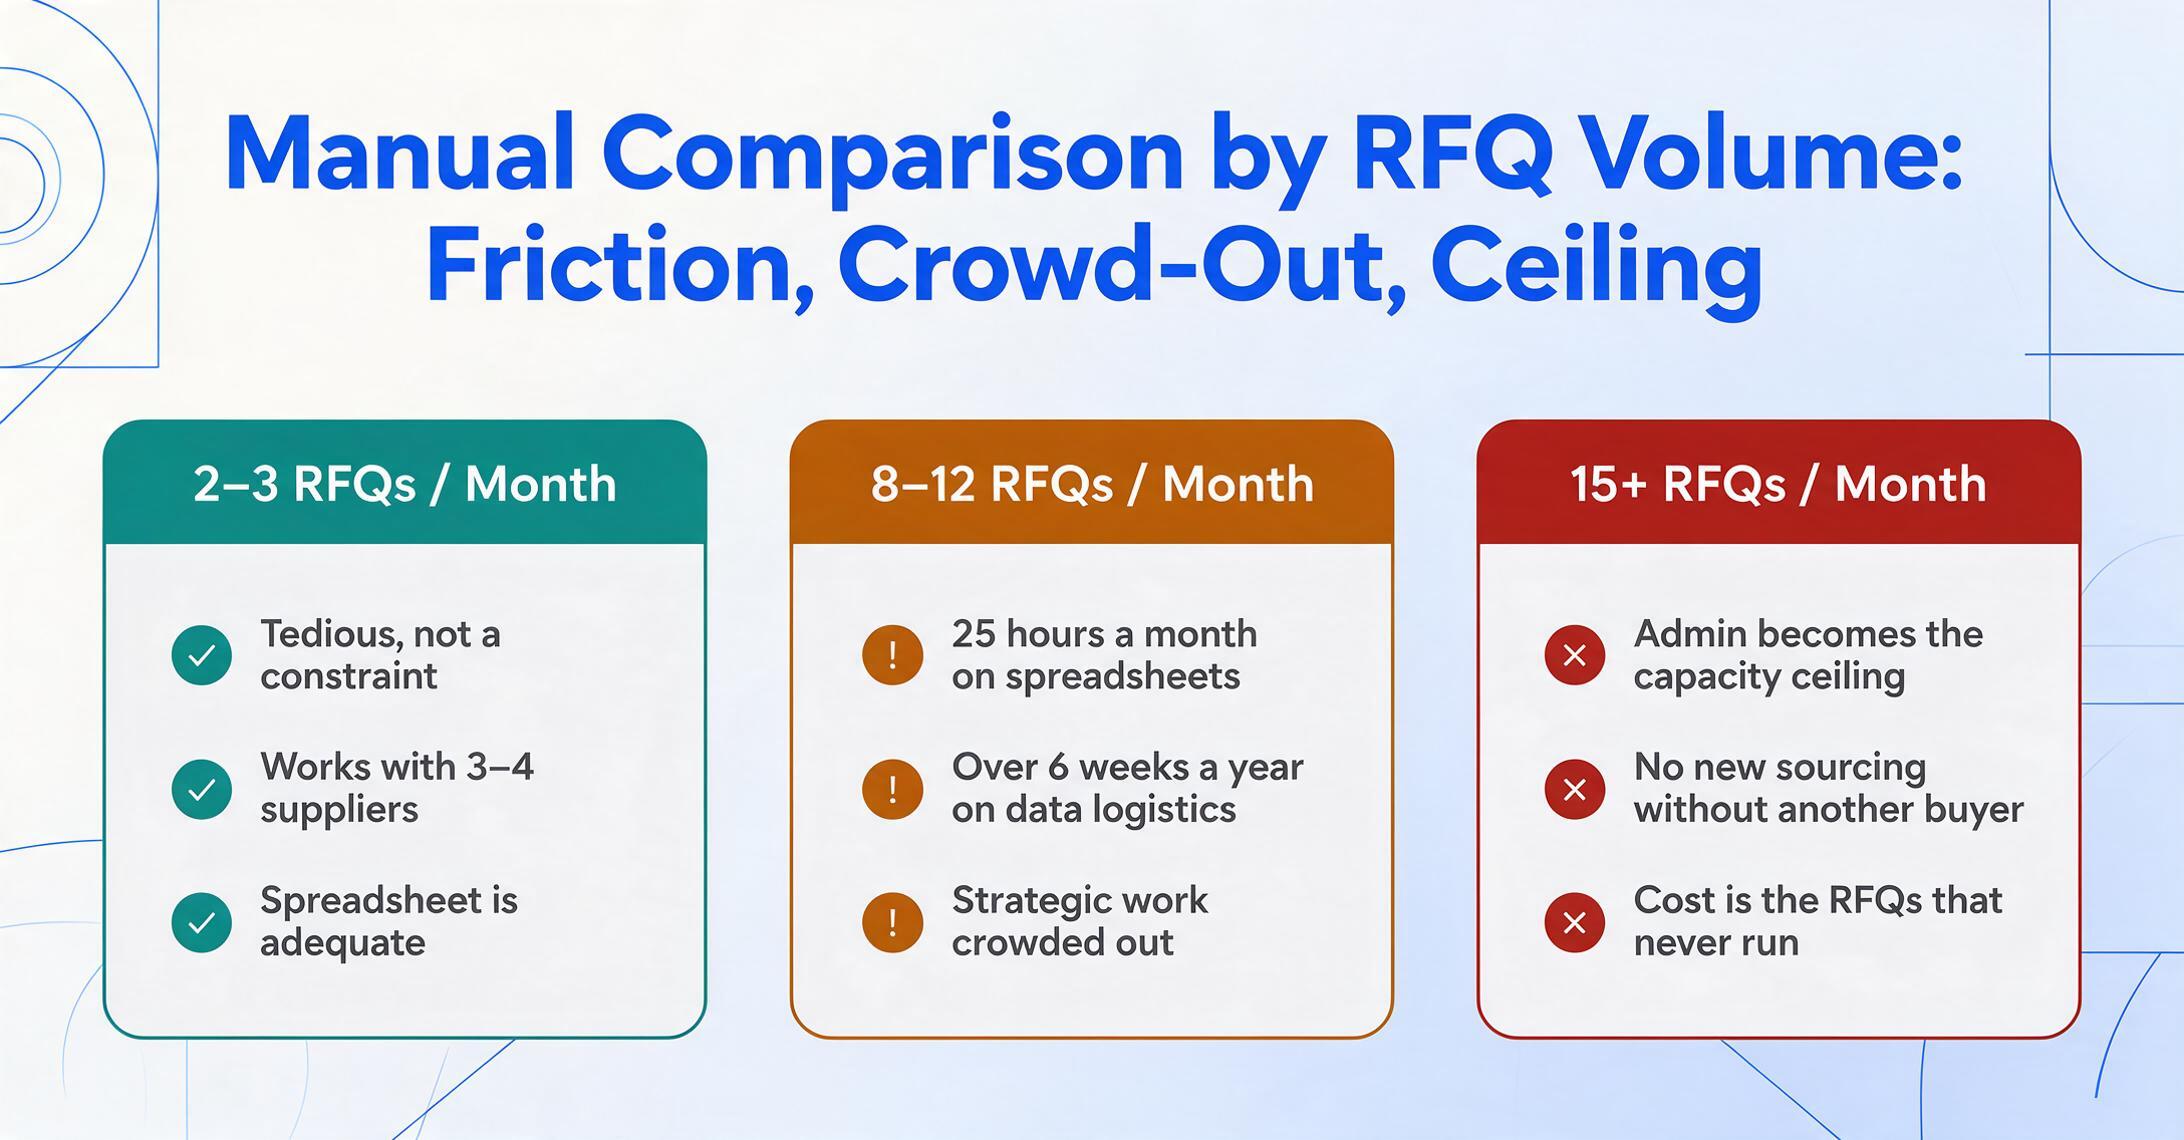
スケーラビリティの限界は、手動ワークフローが破綻する次元であり、その境界線を正確に把握することが重要です。月2〜3件のRFQサイクルを各3〜4社のサプライヤーで回しているチームにとって、手動比較は機能します。面倒ではあっても構造的な制約ではありません。Redditのある調達担当者はこの領域を次のように説明しています。「見積もりからデータを取得して、自分専用の『比較』Excelに入れている。サプライヤー各社のオファーを比較できるようにね(これは大規模なRFQの場合)。」小規模なRFQであれば、スプレッドシートで十分です。
月8〜12件になると、管理業務の時間が戦略的な業務を圧迫し始めます。PDFから比較スプレッドシートを作るのに月25時間を費やすバイヤーは、年間6週間以上をデータ整理に費やしていることになり、サプライヤー交渉や市場分析、コスト削減施策に充てる時間が削られています。これが、85%というデータ整理の割合が抽象論ではなくなる閾値です。各RFQにかかる小さな負担に見えたものが、その月の主要な作業負荷になるのです。
月15件以上になると、手動比較は調達スループットの上限になります。チームは別のバイヤーを雇わない限り、これ以上の調達イベントを実行できません。戦略的な業務がそれを必要としているからではなく、比較スプレッドシート作成という管理作業が利用可能な時間をすべて消費してしまうからです。コストは人件費ではありません。実行されないRFQ、評価されないサプライヤー、スプレッドシート作成でチームが手一杯のため獲得できないコスト削減——それが本当のコストです。
このスケーラビリティのギャップこそが、バッチ抽出を単一ドキュメント処理とは異なる独自の機能にしている理由です。バッチ抽出を使えば、すべてのサプライヤー見積書ファイルを一度にアップロードし——元のフォーマットに関係なく——1回の操作で単一の比較テーブルに処理できます。RFQあたりの抽出時間は、サプライヤーが5社でも15社でも、数時間から数分に短縮されます。比較と意思決定の作業は量に比例して残りますが、抽出の障壁は完全に取り除かれます。
調達プロフェッショナルは誰もがExcelでの見積比較方法をすでに知っている。抽出ツールの学習曲線は、たった一つの新しいパターンだけだ。
手動ワークフローの最大の強みは、トレーニングが不要なことだ。Excelを使ったことがある新しい調達担当者——つまり、すべての新しい調達担当者——は、初日から比較スプレッドシートを作成できる。このプロセスは遅く、エラーが発生しやすく、処理能力に限界がある——しかし、誰でも使える。これは小さな利点ではない。代替ワークフローは、手動プロセスがデフォルトで満たす基準をクリアしなければならない:それは、単一のRFQサイクル内で測定して、節約できる時間よりも速く習得できることだ。
AI支援抽出の学習曲線は、単一の新しいパターンに集中している:各PDFを開いてスプレッドシートに値を入力する代わりに、ユーザーはすべてのファイルをアップロードし、抽出したい内容を定義する。列名はExcelに入力するのと同じ列——「単価」「最小発注数量(MOQ)」「リードタイム」——だが、人間が各PDFを読むのではなく、AIがドキュメント全体から値を特定する。一度定義すれば、列セットは名前付きテンプレートとして保存でき、ワンクリックでRFQサイクル全体で再利用できる。
比較のために:SAP AribaのRFQモジュールは実装に数週間かかり、サプライヤーがプラットフォームを使用する必要がある。Coupaの入札機能はサプライヤーのオンボーディングとポータル導入を必要とする。JAGGAERの調達ツールは、構造化された支出管理プログラムがすでに存在することを前提としている。これらのプラットフォームの学習曲線は数ヶ月単位で測定され、導入曲線はサプライヤー関係単位で測定される。そのため、エンタープライズ調達ソフトウェアでの規模にもかかわらず、ミッドマーケット向けのスプレッドシートベースの比較に取って代わっていない。AI抽出アプローチの学習曲線は、ファイルをアップロードして列名を入力するのにかかる時間で測定される——これは最初のRFQサイクル内でクリアできる閾値だ。
発注書に適用される抽出アプローチに関心のあるチーム向けに、発注書データ入力:ERPテンプレート vs AI抽出に関する同様の次元比較が存在する。そこでは、構造化システムの入力要件と現実世界のドキュメントの多様性との間の同じギャップが、同一の摩擦ポイントを生み出している。
手動ワークフローが依然として明確な利点を持つ領域 — そして持たない領域
正直な手動とAIの比較には、両方の側面を示す必要があります。手動ワークフローは確かにいくつかの点で優れており、それを認めることで、比較の残りの部分に重みが生まれます:
- 限界費用ゼロ。 Excelはすでにライセンスされています。RFQごとの料金も、ページ数制限のティアも、サブスクリプション評価もありません。月に3件未満のRFQを処理する組織では、自動化による時間節約がツールコストを回収できず、手動ワークフローが経済的に合理的な選択となります。
- 出力の完全なフォーマット柔軟性。 手動プロセスでは、人間が作成するため、任意のレイアウト、採点モデル、ピボット構造を生成できます。抽出ツールは標準化されたテーブルを生成しますが、比較ワークフローが高度にカスタマイズされたフォーマットを要求する場合、手動での再構築ステップが依然として必要になることがあります。
- 抽出中の文脈に基づく判断。 経験豊富なバイヤーがサプライヤーの見積書を読むとき、AI抽出が見逃すことに気づく場合があります:「このサプライヤーは常にNet 30で見積もるが納品が遅い — スコアリングに反映させてください。」この組織的知識はバイヤーの頭の中にあり、文書にはなく、自動抽出では捉えられない方法で手動レビュー中に表面化します。
- 政府調達の文書化。 FAR Part 6(競争要件)に基づき、契約担当官は落札決定の根拠を文書化し正当化する必要があります。手動プロセスは、非効率性にもかかわらず、元の見積書、比較スプレッドシート、アナリストのメモという固有の紙の証跡を生成します。AI支援ワークフローも同じ文書化を生成できますが、コンプライアンス目的で抽出データとともに元の文書を保存するように抽出ステップを設定する必要があります。政府調達では、自動化ツールは手動のコンプライアンスフレームワークととともに機能し、その代替ではありません。
手動が負ける領域 — そしてボリュームに比例して負ける領域 — は、スピード、一貫性(エントリあたりのエラー率)、スケーラビリティです。これらの領域は複合的に作用します:RFQあたり90分の抽出時間を節約するチームは、より多くのRFQを処理し、より多くのサプライヤーを評価し、より多くの節約を実現できます。人員を増やさずに。月10件のRFQを処理する典型的な調達チームは、月に約15〜25時間、つまり標準的な調達のロードレートで月額$1,275〜$2,125の人件費を回収します。本当の問いは、手動ワークフローのコストが切り替えの学習投資を超えるRFQボリュームがどこにあるかです。
手動とAIによるベンダー見積比較に関するよくある質問
手動での見積比較が意味をなさなくなるのはどの時点からですか?
月に3〜5件のRFQ(見積依頼書)で、各3社以上のサプライヤーがいる場合が目安です。この閾値を下回る場合、新しいツールを学ぶための時間投資が、その切り替えを正当化できるだけのコスト回収を十分に早く実現できない可能性があります。特に、サプライヤーとの関係が安定しており、各RFQで使い慣れた文書形式を再利用している組織ではその傾向が強くなります。この閾値を超えると、抽出時間の節約は毎月複利的に積み上がり、手動での転記をなくすことによるエラー削減は、実際のドル建てで測定可能になります。月に10件以上のRFQを処理する場合、手動ワークフローは、抽出ツールのサブスクリプション費用を上回る人件費だけでコストがかかっています。これは、チームが新たに実行できる追加RFQの価値を考慮する前の段階での話です。
AI抽出によって、ベンダー見積の人的レビューの必要性はなくなりますか?
いいえ。比較と意思決定のステップ(どのサプライヤーが最良の価値を提供するかの判断、過去の実績の考慮、スコープの前提条件の評価など)には、依然として調達の専門知識が必要です。AI抽出が変えるのは、調達担当者の時間が、データの抽出や転記ではなく、そうした判断重視のステップに費やされるようになることです。抽出により比較表の初稿が作成され、バイヤーがそれをレビューし、修正し、落札先を決定します。意思決定の質は、データ入力ではなく評価により多くの時間が割かれるため、向上します。
見積比較にSAP AribaやCoupaを使わないのはなぜですか?
SAP Ariba、Coupa、JAGGAERは、正式なサプライヤー管理プログラム、専任の調達ITサポート、エンタープライズプラットフォームの導入と維持のための予算を持つ組織向けに設計された、エンタープライズ調達スイートです。これらのRFQモジュールでは、サプライヤーがプラットフォームを通じて回答を提出する必要があります。これは、サプライヤーがこれらのシステムに既にネットワーク接続されている大企業である場合にはうまく機能しますが、サプライヤーが電子メールの添付ファイルで見積を送ってくる中堅・中小企業である場合には、しばしば機能しません。40社の異なるサプライヤーから調達している売上高5,000万ドルのメーカーの調達マネージャーにとって(そのほとんどがAribaにログインすることはないでしょう)、エンタープライズスイートは比較ワークフローを解決しますが、比較すべきデータが存在するプロセスの時点には到達しません。これは、軽量な抽出ツールが埋める構造的なギャップです。
AI抽出はベンダー見積書のどのような文書形式に対応していますか?
PDFファイル(デジタル生成およびスキャン)、JPG/PNG画像、WebPに対応しています。これにより、実際のベンダー見積書のあらゆる形式をカバーします:ERP生成PDF、WordからPDFへの書き出し、スキャンした紙のフォーム、印刷された見積書の写真、サプライヤーポータルのスクリーンショットなどです。スキャン文書の手書き文字も読み取れますが、精度はスキャン品質に依存します — 印刷されたフォームのクリーンなスキャンは高い精度を生みますが、角度のついた手書き価格の低解像度のスマホ写真は手動レビューが必要になる場合があります。
抽出は異なる言語でも機能しますか?
はい。基盤となるビジュアル言語モデルは、言語に関係なくテキストを読み取ります。中国語、ドイツ語、ポルトガル語、スペイン語のベンダー見積書も同じように処理されます — カラム名が抽出をガイドし、値は記載どおりに返されます。価格やリードタイムなどの数値フィールドは、ソース言語に関係なくクリーンな出力を生成します。複数地域から調達する国際的な調達チームにとって、これは言語固有の手動データ入力という追加の手間を排除します。
カラム定義はRFQサイクル間で再利用できますか?
はい。カラムセット — 単価、最小発注数量(MOQ)、リードタイム、支払条件、見積有効期限など、抽出したいフィールドのリスト — は、アカウント内で名前付きテンプレートとして保存できます。標準のRFQ比較カラムは一度定義すれば、将来のすべてのサイクルにワンクリックで適用できます。つまり、RFQごとの繰り返し作業は次のようになります:ファイルをアップロードし、保存済みテンプレートを選択し、比較テーブルをエクスポートする。カラムの再定義も、サプライヤーごとの設定も不要です。
AI抽出は測定単位を自動的に正規化しますか?
AIは文書に記載されたとおりの値を抽出します — サプライヤーAが「ケースあたり24個」と書き、サプライヤーBが「ユニットあたり」と書いた場合、両方の値がそのまま取得されます。正規化ステップ — すべてを共通の単位基準に変換すること — は、抽出後に行われるスプレッドシート操作のままです。この設計選択は意図的です:抽出ステップは機械的であり、前提を導入すべきではありません。正規化ステップは、データ入力中の暗黙の判断ではなく、可視化され、数式ベースで、監査可能です。比較の前にPDF見積書をExcelに変換する必要があるチームにとって、この分離により監査トレイルをクリーンに保てます。
政府調達チームにとってコンプライアンス上の影響はありますか?
連邦調達規則(FAR)第6部および第13部(簡略化調達手続)の下では、競争的な見積比較は単なるベストプラクティスではなく、規制上の要件です。文書化の負担(見積が適切に依頼され、受領され、公正に比較されたことの証明)は、比較ワークフローにさらなる層を追加します。AI抽出は、一貫性のあるタイムスタンプ付きの記録(元の文書と標準化された形式の抽出データ)を生成します。これはFARが要求する授与理由の文書化に代わるものではありませんが、比較エビデンスをまとめるための管理作業を軽減します。FAR 52.244-5(下請負における競争)の適用を受ける政府請負業者は、下請負業者の競争的選定を文書化するという同じ要件に直面します。抽出ワークフローは、これらの監査要件に対応する防御可能な証跡を生成します。
AI支援アプローチは、抽出と比較を別々の順次ステップとして再構成し、各ステップを検証・レビュー可能にします。データ入力と等価性の判断が同じ動作で行われ、区別できないセルを生成する単一の融合プロセスではなくなります。月に5件以上のRFQを処理するチームにとって、この再構成は時間を取り戻し、「これらの見積もりが本当に比較可能だとどうやって確認できるのか」と聞かれたときに自信を持って答えられる判断を生み出します。