Manueller vs. KI-Angebotsvergleich:
Der echte Unterschied im Workflow
Warum vergleichen Beschaffungsteams in mittelständischen Fertigungsbetrieben, Bauunternehmen und Logistikdienstleistern Angebote immer noch in Tabellenkalkulationen – obwohl SAP Ariba, Coupa und JAGGAER seit über zwei Jahrzehnten RFQ-Automatisierung verkaufen? Die Antwort ist die Lücke, die dieser Vergleich untersucht: Die meisten Beschaffungssoftware-Lösungen befassen sich mit dem, was passiert, nachdem Angebote ins System gelangen. Sie befassen sich nicht damit, wie sie dorthin gelangen.
Wichtigste Erkenntnisse
- 85% der Zeit für den Angebotsvergleich vergeht, bevor die Beschaffungsentscheidung überhaupt beginnt: Einzelpreise in fünf unterschiedlich formatierten PDFs finden, 35 Werte manuell in Excel übertragen und Einheiten normalisieren, wenn ein Lieferant pro Karton und ein anderer pro Stück kalkuliert.
- Ab mehr als 15 RFQs pro Monat ist der manuelle Angebotsvergleich nicht mehr nur mühsam, sondern wird zur Obergrenze der Beschaffungskapazität Ihres Teams. Der Engpass ist nicht die Beschaffungskompetenz. Es sind die Stunden, die für die Dateneingabe aufgewendet werden, und der Preis dafür sind die Lieferanten, die Sie nie bewerten.
- ImageToTable.ai entkoppelt die Datenextraktion von der Gleichwertigkeitsbeurteilung: Der Prüfer startet mit einer ausgefüllten Vergleichstabelle statt mit fünf geöffneten PDFs, und der Prüfmodus zeigt, woher jeder Wert im ursprünglichen Angebot stammt, sodass jede Frage „Sind das dieselben Artikel?“ explizit und überprüfbar ist, statt eine stille Annahme in einer Tabellenzelle zu sein.
Eine Angebotsanfrage (RFQ) an fünf Lieferanten erzeugt fünf verschiedene Dokumentstrukturen – und einen universellen Engpass
Senden Sie eine Standard-Angebotsanfrage an fünf Lieferanten, und die Antworten kommen zurück als: eine formatierte PDF aus einem ERP exportiert, ein Word-Dokument, das in PDF konvertiert wurde und Preise in Absätzen versteckt, ein gescannter Ausdruck eines Formulars mit handschriftlicher Unterschrift, eine Excel-Datei mit einem anderen Spaltenlayout als bei jedem anderen Lieferanten, und gelegentlich nur ein E-Mail-Text ohne Anhang. Das ist nicht ungewöhnlich – es ist der Standardzustand der Beschaffung in Organisationen, die kein einziges Lieferantenportal vorschreiben. Die Open-Standards-Benchmarking-Daten von APQC zeigen, dass Organisationen 14 bis über 54 US-Dollar für die Verarbeitung einer einzigen Bestellung (PO) ausgeben, wobei Spitzenreiter 98 % der Bestellungen elektronisch genehmigen, während der Median bei etwa 80 % liegt. Die Lücke zwischen diesen beiden Zahlen ist die Dateneingabe-Reibung, die der manuelle Vergleich erzeugt.
Was beim manuellen Vergleich tatsächlich passiert, Schritt für Schritt:
Öffnen Sie jede PDF und finden Sie die Felder
Der Stückpreis von Lieferant A steht in einer Tabelle unter „Unit Rate (500+).“ Bei Lieferant B steht er mitten im Satz: „our unit cost for volumes exceeding 40 units per month would be $4.20.“ Lieferant C hat ihn handschriftlich in ein Formularfeld mit der Bezeichnung „Price Each“ eingetragen. Denselben Datenpunkt in fünf Dokumenten zu finden, ist eine visuelle Suchaufgabe, die sich für jede Spalte Ihrer Vergleichstabelle wiederholt.
Übertragen Sie die Werte in die Vergleichstabelle
Bei fünf Lieferanten und sieben Vergleichsspalten – Lieferantenname, Stückpreis, MOQ, Lieferzeit, Zahlungsbedingungen, Angebotsgültigkeit, Garantie – sind das 35 manuelle Einträge. Jeder erfordert Fensterwechsel, das Auffinden des Werts, die Eingabe und die Überprüfung, ob er in der richtigen Zelle gelandet ist. Bei einem Bauleistungsverzeichnis mit 300 Positionen wächst das auf über 1.500 Einträge.
Vereinheitlichen Sie abweichende Einheiten und Formate
Lieferant A kalkuliert pro Karton mit 24 Stück. Lieferant B kalkuliert pro Stück. Lieferant C kalkuliert pro Palette mit 120 Stück. Der Analyst rechnet im Kopf oder mit Hilfsspalten, um alles auf eine gemeinsame Basis zu bringen – eine Ermessensentscheidung, die bei einem falschen Ziffernschritt die Kostenvergleich um eine Größenordnung verschiebt.
Gleichen Sie Positionen über Lieferanten hinweg ab
Lieferant A listet „SSD-500-SATA.“ Lieferant B schreibt „Solid State Drive, 500 Gigabytes.“ Sind sie gleichwertig? Der Analyst entscheidet – und diese Entscheidung, getroffen um 16 Uhr kurz vor Abgabefrist, bestimmt, welcher Lieferant günstiger erscheint. Niemand prüft sie später, weil die Tabelle sie nicht als Ermessensentscheidung kennzeichnet.
Wenden Sie Bewertungsformeln an und erstellen Sie die Empfehlung
Die Tabellenkalkulation dauert Minuten. Gewichtete Bewertung, bedingte Formatierung, Pivot-Tabellen – alles sofort. Die Vorlagenarbeit ist der schnellste Teil des Prozesses. Alles davor hat den Tag in Anspruch genommen.
Die Vergleichslogik macht etwa 15 % der gesamten Aufgabenzeit aus. Die restlichen 85 % entfallen auf die Datenlogistik: Werte in Dokumenten lokalisieren, übertragen und normalisieren, um sie in eine Struktur zu bringen, in der der Vergleich beginnen kann. Diese Aufteilung zeigt sich in den oben genannten Zeiten pro Schritt und ist der Grund, warum aus einem theoretisch einfachen Prozess der Engpass wird, mit dem Einkaufsteams in jedem RFQ-Zyklus leben.
Ein RFQ mit fünf Lieferanten dauert manuell 3,25–6,5 Stunden. Der Extraktionsschritt kann in der Zeit erledigt werden, die zum Hochladen der Dateien benötigt wird.
Die Benchmarks von The Hackett Group zeigen, dass seine Digital World Class Einkaufsteams 58 % kürzere Anforderungs-zu-Bestellung-Zykluszeiten aufweisen als typische Organisationen. Die Stunden, die sie trennen, sind die administrativen, die ein RFQ mit fünf Lieferanten erzeugt: Angebote neu formatieren, Vergleichstabellen erstellen, Werte in Dokumenten suchen. Der Durchbruch besteht darin, die Extraktionsbarriere zu beseitigen, sodass sich die Anstrengung auf den Vergleich konzentriert.
Gemessen pro Aufgabe für einen standardmäßigen RFQ mit fünf Lieferanten und sieben Spalten:
| Aufgabe | Manueller Workflow | KI-Extraktions-Workflow |
|---|---|---|
| Dokumente öffnen, Felder lokalisieren | 30–60 Minuten | Nicht erforderlich – KI liest Dokumente direkt |
| Werte in Tabellenkalkulation übertragen | 60–120 Minuten | Nicht erforderlich – Extraktion erzeugt die Tabelle |
| Einheiten und Formate normalisieren | 30–60 Minuten | 5–10 Minuten (prüfen und bei Bedarf anpassen) |
| Positionen über Lieferanten hinweg abgleichen | 45–90 Minuten | 15–30 Minuten (KI-Daten prüfen, Äquivalenzen explizit zuordnen) |
| Bewertung anwenden, Empfehlung erstellen | 30–60 Minuten | 30–60 Minuten (unverändert – erfordert weiterhin menschliches Urteilsvermögen) |
| Gesamt pro RFQ-Zyklus | 3,25–6,5 Stunden | 1,3–2,7 Stunden |
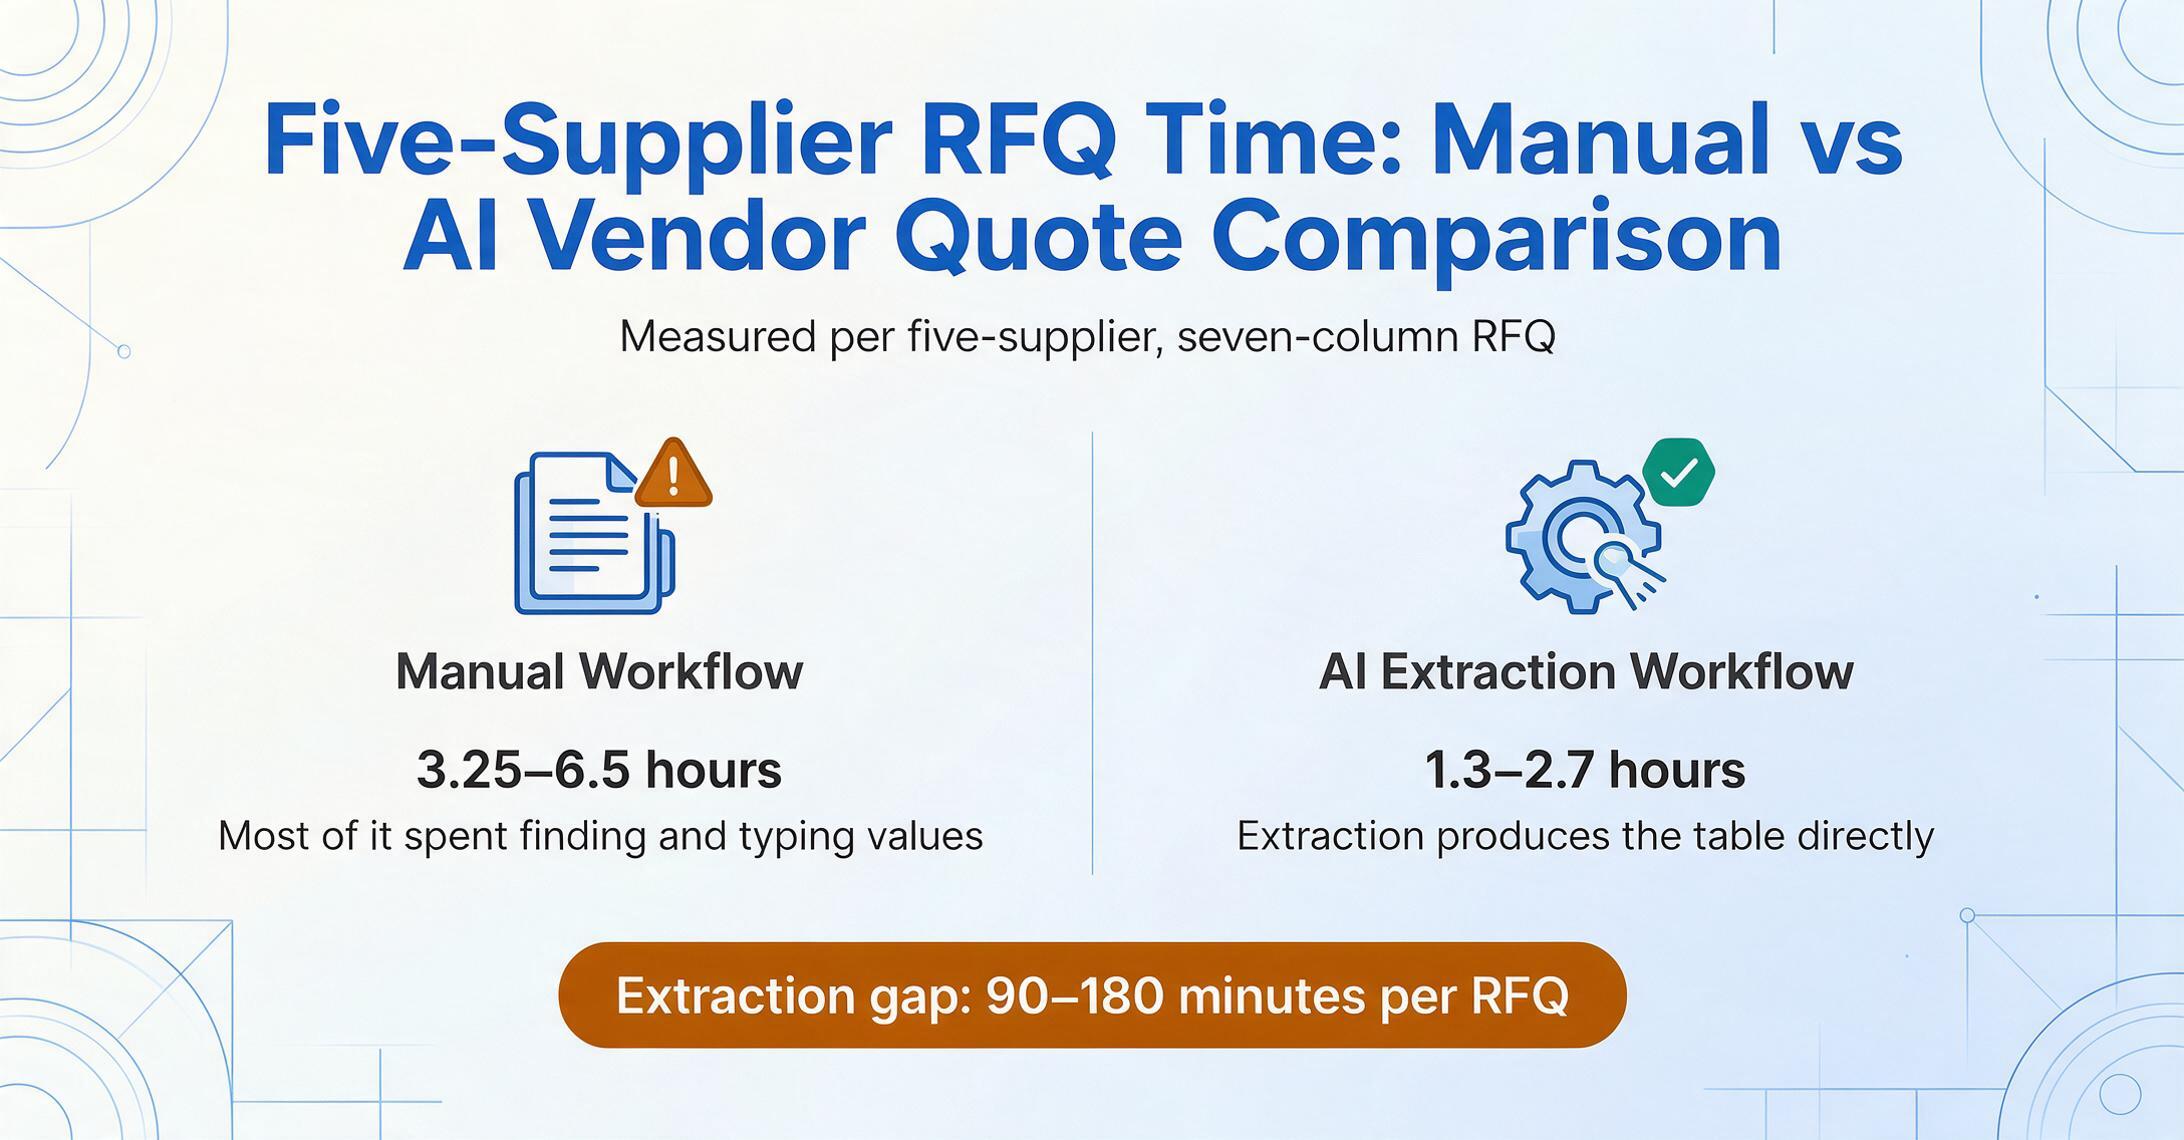
Die Extraktionslücke – das Auffinden von Werten in Dokumenten und deren Übertragung in eine Tabelle – macht 90–180 Minuten pro Angebotsanfrage mit fünf Lieferanten aus. Bei vollständig belasteten Personalkosten von 85 $/Stunde im Einkauf entspricht das 127–255 $ an eingesparten Arbeitskosten pro RFQ, noch bevor die Folgekosten verzögerter Entscheidungen oder abgelaufener Angebote berücksichtigt werden, während die Tabelle noch erstellt wurde. Bei 10 RFQs pro Monat decken die allein gewonnenen Stunden die Kosten für das Extraktionstool. Die Phasen des Vergleichs und der Entscheidungsfindung – die Arbeit, die Einkaufsexpertise erfordert – bleiben in Zeit und Qualität unverändert.
Was diese Geschwindigkeit ermöglicht, ist ein grundlegend anderer Ansatz beim Lesen von Dokumenten. In einem manuellen Arbeitsablauf öffnen Sie jede PDF-Datei, suchen nach dem Stückpreis, finden ihn und tippen ihn ein – und wiederholen das dann für MOQ, Lieferzeit, Zahlungsbedingungen usw. In einem KI-gestützten Arbeitsablauf mit Spaltennamen-Extraktion definieren Sie, was Sie extrahieren möchten – die Spaltennamen wie „Stückpreis“, „MOQ“, „Lieferzeit (Tage)“ – und die KI findet jeden Wert überall auf der Seite, indem sie dessen semantische Bedeutung versteht, nicht indem sie sich merkt, wo ein Feld in einem früheren Dokument positioniert war. Dieselben Spaltendefinitionen funktionieren mit jedem Lieferantenformat ohne anbieterspezifische Konfiguration.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Verarbeitungszeit von 5–10 Sekunden pro Seite (im Vergleich zu etwa 3 Minuten manueller Arbeit pro Seite) bedeutet, dass der Geschwindigkeitsvorteil mit dem Dokumentvolumen wächst – aber nur für den Extraktionsschritt. Der Entscheidungsschritt beschleunigt sich nicht, weil er das nicht muss; das Urteilsvermögen des Einkäufers ist der Wert, nicht der Engpass.
Manueller Vergleich erzeugt drei Fehlertypen, die sich über Positionen hinweg verstärken. KI-Extraktion ersetzt zwei davon.
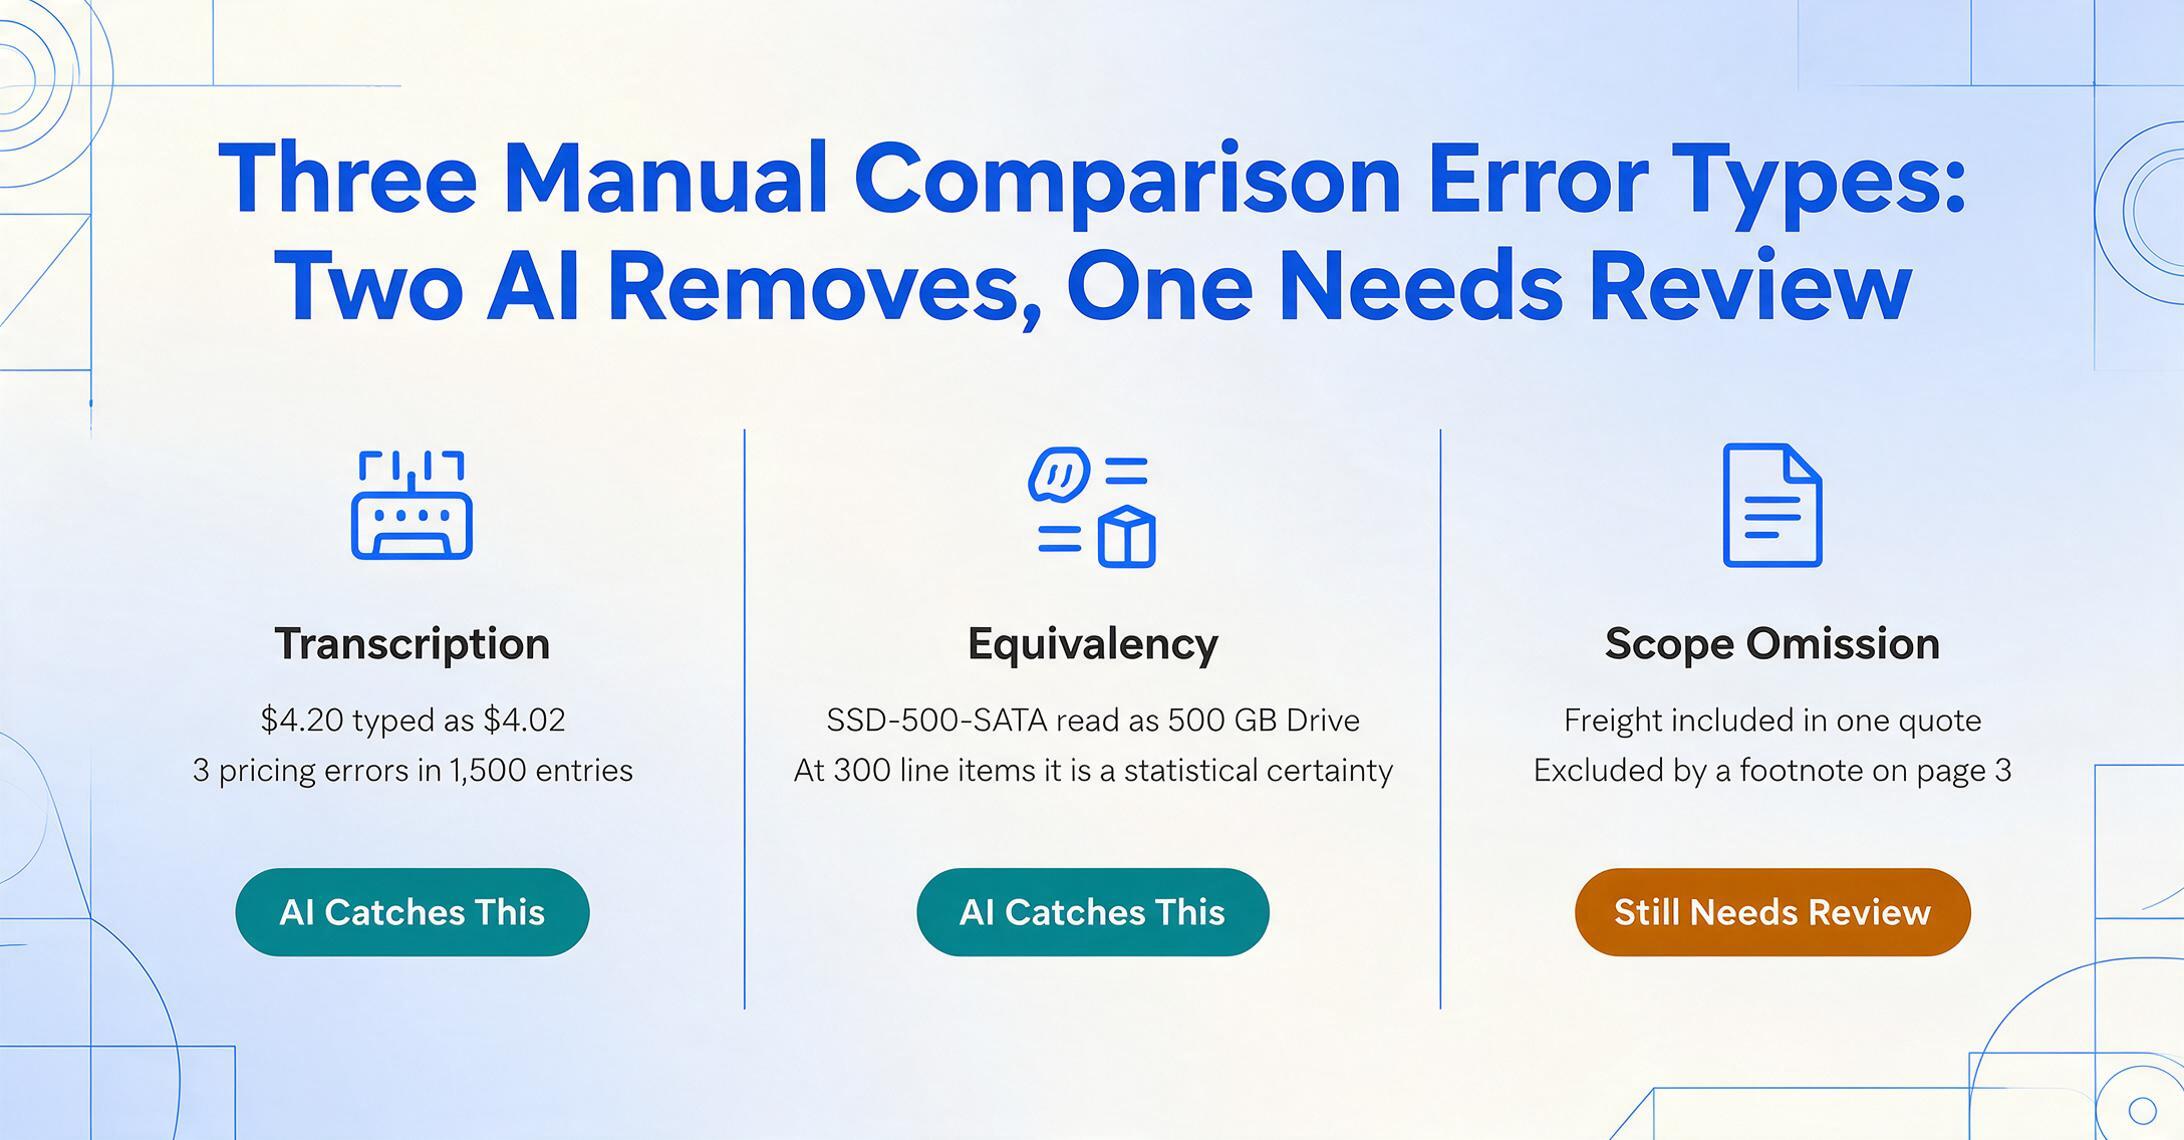
Die Diskussion über die Genauigkeit von Angebotsvergleichen konzentriert sich meist auf „Tippfehler“ – eine vertauschte Ziffer, ein übersehenes Dezimalkomma. Doch die teureren Fehler beim manuellen Vergleich sind struktureller Natur, nicht typografischer Art, und sie fallen in drei Kategorien:
Transkriptionsfehler. Der Wert im PDF beträgt 4,20 $. Der Wert in der Tabelle beträgt 4,02 $. Eine einzige Vertauschung bei einem Materialvertrag über 500.000 $ reicht aus, um zu ändern, welcher Lieferant günstiger erscheint, und eine Leistungsbeschreibung mit 300 Positionen verlangt vom Prüfer, 1.500 Werte von Hand einzugeben. Die Fehlerquote bei ununterstützter manueller Eingabe liegt im niedrigen einstelligen Prozentbereich pro Feld, sodass ein so erstellter Vergleich bereits mehrere falsche Zahlen enthält, bevor ihn jemand prüft. Die branchenübergreifende Studie von CAPS Research aus dem Jahr 2022 bezifferte die Spanne der Bearbeitungskosten für Bestellungen (PO) zwischen den besten und schlechtesten Unternehmen auf das 14-fache (53 $ bis 741 $); Nacharbeit ist einer der Kostentreiber am oberen Ende dieser Spanne.
Äquivalenzfehler. Der Analyst entscheidet, dass „SSD-500-SATA“ und „Solid State Drive, 500 Gigabytes“ dasselbe Produkt sind, und trägt sie in dieselbe Zeile ein. Wenn es sich tatsächlich um unterschiedliche Produktkonfigurationen handelt – eine in Unternehmensqualität, eine in Verbraucherqualität – ist der gesamte Positionsvergleich ungültig, und der Fehler bleibt unsichtbar, weil die Tabelle die Äquivalenzannahme als Tatsache behandelt. Dies ist der Fehlertyp, den manuelle Prozesse proportional zur Anzahl der Positionen erzeugen, nicht zur Fähigkeit des Analysten. Bei 300 Positionen ist er statistisch sicher.
Umfangsauslassungsfehler. Das Angebot von Lieferant A enthält den Frachtzuschlag. Lieferant B schließt ihn mit einer Fußnote auf Seite 3 aus. Der Analyst überfliegt die Fußnote und vergleicht direkt die Grundpreise. Der „günstigere“ Lieferant entpuppt sich als teurer, sobald die Frachtrechnung separat eintrifft – doch die Entscheidung wurde bereits auf Grundlage der Tabelle getroffen. Ein Einkaufsleiter auf Reddits r/procurement beschrieb dieses Muster unverblümt: „Wenn ein Lieferant stundenweise und ein anderer zum Festpreis anbietet, verbringen Sie die halbe Zeit mit Übersetzen statt mit Bewerten.“ Der Übersetzungsschritt kostet die Stunden, aber die darin verborgenen Umfangsannahmen kosten das Geld.
| Fehlertyp | Manueller Workflow | KI-Extraktions-Workflow |
|---|---|---|
| Transkription | Vorhanden — jede manuelle Eingabe birgt ein > 0-Risiko für Tippfehler oder Vertauschungen | Eliminiert — die KI liest das Dokument direkt; kein manueller Abtippschritt |
| Äquivalenz | Vorhanden — wird bei der Dateneingabe stillschweigend vorgenommen, nicht dokumentiert | Weiterhin vorhanden — aber in einen separaten, überprüfbaren Schritt nach der Extraktion verlagert |
| Umfangslücken | Vorhanden — Fußnoten und Ausschlüsse werden beim manuellen Scannen leicht übersehen | Reduziert — die KI liest das gesamte Dokument inklusive Fußnoten; leere Zellen kennzeichnen fehlende Daten |
KI-Extraktion eliminiert keine Äquivalenzfehler — bei zwei Produkten mit unterschiedlichen Beschreibungen muss weiterhin ein Mensch entscheiden, ob sie identisch sind. Aber sie trennt die Extraktion der Rohdaten von der Äquivalenzbeurteilung. Der Analyst prüft eine Tabelle, in der die Werte jedes Lieferanten bereits ausgefüllt sind, und die Zuordnungsentscheidung ist explizit und überprüfbar — keine stille Annahme beim Wechsel zwischen Fenstern. Wie in unserer Analyse zu dem versteckten Fehler beim manuellen Angebotsvergleich dargelegt, macht genau diese Entkopplung den Vergleich prüfbar statt bloß angenommen.
Verifizierung ist das, was diese Entkopplung in der Praxis wertvoll macht. ImageToTable.ai bietet dafür einen Review-Modus: Fahren Sie mit der Maus über eine extrahierte Zelle oder klicken Sie sie an, und das Originalangebot markiert exakt die Stelle, aus der der Wert stammt; ein Klick auf einen Bereich im Quelldokument springt zurück zu seiner Zelle. Ein Feld bearbeitet? Ein Klick zeigt die ursprüngliche KI-Lesung und ermöglicht das Zurücksetzen. Für einen Käufer, der fünf Lieferanten durcharbeitet, wird aus „Ist dieser Stückpreis wirklich das, was Anbieter B genannt hat?" statt einer Suche in einer PDF-Datei ein Blick auf eine markierte Zeile — und Auto-annotate kann dieselbe Prüfung über alle Dateien in einem Batch ausführen, sodass die Rückverfolgung bereits vor der Prüfung bereitliegt. Die Grenze sollte klar benannt werden: Der Review-Modus bestätigt, woher ein Wert stammt, nicht ob er in den Vergleich gehört. Die Äquivalenzentscheidung bleibt bei Ihnen.
Bei drei Angebotsanfragen (RFQ) pro Monat ist der manuelle Vergleich eine kleine Reibung. Bei fünfzehn wird er zum Kapazitätslimit des Teams.
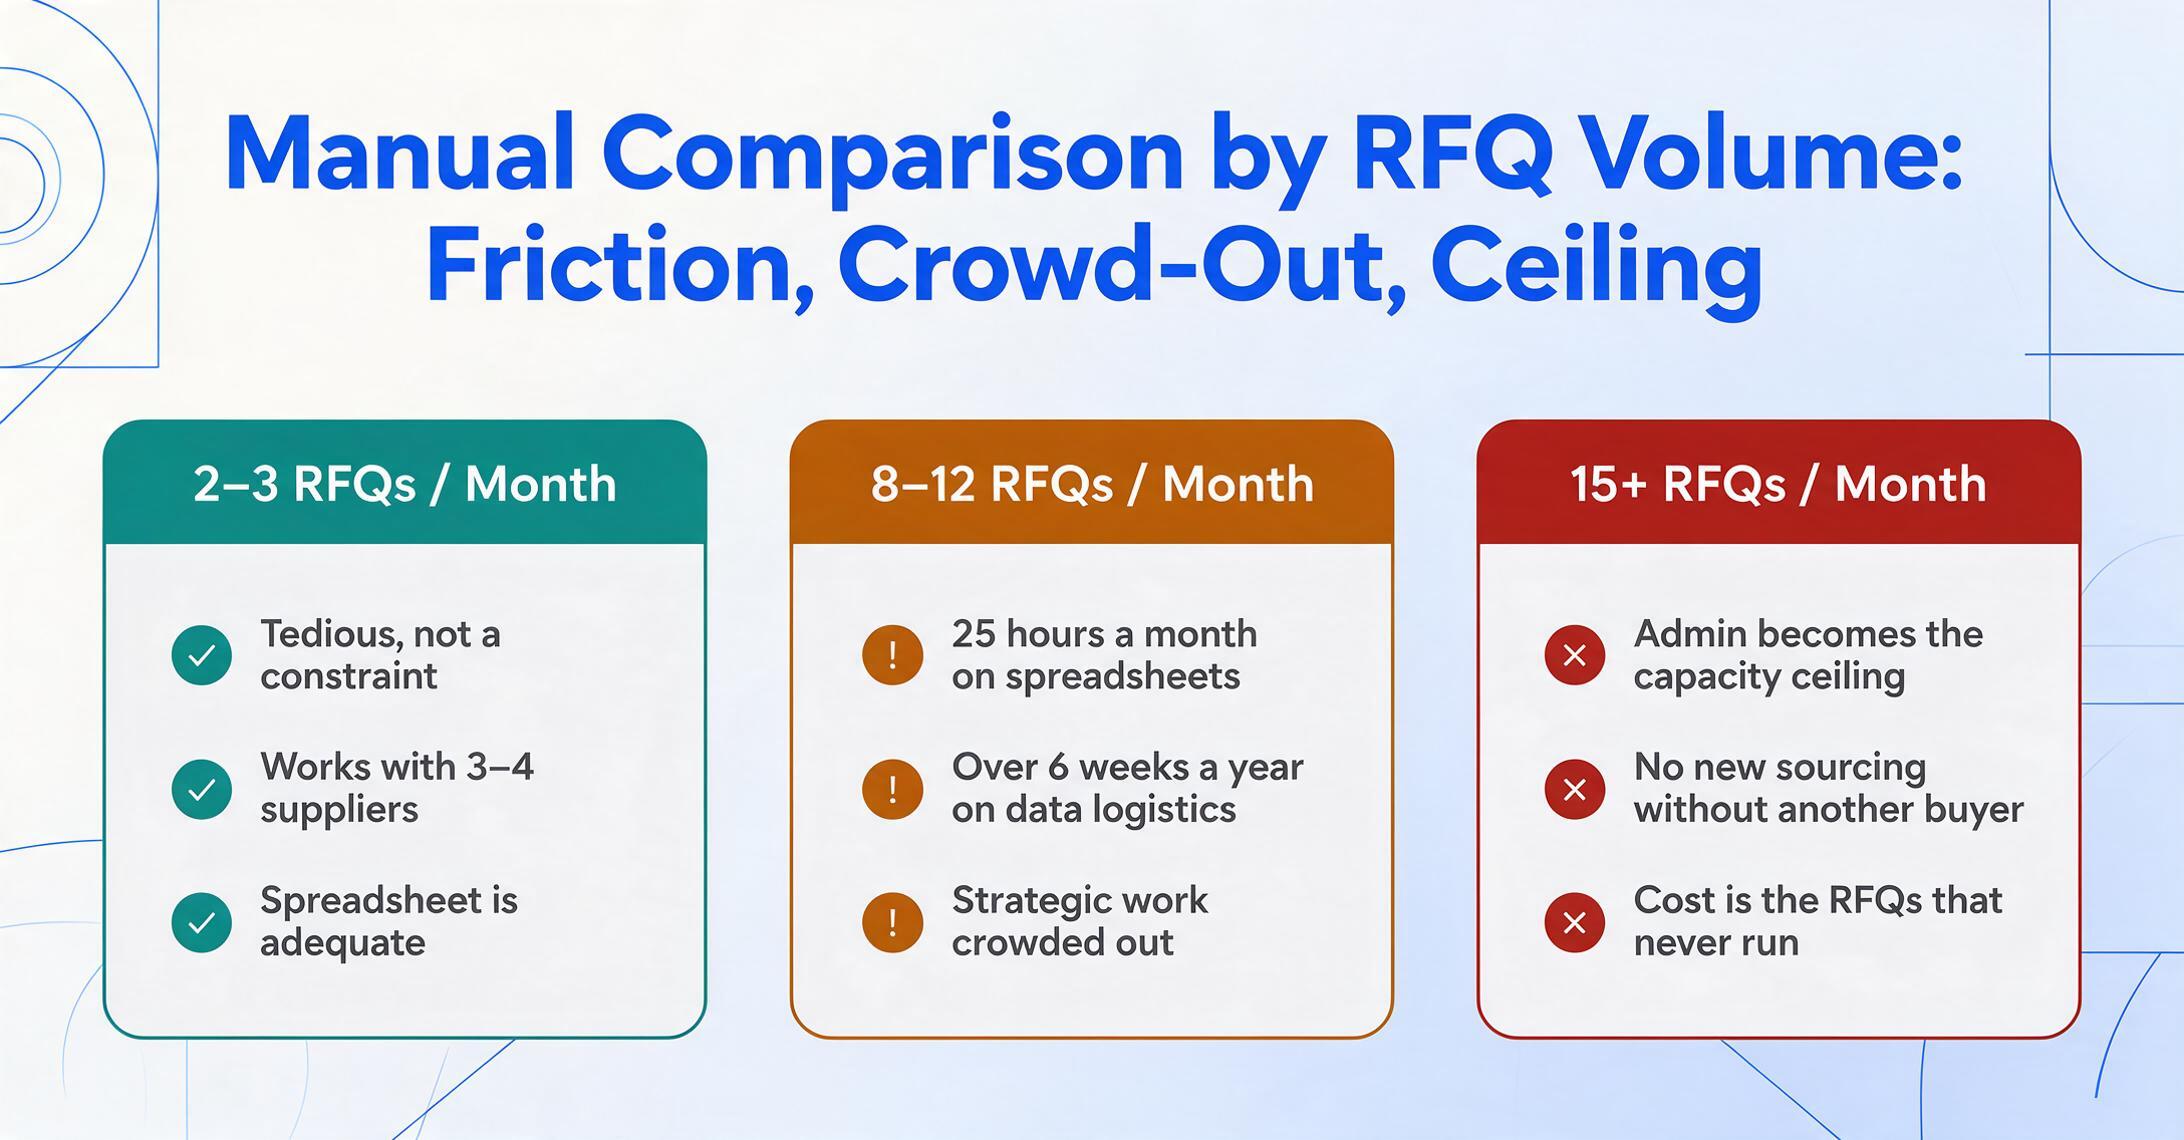
Die Skalierungsschwelle ist die Dimension, an der der manuelle Workflow bricht, und es lohnt sich, hier präzise zu sein. Für ein Team mit 2–3 RFQ-Zyklen pro Monat und 3–4 Lieferanten pro Zyklus funktioniert der manuelle Vergleich – er ist mühsam, aber keine strukturelle Einschränkung. Ein Einkaufsprofi beschrieb diese Zone auf Reddit: „Ich übernehme die Daten aus den Angeboten und trage sie in meine eigene ‚Vergleichs-Excel‘ ein, wo ich die Angebote der einzelnen Lieferanten vergleichen kann (das gilt für große RFQ-Situationen).“ Für kleine RFQs ist die Tabellenkalkulation ausreichend.
Bei 8–12 RFQs pro Monat beginnen die administrativen Stunden, die strategische Arbeit zu verdrängen. Ein Einkäufer, der 25 Stunden pro Monat damit verbringt, Vergleichstabellen aus PDFs zu erstellen, verbringt über 6 Wochen pro Jahr mit Datenlogistik statt mit Lieferantenverhandlungen, Marktanalysen oder Kostensenkungsinitiativen. Dies ist die Schwelle, an der der 85%-Anteil der Datenlogistik keine Abstraktion mehr ist: Was wie eine kleine Abgabe auf jede RFQ wirkte, wird zur dominierenden Arbeitslast des Monats.
Bei 15+ RFQs pro Monat wird der manuelle Vergleich zur Obergrenze des Einkaufsdurchsatzes. Das Team kann keine weiteren Sourcing-Events durchführen, ohne einen weiteren Einkäufer einzustellen – nicht weil die strategische Arbeit es erfordert, sondern weil der administrative Aufwand für den Aufbau von Vergleichstabellen alle verfügbaren Stunden verbraucht. Die Kosten sind nicht die Arbeitskraft – es sind die RFQs, die nicht durchgeführt werden, die Lieferanten, die nicht bewertet werden, die Kosteneinsparungen, die nicht realisiert werden, weil das Team mit dem Erstellen von Tabellen ausgelastet war.
Diese Skalierungslücke macht die Batch-Extraktion zu einer eigenständigen Fähigkeit gegenüber der Einzeldokumentverarbeitung. Mit der Batch-Extraktion werden alle Angebotsdateien der Lieferanten auf einmal hochgeladen – unabhängig von ihren ursprünglichen Formaten – und in einem einzigen Vorgang zu einer Vergleichstabelle verarbeitet. Die Extraktionszeit pro RFQ sinkt von Stunden auf Minuten, unabhängig davon, ob die RFQ 5 oder 15 Lieferanten umfasst. Die Vergleichs- und Entscheidungsarbeit bleibt proportional zum Volumen, aber die Extraktionsbarriere ist vollständig beseitigt.
Jeder Einkaufsprofi weiß bereits, wie man Angebote in Excel vergleicht. Die Lernkurve für Extraktionstools besteht aus einem einzigen neuen Muster.
Das stärkste Argument für den manuellen Workflow ist, dass er keinerlei Schulung erfordert. Ein neuer Einkäufer, der Excel verwendet hat – also jeder neue Einkäufer – kann am ersten Tag eine Vergleichstabelle erstellen. Der Prozess ist langsam, fehleranfällig und kapazitätsbegrenzt – aber allgemein zugänglich. Das ist kein geringer Vorteil. Jeder alternative Workflow muss eine Hürde überwinden, die der manuelle Prozess standardmäßig erfüllt: Er muss schneller zu erlernen sein als die Zeit, die er einspart, gemessen innerhalb eines einzigen RFQ-Zyklus.
Die Lernkurve für KI-gestützte Extraktion konzentriert sich auf ein einziges neues Muster: Statt jede PDF-Datei zu öffnen und Werte in eine Tabelle einzutippen, lädt der Benutzer alle Dateien hoch und definiert, was extrahiert werden soll. Die Spaltennamen sind dieselben, die man in Excel eintippen würde – „Stückpreis“, „MOQ“, „Lieferzeit“ – aber die KI lokalisiert die Werte über Dokumente hinweg, anstatt dass ein Mensch jede PDF-Datei liest. Einmal definiert, können Spaltensätze als benannte Vorlagen gespeichert und mit einem Klick über RFQ-Zyklen hinweg wiederverwendet werden.
Zum Vergleich: Das RFQ-Modul von SAP Ariba benötigt Wochen für die Implementierung und erfordert, dass Lieferanten die Plattform nutzen. Die Bietfunktion von Coupa erfordert Lieferanten-Onboarding und Portal-Adoption. Die Sourcing-Tools von JAGGAER setzen ein strukturiertes Ausgabenmanagement-Programm voraus, das bereits existiert. Diese Plattformen haben Lernkurven, die in Monaten gemessen werden, und Einführungskurven, die in Lieferantenbeziehungen gemessen werden – weshalb sie trotz ihrer Größe in der Enterprise-Beschaffungssoftware den tabellenbasierten Vergleich im Mittelstand nicht ersetzt haben. Der KI-Extraktionsansatz hat eine Lernkurve, die in der Zeit gemessen wird, die zum Hochladen einer Datei und zum Eintippen eines Spaltennamens benötigt wird – eine Schwelle, die innerhalb des ersten RFQ-Zyklus überschritten werden kann.
Für Teams, die sich für den Extraktionsansatz bei Bestellungen interessieren, gibt es einen ähnlichen dimensionalen Vergleich für PO-Dateneingabe: ERP-Vorlagen vs. KI-Extraktion, wo dieselbe Lücke zwischen strukturierten Systemeingabeanforderungen und realer Dokumentenvielfalt einen identischen Reibungspunkt schafft.
Wo der manuelle Workflow noch messbare Vorteile hat – und wo nicht
Ein ehrlicher Vergleich zwischen manuell und KI muss beide Seiten zeigen. Der manuelle Workflow ist in mehreren Dimensionen tatsächlich überlegen, und diese anzuerkennen, verleiht dem Rest des Vergleichs sein Gewicht:
- Keine Grenzkosten. Excel ist bereits lizenziert. Keine Gebühr pro Angebotsanfrage (RFQ), keine Seitenlimit-Stufe, keine Abo-Bewertung. Für Organisationen mit weniger als drei RFQs pro Monat decken die Zeitersparnisse der Automatisierung die Tool-Kosten nicht – der manuelle Workflow ist die wirtschaftlich rationale Wahl.
- Volle Formatflexibilität bei der Ausgabe. Der manuelle Prozess kann jedes Layout, jedes Bewertungsmodell, jede Pivot-Struktur erzeugen – weil ein Mensch sie erstellt. Extraktionstools erzeugen eine standardisierte Tabelle; wenn der Vergleichsworkflow ein hochgradig individuelles Format verlangt, kann ein manueller Neuerstellungsschritt weiterhin nötig sein.
- Kontextuelles Urteilsvermögen bei der Extraktion. Wenn ein erfahrener Einkäufer ein Angebot eines Lieferanten liest, fallen ihm möglicherweise Dinge auf, die eine KI-Extraktion übersieht: „Dieser Lieferant bietet immer Net 30 an, liefert aber zu spät – berücksichtigen Sie das in der Bewertung.“ Dieses institutionelle Wissen lebt im Kopf des Einkäufers, nicht im Dokument, und es kommt bei der manuellen Prüfung zum Vorschein, was die automatisierte Extraktion nicht erfasst.
- Dokumentation für öffentliche Beschaffung. Gemäß FAR Teil 6 (Wettbewerbsanforderungen) müssen Vergabeverantwortliche die Grundlage für Zuschlagsentscheidungen dokumentieren und begründen. Der manuelle Prozess erzeugt trotz seiner Ineffizienz eine inhärente Papierspur: die Originalangebote, die Vergleichstabelle, die Notizen des Analysten. KI-gestützte Workflows können dieselbe Dokumentation erzeugen – aber der Extraktionsschritt muss so konfiguriert sein, dass Originaldokumente neben extrahierten Daten für Compliance-Zwecke aufbewahrt werden. In der öffentlichen Beschaffung arbeiten automatisierte Tools mit dem manuellen Compliance-Rahmenwerk, nicht als Ersatz dafür.
Die Dimensionen, in denen manuell verliert – und zwar proportional zum Volumen –, sind Geschwindigkeit, Konsistenz (Fehlerquote pro Eintrag) und Skalierbarkeit. Diese Dimensionen verstärken sich gegenseitig: Ein Team, das 90 Minuten pro RFQ bei der Extraktion spart, kann mehr RFQs bearbeiten, mehr Lieferanten bewerten und mehr Einsparungen erzielen – ohne zusätzliches Personal. Ein typisches Beschaffungsteam mit 10 RFQs pro Monat gewinnt etwa 15–25 Stunden pro Monat zurück, oder 1.275–2.125 $ an monatlichen Arbeitskosten bei üblichen Beschaffungs-Stundensätzen. Die eigentliche Frage ist, ab welchem RFQ-Volumen die Kosten des manuellen Workflows die Lerninvestition für einen Wechsel übersteigen.
Häufig gestellte Fragen zum Vergleich manueller vs. KI-gestützter Angebotsvergleiche
Ab wann lohnt sich der manuelle Angebotsvergleich nicht mehr?
Bei etwa 3–5 Angebotsanfragen (RFQ) pro Monat mit jeweils mehr als 3 Lieferanten. Unterhalb dieser Schwelle könnte sich der Zeitaufwand für das Erlernen eines neuen Tools nicht schnell genug amortisieren, um den Wechsel zu rechtfertigen – insbesondere für Organisationen mit stabilen Lieferantenbeziehungen, bei denen jede Angebotsanfrage (RFQ) vertraute Dokumentformate wiederverwendet. Oberhalb dieser Schwelle summieren sich die Zeitersparnisse bei der Extraktion monatlich, und die Fehlerreduzierung durch den Wegfall manueller Übertragung wird in echten Dollar messbar. Bei 10+ Angebotsanfragen (RFQ) pro Monat kostet der manuelle Workflow allein an Arbeitszeit mehr als das Extraktionstool an Abonnementgebühren – noch bevor der Wert zusätzlicher Angebotsanfragen (RFQ) berücksichtigt wird, die das Team nun durchführen kann.
Macht die KI-Extraktion die menschliche Prüfung von Lieferantenangeboten überflüssig?
Nein. Die Schritte des Vergleichs und der Entscheidungsfindung – die Bestimmung, welcher Lieferant das beste Preis-Leistungs-Verhältnis bietet, die Berücksichtigung vergangener Leistungen, die Bewertung von Umfangsannahmen – erfordern weiterhin Einkaufsexpertise. Was die KI-Extraktion ändert, ist, dass die Zeit des Einkaufsprofis für diese urteilintensiven Schritte aufgewendet wird, statt für die Extraktion und Übertragung von Daten. Die Extraktion erzeugt eine Vergleichstabelle im Entwurfsstadium; der Käufer prüft, korrigiert und trifft die Vergabeentscheidung. Die Qualität der Entscheidung verbessert sich, weil mehr Zeit in die Bewertung fließt, nicht in die Dateneingabe.
Warum nicht einfach SAP Ariba oder Coupa für den Angebotsvergleich nutzen?
SAP Ariba, Coupa und JAGGAER sind Enterprise-Beschaffungssuiten, die für Organisationen mit formalen Lieferantenmanagementprogrammen, dediziertem IT-Support für die Beschaffung und dem Budget für Implementierung und Wartung einer Enterprise-Plattform entwickelt wurden. Ihre Angebotsanfrage-Module (RFQ-Module) erfordern, dass Lieferanten Antworten über die Plattform einreichen – das funktioniert gut, wenn Ihre Lieferanten große Unternehmen sind, die bereits in diesen Systemen vernetzt sind, scheitert jedoch oft, wenn Ihre Lieferanten mittelständische oder kleinere Unternehmen sind, die Angebote als E-Mail-Anhänge senden. Für den Einkaufsleiter eines 50-Millionen-Dollar-Herstellers, der von 40 verschiedenen Lieferanten bezieht – von denen die meisten sich nie bei Ariba anmelden werden – löst die Enterprise-Suite den Vergleichsworkflow, erreicht aber nie den Punkt im Prozess, an dem die zu vergleichenden Daten existieren. Diese strukturelle Lücke füllen leichtgewichtige Extraktionstools.
Welche Dokumentformate kann die KI-Extraktion für Lieferantenangebote verarbeiten?
PDF-Dateien (sowohl digital erstellt als auch gescannt), JPG/PNG-Bilder und WebP werden unterstützt. Dies deckt die gesamte Bandbreite realer Lieferantenangebotsformate ab: ERP-generierte PDFs, Word-zu-PDF-Exporte, gescannte Papierformulare, Fotos von gedruckten Angeboten und Screenshots von Lieferantenportalen. Handschrift auf gescannten Dokumenten ist lesbar, wobei die Genauigkeit mit der Scanqualität abnimmt – ein sauberer Scan eines gedruckten Formulars liefert hohe Genauigkeit, während ein niedrig aufgelöstes Handyfoto von handschriftlichen Preisen in einem Winkel möglicherweise eine manuelle Überprüfung erfordert.
Funktioniert die Extraktion über verschiedene Sprachen hinweg?
Ja. Das zugrunde liegende visuelle Sprachmodell liest Text unabhängig von der Sprache. Ein Lieferantenangebot auf Chinesisch, Deutsch, Portugiesisch oder Spanisch wird auf die gleiche Weise verarbeitet – Spaltennamen steuern die Extraktion, und Werte werden wie geschrieben zurückgegeben. Numerische Felder wie Preis und Lieferzeit liefern saubere Ergebnisse unabhängig von der Ausgangssprache. Für internationale Einkaufsteams, die über Regionen hinweg beschaffen, entfällt dadurch der zusätzliche Aufwand der sprachspezifischen manuellen Dateneingabe.
Können Spaltendefinitionen über RFQ-Zyklen hinweg wiederverwendet werden?
Ja. Spaltensätze – die Liste der Felder, die Sie extrahieren möchten, wie Stückpreis, MOQ, Lieferzeit, Zahlungsbedingungen, Angebotsgültigkeit – können als benannte Vorlagen in Ihrem Konto gespeichert werden. Ihre Standard-RFQ-Vergleichsspalten werden einmal definiert und mit einem Klick auf jeden zukünftigen Zyklus angewendet. Das bedeutet, der wiederkehrende Aufwand pro RFQ ist: Dateien hochladen, Ihre gespeicherte Vorlage auswählen, die Vergleichstabelle exportieren. Keine Neudefinition von Spalten, keine Konfiguration pro Lieferant.
Normalisiert die KI-Extraktion Maßeinheiten automatisch?
Die KI extrahiert Werte wie im Dokument angegeben – wenn Lieferant A „pro Karton mit 24 Stück“ schreibt und Lieferant B „pro Stück“, werden beide Werte unverändert erfasst. Der Normalisierungsschritt – die Umrechnung aller Werte auf eine gemeinsame Einheitenbasis – bleibt eine Tabellenkalkulationsoperation, die nach der Extraktion durchgeführt wird. Diese Designentscheidung ist beabsichtigt: Der Extraktionsschritt sollte mechanisch sein und keine Annahmen einführen. Der Normalisierungsschritt ist dann sichtbar, formelbasiert und prüfbar, statt einer stillen Beurteilung während der Dateneingabe. Für Teams, die PDF-Angebote in Excel konvertieren müssen, bevor sie vergleichen, hält diese Trennung den Prüfpfad sauber.
Gibt es Compliance-Auswirkungen für Beschaffungsteams im öffentlichen Sektor?
Gemäß FAR Teil 6 und FAR Teil 13 (vereinfachte Beschaffungsverfahren) ist der wettbewerbliche Angebotsvergleich eine regulatorische Anforderung und nicht nur eine bewährte Praxis. Der Dokumentationsaufwand – der Nachweis, dass Angebote eingeholt, erhalten und fair verglichen wurden – stellt eine zusätzliche Ebene im Vergleichsworkflow dar. Die KI-Extraktion erzeugt einen konsistenten, zeitgestempelten Datensatz: Originaldokumente plus extrahierte Daten in einem standardisierten Format. Dies ersetzt nicht die dokumentierte Zuschlagsbegründung, die nach FAR erforderlich ist, reduziert jedoch den Verwaltungsaufwand für die Zusammenstellung der unterstützenden Vergleichsnachweise. Auftragnehmer des öffentlichen Sektors, die FAR 52.244-5 (Wettbewerb bei Untervergabe) unterliegen, stehen vor derselben Anforderung, die wettbewerbliche Auswahl von Unterauftragnehmern zu dokumentieren – der Extraktionsworkflow erzeugt eine belastbare Dokumentationskette für diese Prüfungsanforderungen.
Der KI-gestützte Ansatz strukturiert die Arbeit so um, dass Extraktion und Vergleich getrennte, aufeinanderfolgende Schritte sind, die jeweils überprüfbar und nachvollziehbar sind, anstatt eines einzigen verschmolzenen Prozesses, bei dem Dateneingabe und Gleichwertigkeitsbewertung in derselben Bewegung stattfinden und dieselbe nicht unterscheidbare Zelle erzeugen. Für Teams mit 5+ RFQs pro Monat bringt diese Umstrukturierung Stunden zurück und führt zu Entscheidungen, hinter denen Sie stehen können, wenn jemand fragt: „Woher wissen wir, dass diese Angebote tatsächlich vergleichbar sind?“
Verwandt: Was der Vergleich von Lieferantenangeboten Ihr Team monatlich an Stunden kostet · Batch-Extraktion von Lieferantenangeboten für den Vergleich in Excel