A IA consegue extrair tabelas de imagens?
Sim — e funciona bem
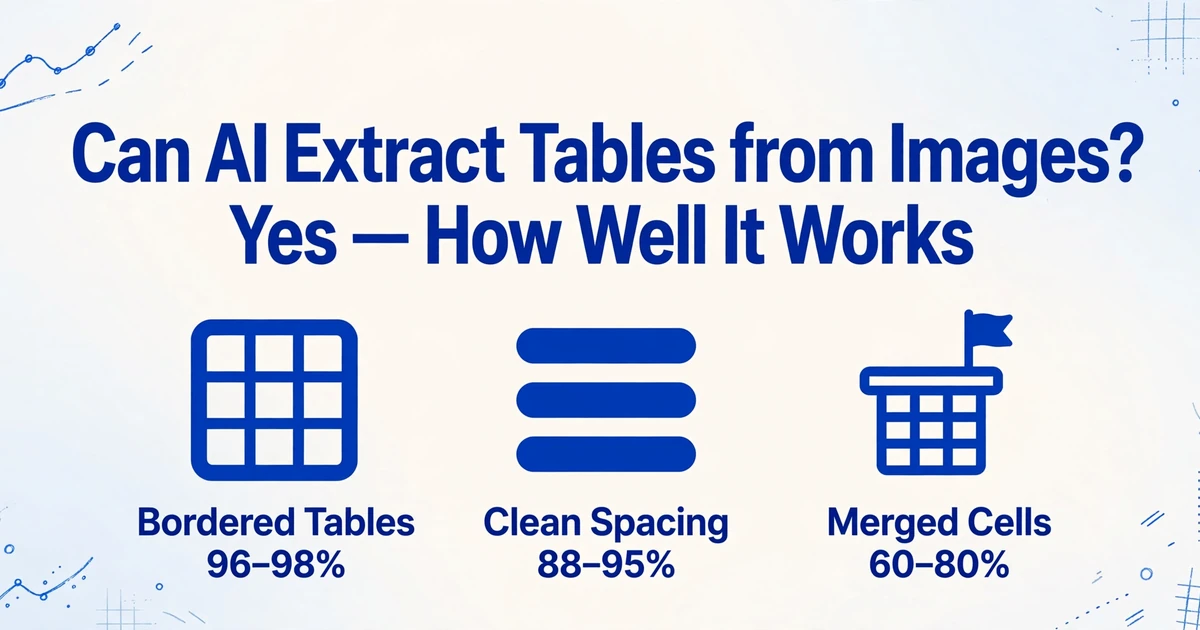
Sim. A IA consegue extrair dados de tabelas — linhas, colunas, cabeçalhos e valores de células — de imagens de tabelas com e sem bordas. Tabelas com bordas alcançam reconhecimento de estrutura quase perfeito, frequentemente acima de 95%. Tabelas sem bordas com espaçamento claro entre colunas funcionam bem na faixa de 85–95%. Tabelas densas sem bordas, com células mescladas e cabeçalhos hierárquicos, continuam sendo o caso mais difícil, geralmente ficando em 60–85% e exigindo alguma limpeza manual. A diferença não está em a IA "entender" tabelas — ela entende — mas na ambiguidade inerente que uma imagem de tabela apresenta: quando não há limites visuais, até um leitor humano precisa adivinhar a qual célula um valor pertence.
Principais Conclusões
- A precisão da extração de tabelas pela IA cai de 96% em tabelas com bordas para 60% em tabelas com células mescladas — e a culpa não é do modelo, mas da imagem de entrada que já apagou a estrutura hierárquica.
- Uma célula mesclada que abrange três linhas significa "esta categoria cobre os próximos três itens" — óbvio para um leitor humano, mas para uma IA operando em uma imagem plana, é um problema de inferência em que a estrutura de árvore não existe mais nos dados.
- Defina suas colunas de saída explicitamente — Descrição do Item, Quantidade, Preço Unitário — e a IA localiza os valores pelo significado semântico em vez de reconstruir a grade da tabela, contornando completamente a ambiguidade das células mescladas.
Qualidade por Tipo de Tabela
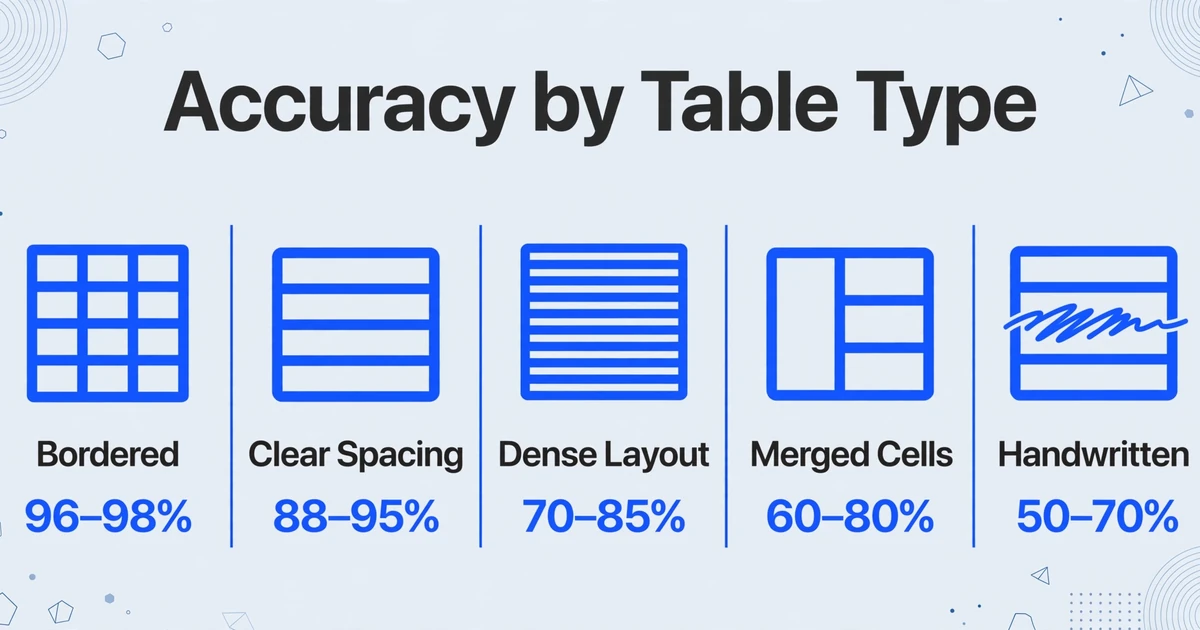
A pergunta "a IA consegue extrair tabelas de imagens" não tem uma resposta única. Depende inteiramente da tabela na sua imagem — não da capacidade geral da IA. Décadas de pesquisa em visão computacional, culminando no benchmark TableBank (417.234 tabelas rotuladas) e no PubTabNet (mais de 568.000 imagens de tabelas), produziram um quadro claro do que funciona e do que não funciona. Veja o detalhamento:
| Tipo de Tabela | Precisão da Estrutura (S-TEDS) | Conteúdo + Estrutura (TEDS) | O Que Faz Funcionar / Falhar |
|---|---|---|---|
| Tabelas com bordas | 96–98% | 90–95% | As linhas de grade fornecem limites inequívocos de células. A IA de visão detecta linhas como separadores; a detecção de colunas é quase perfeita. |
| Sem bordas, espaçamento claro | 88–95% | 85–93% | O espaço em branco entre colunas é suficiente quando amplo e consistente. A IA infere limites de colunas a partir de padrões de alinhamento. |
| Sem bordas, layout denso | 70–85% | 65–80% | Lacunas estreitas entre colunas borram os limites. Valores como "2.400.000" ao lado de "12,5%" com espaçamento fino são mesclados em uma única célula cerca de um terço das vezes. |
| Células mescladas | 60–80% | 55–75% | Rowspan/colspan quebram a suposição de grade. A IA precisa inferir quais linhas uma célula mesclada abrange — trivial para humanos, estruturalmente ambíguo para algoritmos. |
| Tabelas manuscritas | 50–70% | 40–65% | Desafio duplo: reconhecer a caligrafia e inferir a estrutura da tabela a partir de alinhamento irregular. Até operadores humanos de entrada de dados ficam significativamente mais lentos nesses casos. |
Esses números vêm da métrica TEDS (Tree-Edit-Distance-based Similarity) usada em benchmarks acadêmicos. O S-TEDS mede a fidelidade estrutural — há o número correto de linhas e colunas, com abrangência correta de células? O TEDS adiciona a precisão do conteúdo — os valores dentro de cada célula estão corretos? Um benchmark de 2025 de modelos de visão-linguagem no PubTabNet descobriu que VLMs de uso geral alcançam 74–85% de TEDS na extração bruta, enquanto modelos especializados em tabelas com pipelines de pré-processamento chegam à faixa de 93%+ (framework NGTR, IJCAI 2025).
A implicação prática: se você está extraindo dados de tabelas limpas de faturas com bordas ou relatórios estruturados, a IA é madura e pronta para produção. Se você está lidando com um anexo de contrato digitalizado contendo uma tabela de preços densa, sem bordas e com cabeçalhos de categorias mesclados — espere gastar tempo com verificação manual. Para uma visão mais ampla do que a extração de documentos por IA pode e não pode fazer em todos os tipos de documento, consulte nosso guia sobre o que é a extração de documentos por IA.
O que a IA faz bem
Três cenários de tabelas em que a IA visual moderna entrega consistentemente resultados de nível de produção:
Tabelas com bordas de qualquer fonte. Seja uma fatura em PDF, uma captura de tela de um portal contábil ou uma foto de um pedido de compra impresso — se a tabela tem linhas de grade visíveis, a IA detecta os limites das células com precisão quase perfeita. A razão é direta: linhas horizontais e verticais criam um gráfico inequívoco que um modelo de IA pode analisar deterministicamente, semelhante a como analisaria uma grade de planilha. Ferramentas tradicionais de OCR como Camelot também alcançam 90%+ em tabelas bem delimitadas, mas a IA adiciona a capacidade de lidar com bordas curvas ou inclinadas que quebram detectores de linha baseados em regras.
Tabelas sem bordas com espaçamento limpo. Faturas modernas de plataformas SaaS, firmas de serviços profissionais e fornecedores com design arrojado frequentemente usam layouts de tabela baseados em espaços em branco — sem linhas de grade, apenas espaçamento generoso entre colunas. Essas tabelas são projetadas para serem legíveis por humanos apenas através do alinhamento, e modelos de IA treinados em milhões de imagens de tabelas aprenderam a mesma dica visual. Quando os espaços entre colunas são consistentes e mais largos que os espaços entre palavras dentro de uma célula, a IA identifica corretamente os limites em 90%+ das vezes.
Tabelas de várias páginas com estrutura consistente. Quando uma tabela abrange várias páginas com o mesmo layout de colunas em cada página — comum em extratos bancários, relatórios financeiros e contas de serviços públicos — a IA pode processar cada página independentemente e mesclar os resultados em uma única planilha contínua. É aqui que o design de processamento prioritário em lote das ferramentas modernas de extração se torna crítico: você envia todas as páginas de uma vez e recebe uma única tabela de saída unificada, não N extrações separadas que precisam de costura manual.
Onde Ele Enfrenta Dificuldades
Ser específico sobre os modos de falha gera mais confiança do que afirmar 99% de precisão em tudo. Aqui estão os cenários em que a extração de tabelas por IA ainda exige supervisão humana:
Células mescladas com semântica direcional. Uma célula que abrange três linhas em um cabeçalho de coluna significa "esta é a categoria pai para as próximas três linhas." Para um humano, isso é óbvio. Para uma IA, é um problema de inferência estrutural: reconstruir uma árvore a partir de uma grade plana. Quando células mescladas cobrem quatro ou mais linhas, ou quando aparecem simultaneamente em cabeçalhos de linhas e colunas, a precisão cai drasticamente. Um estudo comparativo de 2024 sobre ferramentas de parsing de PDF descobriu que a precisão do parser degradou mais em documentos com layouts não padronizados e mesclagem complexa de células.
Isso não é uma falha da inteligência da IA — é uma falha do formato de entrada. Uma imagem de tabela com células mescladas perdeu a estrutura hierárquica que existiria na fonte original (HTML com atributos rowspan, ou uma planilha com regiões mescladas). A IA está sendo solicitada a reconstruir informações que foram removidas quando a tabela foi renderizada como uma imagem plana. Isso é um problema de inferência, não de reconhecimento.
Cabeçalhos hierárquicos. Tabelas em que os cabeçalhos de coluna têm relações pai-filho (ex.: "Q1 2025" abrangendo "Jan," "Fev," "Mar") e os cabeçalhos de linha também têm grupos pai criam uma hierarquia bidimensional. A maioria dos modelos de IA gera uma tabela plana — uma linha de cabeçalho, depois linhas de dados. Eles não preservam nativamente a relação hierárquica, a menos que sejam explicitamente instruídos. O resultado é frequentemente uma tabela plana tecnicamente correta que perdeu a estrutura multinível que o autor original pretendia. Nossa abordagem de Extração de Colunas Personalizadas contorna isso permitindo que você defina o esquema de saída antecipadamente, em vez de pedir à IA para inferi-lo da imagem.
Grades densas sem bordas e com larguras de célula variáveis. Quando uma tabela não tem bordas, lacunas estreitas entre colunas e células com quantidades variadas de texto (alguns valores curtos, algumas descrições longas), os limites de espaços em branco se tornam ambíguos. Uma célula contendo "Invoice #2405-001" ao lado de uma célula contendo "Office Supplies — Stationery (Bulk Order)" pode ser interpretada como três colunas separadas se a IA julgar mal os limites de espaços em branco.
Tabelas manuscritas. Mesmo quando a caligrafia em si é legível (o que a IA de visão lida com 85–95% de precisão, conforme abordado em nosso guia sobre reconhecimento de escrita manual por IA), o problema estrutural se agrava. Tabelas manuscritas têm alinhamento irregular de colunas — valores se deslocam para a esquerda ou direita, alturas de linha variam e linhas raramente são retas. A IA deve resolver dois problemas difíceis simultaneamente: reconhecimento de texto e inferência estrutural a partir de uma grade irregular.
Como os Métodos Tradicionais se Compara
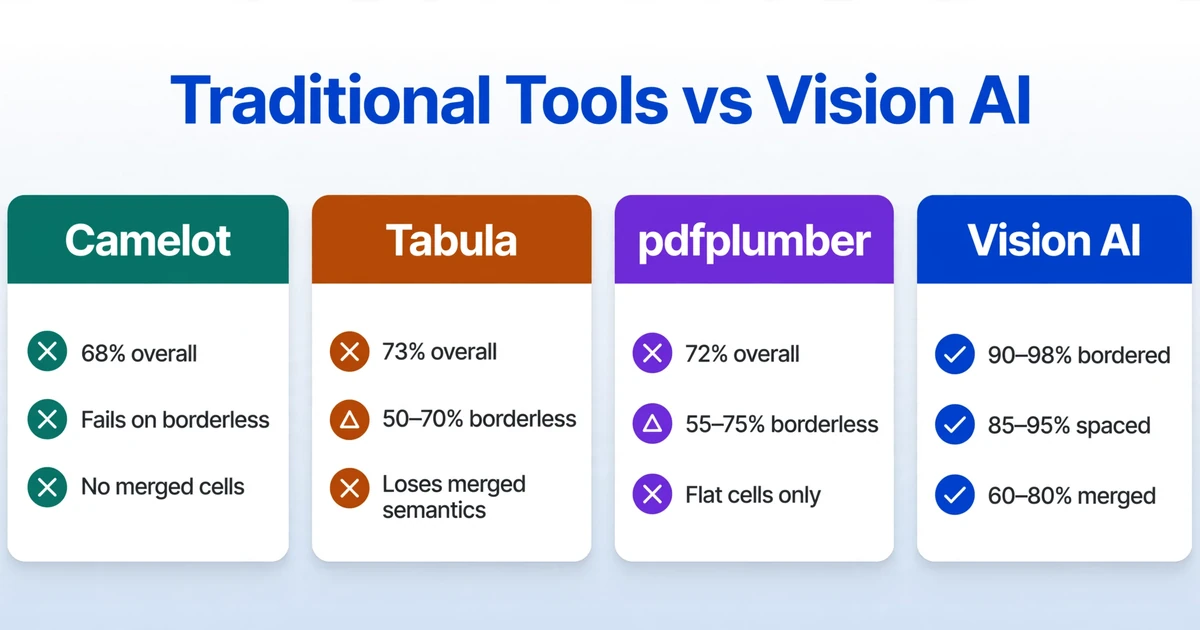
Antes da IA de visão, extrair tabelas de imagens significava combinar várias ferramentas frágeis. Entender a abordagem antiga explica por que a capacidade de extração de tabelas da IA é uma mudança real de paradigma.
| Método | Como Funciona | Precisão em Tabelas com Bordas | Precisão em Tabelas sem Bordas | Células Mescladas |
|---|---|---|---|---|
| Camelot (modo lattice) | Detecta linhas visuais no PDF/imagem e calcula interseções de células | ~68% no geral (entre tipos de documentos) | Falha completamente — o modo lattice exige bordas visíveis | Falha — sem detecção de linhas, não há grade |
| Tabula | Extrai posições de texto do PDF e agrupa por proximidade espacial | ~73% no geral | 50–70% — o modo stream adivinha limites de colunas a partir de espaços em branco | Copia o valor da célula mesclada para células adjacentes arbitrárias, perdendo a semântica |
| pdfplumber | Extração de texto em nível de caractere com análise explícita de espaços em branco | ~72% no geral | 55–75% — mais configurável que o Tabula, mas mesma abordagem fundamental | Sem tratamento de células mescladas; gera células planas |
| Vision AI / VLM | Lê a tabela como uma cena visual — entende estrutura, texto e relações simultaneamente | 90–98% | 85–95% (espaçadas) / 65–80% (densas) | 60–80% — infere extensão a partir do contexto, mas não perfeitamente |
A abordagem tradicional tem um problema arquitetural fundamental: ela separa o reconhecimento de texto do reconhecimento de estrutura. Primeiro, o OCR extrai texto e posições. Depois, um algoritmo separado — geralmente heurísticas ajustadas manualmente — tenta reconstruir a grade da tabela a partir dessas posições. Se o OCR lê mal um caractere (comum em imagens de baixa resolução) ou posiciona mal uma palavra (comum em documentos inclinados), a inferência de estrutura falha a jusante, sem possibilidade de recuperação. Os erros se acumulam.
A Vision AI evita isso completamente. Ela lê a imagem da tabela como uma cena visual — da mesma forma que você — entendendo que um número sob o cabeçalho "Total" pertence àquela coluna não porque está na coordenada de pixel X, mas porque se alinha semanticamente com tudo o mais na coluna "Total". Isso não é apenas um OCR melhor — é uma abordagem fundamentalmente diferente para o problema, que nossa comparação entre IA e OCR tradicional explora em detalhes.
Como Obter os Melhores Resultados
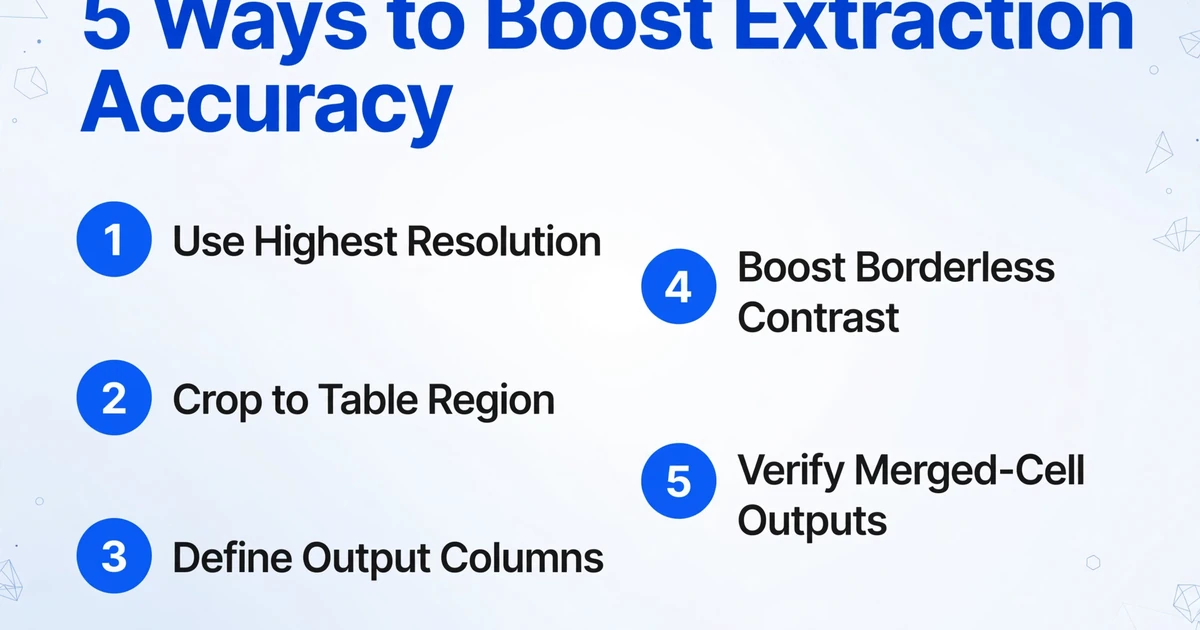
Cinco práticas que melhoram consistentemente a precisão da extração de tabelas por IA, independentemente da ferramenta que você usa:
1. Comece com a maior resolução disponível. Os modelos de IA veem a imagem como uma grade de pixels — mais pixels significam distinção mais precisa entre células adjacentes. Uma análise de 2025 de LLMs de visão no benchmark PubTabNet descobriu que o aumento de escala da imagem era a melhoria de pré-processamento mais comum, utilizada em 64% das extrações bem-sucedidas em entradas de baixa qualidade. Se você está fotografando uma tabela impressa, use a maior resolução que a câmera do seu celular suporta e segure o celular paralelo ao documento para evitar distorção de perspectiva.
2. Recorte para a região da tabela. A IA de visão funciona melhor quando a tabela preenche a maior parte do quadro. Conteúdo extra ao redor da tabela — texto ao redor, logotipos, cabeçalhos de página — adiciona ruído que pode confundir a detecção de colunas. Recorte sua imagem para apenas a área da tabela antes da extração.
3. Defina suas colunas de saída explicitamente. A abordagem mais confiável não é pedir à IA "extraia tudo" — é dizer à IA o que extrair. Quando você especifica nomes de colunas como "Descrição do Item", "Quantidade", "Preço Unitário" e "Total da Linha", a IA sabe exatamente quais campos procurar e onde eles pertencem na saída. Este é o princípio por trás da Extração de Colunas Personalizadas: a IA combina dados com seu esquema ao entender o conteúdo do documento, não ao adivinhar a estrutura da tabela. Para a explicação completa de como isso funciona, veja como a extração orientada por esquema difere da análise de tabela completa.
4. Para tabelas sem bordas, pré-processe com aprimoramento de contraste. Se sua tabela não tem bordas visíveis e espaçamento fino entre colunas, aumentar o contraste da imagem pode ajudar a IA a distinguir os limites das colunas. Até mesmo um simples ajuste de níveis em qualquer editor de imagem — escurecendo o texto, clareando o fundo — melhora a detecção de espaços em branco.
5. Verifique as saídas com células mescladas. Este é o passo que você nunca deve pular. Quando uma tabela tem células mescladas, examine a planilha extraída em busca de linhas onde um valor parece estar ausente ou repetido incorretamente. A inferência estrutural da IA em células mescladas é boa o suficiente para economizar um tempo enorme — ela acerta 80% dos casos — mas os 20% restantes podem introduzir erros que se propagam pela análise downstream se não forem verificados. Trate a extração por IA como um primeiro rascunho que precisa de uma revisão humana de 60 segundos, não como uma caixa-preta que não requer supervisão.
Exemplos Reais: O Que Esperar
Exemplo 1: Um pedido de compra impresso com tabela de itens com bordas. Você fotografa um PO de um fornecedor. A tabela tem bordas nítidas, colunas padrão (Item, Descrição, Qtd, Preço Unitário, Total) e sem células mescladas. A IA extrairá isso com precisão quase perfeita — cada linha, cada valor de célula, alinhado corretamente. Você não gastará tempo com limpeza. Este é o ponto ideal onde a extração de tabelas por IA é genuinamente mais rápida e precisa que a digitação manual.
Exemplo 2: Um extrato bancário em PDF com tabela de transações sem bordas. Extratos bancários geralmente usam layouts de tabela baseados em espaços em branco: colunas de data, descrição, débito, crédito e saldo separadas por lacunas consistentes. A IA lida bem com isso — 90–95% de precisão na estrutura e conteúdo. O erro mais comum é desalinhar descrições longas de transações que invadem a coluna adjacente de débito/crédito. Uma rápida revisão no resultado identifica esses erros em menos de um minuto.
Exemplo 3: Um anexo de contrato escaneado com uma grade de preços densa. Este é o caso mais difícil: sem bordas, espaçamento estreito entre colunas, cabeçalhos de categoria mesclados abrangendo várias subcolunas e valores de dados de comprimentos variados. Espere 65–80% de precisão estrutural. A IA acertará a maioria dos dados, mas pode confundir a relação entre cabeçalhos de categoria mesclados e suas subcolunas. Planeje de 5 a 10 minutos de correção manual em uma tabela de 20 linhas.
Perguntas Frequentes
A IA consegue extrair tabelas de uma foto tirada com meu celular?
Sim, e muitas vezes surpreendentemente bem — desde que a foto seja nítida, bem iluminada e tirada de frente (não em ângulo). O principal modo de falha com fotos de celular é a distorção de perspectiva: uma tabela fotografada em ângulo cria linhas inclinadas que confundem tanto o OCR tradicional quanto o reconhecimento de estrutura da IA. Segure o telefone paralelo à superfície do documento e os resultados serão comparáveis a um escaneamento plano. Para tipos de documento que são mais fotografados do que escaneados, veja nosso guia sobre extração de dados de capturas de tela e fotos.
A IA funciona melhor com PDFs ou imagens?
Depende do PDF. Um PDF de texto nativo (onde você pode selecionar e copiar texto) contém dados de posicionamento que a IA pode usar como um sinal adicional, geralmente melhorando a precisão em 5 a 10 pontos percentuais em relação a uma imagem pura. Um PDF escaneado apenas com imagem equivale a uma imagem. A IA lida com ambos — mas se você tiver escolha, forneça o PDF de texto nativo original em vez de uma captura de tela dele.
A IA consegue lidar com tabelas que têm texto multilinha dentro das células?
Sim, e esta é uma área onde a IA supera significativamente os métodos tradicionais. Quando uma célula contém um parágrafo de texto — comum em anexos de contratos, fichas técnicas e relatórios clínicos — o OCR tradicional perde o controle dos limites das linhas porque quebras de linha dentro de uma célula parecem quebras de linha. A IA de Visão lê a célula como uma entidade inteira e preserva o texto dentro dela, entendendo que uma quebra de linha dentro de "Escopo do Trabalho: O contratante deverá..." não inicia uma nova linha.
Como a IA lida com tabelas que possuem moedas ou formatos numéricos diferentes?
A IA lê valores numéricos em contexto — ela reconhece "1.500,00" como um número formatado no padrão europeu (1.500,00) e "$1.500,00" como formato americano, mesmo que ambos apareçam na mesma tabela. Isso funciona porque a IA de visão não depende de correspondência de padrões em strings numéricas; ela entende o idioma do documento, o contexto das colunas ao redor e o significado provável do valor. Tabelas com formatos mistos — como uma fatura comercial com formatos de moeda mistos — são tratadas corretamente na maioria dos casos.
A IA consegue extrair tabelas que ocupam várias páginas?
Sim. A IA de visão moderna consegue detectar quando uma tabela continua na página seguinte e mesclar os resultados em uma única planilha de saída. Um estudo de 2025 usando o conjunto de dados PubTables-v2 atingiu 99,5% de recall na identificação de continuações de tabelas entre páginas. O requisito prático: todas as páginas devem ser enviadas juntas em lote para que a IA veja a continuidade. Processar as páginas uma a uma perde o contexto entre páginas.
Preciso treinar a IA no formato da minha tabela primeiro?
Não. Esse é um equívoco comum herdado de ferramentas de OCR baseadas em modelos, como Docparser ou Parseur, onde é necessário definir zonas de análise ou regras para cada novo layout de documento. A IA de visão usa compreensão semântica — ela lê sua tabela como um humano faria, sem precisar de exposição prévia ao seu formato específico. A contrapartida: ferramentas baseadas em modelos podem alcançar maior precisão em formatos nos quais foram explicitamente treinadas, mas falham quando o formato muda. A IA lida automaticamente com variações de formato, mas com precisão máxima menor em qualquer formato fixo único. Para uma análise detalhada dessa contrapartida, veja OCR tradicional vs extração por IA.
O que acontece quando uma tabela contém texto e caixas de seleção ou símbolos?
A IA de visão lê caixas de seleção e símbolos contextualmente — uma caixa marcada ao lado de "Frete Expresso" é entendida como "método de envio = expresso", não como um símbolo isolado. Isso funciona porque a IA vê a caixa de seleção e o texto do rótulo juntos como uma unidade semântica, de forma similar a como processa pares chave-valor em outras partes da página. A precisão em dados de caixas de seleção é geralmente de 85–95%, comparável ao texto impresso em tabelas com bordas.
A conclusão: a IA está pronta para tabelas com bordas e bem espaçadas hoje. Ela economiza um tempo enorme mesmo em casos difíceis — porque editar uma extração quase correta é mais rápido do que digitar tudo do zero. E, à medida que os modelos de visão melhoram, a categoria "difícil" encolhe a cada ano. Os dados comprovam isso: as pontuações S-TEDS no PubTabNet subiram de ~65% em 2020 para ~93%+ em 2025, e a tendência ainda não se estabilizou.
Para uma comparação prática de como a extração por IA se sai contra a entrada manual de dados em documentos reais, veja nossa análise de tempo e precisão entre IA e transcrição manual. Ou explore nosso apanhado de as melhores ferramentas de extração de tabelas em 2026 para ver como diferentes ferramentas se comparam nas métricas que importam para seu fluxo de trabalho.