¿Puede la IA extraer tablas de imágenes?
Sí: así de bien funciona
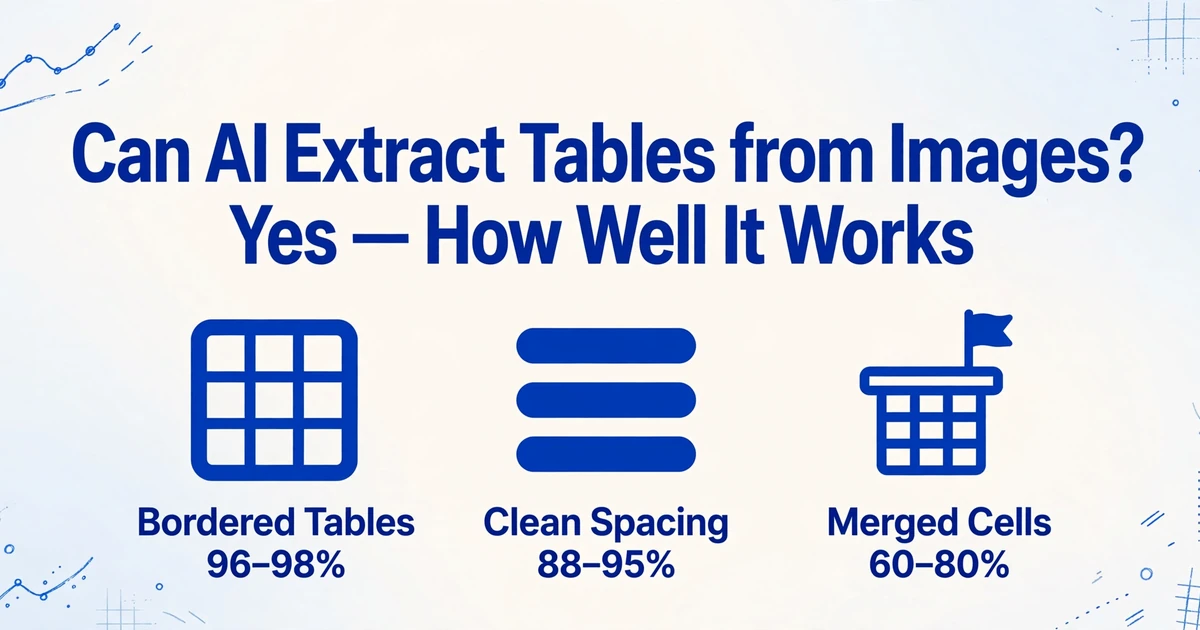
Sí. La IA puede extraer datos de tablas — filas, columnas, encabezados y valores de celda — a partir de imágenes de tablas con y sin bordes. Las tablas con bordes logran un reconocimiento de estructura casi perfecto, que a menudo supera el 95%. Las tablas sin bordes con un espaciado de columnas claro funcionan bien en el rango del 85–95%. Las tablas densas sin bordes con celdas combinadas y encabezados jerárquicos siguen siendo el caso más difícil: normalmente se sitúan en el 60–85% y requieren una limpieza manual. La diferencia no radica en si la IA «entiende» las tablas — las entiende — sino en la ambigüedad inherente que presenta una imagen de tabla: cuando no hay límites visuales, incluso un lector humano tiene que adivinar a qué celda pertenece un valor.
Conclusiones clave
- La precisión de la IA al extraer tablas cae del 96% en tablas con bordes al 60% en tablas con celdas combinadas — y la culpa no es del modelo, sino de la imagen de entrada que ya borró la estructura jerárquica.
- Una celda combinada que abarca tres filas significa «esta categoría cubre los siguientes tres elementos» — algo obvio para un lector humano, pero para una IA que opera sobre una imagen plana es un problema de inferencia en el que la estructura de árbol ya no existe en los datos.
- Defina explícitamente sus columnas de salida — Descripción del artículo, Cantidad, Precio unitario — y la IA localiza los valores por su significado semántico en lugar de reconstruir la cuadrícula de la tabla, evitando por completo la ambigüedad de las celdas combinadas.
Qué tan bien funciona, según el tipo de tabla
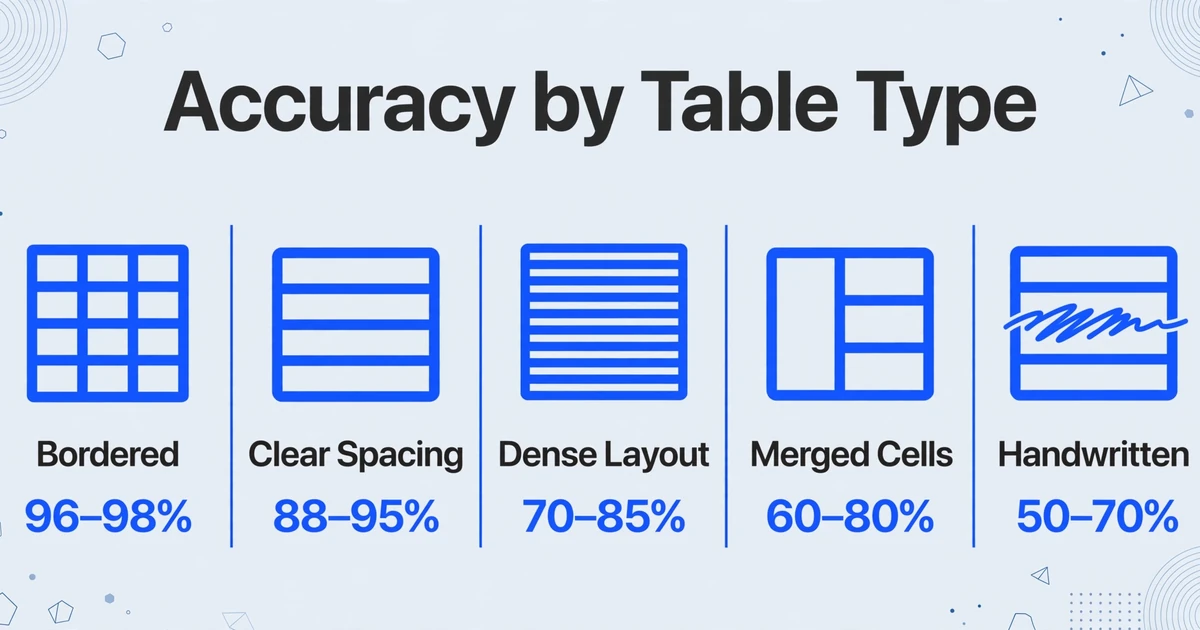
La pregunta «¿puede la IA extraer tablas de imágenes?» no tiene una única respuesta. Depende por completo de la tabla en su imagen, no de la capacidad general de la IA. Décadas de investigación en visión por computadora, que culminaron en el punto de referencia TableBank (417 234 tablas etiquetadas) y PubTabNet (más de 568 000 imágenes de tablas), han producido un panorama claro de lo que funciona y lo que no. Este es el desglose:
| Tipo de tabla | Precisión de estructura (S-TEDS) | Contenido + estructura (TEDS) | Qué hace que funcione o falle |
|---|---|---|---|
| Tablas con bordes | 96–98% | 90–95% | Las líneas de cuadrícula proporcionan límites de celda inequívocos. La IA de visión detecta las líneas como separadores; la detección de columnas es casi perfecta. |
| Sin bordes, con espaciado claro | 88–95% | 85–93% | El espacio en blanco entre columnas es suficiente cuando es amplio y constante. La IA infiere los límites de las columnas a partir de patrones de alineación. |
| Sin bordes, diseño denso | 70–85% | 65–80% | Los espacios estrechos entre columnas difuminan los límites. Valores como «2 400 000» junto a «12,5%» con espaciado reducido se fusionan en una sola celda aproximadamente un tercio de las veces. |
| Celdas combinadas | 60–80% | 55–75% | Rowspan/colspan rompen el supuesto de cuadrícula. La IA debe inferir qué filas abarca una celda combinada: algo trivial para los humanos, pero estructuralmente ambiguo para los algoritmos. |
| Tablas manuscritas | 50–70% | 40–65% | Doble desafío: reconocer la escritura a mano e inferir la estructura de la tabla a partir de una alineación irregular. Incluso los operadores humanos de entrada de datos se ralentizan significativamente con estas. |
Estas cifras provienen de la métrica TEDS (similitud basada en distancia de edición de árbol) utilizada en los puntos de referencia académicos. S-TEDS mide la fidelidad estructural: ¿están presentes el número correcto de filas y columnas, con el combinado de celdas correcto? TEDS añade la precisión del contenido: ¿son correctos los valores dentro de cada celda? Un punto de referencia de 2025 de modelos de visión y lenguaje en PubTabNet encontró que los VLM de propósito general alcanzan un 74–85% de TEDS en la extracción bruta, mientras que los modelos especializados en tablas con canalizaciones de preprocesamiento alcanzan el rango de 93% o más (marco NGTR, IJCAI 2025).
La implicación práctica: si está extrayendo datos de facturas con tablas bordeadas y limpias o de informes estructurados, la IA está madura y lista para producción. Si trabaja con un anexo de contrato escaneado que contiene una tabla de precios densa, sin bordes y con encabezados de categoría combinados — espere dedicar tiempo a la verificación manual. Para una visión más amplia de lo que la extracción de documentos con IA puede y no puede hacer en todos los tipos de documentos, consulte nuestra guía sobre qué es realmente la extracción de documentos con IA.
Lo que la IA hace bien
Tres escenarios de tablas donde la IA de visión moderna ofrece resultados de calidad de producción de forma consistente:
Tablas bordeadas de cualquier fuente. Ya sea una factura en PDF, una captura de pantalla de un portal contable o una foto de una orden de compra impresa — si la tabla tiene líneas de cuadrícula visibles, la IA detecta los límites de las celdas con precisión casi perfecta. La razón es sencilla: las líneas horizontales y verticales crean un gráfico inequívoco que un modelo de IA puede analizar de forma determinista, de manera similar a como analizaría una cuadrícula de hoja de cálculo. Las herramientas OCR tradicionales como Camelot también logran más del 90% en tablas bien bordeadas, pero la IA añade la capacidad de manejar bordes curvos o sesgados que rompen los detectores de líneas basados en reglas.
Tablas sin bordes con espaciado limpio. Las facturas modernas de plataformas SaaS, firmas de servicios profesionales y proveedores orientados al diseño suelen usar diseños de tabla basados en espacios en blanco — sin líneas de cuadrícula, solo un espaciado generoso entre columnas. Estas tablas están diseñadas para ser legibles por humanos solo mediante la alineación, y los modelos de IA entrenados con millones de imágenes de tablas han aprendido la misma señal visual. Cuando los espacios entre columnas son consistentes y más amplios que los espacios entre palabras dentro de una celda, la IA identifica correctamente los límites más del 90% de las veces.
Tablas multipágina con estructura consistente. Cuando una tabla abarca varias páginas con el mismo diseño de columnas en cada página — común en extractos bancarios, informes financieros y facturas de servicios públicos — la IA puede procesar cada página de forma independiente y fusionar los resultados en una sola hoja de cálculo continua. Aquí es donde el diseño de procesamiento por lotes prioritario de las herramientas de extracción modernas resulta crítico: sube todas las páginas a la vez y obtiene una única tabla de salida unificada, no N extractos separados que requieran unión manual.
Dónde presenta dificultades
Ser específico sobre los modos de fallo genera más confianza que afirmar una precisión del 99% en todo. Estos son los escenarios donde la extracción de tablas con IA aún requiere supervisión humana:
Celdas combinadas con semántica direccional. Una celda que abarca tres filas en un encabezado de columna significa "esta es la categoría principal de las tres filas siguientes". Para un humano, eso es obvio. Para una IA, es un problema de inferencia estructural: reconstruir un árbol a partir de una cuadrícula plana. Cuando las celdas combinadas abarcan cuatro o más filas, o cuando aparecen simultáneamente en encabezados de fila y columna, la precisión cae drásticamente. Un estudio comparativo de 2024 sobre herramientas de análisis de PDF encontró que la precisión de los analizadores se degradaba más en documentos con diseños no estándar y celdas combinadas complejas.
Esto no es un fallo de la inteligencia de la IA — es un fallo del formato de entrada. Una imagen de tabla con celdas combinadas ha perdido la estructura jerárquica que existiría en la fuente original (HTML con atributos rowspan, o una hoja de cálculo con regiones combinadas). Se le pide a la IA que reconstruya información que se eliminó cuando la tabla se renderizó como una imagen plana. Eso es un problema de inferencia, no de reconocimiento.
Encabezados jerárquicos. Las tablas donde los encabezados de columna tienen relaciones padre-hijo (p. ej., "Q1 2025" que abarca "Ene," "Feb," "Mar") y los encabezados de fila también tienen grupos principales crean una jerarquía bidimensional. La mayoría de los modelos de IA generan una tabla plana — una fila de encabezado, luego filas de datos. No conservan de forma nativa la relación jerárquica a menos que se les indique explícitamente. El resultado suele ser una tabla plana técnicamente correcta que ha perdido la estructura multinivel que el autor original pretendía. Nuestro enfoque de Extracción de Columnas Personalizadas evita esto al permitirle definir el esquema de salida de antemano, en lugar de pedirle a la IA que lo infiera de la imagen.
Cuadrículas densas sin bordes con anchos de celda variables. Cuando una tabla no tiene bordes, espacios estrechos entre columnas y celdas con cantidades variables de texto (algunos valores cortos, algunas descripciones largas), los límites de los espacios en blanco se vuelven ambiguos. Una celda que contiene "Invoice #2405-001" junto a una celda que contiene "Office Supplies — Stationery (Bulk Order)" podría interpretarse como tres columnas separadas si la IA calcula mal los umbrales de espacios en blanco.
Tablas escritas a mano. Incluso cuando la escritura en sí es legible (que la IA de visión maneja con una precisión del 85–95%, como se cubre en nuestra guía sobre reconocimiento de escritura a mano con IA), el problema estructural se agrava. Las tablas escritas a mano tienen una alineación de columnas irregular — los valores se desplazan a la izquierda o a la derecha, las alturas de fila varían y las líneas rara vez son rectas. La IA debe resolver dos problemas difíciles simultáneamente: el reconocimiento de texto y la inferencia estructural a partir de una cuadrícula irregular.
Cómo se comparan los métodos tradicionales
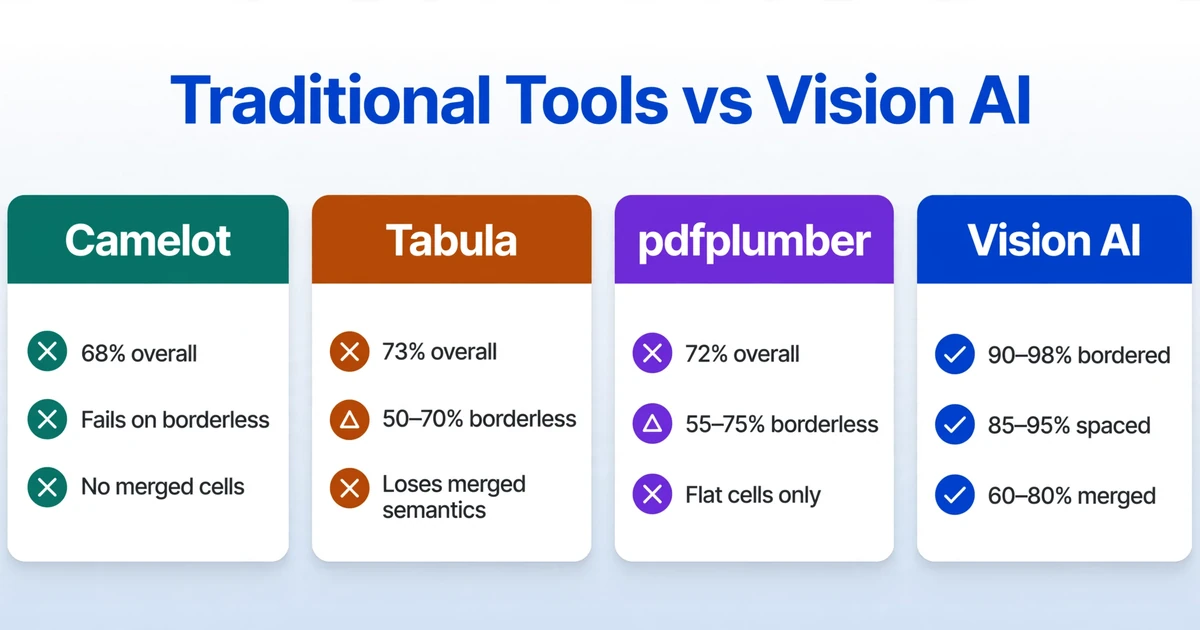
Antes de la IA de visión, extraer tablas de imágenes implicaba combinar múltiples herramientas frágiles. Entender el enfoque antiguo explica por qué las capacidades de extracción de tablas de la IA suponen un cambio cualitativo real.
| Método | Cómo funciona | Precisión en tablas con bordes | Precisión en tablas sin bordes | Celdas combinadas |
|---|---|---|---|---|
| Camelot (modo lattice) | Detecta líneas visuales en el PDF/imagen y calcula las intersecciones de celdas | ~68% en general (según tipo de documento) | Falla por completo: el modo lattice requiere bordes visibles | Falla: sin detección de líneas no hay cuadrícula |
| Tabula | Extrae posiciones de texto del PDF y agrupa por proximidad espacial | ~73% en general | 50–70%: el modo stream adivina los límites de columna a partir de los espacios en blanco | Copia el valor de la celda combinada en celdas adyacentes arbitrarias, perdiendo el significado |
| pdfplumber | Extracción de texto a nivel de carácter con análisis explícito de espacios en blanco | ~72% en general | 55–75%: más configurable que Tabula pero con el mismo enfoque fundamental | Sin gestión de celdas combinadas; genera celdas planas |
| Vision AI / VLM | Lee la tabla como una escena visual: comprende estructura, texto y relaciones simultáneamente | 90–98% | 85–95% (espaciadas) / 65–80% (densas) | 60–80%: infiere el abarcamiento a partir del contexto, aunque no perfectamente |
El enfoque tradicional tiene un problema arquitectónico fundamental: separa el reconocimiento de texto del reconocimiento de estructura. Primero, el OCR extrae texto y posiciones. Luego, un algoritmo independiente — a menudo heurísticas ajustadas manualmente — intenta reconstruir la cuadrícula de la tabla a partir de esas posiciones. Si el OCR lee mal un carácter (algo común en imágenes de baja resolución) o coloca mal una palabra (algo común en documentos inclinados), la inferencia de estructura falla en etapas posteriores sin posibilidad de recuperación. Los errores se acumulan.
La IA de visión evita esto por completo. Lee la imagen de la tabla como una escena visual — igual que usted — entendiendo que un número bajo el encabezado "Total" pertenece a esa columna no porque esté en la coordenada de píxel X, sino porque se alinea semánticamente con todo lo demás en la columna "Total". Esto no es solo un mejor OCR: es un enfoque fundamentalmente distinto del problema, que nuestra comparación entre IA y OCR tradicional explora en detalle.
Cómo obtener los mejores resultados
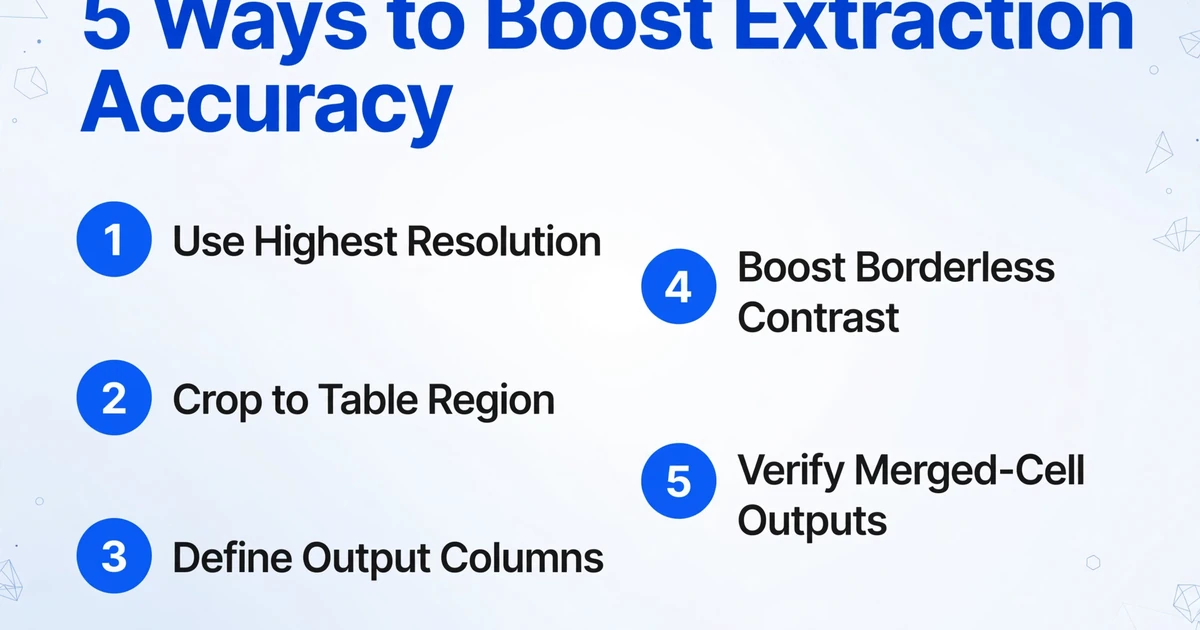
Cinco prácticas que mejoran de forma constante la precisión de la extracción de tablas con IA, independientemente de la herramienta que utilice:
1. Comience con la resolución más alta disponible. Los modelos de IA ven la imagen como una cuadrícula de píxeles: más píxeles significa una distinción más fina entre celdas adyacentes. Un análisis de 2025 de los LLM de visión en el punto de referencia PubTabNet encontró que el aumento de escala de la imagen era la mejora de preprocesamiento más común, utilizada en el 64% de las extracciones exitosas en entradas de baja calidad. Si está fotografiando una tabla impresa, use la resolución más alta que admita la cámara de su teléfono y sostenga el teléfono en paralelo al documento para evitar la distorsión por perspectiva.
2. Recorte a la región de la tabla. La IA de visión funciona mejor cuando la tabla ocupa la mayor parte del encuadre. El contenido adicional alrededor de la tabla (texto circundante, logotipos, encabezados de página) añade ruido que puede confundir la detección de columnas. Recorte su imagen solo al área de la tabla antes de la extracción.
3. Defina sus columnas de salida explícitamente. El enfoque más fiable no es pedirle a la IA que «extraiga todo», sino decirle qué extraer. Cuando especifica nombres de columnas como «Descripción del artículo», «Cantidad», «Precio unitario» y «Total de la línea», la IA sabe exactamente qué campos buscar y dónde pertenecen en la salida. Este es el principio detrás de la Extracción de Columnas Personalizadas: la IA hace coincidir los datos con su esquema al comprender el contenido del documento, no al adivinar la estructura de la tabla. Para la explicación completa de cómo funciona esto, consulte cómo la extracción basada en esquemas difiere del análisis de tablas completas.
4. Para tablas sin bordes, preprocese con mejora de contraste. Si su tabla no tiene bordes visibles y un espaciado de columnas fino, aumentar el contraste de la imagen puede ayudar a la IA a distinguir los límites de las columnas. Incluso un simple ajuste de niveles en cualquier editor de imágenes (oscurecer el texto, aclarar el fondo) mejora la detección de espacios en blanco.
5. Verifique las salidas de celdas combinadas. Este es el paso que nunca debe omitir. Cuando una tabla tiene celdas combinadas, revise la hoja de cálculo extraída para detectar filas donde un valor parezca faltar o repetirse incorrectamente. La inferencia estructural de la IA sobre celdas combinadas es lo suficientemente buena como para ahorrarle muchísimo tiempo: acierta en el 80% de los casos, pero el 20% restante puede introducir errores que se propaguen en cascada por el análisis posterior si no se revisan. Trate la extracción con IA como un primer borrador que necesita una revisión humana de 60 segundos, no como una caja negra que no requiere supervisión.
Ejemplos reales: qué esperar
Ejemplo 1: Una orden de compra impresa con tabla de líneas con bordes. Tomas una foto de una OC de un proveedor. La tabla tiene bordes claros, columnas estándar (Artículo, Descripción, Cant., Precio unitario, Total) y sin celdas combinadas. La IA extraerá esto con una precisión casi perfecta: cada fila, cada valor de celda, correctamente alineado. No perderás tiempo en correcciones. Este es el punto óptimo donde la extracción de tablas con IA es genuinamente más rápida y precisa que la entrada manual de datos.
Ejemplo 2: Un extracto bancario en PDF con una tabla de transacciones sin bordes. Los extractos bancarios suelen usar diseños de tabla basados en espacios en blanco: columnas de fecha, descripción, débito, crédito y saldo separadas por espacios consistentes. La IA maneja esto bien: 90–95 % de precisión en estructura y contenido. El error más común es desalinear descripciones largas de transacciones que se extienden a la columna adyacente de débito/crédito. Una revisión rápida del resultado detecta estos errores en menos de un minuto.
Ejemplo 3: Un anexo de contrato escaneado con una cuadrícula de precios densa. Este es el caso más difícil: sin bordes, espaciado de columnas estrecho, encabezados de categorías combinados que abarcan varias subcolumnas y valores de datos de longitudes variables. Espera una precisión estructural del 65–80 %. La IA obtendrá la mayoría de los datos correctos, pero podría mezclar la relación entre los encabezados de categorías combinados y sus subcolumnas. Prevé de 5 a 10 minutos de corrección manual en una tabla de 20 filas.
Preguntas frecuentes
¿Puede la IA extraer tablas de una foto tomada con mi teléfono?
Sí, y a menudo sorprendentemente bien, siempre que la foto sea nítida, esté bien iluminada y se tome de frente (no en ángulo). El principal problema con las fotos de teléfono es la distorsión de perspectiva: una tabla fotografiada en ángulo crea líneas inclinadas que confunden tanto al OCR tradicional como al reconocimiento de estructura de la IA. Sostén el teléfono paralelo a la superficie del documento y los resultados serán comparables a los de un escáner de cama plana. Para tipos de documentos que se fotografían en lugar de escanearse, consulta nuestra guía sobre extracción de datos de capturas de pantalla y fotos.
¿La IA funciona mejor con PDF o con imágenes?
Depende del PDF. Un PDF de texto nativo (donde puedes seleccionar y copiar texto) contiene datos de posicionamiento que la IA puede usar como señal adicional, lo que a menudo mejora la precisión en 5–10 puntos porcentuales en comparación con una imagen pura. Un PDF escaneado de solo imagen equivale a una imagen. La IA maneja ambos, pero si tienes opción, proporciona el PDF de texto nativo original en lugar de una captura de pantalla del mismo.
¿Puede la IA manejar tablas con texto de varias líneas dentro de las celdas?
Sí, y esta es un área donde la IA supera significativamente a los métodos tradicionales. Cuando una celda contiene un párrafo de texto, algo común en anexos de contratos, hojas de especificaciones e informes clínicos, el OCR tradicional pierde el rastro de los límites de las filas porque los saltos de línea dentro de una celda parecen saltos de fila. La IA de visión lee la celda como una entidad completa y conserva el texto dentro de ella, entendiendo que un salto de línea dentro de "Alcance del trabajo: El contratista deberá..." no inicia una nueva fila.
¿Cómo maneja la IA tablas con diferentes monedas o formatos numéricos?
La IA lee valores numéricos en contexto: reconoce "1.500,00" como un número con formato europeo (1,500.00) y "$1,500.00" como formato estadounidense, incluso si ambos aparecen en la misma tabla. Esto funciona porque la IA de visión no se basa en el emparejamiento de cadenas numéricas; entiende el idioma del documento, el contexto de la columna circundante y el significado probable del valor. Las tablas con formatos mixtos — como una factura comercial con formatos de moneda mixtos — se manejan correctamente en la mayoría de los casos.
¿Puede la IA extraer tablas que abarcan varias páginas?
Sí. La IA de visión moderna puede detectar cuando una tabla continúa en la página siguiente y fusionar los resultados en una sola hoja de cálculo de salida. Un estudio de 2025 que utilizó el conjunto de datos PubTables-v2 logró un 99.5% de recuperación en la identificación de continuaciones de tablas entre páginas. El requisito práctico: todas las páginas deben cargarse juntas como un lote para que la IA pueda ver la continuidad. Procesar páginas una por una pierde el contexto entre páginas.
¿Necesito entrenar primero a la IA con mi formato de tabla?
No. Esta es una idea errónea común heredada de herramientas de OCR basadas en plantillas como Docparser o Parseur, donde debes definir zonas o reglas de análisis para cada nuevo diseño de documento. La IA de visión utiliza comprensión semántica: lee tu tabla como lo haría un humano, sin necesidad de exposición previa a tu formato específico. La contrapartida: las herramientas basadas en plantillas pueden lograr una mayor precisión en formatos para los que han sido entrenadas explícitamente, pero fallan cuando el formato cambia. La IA maneja la variación de formato automáticamente, pero con una precisión máxima menor en cualquier formato fijo único. Para un desglose detallado de esta contrapartida, consulta OCR tradicional vs extracción con IA.
¿Qué sucede cuando una tabla contiene texto y casillas de verificación o símbolos?
La IA de visión lee casillas de verificación y símbolos contextualmente: una casilla marcada junto a "Envío exprés" se entiende como "método de envío = exprés", no como un símbolo aislado. Esto funciona porque la IA ve la casilla de verificación y el texto de la etiqueta juntos como una unidad semántica, similar a cómo procesa pares clave-valor en otras partes de la página. La precisión en datos de casillas de verificación es generalmente del 85–95%, comparable al texto impreso en tablas con bordes.
En resumen: la IA está lista para tablas con bordes y bien espaciadas hoy en día. Ahorra una enorme cantidad de tiempo incluso en casos difíciles, porque editar una extracción mayormente correcta es más rápido que escribir todo desde cero. Y a medida que los modelos de visión mejoran, la categoría "difícil" se reduce cada año. Los datos lo respaldan: las puntuaciones S-TEDS en PubTabNet han aumentado de ~65% en 2020 a ~93%+ en 2025, y la línea de tendencia aún no se ha aplanado.
Para una comparación práctica de cómo la extracción con IA se desempeña frente a la entrada manual de datos en documentos del mundo real, consulta nuestro desglose de tiempo y precisión de IA vs transcripción manual. O explora nuestro resumen de las mejores herramientas de extracción de tablas en 2026 para ver cómo diferentes herramientas se comparan en las métricas que importan para tu flujo de trabajo.