AIは画像から表を抽出できる?
はい — その精度と仕組み
はい。AIは罫線付き・罫線なしの表画像から、行・列・ヘッダー・セル値を抽出できます。罫線付きテーブルでは構造認識がほぼ完璧で、95%を超えることが多いです。列間隔が明確な罫線なしテーブルでは85〜95%の範囲で良好な結果が得られます。セル結合や階層ヘッダーを持つ密度の高い罫線なしテーブルは最も難しいケースで、通常60〜85%に留まり、手動での修正がいくらか必要です。この差はAIが表を「理解」できるかどうかの問題ではなく、表画像が本質的に持つ曖昧さに起因します。視覚的な境界線がない場合、人間の読者でさえ、どのセルにどの値が属するかを推測しなければならないのです。
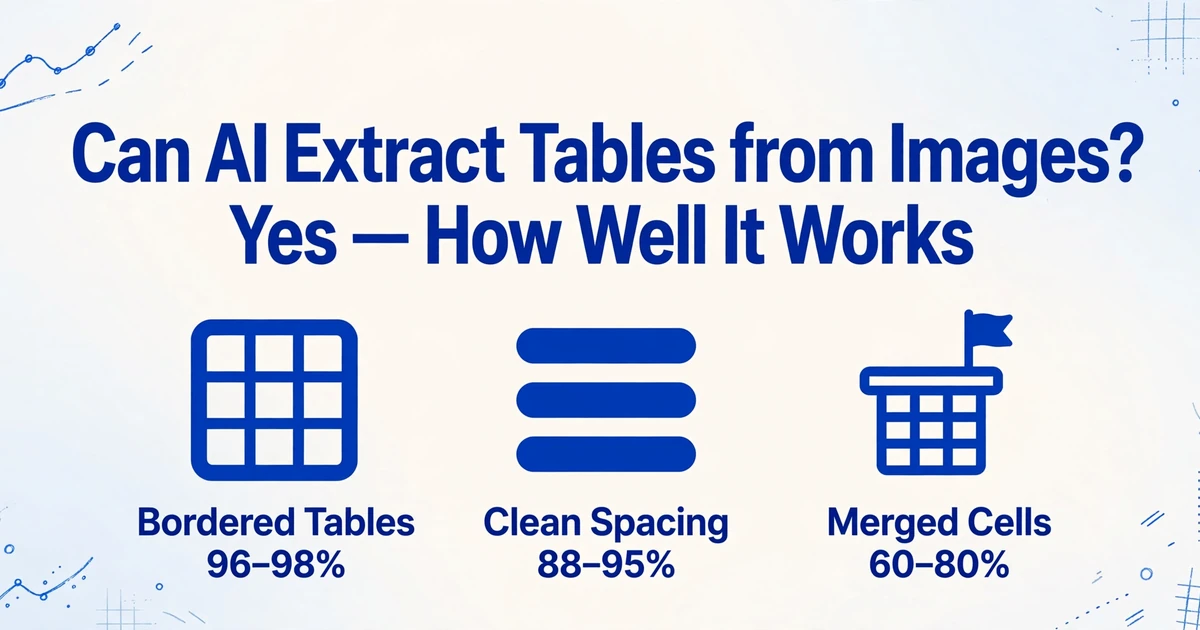
重要なポイント
- AIの表抽出精度は、罫線付きテーブルの96%からセル結合テーブルの60%まで急落します。その原因はモデルではなく、階層構造がすでに失われた入力画像そのものにあります。
- 3行にまたがるセル結合は「このカテゴリが次の3項目をカバーする」ことを意味します。人間の読者には明白でも、フラットな画像を処理するAIにとっては、データ内にツリー構造が存在しない推論問題となるのです。
- 出力列を明示的に定義してください — 品目説明、数量、単価 — そうすればAIはテーブルのグリッドを再構築するのではなく、意味的な意味に基づいて値を特定し、セル結合の曖昧さを完全に回避できます。
テーブルの種類別の精度
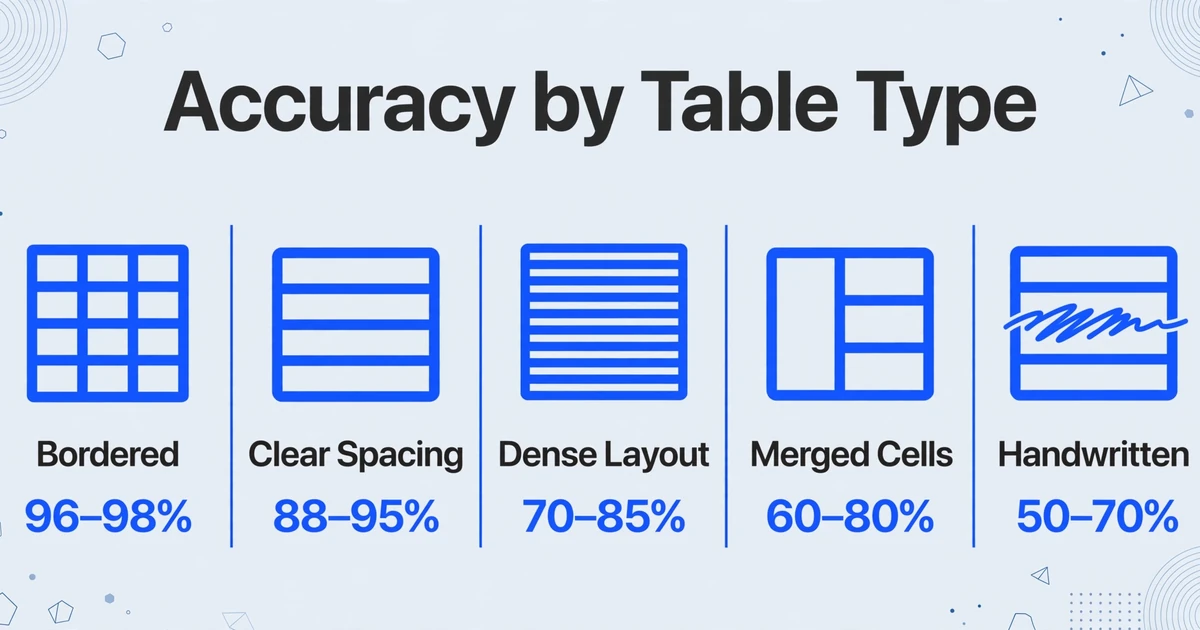
「AIは画像からテーブルを抽出できるのか」という問いに、単一の答えはありません。それはAIの一般的な能力ではなく、画像内のテーブル次第です。数十年にわたるコンピュータビジョン研究の集大成として、TableBankベンチマーク(417,234件のラベル付きテーブル)とPubTabNet(568,000件以上のテーブル画像)により、何が機能し何が機能しないかが明確になっています。内訳は以下のとおりです。
| テーブルの種類 | 構造精度(S-TEDS) | 内容+構造(TEDS) | 成功・失敗の要因 |
|---|---|---|---|
| 罫線付きテーブル | 96–98% | 90–95% | グリッド線がセル境界を明確にします。ビジョンAIは線を区切りとして検出し、列の検出はほぼ完璧です。 |
| 罫線なし・間隔が明確 | 88–95% | 85–93% | 列間の空白が広く一貫していれば十分です。AIは配置パターンから列境界を推測します。 |
| 罫線なし・高密度レイアウト | 70–85% | 65–80% | 列間の狭い隙間が境界を曖昧にします。「2,400,000」と「12.5%」が狭い間隔で隣接すると、約3分の1の確率で1つのセルに結合されます。 |
| セル結合あり | 60–80% | 55–75% | 行・列の結合がグリッドの前提を崩します。AIは結合セルがどの行にまたがるかを推測する必要があります。人間には簡単でも、アルゴリズムには構造的に曖昧です。 |
| 手書きテーブル | 50–70% | 40–65% | 手書き文字の認識と、不規則な配置からのテーブル構造の推測という二重の課題があります。人間のデータ入力オペレーターでも、これらでは作業速度が大幅に低下します。 |
これらの数値は、学術ベンチマークで使用されるTEDS指標(ツリー編集距離ベースの類似度)に基づいています。S-TEDSは構造の忠実度を測定します。つまり、正しい行数と列数が存在し、セルの結合が正しいかどうかです。TEDSは内容の正確性を加味します。つまり、各セル内の値が正しいかどうかです。PubTabNetにおけるビジョン言語モデルの2025年ベンチマークでは、汎用VLMは生の抽出で74〜85%のTEDSを達成する一方、前処理パイプラインを備えたテーブル特化モデルは93%以上の範囲に達することが判明しました(NGTRフレームワーク、IJCAI 2025)。
実際的な意味合いとしては、きれいな罫線のある請求書テーブルや構造化されたレポートからデータを抽出する場合、AIは成熟しており本番環境で使用可能です。スキャンされた契約書の付録に、結合されたカテゴリ見出しを持つ、罫線のない密集した価格表が含まれている場合は、手動での検証に時間を費やすことを想定してください。あらゆるドキュメントタイプにおけるAIドキュメント抽出の可能性と限界についてのより広い視点については、AIドキュメント抽出とは実際には何かに関するガイドをご覧ください。
AIが得意とすること
現代のビジョンAIが一貫して本番品質の結果を提供する3つのテーブルシナリオ:
あらゆるソースからの罫線付きテーブル。PDFの請求書、会計ポータルのスクリーンショット、印刷された発注書の写真など、テーブルに目に見えるグリッド線がある場合、AIはセルの境界をほぼ完璧な精度で検出します。その理由は単純明快です。水平線と垂直線は、AIモデルが決定論的に解析できる明確なグラフを作成し、スプレッドシートのグリッドを解析するのと同様の方法で処理します。Camelotのような従来のOCRツールも、罫線がしっかりしたテーブルでは90%以上の精度を達成しますが、AIはルールベースの線検出器を壊すような曲線や傾いた罫線も処理できるという利点があります。
きれいにスペースが空いた罫線なしテーブル。SaaSプラットフォーム、プロフェッショナルサービス企業、デザイン重視のベンダーからの最新の請求書は、多くの場合、空白ベースのテーブルレイアウトを使用しています。グリッド線はなく、列間の十分なスペースだけがあります。これらのテーブルは、整列だけで人間が読めるように設計されており、何百万ものテーブル画像でトレーニングされたAIモデルは、同じ視覚的手がかりを学習しています。列の間隔が一貫しており、セル内の単語間の間隔よりも広い場合、AIは90%以上の確率で境界を正しく識別します。
一貫した構造を持つ複数ページのテーブル。テーブルが複数のページにまたがり、各ページで同じ列レイアウトを持つ場合(銀行取引明細書、財務レポート、公共料金の請求書によく見られる)、AIは各ページを個別に処理し、結果を単一の連続したスプレッドシートにマージできます。ここで、最新の抽出ツールのバッチファースト設計が重要になります。すべてのページを一度にアップロードすると、手動でつなぎ合わせる必要があるN個の個別の抽出結果ではなく、1つの統合された出力テーブルが得られます。
苦手なケース
失敗モードを具体的に挙げることは、すべてにおいて99%の精度を主張するよりも信頼を築きます。以下は、AIによるテーブル抽出において、依然として人間の確認が必要となるシナリオです。
方向性を持つセル結合。 列ヘッダーで3行にわたって結合されたセルは、「これが次の3行の親カテゴリである」ことを意味します。人間にとっては明白ですが、AIにとっては構造推論の問題です。つまり、フラットなグリッドからツリーを再構築する必要があります。結合セルが4行以上に及ぶ場合、または行ヘッダーと列ヘッダーの両方に同時に結合セルが存在する場合、精度は急激に低下します。2024年のPDF解析ツールの比較研究では、非標準的なレイアウトや複雑なセル結合を含むドキュメントで、パーサーの精度が最も低下することが判明しました。
これはAIの知能の限界ではなく、入力形式の問題です。結合セルを含むテーブル画像は、元のソース(rowspan属性を持つHTML、または結合領域を持つスプレッドシート)に存在する階層構造を失っています。AIは、テーブルがフラットな画像としてレンダリングされた際に削除された情報を再構築するよう求められているのです。これは認識の問題ではなく、推論の問題です。
階層ヘッダー。 列ヘッダーに親子関係(例:「Q1 2025」が「1月」「2月」「3月」を包含する)があり、行ヘッダーにも親グループが存在するテーブルは、2次元の階層を形成します。ほとんどのAIモデルはフラットなテーブル(1行のヘッダー、その後にデータ行)を出力します。明示的に指示しない限り、階層関係をネイティブに保持することはありません。その結果、技術的には正しいものの、元の作成者が意図した多層構造を失ったフラットなテーブルになることがよくあります。当社のカスタム列抽出アプローチは、AIに画像から推論させるのではなく、出力スキーマを事前に定義できるようにすることで、この問題を回避します。
境界線がなく、セル幅が可変の高密度グリッド。 テーブルに境界線がなく、列間のギャップが狭く、セルに含まれるテキスト量がさまざま(短い値もあれば、長い説明もある)場合、空白の境界が曖昧になります。「請求番号 #2405-001」を含むセルと「事務用品 — 文房具(一括注文)」を含むセルが隣接している場合、AIが空白の閾値を誤判断すると、3つの別々の列として解釈される可能性があります。
手書きのテーブル。 手書き文字自体が読みやすい場合(視覚AIは85〜95%の精度で処理します。AI手書き文字認識に関するガイドで説明しています)でも、構造的な問題はさらに複雑になります。手書きのテーブルは列の配置が不規則で、値が左右にずれたり、行の高さがばらついたり、線がまっすぐでないことがよくあります。AIは、テキスト認識と不規則なグリッドからの構造推論という2つの難しい問題を同時に解決する必要があります。
従来手法との比較
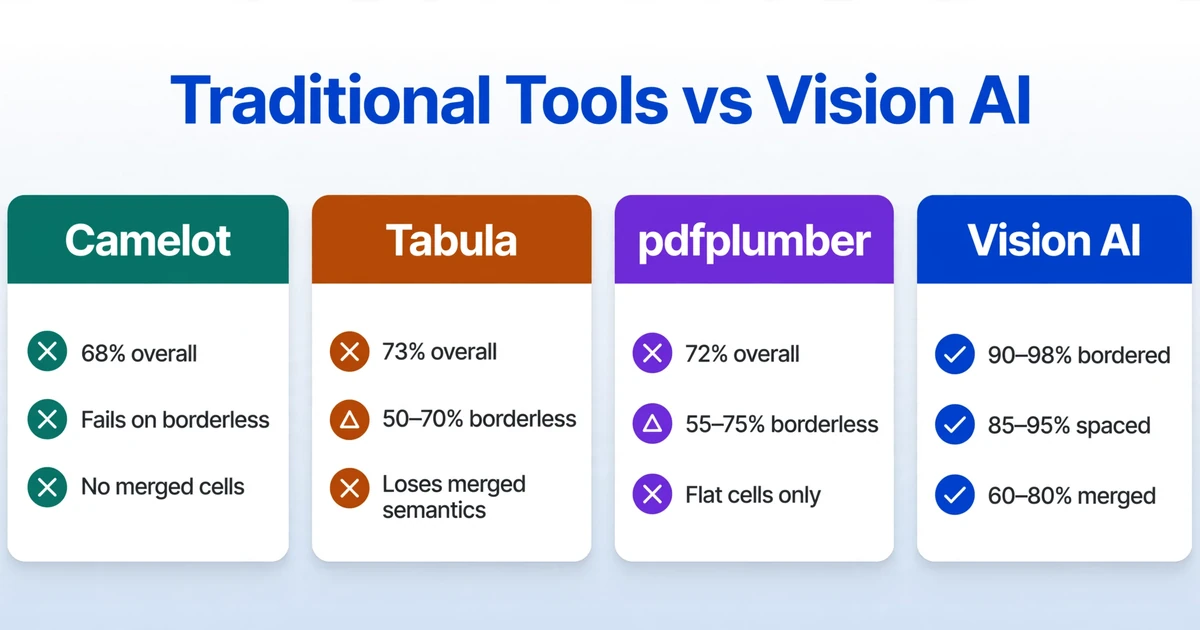
ビジョンAIが登場する前は、画像からのテーブル抽出は、複数の脆弱なツールを組み合わせることを意味していました。従来のアプローチを理解することで、AIのテーブル抽出機能がなぜ真の飛躍的な進歩なのかがわかります。
| 手法 | 仕組み | 罫線ありテーブルの精度 | 罫線なしテーブルの精度 | 結合セル |
|---|---|---|---|---|
| Camelot(ラティスモード) | PDF/画像内の視覚的な線を検出し、セルの交点を計算します | 全体的に約68%(文書タイプ別) | 完全に失敗 — ラティスモードは可視の罫線が必要です | 失敗 — 線の検出がないためグリッドが生成されません |
| Tabula | PDFからテキスト位置を抽出し、空間的な近接性でグループ化します | 全体的に約73% | 50〜70% — ストリームモードは空白から列の境界を推測します | 結合セルの値を任意の隣接セルにコピーし、意味を失います |
| pdfplumber | 文字レベルのテキスト抽出と明示的な空白分析を行います | 全体的に約72% | 55〜75% — Tabulaより設定可能ですが、基本的なアプローチは同じです | 結合セル処理なし。フラットなセルを出力します |
| Vision AI / VLM | テーブルを視覚的なシーンとして読み取ります — 構造、テキスト、関係性を同時に理解します | 90〜98% | 85〜95%(間隔あり)/ 65〜80%(密集) | 60〜80% — 文脈からスパンを推測しますが、完璧ではありません |
従来のアプローチには根本的な構造上の問題があります。それは、テキスト認識と構造認識を分離していることです。まず、OCRがテキストと位置を抽出します。次に、別のアルゴリズム(多くの場合、手動調整されたヒューリスティック)が、その位置からテーブルのグリッドを再構築しようとします。OCRが文字を誤読したり(低解像度画像でよく発生)、単語の位置を誤ったりすると(傾いた文書でよく発生)、構造推論は下流で失敗し、回復する方法がありません。エラーは複合的に積み重なります。
Vision AIはこれを完全に回避します。テーブル画像を視覚的なシーンとして読み取ります — 人間と同じように — 「合計」ヘッダーの下の数字が、ピクセル座標Xにあるからではなく、「合計」列の他のすべての要素と意味的に整合するから、その列に属すると理解します。これは単なる優れたOCRではありません — 問題に対する根本的に異なるアプローチであり、AIと従来のOCRの比較で詳しく解説しています。
最良の結果を得る方法
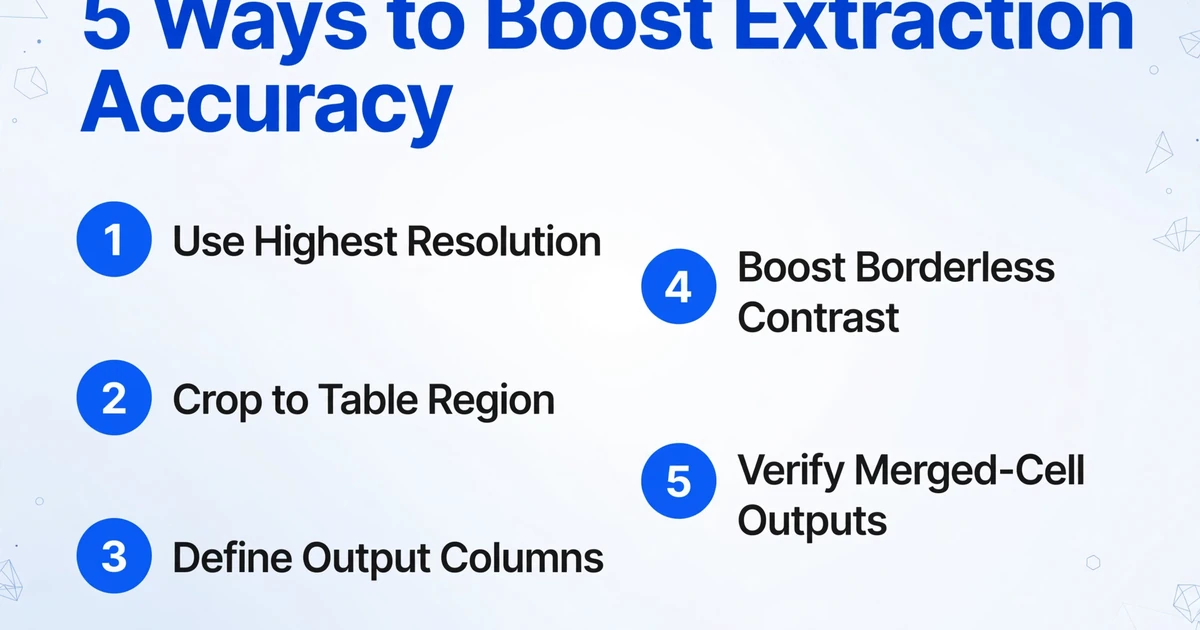
使用するツールに関係なく、AIによるテーブル抽出の精度を一貫して向上させる5つの実践方法をご紹介します。
1. 利用可能な最高解像度から始めます。AIモデルは画像をピクセルのグリッドとして認識します。ピクセル数が多いほど、隣接するセルをより細かく区別できます。PubTabNetベンチマークにおける視覚LLMの2025年の分析では、画像のアップスケーリングが最も一般的な前処理の改善策であり、低品質の入力に対する成功した抽出の64%で使用されたことが判明しました。印刷されたテーブルを撮影する場合は、スマートフォンのカメラが対応する最高解像度を使用し、遠近感による歪みを避けるためにカメラをドキュメントと平行に保ってください。
2. テーブル領域にトリミングします。ビジョンAIは、テーブルがフレームの大部分を占めている場合に、より適切に機能します。テーブル周辺の余分なコンテンツ(周囲のテキスト、ロゴ、ページヘッダーなど)はノイズとなり、列の検出を妨げる可能性があります。抽出前に、画像をテーブル領域だけにトリミングしてください。
3. 出力列を明示的に定義します。最も信頼性の高いアプローチは、AIに「すべて抽出」と指示することではなく、何を抽出するかを具体的に指示することです。「品目説明」「数量」「単価」「合計金額」などの列名を指定すると、AIは出力内でどのフィールドを探し、どこに配置すべきかを正確に把握できます。これはカスタム列抽出の背後にある原理です。AIはテーブル構造を推測するのではなく、ドキュメントの内容を理解してデータをスキーマに照合します。この仕組みの詳細については、スキーマ駆動型抽出がフルテーブル解析とどう異なるかをご覧ください。
4. 境界線のないテーブルには、コントラスト強調による前処理を行います。テーブルに目に見える境界線がなく、列間隔が狭い場合は、画像のコントラストを高めると、AIが列の境界を区別しやすくなります。任意の画像エディタでレベル調整を行うだけでも(テキストを暗くし、背景を明るくする)、空白の検出が向上します。
5. 結合セルの出力を確認します。これは絶対に省略してはいけないステップです。テーブルに結合セルがある場合、抽出されたスプレッドシートをスキャンして、値が欠落していたり、誤って繰り返されている行がないか確認してください。結合セルに対するAIの構造推論は、時間を大幅に節約できるほど優れており、80%のケースで正しく処理されます。しかし、残りの20%では、チェックしないままにすると下流の分析に連鎖的なエラーを引き起こす可能性があります。AI抽出は、60秒の人間によるスキャンが必要な初稿として扱い、監視を必要としないブラックボックスとして扱わないでください。
実際の例:期待できること
例1:明瞭な罫線のある明細表が印刷された注文書。サプライヤーからの注文書を撮影します。表には明確な罫線、標準的な列(品目、説明、数量、単価、合計)があり、セルの結合はありません。AIはほぼ完全な精度で抽出します — すべての行、すべてのセル値が正しく整列されます。修正作業はゼロです。これこそ、AIによる表抽出が手動データ入力よりも真に高速かつ正確である領域です。
例2:罫線のない取引明細表がある銀行取引明細書のPDF。銀行取引明細書は通常、空白ベースの表レイアウトを使用します。日付、説明、借方、貸方、残高の各列が一定の間隔で区切られています。AIはこれを適切に処理し、構造と内容の精度は90~95%です。最も一般的なエラーは、長い取引説明文が隣の借方/貸方の列にはみ出してしまうことです。出力をざっと確認すれば、1分以内にこれらのエラーを見つけられます。
例3:スキャンされた契約書の付属書にある、情報が密集した価格表。これが最も難しいケースです。罫線なし、列間隔が狭い、複数のサブ列にまたがる結合されたカテゴリヘッダー、さまざまな長さのデータ値。構造の精度は65~80%と予想されます。AIはほとんどのデータポイントを正しく取得しますが、結合されたカテゴリヘッダーとそのサブ列の関係を誤ることがあります。20行の表の場合、5~10分の手動修正を見込んでください。
よくある質問
スマートフォンで撮影した写真からAIは表を抽出できますか?
はい、写真が鮮明で明るく、真正面から(斜めではなく)撮影されていれば、驚くほど良好な結果が得られることがよくあります。スマートフォン写真での主な失敗要因は遠近歪みです。斜めから撮影された表は線が傾き、従来のOCRとAIの構造認識の両方を混乱させます。カメラを書類面と平行に保てば、フラットベッドスキャナと同等の結果が得られます。撮影されることの多い書類タイプについては、スクリーンショットや写真からのデータ抽出ガイドをご覧ください。
AIはPDFと画像のどちらでより効果的に機能しますか?
PDFの種類によります。テキストネイティブPDF(テキストを選択してコピーできるもの)には、AIが追加のシグナルとして使用できる配置データが含まれており、純粋な画像と比較して精度が5~10%向上することがよくあります。スキャンされた画像のみのPDFは画像と同等です。AIは両方を処理できますが、選択できるのであれば、スクリーンショットではなく元のテキストネイティブPDFを提供してください。
AIはセル内の複数行テキストを含む表を処理できますか?
はい、これは実際にAIが従来の方法よりも大幅に優れている領域です。セルに段落テキストが含まれている場合(契約書の別紙、仕様書、臨床レポートでよく見られます)、従来のOCRはセル内の改行を行区切りと誤認するため、行の境界を見失います。Vision AIはセルを1つのエンティティとして読み取り、その中のテキストを保持し、「Scope of Work: The contractor shall...」内の改行が新しい行の開始を意味しないことを理解します。
AIは異なる通貨や数値形式の表をどのように処理しますか?
AIは数値を文脈で読み取ります。「1.500,00」をヨーロッパ形式の数値(1,500.00)、「$1,500.00」を米国形式として、同じ表に両方があっても認識します。これは、ビジョンAIが数値文字列のパターンマッチングに依存せず、ドキュメントの言語、周囲の列の文脈、値の意味を理解するためです。異なる形式が混在する表(例:通貨形式が混在する商業送り状)も、ほとんどの場合正しく処理されます。
AIは複数ページにまたがる表を抽出できますか?
はい。最新のビジョンAIは、表が次のページに続いていることを検出し、結果を1つのスプレッドシートに統合できます。2025年にPubTables-v2データセットを用いた研究では、ページをまたぐ表の継続識別において99.5%の再現率を達成しました。実用的な条件として、AIが連続性を認識できるよう、すべてのページをまとめてアップロードする必要があります。ページを1枚ずつ処理すると、ページ間の文脈が失われます。
事前にAIに自分の表形式を学習させる必要はありますか?
いいえ。これは、DocparserやParseurのようなテンプレートベースのOCRツールから引き継がれたよくある誤解です。それらのツールでは、新しいドキュメントレイアウトごとに解析ゾーンやルールを定義する必要があります。ビジョンAIは意味理解を使用し、人間と同じように表を読み取るため、特定の形式に事前に触れる必要はありません。トレードオフとして、テンプレートベースのツールは明示的に学習した形式では高い精度を達成できますが、形式が変わると機能しなくなります。AIは形式の変化に自動的に対応しますが、単一の固定形式に対するピーク精度は低くなります。このトレードオフの詳細については、従来のOCRとAI抽出の比較をご覧ください。
表にテキストとチェックボックスや記号が混在している場合はどうなりますか?
ビジョンAIはチェックボックスや記号を文脈に応じて読み取ります。「速達配送」の横にあるチェックボックスがオンになっていれば、孤立した記号としてではなく「配送方法=速達」として理解します。これは、AIがチェックボックスとラベルテキストを1つの意味単位として捉え、ページ上の他のキーと値のペアを処理するのと同様の方法で機能するためです。チェックボックスデータの精度は一般的に85~95%で、罫線のある表の印刷テキストと同等です。
結論:AIは現在、罫線があり適切にスペースが設定された表に対応可能です。難しいケースでも、大部分が正しい抽出結果を編集する方が、ゼロから入力するよりはるかに速いため、大幅な時間節約になります。また、ビジョンモデルが改善されるにつれて、「難しい」ケースは年々減少しています。データもこれを裏付けており、PubTabNetのS-TEDSスコアは2020年の約65%から2025年には約93%以上に上昇し、その傾向はまだ鈍化していません。
実際のドキュメントにおけるAI抽出と手動データ入力を比較した実践的な分析については、AIと手動転記の時間と精度の比較をご覧ください。または、2026年における最高の表抽出ツールのまとめを参照し、ワークフローに重要な指標で各ツールを比較してください。