Kann KI Tabellen aus Bildern extrahieren?
Ja – so gut funktioniert es
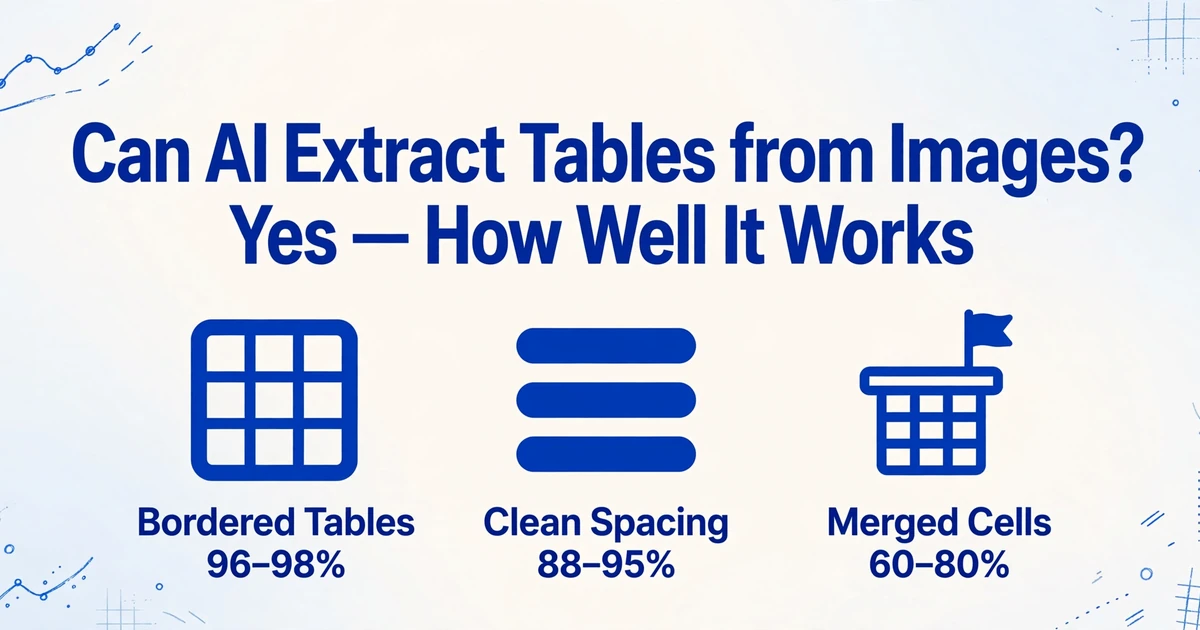
Ja. KI kann Tabellendaten – Zeilen, Spalten, Kopfzeilen und Zellwerte – aus Bildern von Tabellen mit und ohne Linien extrahieren. Tabellen mit Linien erreichen eine nahezu perfekte Strukturerkennung, oft über 95 %. Tabellen ohne Linien mit klarem Spaltenabstand funktionieren im Bereich von 85–95 % gut. Dichte Tabellen ohne Linien mit zusammengeführten Zellen und hierarchischen Kopfzeilen bleiben der schwierigste Fall, typischerweise bei 60–85 %, und erfordern etwas manuelle Nachbearbeitung. Der Unterschied liegt nicht darin, ob KI Tabellen „versteht“ – das tut sie –, sondern in der inhärenten Mehrdeutigkeit, die ein Tabellenbild darstellt: Wenn es keine visuellen Grenzen gibt, muss selbst ein menschlicher Leser raten, zu welcher Zelle ein Wert gehört.
Wichtige Erkenntnisse
- Die Genauigkeit der Tabellenextraktion durch KI fällt von 96 % bei Tabellen mit Linien auf 60 % bei Tabellen mit zusammengeführten Zellen – und die Schuld liegt nicht am Modell, sondern am Eingabebild, das die hierarchische Struktur bereits gelöscht hat.
- Eine zusammengeführte Zelle, die sich über drei Zeilen erstreckt, bedeutet „diese Kategorie umfasst die nächsten drei Einträge“ – für einen menschlichen Leser offensichtlich, aber für eine KI, die mit einem flachen Bild arbeitet, ist es ein Inferenzproblem, bei dem die Baumstruktur in den Daten nicht mehr existiert.
- Definieren Sie Ihre Ausgabespalten explizit – Artikelbeschreibung, Menge, Stückpreis – und die KI lokalisiert Werte anhand der semantischen Bedeutung, statt das Tabellenraster zu rekonstruieren, wodurch die Mehrdeutigkeit zusammengeführter Zellen vollständig umgangen wird.
Wie gut es funktioniert, nach Tabellentyp
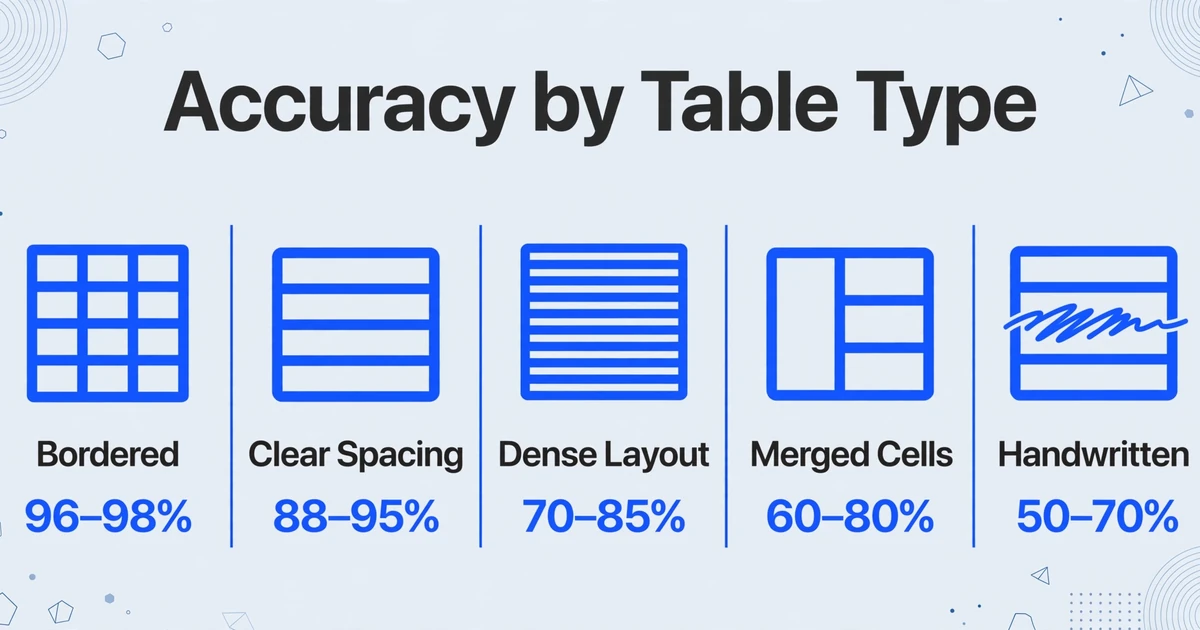
Die Frage „Kann KI Tabellen aus Bildern extrahieren?" hat keine einheitliche Antwort. Es hängt vollständig von der Tabelle in Ihrem Bild ab – nicht von der allgemeinen Fähigkeit der KI. Jahrzehnte der Forschung im Bereich Computer Vision, die im TableBank-Benchmark (417.234 beschriftete Tabellen) und PubTabNet (über 568.000 Tabellenbilder) gipfelte, haben ein klares Bild davon gezeichnet, was funktioniert und was nicht. Hier ist die Aufschlüsselung:
| Tabellentyp | Strukturgenauigkeit (S-TEDS) | Inhalt + Struktur (TEDS) | Was zum Erfolg oder Scheitern führt |
|---|---|---|---|
| Tabellen mit Linien | 96–98 % | 90–95 % | Gitternetzlinien liefern eindeutige Zellgrenzen. Vision-KI erkennt Linien als Trennzeichen; die Spaltenerkennung ist nahezu perfekt. |
| Ohne Linien, klarer Abstand | 88–95 % | 85–93 % | Der Leerraum zwischen Spalten ist ausreichend, wenn er breit und gleichmäßig ist. Die KI leitet Spaltengrenzen aus Ausrichtungsmustern ab. |
| Ohne Linien, dichtes Layout | 70–85 % | 65–80 % | Schmale Abstände zwischen Spalten verwischen die Grenzen. Werte wie „2.400.000" neben „12,5 %" mit geringem Abstand werden in etwa einem Drittel der Fälle zu einer Zelle zusammengeführt. |
| Zellzusammenführungen | 60–80 % | 55–75 % | Rowspan/Colspan durchbrechen die Gitterannahme. Die KI muss ableiten, über welche Zeilen sich eine zusammengeführte Zelle erstreckt – für Menschen trivial, für Algorithmen strukturell mehrdeutig. |
| Handschriftliche Tabellen | 50–70 % | 40–65 % | Doppelte Herausforderung: Handschrift erkennen und die Tabellenstruktur aus unregelmäßiger Ausrichtung ableiten. Selbst menschliche Datenerfasser werden bei diesen deutlich langsamer. |
Diese Zahlen stammen aus der TEDS-Metrik (Tree-Edit-Distance-basierte Ähnlichkeit), die in akademischen Benchmarks verwendet wird. S-TEDS misst die strukturelle Genauigkeit – sind die richtige Anzahl von Zeilen und Spalten vorhanden, mit korrekter Zellspannung? TEDS fügt die Inhaltsgenauigkeit hinzu – sind die Werte in jeder Zelle korrekt? Ein Benchmark von Vision-Language-Modellen auf PubTabNet aus dem Jahr 2025 ergab, dass allgemeine VLMs bei der Roh-Extraktion 74–85 % TEDS erreichen, während spezialisierte tabellenfokussierte Modelle mit Vorverarbeitungspipelines in den Bereich von über 93 % vorstoßen (NGTR-Framework, IJCAI 2025).
Die praktische Konsequenz: Wenn Sie Daten aus sauberen, umrandeten Rechnungstabellen oder strukturierten Berichten extrahieren, ist KI ausgereift und produktionsreif. Wenn Sie mit einem gescannten Vertragsanhang arbeiten, der eine dichte, randlose Preistabelle mit zusammengeführten Kategorieüberschriften enthält, sollten Sie Zeit für manuelle Prüfung einplanen. Für einen breiteren Überblick darüber, was KI-Dokumentextraktion über alle Dokumenttypen hinweg kann und nicht kann, lesen Sie unseren Leitfaden zu was KI-Dokumentextraktion tatsächlich ist.
Was KI richtig macht
Drei Tabellenszenarien, in denen moderne visuelle KI konsistent produktionsreife Ergebnisse liefert:
Umrandete Tabellen aus beliebigen Quellen. Ob PDF-Rechnung, Screenshot aus einem Buchhaltungsportal oder Foto einer gedruckten Bestellung – wenn die Tabelle sichtbare Gitterlinien hat, erkennt KI die Zellgrenzen mit nahezu perfekter Präzision. Der Grund ist einfach: Horizontale und vertikale Linien erzeugen einen eindeutigen Graphen, den ein KI-Modell deterministisch parsen kann, ähnlich wie es ein Tabellenkalkulationsraster parsen würde. Traditionelle OCR-Tools wie Camelot erreichen bei gut umrandeten Tabellen ebenfalls über 90 %, aber KI bietet zusätzlich die Fähigkeit, gekrümmte oder schiefe Ränder zu verarbeiten, die regelbasierte Liniendetektoren überfordern.
Sauber formatierte randlose Tabellen. Moderne Rechnungen von SaaS-Plattformen, professionellen Dienstleistungsunternehmen und designorientierten Anbietern verwenden oft auf Leerraum basierende Tabellenlayouts – keine Gitterlinien, nur großzügige Abstände zwischen den Spalten. Diese Tabellen sind darauf ausgelegt, von Menschen allein durch Ausrichtung lesbar zu sein, und KI-Modelle, die mit Millionen von Tabellenbildern trainiert wurden, haben denselben visuellen Hinweis gelernt. Wenn die Spaltenabstände konsistent und breiter sind als die Abstände zwischen Wörtern innerhalb einer Zelle, identifiziert KI die Grenzen in über 90 % der Fälle korrekt.
Mehrseitige Tabellen mit konsistenter Struktur. Wenn sich eine Tabelle über mehrere Seiten erstreckt und auf jeder Seite dasselbe Spaltenlayout aufweist – üblich bei Kontoauszügen, Finanzberichten und Stromrechnungen – kann KI jede Seite unabhängig verarbeiten und die Ergebnisse zu einer einzigen durchgehenden Tabelle zusammenführen. Hier wird das Batch-First-Design moderner Extraktionstools entscheidend: Sie laden alle Seiten auf einmal hoch und erhalten eine einheitliche Ausgabetabelle, nicht N separate Extrakte, die manuell zusammengefügt werden müssen.
Wo die Grenzen liegen
Konkret über Schwachstellen zu sprechen, schafft mehr Vertrauen, als eine 99-prozentige Genauigkeit für alles zu behaupten. Hier sind die Szenarien, in denen die KI-Tabellenextraktion weiterhin menschliche Kontrolle erfordert:
Verbundene Zellen mit richtungsweisender Semantik. Eine Zelle, die sich über drei Zeilen in einer Spaltenüberschrift erstreckt, bedeutet: „Dies ist die übergeordnete Kategorie für die nächsten drei Zeilen.“ Für einen Menschen ist das offensichtlich. Für eine KI ist es ein Problem der strukturellen Inferenz: die Rekonstruktion eines Baums aus einem flachen Raster. Wenn verbundene Zellen vier oder mehr Zeilen abdecken oder wenn verbundene Zellen gleichzeitig in Zeilen- und Spaltenüberschriften auftreten, sinkt die Genauigkeit deutlich. Eine vergleichende Studie aus dem Jahr 2024 zu PDF-Parsing-Tools zeigte, dass die Parsing-Genauigkeit bei Dokumenten mit nicht standardmäßigen Layouts und komplexen Zellverbindungen am stärksten abnahm.
Das ist kein Versagen der KI-Intelligenz – es ist ein Versagen des Eingabeformats. Ein Tabellenbild mit verbundenen Zellen hat die hierarchische Struktur verloren, die in der Originalquelle vorhanden wäre (HTML mit rowspan-Attributen oder eine Tabellenkalkulation mit verbundenen Bereichen). Die KI soll Informationen rekonstruieren, die entfernt wurden, als die Tabelle als flaches Bild gerendert wurde. Das ist ein Inferenzproblem, kein Erkennungsproblem.
Hierarchische Kopfzeilen. Tabellen, bei denen Spaltenüberschriften Eltern-Kind-Beziehungen haben (z. B. „Q1 2025“ umfasst „Jan“, „Feb“, „Mär“) und Zeilenüberschriften ebenfalls übergeordnete Gruppen haben, erzeugen eine zweidimensionale Hierarchie. Die meisten KI-Modelle geben eine flache Tabelle aus – eine Kopfzeile, dann Datenzeilen. Sie bewahren die hierarchische Beziehung nicht nativ, es sei denn, sie werden ausdrücklich dazu aufgefordert. Das Ergebnis ist oft eine technisch korrekte flache Tabelle, der jedoch die mehrstufige Struktur fehlt, die der ursprüngliche Autor beabsichtigt hat. Unser Ansatz zur Benutzerdefinierten Spaltenextraktion umgeht dies, indem Sie das Ausgabeschema im Voraus festlegen, anstatt die KI zu bitten, es aus dem Bild abzuleiten.
Dichte randlose Raster mit variablen Zellenbreiten. Wenn eine Tabelle keine Ränder, schmale Lücken zwischen Spalten und Zellen mit unterschiedlichen Textmengen (einige kurze Werte, einige lange Beschreibungen) aufweist, werden die Leerraumgrenzen mehrdeutig. Eine Zelle mit „Rechnung #2405-001“ neben einer Zelle mit „Bürobedarf – Schreibwaren (Sammelbestellung)“ könnte als drei separate Spalten interpretiert werden, wenn die KI die Leerraumschwellen falsch einschätzt.
Handgeschriebene Tabellen. Selbst wenn die Handschrift selbst lesbar ist (was die Bild-KI mit 85–95 % Genauigkeit bewältigt, wie in unserem Leitfaden zur KI-Handschrifterkennung beschrieben), verschärft sich das strukturelle Problem. Handgeschriebene Tabellen haben eine unregelmäßige Spaltenausrichtung – Werte driften nach links oder rechts, Zeilenhöhen variieren und Linien sind selten gerade. Die KI muss zwei schwierige Probleme gleichzeitig lösen: Texterkennung und Strukturinferenz aus einem unregelmäßigen Raster.
Wie herkömmliche Methoden im Vergleich abschneiden
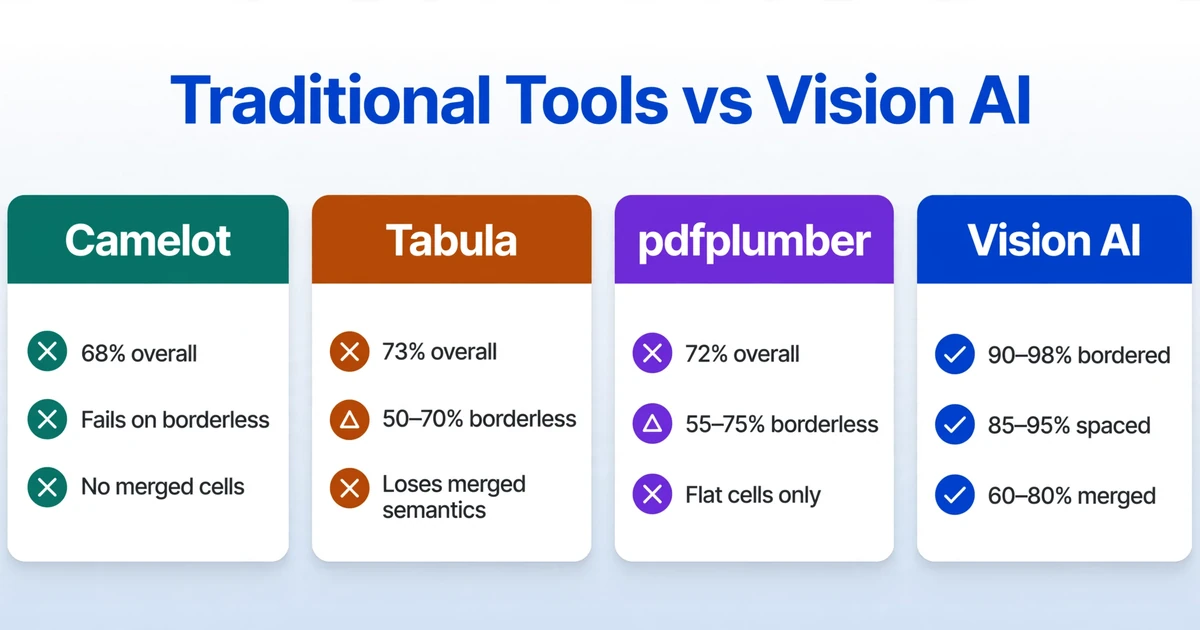
Vor der Vision-KI bedeutete das Extrahieren von Tabellen aus Bildern das Zusammensetzen mehrerer fragiler Tools. Wer den alten Ansatz versteht, erkennt, warum die Tabellenextraktionsfähigkeiten der KI einen echten Fortschritt darstellen.
| Methode | Funktionsweise | Genauigkeit bei Tabellen mit Rahmen | Genauigkeit bei Tabellen ohne Rahmen | Verbundene Zellen |
|---|---|---|---|---|
| Camelot (Lattice-Modus) | Erkennt visuelle Linien im PDF/Bild und berechnet Zellüberschneidungen | ~68 % insgesamt (über Dokumenttypen hinweg) | Scheitert vollständig – der Lattice-Modus erfordert sichtbare Rahmen | Scheitert – ohne Linienerkennung gibt es kein Raster |
| Tabula | Extrahiert Textpositionen aus PDF, gruppiert nach räumlicher Nähe | ~73 % insgesamt | 50–70 % – der Stream-Modus schätzt Spaltengrenzen anhand von Leerzeichen | Kopiert den Wert verbundener Zellen in beliebige benachbarte Zellen und verliert dabei die Semantik |
| pdfplumber | Zeichengenaue Textextraktion mit expliziter Leerraumanalyse | ~72 % insgesamt | 55–75 % – flexibler konfigurierbar als Tabula, aber derselbe grundlegende Ansatz | Keine Behandlung verbundener Zellen; gibt flache Zellen aus |
| Vision-KI / VLM | Liest die Tabelle als visuelle Szene – versteht Struktur, Text und Beziehungen gleichzeitig | 90–98 % | 85–95 % (mit Abstand) / 65–80 % (dicht) | 60–80 % – leitet Spannweiten aus dem Kontext ab, aber nicht perfekt |
Der herkömmliche Ansatz hat ein grundlegendes architektonisches Problem: Er trennt die Texterkennung von der Strukturerkennung. Zuerst extrahiert OCR Text und Positionen. Dann versucht ein separater Algorithmus – oft handabgestimmte Heuristiken –, das Tabellenraster aus diesen Positionen zu rekonstruieren. Wenn OCR ein Zeichen falsch liest (häufig bei Bildern mit niedriger Auflösung) oder ein Wort falsch positioniert (häufig bei schiefen Dokumenten), schlägt die Strukturerkennung nachgelagert fehl, ohne dass eine Wiederherstellung möglich ist. Die Fehler verstärken sich.
Vision-KI vermeidet dies vollständig. Sie liest das Tabellenbild als visuelle Szene – genauso wie Sie es tun – und versteht, dass eine Zahl unter der Kopfzeile „Gesamt" zu dieser Spalte gehört, nicht weil sie sich an Pixelkoordinate X befindet, sondern weil sie semantisch mit allem anderen in der Spalte „Gesamt" übereinstimmt. Das ist nicht nur eine bessere OCR – es ist ein grundlegend anderer Ansatz für das Problem, den unser Vergleich von KI und herkömmlicher OCR im Detail untersucht.
So erzielen Sie die besten Ergebnisse
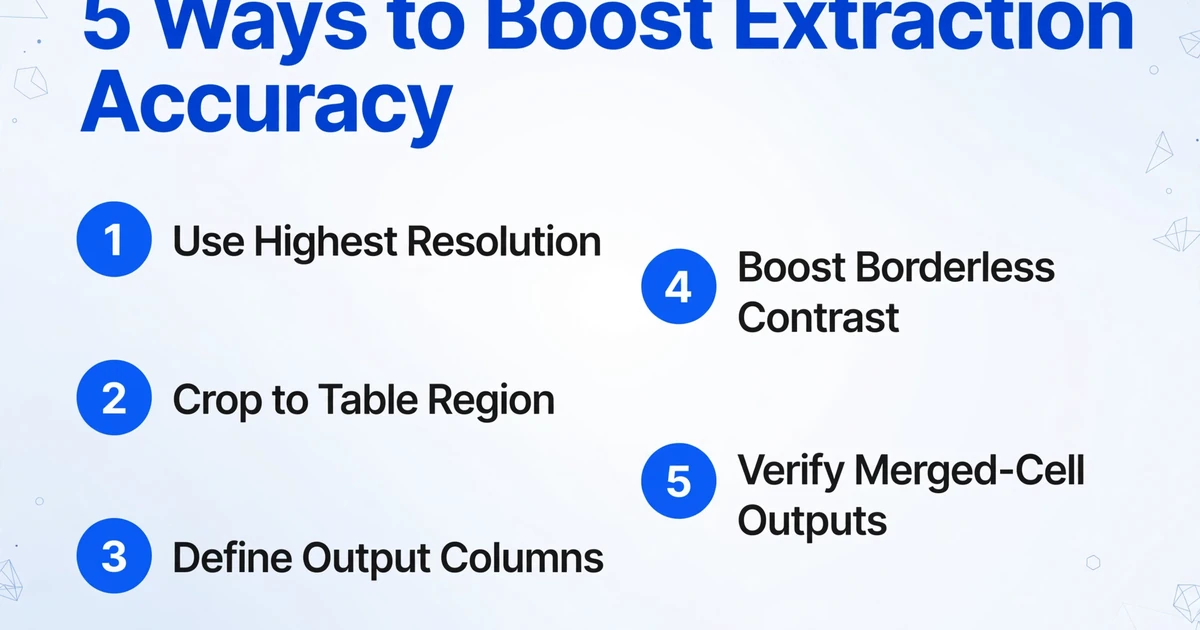
Fünf Vorgehensweisen, die die Genauigkeit der KI-Tabellenextraktion unabhängig vom verwendeten Tool konstant verbessern:
1. Beginnen Sie mit der höchsten verfügbaren Auflösung. KI-Modelle sehen das Bild als Pixelraster – mehr Pixel bedeuten eine feinere Unterscheidung zwischen benachbarten Zellen. Eine Analyse von Vision-LLMs auf dem PubTabNet-Benchmark aus dem Jahr 2025 zeigte, dass die Bildskalierung die häufigste Vorverarbeitungsverbesserung war und in 64 % der erfolgreichen Extraktionen bei Eingaben mit geringer Qualität eingesetzt wurde. Wenn Sie eine gedruckte Tabelle fotografieren, verwenden Sie die höchste Auflösung, die Ihre Handykamera unterstützt, und halten Sie das Telefon parallel zum Dokument, um perspektivische Verzerrungen zu vermeiden.
2. Schneiden Sie auf den Tabellenbereich zu. Vision-KI funktioniert besser, wenn die Tabelle den größten Teil des Bildes ausfüllt. Zusätzlicher Inhalt rund um die Tabelle – umgebender Text, Logos, Seitenkopfzeilen – erzeugt Rauschen, das die Spaltenerkennung verwirren kann. Schneiden Sie Ihr Bild vor der Extraktion auf den Tabellenbereich zu.
3. Definieren Sie Ihre Ausgabespalten explizit. Der zuverlässigste Ansatz besteht nicht darin, die KI zu bitten, „alles zu extrahieren“, sondern der KI mitzuteilen, was sie extrahieren soll. Wenn Sie Spaltennamen wie „Artikelbeschreibung“, „Menge“, „Einzelpreis“ und „Positionssumme“ angeben, weiß die KI genau, welche Felder sie suchen und wo sie in der Ausgabe hingehören. Dies ist das Prinzip hinter der Benutzerdefinierten Spaltenextraktion: Die KI ordnet Daten Ihrem Schema zu, indem sie den Inhalt des Dokuments versteht, statt die Tabellenstruktur zu erraten. Eine vollständige Erklärung, wie das funktioniert, finden Sie unter wie sich schemagesteuerte Extraktion von der vollständigen Tabellenanalyse unterscheidet.
4. Bei Tabellen ohne Rahmen: Kontrast vorab erhöhen. Wenn Ihre Tabelle keine sichtbaren Rahmen und einen geringen Spaltenabstand aufweist, kann eine Erhöhung des Bildkontrasts der KI helfen, Spaltengrenzen zu unterscheiden. Selbst eine einfache Gradationskorrektur in einem beliebigen Bildeditor – Text abdunkeln, Hintergrund aufhellen – verbessert die Erkennung von Leerräumen.
5. Prüfen Sie Ausgaben bei verbundenen Zellen. Diesen Schritt sollten Sie niemals überspringen. Wenn eine Tabelle verbundene Zellen enthält, überprüfen Sie die extrahierte Tabelle auf Zeilen, in denen ein Wert zu fehlen scheint oder falsch wiederholt wird. Die strukturelle Inferenz der KI bei verbundenen Zellen ist gut genug, um Ihnen enorm viel Zeit zu sparen – sie liegt in 80 % der Fälle richtig –, aber die restlichen 20 % können Fehler verursachen, die sich auf nachgelagerte Analysen auswirken, wenn sie nicht geprüft werden. Behandeln Sie die KI-Extraktion als ersten Entwurf, der eine 60-sekündige manuelle Prüfung benötigt, nicht als Blackbox, die keine Kontrolle erfordert.
Praxisbeispiele: Was Sie erwartet
Beispiel 1: Bestellausdruck mit umrandeter Positionstabelle. Sie fotografieren eine Bestellung eines Lieferanten. Die Tabelle hat klare Rahmen, Standardspalten (Position, Beschreibung, Menge, Einzelpreis, Gesamtpreis) und keine verbundenen Zellen. Die KI extrahiert dies nahezu perfekt – jede Zeile, jeder Zellenwert, korrekt ausgerichtet. Sie müssen nichts nachbearbeiten. Das ist der Idealfall, in dem die KI-Tabellenextraktion wirklich schneller und genauer ist als manuelle Dateneingabe.
Beispiel 2: Kontoauszug als PDF mit rahmenloser Umsatztabelle. Kontoauszüge nutzen meist Leerraum-basierte Tabellenlayouts: Datum, Verwendungszweck, Soll, Haben und Saldo, getrennt durch gleichmäßige Abstände. Die KI verarbeitet das gut – 90–95 % Genauigkeit bei Struktur und Inhalt. Der häufigste Fehler sind lange Buchungstexte, die in die benachbarte Soll-/Haben-Spalte ragen. Ein schneller Blick auf die Ausgabe genügt, um diese in unter einer Minute zu korrigieren.
Beispiel 3: Gescannter Vertragsanhang mit dichtem Preistabellenraster. Dies ist der schwierigste Fall: keine Rahmen, enge Spaltenabstände, verbundene Kategorieüberschriften über mehrere Unterspalten und Datenwerte unterschiedlicher Länge. Rechnen Sie mit 65–80 % struktureller Genauigkeit. Die KI erfasst die meisten Datenpunkte richtig, kann aber die Zuordnung zwischen verbundenen Kategorieüberschriften und ihren Unterspalten durcheinanderbringen. Planen Sie bei einer 20-zeiligen Tabelle 5–10 Minuten manuelle Korrektur ein.
FAQ
Kann KI Tabellen aus einem Handyfoto extrahieren?
Ja, und oft überraschend gut – vorausgesetzt, das Foto ist scharf, gut beleuchtet und gerade (nicht schräg) aufgenommen. Der Hauptfehler bei Handyfotos ist die perspektivische Verzerrung: Eine schräg fotografierte Tabelle erzeugt schiefe Linien, die sowohl die klassische OCR als auch die KI-Strukturerkennung verwirren. Halten Sie das Telefon parallel zur Dokumentenoberfläche – die Ergebnisse sind dann mit einem Flachbettscanner vergleichbar. Für häufig fotografierte statt gescannte Dokumenttypen finden Sie in unserem Leitfaden Datenextraktion aus Screenshots und Fotos weitere Informationen.
Funktioniert KI besser mit PDFs oder Bildern?
Das hängt vom PDF ab. Ein textbasiertes PDF (bei dem Sie Text auswählen und kopieren können) enthält Positionsdaten, die die KI als zusätzliches Signal nutzen kann – oft mit 5–10 Prozentpunkten höherer Genauigkeit als bei einem reinen Bild. Ein gescanntes, reines Bild-PDF entspricht einem Bild. Die KI verarbeitet beides – aber wenn Sie die Wahl haben, liefern Sie das originale textbasierte PDF statt eines Screenshots davon.
Kann KI Tabellen mit mehrzeiligem Text in Zellen verarbeiten?
Ja, und das ist ein Bereich, in dem KI herkömmliche Methoden deutlich übertrifft. Enthält eine Zelle einen Textabsatz – häufig in Vertragsanhängen, Spezifikationsblättern und klinischen Berichten – verliert die klassische OCR die Zeilengrenzen, weil Zeilenumbrüche innerhalb einer Zelle wie Zeilenumbrüche aussehen. Die visuelle KI liest die Zelle als Ganzes und bewahrt den darin enthaltenen Text, da sie versteht, dass ein Zeilenumbruch in „Leistungsumfang: Der Auftragnehmer verpflichtet sich…“ keine neue Zeile beginnt.
Wie verarbeitet KI Tabellen mit unterschiedlichen Währungen oder Zahlenformaten?
KI liest Zahlenwerte im Kontext – sie erkennt „1.500,00" als europäisches Format (1.500,00) und „$1.500,00" als US-Format, selbst wenn beide in derselben Tabelle vorkommen. Das funktioniert, weil visuelle KI nicht auf Mustererkennung von Zahlenzeichenfolgen angewiesen ist; sie versteht die Sprache des Dokuments, den umgebenden Spaltenkontext und die wahrscheinliche Bedeutung des Werts. Tabellen mit gemischten Formaten – wie eine Handelsrechnung mit gemischten Währungsformaten – werden in den meisten Fällen korrekt verarbeitet.
Kann KI Tabellen extrahieren, die sich über mehrere Seiten erstrecken?
Ja. Moderne visuelle KI kann erkennen, wenn eine Tabelle auf der nächsten Seite fortgesetzt wird, und die Ergebnisse zu einer einzigen Ausgabetabelle zusammenführen. Eine Studie von 2025 mit dem PubTables-v2-Datensatz erreichte einen Recall von 99,5 % bei der Identifizierung seitenübergreifender Tabellenfortsetzungen. Die praktische Voraussetzung: Alle Seiten müssen als Batch hochgeladen werden, damit die KI den Zusammenhang erkennen kann. Die Verarbeitung Seite für Seite verliert den seitenübergreifenden Kontext.
Muss ich die KI zuerst auf mein Tabellenformat trainieren?
Nein. Dies ist ein häufiges Missverständnis, das von templatebasierten OCR-Tools wie Docparser oder Parseur herrührt, bei denen Sie für jedes neue Dokumentenlayout Parsing-Zonen oder Regeln definieren müssen. Visuelle KI nutzt semantisches Verständnis – sie liest Ihre Tabelle so, wie ein Mensch es tun würde, ohne vorherige Kenntnis Ihres spezifischen Formats. Der Kompromiss: Templatebasierte Tools können bei Formaten, auf die sie explizit trainiert wurden, eine höhere Genauigkeit erzielen, versagen jedoch, wenn sich das Format ändert. KI handhabt Formatvariationen automatisch, jedoch mit geringerer Spitzengenauigkeit bei einem einzelnen festen Format. Eine detaillierte Aufschlüsselung dieses Kompromisses finden Sie unter traditionelle OCR vs. KI-Extraktion.
Was passiert, wenn eine Tabelle sowohl Text als auch Kontrollkästchen oder Symbole enthält?
Visuelle KI liest Kontrollkästchen und Symbole kontextbezogen – ein angekreuztes Kästchen neben „Expressversand" wird als „Versandart = Express" verstanden, nicht als isoliertes Symbol. Dies funktioniert, weil die KI das Kontrollkästchen und den Beschriftungstext zusammen als eine semantische Einheit sieht, ähnlich wie sie Schlüssel-Wert-Paare an anderer Stelle auf der Seite verarbeitet. Die Genauigkeit bei Kontrollkästchendaten liegt in der Regel bei 85–95 %, vergleichbar mit gedrucktem Text in Tabellen mit Rahmen.
Fazit: KI ist heute bereit für Tabellen mit Rahmen und gutem Zeilenabstand. Sie spart selbst bei schwierigen Fällen enorm viel Zeit – denn das Bearbeiten einer größtenteils korrekten Extraktion ist schneller, als alles von Grund auf neu einzutippen. Und mit der Verbesserung der visuellen Modelle schrumpft die Kategorie „schwierig" jedes Jahr. Die Daten belegen dies: Die S-TEDS-Werte für PubTabNet sind von ~65 % im Jahr 2020 auf ~93 %+ im Jahr 2025 gestiegen, und der Trend hat sich noch nicht abgeflacht.
Für einen praktischen Vergleich der KI-Extraktion mit manueller Dateneingabe bei realen Dokumenten siehe unsere Zeit- und Genauigkeitsanalyse von KI vs. manueller Transkription. Oder erkunden Sie unsere Übersicht über die besten Tabellenextraktionstools im Jahr 2026, um zu sehen, wie verschiedene Tools bei den für Ihren Workflow wichtigen Metriken abschneiden.