L'IA peut-elle extraire des tableaux d'images ?
Oui — et voici à quel point c'est efficace
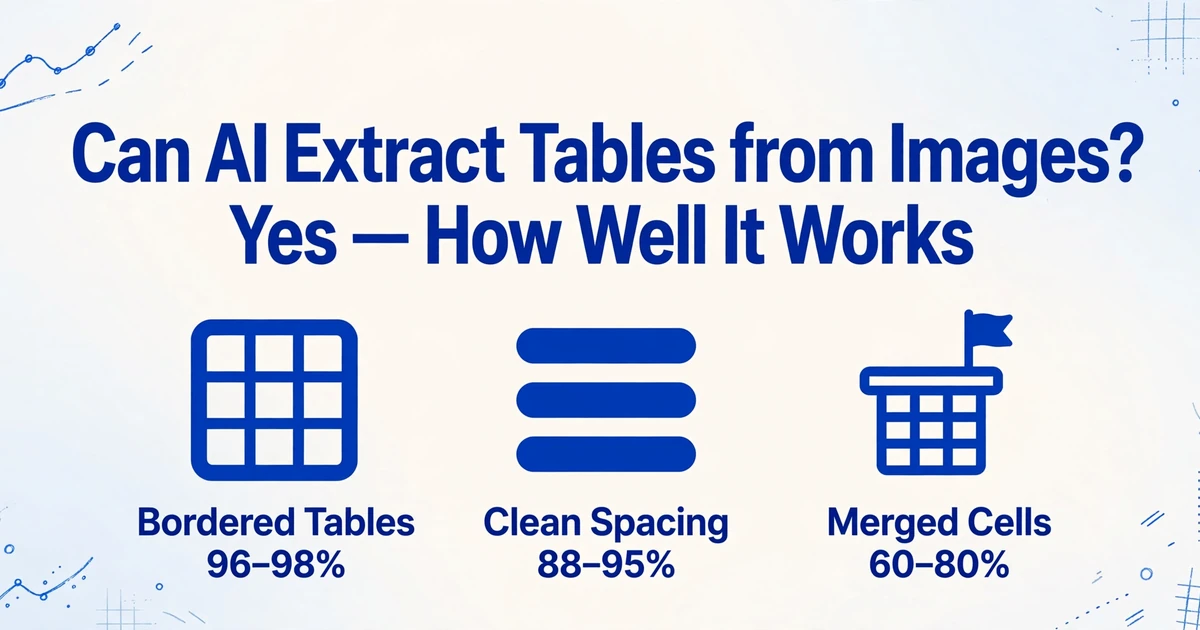
Oui. L'IA peut extraire des données de tableaux — lignes, colonnes, en-têtes et valeurs de cellules — à partir d'images de tableaux avec ou sans bordures. Les tableaux avec bordures atteignent une reconnaissance de structure quasi parfaite, dépassant souvent 95 %. Les tableaux sans bordures avec un espacement clair entre les colonnes fonctionnent bien, dans la plage de 85 à 95 %. Les tableaux denses sans bordures avec cellules fusionnées et en-têtes hiérarchiques restent le cas le plus difficile, se situant généralement entre 60 et 85 % et nécessitant un nettoyage manuel. L'écart ne vient pas du fait que l'IA « comprend » ou non les tableaux — elle les comprend — mais de l'ambiguïté inhérente à une image de tableau : lorsqu'il n'y a pas de limites visuelles, même un lecteur humain doit deviner à quelle cellule appartient une valeur.
Points clés à retenir
- La précision de l'extraction de tableaux par l'IA chute de 96 % sur les tableaux avec bordures à 60 % sur les tableaux à cellules fusionnées — et la faute n'en revient pas au modèle, mais à l'image d'entrée qui a déjà effacé la structure hiérarchique.
- Une cellule fusionnée s'étendant sur trois lignes signifie « cette catégorie couvre les trois éléments suivants » — évident pour un lecteur humain, mais pour une IA opérant sur une image plate, c'est un problème d'inférence où la structure arborescente n'existe plus dans les données.
- Définissez explicitement vos colonnes de sortie — Description de l'article, Quantité, Prix unitaire — et l'IA localise les valeurs par leur sens sémantique plutôt qu'en reconstruisant la grille du tableau, contournant ainsi entièrement l'ambiguïté des cellules fusionnées.
Efficacité selon le type de tableau
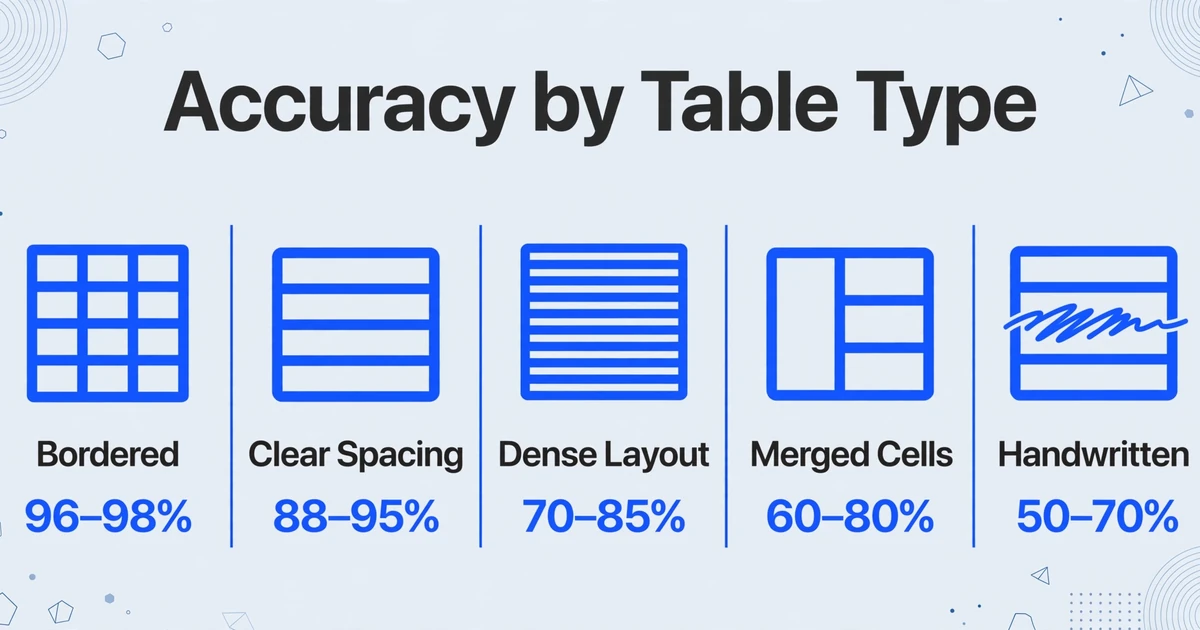
La question « l'IA peut-elle extraire des tableaux à partir d'images » n'a pas de réponse unique. Tout dépend du tableau dans votre image — et non de la capacité générale de l'IA. Des décennies de recherche en vision par ordinateur, culminant avec le benchmark TableBank (417 234 tableaux étiquetés) et PubTabNet (plus de 568 000 images de tableaux), ont produit une image claire de ce qui fonctionne et de ce qui ne fonctionne pas. Voici la répartition :
| Type de tableau | Précision de la structure (S-TEDS) | Contenu + structure (TEDS) | Ce qui le fait fonctionner / échouer |
|---|---|---|---|
| Tableaux avec bordures | 96–98 % | 90–95 % | Les lignes de quadrillage fournissent des limites de cellules sans ambiguïté. La vision IA détecte les lignes comme séparateurs ; la détection des colonnes est quasi parfaite. |
| Sans bordures, espacement clair | 88–95 % | 85–93 % | L'espace blanc entre les colonnes est suffisant lorsqu'il est large et cohérent. L'IA déduit les limites des colonnes à partir des modèles d'alignement. |
| Sans bordures, disposition dense | 70–85 % | 65–80 % | Les espaces étroits entre les colonnes brouillent les limites. Des valeurs comme « 2 400 000 » à côté de « 12,5 % » avec un espacement mince sont fusionnées dans une seule cellule environ un tiers du temps. |
| Cellules fusionnées | 60–80 % | 55–75 % | Rowspan/colspan brisent l'hypothèse de grille. L'IA doit déduire sur quelles lignes s'étend une cellule fusionnée — trivial pour les humains, structurellement ambigu pour les algorithmes. |
| Tableaux manuscrits | 50–70 % | 40–65 % | Double défi : reconnaître l'écriture manuscrite et déduire la structure du tableau à partir d'un alignement irrégulier. Même les opérateurs de saisie de données humains ralentissent considérablement sur ceux-ci. |
Ces chiffres proviennent de la métrique TEDS (Tree-Edit-Distance-based Similarity) utilisée dans les benchmarks académiques. S-TEDS mesure la fidélité structurelle — le bon nombre de lignes et de colonnes est-il présent, avec un chevauchement correct des cellules ? TEDS ajoute la précision du contenu — les valeurs à l'intérieur de chaque cellule sont-elles correctes ? Un benchmark 2025 des modèles de vision-langage sur PubTabNet a révélé que les VLM à usage général atteignent 74–85 % de TEDS en extraction brute, tandis que les modèles spécialisés dans les tableaux avec des pipelines de pré-traitement dépassent les 93 % (framework NGTR, IJCAI 2025).
L'implication pratique : si vous extrayez des données de tableaux de factures propres avec bordures ou de rapports structurés, l'IA est mature et prête pour la production. Si vous traitez une annexe de contrat scannée contenant un tableau de prix dense, sans bordures, avec des en-têtes de catégories fusionnés — prévoyez de consacrer du temps à la vérification manuelle. Pour une vue plus large de ce que l'extraction documentaire par IA peut et ne peut pas faire sur tous les types de documents, consultez notre guide sur ce qu'est réellement l'extraction documentaire par IA.
Ce que l'IA fait bien
Trois scénarios de tableaux où l'IA visuelle moderne fournit systématiquement des résultats de qualité production :
Tableaux avec bordures, quelle qu'en soit la source. Qu'il s'agisse d'une facture PDF, d'une capture d'écran d'un portail comptable ou d'une photo d'un bon de commande imprimé — si le tableau a des lignes de grille visibles, l'IA détecte les limites des cellules avec une précision quasi parfaite. La raison est simple : les lignes horizontales et verticales créent un graphe sans ambiguïté qu'un modèle d'IA peut analyser de manière déterministe, comme il analyserait une grille de feuille de calcul. Les outils OCR traditionnels comme Camelot atteignent aussi 90 %+ sur les tableaux bien bordés, mais l'IA ajoute la capacité de gérer les bordures incurvées ou inclinées qui font échouer les détecteurs de lignes basés sur des règles.
Tableaux sans bordures, avec espacement propre. Les factures modernes des plateformes SaaS, des cabinets de services professionnels et des fournisseurs orientés design utilisent souvent des mises en page basées sur les espaces blancs — pas de lignes de grille, juste un espacement généreux entre les colonnes. Ces tableaux sont conçus pour être lisibles par les humains grâce au seul alignement, et les modèles d'IA entraînés sur des millions d'images de tableaux ont appris le même indice visuel. Lorsque les écarts entre colonnes sont cohérents et plus larges que les espaces entre les mots d'une cellule, l'IA identifie correctement les limites dans 90 %+ des cas.
Tableaux multipages avec structure cohérente. Lorsqu'un tableau s'étend sur plusieurs pages avec la même disposition de colonnes sur chaque page — courant dans les relevés bancaires, les rapports financiers et les factures de services publics — l'IA peut traiter chaque page indépendamment et fusionner les résultats en une seule feuille de calcul continue. C'est là que la conception par lots en priorité des outils d'extraction modernes devient cruciale : vous téléversez toutes les pages d'un coup et obtenez un tableau de sortie unifié, et non N extraits séparés nécessitant un assemblage manuel.
Là où il rencontre des difficultés
Être précis sur les modes d'échec inspire plus de confiance que de prétendre une précision de 99 % sur tout. Voici les scénarios où l'extraction de tableaux par IA exige encore une supervision humaine :
Cellules fusionnées avec une sémantique directionnelle. Une cellule couvrant trois lignes dans un en-tête de colonne signifie « c'est la catégorie parente des trois lignes suivantes ». Pour un humain, c'est évident. Pour une IA, c'est un problème d'inférence structurelle : reconstruire un arbre à partir d'une grille plate. Lorsque les cellules fusionnées couvrent quatre lignes ou plus, ou lorsqu'elles apparaissent simultanément dans les en-têtes de lignes et de colonnes, la précision chute nettement. Une étude comparative de 2024 sur les outils d'analyse PDF a constaté que la précision des analyseurs se dégradait le plus sur les documents aux mises en page non standard et aux fusions de cellules complexes.
Ce n'est pas un échec de l'intelligence artificielle — c'est un échec du format d'entrée. Une image de tableau avec des cellules fusionnées a perdu la structure hiérarchique qui existerait dans la source d'origine (HTML avec attributs rowspan, ou feuille de calcul avec régions fusionnées). On demande à l'IA de reconstruire des informations qui ont été supprimées lorsque le tableau a été rendu sous forme d'image plate. C'est un problème d'inférence, pas de reconnaissance.
En-têtes hiérarchiques. Les tableaux où les en-têtes de colonnes ont des relations parent-enfant (par exemple, « T1 2025 » couvrant « Janv. », « Févr. », « Mars ») et où les en-têtes de lignes ont aussi des groupes parents créent une hiérarchie bidimensionnelle. La plupart des modèles d'IA produisent un tableau plat — une ligne d'en-tête, puis des lignes de données. Ils ne préservent pas naturellement la relation hiérarchique, sauf si on le leur demande explicitement. Le résultat est souvent un tableau plat techniquement correct mais qui a perdu la structure multi-niveaux voulue par l'auteur original. Notre approche d'Extraction de colonnes personnalisées contourne ce problème en vous laissant définir le schéma de sortie à l'avance, plutôt que de demander à l'IA de l'inférer à partir de l'image.
Grilles denses sans bordures avec largeurs de cellules variables. Lorsqu'un tableau n'a pas de bordures, des espaces étroits entre les colonnes et des cellules contenant des quantités de texte variables (certaines valeurs courtes, certaines descriptions longues), les limites des espaces blancs deviennent ambiguës. Une cellule contenant « Facture #2405-001 » à côté d'une cellule contenant « Fournitures de bureau — Papeterie (commande groupée) » pourrait être interprétée comme trois colonnes distinctes si l'IA évalue mal les seuils d'espaces blancs.
Tableaux manuscrits. Même lorsque l'écriture elle-même est lisible (ce que l'IA de vision gère avec une précision de 85 à 95 %, comme couvert dans notre guide sur la reconnaissance de l'écriture manuscrite par IA), le problème structurel s'aggrave. Les tableaux manuscrits ont un alignement de colonnes irrégulier — les valeurs dérivent à gauche ou à droite, les hauteurs de lignes varient et les lignes sont rarement droites. L'IA doit résoudre deux problèmes difficiles simultanément : la reconnaissance de texte et l'inférence de structure à partir d'une grille irrégulière.
Comment les méthodes traditionnelles se comparent
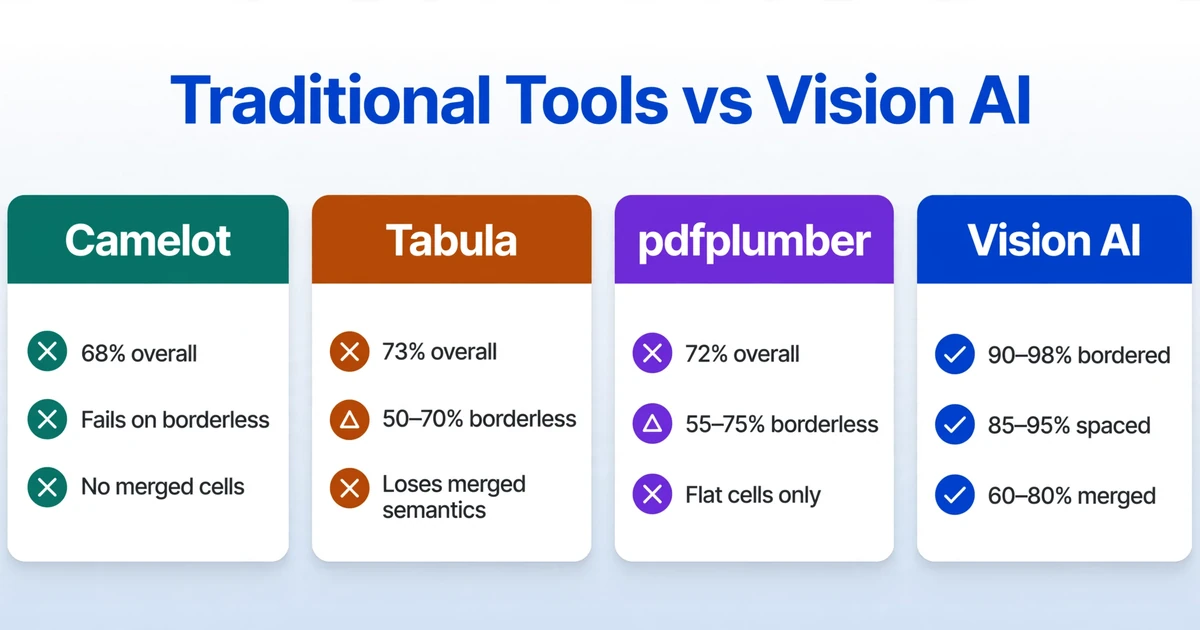
Avant la vision IA, extraire des tableaux d'images signifiait assembler plusieurs outils fragiles. Comprendre l'ancienne approche explique pourquoi les capacités d'extraction de tableaux de l'IA constituent un véritable changement de paradigme.
| Méthode | Comment ça fonctionne | Précision — tableaux avec bordures | Précision — tableaux sans bordures | Cellules fusionnées |
|---|---|---|---|---|
| Camelot (mode lattice) | Détecte les lignes visuelles dans le PDF/l'image et calcule les intersections de cellules | ~68 % en moyenne (tous types de documents confondus) | Échec total — le mode lattice exige des bordures visibles | Échec — pas de détection de lignes, donc pas de grille |
| Tabula | Extrait les positions du texte du PDF et les regroupe par proximité spatiale | ~73 % en moyenne | 50–70 % — le mode stream devine les limites de colonnes à partir des espaces | Copie la valeur de la cellule fusionnée dans des cellules adjacentes arbitraires, perdant ainsi la sémantique |
| pdfplumber | Extraction de texte au niveau du caractère avec analyse explicite des espaces | ~72 % en moyenne | 55–75 % — plus configurable que Tabula mais même approche fondamentale | Aucune gestion des cellules fusionnées ; sort des cellules plates |
| Vision AI / VLM | Lit le tableau comme une scène visuelle — comprend simultanément la structure, le texte et les relations | 90–98 % | 85–95 % (espacé) / 65–80 % (dense) | 60–80 % — déduit l'étendue à partir du contexte, mais pas parfaitement |
L'approche traditionnelle présente un problème architectural fondamental : elle sépare la reconnaissance du texte de la reconnaissance de la structure. D'abord, l'OCR extrait le texte et les positions. Ensuite, un algorithme distinct — souvent des heuristiques réglées à la main — tente de reconstruire la grille du tableau à partir de ces positions. Si l'OCR lit mal un caractère (fréquent sur les images basse résolution) ou positionne mal un mot (fréquent avec les documents inclinés), l'inférence de structure échoue en aval, sans possibilité de récupération. Les erreurs se cumulent.
La vision IA évite complètement ce problème. Elle lit l'image du tableau comme une scène visuelle — exactement comme vous le feriez — comprenant qu'un nombre sous l'en-tête « Total » appartient à cette colonne non pas parce qu'il se trouve à la coordonnée de pixel X, mais parce qu'il s'aligne sémantiquement avec tout le reste de la colonne « Total ». Ce n'est pas simplement un meilleur OCR — c'est une approche fondamentalement différente du problème, que notre comparaison IA vs OCR traditionnel explore en détail.
Comment obtenir les meilleurs résultats
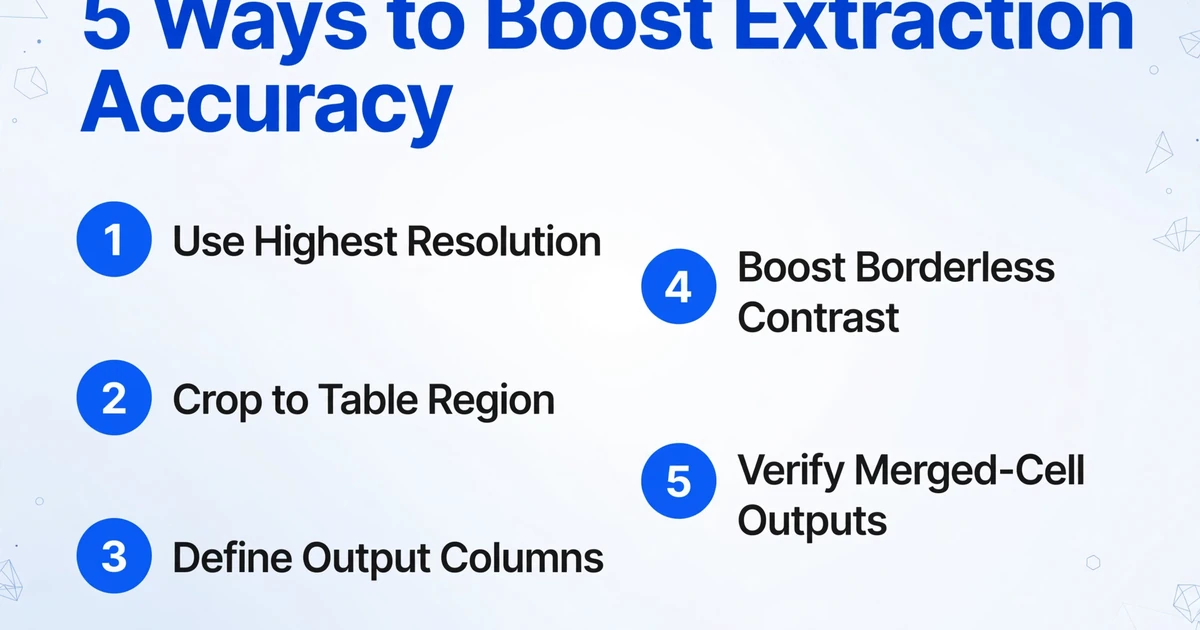
Cinq pratiques qui améliorent systématiquement la précision de l'extraction de tableaux par IA, quel que soit l'outil utilisé :
1. Commencez avec la résolution la plus élevée disponible. Les modèles d'IA voient l'image comme une grille de pixels — plus de pixels signifie une distinction plus fine entre les cellules adjacentes. Une analyse de 2025 des LLM vision sur le benchmark PubTabNet a constaté que la mise à l'échelle de l'image était l'amélioration de prétraitement la plus courante, utilisée dans 64 % des extractions réussies sur des entrées de faible qualité. Si vous photographiez un tableau imprimé, utilisez la résolution la plus élevée prise en charge par l'appareil photo de votre téléphone et tenez le téléphone parallèlement au document pour éviter la distorsion de perspective.
2. Recadrez la zone du tableau. L'IA vision fonctionne mieux lorsque le tableau remplit la majeure partie du cadre. Le contenu supplémentaire autour du tableau — texte environnant, logos, en-têtes de page — ajoute du bruit qui peut perturber la détection des colonnes. Recadrez votre image pour ne conserver que la zone du tableau avant l'extraction.
3. Définissez explicitement vos colonnes de sortie. L'approche la plus fiable ne consiste pas à demander à l'IA d'« extraire tout » — mais à lui dire quoi extraire. Lorsque vous spécifiez des noms de colonnes comme « Description de l'article », « Quantité », « Prix unitaire » et « Total de la ligne », l'IA sait exactement quels champs rechercher et où ils se trouvent dans la sortie. C'est le principe derrière l'Extraction de colonnes personnalisées : l'IA fait correspondre les données à votre schéma en comprenant le contenu du document, sans deviner la structure du tableau. Pour une explication complète de son fonctionnement, voir en quoi l'extraction pilotée par schéma diffère de l'analyse complète du tableau.
4. Pour les tableaux sans bordures, prétraitez avec un renforcement du contraste. Si votre tableau n'a pas de bordures visibles et un espacement de colonnes fin, augmenter le contraste de l'image peut aider l'IA à distinguer les limites des colonnes. Même un simple réglage des niveaux dans n'importe quel éditeur d'image — assombrir le texte, éclaircir l'arrière-plan — améliore la détection des espaces blancs.
5. Vérifiez les sorties des cellules fusionnées. C'est l'étape à ne jamais sauter. Lorsqu'un tableau contient des cellules fusionnées, examinez la feuille de calcul extraite pour repérer les lignes où une valeur semble manquante ou répétée à tort. L'inférence structurelle de l'IA sur les cellules fusionnées est suffisamment bonne pour vous faire gagner un temps considérable — elle réussit 80 % des cas — mais les 20 % restants peuvent introduire des erreurs qui se propagent dans l'analyse en aval si elles ne sont pas vérifiées. Considérez l'extraction par IA comme un premier brouillon nécessitant une vérification humaine de 60 secondes, et non comme une boîte noire ne nécessitant aucune supervision.
Exemples concrets : à quoi s'attendre
Exemple 1 : Un bon de commande imprimé avec un tableau d'articles bordé. Vous photographiez un bon de commande d'un fournisseur. Le tableau a des bordures claires, des colonnes standard (Article, Description, Qté, Prix unitaire, Total) et aucune cellule fusionnée. L'IA extraira cela avec une précision quasi parfaite — chaque ligne, chaque valeur de cellule, correctement alignée. Vous ne passerez aucun temps à nettoyer. C'est le cas idéal où l'extraction de tableaux par IA est vraiment plus rapide et plus précise que la saisie manuelle.
Exemple 2 : Un relevé bancaire PDF avec un tableau de transactions sans bordures. Les relevés bancaires utilisent généralement des mises en page basées sur les espaces blancs : colonnes date, description, débit, crédit et solde séparées par des écarts constants. L'IA gère bien cela — 90 à 95 % de précision sur la structure et le contenu. L'erreur la plus courante est le mauvais alignement des longues descriptions de transactions qui débordent dans la colonne débit/crédit adjacente. Un rapide coup d'œil sur le résultat permet de les repérer en moins d'une minute.
Exemple 3 : Une annexe de contrat scannée avec une grille tarifaire dense. C'est le cas le plus difficile : pas de bordures, espacement étroit des colonnes, en-têtes de catégories fusionnés couvrant plusieurs sous-colonnes, et valeurs de données de longueurs variables. Attendez-vous à une précision structurelle de 65 à 80 %. L'IA obtiendra la plupart des données correctement, mais pourrait mélanger la relation entre les en-têtes de catégories fusionnées et leurs sous-colonnes. Prévoyez 5 à 10 minutes de correction manuelle pour un tableau de 20 lignes.
FAQ
L'IA peut-elle extraire des tableaux d'une photo prise avec mon téléphone ?
Oui, et souvent étonnamment bien — à condition que la photo soit nette, bien éclairée et prise de face (pas en angle). Le principal problème avec les photos de téléphone est la distorsion de perspective : un tableau photographié en angle crée des lignes obliques qui perturbent à la fois l'OCR traditionnel et la reconnaissance structurelle de l'IA. Tenez le téléphone parallèle à la surface du document et les résultats seront comparables à ceux d'un scanner à plat. Pour les types de documents souvent photographiés plutôt que scannés, consultez notre guide sur l'extraction de données à partir de captures d'écran et de photos.
L'IA fonctionne-t-elle mieux avec les PDF ou les images ?
Cela dépend du PDF. Un PDF textuel natif (où vous pouvez sélectionner et copier du texte) contient des données de positionnement que l'IA peut utiliser comme signal supplémentaire, améliorant souvent la précision de 5 à 10 points de pourcentage par rapport à une image pure. Un PDF scanné (image uniquement) équivaut à une image. L'IA gère les deux — mais si vous avez le choix, fournissez le PDF textuel natif original plutôt qu'une capture d'écran de celui-ci.
L'IA peut-elle gérer des tableaux avec du texte multiligne dans les cellules ?
Oui, et c'est d'ailleurs un domaine où l'IA surpasse nettement les méthodes traditionnelles. Lorsqu'une cellule contient un paragraphe de texte — courant dans les annexes de contrats, les fiches techniques et les rapports cliniques — l'OCR traditionnel perd la trace des limites de ligne car les sauts de ligne dans une cellule ressemblent à des sauts de ligne. L'IA visuelle lit la cellule comme une entité entière et préserve le texte qu'elle contient, comprenant qu'un saut de ligne dans « Périmètre d'intervention : Le prestataire devra... » ne commence pas une nouvelle ligne.
Comment l'IA gère-t-elle les tableaux avec différentes devises ou formats de nombres ?
L'IA lit les valeurs numériques en contexte — elle reconnaît « 1.500,00 » comme un nombre au format européen (1 500,00) et « 1 500,00 $ » comme un format américain, même si les deux apparaissent dans le même tableau. Cela fonctionne car l'IA visuelle ne se base pas sur la reconnaissance de motifs de chaînes numériques ; elle comprend la langue du document, le contexte de la colonne environnante et la signification probable de la valeur. Les tableaux aux formats croisés — comme une facture commerciale avec des formats de devises mixtes — sont correctement traités dans la plupart des cas.
L'IA peut-elle extraire des tableaux qui s'étendent sur plusieurs pages ?
Oui. L'IA visuelle moderne peut détecter quand un tableau se poursuit sur la page suivante et fusionner les résultats en un seul fichier de sortie. Une étude de 2025 utilisant le jeu de données PubTables-v2 a atteint un rappel de 99,5 % pour l'identification des continuations de tableaux entre pages. La condition pratique : toutes les pages doivent être téléchargées ensemble en un lot pour que l'IA puisse voir la continuité. Traiter les pages une par une fait perdre le contexte inter-page.
Dois-je d'abord entraîner l'IA sur mon format de tableau ?
Non. C'est une idée reçue courante héritée des outils OCR basés sur des modèles comme Docparser ou Parseur, où vous devez définir des zones ou des règles d'analyse pour chaque nouvelle mise en page de document. L'IA visuelle utilise la compréhension sémantique — elle lit votre tableau comme le ferait un humain, sans avoir besoin d'une exposition préalable à votre format spécifique. Le compromis : les outils basés sur des modèles peuvent atteindre une meilleure précision sur les formats pour lesquels ils ont été explicitement entraînés, mais ils échouent lorsque le format change. L'IA gère automatiquement les variations de format, mais avec une précision maximale plus faible sur un format fixe unique. Pour une analyse détaillée de ce compromis, voir OCR traditionnel vs extraction par IA.
Que se passe-t-il lorsqu'un tableau contient à la fois du texte et des cases à cocher ou des symboles ?
L'IA visuelle lit les cases à cocher et les symboles de manière contextuelle — une case cochée à côté de « Expédition express » est comprise comme « mode d'expédition = express », et non comme un symbole isolé. Cela fonctionne car l'IA voit la case à cocher et le texte de l'étiquette ensemble comme une seule unité sémantique, de la même manière qu'elle traite les paires clé-valeur ailleurs sur la page. La précision sur les données des cases à cocher est généralement de 85 à 95 %, comparable à celle du texte imprimé dans les tableaux avec bordures.
En résumé : l'IA est prête aujourd'hui pour les tableaux avec bordures et bien espacés. Elle fait gagner un temps considérable, même dans les cas difficiles — car éditer une extraction en grande partie correcte est plus rapide que de tout taper à partir de zéro. Et à mesure que les modèles de vision s'améliorent, la catégorie « difficile » se réduit chaque année. Les données le confirment : les scores S-TEDS sur PubTabNet sont passés d'environ 65 % en 2020 à plus de 93 % en 2025, et la tendance ne s'est pas encore stabilisée.
Pour une comparaison pratique des performances de l'extraction par IA par rapport à la saisie manuelle sur des documents réels, consultez notre analyse temps-précision de l'IA vs la transcription manuelle. Ou, explorez notre sélection des meilleurs outils d'extraction de tableaux en 2026 pour voir comment différents outils se comparent sur les métriques qui comptent pour votre flux de travail.