Melhores Ferramentas de Extração de Documentos
de Campo em 2026: 9 Testadas
Testamos nove ferramentas de extração de documentos usando as mesmas 40 fotos de smartphones capturadas em campo — listas de verificação de inspeção manuscritas de pesquisas de postes de utilidade, leituras de medidores analógicos e digitais fotografadas em boa e má iluminação, diários de obra diários com contagens de equipe e horas de equipamento, formulários de JHA (Job Hazard Analysis) com blocos de aprovação, tickets de balança impressos termicamente de um pátio de agregados em operação e relatórios de serviço com diagramas desenhados à mão — em cada plataforma, medindo a precisão em nível de campo em pontos de dados específicos, como números de ID de equipamento, leituras de medidores/indicadores com unidades, resultados de inspeção aprovado/reprovado com assinaturas de inspetores, contagens de equipe, classificações de perigo JHA e placas de veículos contra valores de tara e peso bruto.
Melhores Ferramentas de Extração de Documentos de Campo em 2026: 9 TestadasTestamos nove ferramentas de extração de documentos usando as mesmas 40 fotos de smartphones capturadas em campo, medindo a precisão em nível de campo em pontos de dados específicos, como números de ID de equipamento, leituras de medidores com unidades, resultados de inspeção com assinaturas, contagens de equipe, classificações de perigo JHA e placas de veículos contra valores de tara e peso bruto.
Principais Conclusões
- Oito das nove ferramentas pontuaram acima de 85% em fotos limpas e bem iluminadas de displays de medidores impressos e diários de obra datilografados — depois, cinco caíram abaixo de 60% quando o mesmo documento foi fotografado na sombra, em ângulo ou com desbotamento de impressão térmica, situações que todos os trabalhadores de campo enfrentam diariamente.
- As ferramentas construídas para processamento de documentos de uso geral (faturas, recibos) não estavam falhando por causa de OCR ruim — seus conjuntos de treinamento nunca mostraram um formulário de inspeção de campo com marcas de verificação desenhadas à mão, um JHA com códigos de categoria de perigo ou um ticket de balança com relações de tara/peso bruto/peso líquido que exigem verificação aritmética.
- As três ferramentas que mantiveram acima de 80% em todas as condições de teste compartilharam uma característica de design: elas leem campos por significado semântico em vez de coordenadas de modelo — então "ID do Equipamento" rabiscado na margem de um diário de obra recebe o mesmo tratamento que um digitado em sua caixa designada, e um valor de peso desbotado termicamente em uma terceira cópia carbono ainda pode ser resolvido.
Divulgação: ImageToTable.ai é nosso produto e aparece nesta análise. Nós o incluímos porque acreditamos que sua abordagem — sem modelo, baseada em nomes de colunas — atende a uma lacuna específica no processamento de documentos de serviço de campo, onde a variabilidade de formato e a densidade de escrita à mão são maiores. As outras oito ferramentas são avaliadas de forma independente. Todos os links externos usam rel="nofollow noopener" — não repassamos autoridade de link para as ferramentas que analisamos.
A extração de documentos de serviço de campo não é extração de documentos de escritório feita ao ar livre. A distinção importa porque determina quais documentos você processa, como eles chegam e o que acontece com os dados depois. Um inspetor de concessionária fotografa uma lista de verificação de inspeção de poste às 7h com luz de inverno em ângulo baixo — o papel está úmido, as marcas de verificação são feitas com caneta esferográfica sobre impressões de papel carbono de uma folha anterior, e as anotações manuscritas do inspetor sobre uma travessa rachada estão espremidas na margem. Um supervisor de canteiro de obras registra um diário de obra diário às 16h30 enquanto a luz desaparece — contagens de equipe, horas de equipamento, entregas de material e uma nota de segurança sobre um quase acidente estão todas escritas na mesma caligrafia apressada. Um operador de balança em uma pedreira entrega a um motorista de caminhão um ticket impresso termicamente para 34.200 kg de pedra britada — quando chega ao escritório de compras, o papel térmico ficou exposto ao sol no painel do carro.
As ferramentas de extração que dominam as análises de uso geral — testadas em faturas digitalizadas limpas e recibos de formato padrão — não foram projetadas para essas condições. Elas esperam iluminação uniforme, layout previsível, texto impresso por máquina e documentos que chegam como PDFs limpos. Os documentos de serviço de campo violam todas essas premissas. Este guia testa nove ferramentas especificamente nos tipos de documento, condições de captura e campos específicos do setor que operações de concessionárias, construção, plantas industriais e transporte realmente lidam. Para uma análise mais aprofundada de como é a extração de leitura de medidores por IA especificamente para frotas de medidores de concessionárias, consulte nosso guia sobre como a IA lê medidores a partir de fotos.
Como Testamos: 40 Documentos de Campo, 5 Tipos de Documento, 3 Condições de Iluminação
Cada ferramenta foi testada usando sua avaliação gratuita, demo ou nível de autosservicio. Nenhun fornecedor foi avisado com antelación. A escolha metodológica crítica: cada documento foi testado como foto de smartphone, não como digitalização plana. Usamos uma cámara trasera de um Samsung Galaxy A54 de gama média e um iPhone 14, capturando cada documento de teste duas vezes — uma vez com boa iluminación (bien iluminado, de frente, iluminación uniforme) e outra vez em condições degradadas que refletem a captura real em campo.
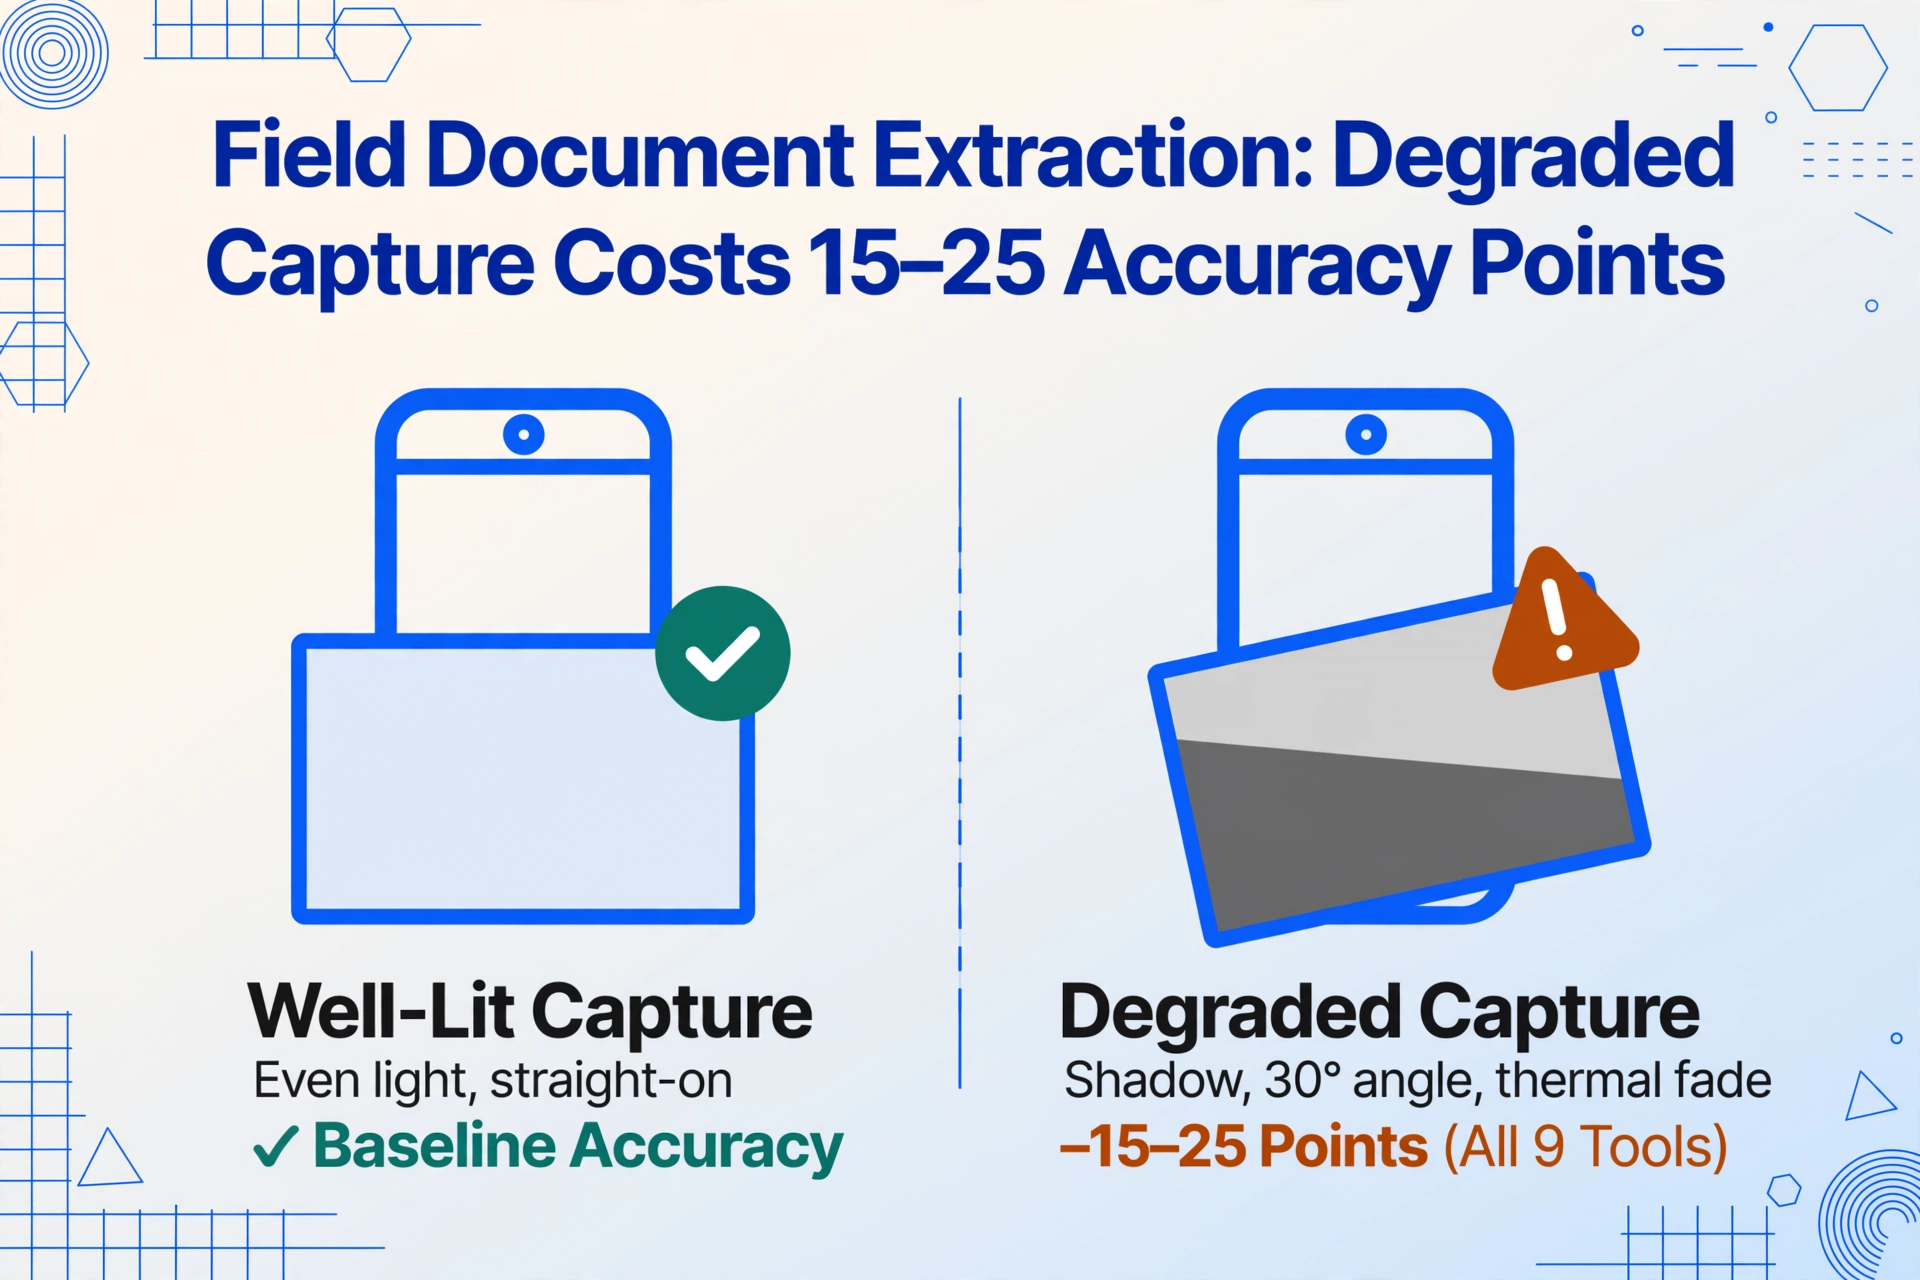
A condição degradada não era uniforme — nós a adaptamos ao tipo de documento. Os formulários de inspección foram fotografados em sombra simulada (uma condição comum para inspecciones de bases de postes de serviços públicos). As pantallas de medidores foram capturadas em um ângulo de 30 graus para simular um técnico lendo um medidor em um sótano apertado. Os tickets de báscula foram fotografados como estavam, incluindo o desvanecimiento térmico e os artefactos de copia carbón já presentes nos documentos originais.
O conjunto de teste de 40 documentos de campo se dividió da seguinte manera:
- 10 listas de verificación manuscritas e formulários de segurança — incluindo listas de verificación de inspección de postes de serviços públicos com caixas de verificación de aprovado/reprovado, formulários de inspección pré-uso de equipos com notas manuscritas de defectos, formulários JHA (Job Hazard Analysis) com códigos de categoría de peligro (golpeado-por, atrapado-entre, eléctrico, etc.), e permisos de entrada a espacios confinados com blocos de firma. A densidade de escritura manual era alta: aproximadamente 60-70% do conteúdo destes documentos era escrito manualmente.
- 10 fotos de medidores e indicadores — cobriendo medidores analógicos de dial (água, gás), pantallas LCD digitais (medidores de serviços públicos elétricos, totalizadores de fluxo), indicadores de pressão circulares com agujas, e painéis multi-indicador com 3-6 instrumentos em um único quadro. Cada um capturado tanto em boa iluminación como em condições degradadas (sombra, brilho de ângulo).
- 8 registros diários de obra de construção — informes diários manuscritos registrando contagens de cuadrilla por ofício, horas de equipos, entregas de materiais, condições climáticas, descripciones de trabalho e eventos de segurança. Estes vinham de projetos de construção ativos e eram fotografados ao final do turno.
- 6 tickets de báscula — tickets impressos térmicamente de um patio de agregados, incluindo tanto impressões limpas como exemplos térmicos muito desvanecidos. Tres dos seis eram duplicados de terceira copia NCR (no-carbon-required) com baixo contraste característico e caracteres quebrados.
- 6 informes de serviço de campo — informes de serviço manuscritos de técnicos de manutención de HVAC e equipos, com números de modelo de equipos, notas de diagnóstico, peças usadas, horas de trabalho e diagramas desenhados à mano.
Medimos três coisas por extracción: precisión a nível de campo em dados específicos do campo (IDs de equipos/inspección, leituras de medidores com unidades, determinações de aprovado/reprovado com assinatura do inspector, códigos de peligro JHA, contagens de cuadrilla, pesos tara/bruto/neto, placas de licencia), tolerância à iluminación e qualidade de captura (delta de precisión entre capturas bem iluminadas e em condições degradadas do mesmo documento), e tolerância à escritura manual e meios (precisión em campos manuscritos e meios térmicos/desvanecidos vs. conteúdo impresso por máquina limpo).
Em fotos limpas e bem iluminadas de conteúdo impresso por máquina (alguns visores de medidores, partes digitadas de registros de campo), oito de nove ferramentas alcançaram 85% ou mais de precisão em nível de campo. Em campos específicos — assinaturas manuscritas de inspetores, códigos de risco JHA, IDs de equipamentos escritos nas margens, valores de peso desbotados pelo calor — a variação foi extrema: as três melhores ferramentas mantiveram 78-88% de precisão, enquanto as três piores ficaram abaixo de 40%. O maior preditor de desempenho geral foi se uma ferramenta lia documentos pelo significado do campo ou pela posição do campo.
Para um detalhamento de como tipos específicos de medidores afetam a precisão da extração em campo, consulte nosso guia de precisão de leitura de medidores.
Comparação Rápida: 9 Ferramentas de Extração de Documentos para Serviço de Campo
| Ferramenta | Melhor para | Preço inicial | Tolerância a fotos* | Manuscrito | Captura offline |
|---|---|---|---|---|---|
| ImageToTable.ai | Extração sem modelo de qualquer tipo de documento de campo | Plano gratuito (20 créditos/mês); pago a partir de US$ 9/mês | Alta (82-95%) | Alta (80-90%) | Não |
| SafetyCulture (iAuditor) | Inspeções de segurança mobile-first com checklists digitais | Grátis (até 10 usuários); pago a partir de ~US$ 19/usuário/mês | N/A (baseado em formulário) | N/A (entrada manual) | Sim |
| Fulcrum | Coleta de dados de campo integrada a GIS com mapeamento | ~US$ 20/usuário/mês | N/A (entrada manual) | N/A (entrada manual) | Sim |
| ProntoForms (TrueContext) | Automação de campo empresarial com design offline-first | Sob consulta (normalmente US$ 50-100/usuário/mês) | Baixa (OCR básico de imagem) | Baixa (OCR básico) | Sim |
| GoCanvas | Formulários de campo móveis no-code com automação | ~US$ 45/usuário/mês | Baixa (captura básica de imagem) | Baixa (sem OCR de manuscrito) | Sim |
| Nanonets | Treinamento personalizado de IA em formatos de formulários específicos de campo | ~US$ 499/mês | Média (60-78% sem treinamento) | Média (55-70% sem treinamento) | Não |
| Amazon Textract | Pipelines de extração personalizados baseados em AWS | ~US$ 0,0015/página | Média (55-75%) | Baixa (45-60%) | Não |
| Docparser | Relatórios de campo com formato consistente de remetentes conhecidos | A partir de US$ 32,50/mês | Baixa (40-55%) | Baixa (35-50%) | Não |
| Device Magic | Implantação rápida de formulários de coleta de dados de campo | ~US$ 20/usuário/mês | N/A (baseado em formulário) | N/A (entrada manual) | Sim |
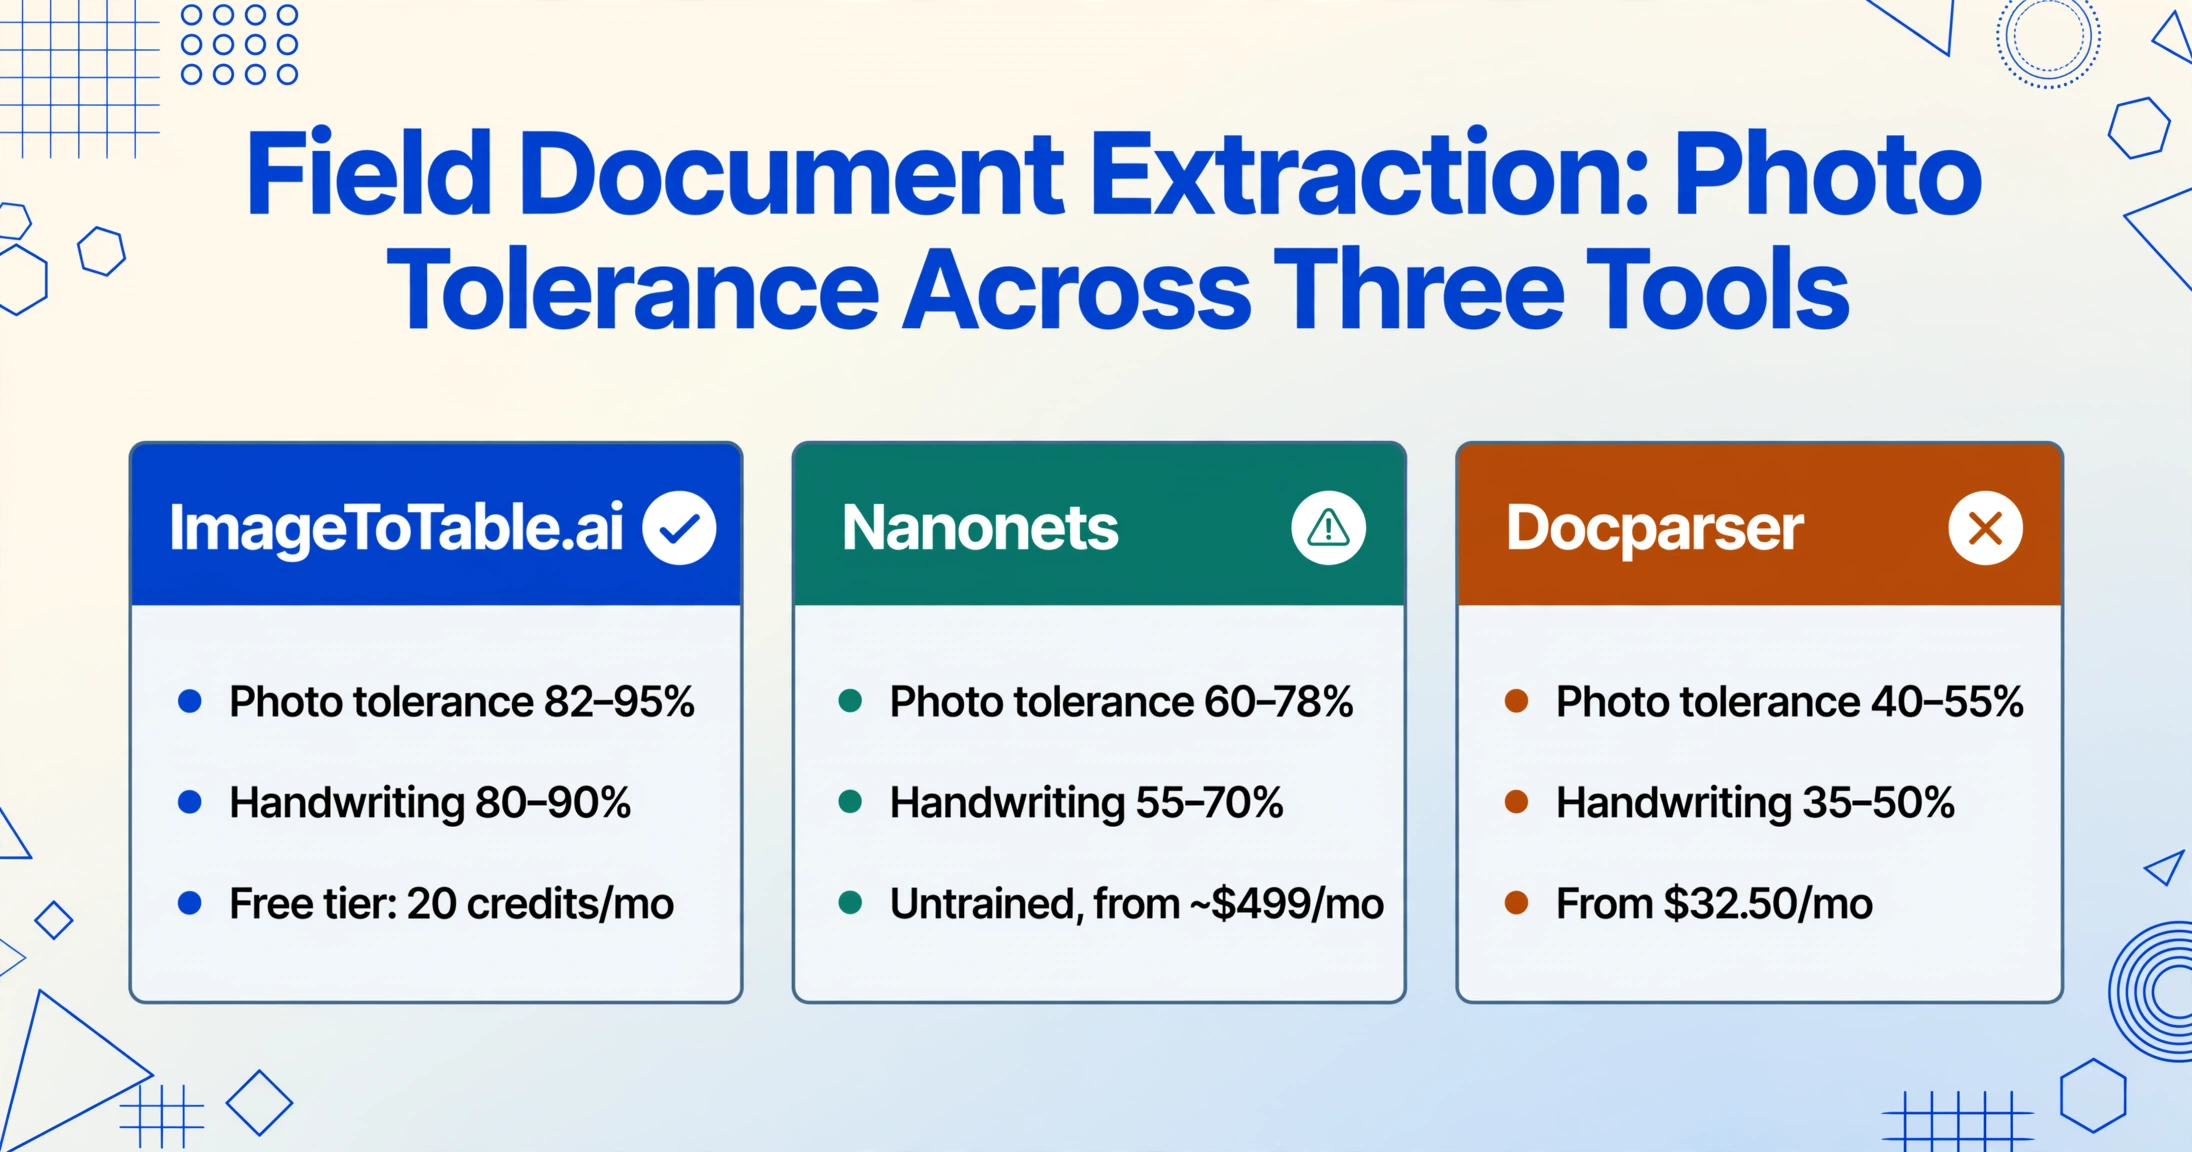
*A tolerância de fotos mede a precisão em documentos fotografados por smartphone em comparação com digitalizações planas. "Alta" significa que a precisão cai menos de 10 pontos percentuais da digitalização para a foto do telefone. "Baixa" significa uma queda de 25+ pontos. N/A para ferramentas baseadas em formulários que não realizam extração de documentos a partir de fotos enviadas.
ImageToTable.ai — Melhor para Extração de Documentos de Campo sem Modelo em Qualquer Formato
Melhor para: Supervisores de campo, inspetores de serviços públicos e equipes de operações no local que processam vários tipos de documentos de campo — formulários de inspeção, fotos de medidores, registros de site, tickets de balança, formulários de segurança — e precisam de um fluxo de extração que funcione em todos os formatos sem configuração por tipo de documento.
Não é ideal para: Operações que exigem coleta de dados móvel offline em áreas sem conectividade celular, ou grandes empresas que precisam de roteamento de aprovação integrado, orquestração de fluxo de trabalho integrada ao ERP ou filas com intervenção humana em escala.
O ImageToTable.ai usa Extração de Colunas Personalizadas — você digita os nomes dos campos que deseja extrair ("ID do Equipamento", "Leitura do Medidor", "Contagem da Equipe", "Peso", "Nome do Inspetor", "Aprovado/Reprovado") e a IA localiza esses valores em qualquer documento de campo por compreensão semântica, em vez de posição de pixel. Essa é a distinção central em relação às ferramentas baseadas em modelos e é mais importante para operações de campo onde uma lista de verificação de inspeção de poste de utilidade da Power Company A usa um layout completamente diferente — rótulos de campo diferentes, posições de caixas de seleção diferentes, localização do bloco de assinatura diferente — do que o mesmo tipo de lista da Power Company B.
No nosso conjunto de testes com 40 documentos, o ImageToTable.ai entregou a maior precisão geral em nível de campo em todos os tipos de documento, com a menor diferença de precisão entre capturas bem iluminadas e em condições degradadas — um delta de aproximadamente 10-13 pontos percentuais em comparação com 20-35 pontos para a maioria das outras ferramentas. A tolerância à caligrafia foi a mais forte do teste: leituras de medidores manuscritas, comentários de inspetores e entradas de registro de site que fizeram quatro ferramentas neste teste caírem abaixo de 50% de precisão foram extraídas de forma confiável aqui, porque o modelo de visão subjacente diferencia texto impresso, caligrafia, carimbos, marcas de verificação e marcas desenhadas à mão intercaladas na mesma superfície do documento.
Os tickets de balança foram um diferencial particular. Tickets impressos termicamente de pátios de agregados e pátios de sucata combinam impressão de baixo contraste, layout variável entre estações de pesagem e anotações de peso manuscritas. Sem configuração de modelo, o ImageToTable.ai extraiu os campos de peso tara, bruto e líquido de todos os seis tickets do conjunto de teste, incluindo dois que eram duplicatas de terceira via carbono — uma categoria que fez as ferramentas baseadas em modelos retornarem dados de caracteres embaralhados.
Os arquivos são processados com segurança e não são armazenados. Tente enviar uma foto de medidor ou formulário de campo para ver o fluxo de extração.
Link de Coleta resolve um problema prático de coleta de dados em campo: levar documentos de campo do ponto de captura para o sistema. Você gera um URL exclusivo da sua conta e o compartilha com equipes de campo, operadores de estações de pesagem ou subcontratados. Eles abrem o link, inserem um código de verificação e enviam fotos diretamente para a sua fila de processamento — sem necessidade de conta, sem anexos de e-mail, sem gerenciamento de pastas na nuvem. Para uma concessionária com 15 equipes de campo fotografando inspeções de postes, cada equipe envia fotos pelo seu Link de Coleta e o lote é processado durante a noite. Para fluxos de extração de leitura de medidor, o complemento do Google Sheets permite que os dados de campo cheguem diretamente em uma planilha ativa, sem etapas intermediárias de exportação.
Preços (junho de 2026): Plano gratuito (extração básica). Planos pagos a partir de $9/mês para 100 páginas, $19/mês para 500 páginas, $39/mês para 1.000 páginas.
SafetyCulture (iAuditor) — Melhor para Inspeções de Segurança Mobile-First com Checklists Digitais
Melhor para: Organizações que executam programas estruturados de inspeção de segurança — verificações de conformidade com a OSHA, auditorias de segurança no local, inspeções pré-uso de equipamentos — onde o fluxo de trabalho principal é preencher checklists digitais em dispositivos móveis no campo.
Não é ideal para: Operações onde os documentos de campo já existem em papel e precisam ser extraídos de fotos — o modelo do iAuditor é voltado para formulários, não para extração de documentos. Lidar com formulários de papel existentes exige entrada manual de dados.
SafetyCulture (anteriormente iAuditor) é a plataforma dominante de inspeção de segurança mobile-first, com mais de 3.000 avaliações na loja de aplicativos e um plano gratuito que suporta até 10 usuários. Seu fluxo de trabalho principal é construído em torno de modelos de checklist digitais que os inspetores preenchem em seus celulares — cada pergunta é um campo estruturado (aprovado/reprovado, valor numérico, nota de texto, foto), e os resultados são compilados automaticamente em um relatório. O reconhecimento da plataforma no Capterra Shortlist e GetApp Category Leaders em 2026 reflete forte adoção no mercado, especialmente em construção, manufatura e gestão de instalações.
A principal distinção para o serviço de campo: o iAuditor resolve o problema de captura de dados substituindo o formulário de papel por um digital no ponto de inspeção. Se suas equipes de campo ainda não estão comprometidas com fluxos de trabalho em papel, esta é uma solução mais elegante do que a extração. O inspetor abre o aplicativo, percorre o checklist, adiciona fotos e o relatório é gerado. Os dados são estruturados por design — não há caligrafia para decifrar, variabilidade de layout ou degradação de cópia carbono.
A limitação é o inverso: se suas equipes de campo já preenchem formulários em papel — e inúmeras operações de campo o fazem, por hábito, papel compatível com luvas, preferência regulatória ou simples falta de orçamento para dispositivos — o iAuditor não pode extrair esses dados da papelada existente. Não há um pipeline de imagem para dados estruturados. O formulário de papel deve ser convertido em um modelo digital primeiro, e todas as inspeções subsequentes acontecem no dispositivo. Para operações que desejam digitalizar seu acervo de papel existente ou processar fotos de fontes externas (tíquetes de balança de fornecedores, registros de obra de subcontratados), uma camada de extração de documentos é necessária junto ou em vez da plataforma de inspeção.
Preços (junho de 2026): Grátis (até 10 usuários, relatórios básicos). Planos pagos a partir de aproximadamente $19/usuário/mês para o nível Pro. Preços personalizados para empresas disponíveis.
Fulcrum — Melhor para Coleta de Dados em Campo Integrada a GIS com Contexto Geoespacial
Melhor para: Concessionárias de água, equipes ambientais de campo e empresas de engenharia que precisam combinar dados de inspeção em campo com mapeamento GIS — cada registro de inspeção é georreferenciado automaticamente e vinculado a ativos específicos no mapa.
Não é ideal para: Equipes que precisam de extração automática de dados de documentos ou fotos em papel existentes — Fulcrum é uma plataforma estruturada de coleta de dados em campo, não uma ferramenta de extração de documentos. Os dados das fotos enviadas devem ser inseridos manualmente.
Fulcrum é a plataforma líder de coleta de dados em campo com foco em GIS, amplamente utilizada por concessionárias de água, consultores ambientais e empresas de engenharia de infraestrutura. Seu construtor de formulários do tipo arrastar e soltar permite que as equipes criem listas de verificação de inspeção que incluem captura de fotos, coordenadas GPS, campos numéricos, seleções suspensas e lógica condicional. A integração do Fulcrum com o Esri ArcGIS é a melhor da categoria: os registros podem ser exportados diretamente como camadas GeoJSON ou Shapefile, e o mapeamento em tempo real mostra cada inspeção concluída como um ponto no mapa do território.
Para operações em que cada registro de inspeção precisa estar em um mapa — levantamentos de postes de utilidades, inspeções de faixa de servidão de dutos, monitoramento ambiental — o Fulcrum oferece a experiência mais rica de coleta de dados geoespaciais. Seu modo offline é confiável: os trabalhadores de campo podem coletar dados o dia todo sem conectividade, e os registros são sincronizados automaticamente quando o sinal retorna. A adição recente do Audio FastFill, um recurso de voz para dados com IA, resolve o problema de "técnicos não podem parar para digitar" permitindo que os inspetores falem suas observações em campos estruturados.
A limitação para extração de documentos é a mesma do SafetyCulture: o Fulcrum é uma plataforma estruturada de coleta de dados, não um mecanismo de extração de documentos. Se sua equipe de campo entregar uma pilha de formulários de inspeção em papel preenchidos do levantamento do mês passado, o Fulcrum não consegue lê-los. As fotos capturadas em campo são anexadas ao registro como evidência — os dados que entram nos campos estruturados são o que o trabalhador de campo digitou ou falou, não o que uma IA extraiu da imagem. Para operações que precisam de extração automática de formulários em papel existentes, o Fulcrum atua como a camada de coleta que alimenta um pipeline de extração separado.
Preços (junho de 2026): A partir de $19.99/usuário/mês (compra no aplicativo no iOS). Preços empresariais disponíveis. Há um teste gratuito de 30 dias.
ProntoForms (TrueContext) — Melhor para Automação de Workflow de Campo Empresarial com Confiabilidade Offline
Melhor para: Grandes empresas com operações de campo que precisam de integração profunda com ERP/SAP/Salesforce, automação complexa de workflow e coleta de dados offline confiável em locais remotos.
Não é ideal para: Operações de campo de pequeno a médio porte que não precisam de integrações empresariais — o poder da plataforma vem da profundidade de integração, o que é um custo adicional se o seu workflow for "enviar foto → obter dados".
ProntoForms (agora rebatizada como TrueContext) é uma plataforma de coleta de dados de campo de nível empresarial, criada para organizações que precisam conectar operações de campo com SAP, Salesforce, Microsoft Dynamics e outros sistemas empresariais. Suas capacidades offline estão entre as mais confiáveis da categoria — formulários de campo, anexos de fotos, coordenadas GPS e assinaturas digitais podem ser capturados sem conectividade e sincronizados automaticamente quando o dispositivo se reconecta.
Os pontos fortes do TrueContext — design estruturado de formulários, regras de validação, lógica condicional, gatilhos de workflow — tornam a plataforma poderosa para operações de campo que desejam padronizar a coleta de dados entre centenas de técnicos. Um programa de inspeção de dutos de petróleo e gás com mais de 200 inspetores usando TrueContext obtém dados consistentes porque o formulário os impõe. O recurso de captura de imagem da plataforma anexa fotos como evidência a cada registro de inspeção, criando uma trilha de auditoria completa.
A lacuna de extração de documentos aqui é semelhante à das outras plataformas de campo: o TrueContext é criado para captura de dados baseada em formulários, não para extrair dados de documentos em papel existentes ou fotos de documentos de terceiros. Sua camada básica de OCR pode ler alguns tipos de texto impresso de imagens, mas não é projetada para a densidade de escrita manual, artefatos de papel térmico e variabilidade de layout que a extração de documentos de campo exige. Para uma operação de campo que recebe formulários em papel de subcontratados ou tickets de balança de fornecedores, a extração precisaria ocorrer em uma ferramenta separada antes que os dados entrem no workflow do TrueContext.
Preços (junho de 2026): Preços empresariais personalizados, tipicamente $50-100/usuário/mês, dependendo dos recursos e do volume. Demonstração disponível pelo site.
GoCanvas — Melhor para Formulários Móveis de Campo Sem Código com Geração Automática de Reportes
Melhor para: Empresas de serviços de campo que desejam implantar formulários móveis rapidamente — inspeções, reportes de serviço, listas de verificação de segurança — sem envolvimento de TI ou projetos de implementação com fornecedores.
Não ideal para: Operações que precisam extrair dados de fotos de documentos de papel existentes em vez de preencher formulários em um dispositivo móvil. Também limitado para lógica condicional complexa e fluxos de trabalho de várias etapas.
GoCanvas oferece uma plataforma de autoservicio para criar formulários de campo móviles e automatizar a geração de reportes. Sua biblioteca de modelos incluye formulários pré-construidos para inspeções, reportes de serviço, auditorías de segurança e verificações de equipos. A plataforma suporta captura offline, anexos de fotos, marcas de localização GPS e assinaturas digitais — todas funcionalidades padrão de coleta de dados de campo. Uma vez que um formulário é enviado, GoCanvas gera automaticamente um reporte PDF com marca própria que pode ser enviado por e-mail ao cliente ou sincronizado com almacenamiento en la nube.
Para uma empresa de serviços de campo que está fazendo a transição de formulários de papel para digitais, o construtor de arrastar e soltar e os modelos pré-construidos de GoCanvas podem ter um primeiro formulário implantado em horas em lugar de semanas. A plataforma se integra com QuickBooks, Xero, Google Sheets e APIs REST para o fluxo de dados downstream. Su força é a simplicidade: os técnicos não precisam de treinamento para navegar no aplicativo.
A limitação, novamente, é que GoCanvas captura dados que são inseridos em seus formulários. Não extrae dados estruturados de imagens cargadas de documentos de papel. As fotos tiradas através do aplicativo GoCanvas são anexadas como evidencia ao registro do formulário — os dados contidos nessas fotos (números de série escritos em etiquetas de equipos, valores de medições manuscritas) devem ser digitados manualmente nos campos do formulário. Para operações de campo que desejam eliminar completamente a entrada manual de dados, GoCanvas não oferece esse caminho.
Preços (junho de 2026): A partir de aproximadamente $45/usuário/mês. Preços empresariales personalizados para implantações maiores. Disponível teste gratuito.
Nanonets — Melhor para Treinamento Personalizado de IA em Formatos de Formulários Específicos de Campo
Melhor para: Operações de campo com um conjunto estável de tipos de formulários (3-5 variações de modelo) e recursos técnicos internos para gerenciar o treinamento do modelo — como uma concessionária com um formulário padrão de inspeção de postes usado por todas as equipes.
Não é ideal para: Operações que leem muitos formatos diferentes de documentos de campo, equipes pequenas sem recursos técnicos, ou qualquer pessoa que precise começar a extrair hoje sem um período de treinamento.
Nanonets é uma plataforma de extração de documentos com IA que suporta treinamento personalizado de modelos. Embora seja mais conhecida pelo processamento de faturas e recibos, os usuários podem treinar modelos em tipos de formulários específicos de campo, enviando documentos de amostra e rotulando os campos desejados. Em nossos testes, treinamos um modelo Nanonets em 15 exemplos rotulados de uma lista de verificação de inspeção de postes de utilidade pública e alcançamos 78-86% de precisão em fotos limpas desse tipo específico de formulário.
A desvantagem torna-se aparente quando a diversidade de documentação de campo entra em cena. Uma operação de concessionária que lê formulários de inspeção de postes de três territórios de serviço diferentes, com três layouts de formulários diferentes, precisaria de três conjuntos de treinamento separados, com 10-20 amostras rotuladas cada. Quando um layout de formulário é atualizado — novos grupos de caixas de seleção adicionados, rótulos de campos alterados — o modelo precisa ser retreinado. Para um superintendente de construção que processa registros de obra de cinco subcontratados diferentes, cada um com um modelo de relatório diário diferente, o fardo do treinamento se multiplica.
Nanonets teve um desempenho respeitável em conteúdo impresso por máquina a partir de capturas limpas — IDs de equipamentos digitados, rótulos de formulários pré-impressos — mas teve dificuldades com a densidade de caligrafia que caracteriza os documentos de campo. Em nossos formulários de inspeção manuscritos, a precisão caiu para 55-70%. O preço mínimo de $499 por mês posiciona a Nanonets para operações com volume dedicado e recursos técnicos, não para equipes de campo individuais ou pequenas operações.
Preços (junho de 2026): Plano Pro a partir de $499/mês para 500 páginas. Preços personalizados para empresas disponíveis.
Amazon Textract — Melhor para Criar Pipelines Personalizados de Extração de Documentos
Ideal para: Equipes de desenvolvimento em empresas de serviços de campo ou utilities que desejam criar pipelines de extração personalizados na infraestrutura AWS, com controle total sobre pré-processamento, validação e integração downstream.
Não é ideal para: Equipes de operações de campo sem desenvolvedores dedicados — Textract não tem interface de usuário, nem fluxo de revisão, nem modelos pré-construidos de extração de documentos de campo.
Amazon Textract é um serviço de machine learning, não uma aplicação. Ele aceita imagens de documentos e retorna texto detectado, pares chave-valor de formulários e estruturas de tabelas. Para uma utility com infraestrutura nativa AWS e uma equipe de desenvolvimento, Textract pode ser a camada de extração em um pipeline personalizado que direciona dados de inspeção de campo para um sistema GIS ou de gestão de ativos. O recurso Queries — que permite consultas em linguagem natural como "Qual é a leitura do medidor?" — retornou resultados moderados em documentos de campo em nossos testes, funcionando bem em displays digitais limpos, mas falhando quando a leitura do medidor era escrita à mano em um campo de notas.
A extração de tabelas do Textract foi útil para as porções estruturadas de documentos de campo — a grade impressa de IDs de equipamento e datas de inspeção em uma checklist. O reconhecimento de escrita manual foi sua área mais fraca em cenários de campo: entradas de registro de site escritas à mano, notas de inspetores e descripções de perigos JHA retornaram texto com erros significativos de caracteres. Tickets de weighbridge impressos térmicamente também foram problemáticos — o baixo contraste do papel térmico desvanecido resultou em caracteres ausentes que um motor OCR de propósito geral não conseguía recuperar.
Preços — pagamento por página, a partir de aproximadamente $0.0015 por página — parecen atractivos em volumes baixos, mas podem aumentar. Processar 500 documentos de campo por mês com etapas adicionais de pré-processamento (realce de imagem, de-skewing, ajuste de contraste necessário para papel térmico) significa custos de computação além do custo de extração, mais tempo de desenvolvimento para construir e manter o pipeline. Para comparação, nosso conjunto completo de testes de campo custou aproximadamente $0.06 para processar via Textract — barato para 40 documentos, mas o custo oculto é o esforço de desenvolvimento do pipeline necessário para tornar a saída utilizável.
Preços (junho de 2026): Preços por página. Primeiro nível ~$0.0015/página para extração de texto + formulários. Custos adicionais para recursos de consulta e níveis de maior volume.
Docparser — Melhor para Relatórios de Campo com Formato Consistente de Fontes Conhecidas
Melhor para: Operações de campo que recebem formulários preenchidos de um conjunto conhecido de remetentes em formatos digitais consistentes — relatórios diários enviados por e-mail como PDFs dos mesmos contratantes, formulários de inspeção de equipamentos dos mesmos provedores de manutenção.
Não é ideal para: Documentos de campo com formato variável, conteúdo com muita caligrafia, fotos de smartphone de formulários em papel ou qualquer documento em que o layout difere entre fontes — a extração baseada em modelo falha silenciosamente quando o formato muda.
Docparser usa uma abordagem de modelo baseada em zonas: você define as coordenadas de extração em um documento de amostra, e o parser extrai essas coordenadas em todos os documentos subsequentes com o mesmo layout. Isso funciona quando o formato é idêntico todas as vezes — por exemplo, um PDF de registro diário de obra gerado pelo mesmo software de gerenciamento de construção, onde o campo de contagem de equipe sempre aparece na mesma posição.
A limitação se torna crítica em operações de campo. Um superintendente de construção recebe registros diários de três subcontratados diferentes — cada um usa um layout de formulário diferente com posições de campo diferentes. O Docparser precisa de três modelos. Quando um subcontratado atualiza o formulário — adiciona uma nova linha de equipamento, altera a seção de observações — o modelo quebra, e a extração retorna silenciosamente valores nulos ou dados incorretos. O superintendente pode não notar por dias.
No nosso conjunto de testes, o Docparser obteve pontuação razoável nos PDFs impressos por máquina gerados por sistemas de gerenciamento de campo (relatórios PDF de 36 KB gerados por software de construção), mas falhou nos documentos em papel fotografados por smartphone — registros de obra manuscritos, listas de verificação de inspeção, tickets de balança — que constituem a maioria da documentação de campo. Os artefatos de ângulo e sombra introduzidos pela captura por telefone causaram desalinhamento das coordenadas de zona, e o conteúdo manuscrito ficou totalmente fora das capacidades de OCR do Docparser.
Com preço inicial de $32,50/mês, o Docparser é a opção mais acessível para relatórios de campo com formato consistente de fontes digitais conhecidas — mas a restrição operacional ("somente formato consistente") elimina a maioria dos cenários de documentos de campo.
Preços (junho de 2026): A partir de $32,50/mês (2.500 páginas/ano). Planos superiores para maior volume.
Device Magic — Melhor para Implantações Rápidas de Coleta de Dados em Campo
Melhor para: Equipes de campo que precisam implantar um aplicativo móvel de coleta de dados rapidamente — em dias, não semanas — com suporte offline, captura de fotos e registro de GPS, sem ciclos de compras corporativas.
Não é ideal para: Operações que exigem extração de documentos por IA a partir de fotos de formulários de papel existentes, ou equipes com lógica complexa de formulários de várias páginas que exige ramificações condicionais avançadas.
Device Magic foca na implantação rápida de formulários de campo móveis com um construtor de formulários baseado na web e aplicativos móveis nativos para iOS e Android. Seu diferencial é a velocidade: um supervisor de campo pode criar um formulário de inspeção simples pela manhã, implantá-lo nos telefones da equipe até o almoço e começar a coletar dados à tarde. A plataforma suporta coleta de dados offline com sincronização automática, upload de fotos, coordenadas GPS, carimbos de data/hora e assinaturas digitais.
Para operações de campo de pequeno e médio porte — um empreiteiro especializado implementando checklists de segurança no local, uma empresa de administração de imóveis implementando formulários de inspeção de entrada/saída — a simplicidade do Device Magic e o preço de US$ 20/usuário/mês o tornam o ponto de entrada mais fácil entre as plataformas de coleta de dados em campo. O construtor de formulários usa campos de arrastar e soltar com lógica condicional básica (mostrar/ocultar perguntas com base em respostas anteriores), o que cobre a maioria dos fluxos de trabalho de inspeção simples.
A contrapartida é a profundidade. O Device Magic não realiza extração de documentos em imagens enviadas. As fotos tiradas pelo aplicativo são anexos de evidência, não fontes de dados. A plataforma também carece de automação avançada de fluxo de trabalho, integração GIS e conectores ERP que operações de campo empresariais precisam. É uma ferramenta de coleta de dados em campo, não uma ferramenta de extração de documentos — e essa distinção importa para operações que precisam extrair dados de documentos de papel existentes em vez de começar do zero com formulários digitais.
Preços (junho de 2026): A partir de aproximadamente US$ 20/usuário/mês. Sem contrato de longo prazo. Teste gratuito disponível.
Qual Ferramenta de Extração de Documentos de Campo é Ideal para a Sua Operação?
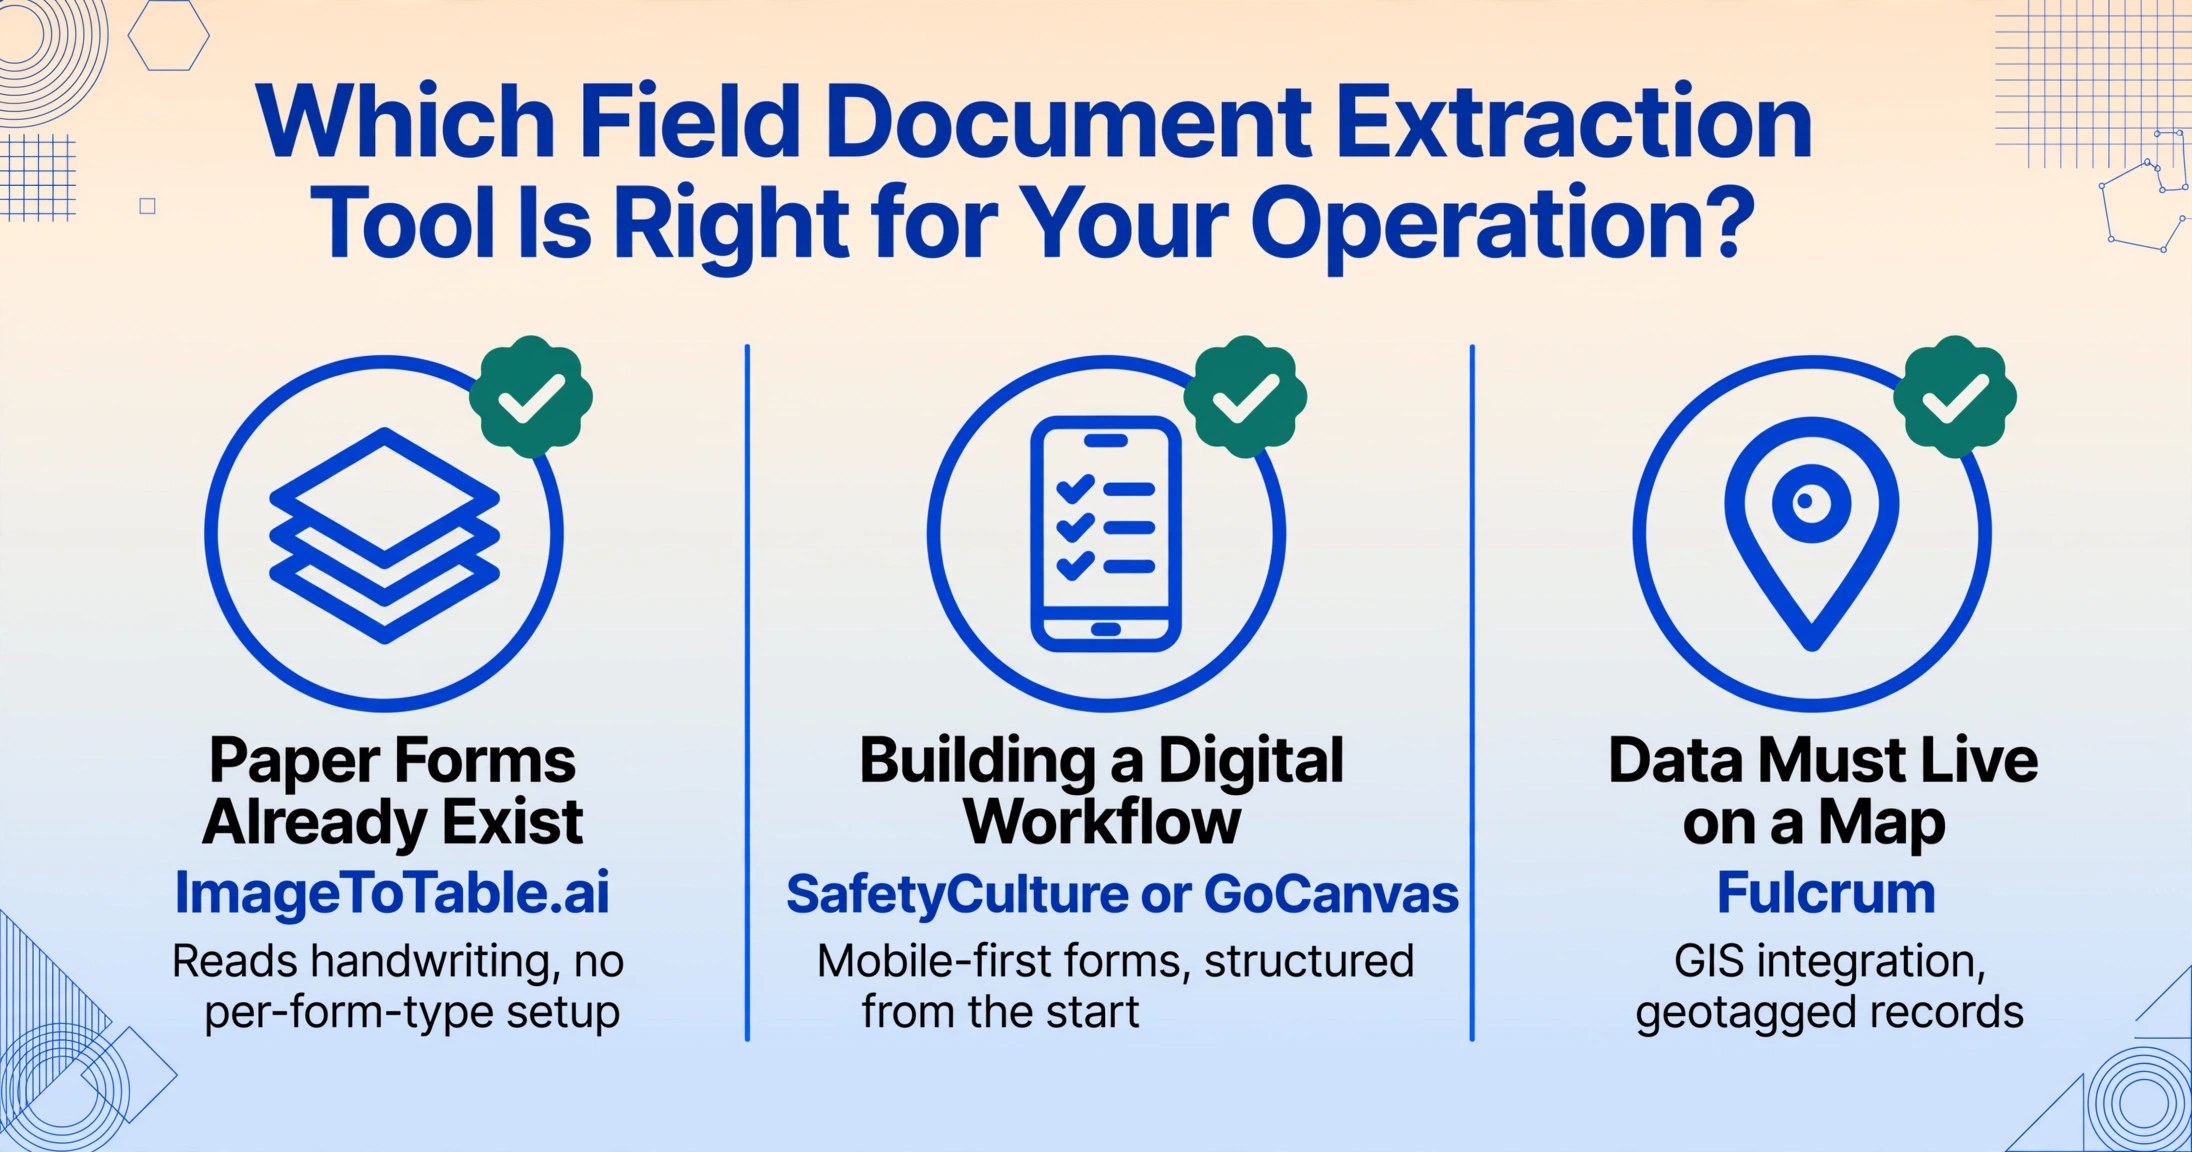
As operações de serviço de campo variam enormemente em escala, mix de tipos de documentos, capacidade técnica e se o objetivo é substituir formulários em papel ou extrair dados de papel que já existe. Escolher a ferramenta certa para a sua operação depende de duas perguntas: os seus documentos de campo já existem em papel, ou você está construindo um fluxo de trabalho digital do zero? E quais tipos de documentos de campo você processa?
| Seu Cenário | Mix de Documentos | Ferramenta Recomendada | Motivo |
|---|---|---|---|
| Formulários em papel já existem — digitalizar o acervo existente | Checklists de inspeção manuscritas, formulários JHA, relatórios de serviço, registros de campo | ImageToTable.ai | Extração semântica lê manuscritos; sem configuração por tipo de formulário; processamento em lote de tipos mistos de documentos |
| Criando novo fluxo de trabalho digital de inspeção | Auditorias de segurança, verificações de equipamentos, inspeções de conformidade | SafetyCulture ou GoCanvas | Construtor de formulários mobile-first; captura offline; dados estruturados desde o início; sem necessidade de extração |
| Dados de campo precisam de mapeamento GIS + rastreamento do ciclo de vida de ativos | Levantamentos de postes de utilidade, inspeções de dutos, monitoramento ambiental | Fulcrum | Integração GIS de melhor desempenho; captura offline; mapa em tempo real dos registros de inspeção |
| Fluxo de trabalho de campo empresarial com integração SAP/Salesforce | Operações de campo em múltiplos locais com fluxos de trabalho conectados a ERP | ProntoForms (TrueContext) | Integração empresarial profunda; modo offline robusto; automação de fluxo de trabalho |
| Documentos de fornecedores com formatos variáveis — tickets de balança, relatórios de subcontratados | Tickets de papel térmico, cópias carbono, recibos manuscritos de fontes externas | ImageToTable.ai + Link de Coleta | Extração independente de formato para documentos que você não controla; Link de Coleta para uploads externos |
| Equipe de desenvolvimento interna criando automação de campo personalizada | Processamento orientado por API de fotos de inspeção e relatórios de serviço | Amazon Textract ou Nanonets | Design API-first; controle total do pipeline; treinamento de modelo personalizado para tipos de formulário consistentes |
| Relatórios PDF digitais consistentes de contratados conhecidos | Relatórios diários digitais do mesmo software de gestão de construção | Docparser | Menor custo para relatórios digitais com modelo consistente — somente se o formato nunca mudar |
| Coleta simples de dados de campo para equipe pequena | Checklists básicos de inspeção, registros de serviço | Device Magic | Implantação mais rápida; preço simples; adequado para formulários móveis básicos |
Para comparações mais específicas em contextos relacionados de campo e industrial, veja nossos resumos complementares para logística e manufatura. Para um foco mais aprofundado especificamente em leitura de medidores, veja as melhores ferramentas de extração de leitura de medidores. E para operações que avaliam se a IA pode ler de forma confiável medidores de campo a partir de fotos de smartphones, nosso guia a-IA-pode-ler-medidor-de-foto fornece dados de testes de campo.
Os Três Desafios Específicos de Extração em Campo que a Maioria dos Resumos Ignora
Com base em testes em todas as nove ferramentas, três padrões surgiram que o típico resumo de "melhor extração de documentos" não aborda, mas que operações de serviço de campo encontram todos os dias:
1. Documentos de campo são fotografados, não digitalizados — e a diferença é estrutural. O conjunto de testes de um extrator de documentos de escritório pressupõe PDFs digitalizados em mesa plana ou capturas limpas de câmera com iluminação uniforme e perspectiva ortogonal. Fotos de documentos de campo são tiradas por alguém em pé em um estacionamento de cascalho às 6h30, segurando um telefone em uma mão e uma prancheta na outra. Os resultados são: perspectiva fora do ângulo (o formulário é fotografado a 40 graus, não a 90); iluminação irregular (um canto em pleno sol, o outro na sombra do corpo); desfoque por estabilização insuficiente das mãos; e artefatos específicos do ambiente de campo (lama na lente, condensação, manchas de chuva). Entre as ferramentas que testamos, as três que tiveram melhor desempenho em fotos capturadas em campo incluíram alguma forma de pré-processamento automatizado de imagem — ajuste de contraste, correção de inclinação e compensação de sombras — antes do reconhecimento de texto. As ferramentas que pressupunham entrada limpa entregaram pontuações de precisão 20 a 30 pontos percentuais menores nas versões com captura degradada dos mesmos documentos.
2. Escrita manual em formulários de campo não é conteúdo opcional — é o registro principal. Em uma fatura de escritório, a escrita manual é limitada a um bloco de assinatura. Em uma lista de verificação de inspeção de campo, 60-70% dos dados são manuscritos: as determinações de aprovação/reprovação do inspetor, notas sobre condições do equipamento, leituras de medidores, contagens de equipe, descrições de perigos e assinaturas de encerramento. Em r/FieldService, técnicos de campo descrevem uma realidade que os fornecedores de ferramentas de extração não abordam: "Nossos caras preenchem a papelada no final do turno no caminhão — é corrido, é no escuro, e às vezes a última página da cópia carbono é praticamente ilegível." As ferramentas que lidaram bem com esse conteúdo em nossos testes não tinham apenas um bom OCR de escrita manual — elas tinham modelos de visão que entendiam a semântica do documento: a diferença entre uma marca de verificação em uma caixa de aprovação/reprovação e um risco de caneta acidental, a relação entre a assinatura de um inspetor e os campos anteriores, a capacidade de ler um valor de um mostrador de medidor reconhecendo o ângulo da agulha em relação às marcações da escala, em vez de procurar dígitos.
3. Documentos em papel térmico e cópias carbonadas exigem um pré-processamento diferente do OCR padrão. Tickets de báscula, recibos de entrega e muitas ordens de serviço de campo são impressos em papel térmico (papel sensível ao calor que desvanece com o tempo) ou em conjuntos multicopia NCR (sem papel carbono) onde a terceira cópia é deliberadamente de baixo contraste. Estes tipos de suporte invalidam a suposição de "texto limpo sobre fundo branco" sobre a qual a maioria dos motores de OCR é construida. O desvanecimento do papel térmico é progressivo — um ticket de báscula que era legible na estação de pesagem pode estar parcialmente ilegible quando chega ao escritório de compras dias depois. A diferença entre as três ferramentas em nosso teste de tickets de báscula foi diretamente atribuible a se o pipeline de pré-processamento de uma ferramenta conseguia realçar texto de baixo contraste sem introducir ruido de OCR. Ferramentas baseadas em modelos e motores de OCR básicos não têm esse pré-processamento e devolveron dados inutilizables dos documentos térmicos e NCR. Para um exame detalhado da extração de tickets de báscula especificamente, nosso guía para extração de tickets de báscula aborda em profundidade o desafio de verificação de duas pesadas.
FAQ: Extração de Documentos de Serviço de Campo
As ferramentas de extração de documentos de campo conseguem ler escritura manual de listas de verificação de inspeção e formulários de segurança?
Isto depende inteiramente da ferramenta. Ferramentas de OCR de propósito geral e parsers baseados em modelos normalmente não conseguem ler escritura manual com a precisão requerida para dados operativos — espere 35-55% de precisão a nível de campo. Ferramentas de Vision AI que usan grandes modelos de linguagem (LLMs) para compreensão de documentos — ImageToTable.ai, Nanonets (com treinamento) — podem interpretar escritura manual com 55-85% de precisão dependendo da legibilidade, consistência da escritura e da presença de contexto de campo (um formulário modelo com campos etiquetados ajuda a IA a prever o que representa o conteúdo manuscrito). Nenhuna ferramenta alcanza 99% em todo conteúdo manuscrito de campo. O fluxo de trabalho prático é: a IA extrae automaticamente campos de alta confianza, os campos de baixa confianza são marcados para revisão humana. Para operações de campo que processan documentos fortemente manuscritos, recomendamos testar com seus formulários reais antes de comprometerse com uma ferramenta — nosso guía para extraer datos de formularios manuscritos percorre este processo de avaliação.
Como a qualidade da foto afeta a precisão da extração em documentos de campo?
Significativamente. Em nossos testes, a precisão na versão bem iluminada de um documento foi, em média, 15 a 25 pontos percentuais maior do que na versão em condições degradadas, em todas as nove ferramentas. As principais causas da degradação da precisão foram: sombra sobre a superfície do documento (o defeito mais comum em fotos de campo), perspectiva fora do ângulo (fotografar uma prancheta a 40 graus em vez de diretamente de cima) e desfoque de movimento devido à captura manual sem estabilização. Ferramentas com pré-processamento de imagem integrado — ajuste automático de contraste, correção de inclinação, compensação de sombra — reduziram a diferença de precisão para 8 a 13 pontos. Ferramentas sem pré-processamento mostraram uma diferença de 20 a 35 pontos. Para dados críticos de campo, recomendamos: (1) fotografar documentos em uma superfície relativamente plana quando possível, (2) garantir iluminação uniforme sem sombra do corpo sobre o formulário e (3) manter o telefone paralelo à superfície do documento. Para fotos já capturadas com defeitos, escolha uma ferramenta com pré-processamento em vez de uma que espere entrada limpa.
E quanto à conformidade com a OSHA? A extração por IA pode atender aos requisitos de manutenção de registros da OSHA?
As normas da OSHA Part 1910 (Indústria Geral) e Part 1926 (Construção) regem a manutenção de registros de lesões, doenças e inspeções de segurança no local de trabalho. A OSHA 29 CFR 1904 exige que os empregadores registrem lesões e doenças relacionadas ao trabalho no registro OSHA 300 e mantenham esses registros por cinco anos. A OSHA 1926.20(b)(2) exige "inspeções frequentes e regulares dos locais de trabalho, materiais e equipamentos por pessoas competentes" — e esses registros de inspeção devem estar disponíveis mediante solicitação. Para fins de conformidade, o requisito crítico é a completude e auditabilidade dos registros, não o método de captura de dados. Um registro de inspeção extraído por IA que preserva a foto original, os dados estruturados extraídos, os carimbos de data/hora, a identificação do inspetor e a localização GPS fornece, argumentavelmente, mais trilha de auditoria do que um livro de registro em papel. No entanto, a OSHA atualmente não fornece orientação específica sobre extração por IA para registros de conformidade — o requisito padrão é que o registro seja preciso, completo e retido pelo período exigido. Operações que usam extração por IA para registros relacionados à conformidade devem verificar uma amostra estatística das extrações e reter as imagens originais junto com os dados extraídos.
Essas ferramentas funcionam offline? Meus locais de campo não têm cobertura celular.
As plataformas de coleta de dados em campo — SafetyCulture, Fulcrum, ProntoForms, GoCanvas, Device Magic — todas suportam modo offline para captura de dados baseada em formulários em dispositivos móveis. Dados de inspeção, fotos e assinaturas são armazenados localmente e sincronizados quando a conectividade retorna. As ferramentas de extração de documentos — ImageToTable.ai, Nanonets, Amazon Textract, Docparser — não oferecem processamento offline nativo. A extração exige o envio da imagem para uma API em nuvem, o que requer conexão com a internet. A solução prática para operações de campo sem conectividade é: capturar as fotos dos documentos em um dispositivo móvel (usando o aplicativo de câmera, não a ferramenta de extração), enviá-las em lote quando a conectividade estiver disponível e processá-las pela ferramenta de extração nesse momento. Contas com Link de Coleta também podem receber envios de vários pontos de campo conforme a conectividade fica disponível. Para operações em ambientes consistentemente desconectados, as plataformas de campo baseadas em formulários combinadas com extração em lote no momento da sincronização é a abordagem mais confiável.
Posso processar em lote tickets de balança de vários locais de fornecedores em uma única planilha?
Sim — se você escolher uma ferramenta com extração independente de formato e suporte a processamento em lote. O ImageToTable.ai processa tipos mistos de documentos (fotos de medidores, tickets de balança, formulários de inspeção) em um único lote e mescla as saídas em uma planilha. O requisito principal é que a ferramenta leia documentos pelo significado semântico dos campos, e não pela posição no modelo — porque tickets de balança de diferentes locais de fornecedores usam layouts completamente diferentes. Para uma operação de compras que recebe tickets de 12 pátios de agregados, uma ferramenta baseada em modelos exigiria 12 modelos separados que precisariam de manutenção toda vez que uma estação de pesagem atualizasse seu software. Para um passo a passo detalhado, veja nosso guia de extração em lote de tickets de balança. O guia de automação de leitura de medidores para Excel cobre o mesmo fluxo de trabalho em lote para leitura de medidores de utilidades.
Alguma dessas ferramentas substitui uma plataforma CMMS ou FSM?
Não — e elas não foram projetadas para isso. Ferramentas de extração de documentos e plataformas de gerenciamento de serviço de campo (FSM) resolvem problemas diferentes. Plataformas FSM (ServiceMax, IFS, Salesforce Field Service, Corrigo) lidam com agendamento, despacho, gerenciamento de ordens de serviço, rastreamento de técnicos e faturamento. Ferramentas de extração de documentos lidam com o gargalo específico de obter dados de documentos de campo em papel ou fotografados para registros digitais estruturados. A arquitetura prática para a maioria das operações é: documentos de campo são capturados (por telefone ou papel) → extraídos em dados estruturados por uma ferramenta de extração de documentos → alimentados na plataforma FSM/CMMS como registros de inspeção digital ou entradas de ordem de serviço. Algumas plataformas FSM (SafetyCulture, Fulcrum) incluem coleta de dados estruturados como um recurso, mas elas capturam dados que os técnicos inserem em formulários — elas não extraem dados de documentos de papel existentes. Para uma operação de campo com um fluxo de trabalho misto (alguns formulários digitais, alguns documentos em papel), ter tanto uma plataforma de coleta de dados de campo quanto uma ferramenta de extração de documentos é frequentemente a resposta certa.
Quanto custa a extração de documentos de campo em comparação com a entrada manual de dados?
A entrada manual de dados para documentos de campo tem dois custos: o tempo que os trabalhadores de campo gastam escrevendo os dados no papel (que faz parte do trabalho deles) e o tempo administrativo gasto digitando esses dados em uma planilha ou sistema (que é adicional). Este último é o custo que a extração substitui. Para uma operação de utilidade de médio porte processando 500 formulários de inspeção de campo por mês, a entrada administrativa de dados normalmente consome 40-60 horas de tempo da equipe a $18-25/hora, ou aproximadamente $720-1.500 por mês. Nesse volume, o plano de $19-39/mês do ImageToTable.ai cobre o volume de extração (500 páginas no plano de $19). A economia líquida é de aproximadamente $700-1.400 por mês — mas apenas se a precisão da extração for alta o suficiente para que o tempo de verificação não compense a economia de mão de obra. Para operações com muita caligrafia, recomendamos testar a precisão em um conjunto de amostra dos seus documentos reais e calcular o tempo de verificação na sua taxa de precisão estimada antes de fazer uma comparação de custos.
Nota metodológica: Os números de precisão neste artigo são baseados em nossos testes de 40 imagens de documentos capturados em campo em 9 ferramentas em junho de 2026. Condições de teste: todas as ferramentas avaliadas usando sua configuração padrão de fábrica, em um smartphone Android de médio porte (Samsung Galaxy A54) e câmera traseira do iPhone 14. Condições de iluminação degradadas incluíram sombra simulada, captura em ângulo de 30 graus e baixa luz ambiente. Para Nanonets, também testamos com um modelo treinado em 15 imagens rotuladas por tipo de formulário; números de precisão sem treinamento são listados como linha de base. As faixas de precisão refletem os melhores e piores resultados em nosso conjunto de testes e excluem falhas completas de extração onde uma ferramenta não retornou dados utilizáveis para um determinado campo. Resultados individuais variarão com base na qualidade da imagem, condição do documento, legibilidade da caligrafia e layout específico do formulário. Todos os dados de preços coletados de páginas públicas de preços em junho de 2026. Para comparação, a entrada manual de dados de formulários de campo manuscritos é estimada em $18-25/hora com base em dados do Bureau of Labor Statistics para digitadores de entrada de dados (43-9021) em maio de 2025.
Veja por si mesmo: Experimente a Extração de Documentos de Campo
Envie uma foto de um documento de campo — uma lista de verificação de inspeção, um registro de obra, um ticket de balança, uma leitura de medidor — e veja o que a IA extrai em segundos. Sem necessidade de conta, sem configuração de modelo, sem dados de treinamento.
Sem necessidade de cadastro. Os arquivos são processados com segurança e excluídos após a extração.