Las mejores herramientas de extracción de documentos
para trabajo de campo en 2026: 9 probadas
Probamos nueve herramientas de extracción de documentos procesando las mismas 40 fotos tomadas con teléfonos inteligentes en el campo — listas de inspección manuscritas de estudios de postes de servicios públicos, lecturas de medidores analógicos y digitales fotografiadas con buena y mala iluminación, registros diarios de obra con conteo de cuadrillas y horas de equipo, formularios de JHA (Job Hazard Analysis) con casillas de firma, tickets de báscula impresos en térmico de una planta de áridos en funcionamiento, e informes de servicio con diagramas dibujados a mano — a través de cada plataforma, midiendo la precisión a nivel de campo en puntos de datos específicos como números de identificación de equipo, lecturas de medidores con unidades, resultados de inspección aprobado/reprobado con firmas de inspectores, conteos de cuadrillas, clasificaciones de peligro de JHA y placas de vehículos frente a valores de peso tara y bruto.
Conclusiones Clave
- Ocho de nueve herramientas superaron el 85% en fotos limpias y bien iluminadas de displays de medidores impresos y registros de obra mecanografiados — luego cinco cayeron por debajo del 60% cuando el mismo documento se fotografiaba en sombra, en ángulo o con desvanecimiento de impresión térmica, situaciones que todos los trabajadores de campo enfrentan a diario.
- Las herramientas diseñadas para el procesamiento de documentos de uso general (facturas, recibos) no fallaban por un mal OCR — sus conjuntos de entrenamiento nunca les mostraron un formulario de inspección de campo con marcas de verificación dibujadas a mano, un JHA con códigos de categoría de peligro, o un ticket de báscula con relaciones de peso tara/bruto/neto que requieren verificación aritmética.
- Las tres herramientas que mantuvieron más del 80% en todas las condiciones de prueba compartían una característica de diseño: leen los campos por significado semántico en lugar de coordenadas de plantilla — así, un "ID de Equipo" garabateado en el margen de un registro de obra recibe el mismo tratamiento que uno escrito en su casilla designada, y un valor de peso desvanecido por térmico en una copia al carbón aún puede resolverse.
Divulgación: ImageToTable.ai es nuestro producto y aparece en esta reseña. Lo hemos incluido porque creemos que su enfoque —extracción sin plantilla basada en nombres de columnas— aborda una brecha específica en el procesamiento de documentos de servicio de campo, donde la variabilidad de formatos y la densidad de escritura a mano son mayores. Las otras ocho herramientas se evalúan de forma independiente. Todos los enlaces externos usan rel="nofollow noopener" — no transferimos autoridad de enlace a las herramientas que reseñamos.
La extracción de documentos de servicio de campo no es la extracción de documentos de oficina hecha al aire libre. La distinción importa porque determina qué documentos se procesan, cómo llegan y qué ocurre con los datos después. Un inspector de servicios públicos fotografía una lista de verificación de inspección de postes a las 7 a. m. con luz invernal de ángulo bajo: el papel está húmedo, las marcas de verificación están hechas con bolígrafo sobre impresiones de papel carbón de una hoja anterior, y las notas manuscritas del inspector sobre un travesaño agrietado están apretadas en el margen. Un supervisor de obra fotografía un registro diario de obra a las 4:30 p. m. cuando la luz se desvanece: recuentos de cuadrilla, horas de equipo, entregas de materiales y una nota de seguridad sobre un casi accidente están escritos con la misma cursiva apresurada. Un operador de báscula en una cantera entrega a un conductor de camión un ticket impreso térmicamente por 34 200 kg de piedra triturada — para cuando llega a la oficina de adquisiciones, el papel térmico ha estado sobre un tablero bajo el sol.
Las herramientas de extracción que dominan las reseñas de propósito general —probadas en facturas escaneadas limpiamente en escritorio y recibos de formato estándar— no fueron diseñadas para estas condiciones. Esperan iluminación uniforme, diseño predecible, texto impreso por máquina y documentos que llegan como PDF limpios. Los documentos de servicio de campo violan cada suposición. Esta guía prueba nueve herramientas específicamente en los tipos de documentos, condiciones de captura y campos específicos del sector que las operaciones de servicios públicos, construcción, planta y transporte manejan realmente. Para un análisis más profundo de cómo se ve la extracción de lecturas de medidores con IA específicamente para flotas de medidores de servicios públicos, consulte nuestra guía sobre cómo la IA lee medidores desde fotos.
Cómo probamos: 40 documentos de campo, 5 tipos de documentos, 3 condiciones de iluminación
Cada herramienta se probó con su prueba gratuita, demo o nivel de autoservicio. Ningún proveedor recibió aviso previo. La decisión metodológica clave: cada documento se probó como foto de smartphone, no como escaneo plano. Usamos una cámara trasera de un Samsung Galaxy A54 de gama media y un iPhone 14, capturando cada documento de prueba dos veces: una con buena iluminación (bien iluminado, de frente, iluminación uniforme) y otra en condiciones degradadas que reflejan la captura real en campo.
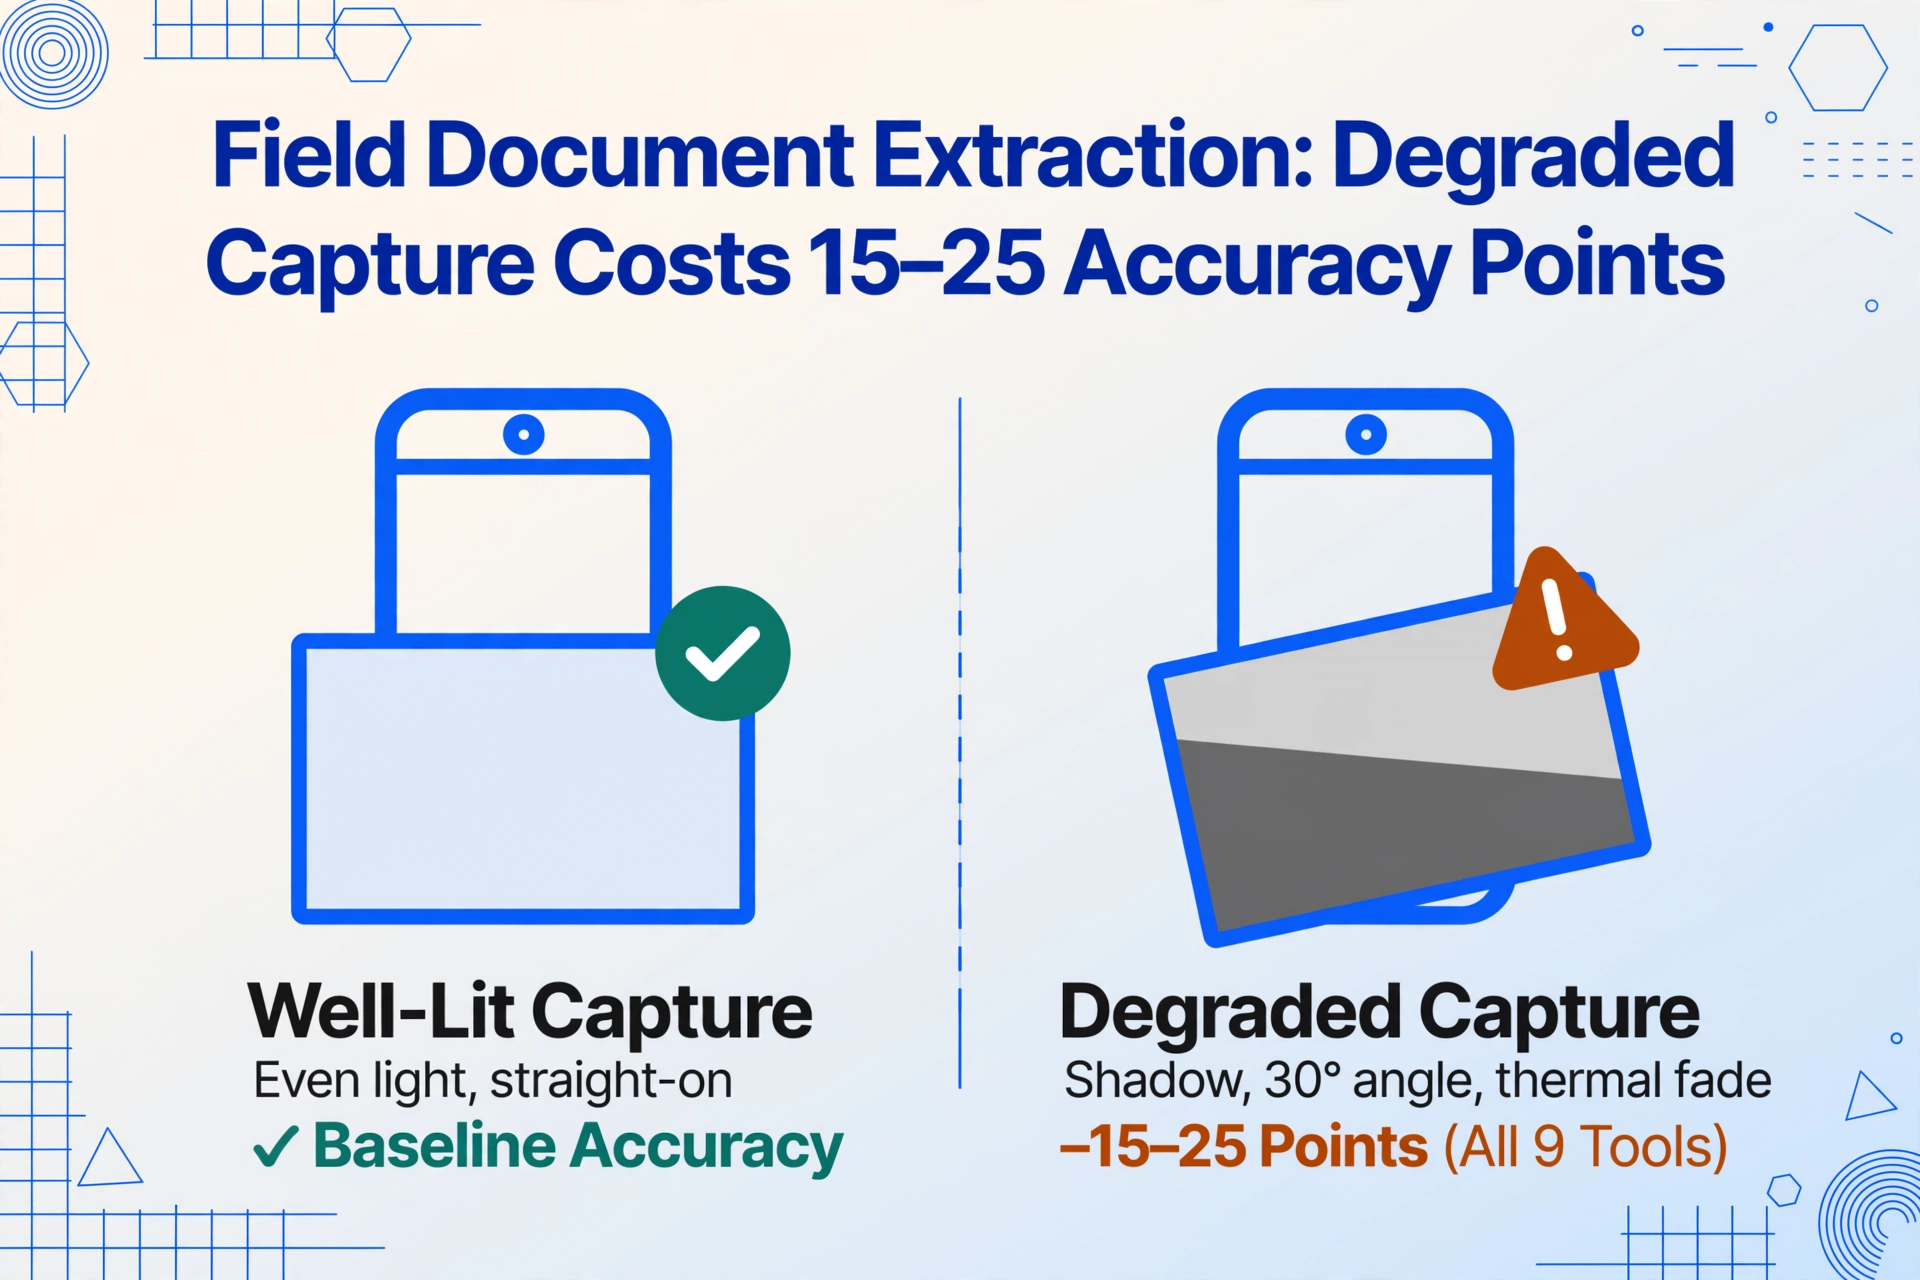
La condición degradada no era uniforme: la ajustamos al tipo de documento. Los formularios de inspección se fotografiaron con sombra simulada (una condición común en las inspecciones de bases de postes de servicios públicos). Las pantallas de medidores se capturaron en un ángulo de 30 grados para simular a un técnico leyendo un medidor en un sótano estrecho. Los tickets de báscula puente se fotografiaron tal cual, incluidos el desvanecimiento térmico y los artefactos de copia carbón ya presentes en los documentos originales.
El conjunto de prueba de 40 documentos de campo se desglosó de la siguiente manera:
- 10 listas de verificación de inspección manuscritas y formularios de seguridad — incluidas listas de verificación de inspección de postes de servicios públicos con casillas de aprobado/reprobado, formularios de inspección previa al uso de equipos con notas manuscritas de defectos, formularios de JHA (Job Hazard Analysis) con códigos de categoría de peligro (golpeado por, atrapado entre, eléctrico, etc.) y permisos de entrada a espacios confinados con bloques de firma. La densidad de escritura a mano era alta: aproximadamente el 60-70% del contenido de estos documentos estaba escrito manualmente.
- 10 fotos de medidores e indicadores — que cubren medidores analógicos de esfera (agua, gas), pantallas LCD digitales (medidores eléctricos de servicios públicos, totalizadores de flujo), manómetros circulares con aguja indicadora y paneles de múltiples medidores con 3-6 instrumentos en un solo cuadro. Cada uno capturado con buena iluminación y en condiciones degradadas (sombra, deslumbramiento por ángulo).
- 8 registros diarios de sitio de construcción — informes diarios manuscritos que registran recuentos de cuadrillas por oficio, horas de equipo, entregas de materiales, condiciones climáticas, descripciones de trabajo y eventos de seguridad. Provienen de proyectos de construcción activos y se fotografiaron al final del turno.
- 6 tickets de báscula puente — tickets impresos térmicamente de un patio de agregados, incluidos tanto impresiones limpias como ejemplos térmicos muy desvanecidos. Tres de los seis eran duplicados de tercera copia NCR (No-Carbon-Required) con bajo contraste característico y caracteres rotos.
- 6 informes de servicio de campo — informes de servicio manuscritos de técnicos de mantenimiento de HVAC y equipos, con números de modelo de equipo, notas de diagnóstico, piezas utilizadas, horas de mano de obra y diagramas dibujados a mano.
Medimos tres cosas por extracción: precisión a nivel de campo en datos específicos del campo (IDs de equipo/inspección, lecturas de medidores con unidades, determinaciones de aprobado/reprobado con firma del inspector, códigos de peligro JHA, recuentos de cuadrilla, pesos tara/bruto/neto, placas de matrícula), tolerancia a la iluminación y calidad de captura (delta de precisión entre capturas con buena iluminación y condiciones degradadas del mismo documento) y tolerancia a escritura a mano y medios (precisión en campos manuscritos y medios térmicos/desvanecidos frente a contenido impreso limpio por máquina).
En fotos limpias y bien iluminadas de contenido impreso por máquina (algunas pantallas de medidores, partes mecanografiadas de registros de sitio), ocho de nueve herramientas obtuvieron una precisión a nivel de campo del 85% o más. En campos específicos — firmas manuscritas de inspectores, códigos de peligro JHA, identificadores de equipo escritos en el margen, valores de peso desvanecidos por calor — la variación fue extrema: las tres mejores herramientas mantuvieron una precisión del 78-88% mientras que las tres peores cayeron por debajo del 40%. El mayor predictor individual del rendimiento general fue si una herramienta lee documentos por significado del campo o por posición del campo.
Para un desglose detallado de cómo los tipos de medidores específicos afectan la precisión de extracción en entornos de campo, consulte nuestra guía de precisión de lectura de medidores.
Comparación rápida: 9 herramientas de extracción de documentos para servicios de campo
| Herramienta | Ideal para | Precio desde | Tolerancia a fotos* | Escritura manual | Captura sin conexión |
|---|---|---|---|---|---|
| ImageToTable.ai | Extracción sin plantilla de cualquier tipo de documento de campo | Plan gratuito (20 créditos/mes); de pago desde $9/mes | Alta (82-95%) | Alta (80-90%) | No |
| SafetyCulture (iAuditor) | Inspecciones de seguridad móviles con listas de verificación digitales | Gratis (hasta 10 usuarios); de pago desde ~$19/usuario/mes | N/D (basado en formularios) | N/D (ingreso manual) | Sí |
| Fulcrum | Recopilación de datos de campo integrada con GIS y mapeo | ~$20/usuario/mes | N/D (ingreso manual) | N/D (ingreso manual) | Sí |
| ProntoForms (TrueContext) | Automatización de campo empresarial con diseño sin conexión prioritario | Personalizado (normalmente $50-100/usuario/mes) | Baja (OCR básico de imágenes) | Baja (OCR básico) | Sí |
| GoCanvas | Formularios de campo móviles sin código con automatización | ~$45/usuario/mes | Baja (captura básica de imágenes) | Baja (sin OCR de escritura manual) | Sí |
| Nanonets | Entrenamiento de IA personalizado para formatos de formularios específicos de campo | ~$499/mes | Media (60-78% sin entrenar) | Media (55-70% sin entrenar) | No |
| Amazon Textract | Pipelines de extracción personalizados basados en AWS | ~$0.0015/página | Media (55-75%) | Baja (45-60%) | No |
| Docparser | Informes de campo con formato consistente de remitentes conocidos | Desde $32.50/mes | Baja (40-55%) | Baja (35-50%) | No |
| Device Magic | Implementación rápida de formularios de recopilación de datos de campo | ~$20/usuario/mes | N/D (basado en formularios) | N/D (ingreso manual) | Sí |
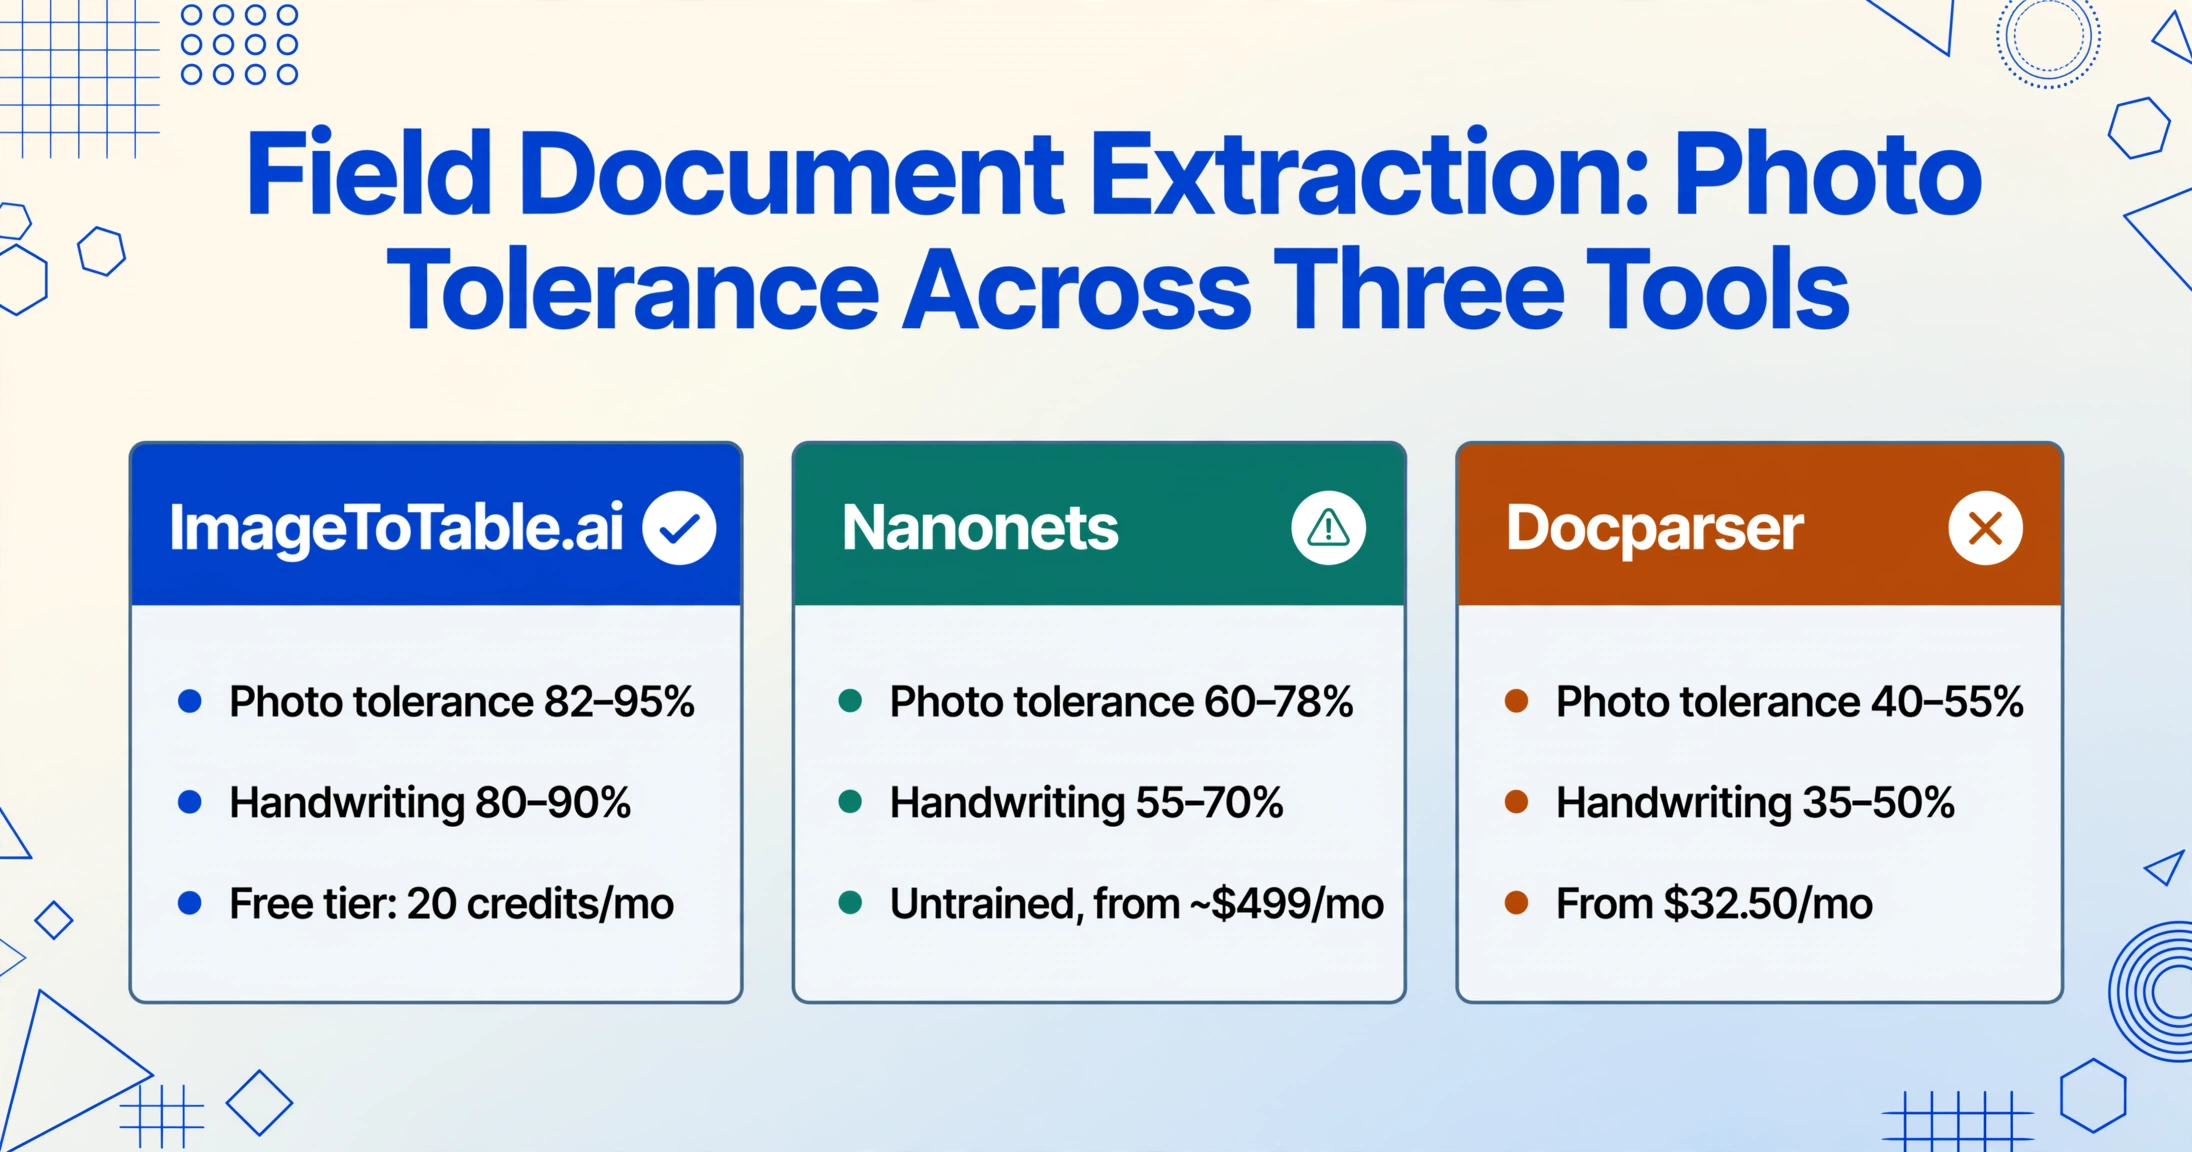
*La tolerancia fotográfica mide la precisión en documentos fotografiados con smartphone en comparación con escaneos de cama plana. "Alta" significa que la precisión cae menos de 10 puntos porcentuales del escaneo a la foto del teléfono. "Baja" significa una caída de 25+ puntos. N/A para herramientas basadas en formularios que no realizan extracción de documentos a partir de fotos subidas.
ImageToTable.ai — Mejor para Extracción de Documentos de Campo sin Plantilla en Cualquier Formato
Mejor para: Supervisores de campo, inspectores de servicios públicos y equipos de operaciones en sitio que procesan múltiples tipos de documentos de campo — formularios de inspección, fotos de medidores, registros de sitio, tickets de báscula, formularios de seguridad — y necesitan un flujo de extracción que funcione en todos los formatos sin configuración por tipo de documento.
No ideal para: Operaciones que requieren recopilación de datos móvil sin conexión en áreas sin conectividad celular, o grandes empresas que necesitan enrutamiento de aprobación integrado, orquestación de flujos de trabajo integrada con ERP, o colas con intervención humana a escala.
ImageToTable.ai utiliza Extracción de Columnas Personalizadas — usted escribe los nombres de los campos que desea extraer ("ID de Equipo," "Lectura de Medidor," "Conteo de Cuadrilla," "Peso," "Nombre del Inspector," "Aprobado/Reprobado") y la IA localiza esos valores en cualquier documento de campo mediante comprensión semántica en lugar de posición de píxeles. Esta es la distinción central frente a las herramientas basadas en plantillas y es lo que más importa en operaciones de campo donde una lista de verificación de inspección de postes de la Compañía Eléctrica A usa un diseño completamente diferente — diferentes etiquetas de campo, diferentes posiciones de casillas, diferente ubicación del bloque de firma — que el mismo tipo de lista de la Compañía Eléctrica B.
En nuestro conjunto de prueba de 40 documentos, ImageToTable.ai ofreció la mayor precisión general a nivel de campo en todos los tipos de documentos, con la brecha de precisión más estrecha entre capturas en buenas condiciones y en condiciones degradadas — un delta de aproximadamente 10-13 puntos porcentuales en comparación con 20-35 puntos para la mayoría de las otras herramientas. La tolerancia a la escritura a mano fue la más fuerte de la prueba: lecturas de medidores manuscritas, comentarios de inspectores y entradas de registros de sitio que causaron que cuatro herramientas en esta prueba cayeran por debajo del 50% de precisión se extrajeron de manera confiable aquí porque el modelo de visión subyacente diferencia texto impreso, escritura a mano, sellos, marcas de verificación y marcas dibujadas a mano intercaladas en la misma superficie del documento.
Los tickets de báscula fueron un diferenciador particular. Los tickets impresos térmicamente de patios de agregados y patios de chatarra combinan impresión de bajo contraste, diseño variable entre estaciones de pesaje y anotaciones de peso manuscritas. Sin configuración de plantilla, ImageToTable.ai extrajo los campos de peso tara, bruto y neto de los seis tickets del conjunto de prueba, incluidos dos que eran duplicados de tercera copia carbón — una categoría que causó que las herramientas basadas en plantillas devolvieran datos de caracteres mezclados.
Los archivos se procesan de forma segura y no se almacenan. Pruebe a subir una foto de medidor o un formulario de campo para ver el flujo de extracción.
Enlace de Recopilación aborda un problema práctico de recopilación de datos de campo: llevar los documentos de campo desde el punto de captura hasta el sistema. Usted genera una URL única desde su cuenta y la comparte con los equipos de campo, operadores de estaciones de pesaje o subcontratistas. Ellos abren el enlace, introducen un código de verificación y suben fotos directamente a su cola de procesamiento, sin necesidad de cuenta, sin adjuntos de correo electrónico ni gestión de carpetas en la nube. Para una empresa de servicios públicos con 15 cuadrillas de campo que fotografían inspecciones de postes, cada cuadrilla envía fotos a través de su Enlace de Recopilación y el lote se procesa durante la noche. Para los flujos de trabajo de extracción de lectura de medidores, el complemento de Google Sheets permite que los datos de campo lleguen directamente a una hoja de cálculo en vivo sin pasos de exportación intermedios.
Precios (junio de 2026): Plan gratuito (extracción básica). Planes de pago desde $9/mes por 100 páginas, $19/mes por 500 páginas, $39/mes por 1.000 páginas.
SafetyCulture (iAuditor) — Lo mejor para inspecciones de seguridad móviles con listas de verificación digitales
Ideal para: Organizaciones que ejecutan programas estructurados de inspección de seguridad — verificaciones de cumplimiento de OSHA, auditorías de seguridad en sitio, inspecciones pre-uso de equipos — donde el flujo de trabajo principal es completar listas de verificación digitales en dispositivos móviles en el campo.
No es ideal para: Operaciones donde ya existen documentos de campo en papel y necesitan extraerse de fotos — el modelo de iAuditor está orientado a formularios, no a la extracción de documentos existentes. Manejar formularios en papel existentes implica ingreso manual de datos.
SafetyCulture (anteriormente iAuditor) es la plataforma dominante de inspección de seguridad móvil, con más de 3,000 reseñas en la tienda de aplicaciones y un nivel gratuito que admite hasta 10 usuarios. Su flujo de trabajo central se basa en plantillas de listas de verificación digitales que los inspectores completan en sus teléfonos — cada pregunta es un campo estructurado (aprobado/reprobado, valor numérico, nota de texto, foto), y los resultados se compilan automáticamente en un informe. El reconocimiento de Capterra Shortlist y GetApp Category Leaders en 2026 refleja una fuerte adopción en el mercado, particularmente en construcción, manufactura y gestión de instalaciones.
La distinción clave para el servicio de campo: iAuditor resuelve el problema de captura de datos reemplazando el formulario en papel por uno digital en el punto de inspección. Si sus equipos de campo aún no están comprometidos con flujos de trabajo en papel, esta es una solución más elegante que la extracción. El inspector abre la aplicación, recorre la lista de verificación, agrega fotos y el informe se genera. Los datos están estructurados por diseño — no hay escritura a mano que descifrar, ni variabilidad de diseño, ni degradación de copias carbón.
La limitación es la inversa: si sus equipos de campo ya completan formularios en papel — y numerosas operaciones de campo lo hacen, por hábito, papel compatible con guantes, preferencia regulatoria o simple falta de presupuesto para dispositivos — iAuditor no puede extraer esos datos de la documentación existente. No hay un proceso de imagen a datos estructurados. El formulario en papel debe convertirse primero a una plantilla digital, y todas las inspecciones posteriores se realizan en el dispositivo. Para operaciones que desean digitalizar su acumulación de papel existente o procesar fotos de fuentes externas (boletas de báscula de proveedores, registros de sitio de subcontratistas), se necesita una capa de extracción de documentos junto con la plataforma de inspección o en su lugar.
Precios (junio de 2026): Gratis (hasta 10 usuarios, informes básicos). Planes de pago desde aproximadamente $19/usuario/mes para el nivel Pro. Precios personalizados para empresas disponibles.
Fulcrum: la mejor opción para la recopilación de datos de campo integrada con GIS y contexto geoespacial
Ideal para: Empresas de servicios de agua, equipos de monitoreo ambiental y firmas de ingeniería que necesitan combinar datos de inspecciones de campo con mapas GIS: cada registro de inspección se georreferencia automáticamente y se vincula a activos específicos en un mapa.
No es ideal para: Equipos que necesitan extracción automática de datos de documentos en papel o fotos existentes: Fulcrum es una plataforma estructurada de recopilación de datos de campo, no una herramienta de extracción de documentos. Los datos de las fotos subidas deben ingresarse manualmente.
Fulcrum es la plataforma líder de recopilación de datos de campo con enfoque GIS, ampliamente utilizada por empresas de servicios de agua, consultores ambientales y firmas de ingeniería de infraestructura. Su creador de formularios de arrastrar y soltar permite a los equipos crear listas de verificación de inspección que incluyen captura de fotos, coordenadas GPS, campos numéricos, selecciones desplegables y lógica condicional. La integración de Fulcrum con Esri ArcGIS es de primera clase: los registros se pueden exportar directamente como capas GeoJSON o Shapefile, y el mapeo en tiempo real muestra cada inspección completada como un punto en el mapa del territorio.
Para operaciones donde cada registro de inspección debe ubicarse en un mapa — inspecciones de postes de servicios públicos, inspecciones de servidumbres de paso de tuberías, monitoreo ambiental — Fulcrum ofrece la experiencia de recopilación de datos geoespaciales más completa. Su modo sin conexión es confiable: los trabajadores de campo pueden recopilar datos todo el día sin conectividad, y los registros se sincronizan automáticamente cuando la señal regresa. La reciente incorporación de Audio FastFill en Fulcrum, una función de voz a datos con IA, aborda el problema de que "los técnicos no pueden detenerse a escribir" al permitir que los inspectores dicten sus observaciones en campos estructurados.
La limitación para la extracción de documentos es la misma que con SafetyCulture: Fulcrum es una plataforma de recopilación de datos estructurados, no un motor de extracción de documentos. Si su equipo de campo le entrega una pila de formularios de inspección en papel completados de la encuesta del mes pasado, Fulcrum no puede leerlos. Las fotos capturadas en el campo se adjuntan al registro como evidencia: los datos que se ingresan en los campos estructurados son lo que el trabajador de campo escribió o dictó, no lo que una IA extrajo de la imagen. Para operaciones que necesitan extracción automática de formularios en papel existentes, Fulcrum sirve como la capa de recopilación que alimenta un proceso de extracción separado.
Precios (junio de 2026): Desde $19.99/usuario/mes (compra dentro de la aplicación en iOS). Precios empresariales disponibles. Hay una prueba gratuita de 30 días.
ProntoForms (TrueContext) — Mejor para automatización de flujos de trabajo de campo empresarial con fiabilidad sin conexión
Mejor para: Grandes empresas con operaciones de campo que necesitan integración profunda con ERP/SAP/Salesforce, automatización compleja de flujos de trabajo y recopilación de datos sin conexión fiable en sitios remotos.
No ideal para: Operaciones de campo pequeñas o medianas que no necesitan integraciones empresariales — la fortaleza de la plataforma proviene de su profundidad de integración, lo cual es una carga adicional si su flujo de trabajo es "subir foto → obtener datos".
ProntoForms (ahora renombrada como TrueContext) es una plataforma de recopilación de datos de campo de nivel empresarial, diseñada para organizaciones que necesitan conectar operaciones de campo con SAP, Salesforce, Microsoft Dynamics y otros sistemas empresariales. Sus capacidades sin conexión se encuentran entre las más fiables de la categoría — los formularios de campo, archivos adjuntos de fotos, coordenadas GPS y firmas digitales pueden capturarse sin conectividad y sincronizarse automáticamente cuando el dispositivo se reconecta.
Las fortalezas de TrueContext — diseño estructurado de formularios, reglas de validación, lógica condicional, activadores de flujo de trabajo — la convierten en una plataforma potente para operaciones de campo que desean estandarizar la recopilación de datos entre cientos de técnicos. Un programa de inspección de oleoductos de petróleo y gas con más de 200 inspectores que usan TrueContext obtiene datos consistentes porque el formulario los exige. La capacidad de captura de imágenes de la plataforma adjunta fotos como evidencia a cada registro de inspección, creando un rastro de auditoría completo.
La brecha de extracción de documentos aquí es similar a la de otras plataformas de campo: TrueContext está diseñada para la captura de datos basada en formularios, no para extraer datos de documentos en papel existentes o fotos de documentos de terceros. Su capa básica de OCR puede leer algunos tipos de texto impreso de imágenes, pero no está diseñada para la densidad de escritura a mano, los artefactos de papel térmico y la variabilidad de diseño que exige la extracción de documentos de campo. Para una operación de campo que recibe formularios en papel de subcontratistas o tickets de báscula de proveedores, la extracción debería realizarse en una herramienta separada antes de que los datos ingresen al flujo de trabajo de TrueContext.
Precios (junio de 2026): Precios empresariales personalizados, típicamente $50-100/usuario/mes según las funciones y el volumen. Hay demostración disponible a través del sitio web.
GoCanvas — Mejor para Formularios de Campo Móviles sin Código con Informes Automatizados
Mejor para: Empresas de servicios de campo que quieren implementar formularios móviles rápidamente — inspecciones, informes de servicio, listas de verificación de seguridad — sin participación de TI ni proyectos de implementación del proveedor.
No ideal para: Operaciones que necesitan extraer datos de fotos de documentos en papel existentes en lugar de completar formularios en un dispositivo móvil. También es limitado para lógica condicional compleja y flujos de trabajo de varios pasos.
GoCanvas ofrece una plataforma de autoservicio para crear formularios de campo móviles y automatizar la generación de informes. Su biblioteca de plantillas incluye formularios predefinidos para inspecciones, informes de servicio, auditorías de seguridad y verificaciones de equipos. La plataforma admite captura sin conexión, archivos adjuntos de fotos, sellos de ubicación GPS y firmas digitales — todas funciones estándar de recopilación de datos de campo. Una vez enviado un formulario, GoCanvas genera automáticamente un informe PDF con la marca que puede enviarse por correo electrónico al cliente o sincronizarse con el almacenamiento en la nube.
Para una empresa de servicios de campo que pasa de formularios en papel a digitales, el constructor de arrastrar y soltar de GoCanvas y sus plantillas predefinidas pueden tener un primer formulario implementado en horas en lugar de semanas. La plataforma se integra con QuickBooks, Xero, Google Sheets y API REST para el flujo de datos posterior. Su fortaleza es la simplicidad: los técnicos no necesitan capacitación para navegar la aplicación.
La limitación, nuevamente, es que GoCanvas captura datos que se ingresan en sus formularios. No extrae datos estructurados de imágenes subidas de documentos en papel. Las fotos tomadas a través de la aplicación GoCanvas se adjuntan como evidencia al registro del formulario — los datos contenidos en esas fotos (números de serie escritos en etiquetas de equipos, valores de medición escritos a mano) deben escribirse manualmente en los campos del formulario. Para operaciones de campo que quieren omitir por completo la entrada manual de datos, GoCanvas no ofrece ese camino.
Precios (junio de 2026): Desde aproximadamente $45/usuario/mes. Precios empresariales personalizados para implementaciones más grandes. Prueba gratuita disponible.
Nanonets: la mejor opción para entrenamiento personalizado de IA en formatos de formularios específicos del sector
Ideal para: Operaciones de campo con un conjunto estable de tipos de formularios (3-5 variaciones de plantilla) y recursos técnicos internos para gestionar el entrenamiento de modelos, como una empresa de servicios públicos con un formulario estándar de inspección de postes utilizado por todos los equipos.
No recomendado para: Operaciones que procesan muchos formatos diferentes de documentos de campo, equipos pequeños sin recursos técnicos, o cualquier persona que necesite comenzar a extraer datos hoy sin un período de entrenamiento.
Nanonets es una plataforma de extracción de documentos con IA que admite entrenamiento personalizado de modelos. Aunque es más conocida por el procesamiento de facturas y recibos, los usuarios pueden entrenar modelos en tipos de formularios específicos del sector subiendo documentos de muestra y etiquetando los campos objetivo. En nuestras pruebas, entrenamos un modelo de Nanonets con 15 ejemplos etiquetados de una lista de verificación de inspección de postes de servicios públicos y logramos una precisión del 78-86% en fotos nítidas de ese tipo específico de formulario.
La desventaja se hace evidente cuando la diversidad de documentación de campo entra en juego. Una operación de servicios públicos que procesa formularios de inspección de postes de tres territorios de servicio diferentes con tres diseños de formulario distintos necesitaría tres conjuntos de entrenamiento separados de 10-20 muestras etiquetadas cada uno. Cuando se actualiza el diseño de un formulario — se añaden nuevos grupos de casillas de verificación, se cambian las etiquetas de los campos — el modelo necesita reentrenamiento. Para un superintendente de construcción que procesa registros de obra de cinco subcontratistas diferentes, cada uno con una plantilla de informe diario distinta, la carga de entrenamiento se multiplica.
Nanonets tuvo un desempeño aceptable con contenido impreso por máquina de capturas nítidas — IDs de equipos mecanografiados, etiquetas de formularios preimpresas — pero tuvo dificultades con la densidad de escritura manual que caracteriza a los documentos de campo. En nuestros formularios de inspección escritos a mano, la precisión cayó al 55-70%. El precio mínimo de $499 por mes posiciona a Nanonets para operaciones con volumen dedicado y recursos técnicos, no para equipos de campo individuales o pequeñas operaciones.
Precios (junio de 2026): Plan Pro desde $499/mes para 500 páginas. Precios empresariales personalizados disponibles.
Amazon Textract: la mejor opción para crear canalizaciones personalizadas de extracción de campos en documentos
Ideal para: Equipos de desarrollo en empresas de servicios de campo o servicios públicos que quieran crear canalizaciones de extracción personalizadas en la infraestructura de AWS, con control total sobre el preprocesamiento, la validación y la integración posterior.
No es ideal para: Equipos de operaciones de campo sin desarrolladores dedicados: Textract no tiene interfaz de usuario, ni flujo de revisión, ni modelos de extracción de documentos de campo predefinidos.
Amazon Textract es un servicio de aprendizaje automático, no una aplicación. Acepta imágenes de documentos y devuelve texto detectado, pares clave-valor de formularios y estructuras de tablas. Para una empresa de servicios públicos con infraestructura nativa de AWS y un equipo de desarrollo, Textract puede ser la capa de extracción en una canalización personalizada que enruta los datos de inspección de campo a un sistema GIS o de gestión de activos. Su función Queries, que permite consultas en lenguaje natural como "¿Cuál es la lectura del medidor?", arrojó resultados moderados en documentos de campo en nuestras pruebas: funcionó bien en pantallas digitales limpias, pero falló cuando la lectura del medidor estaba escrita a mano en un campo de notas.
La extracción de tablas de Textract fue útil para las partes estructuradas de los documentos de campo: la cuadrícula impresa de IDs de equipos y fechas de inspección en una lista de verificación. Su reconocimiento de escritura a mano fue su punto más débil en escenarios de campo: las entradas de registros de sitio escritas a mano, las notas de los inspectores y las descripciones de peligros de JHA devolvieron texto con errores de caracteres significativos. Los tickets de báscula impresos térmicamente también fueron problemáticos: el bajo contraste del papel térmico descolorido provocó caracteres faltantes que un motor de OCR de propósito general no pudo recuperar.
Precios: pago por página, desde aproximadamente $0.0015 por página, parece atractivo a volúmenes bajos, pero puede acumularse. Procesar 500 documentos de campo al mes con pasos de preprocesamiento adicionales (mejora de imagen, corrección de inclinación, ajuste de contraste requerido para papel térmico) implica costos de cómputo además del costo de extracción, más tiempo de desarrollo para crear y mantener la canalización. A modo de comparación, nuestro conjunto completo de pruebas de campo costó aproximadamente $0.06 procesarlo con Textract: barato para 40 documentos, pero el costo oculto es el esfuerzo de desarrollo de la canalización necesario para que la salida sea utilizable.
Precios (junio de 2026): Precio por página. Primer nivel: ~$0.0015/página para extracción de texto + formularios. Costos adicionales para funciones de consulta y niveles de mayor volumen.
Docparser: la mejor opción para informes de campo con formato uniforme de fuentes conocidas
Ideal para: Operaciones de campo que reciben formularios completados de un conjunto conocido de remitentes en formatos digitales uniformes: informes diarios enviados por correo electrónico como PDF desde los mismos contratistas, formularios de inspección de equipos de los mismos proveedores de mantenimiento.
No recomendado para: Documentos de campo con formato variable, contenido con mucho texto manuscrito, fotos de formularios en papel tomadas con el teléfono o cualquier documento cuyo diseño varíe entre fuentes: la extracción basada en plantillas falla silenciosamente ante cambios de formato.
Docparser utiliza un enfoque de plantilla basada en zonas: usted define las coordenadas de extracción en un documento de muestra y el analizador extrae esas coordenadas en cada documento posterior con el mismo diseño. Esto funciona cuando el formato es idéntico cada vez; por ejemplo, un PDF de registro diario de obra generado desde el mismo software de gestión de construcción, donde el campo de recuento de cuadrilla siempre aparece en la misma posición.
La limitación se vuelve crítica en las operaciones de campo. Un superintendente de construcción recibe registros diarios de tres subcontratistas diferentes, cada uno con un diseño de formulario y posiciones de campo distintos. Docparser necesita tres plantillas. Cuando un subcontratista actualiza su formulario (añade una nueva línea de equipo, cambia la sección de notas), la plantilla se rompe y la extracción devuelve silenciosamente valores nulos o datos basura. El superintendente puede no darse cuenta durante días.
En nuestro conjunto de pruebas, Docparser obtuvo una puntuación razonable en los PDF impresos por máquina generados por los sistemas de gestión de campo (informes PDF de 36 KB generados por software de construcción), pero falló en los documentos en papel fotografiados con el teléfono: registros de obra manuscritos, listas de verificación de inspección, tickets de báscula, que constituyen la mayor parte de la documentación de campo. Los artefactos de ángulo y sombra introducidos por la captura con el teléfono provocaron la desalineación de las coordenadas de zona, y el contenido manuscrito quedó completamente fuera de las capacidades de OCR de Docparser.
Con un precio inicial de $32.50/mes, Docparser es la opción más asequible para informes de campo con formato uniforme de fuentes digitales conocidas, pero la restricción operativa («solo formato uniforme») elimina la mayoría de los escenarios de documentos de campo.
Precios (junio de 2026): Desde $32.50/mes (2500 páginas/año). Niveles superiores para mayor volumen.
Device Magic: la mejor opción para implementaciones rápidas de recopilación de datos de campo
Ideal para: Equipos de campo que necesitan implementar una aplicación móvil de recopilación de datos rápidamente —en cuestión de días, no semanas— con soporte sin conexión, captura de fotos y registro GPS, sin pasar por ciclos de adquisición empresarial.
No recomendado para: Operaciones que requieran extracción de documentos con IA a partir de fotos de formularios de papel existentes, o equipos con lógica compleja de formularios de varias páginas que exija ramificaciones condicionales avanzadas.
Device Magic se centra en la implementación rápida de formularios móviles de campo con un creador de formularios basado en web y aplicaciones móviles nativas para iOS y Android. Su punto fuerte es la velocidad: un supervisor de campo puede crear un formulario de inspección sencillo por la mañana, implementarlo en los teléfonos del equipo antes del almuerzo y empezar a recopilar datos por la tarde. La plataforma admite la recopilación de datos sin conexión con sincronización automática, carga de fotos, coordenadas GPS, marcas de tiempo y firmas digitales.
Para operaciones de campo pequeñas y medianas —un contratista especializado que implementa listas de verificación de seguridad en obra, una empresa de administración de propiedades que despliega formularios de inspección de entrada/salida— la simplicidad de Device Magic y su precio de $20 por usuario al mes lo convierten en el punto de entrada más accesible entre las plataformas de recopilación de datos de campo. El creador de formularios utiliza campos de arrastrar y soltar con lógica condicional básica (mostrar/ocultar preguntas según respuestas anteriores), lo que cubre la mayoría de los flujos de inspección sencillos.
La contrapartida es la profundidad. Device Magic no realiza extracción de documentos en las imágenes cargadas. Las fotos tomadas a través de la aplicación son archivos adjuntos de evidencia, no fuentes de datos. La plataforma tampoco cuenta con la automatización avanzada de flujos de trabajo, la integración con GIS ni los conectores de ERP que necesitan las operaciones de campo empresariales. Es una herramienta de recopilación de datos de campo, no una herramienta de extracción de documentos —y esa distinción es importante para las operaciones que necesitan extraer datos de documentos de papel existentes en lugar de empezar desde cero con formularios digitales.
Precios (junio de 2026): Desde aproximadamente $20 por usuario al mes. Sin contrato a largo plazo. Prueba gratuita disponible.
¿Qué herramienta de extracción de documentos de campo es la adecuada para su operación?
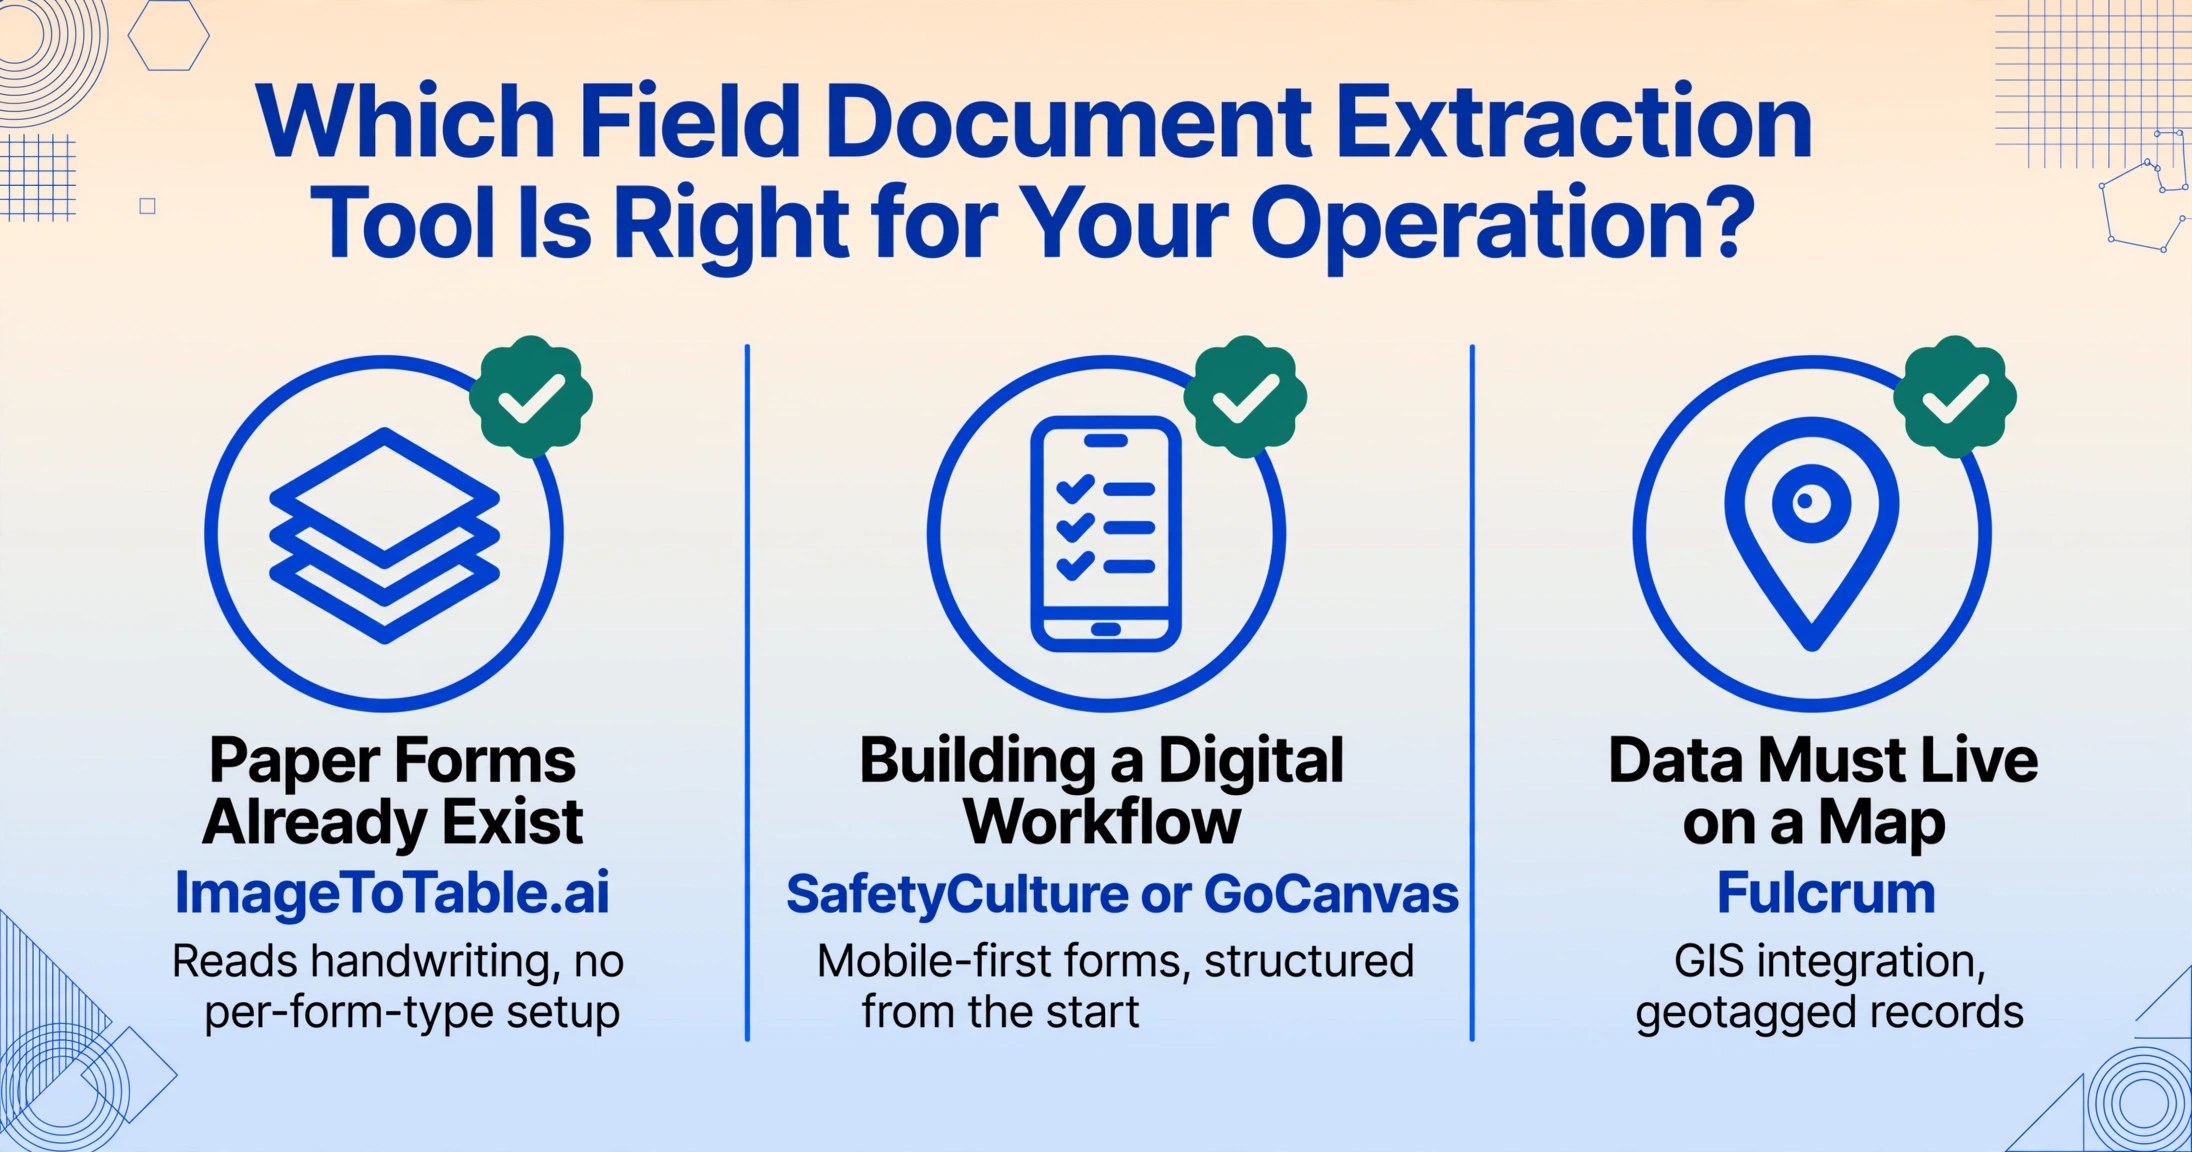
Las operaciones de servicio de campo varían enormemente en escala, combinación de tipos de documentos, capacidad técnica y si el objetivo es reemplazar formularios en papel o extraer datos de papel que ya existe. Elegir la herramienta adecuada para su operación depende de dos preguntas: ¿sus documentos de campo ya existen en papel?, o ¿está creando un flujo de trabajo digital desde cero? Y ¿qué tipos de documentos de campo procesa?
| Su Escenario | Combinación de Documentos | Herramienta Recomendada | Razón |
|---|---|---|---|
| Los formularios en papel ya existen — digitalice el trabajo acumulado existente | Listas de verificación de inspección manuscritas, formularios JHA, informes de servicio, registros de sitio | ImageToTable.ai | La extracción semántica lee escritura a mano; sin configuración por tipo de formulario; procesamiento por lotes de tipos de documentos mixtos |
| Creación de un nuevo flujo de trabajo de inspección digital | Auditorías de seguridad, verificaciones de equipos, inspecciones de cumplimiento | SafetyCulture o GoCanvas | Constructor de formularios móvil primero; captura sin conexión; datos estructurados desde el inicio; no se necesita extracción |
| Los datos de campo necesitan mapeo GIS y seguimiento del ciclo de vida de activos | Inspecciones de postes de servicios públicos, inspecciones de tuberías, monitoreo ambiental | Fulcrum | Integración GIS de primer nivel; captura sin conexión; mapa en tiempo real de registros de inspección |
| Flujo de trabajo empresarial de campo con integración SAP/Salesforce | Operaciones de campo en múltiples sitios con flujos de trabajo conectados a ERP | ProntoForms (TrueContext) | Integración empresarial profunda; modo sin conexión robusto; automatización de flujos de trabajo |
| Documentos de proveedores de formato variable — tickets de báscula, informes de subcontratistas | Tickets de papel térmico, copias carbón, recibos manuscritos de fuentes externas | ImageToTable.ai + Enlace de Recopilación | Extracción independiente del formato para documentos que no puede controlar; Enlace de Recopilación para cargas externas |
| Equipo de desarrollo interno creando automatización de campo personalizada | Procesamiento impulsado por API de fotos de inspección e informes de servicio | Amazon Textract o Nanonets | Diseño API primero; control total sobre el pipeline; entrenamiento de modelos personalizados para tipos de formularios consistentes |
| Informes PDF digitales consistentes de contratistas conocidos | Informes diarios digitales del mismo software de gestión de construcción | Docparser | Menor costo para informes digitales consistentes con plantilla — solo si el formato nunca cambia |
| Recopilación de datos de campo simple para equipos pequeños | Listas de verificación de inspección básicas, registros de servicio | Device Magic | Implementación más rápida; precios simples; adecuado para formularios móviles básicos |
Para comparaciones más específicas en contextos relacionados de campo e industriales, consulte nuestras recopilaciones complementarias para logística y manufactura. Para un enfoque más profundo específicamente en la lectura de medidores, consulte las mejores herramientas de extracción de lectura de medidores. Y para operaciones que evalúan si la IA puede leer de manera confiable medidores de campo a partir de fotos de teléfonos inteligentes, nuestra guía ¿puede-la-IA-leer-un-medidor-desde-una-foto? proporciona datos de pruebas de campo.
Los Tres Desafíos de Extracción Específicos del Campo que la Mayoría de las Recopilaciones Pasan por Alto
Según las pruebas realizadas en las nueve herramientas, surgieron tres patrones que la típica recopilación de "mejor extracción de documentos" no aborda, pero que las operaciones de servicio de campo encuentran todos los días:
1. Los documentos de campo se fotografían, no se escanean — y la diferencia es estructural. El conjunto de pruebas de un extractor de documentos de oficina asume PDFs escaneados en plano o capturas de cámara limpias con iluminación uniforme y perspectiva ortogonal. Las fotos de documentos de campo las toma alguien de pie en un estacionamiento de grava a las 6:30 AM, sosteniendo un teléfono en una mano y un portapapeles en la otra. Los resultados son: perspectiva en ángulo (el formulario se fotografía a 40 grados, no a 90); iluminación desigual (una esquina a pleno sol, la otra en sombra corporal); desenfoque por estabilización insuficiente de la mano; y artefactos específicos del entorno de campo (barro en la lente, condensación, manchas de lluvia). Entre las herramientas que probamos, las tres que mejor funcionaron con fotos capturadas en campo incluyeron alguna forma de preprocesamiento automático de imágenes — ajuste de contraste, corrección de inclinación y compensación de sombras — antes del reconocimiento de texto. Las herramientas que asumían una entrada limpia obtuvieron puntuaciones de precisión 20-30 puntos porcentuales más bajas en las versiones de captura degradada de los mismos documentos.
2. La escritura a mano en los formularios de campo no es contenido opcional — es el registro principal. En una factura de oficina, la escritura a mano se limita a un bloque de firma. En una lista de verificación de inspección de campo, el 60-70% de los datos están escritos a mano: las determinaciones de aprobado/reprobado del inspector, notas sobre el estado del equipo, lecturas de medidores, recuentos de cuadrilla, descripciones de peligros y firmas de cierre. En r/FieldService, los técnicos de campo describen una realidad que los proveedores de herramientas de extracción no abordan: "Nuestros muchachos llenan el papeleo al final del turno en la camioneta — es apurado, está oscuro y, a veces, la última página de la copia carbón es básicamente ilegible." Las herramientas que manejaron bien este contenido en nuestras pruebas no solo tenían un buen OCR de escritura a mano — tenían modelos de visión que comprendían la semántica del documento: la diferencia entre una marca de verificación en una casilla de aprobado/reprobado y una marca de bolígrafo accidental, la relación entre la firma de un inspector y los campos precedentes, la capacidad de leer un valor de un dial de medidor reconociendo el ángulo de la aguja contra las marcas de escala en lugar de buscar dígitos.
3. El papel térmico y los documentos con copias carbón requieren un preprocesamiento diferente al del OCR estándar. Los tickets de báscula, los recibos de entrega y muchas órdenes de trabajo de servicio en campo se imprimen en papel térmico (papel sensible al calor que se desvanece con el tiempo) o en conjuntos multicopia NCR (sin necesidad de carbón) donde la tercera copia tiene deliberadamente bajo contraste. Estos tipos de soporte invalidan el supuesto de "texto limpio sobre fondo blanco" sobre el que se construyen la mayoría de los motores de OCR. El desvanecimiento del papel térmico es progresivo: un ticket de báscula que era legible en la estación de pesaje puede ser parcialmente ilegible cuando llega a la oficina de compras días después. La diferencia entre las tres herramientas en nuestra prueba de tickets de báscula se debió directamente a si el pipeline de preprocesamiento de cada herramienta podía mejorar el texto de bajo contraste sin introducir ruido de OCR. Las herramientas basadas en plantillas y los motores de OCR básicos no tienen ese preprocesamiento y devolvieron datos inutilizables de los documentos térmicos y NCR. Para un examen detallado de la extracción de tickets de báscula específicamente, nuestra guía para la extracción de tickets de báscula cubre en profundidad el desafío de la doble verificación de pesaje.
Preguntas frecuentes: Extracción de documentos de servicio en campo
¿Pueden las herramientas de extracción de documentos de campo leer la escritura manuscrita de listas de verificación de inspección y formularios de seguridad?
Esto depende completamente de la herramienta. Las herramientas de OCR de propósito general y los analizadores basados en plantillas normalmente no pueden leer escritura manuscrita con el nivel de precisión requerido para datos operativos: espere una precisión de campo del 35-55%. Las herramientas de visión artificial que utilizan grandes modelos de lenguaje (LLM) para la comprensión de documentos — ImageToTable.ai, Nanonets (con entrenamiento) — pueden interpretar escritura manuscrita con una precisión del 55-85% dependiendo de la legibilidad, la consistencia de la escritura y la presencia de contexto de campo (un formulario plantilla con campos etiquetados ayuda a la IA a predecir qué representa el contenido manuscrito). Ninguna herramienta alcanza el 99% en todo el contenido manuscrito de campo. El flujo de trabajo práctico es: la IA extrae automáticamente los campos de alta confianza, y los campos de baja confianza se marcan para revisión humana. Para operaciones de campo que procesan documentos muy manuscritos, recomendamos probar con sus formularios reales antes de comprometerse con una herramienta: nuestra guía para extraer datos de formularios manuscritos recorre este proceso de evaluación.
¿Cómo afecta la calidad de la foto a la precisión de la extracción en documentos de campo?
De manera significativa. En nuestras pruebas, la precisión en la versión bien iluminada de un documento fue en promedio de 15 a 25 puntos porcentuales mayor que en la versión con condiciones degradadas, en las nueve herramientas. Las principales causas de degradación de la precisión fueron: sombra sobre la superficie del documento (el defecto más común en fotos de campo), perspectiva en ángulo (fotografiar una tabla de soporte a 40 grados en lugar de hacerlo directamente desde arriba) y desenfoque por movimiento al capturar con la mano sin estabilización. Las herramientas con preprocesamiento de imagen integrado — ajuste automático de contraste, corrección de inclinación, compensación de sombras — redujeron la brecha de precisión a 8-13 puntos. Las herramientas sin preprocesamiento mostraron una brecha de 20-35 puntos. Para datos críticos de campo, recomendamos: (1) fotografiar los documentos sobre una superficie relativamente plana cuando sea posible, (2) garantizar una iluminación uniforme sin sombra del cuerpo sobre el formulario y (3) sostener el teléfono en paralelo a la superficie del documento. Para fotos ya capturadas con defectos, elija una herramienta con preprocesamiento en lugar de una que espere una entrada limpia.
¿Y en cuanto al cumplimiento de OSHA? ¿Puede la extracción con IA cumplir con los requisitos de registro de OSHA?
Las normas de OSHA Part 1910 (Industria General) y Part 1926 (Construcción) regulan el registro de lesiones laborales, enfermedades e inspecciones de seguridad. OSHA 29 CFR 1904 exige que los empleadores registren las lesiones y enfermedades relacionadas con el trabajo en el registro OSHA 300 y conserven estos registros durante cinco años. OSHA 1926.20(b)(2) exige "inspecciones frecuentes y regulares de los sitios de trabajo, materiales y equipos por parte de personas competentes", y esos registros de inspección deben estar disponibles cuando se soliciten. Para fines de cumplimiento, el requisito crítico es la integridad y auditabilidad de los registros, no el método de captura de datos. Un registro de inspección extraído con IA que conserve la foto original, los datos estructurados extraídos, las marcas de tiempo, la identificación del inspector y la ubicación GPS proporciona, posiblemente, más rastro de auditoría que un libro de registro en papel. Sin embargo, OSHA no ofrece actualmente orientación específica sobre la extracción con IA para registros de cumplimiento; el requisito estándar es que el registro sea preciso, completo y se conserve durante el período requerido. Las operaciones que utilicen extracción con IA para registros relacionados con el cumplimiento deben verificar una muestra estadística de las extracciones y conservar las imágenes originales junto con los datos extraídos.
¿Estas herramientas funcionan sin conexión? Mis sitios de campo no tienen cobertura celular.
Las plataformas de recopilación de datos de campo — SafetyCulture, Fulcrum, ProntoForms, GoCanvas, Device Magic — todas admiten el modo sin conexión para la captura de datos basada en formularios en dispositivos móviles. Los datos de inspección, fotos y firmas se almacenan localmente y se sincronizan cuando vuelve la conectividad. Las herramientas de extracción de documentos — ImageToTable.ai, Nanonets, Amazon Textract, Docparser — no ofrecen procesamiento nativo sin conexión. La extracción requiere enviar la imagen a una API en la nube, lo que necesita una conexión a internet. La solución práctica para operaciones de campo sin conectividad es: capturar las fotos de los documentos en un dispositivo móvil (usando la aplicación de cámara, no la herramienta de extracción), subirlas en lote cuando haya conectividad disponible y procesarlas a través de la herramienta de extracción en ese momento. Las cuentas de Enlace de Recopilación también pueden recibir cargas desde múltiples puntos de campo a medida que la conectividad esté disponible. Para operaciones en entornos constantemente desconectados, las plataformas de campo basadas en formularios combinadas con la extracción por lotes al momento de la sincronización es el enfoque más confiable.
¿Puedo procesar por lotes tickets de báscula de múltiples sitios de proveedores en una sola hoja de cálculo?
Sí — si elige una herramienta con extracción independiente del formato y soporte de procesamiento por lotes. ImageToTable.ai procesa tipos de documentos mixtos (fotos de medidores, tickets de báscula, formularios de inspección) en un solo lote y combina los resultados en una hoja de cálculo. El requisito clave es que la herramienta lea los documentos por significado semántico del campo en lugar de la posición en la plantilla — porque los tickets de báscula de diferentes sitios de proveedores usan diseños completamente distintos. Para una operación de adquisición que recibe tickets de 12 patios de agregados, una herramienta basada en plantillas requeriría 12 plantillas separadas que necesitarían mantenimiento cada vez que una estación de pesaje actualice su software. Para un recorrido detallado, consulte nuestra guía para la extracción masiva de tickets de báscula. La guía para automatizar la lectura de medidores a Excel cubre el mismo flujo de trabajo por lotes para la lectura de medidores de servicios públicos.
¿Alguna de estas herramientas reemplaza una plataforma CMMS o FSM?
No — y no están diseñadas para eso. Las herramientas de extracción de documentos y las plataformas de gestión de servicios de campo (FSM) resuelven problemas diferentes. Las plataformas FSM (ServiceMax, IFS, Salesforce Field Service, Corrigo) gestionan la programación, el despacho, la gestión de órdenes de trabajo, el seguimiento de técnicos y la facturación. Las herramientas de extracción de documentos abordan el cuello de botella específico de convertir datos de documentos de campo en papel o fotografiados en registros digitales estructurados. La arquitectura práctica para la mayoría de las operaciones es: los documentos de campo se capturan (por teléfono o en papel) → se extraen a datos estructurados mediante una herramienta de extracción de documentos → se introducen en la plataforma FSM/CMMS como registros de inspección digitales o entradas de órdenes de trabajo. Algunas plataformas FSM (SafetyCulture, Fulcrum) incluyen la recopilación de datos estructurados como una función, pero capturan datos que los técnicos introducen en formularios — no extraen datos de documentos en papel existentes. Para una operación de campo con un flujo de trabajo mixto (algunos formularios digitales, algunos documentos en papel), tener tanto una plataforma de recopilación de datos de campo como una herramienta de extracción de documentos suele ser la respuesta correcta.
¿Cuánto cuesta la extracción de documentos de campo en comparación con la entrada manual de datos?
La entrada manual de datos para documentos de campo tiene dos costos: el tiempo que los trabajadores de campo dedican a escribir los datos en papel (que es parte de su trabajo) y el tiempo administrativo dedicado a teclear esos datos en una hoja de cálculo o sistema (que es adicional). Este último es el costo que la extracción reemplaza. Para una operación de servicios públicos de tamaño mediano que procesa 500 formularios de inspección de campo al mes, la entrada administrativa de datos suele consumir de 40 a 60 horas de personal a $18-25/hora, o aproximadamente $720-1,500 al mes. Con este volumen, el plan de $19-39/mes de ImageToTable.ai cubre el volumen de extracción (500 páginas en el plan de $19). El ahorro neto es de aproximadamente $700-1,400 al mes — pero solo si la precisión de extracción es lo suficientemente alta como para que el tiempo de verificación no compense el ahorro de mano de obra. Para operaciones con mucha escritura a mano, recomendamos probar la precisión en un conjunto de muestra de sus documentos reales y calcular el tiempo de verificación a su tasa de precisión estimada antes de hacer una comparación de costos.
Nota metodológica: Las cifras de precisión en este artículo se basan en nuestras pruebas de 40 imágenes de documentos capturados en campo en 9 herramientas en junio de 2026. Condiciones de prueba: todas las herramientas evaluadas con su configuración predeterminada de fábrica, en un teléfono inteligente Android de gama media (Samsung Galaxy A54) y la cámara trasera del iPhone 14. Las condiciones de iluminación degradada incluyeron sombra simulada, captura en ángulo de 30 grados y poca luz ambiental. Para Nanonets, también probamos con un modelo entrenado en 15 imágenes etiquetadas por tipo de formulario; las cifras de precisión sin entrenamiento se enumeran como referencia. Los rangos de precisión reflejan los mejores y peores resultados de nuestro conjunto de pruebas y excluyen fallos completos de extracción en los que una herramienta no devolvió datos utilizables para un campo determinado. Los resultados individuales variarán según la calidad de la imagen, el estado del documento, la legibilidad de la escritura y el diseño específico del formulario. Todos los datos de precios se recopilaron de páginas públicas de precios en junio de 2026. Para comparar, la entrada manual de datos de formularios de campo escritos a mano se estima en $18-25/hora según los datos del Bureau of Labor Statistics para capturadores de datos (43-9021) a mayo de 2025.
Compruébelo usted mismo: pruebe la extracción de documentos de campo
Sube una foto de un documento de campo (una lista de inspección, un registro de obra, un ticket de báscula, una lectura de medidor) y vea qué extrae la IA en segundos. No se requiere cuenta, ni configuración de plantillas, ni datos de entrenamiento.
No es necesario registrarse. Los archivos se procesan de forma segura y se eliminan tras la extracción.