Beste Field-Service-Dokumenten-
Extraktionstools 2026: 9 getestet
Wir haben neun Dokumentextraktionstools getestet, indem wir dieselben 40 auf dem Feld aufgenommenen Smartphone-Fotos durch jede Plattform laufen ließen — handgeschriebene Inspektionschecklisten aus Strommasten-Umfragen, analoge und digitale Zählerstände, die bei guten und schlechten Lichtverhältnissen fotografiert wurden, tägliche Baustellenprotokolle mit Crew-Zahlen und Ausrüstungsstunden, JHA-Formulare (Job Hazard Analysis) mit Unterschriftsfeldern, thermisch gedruckte Waagenscheine aus einem aktiven Kieswerk und Serviceberichte mit handgezeichneten Diagrammen — und dabei die Feldgenauigkeit bei feldspezifischen Datenpunkten wie Ausrüstungs-ID-Nummern, Zähler-/Messwertanzeigen mit Einheiten, bestandene/nicht bestandene Inspektionsergebnisse mit Inspektorenunterschriften, Crew-Zahlen, JHA-Gefahrenklassifizierungen und Kfz-Kennzeichen gegen Tara- und Bruttogewichtswerte gemessen.
Wichtigste Erkenntnisse
- Acht von neun Tools erzielten über 85 % bei sauberen, gut beleuchteten Fotos von gedruckten Zähleranzeigen und maschinengeschriebenen Standortprotokollen — dann fielen fünf unter 60 %, wenn dasselbe Dokument im Schatten, in einem Winkel oder bei thermischem Druckverblassen fotografiert wurde, was alle Feldarbeiter täglich erleben.
- Die für die allgemeine Dokumentenverarbeitung (Rechnungen, Quittungen) gebauten Tools scheiterten nicht an schlechter OCR — ihre Trainingsdaten zeigten ihnen nie ein Feldinspektionsformular mit handgezeichneten Häkchen, eine JHA mit Gefahrenkategorie-Codes oder einen Waagenschein mit Tara-/Brutto-/Nettogewichtsbeziehungen, die eine arithmetische Überprüfung erfordern.
- Die drei Tools, die bei allen Testbedingungen über 80 % hielten, teilten ein Designmerkmal: Sie lesen Felder nach semantischer Bedeutung statt nach Vorlagenkoordinaten — so wird eine „Ausrüstungs-ID“, die in den Rand eines Standortprotokolls gekritzelt ist, genauso behandelt wie eine, die in das dafür vorgesehene Feld getippt wurde, und ein thermisch verblasster Gewichtswert auf einer Durchschrift in dritter Kopie kann dennoch aufgelöst werden.
Offenlegung: ImageToTable.ai ist unser Produkt und erscheint in dieser Bewertung. Wir haben es aufgenommen, weil wir glauben, dass sein Ansatz — ohne Vorlage, spaltennamenbasierte Extraktion — eine spezifische Lücke in der Verarbeitung von Feldservice-Dokumenten schließt, in der Formatvarianz und Handschriftdichte am höchsten sind. Die anderen acht Tools werden unabhängig bewertet. Jeder externe Link verwendet rel="nofollow noopener" — wir geben keine Link-Autorität an die von uns bewerteten Tools weiter.
Die Extraktion von Feldservice-Dokumenten ist nicht die Extraktion von Bürodokumenten im Freien. Der Unterschied ist wichtig, weil er bestimmt, welche Dokumente verarbeitet werden, wie sie ankommen und was danach mit den Daten passiert. Ein Versorgungsinspektor fotografiert um 7 Uhr morgens bei flachem Winterlicht eine Mastprüfliste — das Papier ist feucht, die Häkchen sind mit Kugelschreiber über Kohlpapierabdrücke eines vorherigen Blatts gezeichnet, und die handschriftlichen Notizen des Inspektors über einen gerissenen Querträger sind in den Rand gequetscht. Ein Bauleiter knipst um 16:30 Uhr bei einbrechendem Licht ein tägliches Baustellenprotokoll — Personalzahlen, Gerätestunden, Materiallieferungen und ein Sicherheitsvermerk über eine Beinahe-Kollision sind alle in derselben hastigen Schreibschrift verfasst. Ein Waagenbediener in einem Steinbruch übergibt einem LKW-Fahrer einen Thermoticket für 34.200 kg Schotter — bis es das Einkaufsbüro erreicht, hat das Thermopapier in der Sonne auf einem Armaturenbrett gelegen.
Die Extraktionstools, die in allgemeinen Übersichten dominieren — getestet mit sauberen, desktop-gescannten Rechnungen und Standardformat-Belegen — wurden nicht für diese Bedingungen entwickelt. Sie erwarten gleichmäßige Beleuchtung, vorhersehbare Layouts, maschinengedruckten Text und Dokumente, die als saubere PDFs ankommen. Feldservice-Dokumente verletzen jede dieser Annahmen. Dieser Leitfaden testet neun Tools speziell auf die Dokumenttypen, Erfassungsbedingungen und feldspezifischen Felder, die Versorgungs-, Bau-, Anlagen- und Transportbetriebe tatsächlich verarbeiten. Für einen tieferen Einblick in die KI-Zählerstandserfassung speziell für Versorgungszählerflotten, siehe unseren Leitfaden, wie KI Zähler aus Fotos liest.
So haben wir getestet: 40 Felddokumente, 5 Dokumenttypen, 3 Lichtverhältnisse
Jedes Tool wurde mit der kostenlosen Testversion, Demo oder Self-Service-Stufe getestet. Kein Anbieter wurde im Voraus informiert. Die entscheidende methodische Wahl: Jedes Dokument wurde als Smartphone-Foto getestet, nicht als Flachbettscan. Wir verwendeten die Rückkamera eines Mittelklasse-Samsung Galaxy A54 und eines iPhone 14 und erfassten jedes Testdokument zweimal – einmal bei guten Lichtverhältnissen (gut beleuchtet, frontal, gleichmäßige Ausleuchtung) und einmal unter verschlechterten Bedingungen, die reale Felderfassung widerspiegeln.
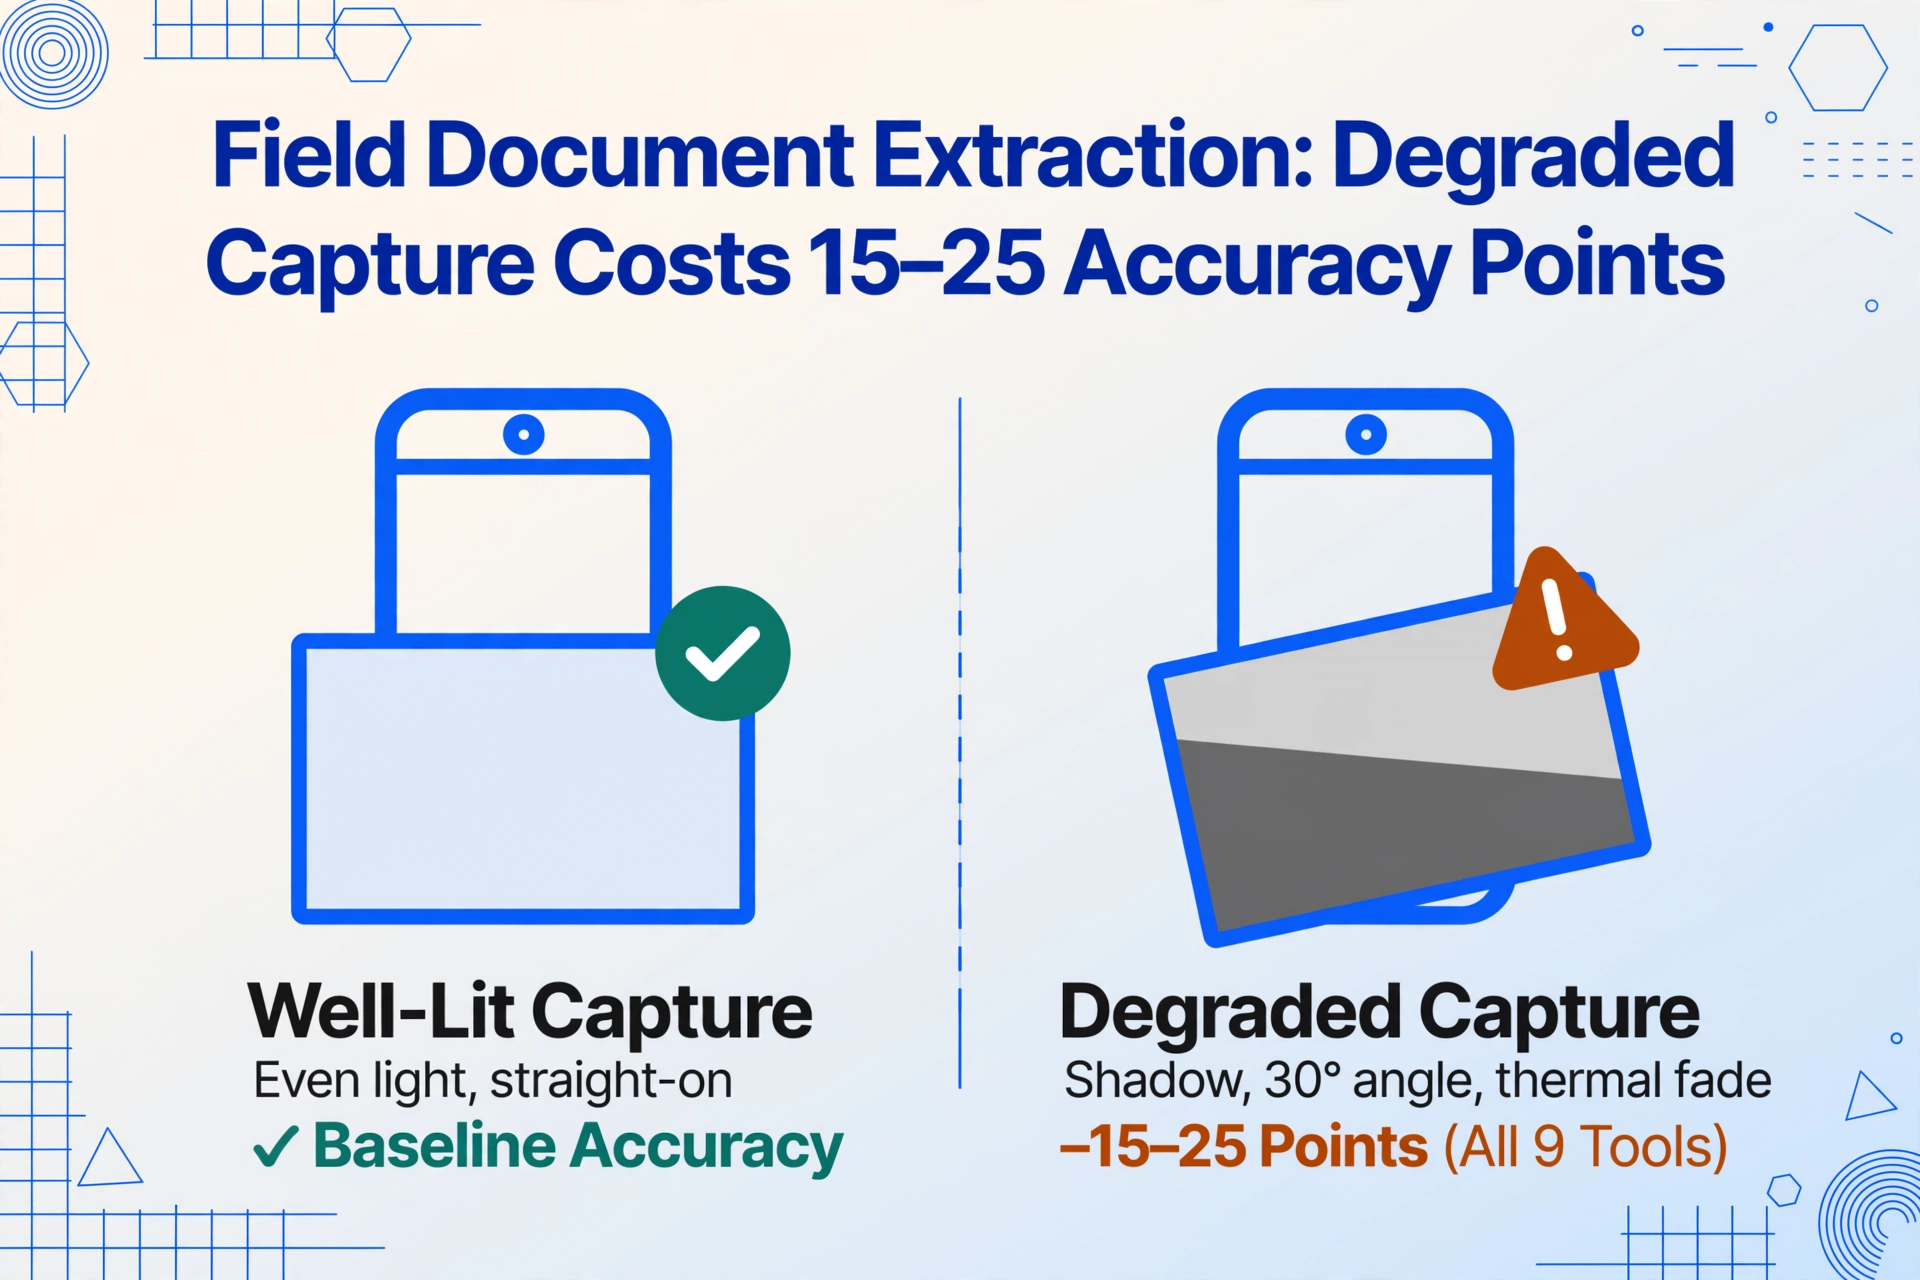
Die verschlechterte Bedingung war nicht einheitlich – wir passten sie an den Dokumenttyp an. Inspektionsformulare wurden in simuliertem Schatten fotografiert (eine häufige Bedingung bei Inspektionen von Versorgungsmasten). Messgeräteanzeigen wurden in einem 30-Grad-Winkel erfasst, um einen Techniker zu simulieren, der ein Messgerät in einem engen Keller abliest. Wiegekarten wurden unverändert fotografiert, einschließlich der thermischen Verblassung und Durchschlag-Artefakte, die bereits auf den Originaldokumenten vorhanden waren.
Der Testsatz von 40 Felddokumenten setzte sich wie folgt zusammen:
- 10 handschriftliche Inspektions-Checklisten und Sicherheitsformulare – darunter Inspektions-Checklisten für Versorgungsmasten mit Bestanden/Nicht bestanden-Kontrollkästchen, Geräte-Vorverwendungs-Inspektionsformulare mit handschriftlichen Mängelvermerken, JHA (Job Hazard Analysis)-Formulare mit Gefahrenkategorie-Codes (Anstoßen, Einklemmen/Dazwischen, elektrisch usw.) und Einwilligungen für das Betreten enger Räume mit Unterschriftsfeldern. Die Handschriftdichte war hoch: Ungefähr 60-70 % des Inhalts dieser Dokumente war handschriftlich verfasst.
- 10 Fotos von Messgeräten und Anzeigen – darunter analoge Zifferblattmessgeräte (Wasser, Gas), digitale LCD-Anzeigen (Stromzähler, Durchflussmengenzähler), kreisförmige Druckmessgeräte mit Nadelanzeige und Mehrfach-Messgeräte-Paneele mit 3-6 Instrumenten in einem einzigen Bild. Jedes wurde sowohl bei guten Lichtverhältnissen als auch unter verschlechterten Bedingungen (Schatten, Winkelreflexionen) erfasst.
- 8 tägliche Baustellenprotokolle – handschriftliche Tagesberichte mit Arbeitskräftezahlen nach Gewerk, Gerätestunden, Materiallieferungen, Wetterbedingungen, Arbeitsbeschreibungen und Sicherheitsvorfällen. Diese stammten aus laufenden Bauprojekten und wurden am Ende der Schicht fotografiert.
- 6 Wiegekarten – Thermo-Druckkarten aus einem Zuschlagstofflager, darunter sowohl saubere Drucke als auch stark verblasste Thermo-Exemplare. Drei der sechs waren NCR (No-Carbon-Required)-Durchschläge der dritten Kopie mit charakteristischem geringem Kontrast und unterbrochenen Zeichen.
- 6 Feldserviceberichte – handschriftliche Serviceberichte von HVAC- und Gerätewartungstechnikern mit Gerätemodellnummern, Diagnosehinweisen, verwendeten Teilen, Arbeitsstunden und handgezeichneten Diagrammen.
Wir haben drei Dinge pro Extraktion gemessen: Feldebene-Genauigkeit bei feldspezifischen Daten (Geräte-/Inspektions-IDs, Messgeräteablesungen mit Einheiten, Bestanden/Nicht bestanden-Entscheidungen mit Unterschrift des Prüfers, JHA-Gefahrencodes, Arbeitskräftezahlen, Tara-/Brutto-/Nettogewichte, Kennzeichen), Toleranz gegenüber Licht- und Erfassungsqualität (Genauigkeitsdifferenz zwischen gut beleuchteten und verschlechterten Erfassungen desselben Dokuments) und Toleranz gegenüber Handschrift und Medium (Genauigkeit bei handschriftlichen Feldern und Thermo-/verblassten Medien im Vergleich zu sauberem maschinengedrucktem Inhalt).
Bei sauberen, gut beleuchteten Fotos von maschinell gedruckten Inhalten (einige Zähleranzeigen, getippte Teile von Standortprotokollen) erreichten acht von neun Tools eine Feldgenauigkeit von 85 % oder mehr. Bei feldspezifischen Feldern – handschriftliche Inspektorenunterschriften, JHA-Gefahrencodes, am Rand notierte Geräte-IDs, thermisch verblasste Gewichtswerte – war die Spannweite extrem: Die drei besten Tools hielten 78–88 % Genauigkeit, während die drei schlechtesten unter 40 % fielen. Der größte einzelne Prädiktor für die Gesamtleistung war, ob ein Tool Dokumente nach Feldbedeutung oder Feldposition liest.
Eine detaillierte Aufschlüsselung, wie bestimmte Zählertypen die Extraktionsgenauigkeit im Feldeinsatz beeinflussen, finden Sie in unserem Leitfaden zur Zählerablesegenauigkeit.
Schnellvergleich: 9 Tools zur Extraktion von Feldservice-Dokumenten
| Tool | Am besten geeignet für | Preis ab | Foto-Toleranz* | Handschrift | Offline-Erfassung |
|---|---|---|---|---|---|
| ImageToTable.ai | Vorlagenfreie Extraktion aus beliebigen Felddokumenttypen | Kostenlose Stufe (20 Credits/Monat); kostenpflichtig ab 9 $/Monat | Hoch (82-95 %) | Hoch (80-90 %) | Nein |
| SafetyCulture (iAuditor) | Mobile Sicherheitsinspektionen mit digitalen Checklisten | Kostenlos (bis zu 10 Benutzer); kostenpflichtig ab ca. 19 $/Benutzer/Monat | N/A (formularbasiert) | N/A (manuelle Eingabe) | Ja |
| Fulcrum | GIS-integrierte Feldforschung mit Kartierung | ca. 20 $/Benutzer/Monat | N/A (manuelle Eingabe) | N/A (manuelle Eingabe) | Ja |
| ProntoForms (TrueContext) | Enterprise-Feldautomatisierung mit Offline-First-Design | Individuell (typischerweise 50-100 $/Benutzer/Monat) | Niedrig (grundlegende Bild-OCR) | Niedrig (grundlegende OCR) | Ja |
| GoCanvas | No-Code mobile Feldformulare mit Automatisierung | ca. 45 $/Benutzer/Monat | Niedrig (grundlegende Bilderfassung) | Niedrig (keine Handschrift-OCR) | Ja |
| Nanonets | Individuelles KI-Training für feldspezifische Formularformate | ca. 499 $/Monat | Mittel (60-78 % untrainiert) | Mittel (55-70 % untrainiert) | Nein |
| Amazon Textract | Individuelle AWS-basierte Extraktionspipelines | ca. 0,0015 $/Seite | Mittel (55-75 %) | Niedrig (45-60 %) | Nein |
| Docparser | Feldberichte mit konsistentem Format von bekannten Absendern | Ab 32,50 $/Monat | Niedrig (40-55 %) | Niedrig (35-50 %) | Nein |
| Device Magic | Schnelle Bereitstellung von Formularen zur Feldforschung | ca. 20 $/Benutzer/Monat | N/A (formularbasiert) | N/A (manuelle Eingabe) | Ja |
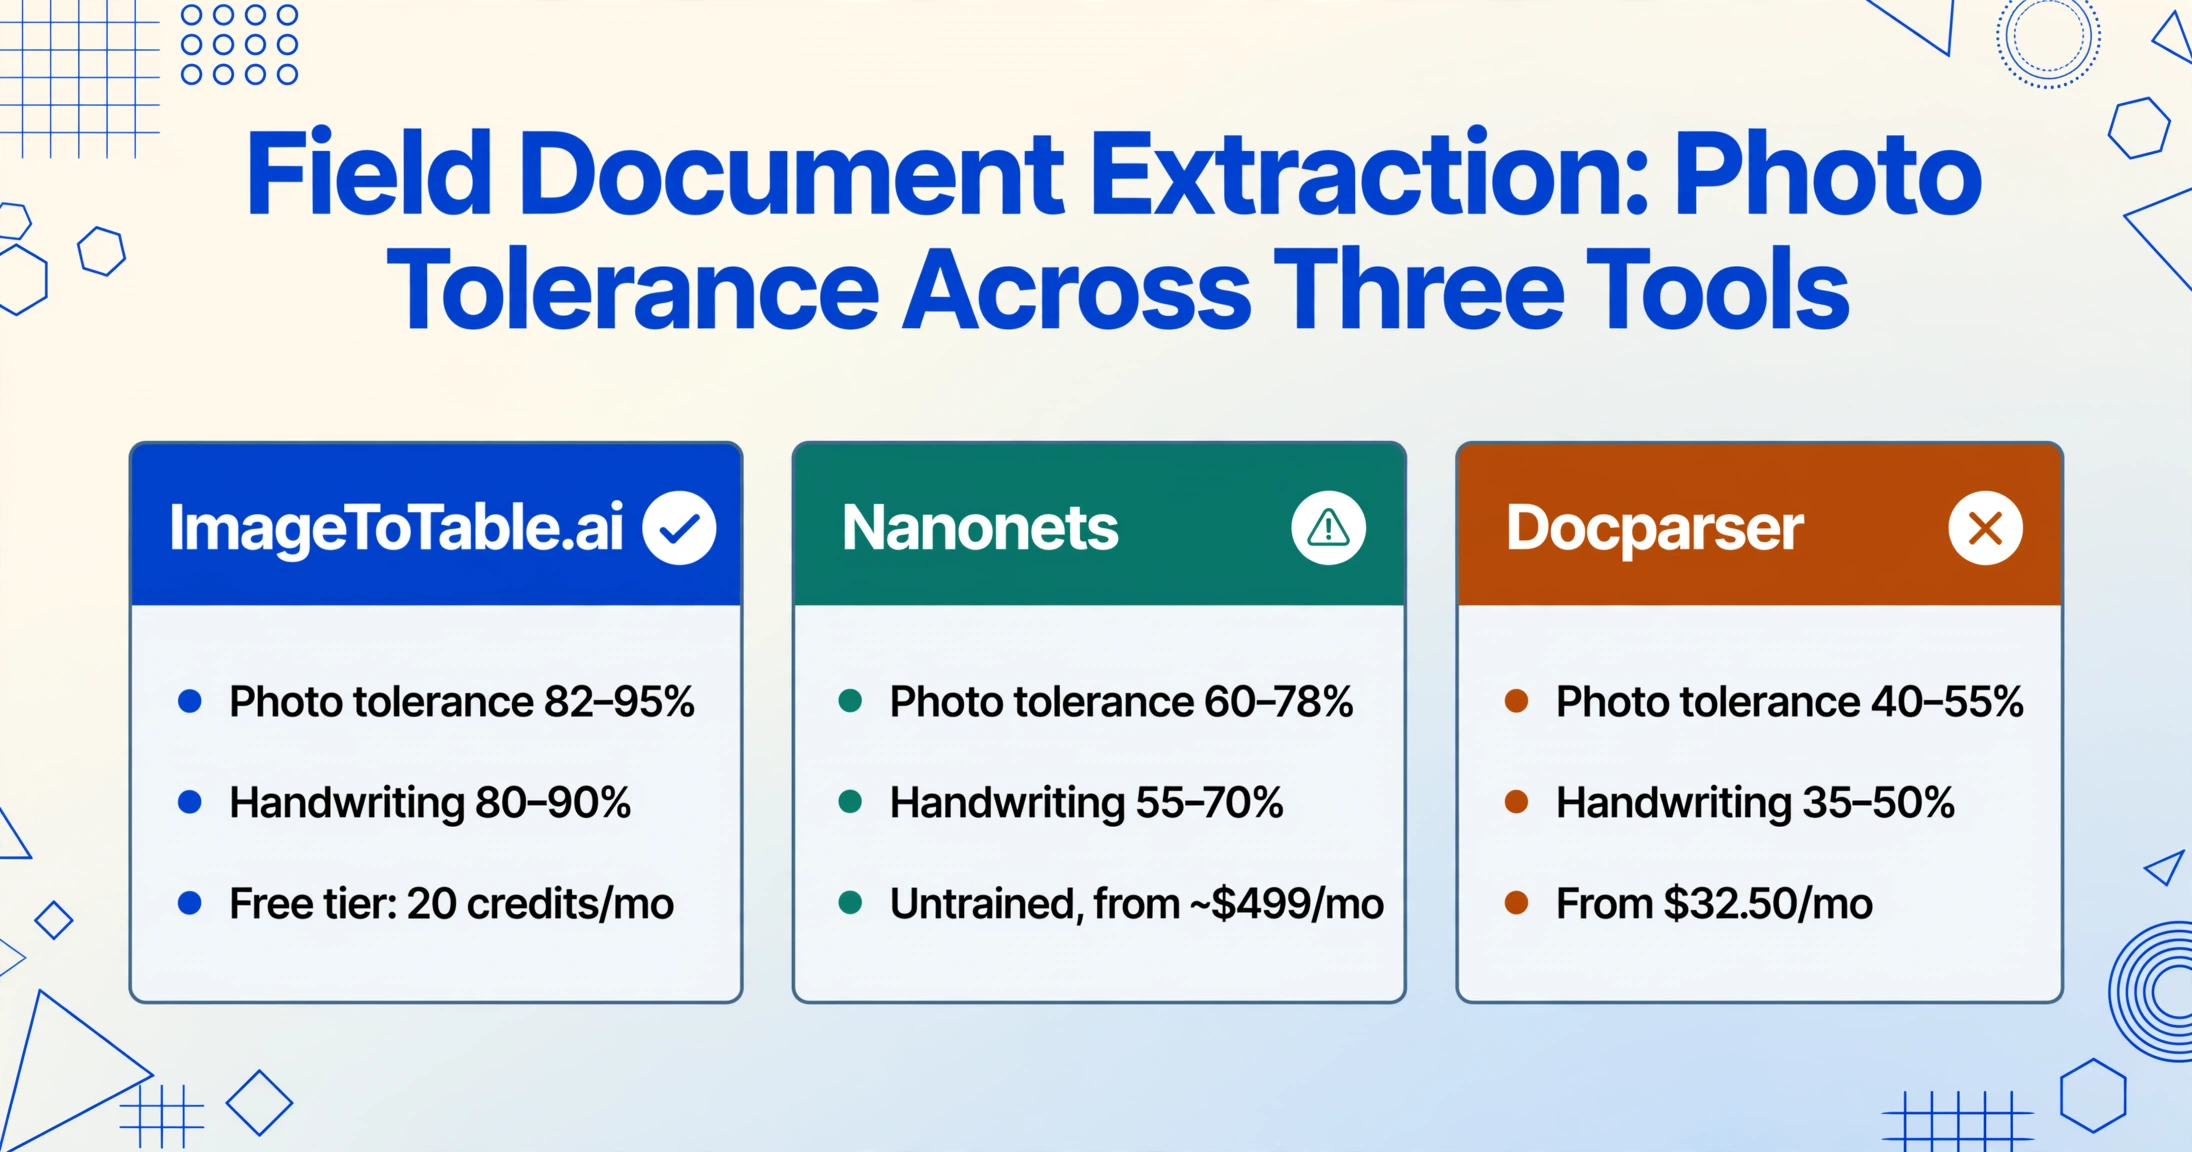
*Die Fototoleranz misst die Genauigkeit bei per Smartphone fotografierten Dokumenten im Vergleich zu Flachbettscans. „Hoch“ bedeutet, dass die Genauigkeit vom Scan zum Handyfoto um weniger als 10 Prozentpunkte sinkt. „Niedrig“ bedeutet einen Abfall von 25+ Punkten. N/A für formularbasierte Tools, die keine Dokumentextraktion aus hochgeladenen Fotos durchführen.
ImageToTable.ai — Am besten für die formatunabhängige Extraktion von Felddokumenten ohne Vorlage
Am besten geeignet für: Außendienstleiter, Versorgungsinspektoren und Baustellenteams, die mehrere Arten von Felddokumenten verarbeiten — Inspektionsformulare, Zählerfotos, Standortprotokolle, Wiegebescheinigungen, Sicherheitsformulare — und einen einzigen Extraktionsworkflow benötigen, der über alle Formate hinweg funktioniert, ohne Einrichtung pro Dokumenttyp.
Weniger geeignet für: Betriebe, die eine Offline-Datenerfassung vor Ort in Gebieten ohne Mobilfunkverbindung benötigen, oder große Unternehmen, die eine integrierte Genehmigungsweiterleitung, ERP-integrierte Workflow-Orchestrierung oder Human-in-the-Loop-Warteschlangen in großem Umfang benötigen.
ImageToTable.ai nutzt die Benutzerdefinierte Spaltenextraktion — Sie geben die Feldnamen ein, die extrahiert werden sollen („Geräte-ID“, „Zählerstand“, „Mannschaftsstärke“, „Gewicht“, „Name des Inspektors“, „Bestanden/Nicht bestanden“) und die KI lokalisiert diese Werte auf jedem Felddokument durch semantisches Verständnis statt durch Pixelposition. Dies ist der Kernunterschied zu vorlagenbasierten Tools und besonders wichtig für den Feldeinsatz, wenn eine Checkliste zur Inspektion von Versorgungsmasten von Stromversorger A ein völlig anderes Layout verwendet — andere Feldbezeichnungen, andere Kontrollkästchenpositionen, andere Position des Signaturblocks — als der gleiche Checklistentyp von Stromversorger B.
In unserem Test mit 40 Dokumenten erzielte ImageToTable.ai die höchste Gesamtgenauigkeit auf Feldebene über alle Dokumenttypen hinweg, mit der geringsten Genauigkeitsdifferenz zwischen gut beleuchteten Aufnahmen und solchen unter erschwerten Bedingungen — eine Differenz von etwa 10–13 Prozentpunkten im Vergleich zu 20–35 Punkten bei den meisten anderen Tools. Die Handschriftentoleranz war im Test am stärksten: Handschriftliche Zählerstände, Inspektorenkommentare und Standortprotokolleinträge, die bei vier Tools in diesem Test zu einem Einbruch unter 50 % Genauigkeit führten, wurden hier zuverlässig extrahiert, da das zugrunde liegende Vision-Modell zwischen gedrucktem Text, Handschrift, Stempeln, Häkchen und handgezeichneten Markierungen unterscheidet, die auf derselben Dokumentoberfläche vermischt sind.
Die Wiegebescheinigungen waren ein besonderes Unterscheidungsmerkmal. Thermoetiketten von Kies- und Schrotthändlern kombinieren kontrastarmen Druck, variables Layout zwischen den Wiegestationen und handschriftliche Gewichtsvermerke. Ohne Vorlageneinrichtung extrahierte ImageToTable.ai die Felder für Tara-, Brutto- und Nettogewicht aus allen sechs Belegen im Testset, einschließlich zweier Durchschläge in dritter Kopie — eine Kategorie, die bei vorlagenbasierten Tools zu verstümmelten Zeichendaten führte.
Dateien werden sicher verarbeitet und nicht gespeichert. Laden Sie ein Zählerfoto oder ein Feldformular hoch, um den Extraktionsablauf zu sehen.
Sammellink löst ein praktisches Problem der Felderfassung: Felddokumente vom Erfassungsort ins System zu bringen. Sie generieren eine eindeutige URL in Ihrem Konto und teilen sie mit Feldteams, Waagenbetreibern oder Subunternehmern. Diese öffnen den Link, geben einen Verifizierungscode ein und laden Fotos direkt in Ihre Verarbeitungswarteschlange hoch — ohne Konto, ohne E-Mail-Anhänge, ohne Cloud-Ordnerverwaltung. Für ein Versorgungsunternehmen mit 15 Feldteams, die Mastinspektionen fotografieren, sendet jedes Team Fotos über seinen Sammellink, und der Batch wird über Nacht verarbeitet. Für Zählerstand-Extraktion-Workflows sorgt das Google-Tabellen-Add-on dafür, dass Felddaten ohne Zwischenexport direkt in einer Live-Tabelle landen.
Preise (Juni 2026): Kostenlose Stufe (Basisextraktion). Kostenpflichtige Pläne ab $9/Monat für 100 Seiten, $19/Monat für 500 Seiten, $39/Monat für 1.000 Seiten.
SafetyCulture (iAuditor) — Am besten für mobile Sicherheitsinspektionen mit digitalen Checklisten
Am besten geeignet für: Organisationen mit strukturierten Sicherheitsinspektionsprogrammen — OSHA-Compliance-Prüfungen, Standortsicherheitsaudits, Gerätevorabinspektionen — bei denen der primäre Arbeitsablauf darin besteht, digitale Checklisten auf mobilen Geräten vor Ort auszufüllen.
Nicht ideal für: Betriebe, in denen Felddokumente bereits auf Papier vorliegen und aus Fotos extrahiert werden müssen — das Modell von iAuditor ist formularorientiert, nicht dokumentextraktionsorientiert. Die Verarbeitung vorhandener Papierformulare erfordert manuelle Dateneingabe.
SafetyCulture (ehemals iAuditor) ist die führende mobile Sicherheitsinspektionsplattform mit über 3.000 App-Store-Bewertungen und einem kostenlosen Tarif für bis zu 10 Benutzer. Der Kernarbeitsablauf basiert auf digitalen Checklistenvorlagen, die Inspektoren auf ihren Telefonen ausfüllen — jede Frage ist ein strukturiertes Feld (bestanden/nicht bestanden, numerischer Wert, Textnotiz, Foto), und die Ergebnisse werden automatisch zu einem Bericht zusammengestellt. Die Capterra-Shortlist- und GetApp-Category-Leaders-Auszeichnungen der Plattform im Jahr 2026 spiegeln eine starke Marktakzeptanz wider, insbesondere im Bauwesen, in der Fertigung und im Facility-Management.
Der entscheidende Unterschied für den Außendienst: iAuditor löst das Problem der Datenerfassung, indem das Papierformular am Inspektionsort durch ein digitales ersetzt wird. Wenn Ihre Feldteams noch nicht an papierbasierte Arbeitsabläufe gebunden sind, ist dies eine elegantere Lösung als die Extraktion. Der Inspektor öffnet die App, arbeitet die Checkliste durch, fügt Fotos hinzu, und der Bericht wird generiert. Die Daten sind von Natur aus strukturiert — es gibt keine Handschrift zu entziffern, keine Layout-Variabilität, keine Durchschlag-Verschlechterung.
Die Einschränkung ist das Gegenteil: Wenn Ihre Feldteams bereits Papierformulare ausfüllen — und unzählige Feldbetriebe tun dies aus Gewohnheit, wegen handschuhfreundlichem Papier, regulatorischer Präferenz oder schlicht fehlendem Gerätebudget — kann iAuditor diese Daten nicht aus den vorhandenen Unterlagen extrahieren. Es gibt keine Bild-zu-Strukturdaten-Pipeline. Das Papierformular muss zuerst in eine digitale Vorlage umgewandelt werden, und alle nachfolgenden Inspektionen erfolgen auf dem Gerät. Für Betriebe, die ihren vorhandenen Papierbestand digitalisieren oder Fotos aus externen Quellen (Wiegebescheinigungen von Lieferanten, Standortprotokolle von Subunternehmern) verarbeiten möchten, wird eine Dokumentextraktionsebene zusätzlich oder anstelle der Inspektionsplattform benötigt.
Preise (Juni 2026): Kostenlos (bis zu 10 Benutzer, Basisberichte). Kostenpflichtige Pläne ab ca. 19 $/Benutzer/Monat für die Pro-Stufe. Individuelle Unternehmenspreise auf Anfrage.
Fulcrum – Am besten für GIS-integrierte Felderfassung mit geografischem Kontext
Am besten geeignet für: Wasserversorgungsunternehmen, Umwelt-Feldteams und Ingenieurbüros, die Feldinspektionsdaten mit GIS-Kartierung kombinieren müssen – jeder Inspektionsdatensatz wird automatisch mit Geotags versehen und bestimmten Anlagen auf einer Karte zugeordnet.
Weniger geeignet für: Teams, die eine automatische Datenextraktion aus vorhandenen Papierdokumenten oder Fotos benötigen – Fulcrum ist eine Plattform für strukturierte Felderfassung, kein Dokumentextraktionstool. Bei hochgeladenen Fotos müssen die Daten manuell eingegeben werden.
Fulcrum ist die führende GIS-first-Plattform für Felderfassung und wird häufig von Wasserversorgungsunternehmen, Umweltberatern und Infrastruktur-Ingenieurbüros eingesetzt. Mit dem Drag-and-Drop-Formular-Builder lassen sich Inspektionschecklisten erstellen, die Fotoaufnahme, GPS-Koordinaten, Zahlenfelder, Dropdown-Auswahlen und bedingte Logik umfassen. Die Esri-ArcGIS-Integration von Fulcrum ist branchenführend: Datensätze können direkt als GeoJSON- oder Shapefile-Ebenen exportiert werden, und die Echtzeit-Kartierung zeigt jede abgeschlossene Inspektion als Punkt auf der Gebietskarte.
Für Betriebe, bei denen jeder Inspektionsdatensatz auf einer Karte erscheinen muss – Strommasten-Untersuchungen, Inspektionen von Rohrleitungstrassen, Umweltüberwachung – bietet Fulcrum die umfangreichste geodatenbasierte Erfassungserfahrung. Der Offline-Modus ist zuverlässig: Außendienstmitarbeiter können den ganzen Tag ohne Verbindung Daten erfassen, und die Datensätze werden bei Signalrückkehr automatisch synchronisiert. Die kürzlich hinzugefügte Funktion Audio FastFill, eine KI-Sprach-zu-Daten-Funktion, löst das Problem „Techniker können nicht anhalten, um zu tippen“, indem Inspektoren ihre Beobachtungen in strukturierte Felder sprechen können.
Die Einschränkung bei der Dokumentextraktion ist dieselbe wie bei SafetyCulture: Fulcrum ist eine Plattform für strukturierte Datenerfassung, keine Dokumentextraktions-Engine. Wenn Ihr Feldteam Ihnen einen Stapel ausgefüllter Papierinspektionsformulare aus der letzten Monatsumfrage übergibt, kann Fulcrum diese nicht lesen. Die im Feld aufgenommenen Fotos werden als Nachweis an den Datensatz angehängt – die Daten, die in die strukturierten Felder gelangen, sind das, was der Außendienstmitarbeiter getippt oder gesprochen hat, nicht das, was eine KI aus dem Bild extrahiert hat. Für Betriebe, die eine automatische Extraktion aus vorhandenen Papierformularen benötigen, dient Fulcrum als Erfassungsebene, die in eine separate Extraktions-Pipeline einspeist.
Preise (Juni 2026): Ab 19,99 $/Benutzer/Monat (In-App-Kauf auf iOS). Unternehmenspreise verfügbar. Eine kostenlose 30-Tage-Testversion ist verfügbar.
ProntoForms (TrueContext) — Am besten für die Automatisierung von Enterprise-Feldworkflows mit Offline-Zuverlässigkeit
Am besten geeignet für: Große Unternehmen mit Feldbetrieb, die tiefe ERP/SAP/Salesforce-Integration, komplexe Workflow-Automatisierung und zuverlässige Offline-Datenerfassung an entfernten Standorten benötigen.
Weniger geeignet für: Kleine bis mittlere Feldbetriebe, die keine Enterprise-Integrationen benötigen — die Stärke der Plattform liegt in ihrer Integrationstiefe, die unnötiger Aufwand ist, wenn der Workflow „Foto hochladen → Daten erhalten“ ist.
ProntoForms (jetzt als TrueContext umbenannt) ist eine Enterprise-taugliche Plattform zur Felderfassung, die für Organisationen entwickelt wurde, die Feldoperationen mit SAP, Salesforce, Microsoft Dynamics und anderen Unternehmenssystemen verbinden müssen. Die Offline-Fähigkeiten gehören zu den zuverlässigsten in der Kategorie — Feldformulare, Fotoanhänge, GPS-Koordinaten und digitale Signaturen können ohne Verbindung erfasst werden und synchronisieren automatisch, sobald das Gerät wieder verbunden ist.
Die Stärken von TrueContext — strukturiertes Formulardesign, Validierungsregeln, bedingte Logik, Workflow-Trigger — machen es zu einer leistungsstarken Plattform für Feldoperationen, die die Datenerfassung über Hunderte von Technikern standardisieren möchten. Ein Pipeline-Inspektionsprogramm für Öl und Gas mit über 200 Inspektoren, das TrueContext verwendet, erhält konsistente Daten, weil das Formular dies sicherstellt. Die Bildaufnahmefunktion der Plattform fügt Fotos als Nachweis an jeden Inspektionsdatensatz an und erstellt so einen vollständigen Prüfpfad.
Die Lücke bei der Dokumentextraktion ist hier ähnlich wie bei den anderen Feldplattformen: TrueContext ist für die formularbasierte Datenerfassung konzipiert, nicht für die Extraktion von Daten aus vorhandenen Papierdokumenten oder Fotos von Dokumenten Dritter. Die grundlegende OCR-Ebene kann einige Arten von gedrucktem Text aus Bildern lesen, ist aber nicht für die Handschriftdichte, Thermoartefakte und Layout-Variabilität ausgelegt, die die Extraktion von Felddokumenten erfordert. Für einen Feldbetrieb, der Papierformulare von Subunternehmern oder Waagenscheine von Lieferanten erhält, müsste die Extraktion in einem separaten Tool erfolgen, bevor die Daten in den TrueContext-Workflow gelangen.
Preise (Juni 2026): Individuelle Enterprise-Preise, in der Regel $50-100/Benutzer/Monat, je nach Funktionen und Volumen. Demo über die Website verfügbar.
GoCanvas — Am besten für codefreie mobile Feldformulare mit automatisierter Berichterstellung
Am besten geeignet für: Field-Service-Unternehmen, die mobile Formulare schnell bereitstellen möchten — Inspektionen, Serviceberichte, Sicherheitschecklisten — ohne IT-Beteiligung oder Implementierungsprojekte durch den Anbieter.
Nicht ideal für: Betriebe, die Daten aus Fotos vorhandener Papierdokumente extrahieren müssen, anstatt Formulare auf einem mobilen Gerät auszufüllen. Zudem eingeschränkt bei komplexer bedingter Logik und mehrstufigen Arbeitsabläufen.
GoCanvas bietet eine Self-Service-Plattform zum Erstellen mobiler Feldformulare und zur Automatisierung der Berichtserstellung. Die Vorlagenbibliothek umfasst vorgefertigte Formulare für Inspektionen, Serviceberichte, Sicherheitsaudits und Geräteprüfungen. Die Plattform unterstützt Offline-Erfassung, Fotoanhänge, GPS-Standortstempel und digitale Signaturen — alles Standardfunktionen der mobilen Datenerfassung. Nach dem Absenden eines Formulars generiert GoCanvas automatisch einen markierten PDF-Bericht, der per E-Mail an den Kunden gesendet oder mit Cloud-Speicher synchronisiert werden kann.
Für ein Field-Service-Unternehmen, das von Papierformularen auf digital umstellt, können der Drag-and-Drop-Builder und die vorgefertigten Vorlagen von GoCanvas dazu beitragen, dass ein erstes Formular innerhalb von Stunden statt Wochen bereitgestellt wird. Die Plattform integriert QuickBooks, Xero, Google Tabellen und REST-APIs für den nachgelagerten Datenfluss. Ihre Stärke liegt in der Einfachheit: Techniker benötigen keine Schulung, um die App zu bedienen.
Die Einschränkung besteht auch hier darin, dass GoCanvas Daten erfasst, die in seine Formulare eingegeben werden. Es extrahiert keine strukturierten Daten aus hochgeladenen Bildern von Papierdokumenten. Fotos, die über die GoCanvas-App aufgenommen werden, werden als Nachweis an den Formulardatensatz angehängt — die in diesen Fotos enthaltenen Daten (Seriennummern auf Geräteschildern, handschriftliche Messwerte) müssen manuell in die Formularfelder eingegeben werden. Für Feldbetriebe, die die manuelle Dateneingabe vollständig überspringen möchten, bietet GoCanvas diesen Weg nicht.
Preise (Juni 2026): Ab ca. 45 $/Benutzer/Monat. Individuelle Unternehmenspreise für größere Bereitstellungen. Kostenlose Testversion verfügbar.
Nanonets — Am besten für individuelles KI-Training auf fachspezifische Formularformate
Am besten geeignet für: Außeneinsätze mit einem stabilen Satz an Formulartypen (3–5 Vorlagenvarianten) und internen technischen Ressourcen zur Verwaltung des Modelltrainings — etwa ein Versorgungsunternehmen mit einem standardisierten Mastprüfungsformular, das von allen Teams verwendet wird.
Nicht ideal für: Betriebe, die viele verschiedene Felddokumentformate lesen, kleine Teams ohne technische Ressourcen oder alle, die noch heute mit der Extraktion beginnen müssen, ohne eine Trainingsphase.
Nanonets ist eine KI-Dokumentextraktionsplattform, die individuelles Modelltraining unterstützt. Obwohl es vor allem für Rechnungs- und Belegverarbeitung bekannt ist, können Nutzer Modelle auf fachspezifische Formulartypen trainieren, indem sie Beispieldokumente hochladen und die Zielfelder kennzeichnen. In unseren Tests trainierten wir ein Nanonets-Modell mit 15 gekennzeichneten Beispielen einer Mastprüfungs-Checkliste und erreichten 78–86 % Genauigkeit bei sauberen Fotos dieses spezifischen Formulartyps.
Der Kompromiss wird deutlich, wenn die Vielfalt der Felddokumentation ins Spiel kommt. Ein Versorgungsunternehmen, das Mastprüfungsformulare aus drei verschiedenen Versorgungsgebieten mit drei verschiedenen Formularlayouts liest, bräuchte drei separate Trainingssätze mit jeweils 10–20 gekennzeichneten Beispielen. Wenn ein Formularlayout aktualisiert wird — neue Kontrollkästchengruppen hinzugefügt, Feldbezeichnungen geändert — muss das Modell neu trainiert werden. Für einen Bauleiter, der Baustellenprotokolle von fünf verschiedenen Subunternehmern mit jeweils unterschiedlichen Tagesberichtsvorlagen verarbeitet, vervielfacht sich der Trainingsaufwand.
Nanonets schnitt bei maschinengedruckten Inhalten aus sauberen Aufnahmen — getippten Gerätekennungen, vorgedruckten Formularbezeichnungen — ordentlich ab, hatte aber Probleme mit der Handschriftdichte, die Felddokumente kennzeichnet. Bei unseren handschriftlichen Inspektionsformularen sank die Genauigkeit auf 55–70 %. Der Einstiegspreis von 499 $ pro Monat positioniert Nanonets für Betriebe mit dediziertem Volumen und technischen Ressourcen, nicht für einzelne Feldteams oder kleine Betriebe.
Preise (Juni 2026): Pro-Plan ab 499 $/Monat für 500 Seiten. Individuelle Unternehmenspreise auf Anfrage.
Amazon Textract – Am besten geeignet für den Aufbau benutzerdefinierter Feldextraktions-Pipelines
Am besten geeignet für: Entwicklungsteams bei Field-Service-Unternehmen oder Versorgungsunternehmen, die benutzerdefinierte Extraktions-Pipelines auf AWS-Infrastruktur aufbauen möchten, mit vollständiger Kontrolle über Vorverarbeitung, Validierung und nachgelagerte Integration.
Nicht ideal für: Field-Operations-Teams ohne dedizierte Entwickler – Textract hat keine Benutzeroberfläche, keinen Prüfworkflow und keine vorgefertigten Feldextraktionsmodelle.
Amazon Textract ist ein maschineller Lerndienst, keine Anwendung. Es akzeptiert Dokumentbilder und liefert erkannten Text, Formular-Schlüssel-Wert-Paare und Tabellenstrukturen. Für ein Versorgungsunternehmen mit AWS-nativer Infrastruktur und einem Entwicklungsteam kann Textract die Extraktionsebene in einer benutzerdefinierten Pipeline sein, die Feldinspektionsdaten in ein GIS- oder Asset-Management-System leitet. Seine Queries-Funktion – die natürliche Sprachabfragen wie „Wie lautet der Zählerstand?“ ermöglicht – lieferte in unseren Tests mittelmäßige Ergebnisse bei Felddokumenten, funktionierte gut bei sauberen digitalen Anzeigen, scheiterte jedoch, wenn der Zählerstand handschriftlich in ein Notizfeld eingetragen wurde.
Textracts Tabellenextraktion war nützlich für die strukturierten Teile von Felddokumenten – das gedruckte Raster aus Geräte-IDs und Inspektionsdaten auf einer Checkliste. Seine Handschrifterkennung war sein schwächster Bereich in Feld-Szenarien: handschriftliche Standortprotokolle, Inspektorennotizen und JHA-Gefahrenbeschreibungen lieferten Text mit erheblichen Zeichenfehlern. Thermogedruckte Wiegekarten waren ebenfalls problematisch – der geringe Kontrast von verblasstem Thermopapier führte zu fehlenden Zeichen, die eine allgemeine OCR-Engine nicht wiederherstellen konnte.
Preisgestaltung – pro Seite, ab etwa 0,0015 $ pro Seite – sieht bei geringen Mengen attraktiv aus, kann sich aber summieren. Die Verarbeitung von 500 Felddokumenten pro Monat mit zusätzlichen Vorverarbeitungsschritten (Bildverbesserung, Entzerrung, Kontrastanpassung für Thermopapier) bedeutet Rechenkosten zusätzlich zu den Extraktionskosten, plus Entwicklerzeit für den Aufbau und die Wartung der Pipeline. Zum Vergleich: Unser vollständiger Feldtestdatensatz kostete etwa 0,06 $ für die Verarbeitung durch Textract – günstig für 40 Dokumente, aber die versteckten Kosten sind der Pipeline-Entwicklungsaufwand, der erforderlich ist, um die Ausgabe nutzbar zu machen.
Preisgestaltung (Juni 2026): Preis pro Seite. Erste Stufe ~0,0015 $/Seite für Text- und Formularextraktion. Zusätzliche Kosten für Abfragefunktionen und höhere Mengenstufen.
Docparser — Am besten für Feldberichte mit einheitlichem Format von bekannten Quellen
Am besten für: Feldeinsätze, die ausgefüllte Formulare von einem bekannten Absenderkreis in einheitlichen digitalen Formaten erhalten — tägliche Berichte, die als PDFs von denselben Auftragnehmern per E-Mail kommen, Geräteinspektionsformulare von denselben Wartungsdienstleistern.
Nicht ideal für: Felddokumente mit variablem Format, handschriftlastige Inhalte, Smartphone-Fotos von Papierformularen oder Dokumente, deren Layout sich zwischen Quellen unterscheidet — die vorlagenbasierte Extraktion scheitert stillschweigend bei Formatänderungen.
Docparser verwendet einen zonenbasierten Vorlagenansatz: Sie definieren die Extraktionskoordinaten anhand eines Beispieldokuments, und der Parser extrahiert diese Koordinaten bei jedem weiteren Dokument mit demselben Layout. Das funktioniert, wenn das Format jedes Mal identisch ist — zum Beispiel bei einem täglichen Standortprotokoll als PDF, das von derselben Bauverwaltungssoftware erzeugt wird und bei dem das Feld für die Mannschaftsstärke immer an derselben Position erscheint.
Diese Einschränkung wird im Feldeinsatz zum kritischen Problem. Ein Bauleiter erhält tägliche Protokolle von drei verschiedenen Subunternehmern — jeder verwendet ein anderes Formularlayout mit unterschiedlichen Feldpositionen. Docparser benötigt drei Vorlagen. Wenn ein Subunternehmer sein Formular aktualisiert — eine neue Gerätezeile hinzufügt, den Notizbereich ändert — bricht die Vorlage, und die Extraktion liefert stillschweigend Nullwerte oder fehlerhafte Daten. Der Bauleiter bemerkt das möglicherweise tagelang nicht.
In unserem Testset schnitt Docparser bei maschinengedruckten PDF-Ausgaben von Feldmanagementsystemen (36-KB-PDF-Berichte aus Bauverwaltungssoftware) ordentlich ab, scheiterte jedoch an den per Smartphone fotografierten Papierdokumenten — handschriftliche Standortprotokolle, Inspektionschecklisten, Wiegescheine — die den Großteil der Felddokumentation ausmachen. Die durch die Handyfotografie verursachten Winkel- und Schattenartefakte führten zu einer Fehlausrichtung der Zonenkoordinaten, und die handschriftlichen Inhalte lagen vollständig außerhalb der OCR-Fähigkeiten von Docparser.
Mit einem Einstiegspreis von 32,50 $/Monat ist Docparser die günstigste Option für Feldberichte mit einheitlichem Format aus bekannten digitalen Quellen — aber die betriebliche Einschränkung („nur einheitliches Format“) schließt die meisten Felddokumentationsszenarien aus.
Preise (Juni 2026): Ab 32,50 $/Monat (2.500 Seiten/Jahr). Höhere Tarife für größere Mengen.
Device Magic — Am besten für schnelle Felddatenerfassungs-Bereitstellungen
Am besten geeignet für: Feldteams, die schnell eine mobile Datenerfassungs-App bereitstellen müssen — in Tagen, nicht Wochen — mit Offline-Unterstützung, Fotoaufnahme und GPS-Protokollierung, ohne unternehmensweite Beschaffungszyklen.
Nicht ideal für: Betriebe, die eine KI-Dokumentenextraktion aus Fotos vorhandener Papierformulare benötigen, oder Teams mit komplexer mehrseitiger Formularlogik, die erweiterte bedingte Verzweigungen erfordert.
Device Magic konzentriert sich auf die schnelle Bereitstellung mobiler Feldformulare mit einem webbasierten Formular-Builder und nativen mobilen Apps für iOS und Android. Sein Verkaufsargument ist die Geschwindigkeit: Ein Feldleiter kann morgens ein einfaches Inspektionsformular erstellen, es bis zum Mittagessen auf die Telefone des Teams verteilen und am Nachmittag mit der Datenerfassung beginnen. Die Plattform unterstützt die Offline-Datenerfassung mit automatischer Synchronisierung, Foto-Uploads, GPS-Koordinaten, Zeitstempeln und digitalen Signaturen.
Für kleine bis mittelgroße Feldbetriebe — ein Spezialauftragnehmer, der Sicherheitschecklisten auf der Baustelle implementiert, ein Immobilienverwaltungsunternehmen, das Einzugs-/Auszugs-Inspektionsformulare einführt — machen die Einfachheit und der Preis von 20 $/Benutzer/Monat von Device Magic den einfachsten Einstieg unter den Plattformen zur Felddatenerfassung. Der Formular-Builder verwendet Drag-and-Drop-Felder mit grundlegender bedingter Logik (Fragen basierend auf früheren Antworten ein-/ausblenden), was die Mehrheit einfacher Inspektionsabläufe abdeckt.
Der Kompromiss ist die Tiefe. Device Magic führt keine Dokumentenextraktion an hochgeladenen Bildern durch. Fotos, die über die App aufgenommen werden, sind Beweisanhänge, keine Datenquellen. Der Plattform fehlen außerdem die erweiterte Workflow-Automatisierung, GIS-Integration und ERP-Konnektoren, die Unternehmens-Feldbetriebe benötigen. Es ist ein Werkzeug zur Felddatenerfassung, kein Werkzeug zur Dokumentenextraktion — und diese Unterscheidung ist wichtig für Betriebe, die Daten aus vorhandenen Papierdokumenten extrahieren müssen, anstatt mit digitalen Formularen neu zu beginnen.
Preise (Juni 2026): Ab ca. 20 $/Benutzer/Monat. Kein langfristiger Vertrag erforderlich. Kostenlose Testversion verfügbar.
Welches Felddokument-Extraktionstool passt zu Ihrem Betrieb?
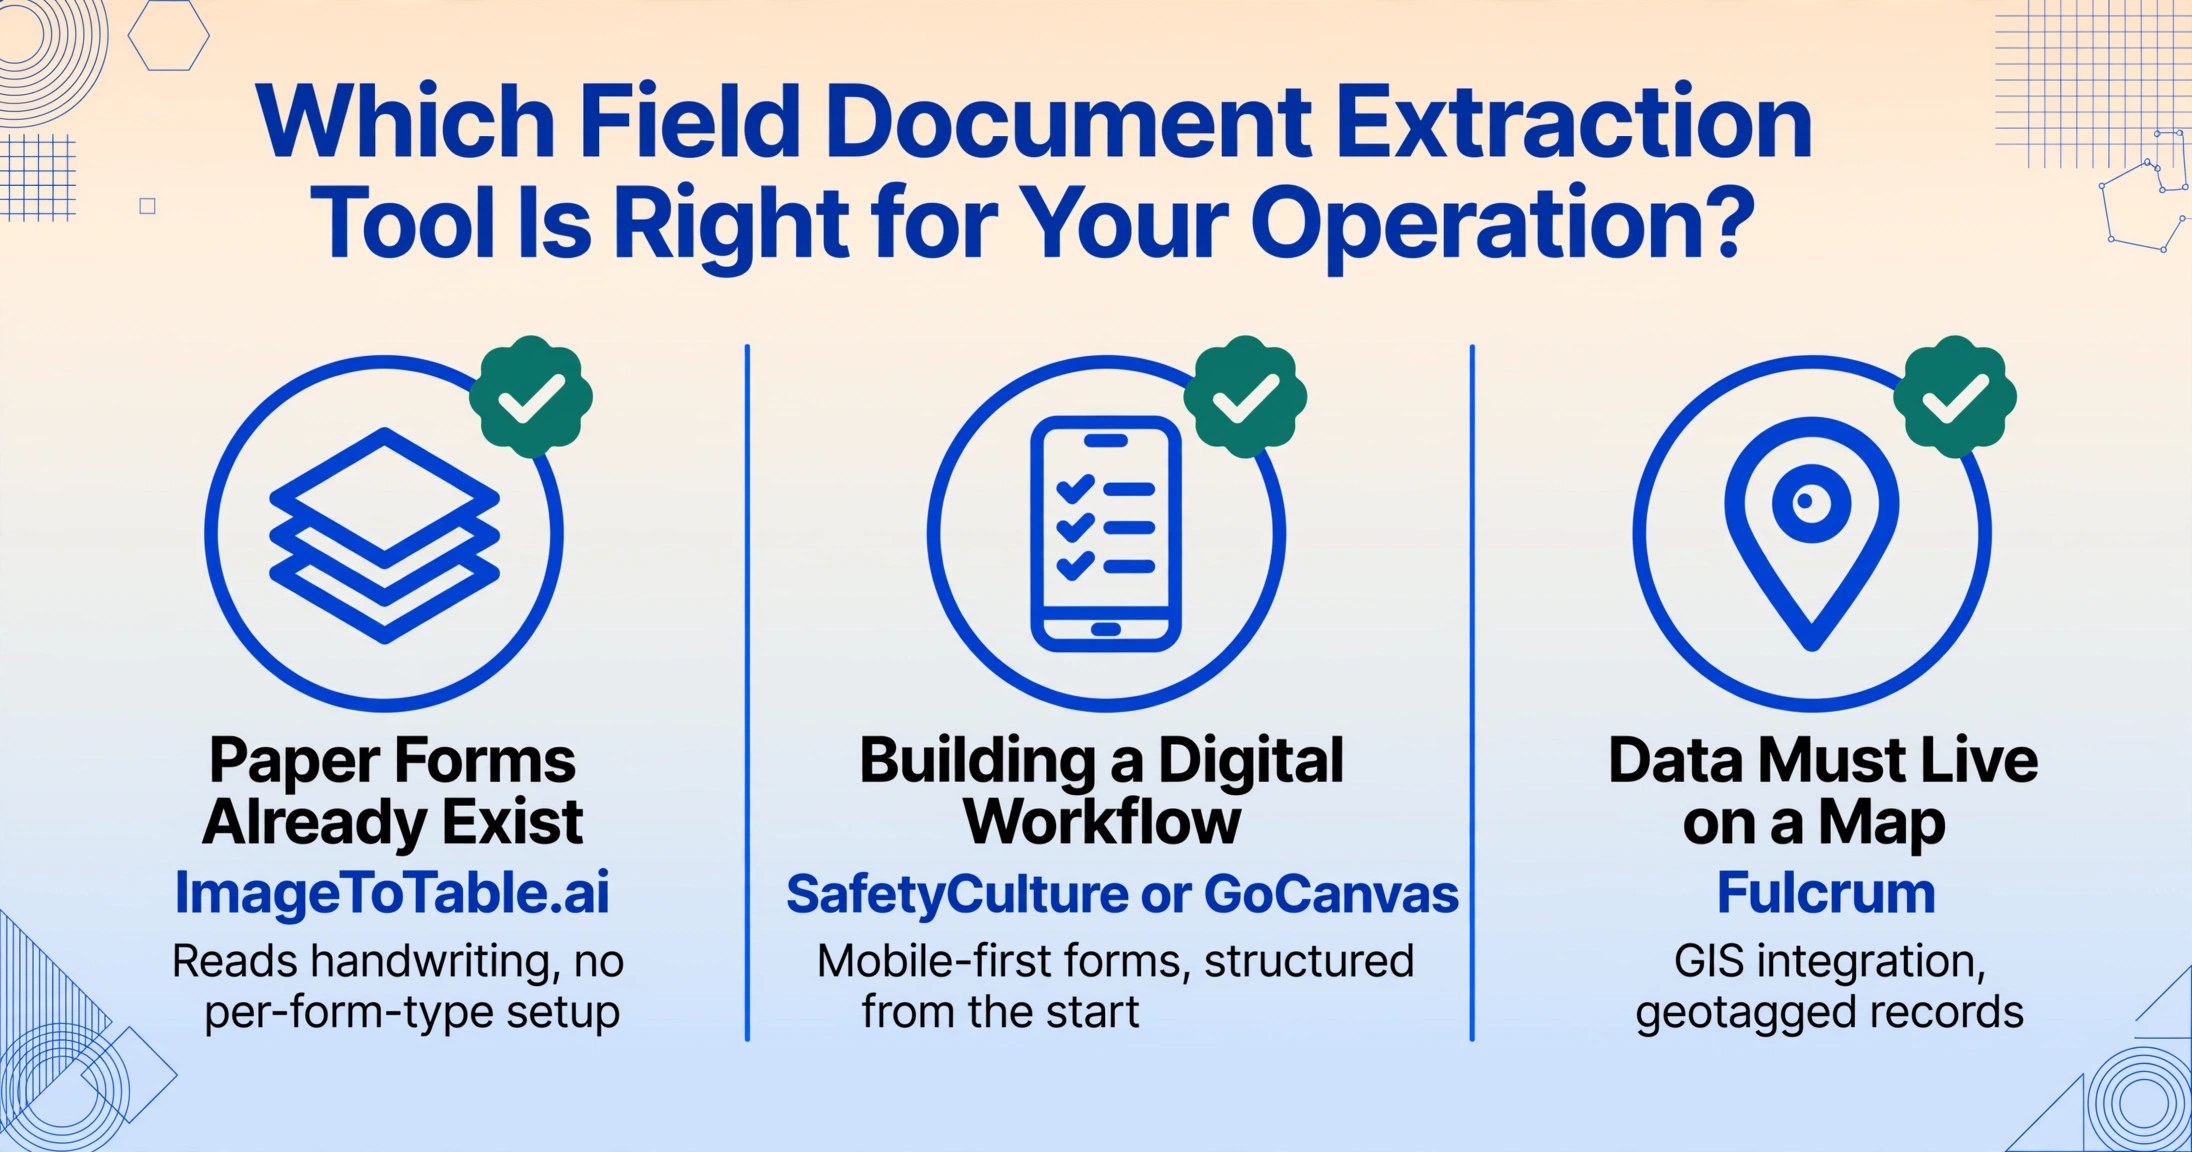
Feldservice-Betriebe unterscheiden sich enorm in Umfang, Dokumentartenmix, technischer Ausstattung und danach, ob das Ziel darin besteht, Papierformulare zu ersetzen oder Daten aus bereits vorhandenem Papier zu extrahieren. Die Auswahl des passenden Tools hängt von zwei Fragen ab: Existieren Ihre Felddokumente bereits auf Papier, oder bauen Sie einen digitalen Workflow von Grund auf auf? Und welche Arten von Felddokumenten verarbeiten Sie?
| Ihr Szenario | Dokumentenmix | Empfohlenes Tool | Begründung |
|---|---|---|---|
| Papierformulare existieren bereits – bestehenden Bestand digitalisieren | Handschriftliche Inspektionschecklisten, JHA-Formulare, Serviceberichte, Standortprotokolle | ImageToTable.ai | Semantische Extraktion liest Handschrift; keine Einrichtung pro Formulartyp; Stapelverarbeitung gemischter Dokumenttypen |
| Aufbau eines neuen digitalen Inspektionsworkflows | Sicherheitsaudits, Geräteprüfungen, Compliance-Inspektionen | SafetyCulture oder GoCanvas | Mobile-First-Formularbuilder; Offline-Erfassung; strukturierte Daten von Anfang an; keine Extraktion erforderlich |
| Felddaten benötigen GIS-Kartierung + Asset-Lifecycle-Tracking | Versorgungsmast-Erhebungen, Pipeline-Inspektionen, Umweltüberwachung | Fulcrum | Beste GIS-Integration ihrer Klasse; Offline-Erfassung; Echtzeitkarte der Inspektionsaufzeichnungen |
| Enterprise-Feldworkflow mit SAP/Salesforce-Integration | Standortübergreifende Feldoperationen mit ERP-verbundenen Workflows | ProntoForms (TrueContext) | Tiefe Enterprise-Integration; robuster Offline-Modus; Workflow-Automatisierung |
| Lieferantendokumente mit variablem Format – Wiegekarten, Subunternehmerberichte | Thermopapierbelege, Durchschläge, handschriftliche Quittungen von externen Quellen | ImageToTable.ai + Sammellink | Formatunabhängige Extraktion für Dokumente, die Sie nicht kontrollieren können; Sammellink für externe Uploads |
| Internes Entwicklungsteam baut kundenspezifische Feldautomatisierung | API-gesteuerte Verarbeitung von Inspektionsfotos und Serviceberichten | Amazon Textract oder Nanonets | API-First-Design; volle Kontrolle über die Pipeline; individuelles Modelltraining für konsistente Formulartypen |
| Konsistente digitale PDF-Berichte von bekannten Auftragnehmern | Digitale Tagesberichte aus derselben Baumanagementsoftware | Docparser | Niedrigste Kosten für vorlagenkonsistente digitale Berichte – nur wenn sich das Format nie ändert |
| Einfache Felddatenerfassung für ein kleines Team | Basis-Inspektionschecklisten, Servicerecords | Device Magic | Schnellste Bereitstellung; einfache Preisgestaltung; ausreichend für einfache mobile Formulare |
Für spezifischere Vergleiche in verwandten Feld- und Industriekontexten finden Sie in unseren Schwesterübersichten für Logistik und Fertigung. Für einen tieferen Fokus speziell auf Zählerstandserfassung siehe die besten Tools zur Zählerstandsextraktion. Und für Betriebe, die prüfen, ob KI Feldmessgeräte zuverlässig aus Smartphone-Fotos lesen kann, bietet unser Kann-KI-Zähler-aus-Foto-lesen-Leitfaden Feldtestdaten.
Die drei feldspezifischen Extraktionsherausforderungen, die die meisten Übersichten übersehen
Basierend auf Tests aller neun Tools zeigten sich drei Muster, die typische Übersichten zu „bester Dokumentextraktion“ nicht behandeln, denen Feldservice-Betriebe jedoch täglich begegnen:
1. Felddokumente werden fotografiert, nicht gescannt – und der Unterschied ist struktureller Natur. Der Testsatz eines Büro-Dokumentextraktors setzt flach gescannte PDFs oder saubere Kameraaufnahmen mit gleichmäßiger Beleuchtung und orthogonaler Perspektive voraus. Felddokumentfotos werden von jemandem aufgenommen, der um 6:30 Uhr auf einem Schotterplatz steht, in einer Hand ein Telefon und in der anderen ein Klemmbrett hält. Die Ergebnisse: abgewinkelte Perspektive (das Formular wird in 40 Grad statt 90 Grad fotografiert); ungleichmäßige Beleuchtung (eine Ecke in voller Sonne, die andere im Körperschatten); Unschärfe durch unzureichende Handstabilisierung; und Artefakte, die für die Feldumgebung spezifisch sind (Schlamm auf der Linse, Kondensation, Regenspritzer). Unter den getesteten Tools enthielten die drei, die bei feldaufgenommenen Fotos am besten abschnitten, alle eine Form der automatischen Bildvorverarbeitung – Kontrastanpassung, Schräglagenkorrektur und Schattenkompensation – vor der Texterkennung. Die Tools, die saubere Eingaben voraussetzten, erzielten bei den verschlechterten Aufnahmeversionen derselben Dokumente Genauigkeitswerte, die 20–30 Prozentpunkte niedriger lagen.
2. Handschrift auf Feldformularen ist kein optionaler Inhalt – sie ist die primäre Aufzeichnung. Bei einer Bürorechnung beschränkt sich Handschrift auf ein Signaturfeld. Auf einer Feldinspektions-Checkliste sind 60–70 % der Daten handschriftlich: die Bestanden/Nicht-bestanden-Urteile des Inspektors, Anmerkungen zum Gerätezustand, Zählerstände, Crew-Stärken, Gefahrenbeschreibungen und Unterschriften zur Abzeichnung. Auf r/FieldService beschreiben Feldtechniker eine Realität, die Anbieter von Extraktionstools nicht ansprechen: „Unsere Leute füllen die Unterlagen am Ende der Schicht im LKW aus – es ist hastig, es ist dunkel, und manchmal ist die letzte Seite der Durchschrift praktisch unlesbar.“ Die Tools, die diese Inhalte in unseren Tests gut verarbeiteten, hatten nicht nur gute Handschrift-OCR – sie hatten Vision-Modelle, die die Semantik von Dokumenten verstanden: den Unterschied zwischen einem Häkchen in einem Bestanden/Nicht-bestanden-Feld und einem versehentlichen Stiftstrich, die Beziehung zwischen der Unterschrift eines Inspektors und den vorhergehenden Feldern, die Fähigkeit, einen Wert von einer Messskala zu lesen, indem der Nadelwinkel relativ zu den Skalenmarkierungen erkannt wird, statt nach Ziffern zu suchen.
3. Thermopapier- und Durchschreibedokumente erfordern eine andere Vorverarbeitung als Standard-OCR. Wiegekarten, Lieferscheine und viele Serviceaufträge im Außendienst werden auf Thermopapier (wärmeempfindliches Papier, das mit der Zeit verblasst) oder auf NCR-Sätzen (No-Carbon-Required) gedruckt, bei denen die dritte Kopie absichtlich kontrastarm ist. Diese Medienarten machen die Annahme „sauberer Text auf weißem Hintergrund“, auf der die meisten OCR-Engines basieren, zunichte. Das Verblassen von Thermopapier ist fortschreitend – eine Wiegekarte, die an der Waage noch lesbar war, kann Tage später, wenn sie im Einkaufsbüro ankommt, teilweise unleserlich sein. Die Lücke zwischen den drei Tools in unserem Wiegekarten-Test war direkt darauf zurückzuführen, ob die Vorverarbeitungspipeline eines Tools kontrastarmen Text verbessern konnte, ohne OCR-Rauschen zu erzeugen. Vorlagenbasierte Tools und einfache OCR-Engines verfügen über keine solche Vorverarbeitung und lieferten unbrauchbare Daten aus den Thermopapier- und NCR-Dokumenten. Für eine detaillierte Untersuchung speziell zur Wiegekartenextraktion finden Sie in unserem Leitfaden zur Wiegekartenextraktion eine ausführliche Behandlung der Herausforderung der Doppelwägung.
FAQ: Extraktion von Außendienst-Dokumenten
Können Tools zur Extraktion von Außendienst-Dokumenten Handschrift aus Inspektionschecklisten und Sicherheitsformularen lesen?
Dies hängt vollständig vom Tool ab. Allgemeine OCR-Tools und vorlagenbasierte Parser können Handschrift in der Regel nicht mit der für operative Daten erforderlichen Genauigkeit lesen – erwarten Sie 35-55% Feldgenauigkeit. Vision-KI-Tools, die große Sprachmodelle (LLMs) für das Dokumentverständnis verwenden – ImageToTable.ai, Nanonets (mit Training) – können Handschrift mit 55-85% Genauigkeit interpretieren, abhängig von Lesbarkeit, Schreibkonsistenz und dem Vorhandensein von Feldkontext (ein Formular mit beschrifteten Feldern hilft der KI, vorherzusagen, was der handschriftliche Inhalt darstellt). Kein Tool erreicht 99% bei allen handschriftlichen Feldinhalten. Der praktische Arbeitsablauf ist: KI extrahiert automatisch Felder mit hoher Konfidenz, Felder mit niedriger Konfidenz werden zur manuellen Überprüfung markiert. Für Außendienstabläufe, die stark handschriftliche Dokumente verarbeiten, empfehlen wir, vor der Entscheidung für ein Tool mit Ihren tatsächlichen Formularen zu testen – unser Leitfaden zur Datenextraktion aus handschriftlichen Formularen führt durch diesen Bewertungsprozess.
Wie wirkt sich die Fotoqualität auf die Extraktionsgenauigkeit bei Felddokumenten aus?
Erheblich. In unseren Tests lag die Genauigkeit bei gut beleuchteten Dokumentversionen im Durchschnitt 15–25 Prozentpunkte höher als bei der Version mit verschlechterter Qualität – und das über alle neun Tools hinweg. Die Hauptursachen für die Genauigkeitsminderung waren: Schatten auf der Dokumentoberfläche (der häufigste Fotofehler im Feld), Schrägperspektive (Fotografieren eines Klemmbretts in einem 40-Grad-Winkel statt direkt von oben) sowie Bewegungsunschärfe durch Handaufnahme ohne Stabilisierung. Tools mit integrierter Bildvorverarbeitung – automatischer Kontrastabgleich, Schräglagenkorrektur, Schattenkompensation – verringerten die Genauigkeitslücke auf 8–13 Punkte. Tools ohne Vorverarbeitung zeigten eine Lücke von 20–35 Punkten. Für kritische Felddaten empfehlen wir: (1) Dokumente nach Möglichkeit auf einer relativ ebenen Fläche fotografieren, (2) gleichmäßige Beleuchtung ohne Körperschatten über dem Formular sicherstellen und (3) das Telefon parallel zur Dokumentoberfläche halten. Für bereits aufgenommene Fotos mit Mängeln sollte ein Tool mit Vorverarbeitung gewählt werden, statt eines, das saubere Eingaben erwartet.
Wie sieht es mit der OSHA-Konformität aus? Kann KI-Extraktion die OSHA-Aufzeichnungspflichten erfüllen?
Die OSHA-Standards Part 1910 (Allgemeine Industrie) und Part 1926 (Bauwesen) regeln die Aufzeichnung von Arbeitsunfällen, Erkrankungen und Sicherheitsinspektionen. OSHA 29 CFR 1904 verlangt von Arbeitgebern, arbeitsbedingte Verletzungen und Erkrankungen im OSHA-300-Protokoll zu erfassen und diese Aufzeichnungen fünf Jahre lang aufzubewahren. OSHA 1926.20(b)(2) verlangt „häufige und regelmäßige Inspektionen der Baustellen, Materialien und Ausrüstung durch befugte Personen“ – und diese Inspektionsaufzeichnungen müssen auf Anfrage verfügbar sein. Für Compliance-Zwecke ist die entscheidende Anforderung Vollständigkeit und Prüfbarkeit der Aufzeichnungen, nicht die Methode der Datenerfassung. Ein KI-extrahierter Inspektionsdatensatz, der das Originalfoto, die extrahierten strukturierten Daten, Zeitstempel, Prüferidentifikation und GPS-Standort bewahrt, bietet argumentativ mehr Prüfpfad als ein Papierprotokollbuch. Allerdings bietet die OSHA derzeit keine spezifische Anleitung zur KI-Extraktion für Compliance-Aufzeichnungen – die Standardanforderung ist, dass die Aufzeichnung genau, vollständig und für den geforderten Zeitraum aufbewahrt wird. Betriebe, die KI-Extraktion für compliance-nahe Aufzeichnungen nutzen, sollten eine statistische Stichprobe der Extraktionen verifizieren und die Original-Quellbilder zusammen mit den extrahierten Daten aufbewahren.
Funktionieren diese Tools offline? Meine Baustellen haben keine Mobilfunkabdeckung.
Die Plattformen zur Datenerfassung im Feld – SafetyCulture, Fulcrum, ProntoForms, GoCanvas, Device Magic – unterstützen alle den Offline-Modus für die formularbasierte Datenerfassung auf mobilen Geräten. Inspektionsdaten, Fotos und Unterschriften werden lokal gespeichert und synchronisiert, sobald die Verbindung wiederhergestellt ist. Die Dokumentextraktionstools – ImageToTable.ai, Nanonets, Amazon Textract, Docparser – bieten keine native Offline-Verarbeitung. Die Extraktion erfordert das Senden des Bildes an eine Cloud-API, was eine Internetverbindung benötigt. Der praktische Workaround für Feldbetrieb ohne Konnektivität ist: Dokumentfotos auf einem mobilen Gerät aufnehmen (mit der Kamera-App, nicht mit dem Extraktionstool), sie in einer Sammelaktion hochladen, sobald Konnektivität verfügbar ist, und sie zu diesem Zeitpunkt durch das Extraktionstool verarbeiten. Sammellink-Konten können auch Uploads von mehreren Feldpunkten empfangen, sobald Konnektivität verfügbar wird. Für Betriebe in durchgehend verbindungslosen Umgebungen ist die Kombination aus formularbasierten Feldplattformen und Batch-Extraktion zum Synchronisierungszeitpunkt der zuverlässigste Ansatz.
Kann ich Wiegebrückenbelege von mehreren Lieferantenstandorten in einer Sammelaktion zu einer Tabelle verarbeiten?
Ja – wenn Sie ein Tool mit formatunabhängiger Extraktion und Batch-Verarbeitungsunterstützung wählen. ImageToTable.ai verarbeitet gemischte Dokumenttypen (Zählerfotos, Wiegebrückenbelege, Inspektionsformulare) in einer einzigen Sammelaktion und führt die Ausgaben in einer Tabelle zusammen. Die wichtigste Anforderung ist, dass das Tool Dokumente nach semantischer Feldbedeutung und nicht nach Vorlagenposition liest – da Wiegebrückenbelege von verschiedenen Lieferantenstandorten völlig unterschiedliche Layouts verwenden. Für einen Beschaffungsbetrieb, der Belege von 12 Zuschlagstoffwerken erhält, würde ein vorlagenbasiertes Tool 12 separate Vorlagen erfordern, die jedes Mal gewartet werden müssten, wenn eine Wiegestation ihre Software aktualisiert. Eine detaillierte Anleitung finden Sie in unserem Leitfaden zur Sammel-Extraktion von Wiegebrückenbelegen. Der Leitfaden zur Automatisierung der Zählerstandserfassung in Excel behandelt denselben Batch-Workflow für die Ablesung von Versorgungszählern.
Ersetzen diese Tools eine CMMS- oder FSM-Plattform?
Nein – und das ist auch nicht ihr Zweck. Dokumentextraktionstools und Field-Service-Management-Plattformen (FSM) lösen unterschiedliche Probleme. FSM-Plattformen (ServiceMax, IFS, Salesforce Field Service, Corrigo) übernehmen Planung, Einsatzdisposition, Arbeitsauftragsverwaltung, Techniker-Tracking und Rechnungsstellung. Dokumentextraktionstools adressieren den spezifischen Engpass, Daten aus Papier- oder fotografierten Felddokumenten in strukturierte digitale Datensätze zu überführen. Die praktische Architektur für die meisten Betriebe ist: Felddokumente werden erfasst (per Telefon oder Papier) → durch ein Dokumentextraktionstool in strukturierte Daten extrahiert → als digitale Inspektionsprotokolle oder Arbeitsauftragseingaben in die FSM-/CMMS-Plattform eingespeist. Einige FSM-Plattformen (SafetyCulture, Fulcrum) bieten strukturierte Datenerfassung als Funktion an, aber sie erfassen Daten, die Techniker in Formulare eingeben – sie extrahieren keine Daten aus vorhandenen Papierdokumenten. Für einen Feldbetrieb mit gemischtem Workflow (einige digitale Formulare, einige Papierdokumente) ist die Kombination aus einer Felddatenerfassungsplattform und einem Dokumentextraktionstool oft die richtige Lösung.
Was kostet die Extraktion von Felddokumenten im Vergleich zur manuellen Dateneingabe?
Die manuelle Dateneingabe für Felddokumente verursacht zwei Kosten: die Zeit, die Feldarbeiter für das Schreiben der Daten auf Papier aufwenden (Teil ihrer Arbeit) und die administrative Zeit, die für die Eingabe dieser Daten in eine Tabellenkalkulation oder ein System aufgewendet wird (zusätzlich). Letzteres ist die Kosten, die die Extraktion ersetzt. Für einen mittelgroßen Versorgungsbetrieb, der 500 Feldinspektionsformulare pro Monat verarbeitet, beansprucht die administrative Dateneingabe typischerweise 40-60 Arbeitsstunden bei $18-25/Stunde, also etwa $720-1.500 pro Monat. Bei diesem Volumen deckt der ImageToTable.ai-Plan für $19-39/Monat das Extraktionsvolumen ab (500 Seiten im $19-Plan). Die Nettoeinsparung beträgt grob $700-1.400 pro Monat – aber nur, wenn die Extraktionsgenauigkeit hoch genug ist, sodass die Verifizierungszeit die Arbeitseinsparung nicht aufwiegt. Bei stark handschriftlichen Vorgängen empfehlen wir, die Genauigkeit anhand einer Stichprobe Ihrer tatsächlichen Dokumente zu testen und die Verifizierungszeit bei Ihrer geschätzten Genauigkeitsrate zu berechnen, bevor Sie einen Kostenvergleich anstellen.
Methodik-Hinweis: Die Genauigkeitsangaben in diesem Artikel basieren auf unseren Tests von 40 feldaufgenommenen Dokumentbildern mit 9 Tools im Juni 2026. Testbedingungen: Alle Tools wurden mit ihrer Standardkonfiguration bewertet, auf einem Mittelklasse-Android-Smartphone (Samsung Galaxy A54) und der Rückkamera des iPhone 14. Verschlechterte Lichtbedingungen umfassten simulierten Schatten, 30-Grad-Schrägaufnahme und schwaches Umgebungslicht. Für Nanonets testeten wir zusätzlich ein Modell, das mit 15 beschrifteten Bildern pro Formulartyp trainiert wurde; die untrainierten Genauigkeitswerte sind als Basislinie aufgeführt. Die Genauigkeitsspannen spiegeln die besten und schlechtesten Ergebnisse in unserem Testsatz wider und schließen vollständige Extraktionsfehler aus, bei denen ein Tool für ein bestimmtes Feld keine verwertbaren Daten lieferte. Einzelne Ergebnisse variieren je nach Bildqualität, Dokumentzustand, Lesbarkeit der Handschrift und spezifischem Formularlayout. Alle Preisdaten stammen von öffentlichen Preisseiten im Juni 2026. Zum Vergleich: Die manuelle Dateneingabe handschriftlicher Feldformulare wird auf $18-25/Stunde geschätzt, basierend auf Daten des US-Büros für Arbeitsstatistik für Datenerfasser (43-9021) Stand Mai 2025.
Überzeugen Sie sich selbst: Testen Sie die Feldextraktion
Laden Sie ein Foto eines Felddokuments hoch – eine Inspektionscheckliste, ein Standortprotokoll, einen Waagenschein, einen Zählerstand – und sehen Sie, was die KI in Sekunden extrahiert. Kein Konto erforderlich, keine Vorlageneinrichtung, keine Trainingsdaten.
Keine Anmeldung erforderlich. Dateien werden sicher verarbeitet und nach der Extraktion gelöscht.