AIが長い法的文書で幻覚を起こす理由
そしてすべてのフィールドを検証する方法
汎用AIアシスタントは現在、200ページの融資契約書を丸ごと収められるコンテキストウィンドウを備えて販売されています。問題が始まるのは、文書がそのウィンドウより長い場合です。ツールが取る対処法は要約であり、契約書の要約は契約書ではありません。その要約からこぼれ落ちた値は、空白で返ってくるのではありません。もっともらしく返ってくるのです。
「モデルが読める」と「モデルを信頼できる」の間には、測定可能な隔たりがあります。スタンフォード大学RegLabが主要な法務AIリサーチツール(Lexis+ AIやWestlawのAI-Assisted Researchを含む)を評価したところ、すべてのベンダーが検索を解決策として売り込んでいるにもかかわらず、クエリの17%から33%で捏造された回答または根拠誤りの回答が返ってくることが判明しました(スタンフォードHAI)。これらのツールは法律に関する質問に答えるものです。そのエラーの背後にあるメカニズムは、あなたの契約書から抽出されたフィールドを破損させるものと同じです。
重要なポイント
- 200ページの契約書を収められるコンテキストウィンドウは、幻覚問題が解決されたかのように聞こえますが、すべてのベンダーが検索を解決策として売り込んでいます。
- 主要な法務AIツールは、スタンフォード大学の評価でクエリの17%から33%において、依然として捏造された回答または根拠誤りの回答を返しました。圧縮された文書からこぼれ落ちた値は、モデルが実際に読んだ値とまったく同じように見えるからです。
- 文書を読み直しても見つけることはできません。したがって検証とは、すべてのセルをそのソースに遡って指し示すことを意味し、ImageToTable.aiはレビューモードでそれを実現します。
法務チームはすでにこの実験を大規模に実施しています。ILTAの2024年テクノロジー調査では、37%の法律事務所が業務に生成AIを使用していると報告し、前年から22ポイント増加しました。最も多く挙げられた用途は、リサーチ(73%)、要約(70%)、初稿作成(69%)でした(ILTA)。要約こそが、この記事が扱う問題を生み出す操作です。捏造された値がどこで生まれ、どのフィールドに最初に影響するのか、そしてドキュメントが一度に読み切れないほど長い場合、「すべてのフィールドを検証する」ことが実際に何を意味するのかを説明します。
捏造された値はどこから来るのか
幻覚フィールドとは、モデルが実際には読んでいない値を、その位置に通常現れるものから再構成し、実際に読んだ値と同じ確信度で返すものです。アシスタントに180ページの契約書から責任上限額、通知期間、準拠法を抽出するよう依頼すると、きれいな行が返ってきます。上限額は上限額らしく見えます。通知期間はきりのいい数字です。準拠法は、この種の取引で通常選ばれるものです。しかし、それらのどれもが値がページに存在することを証明しません。なぜなら、ソースを見失ったモデルは、自分がソースを見失ったことに気づかないからです。
購入者はまさにこの点についてすでに不安を抱いています。AIベンダーのデューデリジェンスに関するr/legaltechのスレッドで、あるレビュアーは証拠を求めたが得られなかったと述べています:「ベンダーは『精度99%』と主張しますが、デューデリジェンス中に証拠を求めると、『自分でテストしてください』と言うだけです。」(r/legaltech)。不満はツールが役に立たないということではありません。検証の負担が、照合する基準がないまま購入者にのしかかるということです。この記事の残りの部分では、その負担を実際に実行できるチェックに変える方法について説明します。
長い法律文書が実際に処理される仕組み
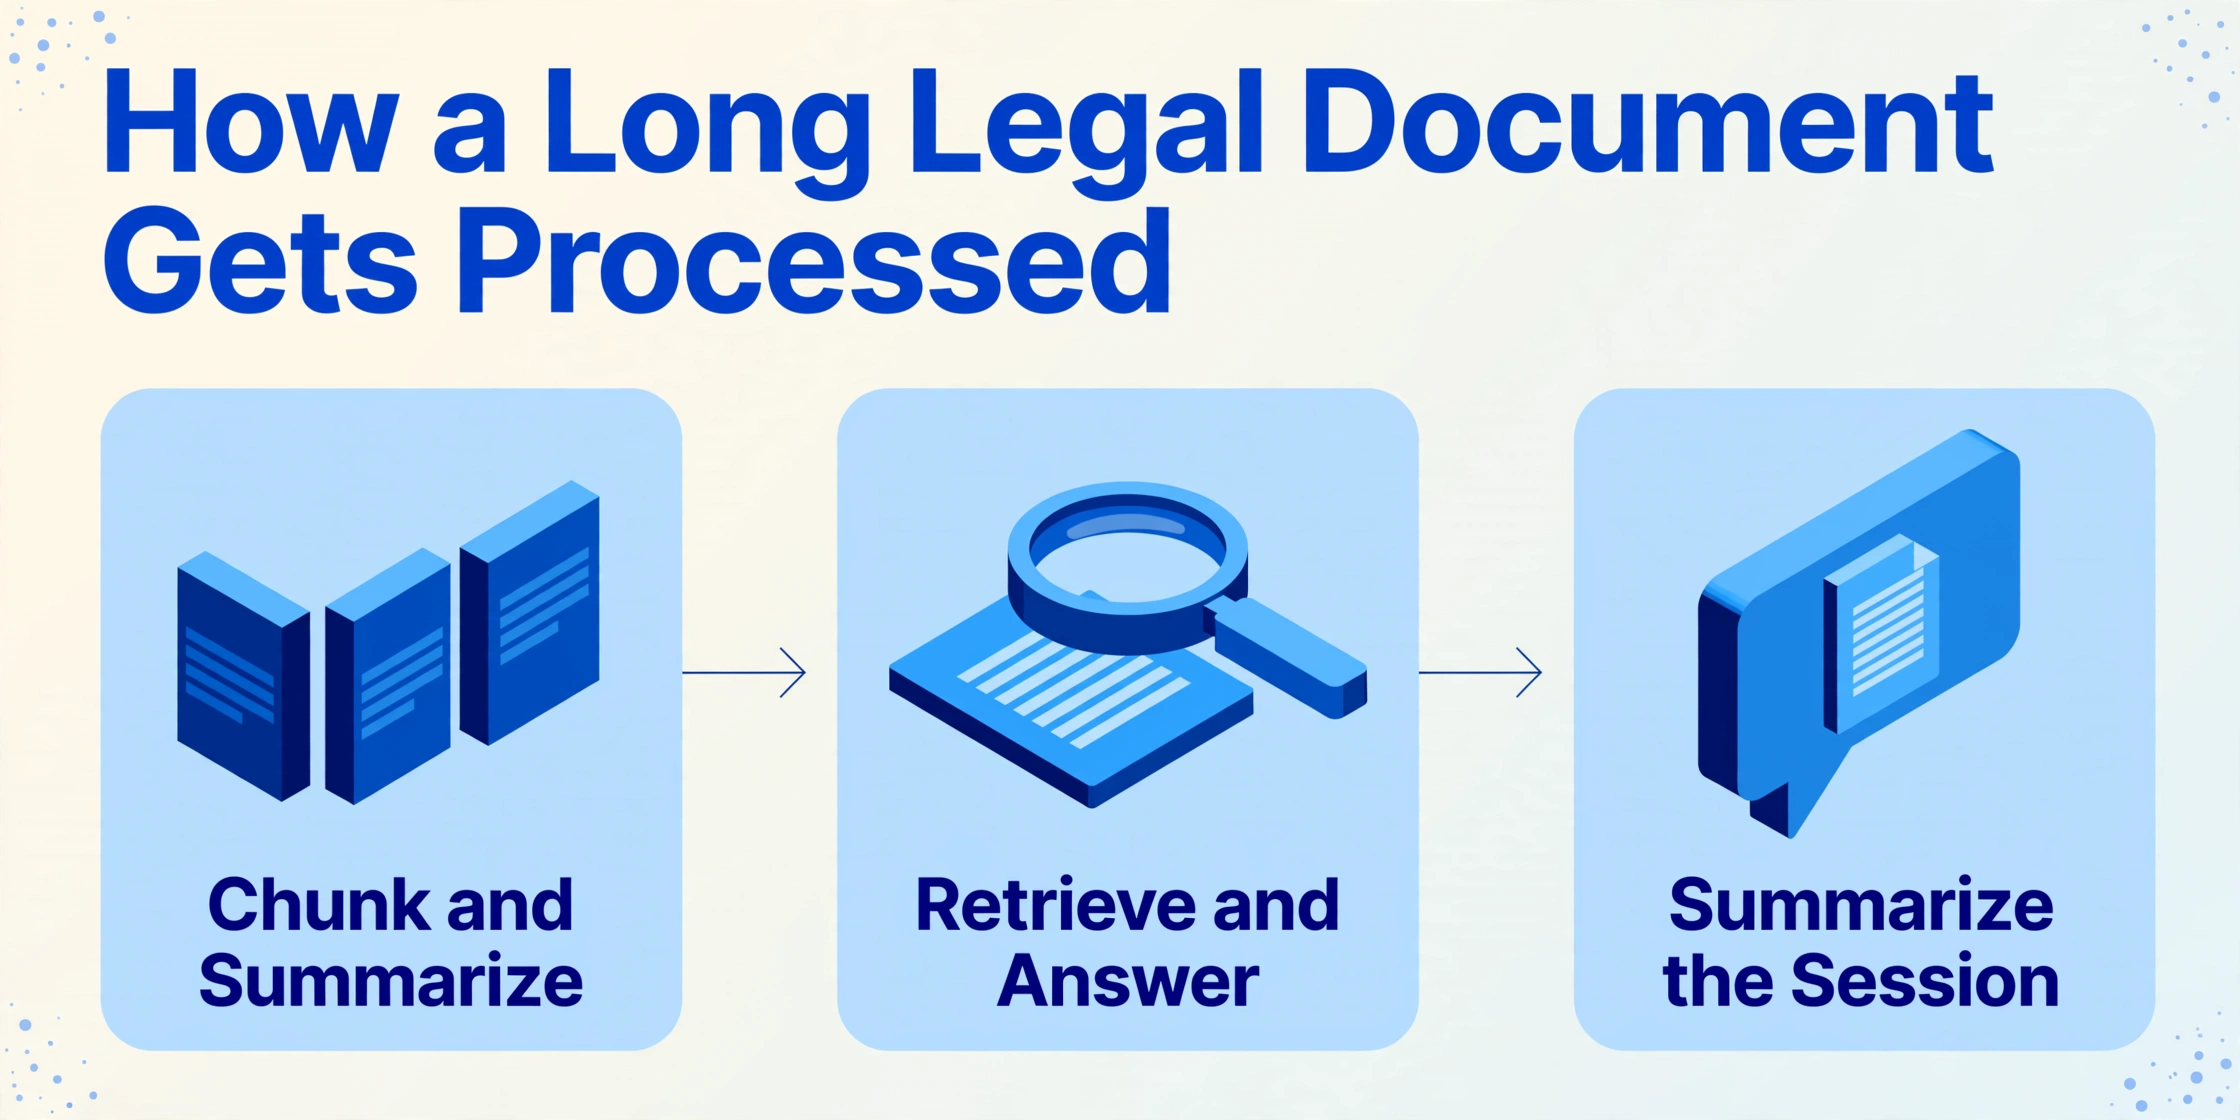
400ページの文書を読めるとうたうツールは、たいてい小さな読み取りを縫い合わせるパイプラインのことを指しており、その縫い合わせの部分で値が変わります。モデルは人間のように読みません。テキストはトークンに分割され、コンテキストウィンドウ、つまりモデルが一度に保持して考慮できる固定量のテキストに配置されます。文書がそのウィンドウより長い場合、システムは3つの回避策のいずれかに頼りますが、そのどれもが完全な文書をより小さな代替物に置き換えます。
チャンク化して要約する
文書は複数の断片に分割され、各断片が要約され、その要約が結合されます。フィールド値は元のページからではなく、要約から抽出されます。
取得して回答する
文書はインデックス化され、各フィールドに関連しそうな箇所だけが取得されて回答が構築されます。これが検索拡張生成、すなわちRAGの実際の意味です。適切な箇所が取得されなければ、モデルはそれを参照せずに回答します。
セッションを要約する
チャット型アシスタントには、見落とされがちな経路があります。長いセッションがコンテキストウィンドウを埋めると、一部のツールは以前の会話を要約して続行します。チャットとしては妥当です。しかし、責任を持って扱わなければならない文書の場合、ツールが推論の根拠とするのはその要約になります。
これらのステップのどれもバグではありません。長い文書を処理するには、そもそもこのような方法が必要です。重要なのは、これらのいずれかが機能すると、ツールはもはやあなたの契約書を読んでいないということです。ツールは、その代わりとなる小さなもの、つまり代替物を読んでおり、その代替物の隙間こそ、捏造された値が入り込む場所です。長い文書を読む際の限界については、AIがマルチページPDFでできることとできないことのガイドで詳しく説明しています。このカテゴリに初めて触れる方は、契約データ抽出とは実際には何かの解説で、失敗モードの前に基礎を固めてください。
圧縮がランダムな誤りではなく、もっともらしい誤りを生む理由
圧縮されたビューに値が欠けている場合、モデルは空白のままにしません。その種類のドキュメントにとって最も可能性の高い値でスロットを埋めます。これはまさに、注意深い読者でも気づかない種類の誤りです。研究者はこのパターンを詳細幻覚と呼びます。出力は構造的に大まかに正しいままですが、結果を左右するパラメータ(しきい値、単位、範囲、義務の強さ(「shall」と「should」)、およびそれをトリガーする条件)を静かに破壊します。長い規制文書の調査では、この詳細レベルの忠実度はコンテキストが増えるにつれて低下し、誤り率は短い入力の0.22から長い入力の0.36へと上昇し、64%の劣化が見られました(arXiv)。
法律業務において、これらは表面的な誤りではありません。「shall」と「should」の違いは、義務が必須かどうかを決定します。「第4.2条に規定される場合を除く」のような限定句が脱落すると、狭い例外が一般的なルールに変わります。上限額の置き換えはクライアントのエクスポージャーを変えます。それぞれが読まれても見逃されます。なぜなら、それぞれが本物の値のように読めるからです。スタンフォードの評価は、ここで借用する価値のある線引きを示しています。抽出された値は捏造された(ドキュメントにまったく存在しない)か、根拠誤り(テキストは存在するが、ツールが主張することを言っていない)のいずれかです。後者は、ソースが本物でフィールドが根拠付けられているように見えるため、見つけるのがより困難です。
圧縮が最初に壊すフィールド
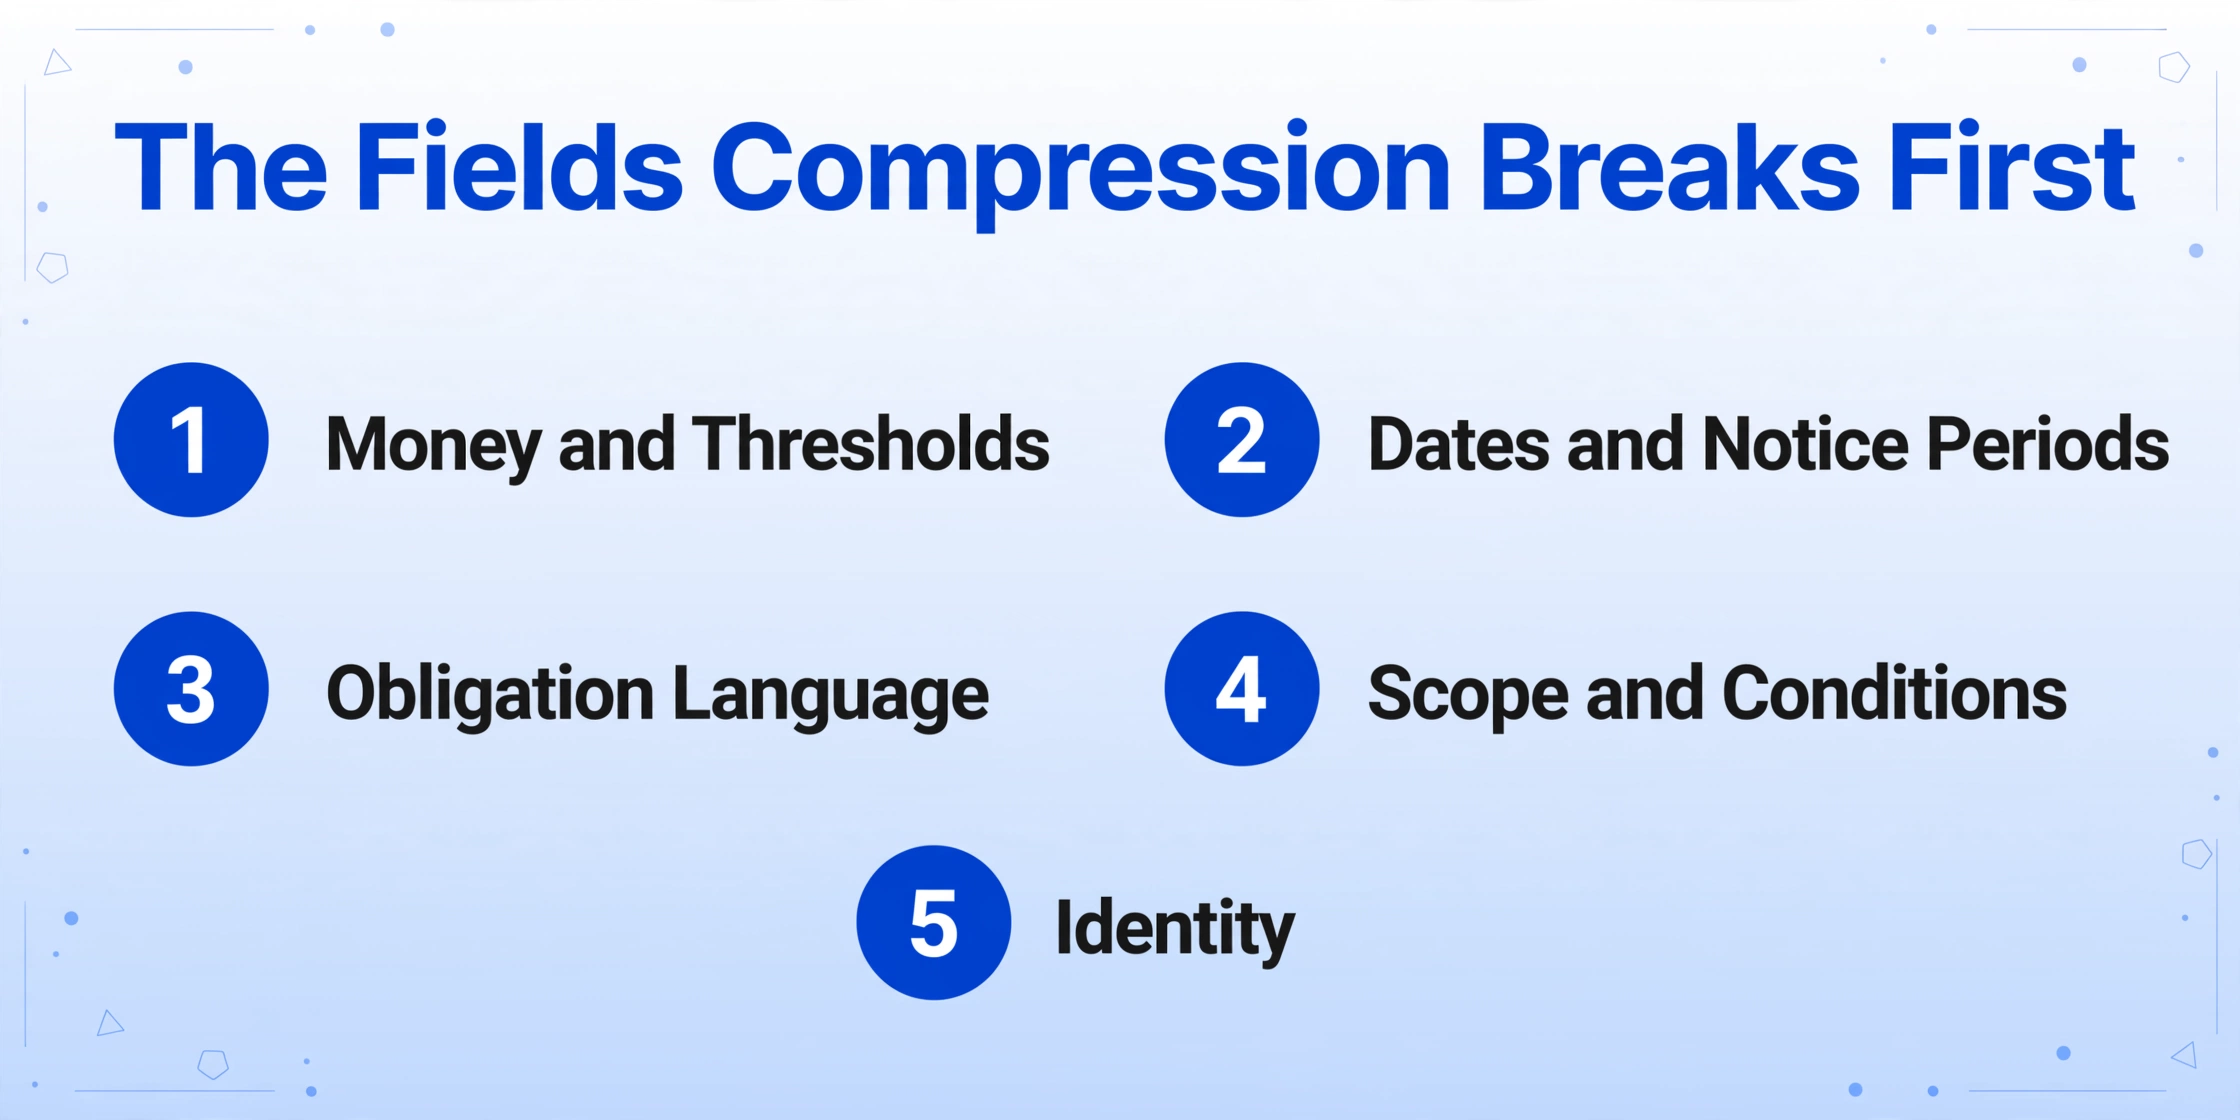
圧縮はすべてのフィールドに均等にダメージを与えるわけではありません。誤って返される可能性が最も高いのは、もっともらしい代替値が生成しやすく、目で見つけにくいフィールドです。これは、法律文書においては、小さく予測可能なセットです。
| フィールドタイプ | 圧縮による影響 | 照合すべき内容 |
|---|---|---|
| 金額と閾値(責任上限、手数料、割合) | 一般的な丸い値で埋められる、または桁がずれる。モデルの条項タイプに対する事前知識がページの内容を上書きすることがある | 条項と数値を一字一句正確に |
| 日付と通知期間 | 発効日、修正日、署名日が一つにまとめられる | 日付が示すマイルストーンと、後続の文書で変更されたかどうか |
| 義務に関する文言 | 「shall」と「should」の区別が失われ、例外条項が削除される | コンマ以降の限定句を含む完全な文 |
| 範囲と条件(「50マイル以内」「規定に基づく場合を除く」) | 条項を制限する条件が削除される | 見出しとなる用語だけでなく、条件句全体 |
| 当事者情報(準拠法、相手方、当事者の役割) | モデルが最も多く見てきた法域や名称にデフォルト設定される | 前文と準拠法条項を記載のまま確認 |
これらのフィールドに共通点があることに注目してください。それぞれに、正しい値も退屈で、間違った値も退屈です。だからこそ、ざっと目を通しただけでは見逃されてしまうのです。また、チェックの順序が重要な理由でもあります。数値と義務に関するフィールドから始めてください。これらのエラーがエクスポージャーを生むからです。
修正条項とレッドラインは、専用のチェックが必要です。置き換えられた数値は、スキャンされた執行済みコピー上で高い可読性を保つことがあり、部分的なビューから作業するモデルには、どのバージョンが優先されるかを確実に判断する手段がありません。法的文書では同じフィールドが正当に複数回出現し、異なる値での繰り返し出現は、まさに圧縮が最も苦手とするケースです。
「すべてのフィールドを検証する」に実際に必要なこと
長いドキュメントでは、すべてのフィールドを検証するということは、抽出された各値をソース内の特定の場所に強制的に結び付けることを意味します。そうすることで、誤った値は、それが読めるかどうかではなく、その値が指し示す場所によって検出されます。ドキュメントを読み直すことはツールの目的を無効にし、また、読み直すことこそが、根拠誤りの値が見逃される原因になります。なぜなら、テキストを置き換えた値は、テキストと同じくらい説得力があるように見えるからです。この種の検証が可能になる前に、2つのことが真実である必要があります。つまり、必要なフィールドを正確に把握していることと、ツールが各値の出所を表示できることです。
処理前にフィールドを指定する
ドキュメントに列を決めさせるのではなく、必要なフィールドを入力します。「責任限度額」「通知期間」「準拠法」「発効日」などです。これがカスタム列抽出の意味です。AIがドキュメントを読み取り、ページ上の固定位置ではなく意味に基づいて各値を見つけ、入力した列名が出力テーブルのヘッダーになります。検証の価値は、チェック対象セットが事前に固定されることです。180ページすべてを監査するのではなく、指定したフィールドのみを監査します。
すべてのセルにソースの場所を要求する
レビューモードは、値の出所を表示します。抽出されたセルにホバーまたはクリックすると、元のページの該当領域がハイライトされます。ページ上の領域をクリックすると、対応するセルにジャンプします。フィールドを編集した場合、ツールはAIの元の値を保持するため、比較または元に戻すことができます。長いドキュメントでは、これにより「すべてのフィールドを検証する」という願望が行動に変わります。つまり、読み直すのではなく、値が主張する場所にあることを確認するのです。
必要になる前にマップを有効にする
ソースの場所は、単一ファイルに対してオンデマンドで生成することも、アカウントを設定して処理されたすべてのドキュメントに自動的に注釈を付けることもできます。後から生成する場合、抽出が完了した瞬間にレビューファイルが準備できることになり、スピードが自動化の理由である場合に重要です。
リスクの高い順に作業する
上記の表を使用して、数値、義務、バージョンに敏感なフィールドを最初にクリアします。それらが確定すれば、残りのメタデータの承認は迅速に行えます。名前や日付から始まる検証パスは、リスクを伴うフィールドに到達する前に注意力を消耗させます。
ファイルは安全に処理され、保存されません。
列の整列、行数、欠落フィールドの監査、数値・日付の検証、手作業での修正ではなく再抽出すべきケースなど、より広範な検証手順については、7項目の抽出QAチェックリストで説明しています。パイプライン内でレビューゲートをどこに置くべきかは、ヒューマン・イン・ザ・ループのワークフローで解説しています。また、複数のドキュメントにまたがるチェックについては、クロスドキュメント整合性のウォークスルーで、1つのシート上で比較する方法を示しています。これらの前提となるのは、すべての値が元のソースに遡って指し示せることです。圧縮によってこれがより重要になっています。
この検証でまだできないこと
ソース接地は、値がどこから来たのかを示します。条項が執行可能かどうか、その後の修正で有効かどうか、クライアントがどう対処すべきかは示しません。抽出ツールがそれを変えることはありません。ソースの場所は証拠であり、法的な結論ではありません。ツールは「90日」がセクション12.3に記載されていることを示せます。しかし、アップロードしていないサイドレターの後もその通知期間が適用されるかどうかは教えてくれません。
一部の失敗はツールの範囲外にあります。重要な数値が別紙、以前の修正、またはアップロードに含まれていないサイドレターにある場合、ソース接地では見つけられません。そこに存在しないからです。完全なパッケージを送信し、同じ契約が複数のファイルに分かれている場合は、レビュー前に1つのレコードにまとめてください。ソース自体が品質の低いスキャンの場合、その上のすべてのレイヤーが問題を引き継ぎます。そのため、クリーンな読み取りは優れたOCRから始まります。法的文書には独自の要件があり、法的文書のOCRガイドで説明しています。また、空白は失敗ではありません。「存在しない」と報告されたフィールドは、行を埋めるために作られたもっともらしい値よりも安全です。次の人にテーブルを信頼するのではなくドキュメントを見るように伝えるからです。
その義務がツールに移るわけでもありません。ABAモデルルール1.1、コメント8は、関連技術の利点とリスクを弁護士の能力義務の範囲内に位置づけており、米国の約40の法域がその文言の一部を採用しています(ABA)。実務家も同じように解釈しています:「AIは私が弁護士である責任をなくすものではありません。あなたの名前が入る案件に関わるなら、引用を探して読んでください。」(r/legaltech)。ツールを比較するとき、レビュー対応の抽出ツールとブラックボックスを分ける問いは、すべてのフィールドにソースの位置情報を返すかどうかです。きれいなテーブルだけを返すツールでは確認すべき対象が何もありません。これは、eディスカバリプラットフォームとフィールド抽出の比較を読むときや、小規模な法務チーム向けのドキュメント抽出オプションを検討するときに覚えておく価値があります。
よくある質問
AIツールは短い文書より長い法律文書で幻覚を起こしやすいのはなぜですか?
長い文書はモデルが一度に保持できるテキスト量を超えるため、システムは全体を読む代わりに要約や検索を行います。その圧縮されたビューにない値は、その位置に通常現れるものから再構築されます。長文コンテキストのドキュメントに関する研究では、入力が長くなるにつれて詳細レベルの正確性が全体的な正確性よりも速く低下することが判明しています。
より大きなコンテキストウィンドウで問題は解決しますか?
閾値は上がりますが、問題はなくなりません。ドキュメントがウィンドウを超えることは依然としてあり、チャット型アシスタントは会話を続けるために古いテキストを要約し続け、コンテキストが増えると限界に達する前からモデルの動作は劣化します。大きなウィンドウは余裕として捉え、保証としては捉えないでください。
重要なフィールドだけを検証して残りをスキップしてもいいですか?
すべてを検証するか全くしないかではなく、リスクに基づいてフィールドを選んでください。数字、義務に関する文言、発効日と改正日のようなバージョンに敏感なフィールドは慎重なチェックに値します。リスクの低いメタデータはすぐに確認できます。どのフィールドが重要かの判断は事前に行って文書化し、ツールに任せないでください。
契約書全体を読まずに、抽出された契約値を検証するにはどうすればいいですか?
ソース接地を使用してください。ツールに各値の元ページ上の位置を表示させ、ドキュメントを再読する代わりに、値が主張する場所にあることを確認します。ImageToTable.aiでは、レビューモードが抽出された任意のセルのソース領域をハイライトし、処理後に自動的に注釈を付けるようにドキュメントを設定できます。
AI契約抽出はレビューなしで使えるほど正確ですか?
当社のツールを含め、法的または金銭的エクスポージャーを伴うドキュメントのフィールドレベルの出力をチェックする必要性をなくすツールはありません。当社の抽出は印刷されたテーブルデータで最大99%の正確性に達しますが、責任あるワークフローでは依然として高リスクのフィールドをソースと照合します。どのベンダーの「幻覚なし」という主張も、引用のない正確性の数字に適用するのと同じ懐疑心で扱ってください。
フィールドが空で返ってきたらどうすればいいですか?
条項が本当に存在しないかどうかを確認し、存在しない場合は空のままにしてください。「存在しない」とフラグが付けられた空白は、行を埋めるためにでっち上げたもっともらしい値よりも有用です。なぜなら、次の担当者にテーブルを信頼するのではなくドキュメントを確認するよう伝えるからです。
重要なテスト
法務AIワークフローの有用な指標は、初回実行時にテーブルがどれだけ見栄えするかではありません。テーブルの任意のセルを選び、ワンステップでページ上の正確な出所を示せるかどうかです。圧縮がそのステップを必要にさせるのは、すべての長文書の回避策が契約書をより小さな代替物に置き換えるからです。ソース接地がそれを可能にします。最も間違えたくないフィールドから始めて、ツールがそこに導けるかどうかを確認してください。
すでによく知っている契約書を1つ選び、間違えたくない4つのフィールドを抽出し、それぞれをソースの場所と照合してください。この1回のパスで、マーケティングページの正確性の主張よりも、ツールについて多くのことがわかります。