Por que a IA alucina em documentos jurídicos longos
e como verificar cada campo
Assistentes de IA de uso geral agora são vendidos com janelas de contexto grandes o suficiente para conter um contrato de crédito de 200 páginas. O problema começa quando o documento é mais longo que a janela, porque a solução que a ferramenta adota é resumir, e um resumo de um contrato não é um contrato. Um valor que sai desse resumo não volta em branco. Ele volta plausível.
A diferença entre "o modelo consegue ler" e "o modelo é confiável" é mensurável. Uma avaliação do Stanford RegLab das principais ferramentas de pesquisa jurídica com IA, incluindo Lexis+ AI e AI-Assisted Research da Westlaw, constatou que elas ainda retornavam respostas fabricadas ou mal fundamentadas em 17% a 33% das consultas, mesmo com todos os fornecedores vendendo a recuperação como a cura (Stanford HAI). Essas ferramentas respondem perguntas sobre a lei. O mecanismo por trás dos erros delas é o mesmo que corrompe um campo extraído do seu contrato.
Principais Conclusões
- Uma janela de contexto grande o suficiente para conter um contrato de 200 páginas parece resolver o problema da alucinação, e todos os fornecedores vendem a recuperação como a cura.
- As principais ferramentas jurídicas com IA ainda retornavam respostas fabricadas ou mal fundamentadas em 17% a 33% das consultas em uma avaliação da Stanford, porque um valor que sai de um documento comprimido parece exatamente um que o modelo realmente leu.
- Reler o documento não vai resolver, então a verificação precisa apontar cada célula de volta à sua fonte, o que o ImageToTable.ai faz no Review Mode.
As equipes jurídicas já estão executando este experimento em escala. Na pesquisa de tecnologia de 2024 da ILTA, 37% dos escritórios informaram usar IA generativa para tarefas de negocio, um aumento de 22 pontos em relação ao ano anterior, e os principais usos que citaram foram pesquisa (73%), resumos (70%) e primeiros rascunhos (69%) (ILTA). A sumarização é exatamente a operação que cria o problema sobre o qual trata este artigo. Aqui é onde nasce o valor fabricado, quais campos ele ataca primeiro, e o que "verificar cada campo" realmente tem que significar quando o documento é longo demais para ser lido de uma vez.
De Onde Viene um Valor Fabricado
Um campo alucinado é um valor que o modelo nunca leu, reconstruido a partir do que normalmente aparece nessa posição e devolvido com a mesma confianza que um valor que ele leu. Pida a um assistente que extraiga o limite de responsabilidade, o período de aviso prévio e a lei aplicable de um acordo de 180 páginas, e ele devolverá uma linha limpa. O limite parece um limite. O período de aviso prévio é um número redondo. A lei aplicable é o que acuerdos como este normalmente escolhem. Nada disso prova que os valores estão na página, porque um modelo que perdiu de vista a fonte não sabe que a perdiu de vista.
Os compradores já estão inquietos exatamente por isso. Em um fio de r/legaltech sobre due diligence de fornecedores de IA, um revisor descreviu pedir evidencia e não receber nada: "Os fornecedores afirmam '99% de precisão', mas quando pedimos prova durante a Due Diligence, eles basicamente dizem, 'Teste você mesmo.'" (r/legaltech). A queixa não é que as herramientas sejam inútiles. É que a carga de verificación recae sobre o comprador sem nada contra o que verificar. O resto deste artigo trata de transformar essa carga em uma verificação que você realmente possa executar.
Como um Documento Jurídico Longo É Realmente Processado
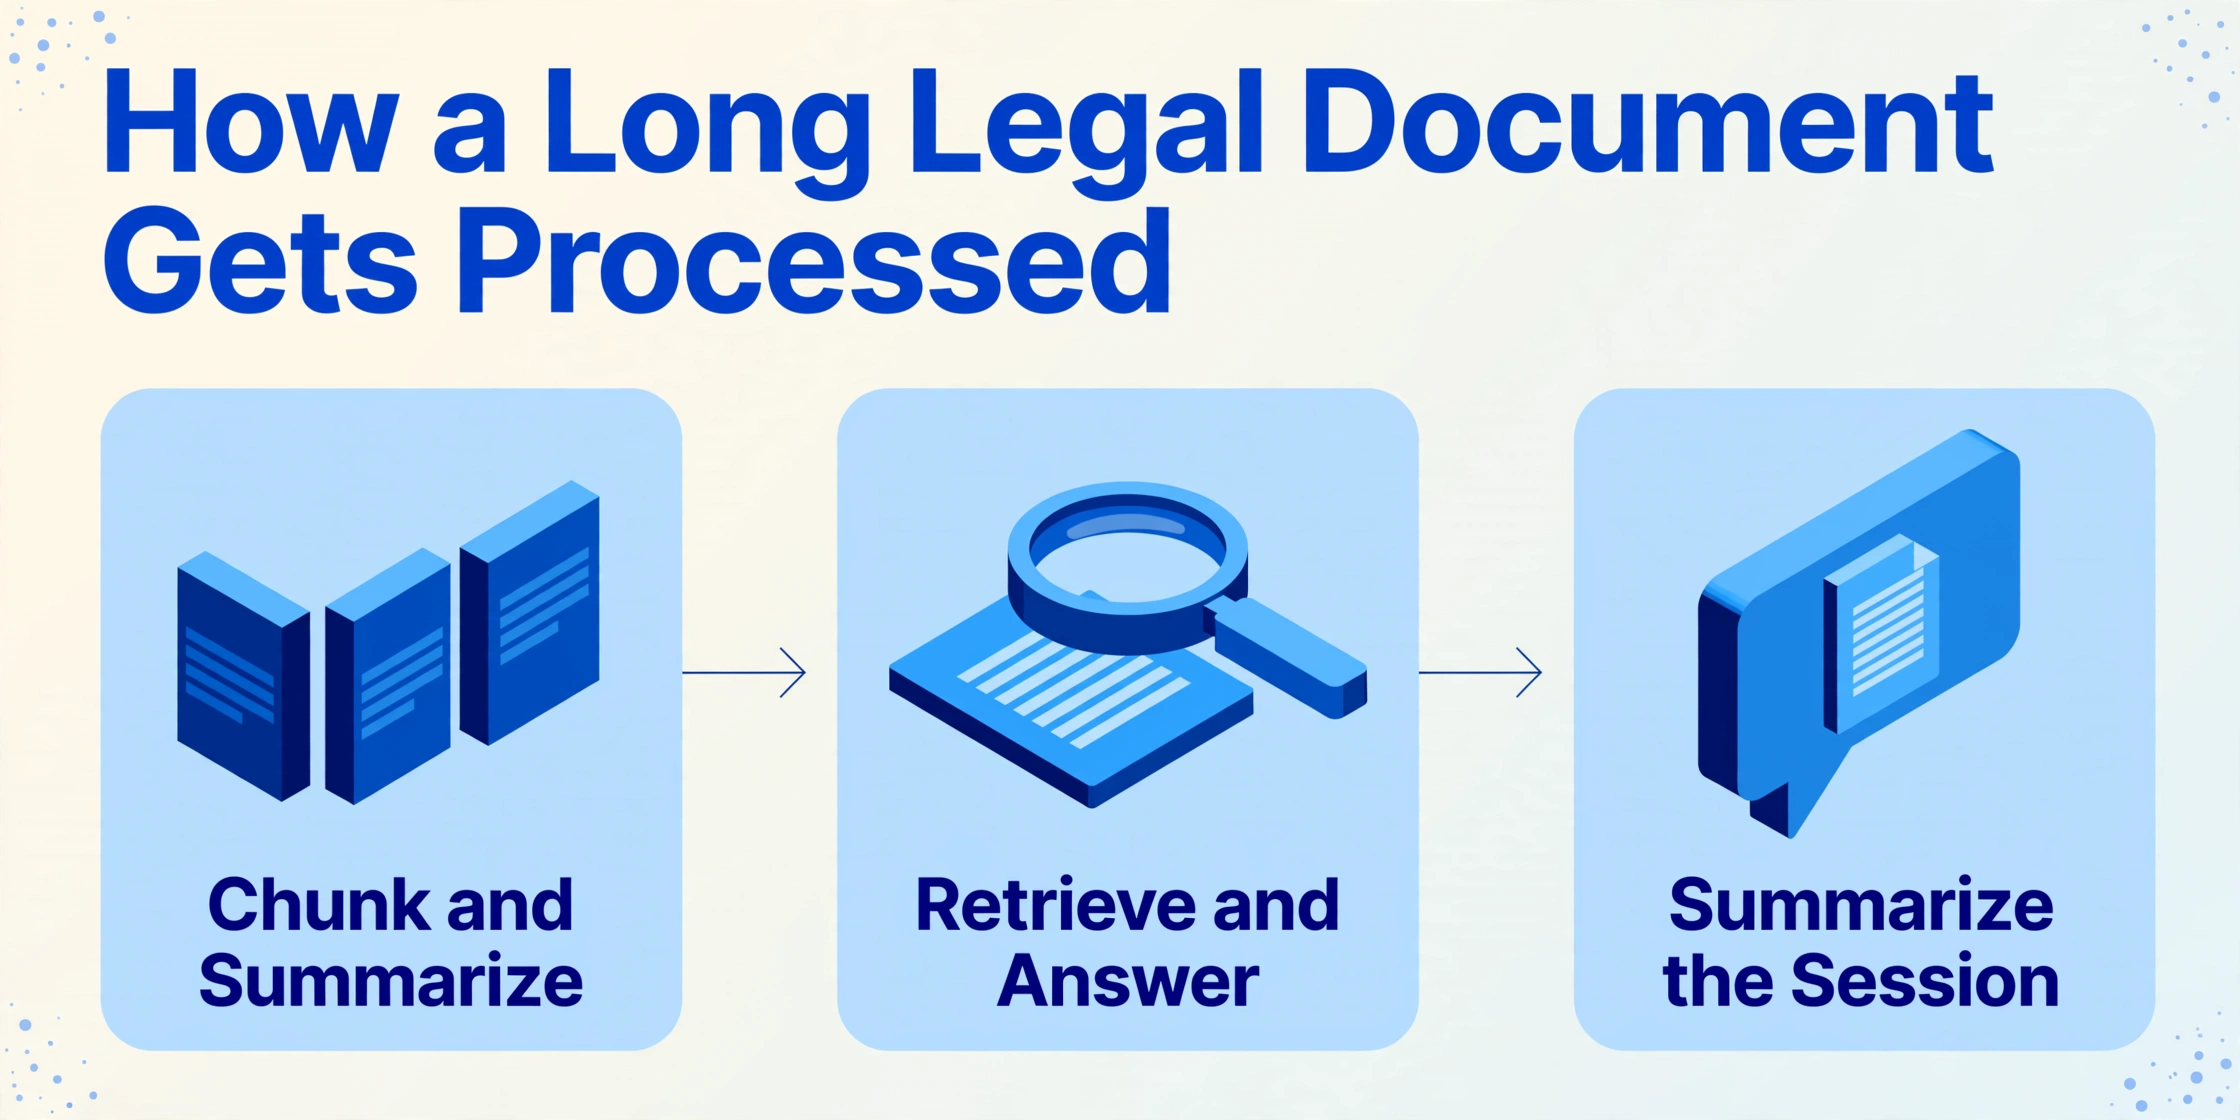
Uma ferramenta que diz que consegue ler um documento de 400 páginas geralmente descreve um pipeline de leituras menores costuradas de volta, e é na costura que os valores mudam. Um modelo não lê do jeito que você lê. O texto é dividido em tokens e colocado em uma janela de contexto, a quantidade fixa de texto que o modelo consegue segurar e considerar de uma vez. Quando um documento é mais longo que essa janela, o sistema recorre a uma de três soluções alternativas, e cada uma delas substitui o documento completo por uma versão menor.
Dividir e resumir
O documento é dividido em partes, cada parte é resumida e os resumos são combinados. Os valores dos campos são então extraídos dos resumos, não das páginas de onde vieram.
Recuperar e responder
O documento é indexado, e apenas as passagens que parecem relevantes para cada campo são recuperadas para construir a resposta. É isso que a geração aumentada por recuperação, ou RAG, significa na prática. Se a passagem certa não for recuperada, o modelo responde sem ela.
Resumir a sessão
Assistentes de chat adicionam um caminho fácil de ignorar. Quando uma sessão longa preenche a janela de contexto, algumas ferramentas resumem a conversa anterior e continuam. Para um chat, isso é razoável. Para um documento pelo qual você precisa responder, o resumo agora é a base do raciocínio da ferramenta.
Nenhuma dessas etapas é um bug. É assim que documentos longos são tratados. O ponto é que, uma vez que qualquer uma delas está em ação, a ferramenta não está mais lendo seu contrato. Ela está lendo algo menor que o representa, e as lacunas nessa representação são onde valores fabricados entram. Os limites da leitura de documentos longos são abordados em mais profundidade no nosso guia sobre o que a IA pode e não pode fazer com PDFs de várias páginas. Se você é novo na categoria, nosso explicador sobre o que é extração de dados de contratos estabelece a base antes dos modos de falha.
Por que a compressão produz erros plausíveis, e não aleatórios
Quando um valor está ausente na visão comprimida, o modelo não deixa um espaço em branco. Ele preenche a lacuna com o valor mais provável para aquele tipo de documento, que é exatamente o tipo de erro que um leitor atento não notará. Pesquisadores chamam esse padrão de alucinação de detalhe: a saída permanece amplamente correta na estrutura enquanto corrompe silenciosamente os parâmetros que decidem os resultados, incluindo números de limite, unidades, escopo, a força de uma obrigação ("shall" contra "should") e as condições que a acionam. Um estudo de documentos regulatórios longos constatou que essa fidelidade de detalhe decai conforme o contexto cresce, com a taxa de erro subindo de 0,22 em entradas curtas para 0,36 em entradas longas, uma degradação de 64% (arXiv).
No trabalho jurídico, esses não são erros cosméticos. "Shall" contra "should" decide se um dever é obrigatório. Um qualificador omitido, como "exceto conforme previsto na Seção 4.2", transforma uma exceção restrita em uma regra geral. Um teto substituído muda a exposição do cliente. Cada um deles passa pela leitura que recebe, porque cada um parece um valor real. A avaliação de Stanford traça uma linha que vale a pena emprestar aqui: um valor extraído pode ser fabricado (não está no documento) ou mal fundamentado (o texto existe, mas não diz o que a ferramenta afirma). O segundo é mais difícil de detectar, porque a fonte é real e o campo parece fundamentado.
Os campos que a compressão quebra primeiro
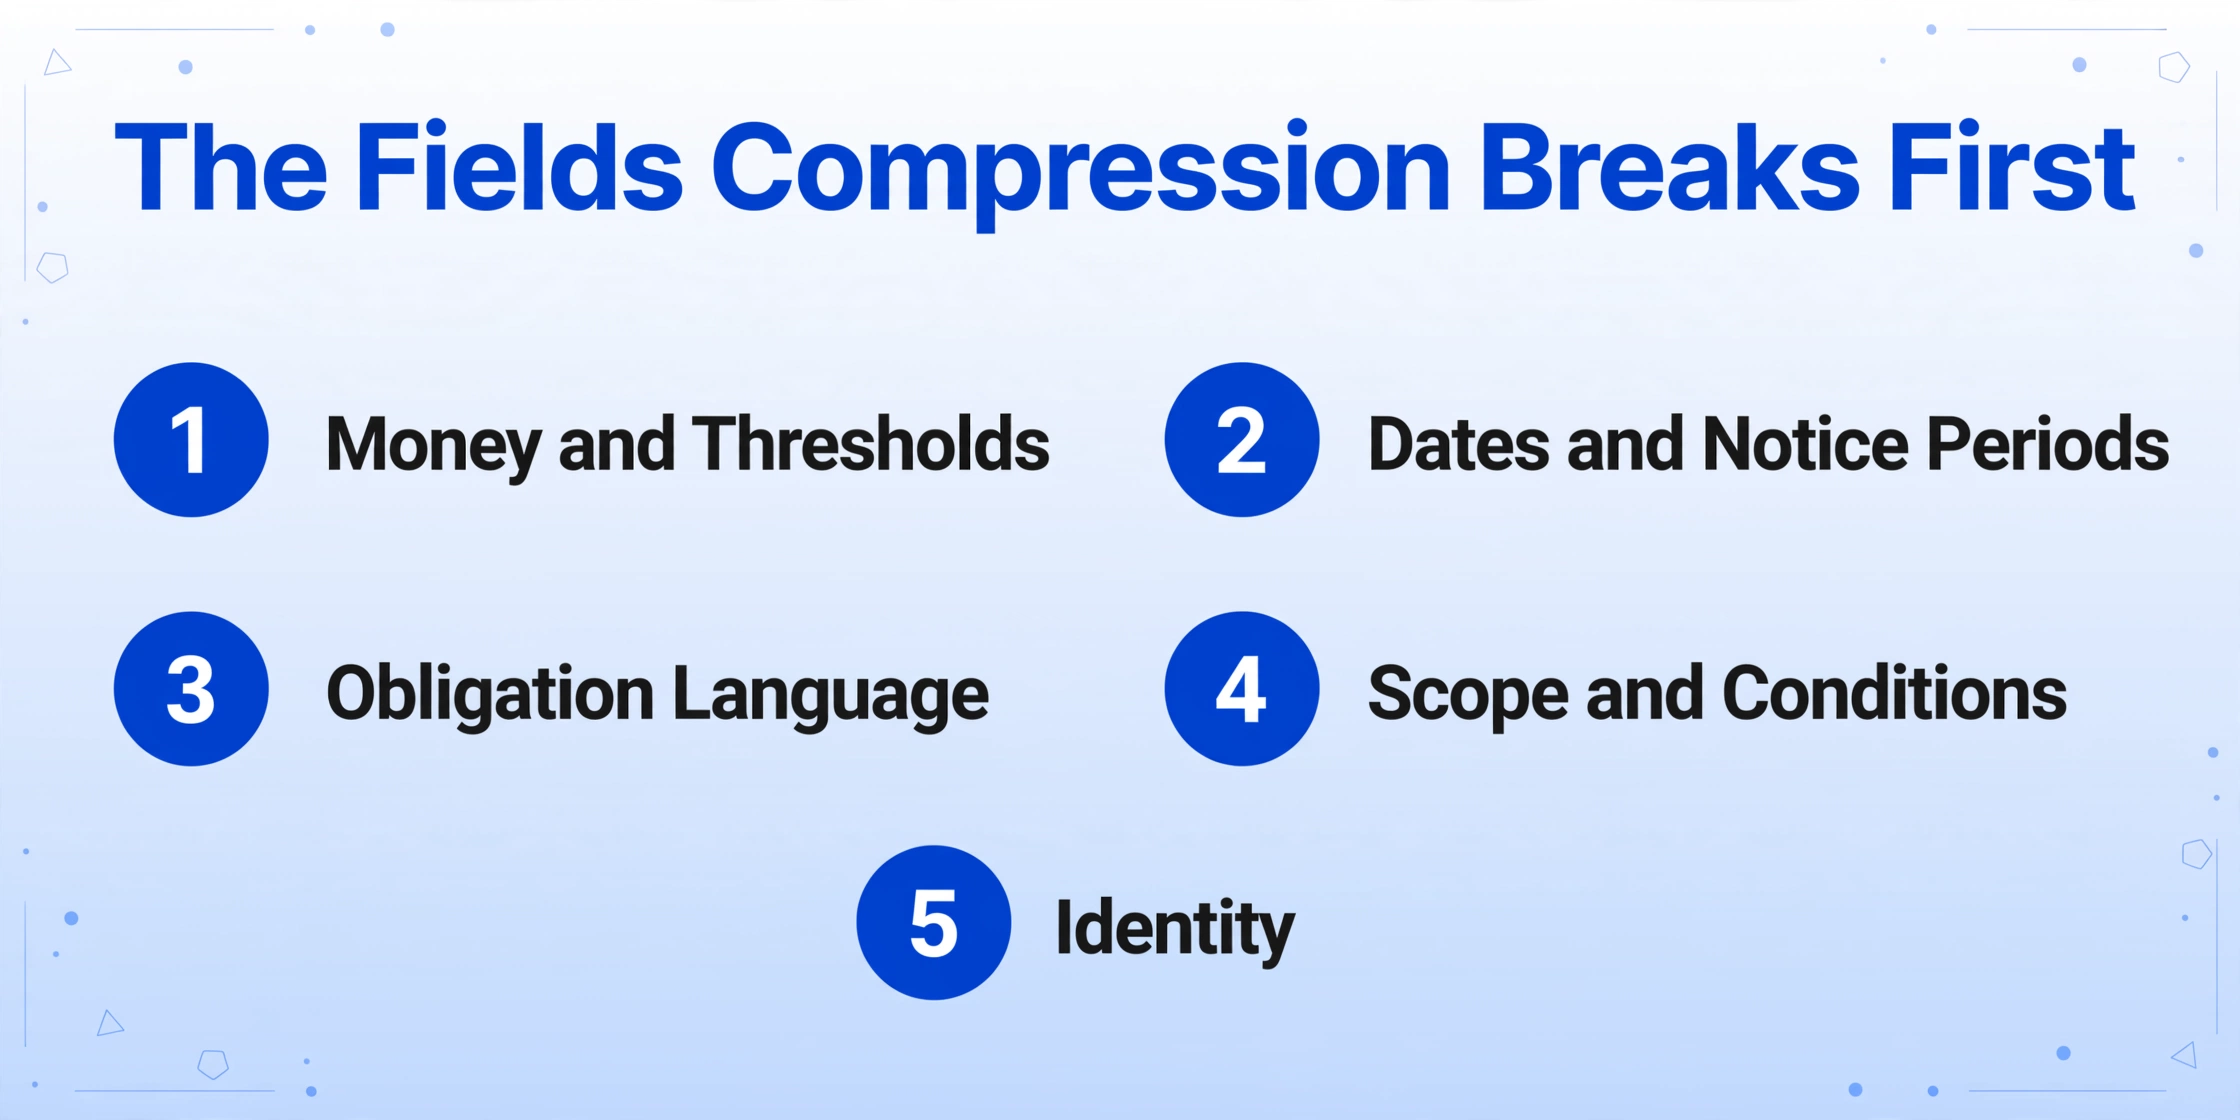
A compressão não danifica todos os campos igualmente. Os mais propensos a voltarem errados são aqueles em que um substituto plausível é fácil de gerar e difícil de detectar a olho nu. Esse é um conjunto pequeno e previsível em documentos jurídicos.
| Tipo de campo | O que a compressão faz com ele | O que verificar |
|---|---|---|
| Valores monetários e limites (teto de responsabilidade, taxa, porcentagem) | Preenche com um valor redondo comum, ou desloca um dígito; a prioridade do modelo para o tipo de cláusula pode sobrepor a página | A cláusula e o valor exatos, caractere por caractere |
| Datas e prazos de aviso | Colapsa data de vigência, data de alteração e data de assinatura em uma só | Qual marco a data indica e se um documento posterior a alterou |
| Linguagem de obrigação | Perde a diferença entre "deverá" e "deveria", e remove ressalvas | A frase completa, incluindo o qualificador após a vírgula |
| Escopo e condições ("dentro de 50 milhas", "exceto conforme previsto") | Remove a condição que limita a cláusula | A cláusula de condição, não apenas o termo principal |
| Identidade (lei aplicável, contraparte, papel da parte) | Assume como padrão a jurisdição ou o nome que o modelo mais viu | O preâmbulo e a cláusula de lei aplicável como escritos |
Observe o que esses campos têm em comum. Cada um tem um valor correto que é comum, e um valor errado que também é comum. É por isso que eles passam despercebidos em uma leitura rápida. É também por isso que a ordem das suas verificações importa: comece pelos campos numéricos e de obrigação, porque são os que, quando errados, criam exposição.
Alterações e versões com marcações merecem uma passada própria. Um valor substituído pode permanecer bem legível em uma cópia assinada digitalizada, e um modelo trabalhando com uma visão parcial não tem como saber de forma confiável qual versão prevalece. Em um documento jurídico, o mesmo campo aparece legitimamente várias vezes, e aparições repetidas com valores diferentes são exatamente o que a compressão lida pior.
O que "Verificar Cada Campo" Realmente Exige
Em um documento longo, verificar cada campo tem que significar forçar cada valor extraído de volta a um local específico na fonte, para que um valor errado seja pego por onde aponta, em vez de por se ler bem. Reler o documento anula o propósito da ferramenta, e reler também é como um valor mal fundamentado passa despercebido, porque o valor que substituiu o texto parece tão convincente quanto o texto. Duas coisas precisam ser verdade antes que esse tipo de verificação seja possível: você sabe exatamente quais campos queria, e a ferramenta consegue mostrar de onde cada um veio.
Nomeie os campos antes de processar
Em vez de deixar o documento decidir suas colunas, você digita os campos de que precisa: "Liability Cap", "Notice Period", "Governing Law", "Effective Date". É isso que Custom Column Extraction significa: a IA lê o documento e encontra cada valor pelo que ele significa, não por uma posição fixa na página, e os nomes das colunas que você insere viram os cabeçalhos da tabela de saída. O valor da verificação é que o conjunto de checagem é fixo desde o início. Você não está auditando todas as 180 páginas, apenas os campos que nomeou.
Exija um local de origem para cada célula
O Review Mode mostra de onde um valor veio. Passe o mouse ou clique em qualquer célula extraída e a região correspondente é destacada na página original; clique em uma região na página e ela salta de volta para a célula correspondente. Se você editar um campo, a ferramenta mantém o valor original da IA para que você possa comparar ou reverter. Em um documento longo, isso transforma "verificar cada campo" de aspiração em ação: você não está relendo, está confirmando que o valor está onde afirma estar.
Ative o mapa antes de precisar dele
Os locais de origem podem ser gerados sob demanda para um único arquivo, ou a conta pode ser configurada para anotar automaticamente todos os documentos processados. Gerá-los depois significa que o arquivo de revisão está pronto no momento em que a extração termina, o que importa quando a velocidade é o motivo pelo qual você automatizou a etapa em primeiro lugar.
Trabalhe em ordem de risco
Limpe primeiro os campos numéricos, de obrigação e sensíveis a versão, usando a tabela acima. Depois que esses estiverem corretos, os metadados restantes são mais rápidos de aprovar. Uma passada de verificação que começa com nomes e datas gasta atenção antes de chegar aos campos que carregam a exposição.
Os arquivos são processados com segurança e não são armazenados.
A rotina de verificação mais ampla, incluindo alinhamento de colunas, contagem de linhas, auditorias de campos ausentes, validação numérica e de datas, e quando reextrair em vez de corrigir manualmente, está detalhada na nossa lista de verificação de QA de extração em sete pontos. Onde um ponto de revisão se encaixa em um pipeline é abordado no fluxo de trabalho com humano no circuito. E quando a verificação abrange vários documentos de uma vez, o passo a passo de consistência entre documentos mostra como compará-los em uma única planilha. O que cada um desses pressupõe, e o que a compressão torna urgente, é que todo valor pode ser rastreado até sua fonte em primeiro lugar.
O Que Esta Verificação Ainda Não Consegue Fazer
A ancoragem à fonte informa de onde veio um valor. Ela não informa se a cláusula é executável, se sobrevive a uma alteração posterior, ou o que o cliente deve fazer a respeito, e nenhuma ferramenta de extração muda isso. Uma localização de fonte é evidência, não uma conclusão jurídica. A ferramenta pode mostrar que "90 dias" aparece na Seção 12.3. Ela não pode informar se esse prazo de aviso ainda se aplica após a carta lateral que você não enviou.
Algumas falhas ficam totalmente fora da ferramenta. Se o valor operacional está em um anexo, uma alteração anterior, ou uma carta lateral que nunca esteve no upload, nenhuma quantidade de ancoragem vai encontrá-lo, porque ele não está lá para ser encontrado. Envie o pacote completo e, quando o mesmo acordo chegar em vários arquivos, reúna as partes em um único registro antes da revisão. Se a fonte em si é um escaneamento ruim, cada camada acima herda o problema, e é por isso que uma leitura limpa começa com um bom OCR; documentos jurídicos têm seus próprios requisitos, abordados no nosso guia de OCR para documentos jurídicos. E um campo em branco não é uma falha. Um campo reportado como "não presente" é mais seguro do que um valor plausível inventado para preencher a linha, porque indica à próxima pessoa que olhe o documento em vez de confiar na tabela.
O dever também não é transferido para a ferramenta. O Comentário 8 da Regra Modelo 1.1 da ABA coloca os benefícios e riscos da tecnologia relevante dentro do dever de competência do advogado, e cerca de 40 jurisdições dos EUA adotaram uma versão dessa linguagem (ABA). Os profissionais interpretam da mesma forma: "A IA não elimina a responsabilidade de eu ser advogado. Se um caso vai para algo com seu nome nele, encontre a citação. Leia-a." (r/legaltech). Ao comparar ferramentas, a pergunta que separa um extrator de nível de revisão de uma caixa-preta é se ele retorna uma localização de fonte para cada campo. Uma ferramenta que apenas devolve uma tabela limpa não lhe dá nada para verificar, o que vale lembrar ao ler plataformas de e-discovery versus extração de campos ou ao avaliar opções de extração de documentos para um pequeno escritório jurídico.
Perguntas Frequentes
Por que as ferramentas de IA alucinam mais em documentos jurídicos longos do que em curtos?
Porque um documento longo excede a quantidade de texto que um modelo consegue reter de uma vez, então o sistema resume ou recupera em vez de ler tudo. Qualquer valor ausente dessa visão compactada é reconstruído a partir do que normalmente aparece naquele local. Pesquisas sobre documentos de contexto longo descobriram que a precisão em nível de detalhe decai mais rápido do que a precisão geral conforme a entrada cresce.
Uma janela de contexto maior resolve o problema?
Ela eleva o limite, mas não o remove. Documentos ainda podem exceder a janela, assistentes estilo chat ainda resumem texto mais antigo para continuar, e o comportamento do modelo degrada conforme o contexto cresce, mesmo antes de atingir o limite. Trate uma janela grande como margem de manobra, não como garantia.
Posso apenas verificar os campos importantes e pular o resto?
Escolha os campos pelo risco em vez de verificar tudo ou nada. Números, linguagem de obrigações e campos sensíveis a versão, como data de vigência versus data de alteração, merecem verificação cuidadosa; metadados de baixo risco são mais rápidos de liberar. A decisão sobre quais campos são importantes deve ser tomada com antecedência e registrada por escrito, não deixada para a ferramenta.
Como verifico um valor extraído de contrato sem ler o contrato inteiro?
Use ancoragem à fonte. Faça a ferramenta mostrar a localização de cada valor na página original e confirme que o valor está onde afirma estar, em vez de reler o documento. No ImageToTable.ai, o Review Mode destaca a região de origem de qualquer célula extraída, e os documentos podem ser configurados para anotar automaticamente após o processamento.
A extração de contratos por IA é precisa o suficiente para uso sem revisão?
Nenhuma ferramenta, incluindo a nossa, elimina a necessidade de verificar a saída em nível de campo em documentos que envolvem exposição jurídica ou financeira. Nossa extração atinge até 99% de precisão em dados de tabelas impressas, e o fluxo de trabalho responsável ainda confirma os campos de alto risco contra a fonte. Trate qualquer alegação de "livre de alucinações" de qualquer fornecedor com o mesmo ceticismo que aplicaria a um número de precisão sem citação por trás.
O que devo fazer quando um campo volta vazio?
Verifique se a cláusula está realmente ausente e, se estiver, deixe-a vazia. Um campo em branco marcado como "não presente" é mais útil do que um valor plausível inventado para preencher a linha, porque informa à próxima pessoa no fluxo de trabalho que ela deve olhar o documento em vez de confiar na tabela.
O Teste Que Importa
A medida útil de um fluxo de trabalho jurídico com IA não é o quão boa a tabela parece na primeira execução. É se você consegue pegar qualquer célula dessa tabela e mostrar, em uma única etapa, exatamente onde na página ela veio. A compressão é o que torna essa etapa necessária, já que toda solução alternativa para documentos longos substitui o contrato por uma versão menor. A ancoragem à fonte é o que a torna possível. Comece pelo campo em que você menos gostaria de errar e veja se a ferramenta consegue levá-lo até ele.
Escolha um contrato que você já conhece bem, extraia os quatro campos em que você odiaria errar e verifique cada um contra sua localização de origem. Essa única passagem diz mais sobre uma ferramenta do que qualquer alegação de precisão na página de marketing dela.