Pourquoi l'IA hallucine dans les longs documents juridiques
et comment vérifier chaque champ
Les assistants IA généralistes sont désormais vendus avec des fenêtres de contexte assez grandes pour contenir un contrat de crédit de 200 pages. Le problème commence lorsque le document est plus long que la fenêtre, car la solution que l'outil adopte est de résumer, et un résumé de contrat n'est pas un contrat. Une valeur qui échappe à ce résumé ne revient pas vide. Elle revient plausible.
L'écart entre « le modèle peut le lire » et « on peut lui faire confiance » est mesurable. Une évaluation du Stanford RegLab des principaux outils de recherche juridique par IA, dont Lexis+ AI et Westlaw's AI-Assisted Research, a révélé qu'ils renvoyaient encore des réponses fabriquées ou mal ancrées dans 17 % à 33 % des requêtes, alors même que chaque fournisseur commercialise la récupération comme la solution (Stanford HAI). Ces outils répondent à des questions sur le droit. Le mécanisme derrière leurs erreurs est le même que celui qui corrompt un champ extrait de votre contrat.
Points clés à retenir
- Une fenêtre de contexte assez grande pour contenir un accord de 200 pages donne l'impression que le problème de l'hallucination est résolu, et chaque fournisseur commercialise la récupération comme la solution.
- Les principaux outils juridiques par IA renvoyaient encore des réponses fabriquées ou mal ancrées dans 17 % à 33 % des requêtes lors d'une évaluation de Stanford, car une valeur issue d'un document compressé se lit exactement comme une valeur que le modèle a réellement lue.
- Relire le document ne suffira pas à détecter l'erreur : la vérification doit donc consister à rattacher chaque cellule à sa source, ce que fait ImageToTable.ai en Review Mode.
Les équipes juridiques mènent déjà cette expérience à grande échelle. Dans l'enquête technologique 2024 de l'ILTA, 37 % des cabinets ont déclaré utiliser l'IA générative pour des tâches professionnelles, soit 22 points de plus que l'année précédente, et les principaux usages cités étaient la recherche (73 %), la synthèse (70 %) et les premières ébauches (69 %) (ILTA). La synthèse est précisément l'opération qui crée le problème dont traite cet article. C'est ici que naît la valeur fabriquée, quels champs elle touche en premier, et ce que « vérifier chaque champ » doit réellement signifier lorsque le document est trop long pour être lu en une seule fois.
D'où vient une valeur fabriquée
Un champ halluciné est une valeur que le modèle n'a jamais lue, reconstruite à partir de ce qui apparaît habituellement à cette position et renvoyée avec la même confiance qu'une valeur qu'il a réellement lue. Demandez à un assistant d'extraire le plafond de responsabilité, le préavis et la loi applicable d'un accord de 180 pages, et il vous remettra une ligne propre. Le plafond ressemble à un plafond. Le préavis est un nombre rond. La loi applicable est celle que ce type d'accord choisit habituellement. Rien de tout cela ne prouve que les valeurs figurent dans le document, car un modèle qui a perdu de vue la source ne sait pas qu'il l'a perdue de vue.
Les acheteurs sont déjà méfiants à ce sujet. Dans un fil r/legaltech sur la due diligence des fournisseurs d'IA, un examinateur a décrit avoir demandé des preuves sans en obtenir : « Les fournisseurs prétendent avoir une « précision de 99 % », mais quand on leur demande des preuves pendant la due diligence, ils répondent en gros : « Testez par vous-même. » » (r/legaltech). La plainte n'est pas que les outils sont inutiles. C'est que la charge de la vérification retombe sur l'acheteur sans rien pour vérifier. Le reste de cet article explique comment transformer cette charge en un contrôle que vous pouvez réellement exécuter.
Comment un long document juridique est réellement traité
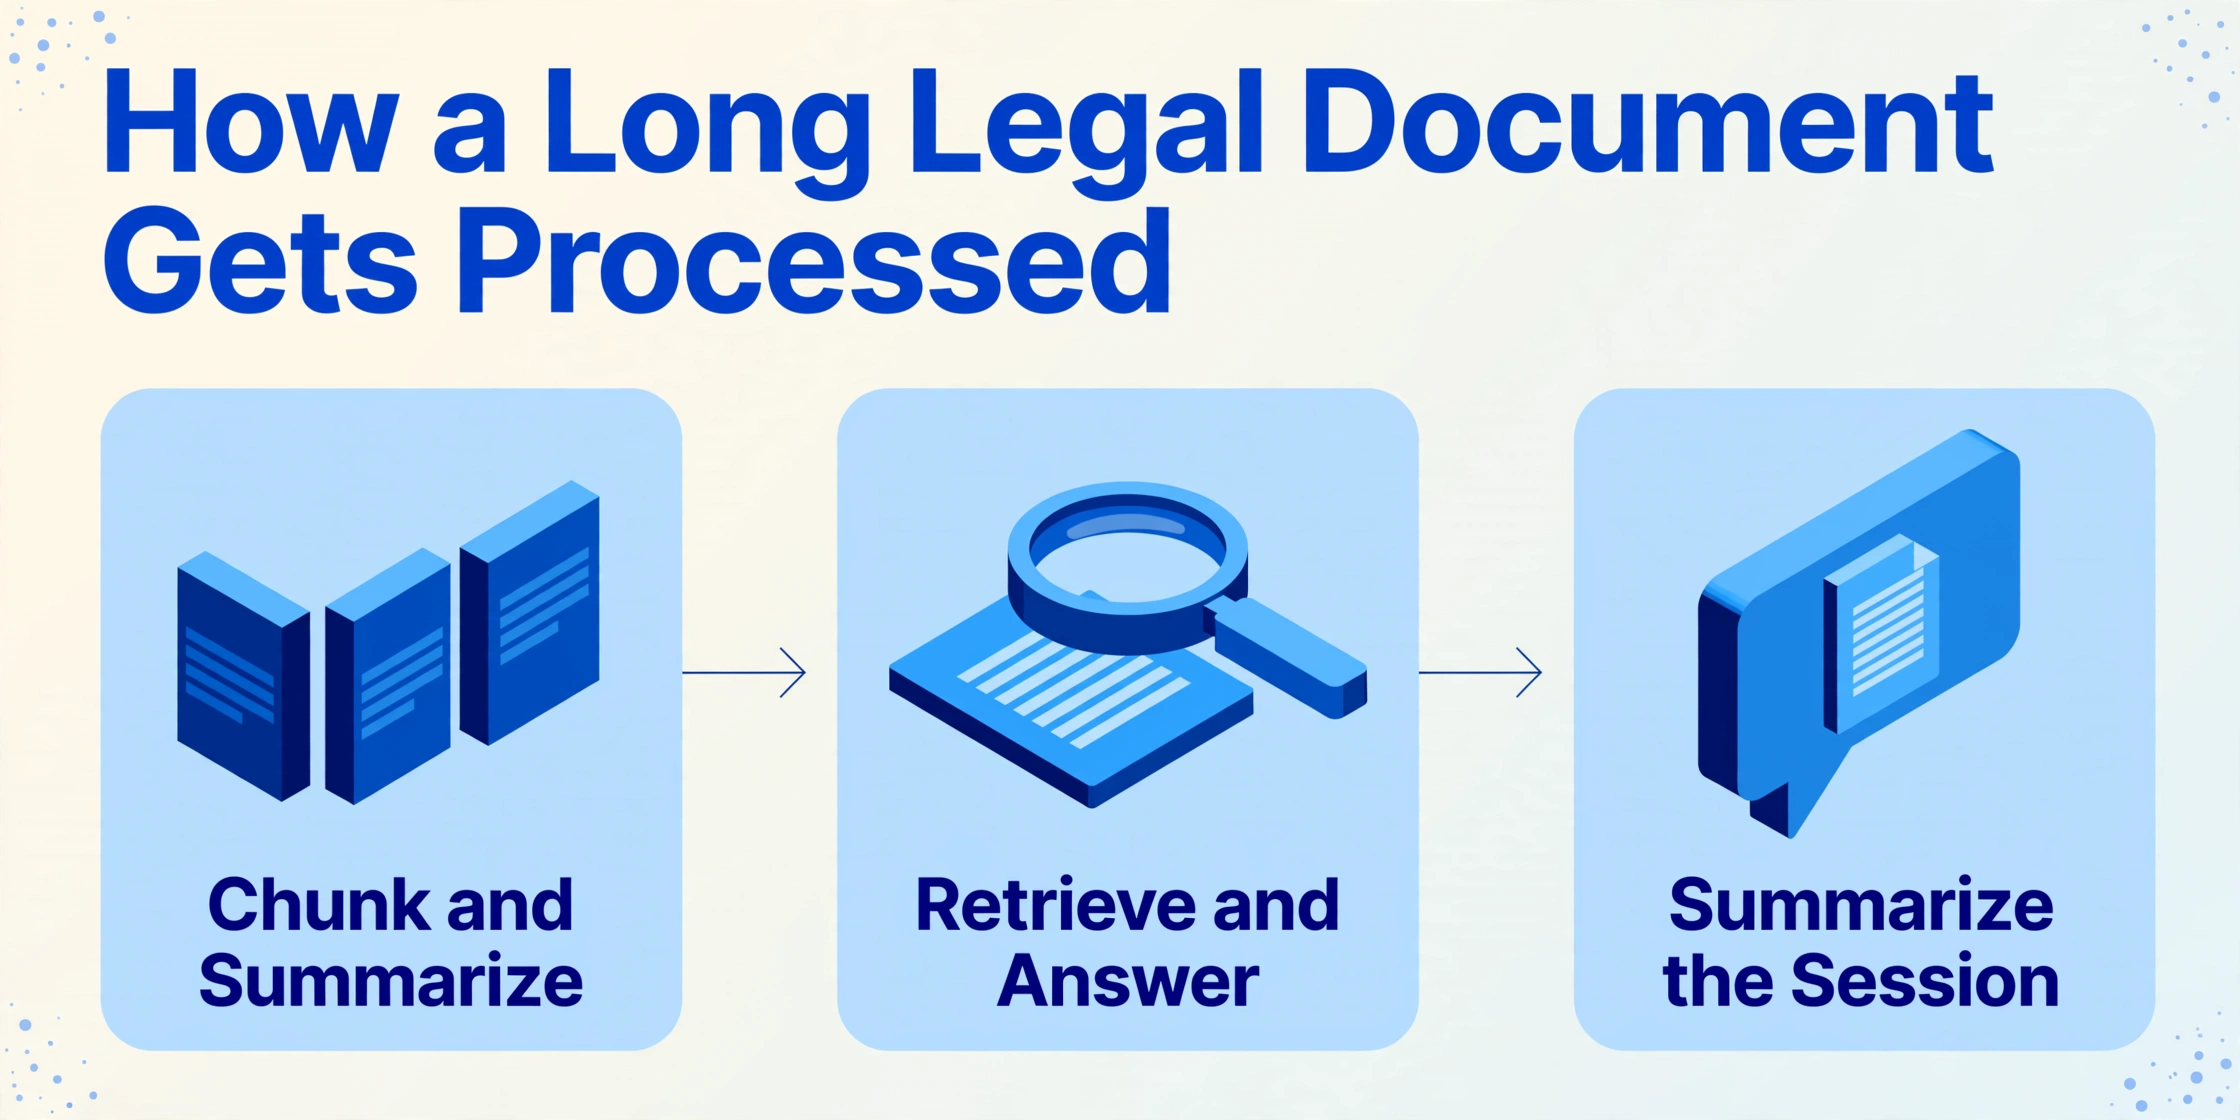
Un outil qui prétend pouvoir lire un document de 400 pages décrit généralement un pipeline de lectures plus courtes recousues ensemble, et c'est dans la couture que les valeurs changent. Un modèle ne lit pas comme vous. Le texte est divisé en jetons et placé dans une fenêtre de contexte, la quantité fixe de texte que le modèle peut contenir et considérer à la fois. Lorsqu'un document est plus long que cette fenêtre, le système recourt à l'un des trois contournements, et chacun d'eux remplace le document complet par un substitut plus petit.
Découper et synthétiser
Le document est divisé en morceaux, chaque morceau est résumé, et les résumés sont combinés. Les valeurs des champs sont ensuite extraites des résumés, et non des pages dont elles proviennent.
Récupérer et répondre
Le document est indexé, et seuls les passages qui semblent pertinents pour chaque champ sont récupérés pour construire la réponse. C'est ce que signifie la génération augmentée par récupération, ou RAG, en pratique. Si le bon passage n'est pas récupéré, le modèle répond sans lui.
Résumer la session
Les assistants de type chat ajoutent un chemin facile à manquer. Lorsqu'une longue session remplit la fenêtre de contexte, certains outils résument la conversation précédente et continuent. Pour un chat, c'est raisonnable. Pour un document dont vous devez répondre, le résumé est désormais ce sur quoi l'outil raisonne.
Aucune de ces étapes n'est un bug. C'est ainsi que les longs documents sont traités tout court. Le point est qu'une fois que l'un d'eux est en jeu, l'outil ne lit plus votre contrat. Il lit quelque chose de plus petit qui le remplace, et les lacunes de ce substitut sont là où entrent les valeurs fabriquées. Les limites de la lecture de longs documents sont abordées plus en détail dans notre guide sur ce que l'IA peut et ne peut pas faire avec les PDF multipages. Si vous êtes nouveau dans la catégorie, notre explication sur ce qu'est réellement l'extraction de données contractuelles établit les bases avant les modes de défaillance.
Pourquoi la compression produit des erreurs plausibles, et non aléatoires
Lorsqu'une valeur est absente de la vue compressée, le modèle ne laisse pas de blanc. Il comble l'espace avec la valeur la plus probable pour ce type de document, ce qui est précisément le genre d'erreur qu'un lecteur attentif ne remarquera pas. Les chercheurs appellent ce phénomène hallucination de détail : la sortie reste globalement correcte dans sa structure tout en corrompant silencieusement les paramètres qui déterminent les résultats, notamment les seuils, les unités, le champ d'application, la force d'une obligation (« shall » contre « should ») et les conditions qui la déclenchent. Une étude portant sur de longs documents réglementaires a montré que cette fidélité au niveau du détail se dégrade à mesure que le contexte s'allonge, le taux d'erreur passant de 0,22 sur des entrées courtes à 0,36 sur des entrées longues, soit une dégradation de 64 % (arXiv).
Dans le travail juridique, ce ne sont pas des erreurs cosmétiques. « Shall » contre « should » détermine si une obligation est impérative. Un qualificatif omis tel que « sauf disposition contraire de l'article 4.2 » transforme une exception étroite en règle générale. Un plafond substitué modifie l'exposition du client. Chacune de ces erreurs passe la relecture, car chacune ressemble à une valeur réelle. L'évaluation de Stanford trace une ligne qu'il vaut la peine d'emprunter ici : une valeur extraite peut être fabriquée (elle n'est pas du tout dans le document) ou mal ancrée (le texte existe, mais il ne dit pas ce que l'outil prétend). La seconde est plus difficile à détecter, car la source est réelle et le champ semble ancré.
Les champs que la compression altère en premier
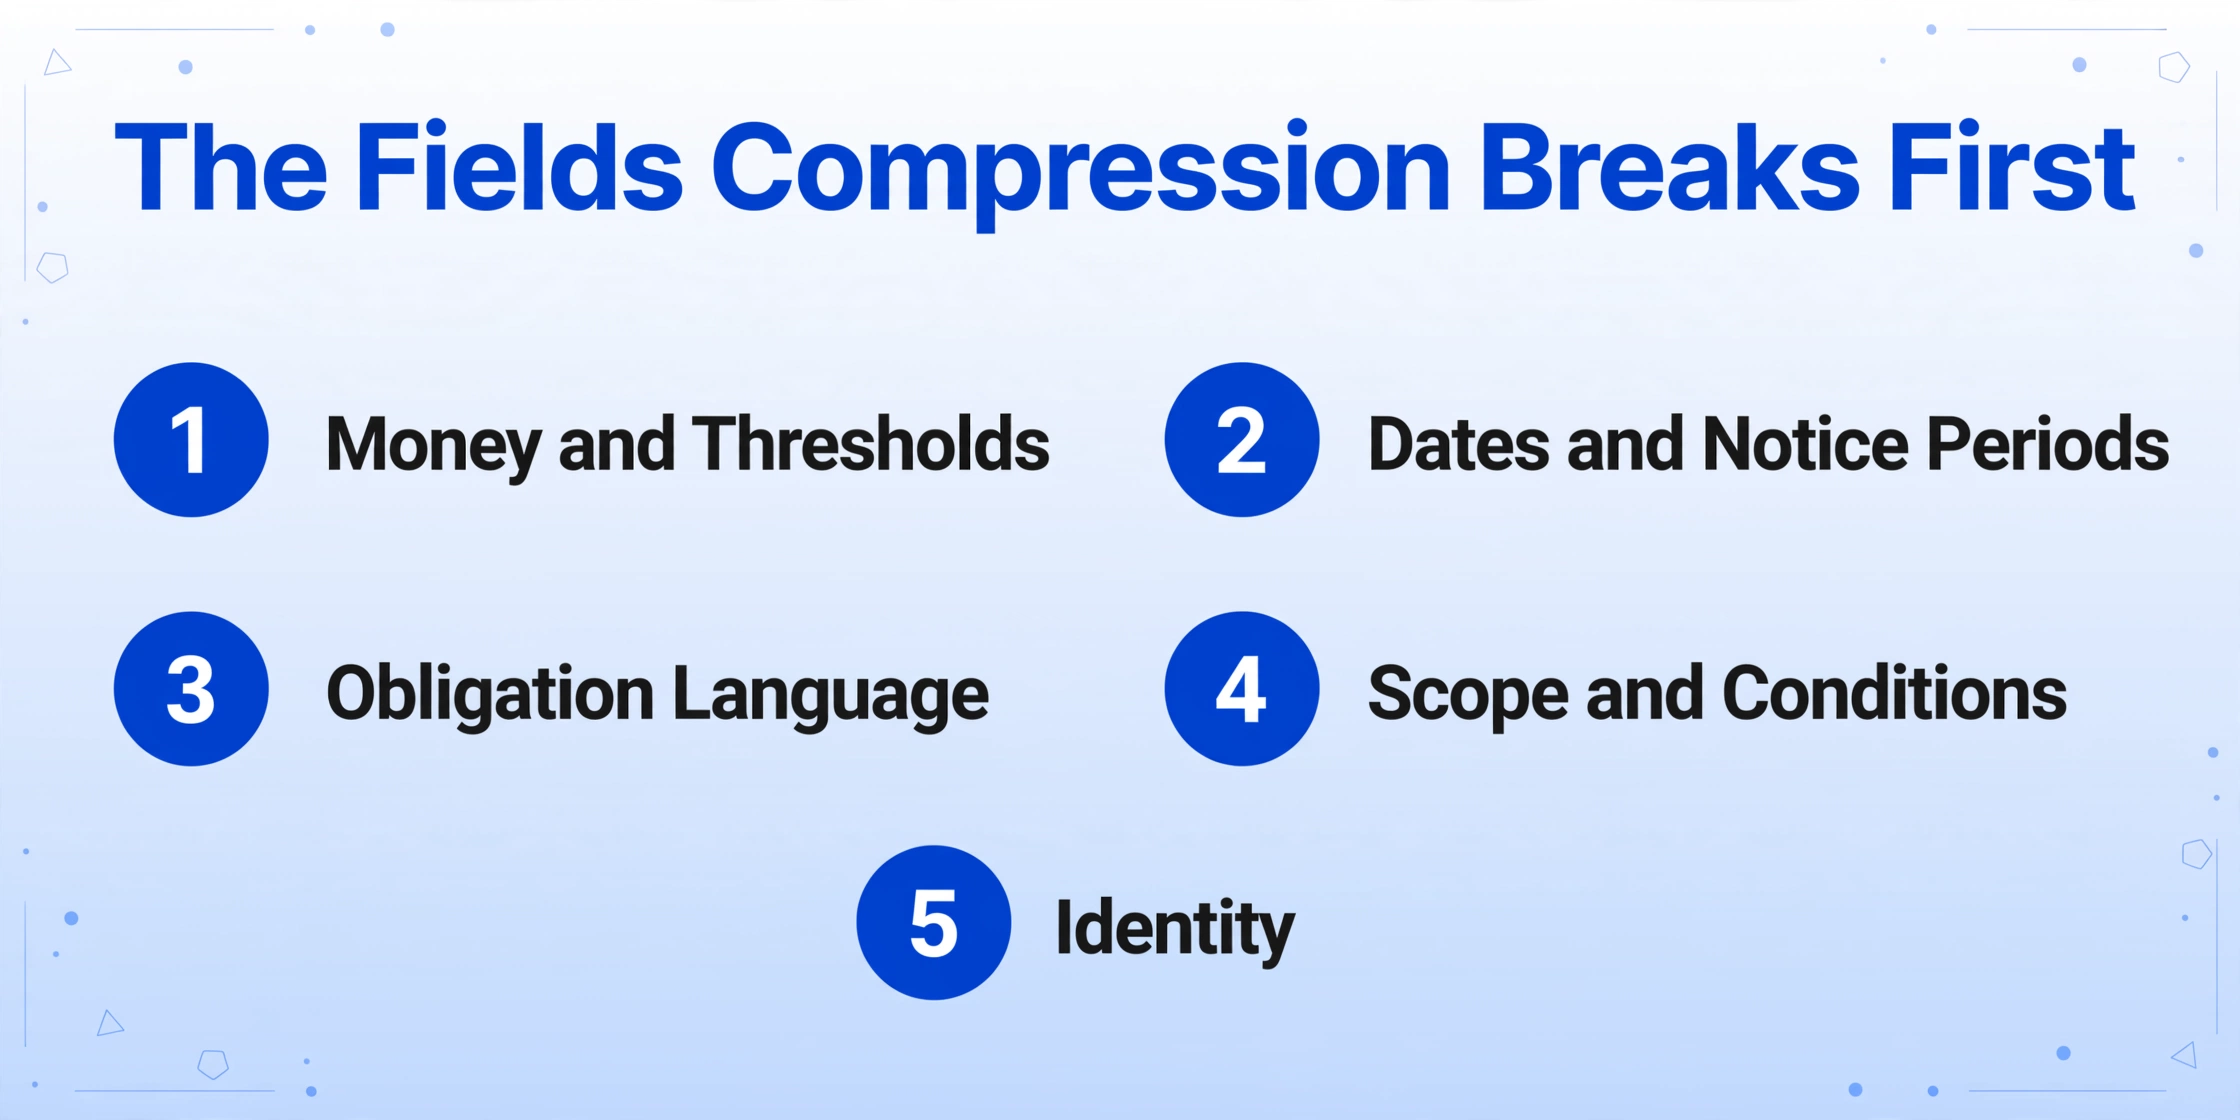
La compression n'endommage pas tous les champs de manière égale. Ceux qui risquent le plus de revenir erronés sont ceux pour lesquels un substitut plausible est facile à générer et difficile à repérer à l'œil nu. C'est un ensemble restreint et prévisible dans les documents juridiques.
| Type de champ | Ce que la compression lui fait | Contre quoi vérifier |
|---|---|---|
| Montants et seuils (plafond de responsabilité, frais, pourcentage) | Se remplit avec une valeur ronde courante, ou déplace un chiffre ; l'a priori du modèle pour le type de clause peut l'emporter sur la page | La clause et le chiffre exacts, caractère par caractère |
| Dates et délais de préavis | Fusionne la date d'entrée en vigueur, la date de modification et la date de signature en une seule | Quel jalon la date marque, et si un document ultérieur l'a modifiée |
| Langage des obligations | Perd la distinction entre « doit » et « devrait », et supprime les réserves | La phrase complète, y compris la condition après la virgule |
| Portée et conditions (« dans un rayon de 50 miles », « sauf disposition contraire ») | Supprime la condition qui limite la clause | La clause conditionnelle, pas seulement le terme principal |
| Identité (droit applicable, contrepartie, rôle des parties) | Par défaut, utilise la juridiction ou le nom que le modèle a le plus vu | Le préambule et la clause de droit applicable tels qu'écrits |
Remarquez ce que ces champs ont en commun. Chacun a une valeur correcte qui est banale, et une valeur incorrecte qui l'est tout autant. C'est pourquoi ils survivent à une lecture rapide. C'est aussi pourquoi l'ordre de vos vérifications compte : commencez par les champs numériques et les obligations, car ce sont ceux dont les erreurs créent une exposition.
Les avenants et les versions annotées méritent un passage dédié. Un chiffre remplacé peut rester très lisible sur une copie signée numérisée, et un modèle travaillant à partir d'une vue partielle n'a aucun moyen fiable de savoir quelle version prévaut. Dans un document juridique, le même champ apparaît légitimement plusieurs fois, et des apparitions répétées avec des valeurs différentes sont précisément ce que la compression gère le plus mal.
Ce que « Vérifier chaque champ » exige réellement
Dans un document long, vérifier chaque champ doit signifier forcer chaque valeur extraite à renvoyer vers un emplacement précis dans la source, afin qu'une valeur erronée soit détectée par l'endroit où elle pointe plutôt que par sa plausibilité. Relire le document va à l'encontre de l'utilité de l'outil, et c'est aussi en le relisant qu'une valeur mal ancrée passe inaperçue, car la valeur qui a remplacé le texte semble tout aussi convaincante que le texte lui-même. Deux conditions doivent être réunies pour que ce type de vérification soit possible : savoir exactement quels champs vous souhaitez, et pouvoir voir d'où provient chacun d'eux.
Nommez les champs avant le traitement
Plutôt que de laisser le document décider de vos colonnes, vous saisissez les champs dont vous avez besoin : « Plafond de responsabilité », « Préavis », « Droit applicable », « Date d'entrée en vigueur ». C'est ce que signifie Extraction de colonnes personnalisées : l'IA lit le document et trouve chaque valeur selon son sens, et non selon une position fixe sur la page, et les noms de colonnes que vous saisissez deviennent les en-têtes du tableau de sortie. La valeur ajoutée pour la vérification est que l'ensemble des contrôles est fixé en amont. Vous n'auditez pas les 180 pages, uniquement les champs que vous avez nommés.
Exigez un emplacement source pour chaque cellule
Le Review Mode vous montre d'où provient une valeur. Survolez ou cliquez sur n'importe quelle cellule extraite et la région correspondante est mise en évidence sur la page d'origine ; cliquez sur une région de la page et elle vous ramène à la cellule correspondante. Si vous modifiez un champ, l'outil conserve la valeur d'origine de l'IA afin que vous puissiez comparer ou revenir en arrière. Dans un document long, cela transforme « vérifier chaque champ » d'une aspiration en une action : vous ne relisez pas, vous confirmez que la valeur se trouve là où elle prétend se trouver.
Activez la cartographie avant d'en avoir besoin
Les emplacements source peuvent être générés à la demande pour un seul fichier, ou le compte peut être configuré pour annoter automatiquement chaque document traité. Les générer après coup signifie que le fichier de révision est prêt dès la fin de l'extraction, ce qui importe lorsque la rapidité est la raison pour laquelle vous avez automatisé cette étape en premier lieu.
Travaillez par ordre de risque
Traitez d'abord les champs numériques, les obligations et les éléments sensibles aux versions, en utilisant le tableau ci-dessus. Une fois ceux-ci validés, les métadonnées restantes sont plus rapides à approuver. Une passe de vérification qui commence par les noms et les dates épuise l'attention avant d'atteindre les champs qui portent le risque.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
La procédure de vérification complète, y compris l'alignement des colonnes, le nombre de lignes, les audits de champs manquants, la validation numérique et des dates, et le moment où il faut réextraire plutôt que corriger à la main, est détaillée dans notre checklist de contrôle qualité en sept points pour l'extraction. La place d'un point de contrôle dans un pipeline est couverte dans le flux de travail avec intervention humaine. Et lorsque le contrôle porte sur plusieurs documents à la fois, la procédure de cohérence inter-documents montre comment les comparer sur une seule feuille. Ce que chacune de ces étapes suppose, et ce que la compression rend urgent, c'est que chaque valeur puisse être rattachée à sa source en premier lieu.
Ce que cette vérification ne peut toujours pas faire
L'ancrage à la source vous indique d'où vient une valeur. Il ne vous dit pas si la clause est exécutoire, si elle survit à un avenant ultérieur, ni ce que le client devrait en faire, et aucun outil d'extraction ne change cela. Une localisation de source est une preuve, pas une conclusion juridique. L'outil peut montrer que « 90 jours » apparaît dans la section 12.3. Il ne peut pas vous dire si ce délai de préavis s'applique toujours après la lettre d'accompagnement que vous n'avez pas téléchargée.
Certaines défaillances échappent entièrement à l'outil. Si le chiffre déterminant se trouve dans une annexe, un avenant antérieur ou une lettre d'accompagnement qui n'a jamais été téléchargée, aucun ancrage ne le trouvera, car il n'y est pas pour être trouvé. Envoyez le dossier complet, et lorsque le même accord arrive en plusieurs fichiers, regroupez les pièces en un seul enregistrement avant la vérification. Si la source elle-même est un scan de mauvaise qualité, chaque couche au-dessus hérite du problème, c'est pourquoi une lecture propre commence par une bonne OCR ; les documents juridiques ont leurs propres exigences, couvertes dans notre guide OCR pour documents juridiques. Et un champ vide n'est pas un échec. Un champ signalé comme « non présent » est plus sûr qu'une valeur plausible inventée pour remplir la ligne, car il indique à la personne suivante de consulter le document plutôt que de se fier au tableau.
L'obligation ne se transfère pas non plus à l'outil. La règle 1.1, commentaire 8, de l'ABA Model Rule place les avantages et les risques de la technologie pertinente dans le devoir de compétence de l'avocat, et environ 40 juridictions américaines ont adopté une version de ce langage (ABA). Les praticiens le lisent de la même manière : « L'IA n'élimine pas ma responsabilité en tant qu'avocat. Si un dossier part avec votre nom dessus, trouvez la citation. Lisez-la. » (r/legaltech). Lorsque vous comparez des outils, la question qui sépare un extracteur de qualité révisionnelle d'une boîte noire est de savoir s'il renvoie un emplacement source pour chaque champ. Un outil qui ne fournit qu'un tableau propre ne vous donne rien à vérifier, ce qui vaut la peine d'être rappelé lorsque vous lisez les plateformes d'e-discovery par rapport à l'extraction de champs ou que vous évaluez les options d'extraction de documents pour une petite équipe juridique.
Questions fréquemment posées
Pourquoi les outils d'IA hallucinent-ils davantage sur les longs documents juridiques que sur les courts ?
Parce qu'un long document dépasse la quantité de texte qu'un modèle peut contenir à la fois, le système résume ou récupère donc au lieu de tout lire. Toute valeur manquante dans cette vue compressée est reconstruite à partir de ce qui apparaît habituellement à cet endroit. Les recherches sur les documents à contexte long ont montré que la précision au niveau du détail se dégrade plus rapidement que la précision globale à mesure que l'entrée s'allonge.
Une fenêtre de contexte plus grande résout-elle le problème ?
Elle relève le seuil, elle ne le supprime pas. Les documents peuvent toujours dépasser la fenêtre, les assistants de type chat résument toujours les textes plus anciens pour continuer, et le comportement du modèle se dégrade à mesure que le contexte s'allonge, même avant d'atteindre la limite. Traitez une grande fenêtre comme une marge de manœuvre, pas comme une garantie.
Puis-je simplement vérifier les champs importants et ignorer le reste ?
Choisissez les champs en fonction du risque plutôt que de tout vérifier ou rien. Les chiffres, le langage d'obligation et les champs sensibles à la version, comme la date d'entrée en vigueur par rapport à la date d'amendement, méritent une vérification minutieuse ; les métadonnées à faible risque sont plus rapides à valider. La décision sur les champs importants doit être prise à l'avance et consignée par écrit, et non laissée à l'outil.
Comment vérifier une valeur de contrat extraite sans lire tout le contrat ?
Utilisez l'ancrage à la source. Demandez à l'outil d'afficher l'emplacement de chaque valeur sur la page d'origine, puis confirmez que la valeur se trouve bien là où elle prétend être, plutôt que de relire le document. Sur ImageToTable.ai, Review Mode met en évidence la région source de toute cellule extraite, et les documents peuvent être configurés pour s'annoter automatiquement après le traitement.
L'extraction de contrats par IA est-elle suffisamment précise pour être utilisée sans révision ?
Aucun outil, y compris le nôtre, ne supprime la nécessité de vérifier les résultats au niveau des champs sur les documents qui comportent une exposition juridique ou financière. Notre extraction atteint jusqu'à 99 % de précision sur les données de tableaux imprimés, et le flux de travail responsable confirme toujours les champs à haut risque par rapport à la source. Traitez toute affirmation « sans hallucination » de tout fournisseur avec le même scepticisme que vous appliqueriez à un chiffre de précision sans citation derrière.
Que dois-je faire lorsqu'un champ revient vide ?
Vérifiez si la clause est réellement absente et, si c'est le cas, laissez-la vide. Une case vide signalée comme « non présente » est plus utile qu'une valeur plausible inventée pour remplir la ligne, car elle indique à la personne suivante dans le flux de travail de consulter le document plutôt que de se fier au tableau.
Le test qui compte
La mesure utile d'un flux de travail juridique basé sur l'IA n'est pas la qualité du tableau lors de la première exécution. C'est de savoir si vous pouvez prendre n'importe quelle cellule de ce tableau et montrer, en une seule étape, exactement où sur la page elle provient. La compression est ce qui rend cette étape nécessaire, puisque chaque solution de contournement pour les documents longs remplace le contrat par un substitut plus petit. L'ancrage à la source est ce qui la rend possible. Commencez par le champ que vous voudriez le moins voir erroné et vérifiez si l'outil peut vous y amener.
Choisissez un contrat que vous connaissez déjà bien, extrayez les quatre champs que vous détesteriez voir erronés et vérifiez chacun par rapport à son emplacement source. Ce seul passage vous en apprend plus sur un outil que n'importe quelle affirmation de précision sur sa page marketing.