L'IA peut-elle extraire des données de PDF multipages ?
Oui — voici à quoi s'attendre
Oui. L'IA peut lire et extraire des données de PDF multipages — y compris les documents où les informations pertinentes s'étendent sur plusieurs pages, comme les contrats dont les pages de signature se trouvent plusieurs pages après le corps du texte, ou les relevés bancaires où le solde courant se reporte d'une page à l'autre. L'IA lit toutes les pages comme un document continu. La question clé n'est pas de savoir si l'extraction multipage fonctionne — c'est de comprendre comment l'IA maintient la continuité à travers les sauts de page, et où cette continuité peut se rompre.
Points clés à retenir
- Vous passez des heures à assembler manuellement des tableaux à travers les sauts de page et à rapprocher les soldes courants — non pas parce que vous êtes lent, mais parce que les outils qui lisent page par page brisent toutes les relations entre les pages.
- Un relevé bancaire traité page par page perd la chaîne du solde courant — le solde de clôture de la page 3 ne se connecte jamais au solde d'ouverture de la page 4, car chaque page a été traitée comme un monde isolé.
- Téléversez le même PDF multipage comme un seul fichier et l'IA le lit comme un document continu — transactions ordonnées, solde cohérent, zéro rapprochement manuel entre les pages.
Efficacité : lecture page par page vs compréhension au niveau du document
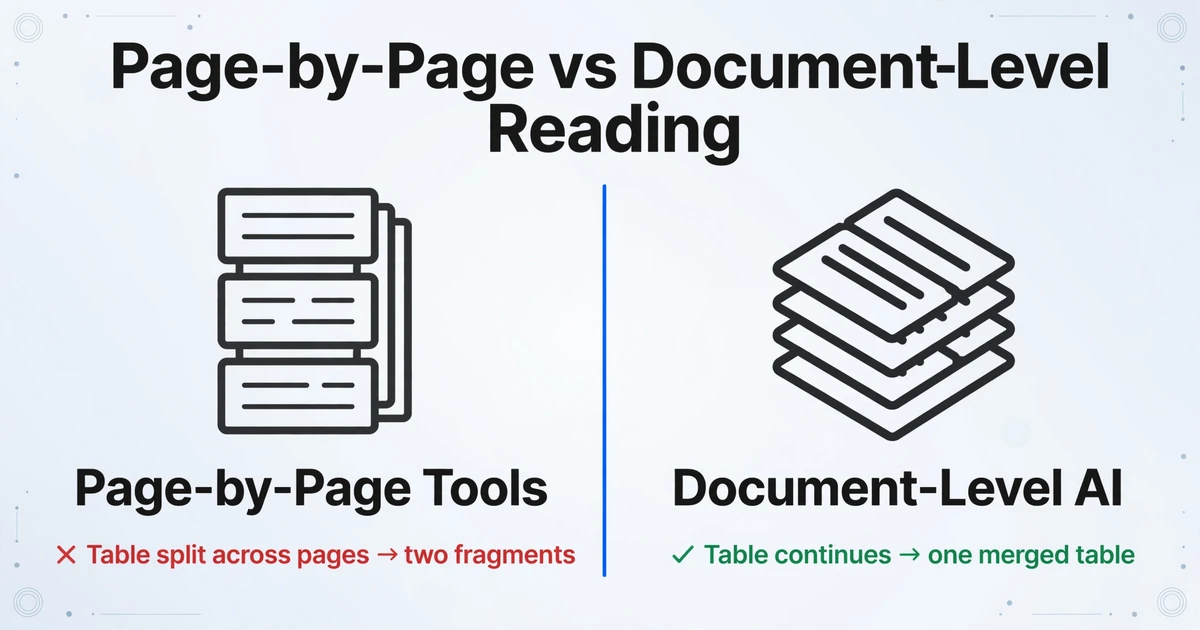
La différence entre les outils capables de traiter des documents multipages et les autres tient à un choix d'architecture : l'outil lit-il page par page, ou le document dans son ensemble ?
La plupart des outils d'extraction traditionnels — bibliothèques PDF, pipelines OCR de base, voire certains analyseurs basés sur l'IA — traitent les pages isolément. La page 1 passe dans le moteur. La page 2 suit. La page 3. Chaque page est un monde à part. Si un tableau commence en bas de la page 3 et se poursuit sur la page 4, l'outil voit deux fragments incomplets. Les en-têtes de colonnes de la page 3 ne sont pas repris. Un solde courant sur un relevé bancaire perd tout son sens lorsque le solde final de chaque page ne se raccorde pas au point de départ de la page suivante.
L'extraction moderne par IA — propulsée par les modèles de vision-langage — adopte l'approche inverse. Elle lit le PDF entier comme un document visuel continu. Elle reconnaît que le tableau de la page 12 est la suite de celui de la page 11, car elle voit la même structure de colonnes et les mêmes schémas de données. Elle n'a pas besoin d'une règle disant « hériter des en-têtes de colonnes de la page précédente » — elle comprend que c'est ce qui doit s'y trouver, car elle lit le document, elle ne traite pas une pile de pages.
C'est ce qui rend l'extraction de documents par IA qualitativement différente de l'OCR basé sur des modèles. L'IA suit la trame narrative du document — une date d'entrée en vigueur en page 1 d'un contrat appartient au même document que la signature en page 14. Une transaction à la ligne 47 d'un relevé bancaire se relie au solde courant de la ligne 48, même si la ligne 48 se trouve sur la page suivante. Pour le mécanisme sous-jacent, voir comment l'IA lit les documents.
Continuité du solde
Les relevés bancaires sont le test décisif. Un relevé mensuel type fait 3 à 8 pages avec un solde qui doit rester cohérent à chaque saut de page. Les outils page par page brisent cette chaîne — ils produisent les transactions des pages 3 et 4 comme des blocs déconnectés, nécessitant une vérification croisée manuelle pour la réconciliation.
L'IA qui lit le document complet préserve cette chaîne naturellement. Le modèle voit le relevé comme un long registre unique. Lorsque la sortie arrive dans un tableur, les transactions apparaissent dans l'ordre avec une colonne de solde cohérente — aucune couture requise.
Continuation des tableaux sur les sauts de page
Lorsqu'un tableau multi-colonnes est coupé par une limite de page — courant dans les bons de commande avec de nombreuses lignes ou les rapports financiers — la plupart des outils perdent la correspondance des colonnes. Les dernières lignes de la page N arrivent comme des valeurs orphelines sans étiquettes de champ, car les en-têtes étaient sur la page N-1.
Les modèles de vision IA reconnaissent le tableau comme une structure visuelle unique s'étendant sur plusieurs pages. La disposition à six colonnes de la page 5 est la même disposition à six colonnes de la page 4 — mêmes positions de colonnes, mêmes types de données, même formatage. L'IA continue de remplir le même tableau logique, fusionnant les lignes de continuation de manière transparente sous les en-têtes d'origine dans la sortie.
Ce que l'IA réussit avec les documents multipages
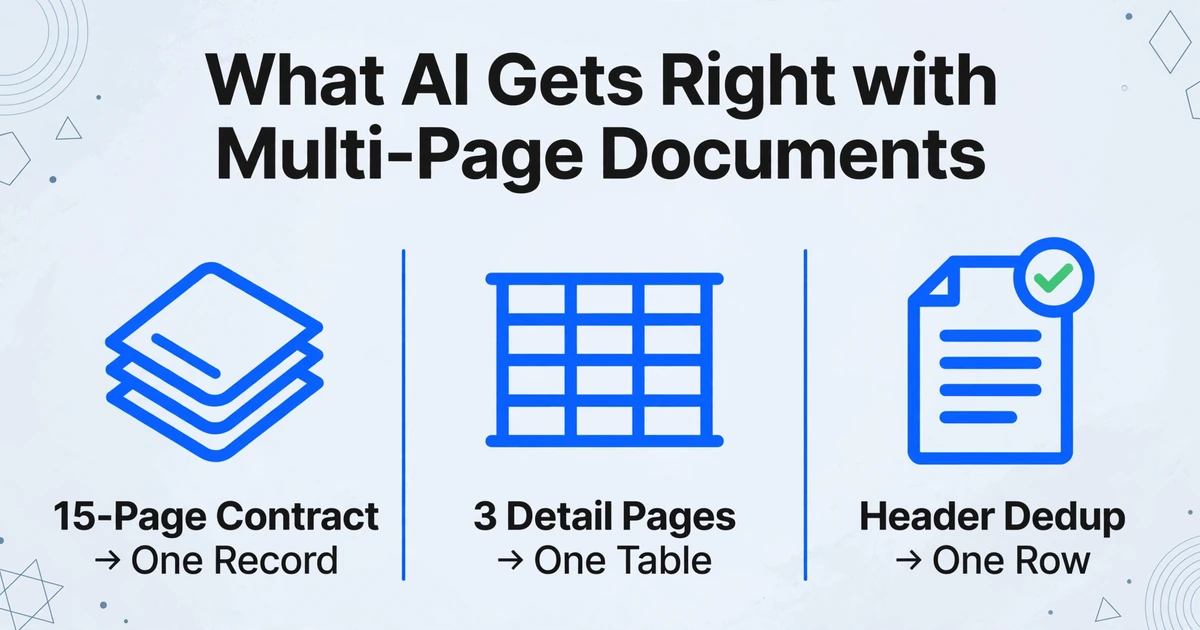
- Contrats avec pages de signature séparées. Un contrat de 15 pages avec les noms des parties et les dates en page 1, les obligations sur les pages 2 à 12, et les signatures sur les pages 13 à 15 est extrait en un seul enregistrement unifié — l'IA le lit comme un document unique, pas comme une collection de pages discontinues.
- Factures multipages avec pages de continuation. Les lignes d'articles sur 3 pages de détail s'écoulent dans un tableau continu unique, avec les totaux récapitulatifs de la page 4 alignés sur la même ligne de sortie. Aucune fusion manuelle de tableaux partiels.
- Déduplication des champs d'en-tête. Lorsque « Facture n° 4521 » apparaît sur chaque page d'un document de 8 pages, l'IA qui lit de manière holistique l'extrait une seule fois — reconnaissant les en-têtes de page comme des artefacts d'impression, pas comme des points de données distincts. Les outils page par page produisent 8 lignes en double.
- Traitement par lots de documents de longueurs variées. Déposez 20 PDF — certains d'une page, certains de 12 pages, certains de 40 — dans un seul lot. Chaque document produit une ligne dans la sortie, quel que soit le nombre de pages. Un contrat de 40 pages et une facture d'une page arrivent dans le même tableau avec des colonnes alignées.
Le schéma central : L'IA gère bien les documents multipages lorsque le document a une logique interne cohérente — des champs qui se rapportent, des tableaux qui continuent, des soldes qui s'accumulent. Elle échoue lorsque cette cohérence se brise.
Là où l'IA rencontre des difficultés avec les documents multipages
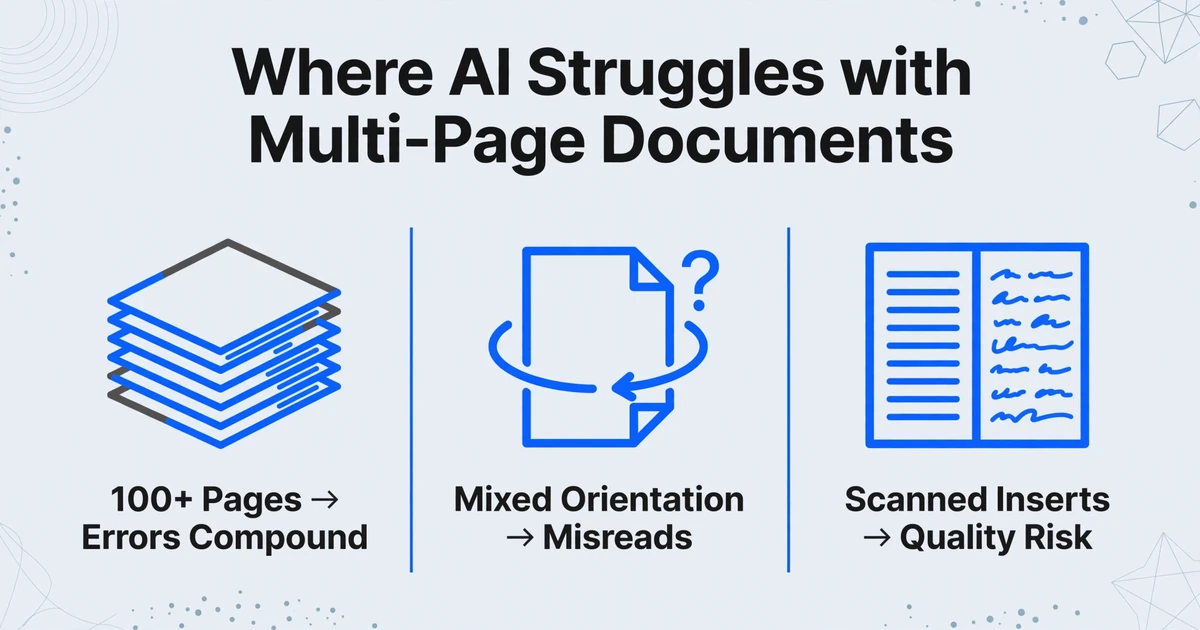
- Documents très longs (100+ pages). Les erreurs de transcription s'accumulent avec la longueur. Une seule erreur à la page 87 d'un dossier de 120 pages peut se répercuter sur les champs référencés de manière croisée. Diviser les documents de plus de 100 pages en sections logiques avant l'extraction améliore la précision — extrayez les définitions, les obligations et les annexes séparément plutôt que comme un seul traitement monolithique.
- Pages à orientation mixte. Un document où la page 3 est en portrait et la page 4 en paysage — courant dans les rapports contenant des feuilles de calcul intégrées — peut perturber le suivi de l'orientation. L'IA peut mal lire le texte pivoté ou perdre la structure du tableau sur la page en paysage. Normaliser l'orientation des pages avant le téléchargement résout ce problème.
- Changements de format en cours de route. Un PDF qui commence comme un export numérique mais contient des pages scannées insérées — comme un dossier de comptes fournisseurs avec une note manuscrite jointe — crée un mélange imprévisible. L'IA gère cela mieux que les outils traditionnels (qui échouent sur les pages scannées), mais la précision sur les scans insérés dépend de la qualité du scan. Voir l'IA peut-elle extraire des données de PDF scannés pour le traitement des PDF scannés.
Comment obtenir les meilleurs résultats avec les documents multipages
Conservez les pages liées dans un même fichier. Diviser un relevé bancaire de 10 pages en 10 PDF distincts donne à l'IA 10 documents indépendants — chacun avec un solde courant isolé et fragmenté. Téléversez le PDF de 10 pages comme un seul fichier, et l'IA lit l'intégralité du grand livre comme une chaîne continue.
Nommez explicitement les champs qui s'étendent sur plusieurs pages. Si un contrat mentionne « Partie A » à la page 1 et « Signé par la Partie A » à la page 14, utilisez des noms de colonnes distincts — « Nom de la Partie A » et « Date de signature de la Partie A » — afin que l'IA place chaque valeur dans la bonne colonne plutôt que de confondre les deux occurrences.
Divisez les documents très longs aux limites logiques. Un document juridique de 150 pages comporte des ruptures naturelles — définitions, corps principal, annexes. Diviser en sections permet à l'IA de se concentrer sur les champs spécifiques de chaque section sans plus de 100 pages de contenu sans rapport. Cela reflète l'approche d'un relecteur humain.
Vérifiez par sondage les champs trans-pages, pas chaque cellule. Lors d'une extraction sur 20 pages, concentrez la relecture sur les champs les plus vulnérables aux sauts de page : soldes courants aux transitions de pages, éléments de ligne qui chevauchent les limites, et valeurs apparaissant à la fois dans les en-têtes et le corps du texte. Vérifier 8 à 10 cellules critiques détecte la grande majorité des problèmes.
Exemples concrets : les documents multipages que l'IA traite au quotidien
Relevés bancaires multipages
Un relevé bancaire professionnel mensuel fait 5 à 8 pages : une page de synthèse suivie du détail des transactions avec les soldes courants. L'IA lit l'intégralité du relevé en continu, en sortant chaque transaction dans l'ordre avec un solde cohérent qui suit la ligne d'ouverture jusqu'à la ligne de clôture — exactement comme sur le PDF d'origine, sans aucun rapprochement manuel.
Contrats multipages
Les contrats signés placent les noms des parties et les dates en page 1, les obligations sur les pages 2 à 10, et les signatures sur les pages 11 à 14 — le tout formant un seul enregistrement logique. L'IA lit l'intégralité du contrat et regroupe tout dans une seule ligne : nom de la partie, date d'entrée en vigueur, valeur du contrat, droit applicable, date de signature — chacun dans sa propre colonne. Le temps gagné ne vient pas seulement de l'extraction ; il vient aussi du fait de ne plus avoir à revenir à la page 1 pour vérifier à quel contrat cette page de signature appartient.
FAQ
Y a-t-il une limite de pages pour l'extraction de documents par IA ?
La plupart des outils d'extraction par IA traitent de manière fiable des documents allant jusqu'à 50 à 100 pages. Au-delà de 100 pages, les taux d'erreur augmentent car les erreurs de transcription s'accumulent et les champs recoupés deviennent plus difficiles à suivre. Pour les documents plus longs, diviser en sections logiques avant l'extraction donne de meilleurs résultats.
Puis-je traiter des PDF d'une page et de plusieurs pages dans un même lot ?
Oui. Déposez un dossier contenant une facture d'une page, un contrat de 12 pages et un relevé bancaire de 6 pages dans le même lot. L'IA lit chaque document indépendamment et produit une ligne par document — une facture d'une page et un contrat de 50 pages occupent chacun exactement une ligne dans la sortie.
Que se passe-t-il lorsqu'un tableau chevauche un saut de page ?
L'IA qui lit en continu reconnaît le tableau comme une seule structure et fusionne les lignes des deux pages sous les mêmes en-têtes de colonnes. Cela fonctionne pour les tableaux à la mise en page cohérente. Si le format du tableau change entre les pages — nombre de colonnes différent ou cellules fusionnées — la précision diminue et une vérification manuelle de ces lignes est recommandée.
L'extraction multi-page fonctionne-t-elle sur les PDF scannés ?
Oui, à condition que la qualité de numérisation soit correcte (200+ DPI, plat, bien éclairé). L'IA lit les PDF scannés visuellement — de la même manière qu'elle lit les PDF numériques — donc le nombre de pages ne change pas l'approche. Un relevé scanné propre de 20 pages est extrait avec la même précision qu'une facture scannée propre de 2 pages. Voir l'IA peut-elle extraire des données de PDF scannés pour les exigences de qualité de numérisation.
Que faire si le même champ apparaît sur chaque page — comme un numéro de document dans l'en-tête ?
Les outils d'IA qui lisent de manière holistique extraient généralement le champ une fois et traitent les répétitions comme des artefacts d'impression. Certains outils peuvent encore produire des doublons. Utilisez des noms de colonnes sans ambiguïté, et si des doublons apparaissent dans le résultat, un passage rapide de déduplication dans le tableur les résout.
La différence entre les outils qui fonctionnent sur les documents multi-pages et ceux qui ne fonctionnent pas n'est pas un chiffre de précision — c'est de savoir si l'outil voit un document ou une pile de pages. Téléchargez un PDF multi-page et voyez comment les mêmes noms de colonnes extraient les données de chaque page en une seule lecture continue — sans découpage, sans assemblage, sans rapprochement page par page.
Essayer ImageToTable.ai gratuitement