Kann KI Daten aus mehrseitigen PDFs extrahieren?
Ja – das erwartet Sie
Ja. KI kann Daten aus mehrseitigen PDFs lesen und extrahieren – einschließlich Dokumenten, bei denen relevante Informationen über mehrere Seiten verteilt sind, wie Verträge mit Unterschriftsseiten mehrere Seiten nach dem Hauptteil oder Kontoauszüge, bei denen sich der laufende Saldo über Seiten hinweg fortsetzt. Die KI liest alle Seiten als ein zusammenhängendes Dokument. Die entscheidende Frage ist nicht, ob die Extraktion aus mehrseitigen Dokumenten funktioniert – es geht darum zu verstehen, wie die KI die Kontinuität über Seitenumbrüche hinweg aufrechterhält und wo diese Kontinuität zusammenbrechen kann.
Die wichtigsten Erkenntnisse
- Sie verbringen Stunden damit, Tabellen manuell über Seitenumbrüche hinweg zusammenzufügen und laufende Salden abzugleichen – nicht weil Sie langsam sind, sondern weil Tools, die Seite für Seite lesen, jede seitenübergreifende Beziehung zerstören.
- Ein seitenweise verarbeiteter Kontoauszug verliert die Kette des laufenden Saldos – der Endsaldo von Seite 3 wird nie mit dem Anfangssaldo von Seite 4 verbunden, weil jede Seite als isolierte Welt verarbeitet wurde.
- Laden Sie dasselbe mehrseitige PDF als eine Datei hoch und die KI liest es als ein zusammenhängendes Dokument – Transaktionen geordnet, Saldo konsistent, null manueller Abgleich über Seiten hinweg.
Wie gut es funktioniert: Seitenweises Lesen vs. Dokumentverständnis
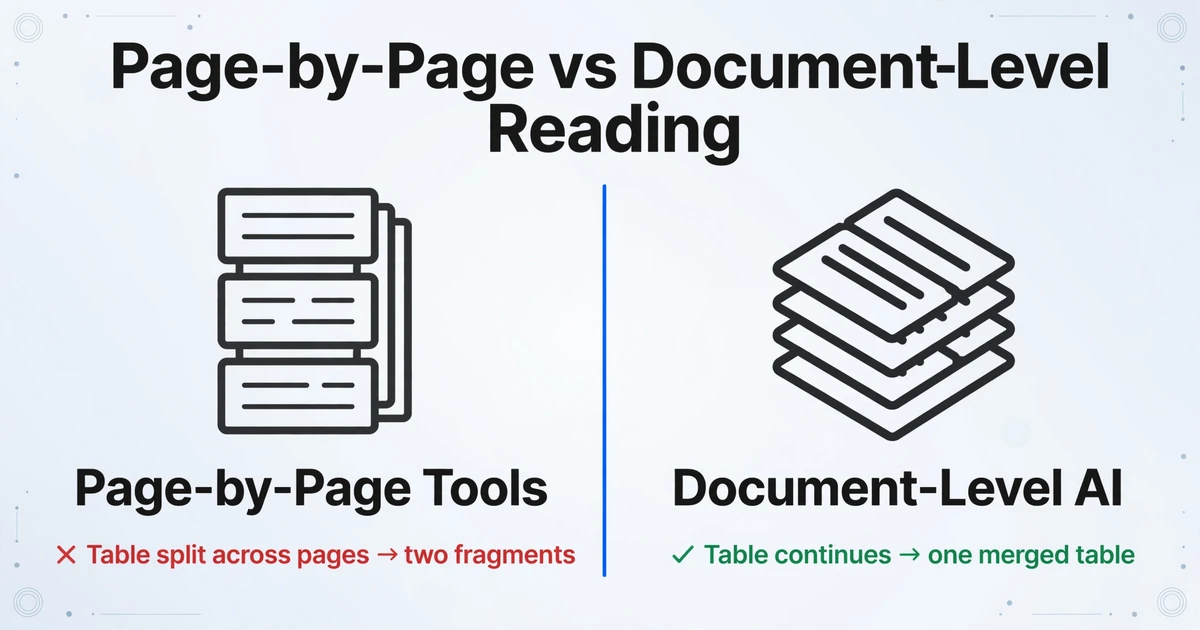
Der Unterschied zwischen Tools, die mit mehrseitigen Dokumenten arbeiten, und solchen, die das nicht tun, liegt in einer architektonischen Entscheidung: Liest das Tool Seite für Seite oder das Dokument als Ganzes?
Die meisten herkömmlichen Extraktionstools – PDF-Bibliotheken, einfache OCR-Pipelines, sogar einige KI-basierte Parser – verarbeiten Seiten isoliert. Seite 1 durchläuft die Engine. Seite 2 folgt. Seite 3. Jede Seite ist eine eigene Welt. Beginnt eine Tabelle am Ende von Seite 3 und setzt sich auf Seite 4 fort, sieht das Tool zwei unvollständige Fragmente. Spaltenüberschriften auf Seite 3 werden nicht übernommen. Ein laufender Saldo in einem Kontoauszug wird bedeutungslos, wenn der Endsaldo jeder Seite nicht mit dem Startpunkt der nächsten Seite verbunden ist.
Moderne KI-Extraktion – unterstützt durch visuelle Sprachmodelle – verfolgt den gegenteiligen Ansatz. Sie liest das gesamte PDF als ein kontinuierliches visuelles Dokument. Sie erkennt, dass die Tabelle auf Seite 12 eine Fortsetzung der Tabelle auf Seite 11 ist, weil sie dieselbe Spaltenstruktur und dieselben Datenmuster sieht. Sie benötigt keine Regel, die besagt: „Spaltenüberschriften von der vorherigen Seite übernehmen“ – sie versteht, dass diese dorthin gehören, weil sie das Dokument liest und nicht einen Stapel Seiten verarbeitet.
Genau das macht KI-Dokumentenextraktion qualitativ anders als vorlagenbasierte OCR. Die KI verfolgt die Erzählung des Dokuments – ein Wirksamkeitsdatum auf Seite 1 eines Vertrags gehört zu demselben Dokument wie die Unterschrift auf Seite 14. Eine Transaktion in Zeile 47 eines Kontoauszugs steht in Verbindung mit dem laufenden Saldo in Zeile 48, selbst wenn Zeile 48 auf der nächsten Seite liegt. Zum zugrunde liegenden Mechanismus siehe wie KI Dokumente liest.
Kontinuität des laufenden Saldos
Kontoauszüge sind der Härtetest. Ein typischer monatlicher Kontoauszug umfasst 3–8 Seiten, wobei der Saldo über jeden Seitenumbruch hinweg konsistent bleiben muss. Seitenweise arbeitende Tools brechen diese Kette – sie geben Transaktionen von Seite 3 und Seite 4 als getrennte Blöcke aus, was einen manuellen Abgleich zur Abstimmung erfordert.
KI, die das gesamte Dokument liest, erhält diese Kette auf natürliche Weise. Das Modell betrachtet den Kontoauszug als ein einziges langes Hauptbuch. Wenn die Ausgabe in einer Tabellenkalkulation landet, erscheinen die Transaktionen in der richtigen Reihenfolge mit einer konsistenten Saldospalte – kein Zusammenfügen erforderlich.
Tabellenfortsetzung über Seitenumbrüche hinweg
Wenn eine mehrspaltige Tabelle an einer Seitengrenze umbricht – häufig bei Bestellungen mit vielen Positionen oder Finanzberichten – verlieren die meisten Tools die Spaltenzuordnung. Die letzten Zeilen auf Seite N erscheinen als verwaiste Werte ohne Feldbezeichnungen, da sich die Kopfzeilen auf Seite N-1 befanden.
KI-Visionsmodelle erkennen die Tabelle als eine visuelle Struktur, die sich über Seiten erstreckt. Das sechsspaltige Layout auf Seite 5 ist dasselbe sechsspaltige Layout wie auf Seite 4 – gleiche Spaltenpositionen, gleiche Datentypen, gleiche Formatierung. Die KI füllt dieselbe logische Tabelle weiter und fügt die Fortsetzungszeilen nahtlos unter den ursprünglichen Kopfzeilen in der Ausgabe zusammen.
Was KI bei mehrseitigen Dokumenten richtig macht
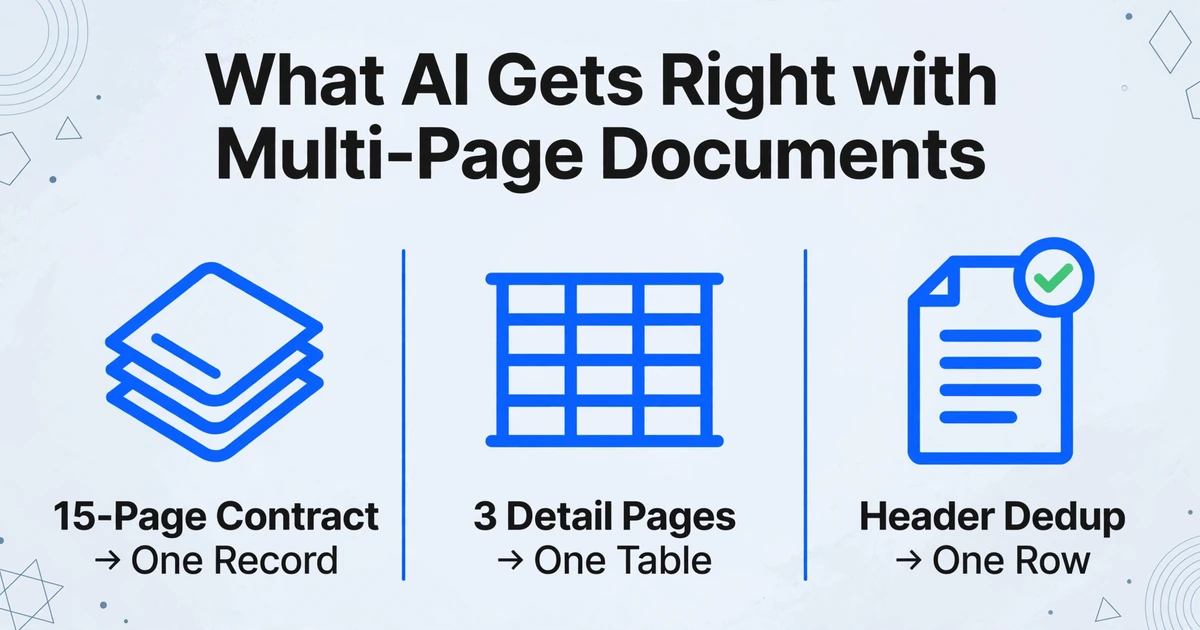
- Verträge mit getrennten Unterschriftenseiten. Ein 15-seitiger Vertrag mit Parteinamen und Daten auf Seite 1, Verpflichtungen auf den Seiten 2–12 und Unterschriften auf den Seiten 13–15 wird in einen einheitlichen Datensatz extrahiert – die KI liest ihn als ein Dokument, nicht als eine Sammlung nicht zusammenhängender Seiten.
- Mehrseitige Rechnungen mit Fortsetzungsseiten. Positionen über 3 Detailseiten fließen in eine durchgehende Tabelle, wobei die Summen von Seite 4 an derselben Ausgabezeile ausgerichtet werden. Kein manuelles Zusammenführen von Teiltabellen.
- Deduplizierung von Kopffeldern. Wenn „Rechnung Nr. 4521“ auf jeder Seite eines 8-seitigen Dokuments erscheint, extrahiert KI, die ganzheitlich liest, sie nur einmal – sie erkennt Seitenkopfzeilen als Druckartefakte, nicht als separate Datenpunkte. Seitenweise arbeitende Tools erzeugen 8 doppelte Zeilen.
- Batch-Verarbeitung von Dokumenten mit gemischter Länge. Legen Sie 20 PDFs in einen Batch – einige mit 1 Seite, einige mit 12 Seiten, einige mit 40. Jedes Dokument erzeugt unabhängig von der Seitenzahl eine Zeile in der Ausgabe. Ein 40-seitiger Vertrag und eine 1-seitige Rechnung landen in derselben Tabelle mit ausgerichteten Spalten.
Das Kernmuster: KI verarbeitet mehrseitige Dokumente gut, wenn das Dokument eine kohärente interne Logik aufweist – Felder, die in Beziehung stehen, Tabellen, die fortgesetzt werden, Salden, die sich akkumulieren. Sie scheitert, wenn diese Kohärenz zusammenbricht.
Wo KI bei mehrseitigen Dokumenten an ihre Grenzen stößt
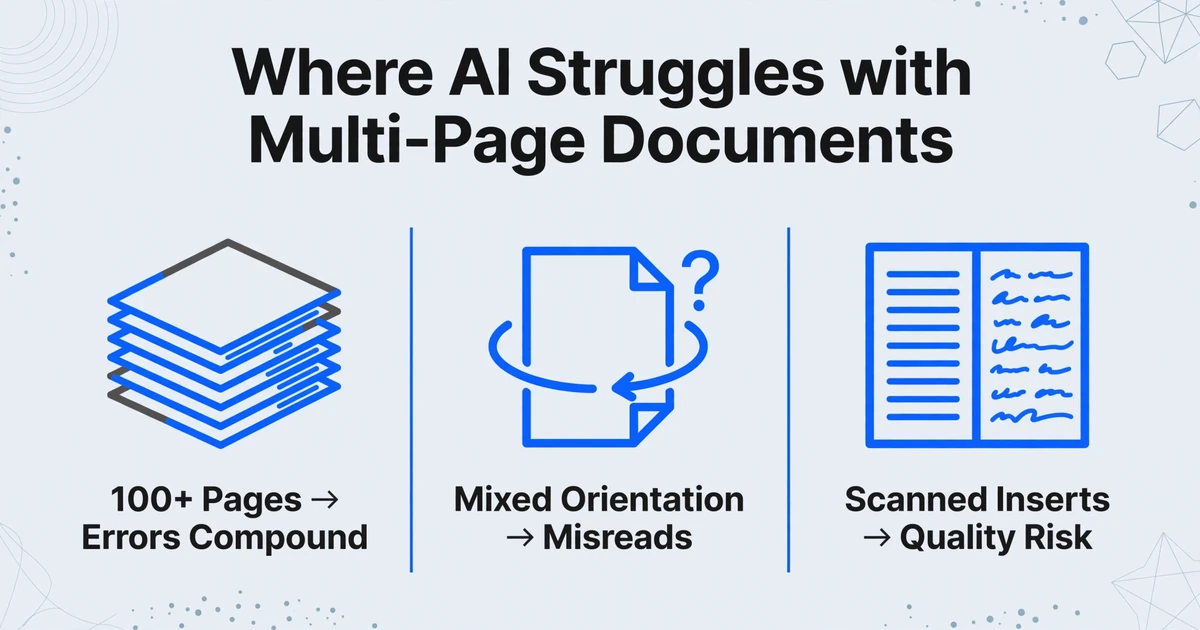
- Sehr lange Dokumente (100+ Seiten). Transkriptionsfehler summieren sich mit der Länge. Ein einzelner Fehler auf Seite 87 einer 120-seitigen Einreichung kann sich über kreuzreferenzierte Felder fortsetzen. Die Aufteilung von Dokumenten mit über 100 Seiten in logische Abschnitte vor der Extraktion verbessert die Genauigkeit – extrahieren Sie Definitionen, Verpflichtungen und Anhänge separat statt in einem einzigen monolithischen Durchlauf.
- Gemischte Seitenausrichtungen. Ein Dokument, bei dem Seite 3 im Hochformat und Seite 4 im Querformat vorliegt – häufig bei Berichten mit eingebetteten Tabellenkalkulationen – kann die Ausrichtungserkennung verwirren. Die KI könnte gedrehten Text falsch lesen oder die Tabellenstruktur auf der Querformatseite verlieren. Die Normalisierung der Seitenausrichtung vor dem Hochladen löst dieses Problem.
- Formatwechsel mitten im Dokument. Eine PDF-Datei, die als digitaler Export beginnt, aber eingescannte Seiten enthält – wie ein AP-Paket mit einer handschriftlichen Notiz – erzeugt eine unvorhersehbare Mischung. Die KI verarbeitet dies besser als herkömmliche Tools (die bei eingescannten Seiten versagen), aber die Genauigkeit bei eingefügten Scans hängt von der Scanqualität ab. Siehe Kann KI Daten aus eingescannten PDFs extrahieren? für die Verarbeitung eingescannten PDFs.
So erzielen Sie die besten Ergebnisse bei mehrseitigen Dokumenten
Zusammengehörige Seiten in einer Datei zusammenhalten. Wenn Sie einen 10-seitigen Kontoauszug in 10 separate PDFs aufteilen, erhält die KI 10 unabhängige Dokumente – jedes mit einem isolierten, unterbrochenen laufenden Saldo. Laden Sie das 10-seitige PDF als eine Datei hoch, und die KI liest das gesamte Hauptbuch als durchgehende Kette.
Felder, die sich über Seiten erstrecken, explizit benennen. Wenn ein Vertrag „Partei A" auf Seite 1 und „Unterzeichnet von Partei A" auf Seite 14 enthält, verwenden Sie eindeutige Spaltennamen – „Name Partei A" und „Unterschriftsdatum Partei A" – damit die KI jeden Wert der richtigen Spalte zuordnet, anstatt die beiden Vorkommen zu verwechseln.
Sehr lange Dokumente an logischen Grenzen aufteilen. Ein 150-seitiges Rechtsdokument hat natürliche Abschnittsgrenzen – Definitionen, Hauptteil, Anlagen. Durch die Aufteilung in Abschnitte kann sich die KI auf die spezifischen Felder jedes Abschnitts konzentrieren, ohne 100+ Seiten unzusammenhängenden Inhalts. Dies spiegelt die Vorgehensweise eines menschlichen Prüfers wider.
Seitenübergreifende Felder stichprobenartig prüfen, nicht jede Zelle. Bei einer 20-seitigen Extraktion konzentrieren Sie die Prüfung auf die Felder, die am anfälligsten für Seitenumbrüche sind: laufende Salden an Seitenübergängen, Positionen, die über Grenzen hinweggehen, und Werte, die sowohl in Kopfzeilen als auch im Fließtext erscheinen. Die Prüfung von 8–10 kritischen Zellen erfasst die überwiegende Mehrheit der Probleme.
Praktische Beispiele: Mehrseitige Dokumente, die KI täglich verarbeitet
Mehrseitige Kontoauszüge
Ein monatlicher Geschäftskontoauszug umfasst 5–8 Seiten: eine Übersichtsseite, gefolgt von Transaktionsdetails mit laufenden Salden. Die KI liest den gesamten Auszug kontinuierlich und gibt jede Transaktion in Reihenfolge mit einem konsistenten Saldo aus, der von der Eröffnungszeile bis zur Schlusszeile nachvollziehbar ist – genau wie im Original-PDF, ohne manuellen Abgleich.
Mehrseitige Verträge
Unterzeichnete Verträge nennen Vertragsparteien und Daten auf Seite 1, Verpflichtungen auf den Seiten 2–10 und Unterschriften auf den Seiten 11–14 – alles Teil eines einzigen logischen Datensatzes. Die KI liest den gesamten Vertrag und fasst alles in einer Zeile zusammen: Vertragspartei, Wirksamkeitsdatum, Vertragswert, anwendbares Recht, Unterschriftsdatum – jeweils in einer eigenen Spalte. Die Zeitersparnis liegt nicht nur in der Extraktion, sondern auch darin, nicht zur Seite 1 zurückblättern zu müssen, um zu bestätigen, zu welchem Vertrag diese Unterschriftenseite gehört.
FAQ
Gibt es eine Seitenbegrenzung für die KI-Dokumentextraktion?
Die meisten KI-Extraktionstools verarbeiten Dokumente mit bis zu 50–100 Seiten zuverlässig. Über 100 Seiten hinaus steigt die Fehlerquote, da sich Transkriptionsfehler summieren und kreuzreferenzierte Felder schwerer nachzuverfolgen sind. Bei längeren Dokumenten führt eine Aufteilung in logische Abschnitte vor der Extraktion zu besseren Ergebnissen.
Kann ich einseitige und mehrseitige PDFs in einem Batch verarbeiten?
Ja. Legen Sie einen Ordner mit einer 1-seitigen Rechnung, einem 12-seitigen Vertrag und einem 6-seitigen Kontoauszug in denselben Batch. Die KI liest jedes Dokument unabhängig und erzeugt eine Zeile pro Dokument – eine 1-seitige Rechnung und ein 50-seitiger Vertrag belegen jeweils genau eine Zeile in der Ausgabe.
Was passiert, wenn eine Tabelle über einen Seitenumbruch geteilt wird?
KI, die kontinuierlich liest, erkennt die Tabelle als eine Struktur und führt Zeilen von beiden Seiten unter denselben Spaltenüberschriften zusammen. Dies funktioniert bei Tabellen mit einheitlichem Layout. Ändert sich das Tabellenformat zwischen den Seiten – unterschiedliche Spaltenanzahl oder verbundene Zellen – sinkt die Genauigkeit, und eine manuelle Überprüfung dieser Zeilen wird empfohlen.
Funktioniert die Extraktion über mehrere Seiten auch bei gescannten PDFs?
Ja, sofern die Scanqualität angemessen ist (200+ DPI, flach, gut ausgeleuchtet). Die KI liest gescannte PDFs visuell – genauso wie digitale PDFs – daher ändert die Seitenanzahl den Ansatz nicht. Ein sauberer 20-seitiger Kontoauszug wird mit derselben Genauigkeit extrahiert wie eine saubere 2-seitige gescannte Rechnung. Siehe Kann KI Daten aus gescannten PDFs extrahieren? für Anforderungen an die Scanqualität.
Was ist, wenn dasselbe Feld auf jeder Seite erscheint – wie eine Belegnummer in der Kopfzeile?
KI-Tools, die ganzheitlich lesen, extrahieren das Feld in der Regel einmal und behandeln Wiederholungen als Druckartefakte. Einige Tools können dennoch Duplikate erzeugen. Verwenden Sie eindeutige Spaltennamen, und falls Duplikate in der Ausgabe erscheinen, löst ein schneller Deduplizierungsdurchlauf in der Tabellenkalkulation das Problem.
Der Unterschied zwischen Tools, die mit mehrseitigen Dokumenten arbeiten, und solchen, die es nicht tun, ist keine Genauigkeitszahl – es ist die Frage, ob das Tool ein Dokument oder einen Stapel Seiten sieht. Laden Sie ein mehrseitiges PDF hoch und sehen Sie, wie dieselben Spaltennamen Daten über jede Seite hinweg als einen kontinuierlichen Lesevorgang abrufen – ohne Aufteilung, ohne Zusammenfügen, ohne seitenweise Abgleich.
ImageToTable.ai kostenlos testen