AIは複数ページのPDFからデータを抽出できる?
はい — 期待できること
はい。AIは複数ページのPDFからデータを読み取り、抽出できます — 本文から数ページ離れた署名ページがある契約書や、累計残高がページをまたいで引き継がれる銀行取引明細書など、関連情報が複数ページにまたがるドキュメントも含みます。AIはすべてのページを1つの連続したドキュメントとして読み取ります。重要なのは複数ページ抽出が機能するかどうかではなく、AIがページ区切りをまたいでどのように連続性を維持するか、そしてその連続性がどこで崩れる可能性があるかを理解することです。
重要なポイント
- ページ区切りをまたいでテーブルを手作業でつなぎ合わせ、累計残高を照合するのに何時間も費やしています — それはあなたが遅いからではなく、ページごとに読み取るツールがすべてのページ間の関係を壊してしまうからです。
- 銀行取引明細書をページごとに処理すると、累計残高の連鎖が失われます — 各ページが独立した世界として処理されるため、3ページ目の最終残高が4ページ目の開始残高につながりません。
- 同じ複数ページのPDFを1つのファイルとしてアップロードすると、AIはそれを1つの連続したドキュメントとして読み取ります — 取引は順序付けられ、残高は一貫し、ページ間の手動照合はゼロです。
精度の検証:ページ単位の読み取りとドキュメント全体の理解
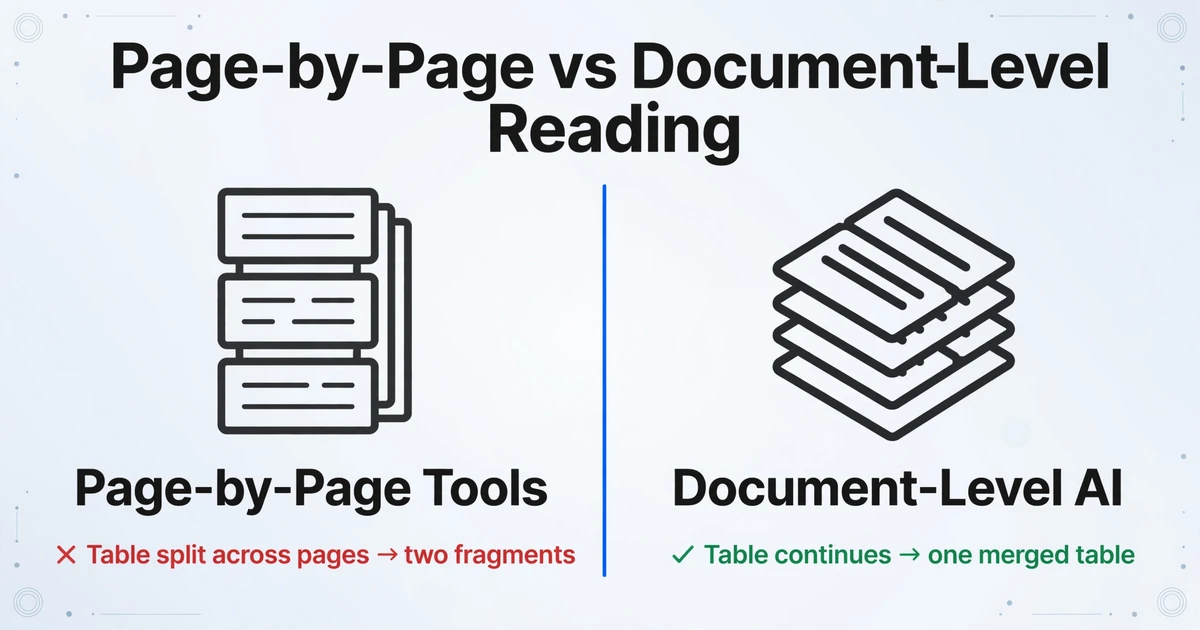
マルチページのドキュメントに対応できるツールとできないツールの違いは、1つの設計上の選択に集約されます。それは、ページ単位で読み取るか、ドキュメント全体として読み取るかです。
従来の抽出ツールのほとんど(PDFライブラリ、基本的なOCRパイプライン、AIベースのパーサーも含む)は、ページを個別に処理します。1ページ目がエンジンを通過し、2ページ目、3ページ目と続きます。各ページは独立した世界です。テーブルが3ページ目の下部で始まり4ページ目に続く場合、ツールは2つの不完全な断片を認識します。3ページ目の列ヘッダーは引き継がれません。銀行明細書の累計残高は、各ページの期末残高が次のページの期首残高と結びつかないため、意味を失います。
最新のAI抽出(ビジョン言語モデルを搭載)は、逆のアプローチを取ります。PDF全体を1つの連続した視覚ドキュメントとして読み取ります。12ページ目のテーブルが11ページ目のテーブルの続きであることを、同じ列構造とデータパターンを認識して判断します。「前のページから列ヘッダーを引き継ぐ」というルールは不要です。ページの集合を処理するのではなく、ドキュメントを読んでいるため、そこに何が属するかを理解できるのです。
これこそが、AIドキュメント抽出がテンプレートベースのOCRと質的に異なる点です。AIはドキュメントのストーリーを追跡します。契約書の1ページ目の発効日は、14ページ目の署名と同じドキュメントに属します。銀行明細書の47行目の取引は、48行目が次のページにまたがっていても、48行目の累計残高と結びつきます。基盤となる仕組みについては、AIがドキュメントを読み取る仕組みをご覧ください。
残高の連続性
銀行明細書は究極の試金石です。一般的な月次明細書は3〜8ページにわたり、各ページの区切りをまたいで残高が一貫している必要があります。ページ単位で処理するツールはこの連鎖を断ち切ります。3ページ目と4ページ目の取引を別々のブロックとして出力するため、照合には手作業での突き合わせが必要になります。
文書全体を読み取るAIは、この連鎖を自然に維持します。モデルは明細書を1つの長い台帳として認識します。出力がスプレッドシートに反映されると、取引は一貫した残高列とともに順序どおりに表示され、つなぎ合わせの作業は不要です。
ページ区切りをまたぐテーブルの継続
複数列のテーブルがページ境界をまたいで分割される場合(発注書の明細項目が多い場合や財務レポートでよく発生)、ほとんどのツールは列の対応関係を見失います。ページNの最後の行は、ヘッダーがページN-1にあるため、フィールドラベルなしの孤立した値として出力されます。
AIビジョンモデルは、テーブルをページをまたぐ1つの視覚的構造として認識します。5ページ目の6列レイアウトは、4ページ目と同じ6列レイアウトです。列の位置、データ型、書式がすべて同じです。AIは同じ論理テーブルへの入力を継続し、継続行を元のヘッダーの下にシームレスに統合して出力します。
AIがマルチページ文書で得意とする処理
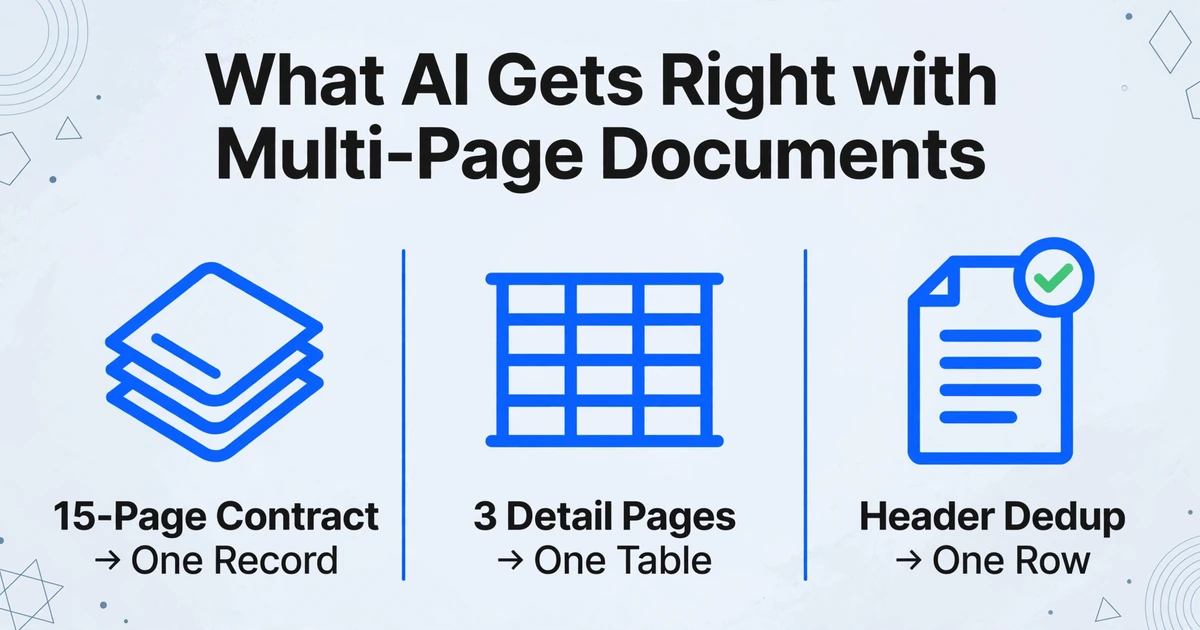
- 署名ページが分離された契約書。1ページ目に当事者名と日付、2〜12ページ目に義務、13〜15ページ目に署名がある15ページの契約書は、1つの統合レコードとして抽出されます。AIはこれを断片的なページの集合ではなく、1つの文書として読み取ります。
- 継続ページを含むマルチページ請求書。3つの詳細ページにわたる明細項目は1つの連続テーブルに流れ込み、4ページ目の合計額は同じ出力行に整列されます。部分テーブルの手動マージは不要です。
- ヘッダーフィールドの重複排除。8ページの文書の各ページに「Invoice #4521」が表示される場合、全体を読み取るAIはこれを1回だけ抽出します。ページヘッダーを印刷上の飾りと認識し、個別のデータポイントとは見なさないためです。ページ単位のツールでは8件の重複行が生成されます。
- 異なる長さの文書のバッチ処理。1ページのもの、12ページのもの、40ページのものなど、20件のPDFを1つのバッチにドロップします。各文書はページ数に関係なく、出力では1行を生成します。40ページの契約書と1ページの請求書が、列が整列された同じテーブルに格納されます。
核心となるパターン:AIは、文書に一貫した内部ロジック(関連するフィールド、継続するテーブル、累積する残高)がある場合、マルチページ文書を適切に処理します。その一貫性が崩れると、処理に苦労します。
AIがマルチページドキュメントで苦戦する点
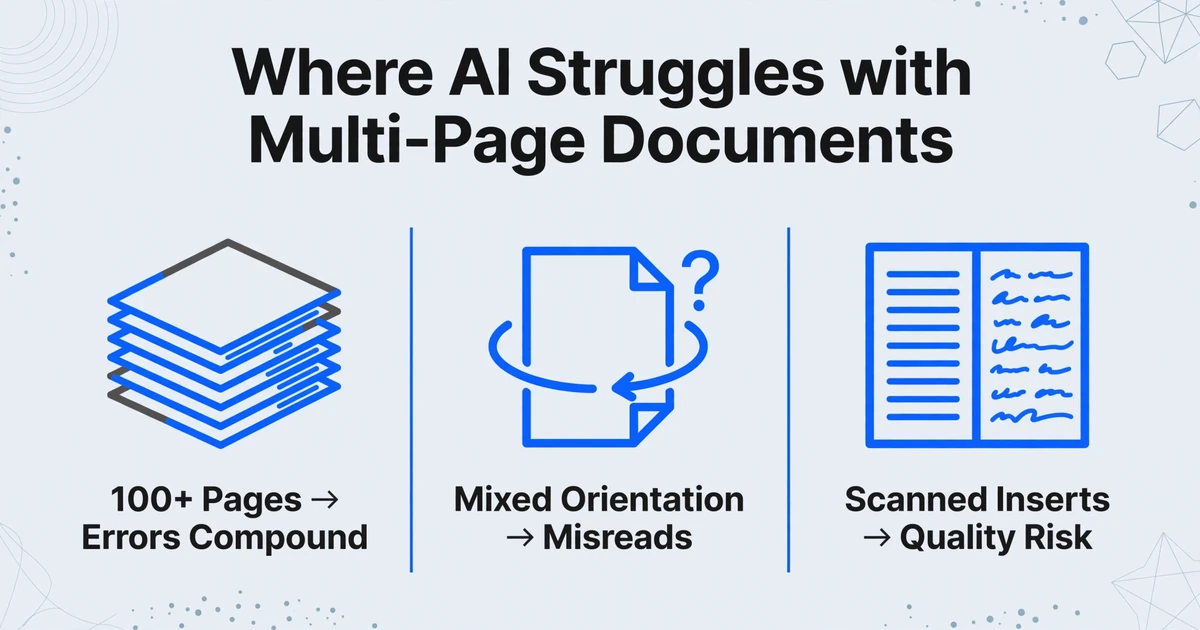
- 非常に長いドキュメント(100ページ超)。文字起こしエラーは文書が長くなるほど累積します。120ページの書類の87ページ目で起きた1つのミスが、相互参照フィールド全体に連鎖する可能性があります。抽出前に100ページ超のドキュメントを論理的なセクションに分割すると精度が向上します — 定義、義務、付属書を1つのまとまりとしてではなく、個別に抽出してください。
- 混在するページ向き。3ページ目が縦向きで4ページ目が横向きのドキュメント — 埋め込みスプレッドシートを含むレポートでよく見られます — は、向きの追跡を混乱させる可能性があります。AIは回転したテキストを誤読したり、横向きページのテーブル構造を失ったりすることがあります。アップロード前にページの向きを統一することで解決できます。
- 途中でのフォーマット変更。デジタル書き出しで始まり、スキャンしたページが挿入されたPDF — 手書きメモが添付されたAPパケットなど — は、予測不能な混在状態を生み出します。AIは従来のツール(スキャンページで失敗する)よりもこれをうまく処理しますが、挿入されたスキャンの精度はスキャン品質に依存します。スキャンPDFの処理についてはAIはスキャンしたPDFからデータを抽出できるかを参照してください。
マルチページドキュメントから最良の結果を得る方法
関連するページは1つのファイルにまとめてください。10ページの銀行明細書を10個の別々のPDFに分割すると、AIには10個の独立したドキュメントとして認識され、それぞれが孤立した不連続な残高になります。10ページのPDFを1つのファイルとしてアップロードすれば、AIは完全な台帳を連続したチェーンとして読み取ります。
複数ページにまたがるフィールドには明確な名前を付けましょう。契約書の1ページ目に「甲」、14ページ目に「甲の署名」がある場合、「甲の氏名」と「甲の署名日」のように異なる列名を使用してください。そうすることで、AIは各値を正しい列に配置し、2つの出現箇所を混同しません。
非常に長いドキュメントは論理的な区切りで分割しましょう。150ページの法的文書には、定義、本文、別表などの自然なセクション区切りがあります。セクションに分割することで、AIは100ページ以上の無関係なコンテンツに邪魔されることなく、各セクションの特定のフィールドに集中できます。これは人間のレビュアーが取り組む方法と同じです。
すべてのセルではなく、ページをまたぐフィールドを重点的に確認しましょう。20ページの抽出では、ページ区切りの影響を受けやすいフィールドにレビューを集中させてください。ページ遷移時の残高、境界をまたぐ明細行、ヘッダーと本文の両方に表示される値などです。8〜10個の重要なセルを確認すれば、問題の大部分を検出できます。
実際の例:AIが毎日処理するマルチページドキュメント
マルチページの銀行取引明細書
毎月の事業用銀行取引明細書は5〜8ページに及びます。概要ページに続き、取引詳細と累計残高が記載されています。AIは明細書全体を継続的に読み取り、すべての取引を順番どおりに出力し、開始行から終了行まで一貫した残高を追跡します。元のPDFに記載されている内容と完全に一致し、手動での照合作業は一切不要です。
マルチページの契約書
署名済み契約書では、当事者名と日付が1ページ目、義務事項が2〜10ページ、署名が11〜14ページに記載されており、すべてが1つの論理レコードを構成します。AIは契約書全体を読み取り、すべてを1行にまとめます。当事者名、発効日、契約金額、準拠法、署名日をそれぞれ専用の列に出力します。節約される時間は抽出作業だけではありません。この署名ページがどの契約書に属するかを確認するために1ページ目をめくり直す手間も省けます。
FAQ
AIドキュメント抽出にページ数の制限はありますか?
ほとんどのAI抽出ツールは、50〜100ページまでのドキュメントを確実に処理できます。100ページを超えると、文字起こしエラーが累積し、相互参照フィールドの追跡が困難になるため、エラー率が上昇します。より長いドキュメントの場合は、抽出前に論理セクションに分割すると、より良い結果が得られます。
単一ページとマルチページのPDFを同じバッチで処理できますか?
はい。1ページの請求書、12ページの契約書、6ページの銀行取引明細書が入ったフォルダを同じバッチにドロップできます。AIは各ドキュメントを個別に読み取り、ドキュメントごとに1行を生成します。1ページの請求書も50ページの契約書も、出力ではそれぞれ正確に1行を占めます。
表がページをまたいで分割された場合はどうなりますか?
連続読み取りに対応したAIは、表を1つの構造として認識し、両ページの行を同じ列ヘッダーの下に統合します。これはレイアウトが一貫している表で機能します。ページ間で表の形式が異なる場合(列数やセルの結合が異なる場合)は精度が低下するため、該当行の手動確認をお勧めします。
スキャンしたPDFでも複数ページの抽出は可能ですか?
はい、スキャン品質が適切(200 DPI以上、平坦で明るい状態)であれば可能です。AIはスキャンPDFをデジタルPDFと同様に視覚的に読み取るため、ページ数によってアプローチは変わりません。クリーンな20ページのスキャン明細書は、クリーンな2ページのスキャン請求書と同じ精度で抽出されます。スキャン品質の要件については、AIはスキャンPDFからデータを抽出できますかをご覧ください。
ヘッダーにある文書番号など、同じ項目がすべてのページに表示される場合はどうなりますか?
全体を読み取るAIツールは、通常その項目を1回だけ抽出し、繰り返しは印刷上のアーティファクトとして扱います。一部のツールでは重複が発生する可能性もあります。明確な列名を使用し、出力に重複が生じた場合は、スプレッドシートで簡単に重複除去することで解決できます。
複数ページ文書に対応するツールとそうでないツールの違いは、精度の数値ではありません。ツールが文書を見ているのか、それともページの束を見ているのかの違いです。複数ページのPDFをアップロードして、同じ列名がすべてのページにわたってデータを1回の連続読み取りで取得する様子をご確認ください。分割も、つなぎ合わせも、ページごとの調整も不要です。
ImageToTable.aiを無料で試す