¿Puede la IA extraer datos de PDF de varias páginas?
Sí — esto es lo que puede esperar
Sí. La IA puede leer y extraer datos de PDF de varias páginas, incluidos documentos donde la información relevante abarca varias páginas, como contratos con páginas de firma varias páginas después del cuerpo, o estados de cuenta bancarios donde el saldo acumulado se traslada entre páginas. La IA lee todas las páginas como un documento continuo. La pregunta clave no es si la extracción de varias páginas funciona, sino comprender cómo la IA mantiene la continuidad a través de los saltos de página y dónde esa continuidad puede fallar.
Conclusiones clave
- Usted dedica horas a unir manualmente tablas a través de los saltos de página y a conciliar saldos acumulados, no porque sea lento, sino porque las herramientas que leen página por página rompen toda relación entre páginas.
- Un estado de cuenta bancario procesado página por página pierde la cadena de saldo acumulado: el saldo final de la página 3 nunca se conecta con el saldo inicial de la página 4 porque cada página se procesó como un mundo aislado.
- Cargue el mismo PDF de varias páginas como un solo archivo y la IA lo leerá como un documento continuo: transacciones ordenadas, saldo consistente, sin conciliación manual entre páginas.
Qué tan bien funciona: lectura por página frente a comprensión a nivel de documento
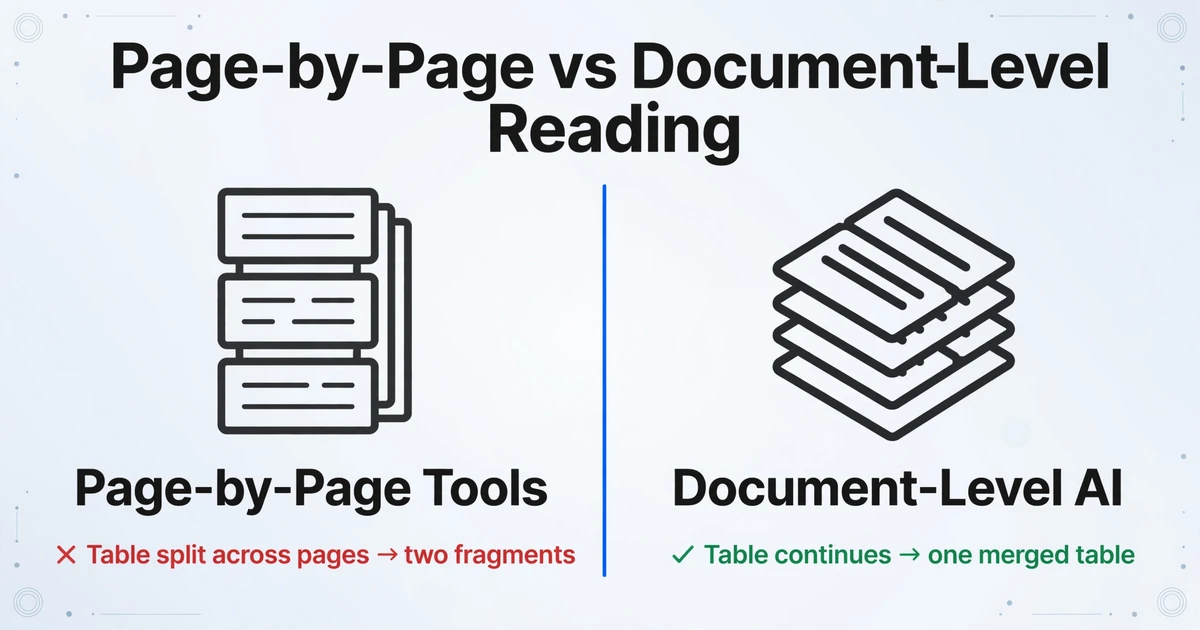
La diferencia entre las herramientas que funcionan con documentos de varias páginas y las que no, se reduce a una decisión arquitectónica: ¿la herramienta lee página por página o el documento como un todo?
La mayoría de las herramientas de extracción tradicionales — bibliotecas de PDF, flujos básicos de OCR, incluso algunos analizadores basados en IA — procesan las páginas de forma aislada. La página 1 pasa por el motor. Luego la página 2. La página 3. Cada página es su propio mundo. Si una tabla comienza al final de la página 3 y continúa en la página 4, la herramienta ve dos fragmentos incompletos. Los encabezados de columna de la página 3 no se transfieren. Un saldo corriente en un estado de cuenta bancario pierde sentido cuando el saldo final de cada página no se conecta con el punto de partida de la página siguiente.
La extracción moderna con IA — impulsada por modelos de visión y lenguaje — adopta el enfoque opuesto. Lee el PDF completo como un documento visual continuo. Reconoce que la tabla de la página 12 es una continuación de la tabla de la página 11 porque ve la misma estructura de columnas y los mismos patrones de datos. No necesita una regla que diga "heredar los encabezados de columna de la página anterior" — entiende que eso es lo que corresponde allí porque está leyendo el documento, no procesando una pila de páginas.
Esto es lo que hace que la extracción de documentos con IA sea cualitativamente diferente del OCR basado en plantillas. La IA sigue la narrativa del documento: una fecha de vigencia en la página 1 de un contrato pertenece al mismo documento que la firma en la página 14. Una transacción en la línea 47 de un estado de cuenta bancario se conecta con el saldo corriente de la línea 48, incluso si la línea 48 cae en la página siguiente. Para conocer el mecanismo subyacente, consulte cómo la IA lee documentos.
Continuidad del Saldo Correlativo
Los estados de cuenta bancarios son la prueba de fuego. Un estado de cuenta mensual típico abarca de 3 a 8 páginas con un saldo que debe mantenerse consistente en cada salto de página. Las herramientas página por página rompen esta cadena: generan las transacciones de la página 3 y la página 4 como bloques desconectados, lo que requiere una verificación cruzada manual para conciliarlos.
La IA que lee el documento completo preserva esta cadena de forma natural. El modelo ve el estado de cuenta como un único libro mayor extenso. Cuando el resultado llega a una hoja de cálculo, las transacciones aparecen en orden con una columna de saldo consistente, sin necesidad de unirlas manualmente.
Continuación de Tablas a Través de Saltos de Página
Cuando una tabla de varias columnas se interrumpe en un límite de página — algo común en órdenes de compra con muchas líneas de artículos o en informes financieros — la mayoría de las herramientas pierden el mapeo de columnas. Las últimas filas de la página N llegan como valores huérfanos sin etiquetas de campo porque los encabezados estaban en la página N-1.
Los modelos de visión de IA reconocen la tabla como una única estructura visual que abarca varias páginas. El diseño de seis columnas en la página 5 es el mismo diseño de seis columnas de la página 4: mismas posiciones de columna, mismos tipos de datos, mismo formato. La IA continúa completando la misma tabla lógica, fusionando las filas de continuación sin problemas bajo los encabezados originales en el resultado.
Lo que la IA Hace Bien con Documentos de Varias Páginas
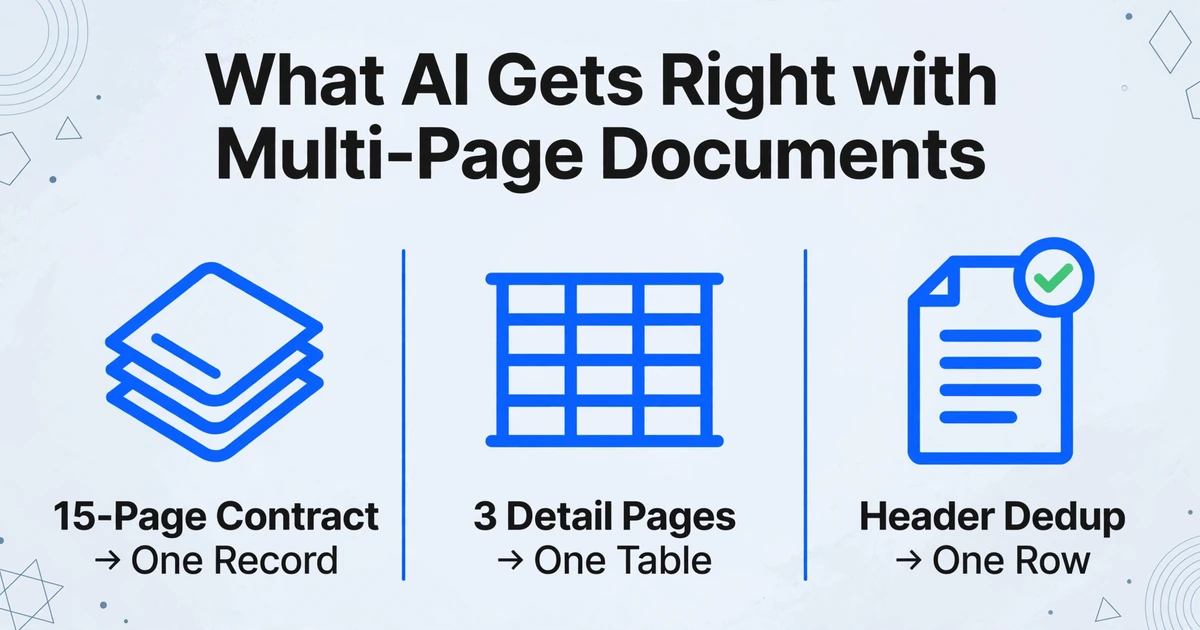
- Contratos con páginas de firma separadas. Un contrato de 15 páginas con nombres de las partes y fechas en la página 1, obligaciones en las páginas 2–12 y firmas en las páginas 13–15 se extrae en un único registro unificado: la IA lo lee como un solo documento, no como una colección de páginas inconexas.
- Facturas de varias páginas con páginas de continuación. Las líneas de artículos de 3 páginas de detalles fluyen en una tabla continua única, con los totales resumidos de la página 4 alineados en la misma fila de salida. Sin fusión manual de tablas parciales.
- Deduplicación de campos de encabezado. Cuando "Factura #4521" aparece en cada página de un documento de 8 páginas, la IA que lee de manera holística lo extrae una sola vez, reconociendo los encabezados de página como artefactos de impresión, no como puntos de datos separados. Las herramientas página por página producen 8 filas duplicadas.
- Procesamiento por lotes de documentos de longitud variable. Cargue 20 PDF — algunos de 1 página, otros de 12, otros de 40 — en un solo lote. Cada documento produce una fila en el resultado, independientemente del número de páginas. Un contrato de 40 páginas y una factura de 1 página llegan a la misma tabla con las columnas alineadas.
El patrón central: La IA maneja bien los documentos de varias páginas cuando el documento tiene una lógica interna coherente — campos que se relacionan, tablas que continúan, saldos que se acumulan. Le cuesta cuando esa coherencia se rompe.
Dónde la IA tiene dificultades con los documentos de varias páginas
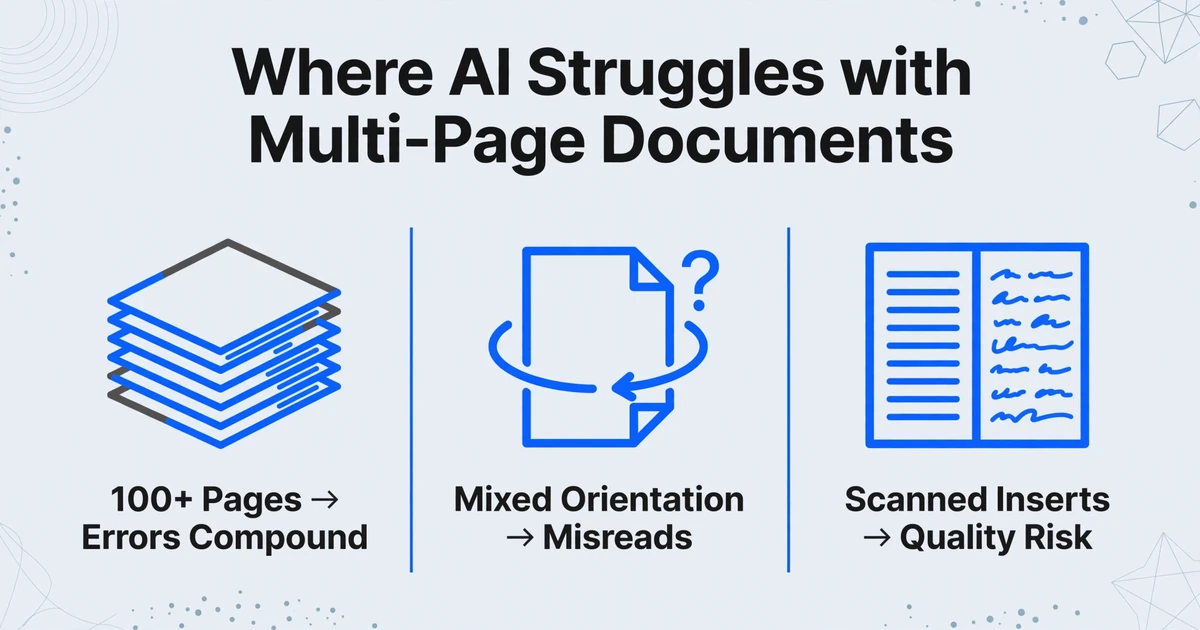
- Documentos muy largos (más de 100 páginas). Los errores de transcripción se acumulan con la longitud. Un solo error en la página 87 de un documento de 120 páginas puede propagarse a través de campos con referencias cruzadas. Dividir documentos de más de 100 páginas en secciones lógicas antes de la extracción mejora la precisión: extraiga definiciones, obligaciones y anexos por separado en lugar de hacerlo en una sola ejecución monolítica.
- Páginas con orientación mixta. Un documento donde la página 3 está en vertical y la página 4 en horizontal — algo común en informes con hojas de cálculo incrustadas — puede confundir el seguimiento de la orientación. La IA puede leer mal el texto rotado o perder la estructura de la tabla en la página horizontal. Normalizar la orientación de las páginas antes de la carga resuelve este problema.
- Cambios de formato a mitad del documento. Un PDF que comienza como una exportación digital pero tiene páginas escaneadas insertadas — como un paquete de cuentas por pagar con una nota manuscrita adjunta — crea una mezcla impredecible. La IA maneja esto mejor que las herramientas tradicionales (que fallan en las páginas escaneadas), pero la precisión en los escaneos insertados depende de la calidad del escaneo. Consulte ¿puede la IA extraer datos de PDF escaneados? para conocer el manejo de PDF escaneados.
Cómo obtener los mejores resultados de documentos de varias páginas
Mantenga las páginas relacionadas juntas en un solo archivo. Dividir un extracto bancario de 10 páginas en 10 PDF separados le da a la IA 10 documentos independientes, cada uno con un saldo corriente aislado y fragmentado. Suba el PDF de 10 páginas como un solo archivo y la IA leerá el libro mayor completo como una cadena continua.
Nombre explícitamente los campos que abarcan varias páginas. Si un contrato tiene "Parte A" en la página 1 y "Firmado por la Parte A" en la página 14, use nombres de columna distintos — "Nombre de la Parte A" y "Fecha de firma de la Parte A" — para que la IA coloque cada valor en la columna correcta en lugar de confundir las dos apariciones.
Divida documentos muy largos en límites lógicos. Un documento legal de 150 páginas tiene divisiones naturales por secciones: definiciones, cuerpo principal, anexos. Dividirlo en secciones permite que la IA se enfoque en los campos específicos de cada sección sin más de 100 páginas de contenido no relacionado. Esto refleja cómo un revisor humano abordaría el documento.
Verifique selectivamente los campos entre páginas, no cada celda. En una extracción de 20 páginas, centre la revisión en los campos más vulnerables a los saltos de página: saldos corrientes en las transiciones de página, partidas que abarcan límites y valores que aparecen tanto en encabezados como en el cuerpo del texto. Revisar entre 8 y 10 celdas críticas detecta la gran mayoría de los problemas.
Ejemplos reales: documentos de varias páginas que la IA maneja todos los días
Estados de cuenta bancarios de varias páginas
Un estado de cuenta bancario comercial mensual tiene de 5 a 8 páginas: una página de resumen seguida del detalle de transacciones con saldos corrientes. La IA lee el estado de cuenta completo de forma continua y genera cada transacción en orden con un saldo consistente que se rastrea desde la línea inicial hasta la línea final, exactamente como aparece en el PDF original, sin conciliación manual.
Contratos de varias páginas
Los contratos firmados colocan los nombres de las partes y las fechas en la página 1, las obligaciones en las páginas 2 a 10 y las firmas en las páginas 11 a 14, todo parte de un solo registro lógico. La IA lee el contrato completo y extrae todo en una sola fila: nombre de la parte, fecha de vigencia, valor del contrato, ley aplicable y fecha de firma, cada uno en su propia columna. El tiempo ahorrado no es solo la extracción; es no tener que volver a la página 1 para confirmar a qué contrato pertenece esa página de firmas.
Preguntas frecuentes
¿Existe un límite de páginas para la extracción de documentos con IA?
La mayoría de las herramientas de extracción con IA manejan documentos de hasta 50 a 100 páginas de forma confiable. Más allá de 100 páginas, las tasas de error aumentan porque los errores de transcripción se acumulan y los campos con referencias cruzadas son más difíciles de rastrear. Para documentos más largos, dividirlos en secciones lógicas antes de la extracción produce mejores resultados.
¿Puedo procesar PDF de una y varias páginas en un mismo lote?
Sí. Coloque una carpeta que contenga una factura de 1 página, un contrato de 12 páginas y un estado de cuenta bancario de 6 páginas en el mismo lote. La IA lee cada documento de forma independiente y genera una fila por documento: una factura de 1 página y un contrato de 50 páginas ocupan exactamente una fila cada uno en el resultado.
¿Qué sucede cuando una tabla se divide en un salto de página?
La IA que lee de forma continua reconoce la tabla como una sola estructura y fusiona las filas de ambas páginas bajo los mismos encabezados de columna. Esto funciona para tablas con diseños consistentes. Si el formato de la tabla cambia entre páginas —diferente número de columnas o celdas combinadas— la precisión disminuye y se recomienda revisar manualmente esas filas.
¿La extracción de varias páginas funciona en PDFs escaneados?
Sí, siempre que la calidad del escaneo sea razonable (200+ DPI, plano, bien iluminado). La IA lee los PDFs escaneados visualmente —de la misma manera que lee los PDFs digitales— por lo que la cantidad de páginas no cambia el enfoque. Un estado de cuenta escaneado limpio de 20 páginas se extrae con la misma precisión que una factura escaneada limpia de 2 páginas. Consulte ¿puede la IA extraer datos de PDFs escaneados? para conocer los requisitos de calidad del escaneo.
¿Qué sucede si el mismo campo aparece en cada página —como un número de documento en el encabezado?
Las herramientas de IA que leen de manera holística generalmente extraen el campo una vez y tratan las repeticiones como artefactos de impresión. Algunas herramientas aún pueden producir duplicados. Use nombres de columna inequívocos y, si aparecen duplicados en la salida, una pasada rápida de deduplicación en la hoja de cálculo lo resuelve.
La diferencia entre las herramientas que funcionan con documentos de varias páginas y las que no, no es un número de precisión —es si la herramienta ve un documento o una pila de páginas. Suba un PDF de varias páginas y vea cómo los mismos nombres de columna extraen datos de cada página como una sola lectura continua —sin división, sin costura, sin conciliación página por página.
Pruebe ImageToTable.ai Gratis