Où placer une étape de revue humaine dans un flux d'extraction de documents
La plupart des chaînes d'automatisation documentaire traitent l'extraction et l'import comme un seul mouvement : l'IA lit le document, et le résultat atterrit dans votre système comptable, votre base de données ou votre webhook. Les équipes qui exécutent cela en production savent que l'étape risquée n'est pas l'extraction. C'est le moment entre le tableau extrait et l'import, car c'est le moment où personne ne regarde.
Cet écart est mesurable. En comptabilité fournisseurs, le taux de traitement direct moyen est de 32,6 % (Ardent Partners 2025), ce qui signifie que près des deux tiers des factures reçoivent encore une intervention humaine quelque part dans le cycle. Les équipes qui maintiennent une extraction fiable y sont généralement arrivées de la même manière : elles ont décidé à l'avance où les personnes vérifient la sortie, ont doté cette étape en personnel et l'ont planifiée avant que quoi que ce soit ne soit importé.
Points clés à retenir
- 49,2 % est le taux de traitement direct de meilleure pratique, donc même les meilleures équipes confient encore environ la moitié de leurs factures à une personne.
- Même avec une précision par champ de 95 %, une facture à 15 champs sort entièrement correcte moins de la moitié du temps.
- Une passerelle de revue n'est pas un signe d'échec de l'automatisation, c'est ce qui rend le pipeline sûr à exécuter sans surveillance.
Un projet d'automatisation commence généralement par un chiffre que l'équipe souhaite atteindre : traiter 500 factures par jour, clôturer les flux bancaires sans ressaisie, charger chaque preuve de livraison dans l'ERP. Puis l'extraction est activée, le tableau se remplit, et la première vraie décision apparaît : qui regarde ce tableau avant que quoi que ce soit ne se déplace en aval ? Cet article explique pourquoi cette question mérite une réponse explicite, où l'étape de revue s'insère dans un flux de réception de documents, et comment une vérification de source au niveau de la cellule la maintient assez rapide pour que la passerelle ne devienne pas le goulot d'étranglement.
Ce que coûte une étape de revue manquante
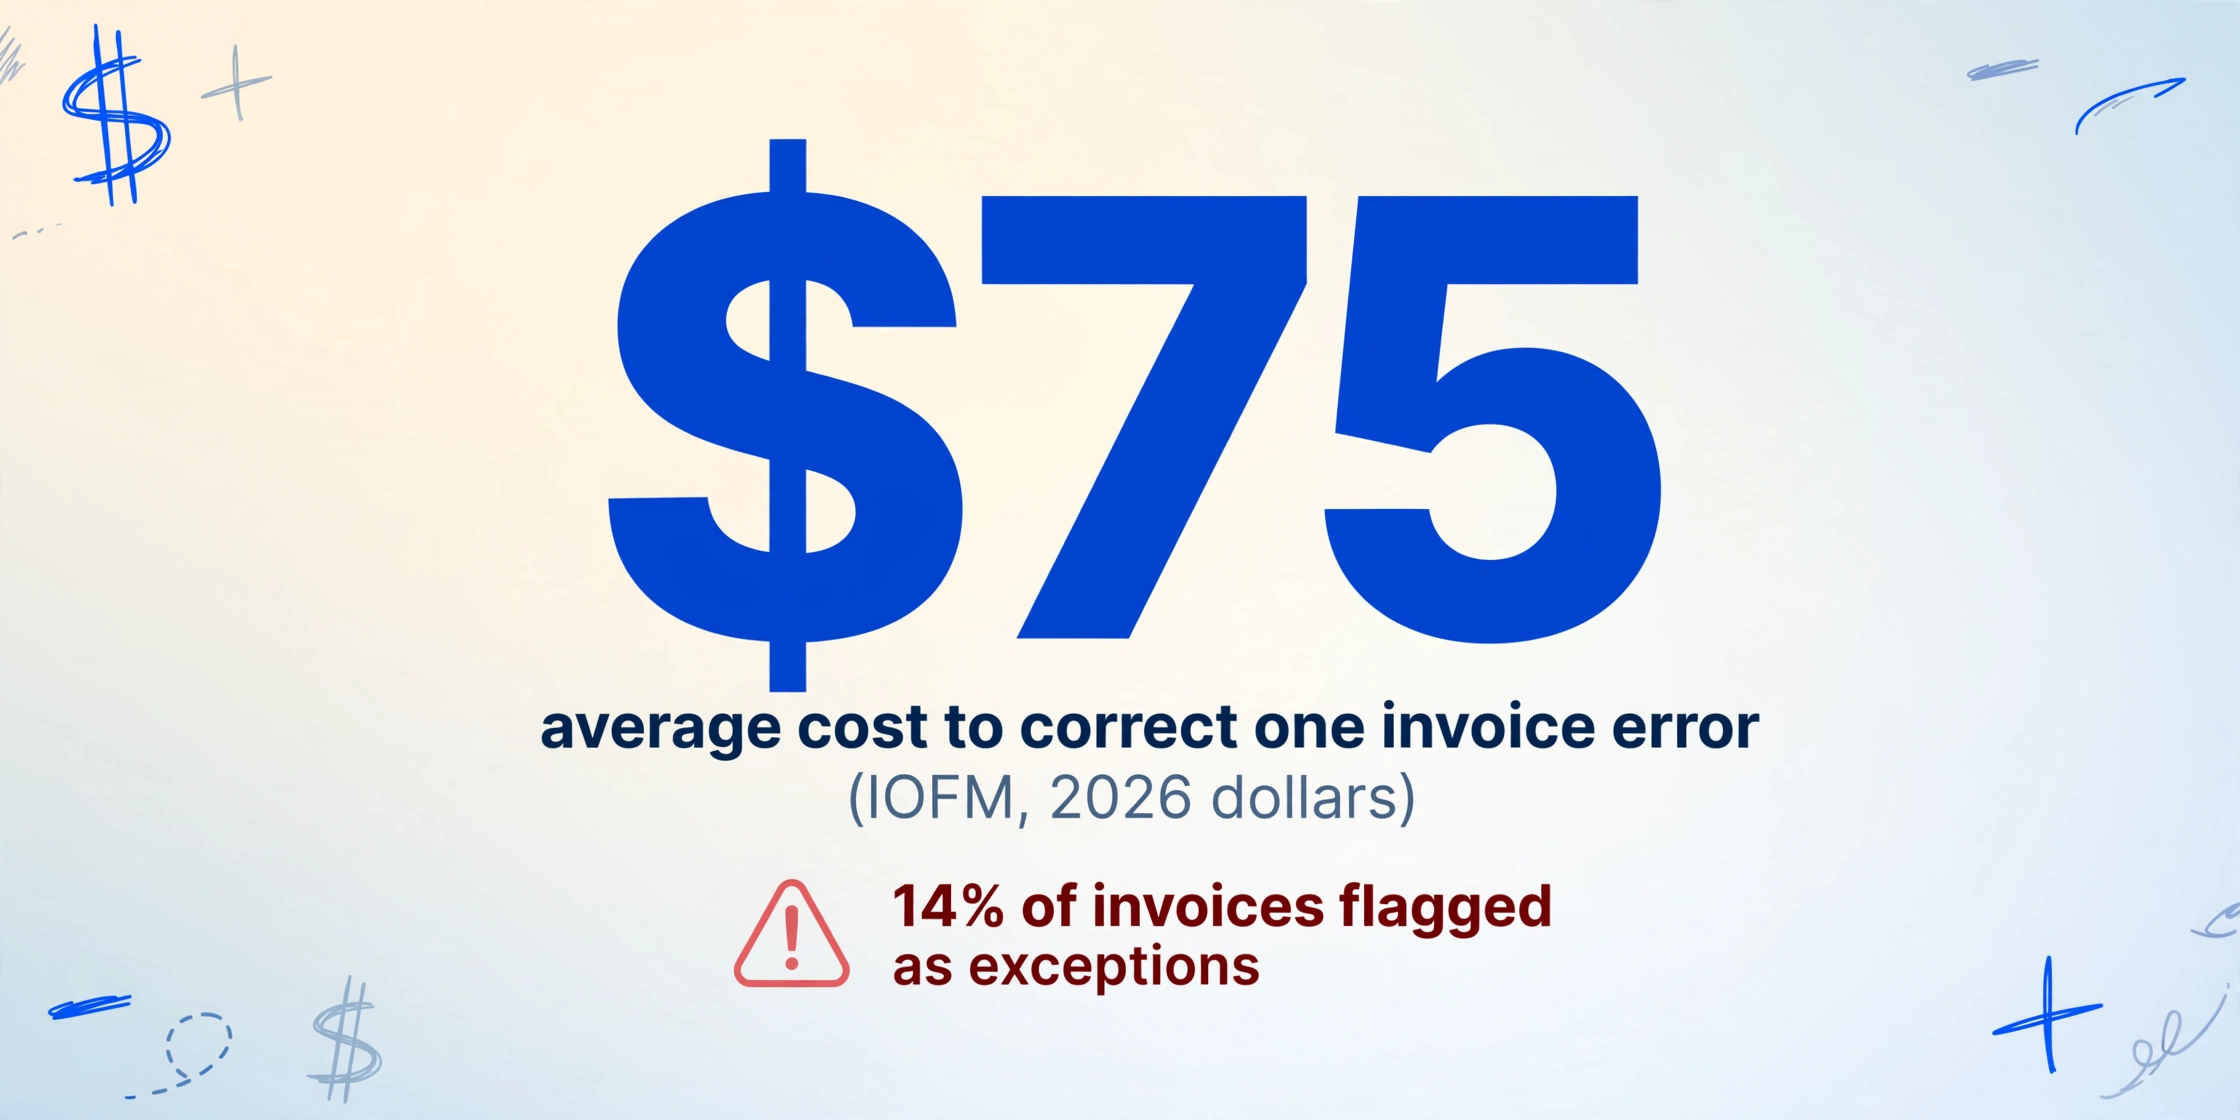
Sans la passerelle, une erreur d'extraction devient une erreur commerciale sans propriétaire. Une transposition de chiffres fait passer un total de facture de 2 470 $ à 2 740 $. Un nom de fournisseur mal lu une fois signifie un paiement dirigé vers le mauvais compte. Une ligne d'article de la page deux atterrit sur le mauvais document lorsqu'un jeu multipage est fusionné. Chacune de ces erreurs se situe dans les 14 % de factures que l'enquête 2025 d'Ardent Partners signale comme exceptions, et chacune est peu coûteuse à capturer dans le tableau, mais coûteuse à corriger après comptabilisation.
Le côté coût est bien documenté. IOFM établit une moyenne de traitement manuel de facture à 12,5 minutes, chaque exception ajoutant 15 à 45 minutes de traitement spécial par-dessus. La correction d'une seule erreur de facture coûte environ 75 $ en dollars de 2026, une fois l'enquête, la correction et le suivi inclus, et une erreur qui atteint le rapprochement peut ajouter 25 à 50 % au coût initial de la facture (IOFM ; Ardent Partners 2025). La file d'exceptions est la minorité coûteuse : les exceptions représentent généralement 5 à 15 % du volume de documents mais 30 à 50 % du coût total de traitement, car chaque exception consomme une attention humaine qualifiée.
Ceux qui vivent avec cela le savent par expérience. Dans un fil r/Accounting sur l'extraction automatisée de factures, un praticien AP a décrit ce que son équipe a construit après un an à faire confiance à l'outil : « nous avons dû mettre en place environ trois couches de validation différentes parce que l'IA continuait de rater les conditions de paiement ou de mélanger les lignes d'article sur les factures multipages... vous avez toujours besoin de quelqu'un pour surveiller chaque extraction » (r/Accounting). Ce que cette histoire montre, c'est une passerelle réactive : les humains ont été ajoutés après le premier mauvais import, alors qu'une étape de revue délibérée conçue en amont aurait capturé les mêmes erreurs à une fraction du coût.
Le flux d'entrée et où placer une passerelle
La réception de documents a une forme reconnaissable dans la plupart des équipes d'exploitation. Les documents arrivent (transfert d'e-mail, lien de collecte, dossier partagé, page de téléversement). Un moteur d'extraction lit chacun d'eux et produit un tableau. Ce tableau est exporté ou poussé vers le système d'enregistrement : Xero, QuickBooks, NetSuite, une base de données SQL, un webhook vers une automatisation plus large. Le pipeline comporte quatre moments où une étape de revue pourrait être placée :
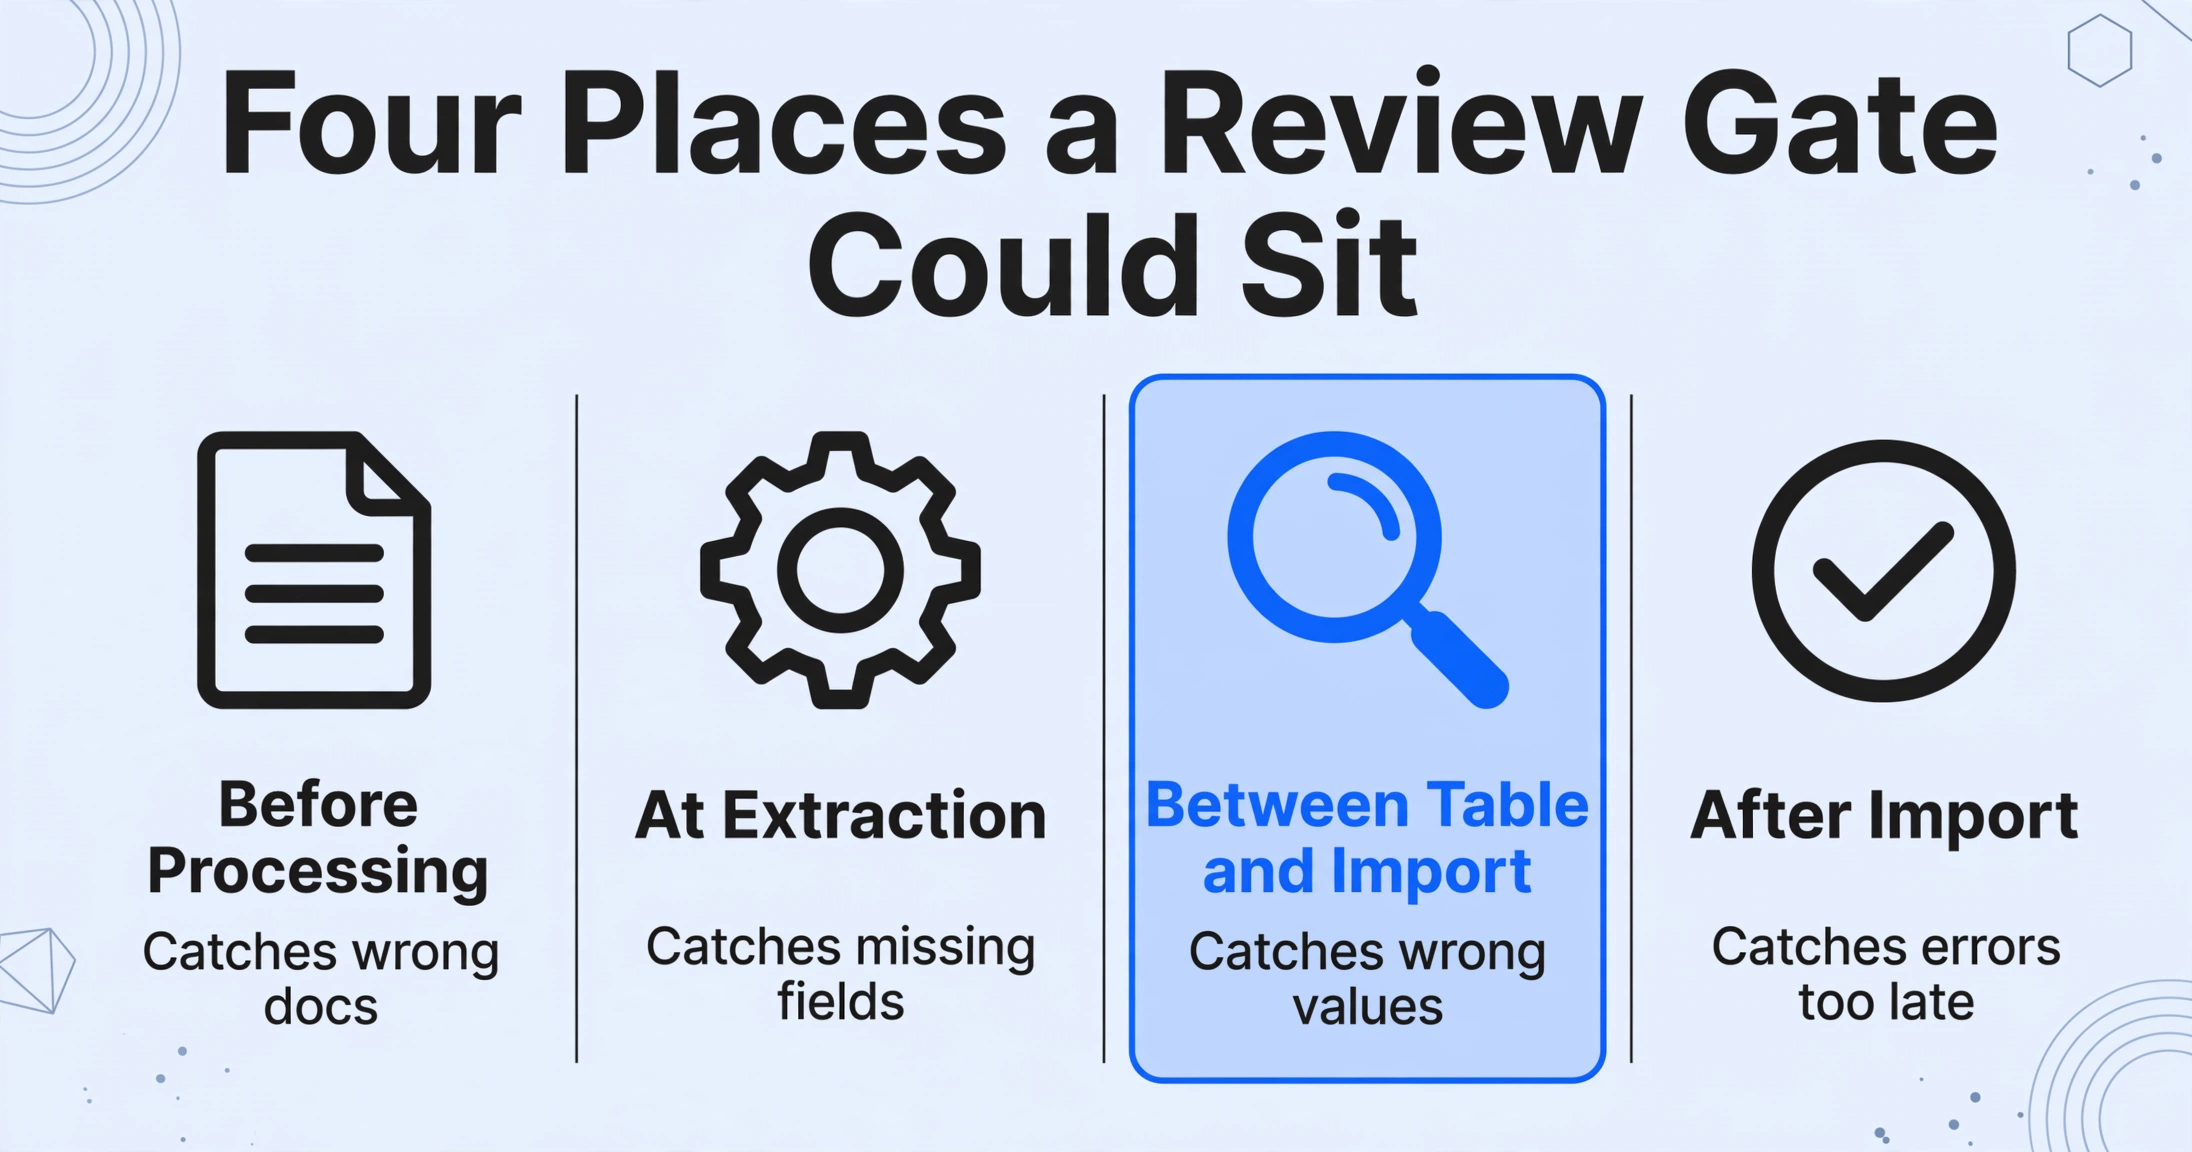
| Position de la passerelle | Ce qu'elle capture | Ce qu'elle manque |
|---|---|---|
| Avant le traitement (approbation de file d'attente) | Mauvais documents, doublons à la réception | Rien sur les valeurs extraites |
| Au moment de l'extraction (règles de validation) | Champs manquants, totaux qui ne se concilient pas | Valeurs présentes mais fausses |
| Entre le tableau et l'import (revue humaine) | Valeurs fausses, mal lues ou ambiguës | Erreurs quand le réviseur ne regarde pas |
| Après l'import (audit de comptabilisation) | Erreurs qui ont survécu, après que le coût est encouru | Tout jusqu'à ce que quelqu'un le remarque |
La troisième position est celle que la plupart des équipes sous-utilisent. Les règles de validation capturent les problèmes structurels, mais elles ne peuvent pas vous dire si le montant extrait est le montant imprimé sur la page. Cette comparaison, valeur extraite par rapport à la source, est un fait visible par l'humain, et c'est exactement à cela que sert une étape de revue entre le tableau et l'import.
Pourquoi 100 % de traitement direct n'est pas l'objectif réaliste
Mettre en place une passerelle de revue donne l'impression d'admettre que l'automatisation est incomplète. Le cadrage honnête est l'opposé : une passerelle est ce qui rend l'automatisation sûre à exécuter sans surveillance sur les documents qu'elle peut traiter. Le traitement direct signifie qu'un document termine l'ingestion, l'extraction, la validation et la comptabilisation avec zéro intervention humaine. D'après le même ensemble de données Ardent Partners, seulement 32,6 % des factures passent en traitement direct en moyenne, et le chiffre de meilleure pratique est de 49,2 % (Ardent Partners 2025). La page de référence sur les taux de traitement direct explique la formule et pourquoi les équipes de meilleure pratique laissent encore environ la moitié de leurs documents avec un point de contact humain.
Il y a de bonnes raisons pour que ces documents existent. Un champ manquant (le numéro de PO n'est pas sur la facture) est une absence qu'aucun moteur d'extraction ne peut inventer, et le traiter comme une erreur de lecture ne mène nulle part. L'écriture manuscrite, les scans de mauvaise qualité et les formats de date européens font trébucher les lecteurs au niveau des caractères. Les factures multipages voient leurs lignes d'article fusionnées dans un ordre incohérent. Et la précision par champ se cumule : même avec une précision par champ de 95 %, un document à 15 champs est entièrement correct moins de la moitié du temps (0,95 à la puissance 15), c'est pourquoi une attente de document entièrement propre échoue bien avant que le modèle soit blâmé. Les données sur le taux d'exception de l'automatisation documentaire collectent les chiffres indépendants derrière tout cela.
La règle pratique qui découle de ces chiffres est une file d'attente divisée : les documents dont les champs extraits passent vos contrôles passent sans regard, et un ensemble signalé plus petit reçoit une revue humaine avant l'import. Être dans cet ensemble signifie seulement que l'automatisation fait son travail en disant « vérifie-moi » ; cela ne dit rien sur la qualité du document ou de l'extraction.
Quelles lignes ont réellement besoin du regard humain
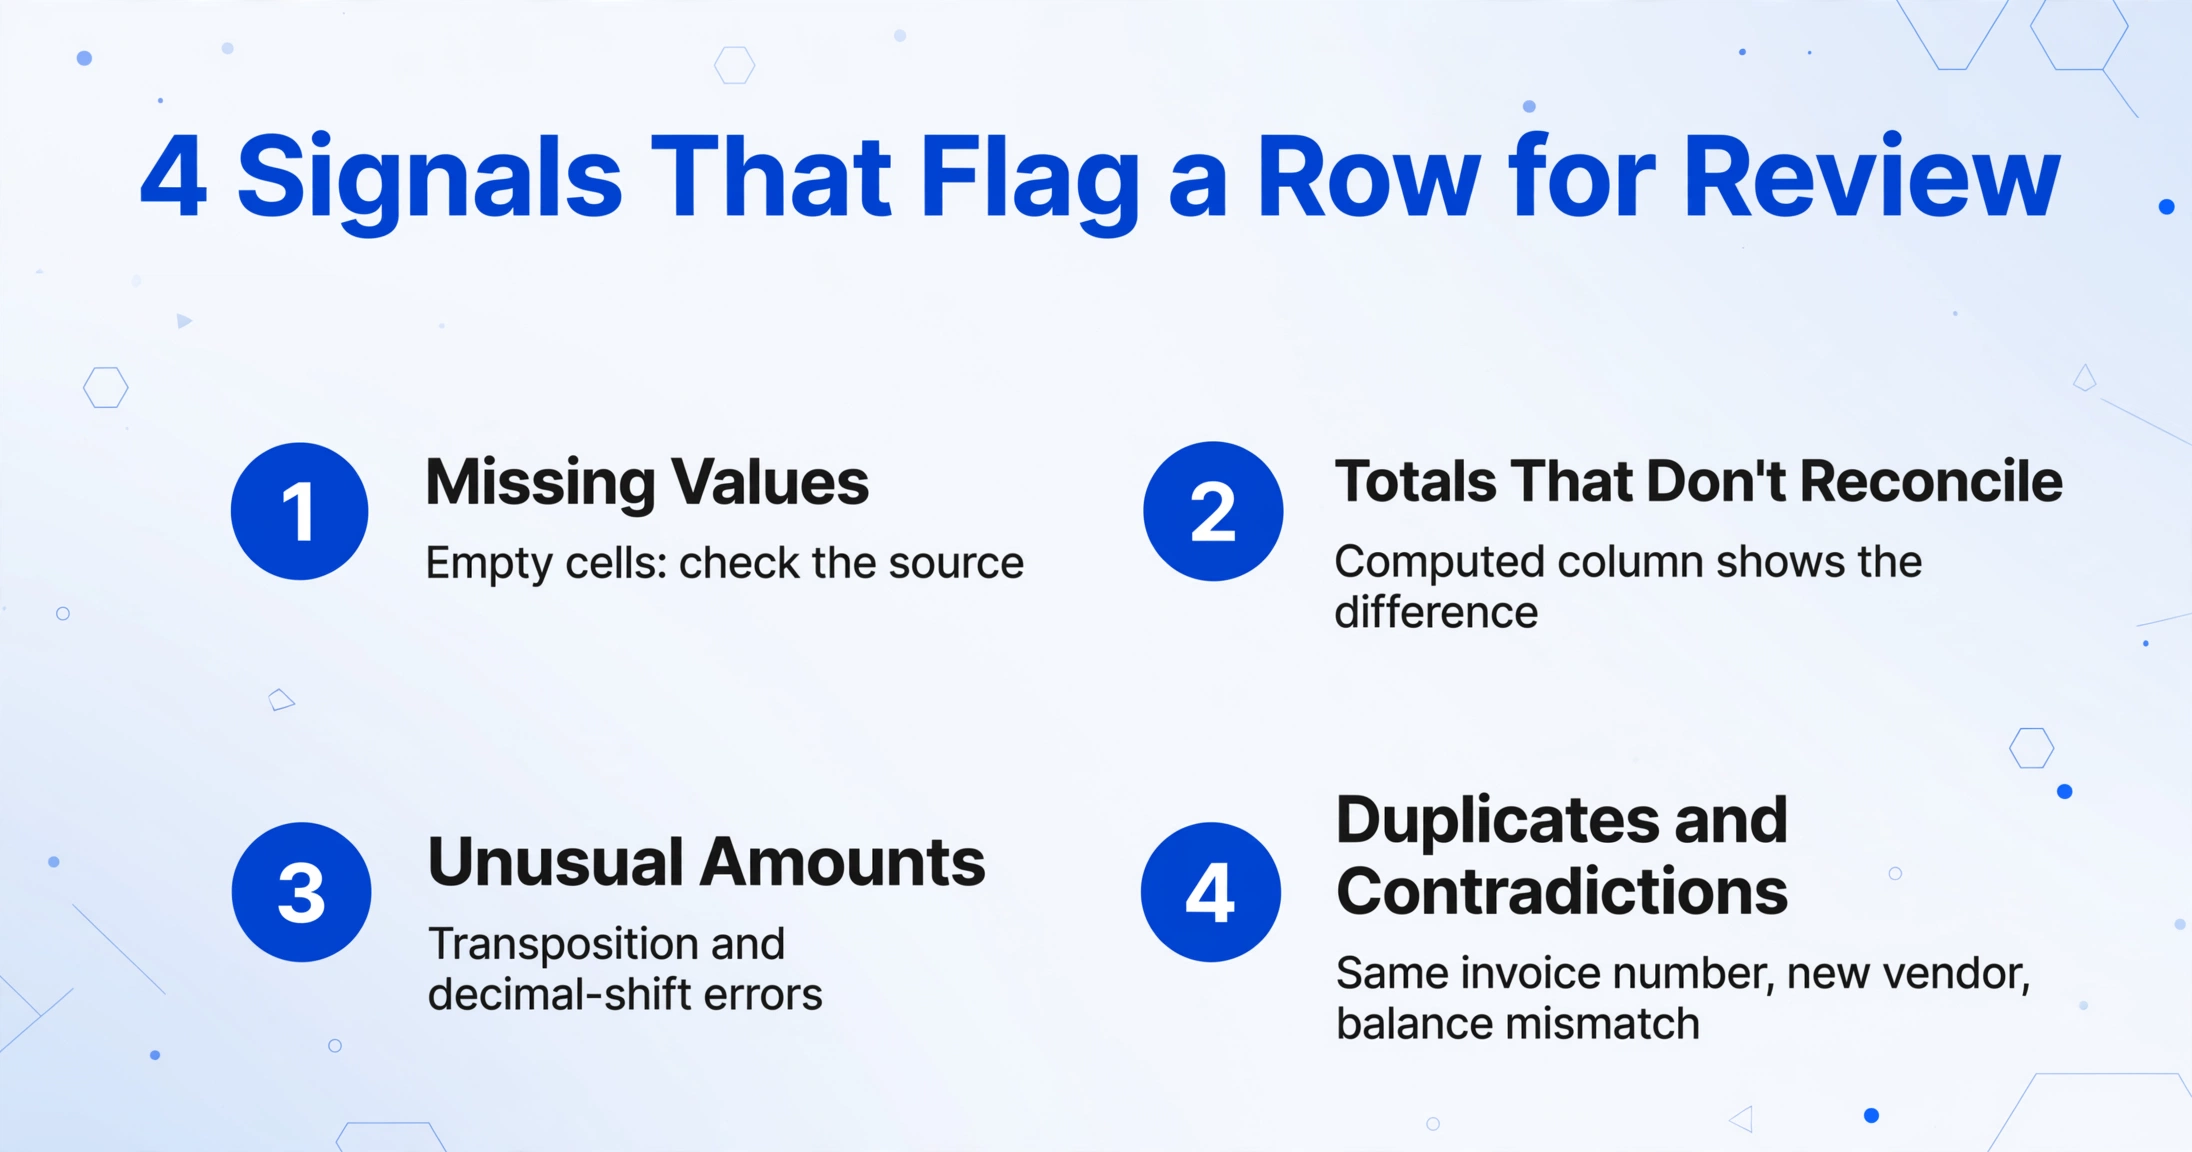
Examiner chaque ligne est aussi inutile que de n'en examiner aucune. La question de conception est de savoir quelles lignes portent le plus de risque. En pratique, quatre types de signaux couvrent la plupart de ce qu'une passerelle de revue devrait capturer :
- Valeurs manquantes. Un champ que l'extraction a renvoyé vide (numéro de facture, date, total). Triez le tableau par cellules vides et vérifiez la source : le champ peut être réellement absent, ou le moteur a pu le manquer.
- Valeurs qui ne se concilient pas. Un total qui ne correspond pas à la somme de ses lignes d'article. Si l'outil d'extraction prend en charge les colonnes calculées, demandez-lui de sortir la différence comme colonne de vérification, puis regardez les lignes où la différence n'est pas nulle.
- Montants inhabituels. Des valeurs hors de la plage que le fournisseur facture normalement, ou un total qui semble décalé d'un facteur dix. Ce sont les erreurs de transposition de chiffres et de décalage décimal.
- Deux documents qui ne devraient pas se comporter de manière identique. Des numéros de facture en double, des paiements vers un compte fournisseur que vous n'avez jamais vu, ou un solde de relevé bancaire qui contredit la période précédente.
Aucun de ces signaux n'exige de lire chaque cellule. Ce sont des filtres que vous appliquez d'abord au tableau, ce qui maintient l'étape humaine à des minutes plutôt qu'à des heures. Notre guide sur la vérification des résultats d'extraction avec des contrôles ponctuels ciblés couvre la logique d'échantillonnage en profondeur, notamment pourquoi l'échantillonnage aléatoire manque les erreurs qui se concentrent dans les montants, les dates et les identifiants.
Comment l'étape de revue correspond à une configuration
ImageToTable.ai prend en charge la revue en reliant chaque cellule extraite à l'emplacement d'origine sur le document. C'est ce qui rend la passerelle entre tableau et import assez rapide pour fonctionner en production. La configuration se décompose en quatre étapes.
Extraire le lot dans un tableau
Nommez les colonnes souhaitées (numéro de facture, numéro de PO, total, date d'échéance) et laissez le moteur d'extraction les remplir en trouvant chaque valeur n'importe où sur la page. Le téléversement par lot fusionne chaque document dans une seule feuille de calcul, afin que la passerelle de revue fonctionne sur l'ensemble du lot plutôt que fichier par fichier. La version API du même flux alimente directement vos systèmes en aval existants.
Activer l'auto-annotation pour le lot
Activez « auto-annotation après traitement » afin que chaque extraction revienne avec ses emplacements sources attachés. Survolez ou cliquez sur n'importe quelle cellule de l'écran de revue et l'image d'origine surligne exactement où cette valeur a été lue. Cliquez sur une région localisée de l'image et elle saute à la cellule correspondante du tableau.
Vérifier les lignes signalées par rapport à la source
Triez par vos signaux de risque : cellules vides, différences de colonnes calculées, identifiants en double. Pour chaque ligne signalée, vérifiez la cellule par rapport à son emplacement source surligné. Si une valeur est fausse, modifiez-la sur place ; un clic montre la valeur d'origine de l'IA et permet d'annuler si votre modification était l'erreur.
Importer uniquement après revue
Exportez le tableau revu, ou poussez-le via l'API v1, uniquement lorsque les lignes signalées ont été vérifiées. Rien dans l'outil n'envoie de données à votre système comptable de lui-même ; l'import est une étape que vous déclenchez après la fermeture de la passerelle.
Cette séquence est volontairement petite. Elle ajoute une configuration et une habitude (vérifier avant import) à un flux qui autrement semble identique à un pipeline de traitement direct aveugle. La différence est l'endroit où les erreurs apparaissent : dans le tableau, où la correction coûte des secondes, plutôt que dans l'ERP, où la même correction coûte 75 $ plus une conversation de suivi.
Ce que cette configuration ne fait pas
Être précis sur les limites de la passerelle fait partie de sa fiabilité. Trois limites comptent ici.
La passerelle est une étape que vous exécutez, pas un blocage côté serveur sur un webhook. Certaines plateformes documentaires vous permettent de configurer une condition de livraison qui retient les documents sous un score de confiance jusqu'à ce qu'un humain les approuve dans une file d'attente séparée. ImageToTable.ai ne se comporte pas ainsi : la revue se fait dans le tableau extrait, avant d'exporter ou d'appeler l'API. Si votre flux de travail exige un blocage technique strict à la limite du webhook (rien n'atteint le système suivant jusqu'à ce qu'un enregistrement d'approbation existe), comparez les deux architectures sur notre page de comparaison Airparser avant de vous engager.
La vérification cellule-source n'est pas un jugement commercial. L'écran de revue vous montre d'où vient une valeur, afin que vous puissiez confirmer que l'extraction correspond au document. Il ne décide pas si le montant est acceptable, si la condition contractuelle est favorable, ou si un paiement doit être approuvé. Pour les opérations sous séparation des tâches (l'environnement de contrôle SOX 404, ou tout cadre d'audit), la personne qui vérifie l'extraction doit toujours être une personne différente de celle qui approuve le paiement.
Une étape de revue ne remplace pas la QA côté sortie. La passerelle capture les erreurs de lecture par rapport à la source. Elle ne remplace pas les contrôles au niveau du tableur qui se produisent avant que les données n'entrent dans un système : alignement des colonnes, nombre de lignes correspondant au nombre de fichiers, et formatage des dates et des nombres. Notre liste de contrôle QA en 7 points pour les feuilles de calcul extraites est une couche séparée que la passerelle de revue devrait accompagner, pas remplacer.
Faire de la passerelle un processus, pas un espoir
Les équipes qui font cela correctement traitent l'étape de revue comme une partie planifiée de la journée, pas comme quelque chose qui se produit quand quelqu'un a le temps. Assignez une personne par lot, définissez quels documents contournent entièrement la revue, et convenez de ce qui arrive à un document signalé qui nécessite un second avis. L'amélioration largement partagée de la confiance se produit dans les premiers centaines de documents : votre équipe construit une liste des schémas d'erreur que l'extraction produit réellement sur votre mix documentaire, et vos signalements deviennent plus précis parce qu'ils sont basés sur l'observation, pas sur un seuil générique.
C'est la mesure honnête d'un déploiement d'extraction. Une affirmation unique de « précision à 99 % » ne capture aucune réalité opérationnelle ; ce qui gagne réellement la confiance, c'est une étape humaine définie qui regarde les lignes importantes avant que quoi que ce soit ne se déplace en aval.
Questions fréquemment posées
ImageToTable.ai peut-il retenir un document avant qu'il n'atteigne mon logiciel comptable ?
Pas au sens de condition de webhook. L'outil extrait dans un tableau, et la passerelle de revue est l'étape que vous exécutez en mode de revue avant d'exporter ou de comptabiliser via l'API. Aucun blocage automatique ne bloque la livraison sur la base d'un score de confiance. Si vous avez besoin de ce contrôle exact à la limite du système, une plateforme avec livraison soumise à approbation est l'architecture à comparer à notre page alternative Airparser.
Comment savoir quelles lignes examiner sans score de confiance ?
Intégrez les signaux dans le tableau lui-même : triez par valeurs manquantes, ajoutez une colonne calculée qui sort la différence entre le total et la somme de ses lignes d'article, et recherchez des identifiants en double ou des montants hors plage. Le mode de revue vous permet alors de vérifier exactement ces cellules par rapport à leurs emplacements sources.
Dois-je examiner chaque document d'un lot ?
Non. L'intention est que la plupart des documents passent leurs contrôles sans être touchés. Si votre taux d'exception semble inférieur à celui attendu, vérifiez que vos filtres ne sont pas trop lâches ; un audit par échantillonnage des lignes qui passent est une bonne mesure de protection et peut rester petit une fois que vous connaissez le schéma d'erreur réel de vos documents.
L'écran de revue fonctionne-t-il pour chaque fichier que je traite ?
Les emplacements sources sont générés par fichier via l'annotation bbox. Déclenchez-le sur un seul fichier si nécessaire, ou activez l'auto-annotation après traitement afin que les lots revus aient déjà leurs surlignages attachés.
Que se passe-t-il si mon réviseur modifie une valeur et se trompe ?
Chaque cellule modifiée conserve la valeur d'origine de l'IA à un clic, afin que le réviseur puisse annuler sa propre modification au lieu d'aggraver une erreur. Les erreurs sont corrigibles dans les deux sens.
Testez-le sur votre propre lot et voyez si la revue des lignes signalées tient dans les minutes que vous avez budgétisées. La passerelle est une petite habitude, et c'est la différence entre des données d'extraction fiables et des données d'extraction importées en espérant.