Comment vérifier les résultats d'extraction :
détectez 95 % des erreurs en 5 étapes
Vous avez extrait 200 factures. Contrôler chaque champ au hasard prendrait des heures. Ne rien faire risque de provoquer une erreur en production. Voici un cadre de vérification qui détecte 95 % des erreurs en contrôlant moins de 10 % de vos données.
La tension est réelle : vous voulez faire confiance aux résultats de l'outil, mais les erreurs d'extraction existent — une décimale décalée, une date mal interprétée, un total pointant vers le sous-total. La plupart des conseils de vérification se répartissent en deux camps — « tout vérifier » (ce qui annule l'automatisation) ou « l'IA est précise à 99 %, faites-lui confiance » (ce qui ignore que ce 1 % sur 500 documents représente 5 erreurs réelles). Cet article propose une troisième voie : cinq contrôles en couches, chacun détectant les erreurs que les précédents ont manquées, pour un taux de détection cumulé supérieur à 90 %.
Points clés à retenir
- La vérification complète de 200 factures prend six heures, alors la plupart des équipes soit l'ignorent et risquent des erreurs en production, soit tout vérifient et détruisent l'efficacité qu'elles ont automatisée.
- 95 % des erreurs d'extraction proviennent des trois mêmes types de champs — montants, dates et numéros de TVA — et non réparties aléatoirement dans chaque colonne.
- Cinq contrôles en couches — échantillonnage des champs critiques, règles de plages, validation des motifs, calculs inter-champs et vérification de cohérence par lot — détectent 95 % des erreurs en touchant moins de 10 % de vos données.
Étape 1 : Échantillonnage des champs critiques — Montant, date, numéro de TVA en premier
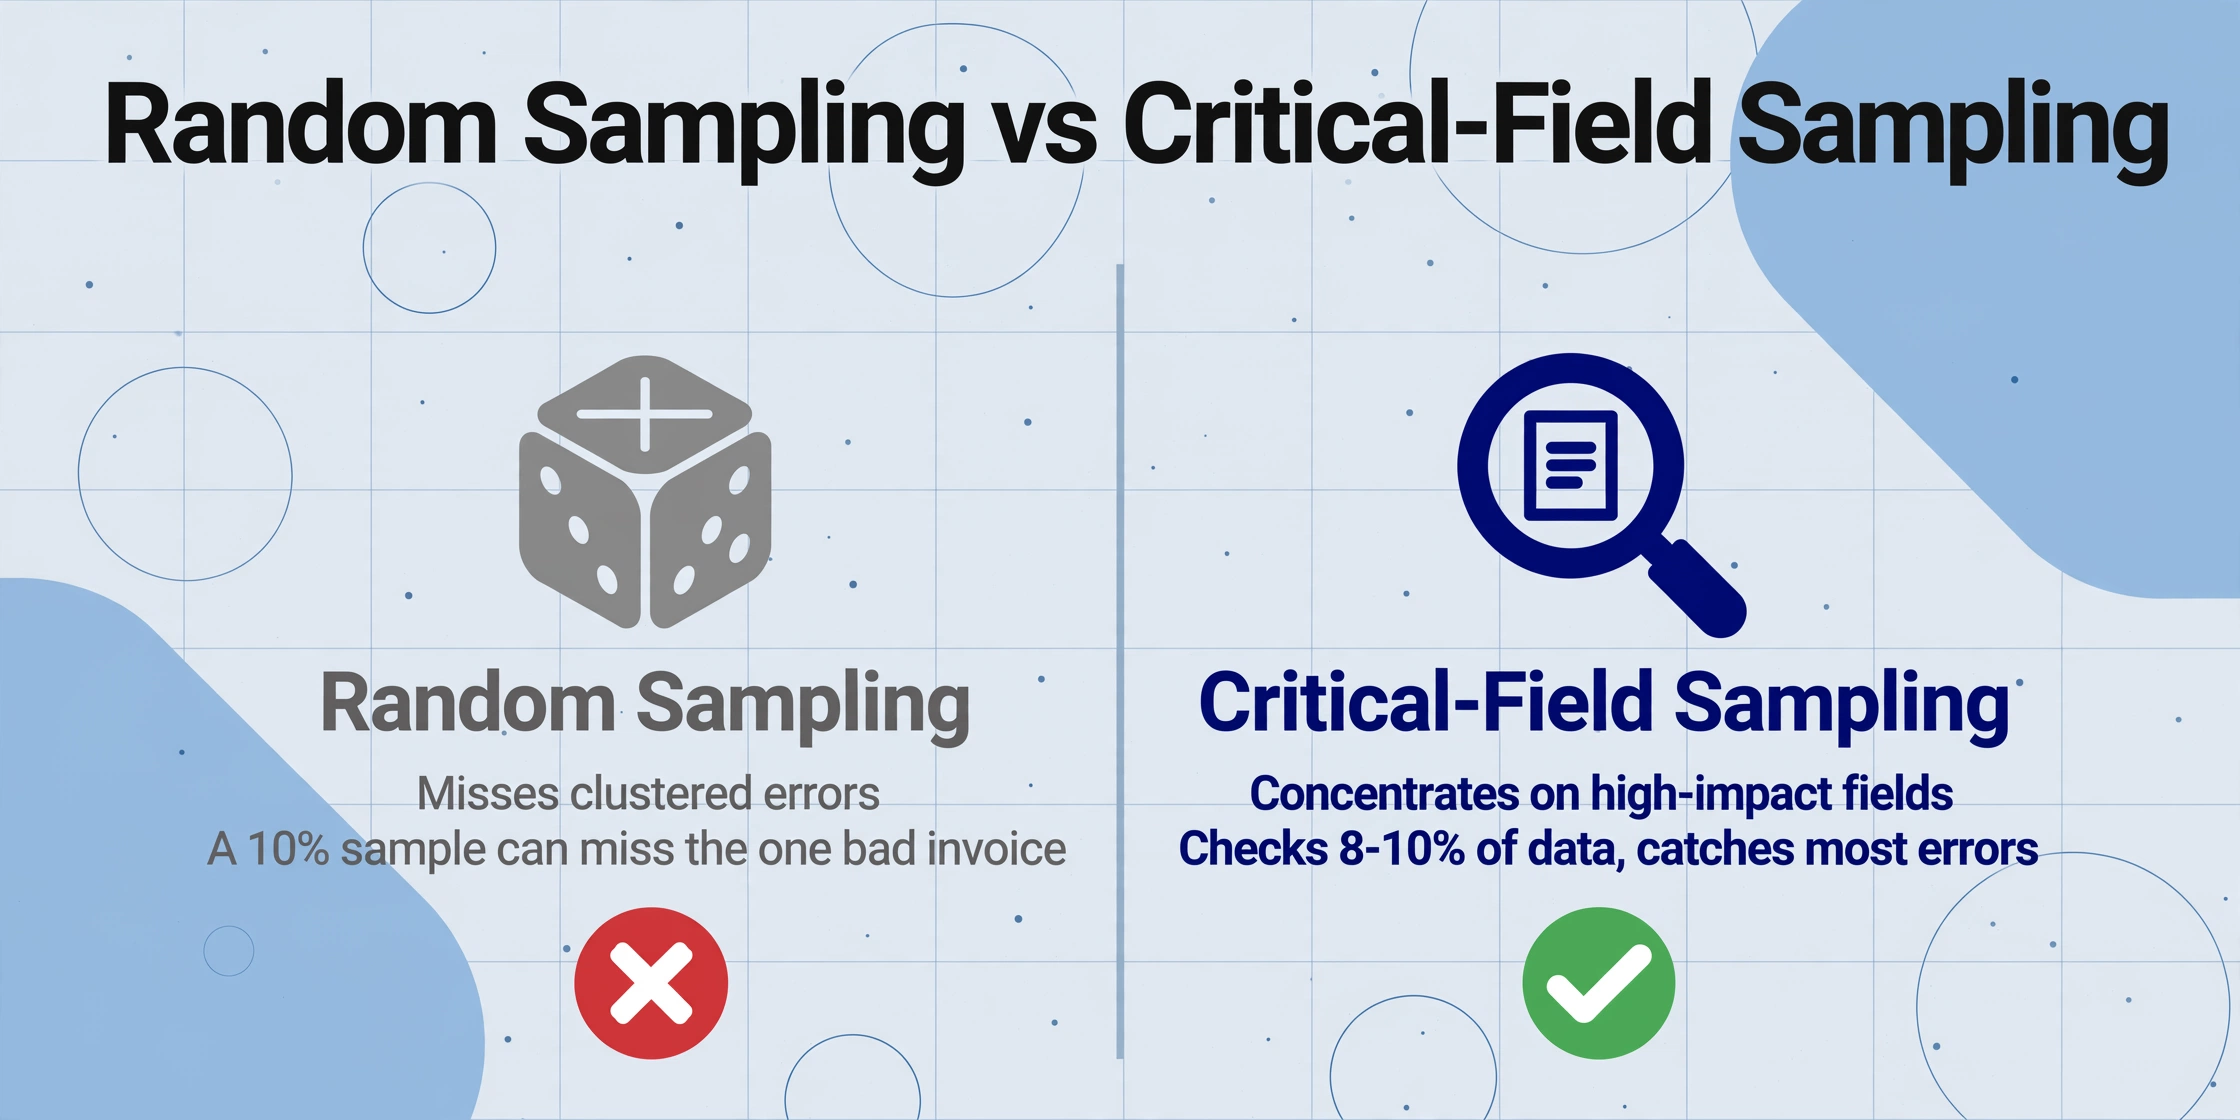
Ce que cela détecte : Des contrôles ponctuels ciblés sur les champs où une erreur crée le plus de dégâts en aval — pertes financières, exposition réglementaire ou cascades opérationnelles.
Pourquoi pas un échantillonnage aléatoire : L'échantillonnage aléatoire suppose que les erreurs sont réparties uniformément. En pratique, ce n'est pas le cas — elles se concentrent autour des chiffres, des dates et des identifiants. Un échantillon aléatoire de 10 % peut manquer le fournisseur dont le total de facture a été mal lu d'un facteur dix. La solution est l'échantillonnage stratifié des champs critiques : concentrez votre budget de contrôle sur les champs qui ont le plus d'impact en cas d'erreur.
- Champs de montant : Vérifiez les 10 premières factures, puis une sur dix ensuite. Une décimale mal placée peut signifier un trop-payé de 1 000 $ ou une déclaration de TVA avec un montant erroné.
- Champs de date : Vérifiez un document sur quinze. Une mauvaise date d'échéance entraîne des pénalités de retard ; une mauvaise date de facture place la transaction dans la mauvaise période de déclaration.
- Numéro de TVA : Vérifiez les 5 premiers documents et tout document provenant d'un nouveau fournisseur. Un numéro de TVA mal lu signifie que l'administration fiscale rejette la déduction — dans l'UE, un seul mauvais numéro de TVA peut invalider une demande de crédit de taxe en amont en vertu de l'article 226 de la directive TVA 2006/112/CE.
- Numéro de facture : Vérifiez que le format correspond au modèle du fournisseur sur les premières factures de chaque fournisseur.
Cette approche vérifie environ 8 à 10 % de vos données totales — environ 15 à 20 champs par lot de 200 factures — mais couvre les champs qui représentent la majorité des erreurs d'extraction conséquentes.
Comment procéder : Triez votre exportation par ordre de nom de fichier et appliquez les intervalles d'échantillonnage ci-dessus. Ou filtrez par nom de champ et scannez les colonnes verticalement — lire la colonne « Montant » pour repérer les valeurs aberrantes est plus rapide que de vérifier ligne par ligne.
Étape 2 : Validation basée sur des plages — Signaler ce qui ne correspond pas
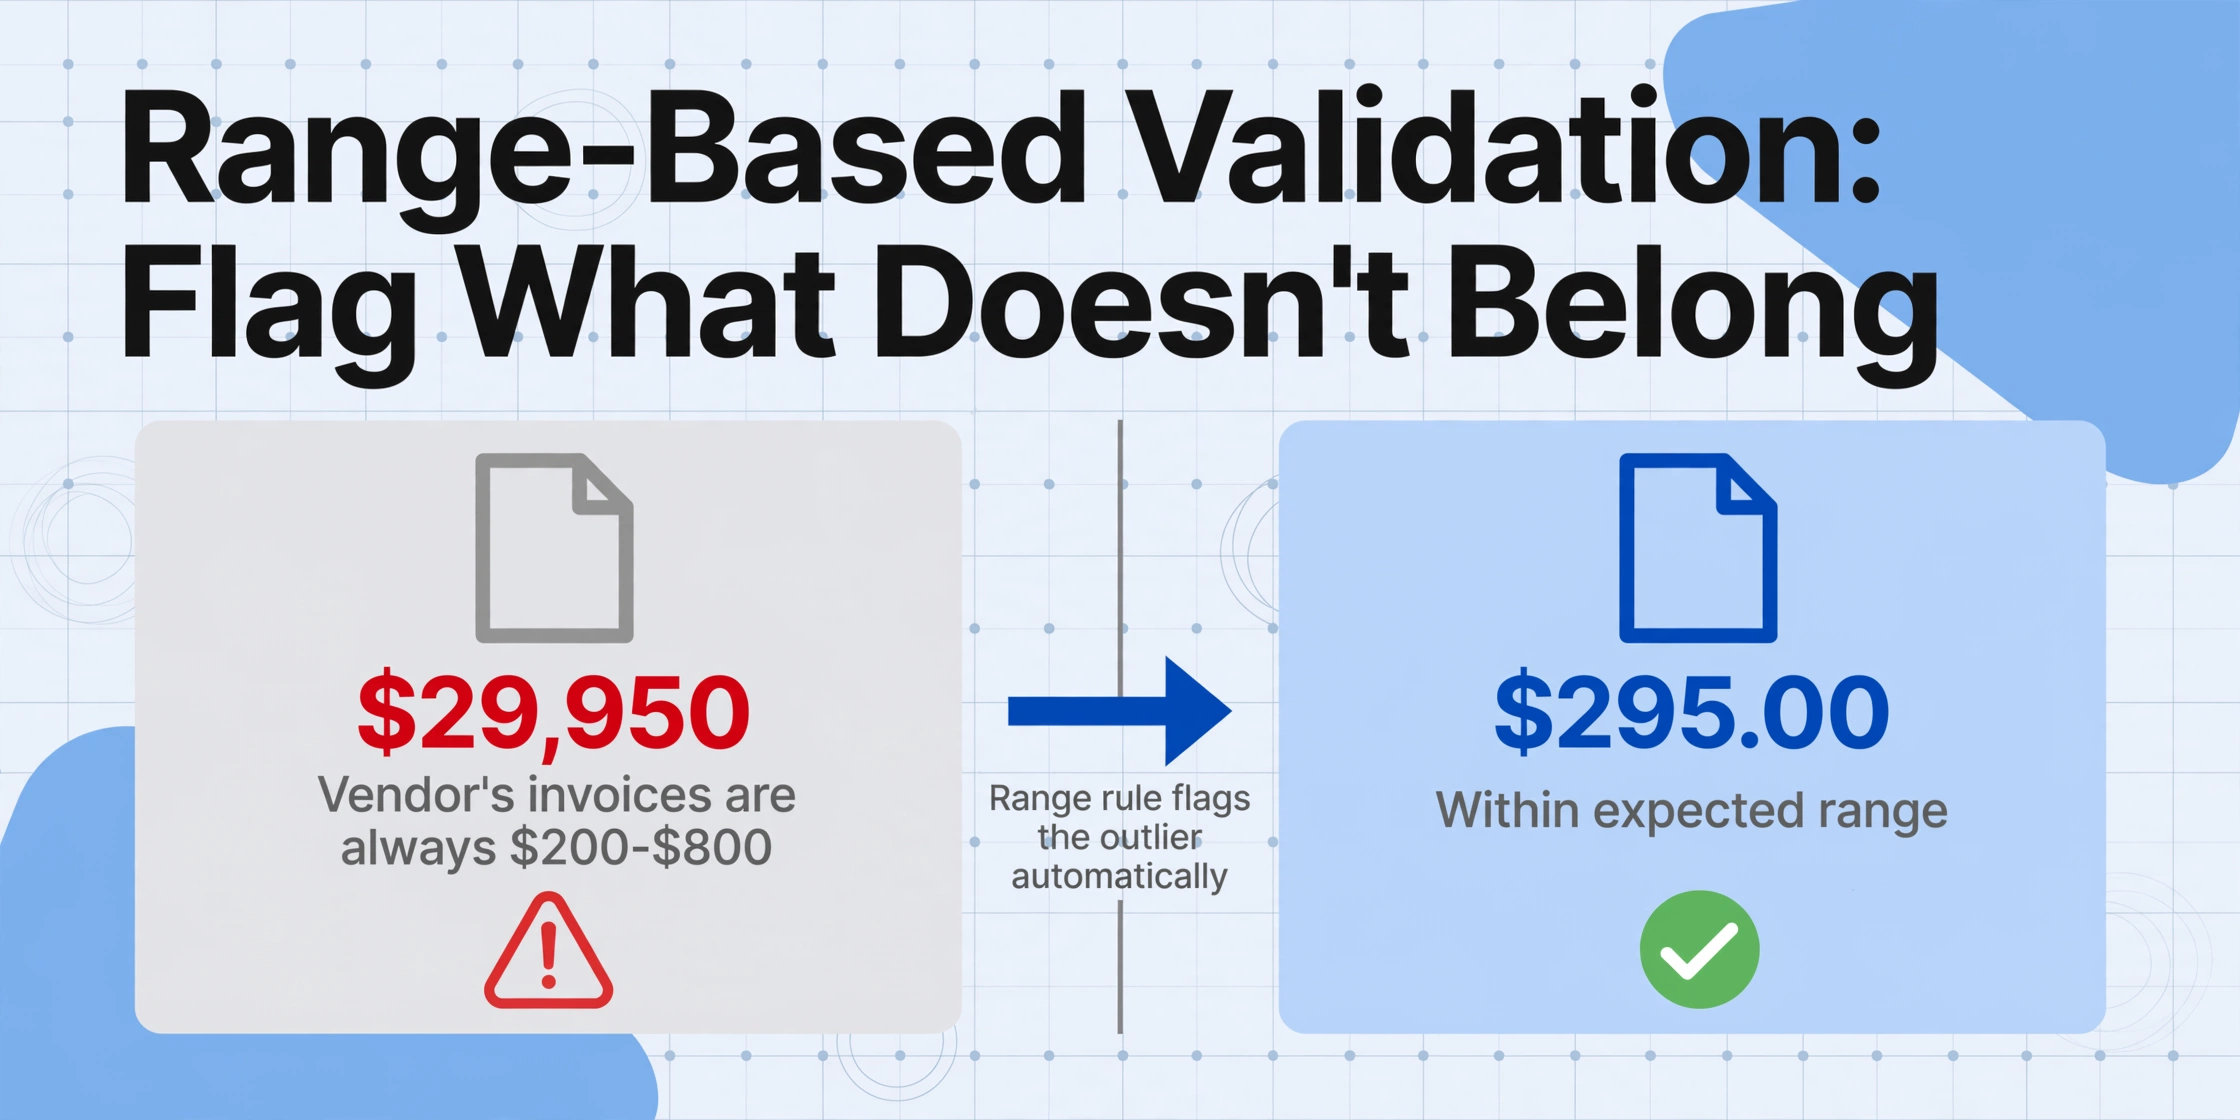
Ce que cela détecte : Des valeurs techniquement plausibles mais factuellement erronées — un total de 29 950 $ alors que les factures du fournisseur sont toujours entre 200 $ et 800 $, ou une date du 01/01/1900 indiquant que le champ était vide et que l'outil a renvoyé une valeur par défaut.
Pourquoi cela fonctionne : La plupart des erreurs d'extraction produisent des valeurs qui semblent presque correctes. Une confusion de caractères transformant « 295,00 $ » en « 2 995,00 $ » passe un examen rapide. Mais face à une limite de plage (« les factures de ce fournisseur sont toujours entre 200 $ et 400 $ »), l'erreur ressort immédiatement.
Comment procéder : Définissez des règles de plage par champ dans votre feuille de calcul. Pour les montants, signalez les valeurs au-delà de 3 écarts-types par rapport à la moyenne historique du fournisseur. Pour les dates, signalez tout ce qui dépasse 90 jours dans le futur ou qui est antérieur à la période d'activité connue du fournisseur. Pour les identifiants numériques, signalez les valeurs d'un ordre de grandeur hors de la séquence attendue. Cela prend 5 minutes à configurer et zéro temps par lot — c'est un filtre automatisé, pas un contrôle manuel.
La validation basée sur des plages est l'étape de vérification au meilleur retour sur investissement. Elle détecte les erreurs qui semblent « réelles » à première vue, coûte presque rien à mettre en place et réduit l'ensemble à vérifier de 200 lignes à 3 à 5 valeurs aberrantes signalées. Si vous ne mettez en œuvre qu'une seule étape de ce cadre, choisissez celle-ci.
Étape 3 : Validation basée sur des motifs — La cohérence du format détecte les ratés
Ce que cela détecte : Des valeurs qui passent les contrôles de plage mais violent les attentes de format — un numéro de facture extrait comme « INV-000 » sur un document qui suit « INV-2026-xxxxx », ou une date indiquant « 2026-13-01 » (le mois 13 n'existe pas).
Pourquoi cela fonctionne : Les documents d'un même fournisseur suivent des conventions de format cohérentes. L'IA lit le contenu visuel mais ne peut pas toujours imposer une cohérence au niveau du format lorsque la source est de qualité dégradée. La validation des motifs détecte ces violations sans connaître la valeur correcte attendue.
Comment procéder : Définissez des motifs par champ et vérifiez la cohérence sur l'ensemble du lot :
- Numéros de facture : Suivent-ils un motif cohérent de préfixe + chiffres ? Signalez tout écart.
- Dates : Toutes les dates correspondent-elles à des mois calendaires valides ? Le mois doit être entre 01 et 12, le jour doit être valide pour ce mois. Vérifiez également que toutes les dates se situent dans une plage raisonnable — une facture datée de décembre 2025 dans un lot de documents de juin 2026 est un signal d'alarme.
- E-mails, téléphones, codes de devise : Contiennent-ils les éléments structurels requis ? Une devise extraite comme « USO » au lieu de « USD » est presque certainement une erreur de lecture de caractère.
La plupart des tableurs exécutent ces contrôles avec des formules de base. Un format conditionnel qui met en évidence les lignes où le mois est supérieur à 12 détecte les violations de dates sur l'ensemble de votre lot en quelques secondes.
Étape 4 : Validation inter-champs — Le contrôle mathématique
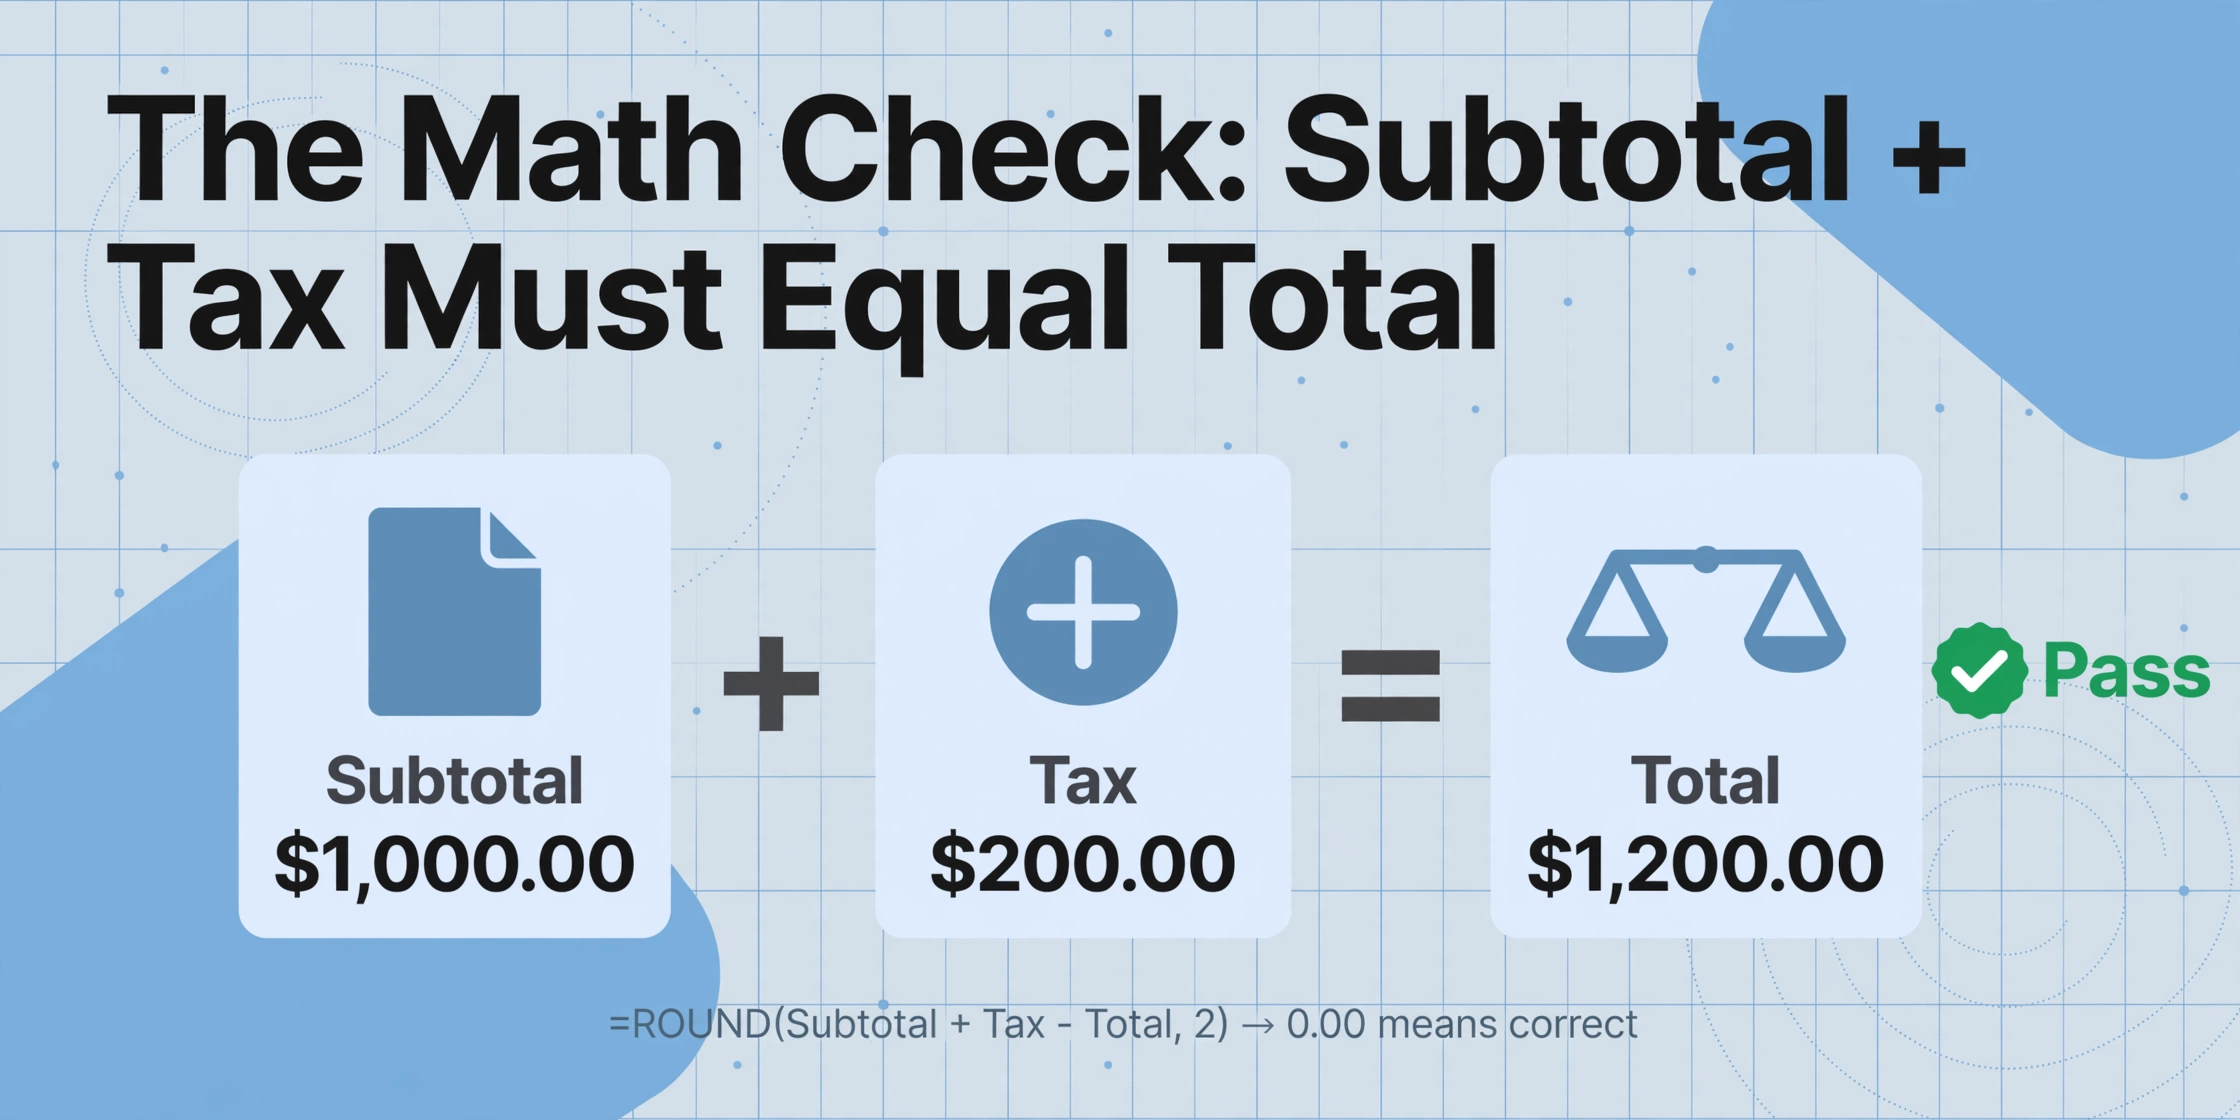
Ce qu'il détecte : Les champs qui réussissent les contrôles ci-dessus mais qui sont incorrects les uns par rapport aux autres — le sous-total, la taxe et le total semblent chacun plausibles individuellement, mais le sous-total + la taxe ne correspond pas au total.
Pourquoi cela fonctionne : Les relations arithmétiques entre les champs constituent un contrôle de vérité intégré qui ne nécessite aucune donnée externe. Un contrôle mathématique inter-champs détecte les types d'erreurs que la validation basée sur des plages et des motifs manque : le total qui est visuellement correct mais qui pointe vers la mauvaise ligne, le taux de taxe mal lu comme 15 % alors que la facture indique 20 %, ou une quantité extraite comme 50 au lieu de 15.
Comment l'exécuter : Ajoutez une colonne calculée à votre sortie : =ROUND(Subtotal + Tax - Total, 2). Toute ligne dont le résultat n'est pas 0,00 nécessite une vérification. Pour l'extraction d'articles de ligne, ajoutez Qté × Prix unitaire - Total de ligne. Une ligne où 10 × 24,95 $ = 249,50 $ est correcte ; 10 × 24,95 $ = 2 495,00 $ indique un décalage de décimale.
Ce contrôle est particulièrement efficace pour détecter les erreurs de variance de format couvertes en détail dans notre article compagnon sur les numéros extraits incorrects et leurs causes profondes. Une erreur de lecture du séparateur décimal rompt toutes les relations arithmétiques sur la facture, et le contrôle mathématique inter-champs la détecte à chaque fois.
Étape 5 : Contrôles de cohérence au niveau du lot — Compter et dédupliquer
Ce qu'il détecte : Les problèmes systémiques qui affectent l'ensemble du lot — lignes manquantes, entrées en double et correspondance fichier-ligne incohérente.
Pourquoi cela fonctionne : Même une extraction parfaite sur tous les champs est inutile si la feuille de calcul a un mauvais nombre de lignes ou contient des enregistrements en double. Trois contrôles qui ne nécessitent aucune inspection au niveau des champs :
- Nombre de lignes vs nombre de fichiers : Comparez le nombre de lignes au nombre de fichiers téléchargés. Si vous avez téléchargé 30 fichiers mais que l'exportation comporte 28 lignes, des fichiers ont été perdus quelque part dans le pipeline. Notre article sur les modes de défaillance courants de l'extraction par lots détaille les étapes de diagnostic pour chaque étape.
- Contrôle des numéros de facture en double : Exécutez
COUNTIFsur la colonne des numéros de facture. Les doublons authentiques sont rares — plus souvent, un doublon indique un problème de traitement ou un téléchargement accidentel. - Cohérence de la plage de dates : Analysez les dates min et max. Un lot de factures de juin 2026 ne devrait pas contenir une date d'août 2027. Une date hors plage signale généralement un champ mal lu ou un document qui ne devrait pas être dans ce lot.
Ces trois contrôles prennent environ 30 secondes et détectent les erreurs qui ruinent un lot au niveau structurel — non pas des données incorrectes, mais des données manquantes ou dupliquées.
Quand escalader — aucun cadre ne détecte tout
Ce cadre en cinq couches détecte la majorité des erreurs d'extraction — nos tests sur des lots de factures, reçus et bons de commande montrent un taux de détection cumulé supérieur à 90 % — mais il ne détecte pas tout.
Trois situations où la couverture du cadre diminue et où vous devez prévoir une vérification plus approfondie :
- Premier lot d'un nouveau type de document ou d'un nouveau fournisseur : Tant que vous n'avez pas établi les limites de plages et les attentes de motifs, les étapes 2 et 3 ne peuvent pas fonctionner. Pour les 20 à 30 premiers documents, vérifiez manuellement 30 à 40 % des champs.
- Originaux manuscrits ou de mauvaise qualité : Les taux d'erreur sur l'écriture manuscrite sont intrinsèquement plus élevés. Augmentez la densité d'échantillonnage de vos champs critiques et attendez-vous à davantage de valeurs aberrantes signalées.
- Types de documents hétérogènes : Mélanger des factures, des avoirs et des bons de commande crée une incohérence structurelle. Le contrôle mathématique inter-champs suppose que sous-total + TVA = total — ce qui fonctionne pour les factures mais pas pour les avoirs. Séparez les types de documents en lots dédiés.
Le cadre ne remplace pas le jugement. C'est une méthode systématique pour allouer votre temps de vérification limité là où il compte le plus — et pour savoir, quantitativement, quand vous avez suffisamment vérifié.
Questions fréquentes
Combien de temps prend le contrôle ponctuel complet en 5 étapes pour un lot de 200 factures ?
Environ 15 à 20 minutes. Les étapes 2, 3 et 5 sont des filtres automatisés qui prennent 5 minutes au total à configurer et zéro minute par lot. L'étape 1 nécessite environ 10 minutes de vérification manuelle pour 15 à 20 champs ciblés. L'étape 4 est une seule formule plus 5 minutes pour examiner les lignes signalées. Comparé à une vérification manuelle complète des 200 lignes — 6 à 10 heures — les économies sont considérables.
Et si je trouve une erreur dans les 10 % que j'ai vérifiés — dois-je revérifier tout le lot ?
Pas nécessairement. Si l'erreur est isolée à un seul document, corrigez-la et continuez. Mais si vous constatez un schéma systématique — le même champ erroné sur plusieurs documents du même fournisseur — traitez-le comme un problème de cause racine. La cause racine affecte probablement bien plus de documents que ceux que vous avez vérifiés. Notre article sur le diagnostic des numéros extraits erronés peut vous aider à déterminer s'il s'agit d'un problème isolé ou systémique.
Dois-je exécuter les 5 étapes pour chaque lot ?
Les étapes 2, 3 et 5 doivent être exécutées sur chaque lot — elles sont automatisées et ne coûtent rien une fois configurées. Les étapes 1 et 4 sont les parties pratiques. Pour les lots provenant de fournisseurs connus avec une qualité constante, vous pouvez réduire le taux d'échantillonnage à l'étape 1. Pour les premiers lots, conservez la densité complète.
ImageToTable.ai peut-il exécuter automatiquement certaines de ces validations ?
Oui. Le post-traitement intelligent des données d'ImageToTable.ai gère la normalisation des dates, le formatage des montants et la normalisation des séparateurs décimaux — couvrant une partie des étapes 2 et 3. La fonctionnalité colonnes calculées effectue une validation mathématique inter-champs pendant l'extraction, signalant les lignes où le sous-total + la TVA ne correspondent pas au total avant que les données n'atteignent votre feuille de calcul. Les contrôles de cohérence au niveau du lot s'effectuent à l'étape d'exportation.
La vérification ne signifie pas nécessairement tout contrôler. Un cadre en couches — échantillonnage des champs critiques, validation des plages, contrôles basés sur des motifs, mathématiques inter-champs et cohérence au niveau du lot — détecte 95 % des erreurs d'extraction tout en vérifiant moins de 10 % de vos données. L'astuce n'est pas de vérifier davantage. C'est de vérifier ce qui compte, dans le bon ordre, avec le bon outil pour chaque couche.
Testez le cadre sur votre prochain lot. Téléchargez un ensemble de documents, exportez les résultats et parcourez les cinq étapes dans l'ordre — vous constaterez probablement que 15 minutes de vérification ciblée vous donnent 95 % de la confiance qu'une révision manuelle complète offrirait. Téléchargez un lot et exécutez le cadre de vérification vous-même.
Aucune inscription requise · Compatible JPG, PNG et PDF