抽出結果の検証方法:
5ステップでエラーの95%を発見する方法
200件の請求書を抽出したとします。すべてのフィールドをランダムにスポットチェックすると、何時間もかかります。何もしなければ、本番環境でエラーが発生するリスクがあります。ここでは、データの10%未満をチェックするだけでエラーの95%を発見できる検証フレームワークを紹介します。
ジレンマは現実にあります。ツールの出力を信頼したい一方で、抽出エラーは発生します。小数点のずれ、日付の解釈ミス、合計が小計を指しているなどです。ほとんどの検証アドバイスは、「すべてチェックする」(自動化の意味がなくなる)か、「AIは99%正確なので信頼する」(500件の文書で1%は5件の実際のエラーを意味することを無視)のどちらかに分類されます。この記事では、3つ目の道を提案します。5つのレイヤー化されたチェックで、それぞれが前のチェックで見逃したエラーを捕捉し、累積捕捉率は90%を超えます。
重要なポイント
- 200件の請求書を完全に検証するには6時間かかるため、多くのチームはそれをスキップして本番環境でのエラーをリスクするか、すべてをチェックして自動化した効率性を台無しにしています。
- 抽出エラーの95%は、金額、日付、税番号という同じ3つのフィールドタイプに起因しており、すべての列にランダムに散らばっているわけではありません。
- 重要なフィールドのサンプリング、範囲ルール、パターン検証、クロスフィールド計算、バッチの健全性チェックという5つのレイヤー化されたチェックで、データの10%未満に触れるだけでエラーの95%を発見できます。
ステップ1: 重要フィールドのサンプリング — 金額、日付、税番号を優先
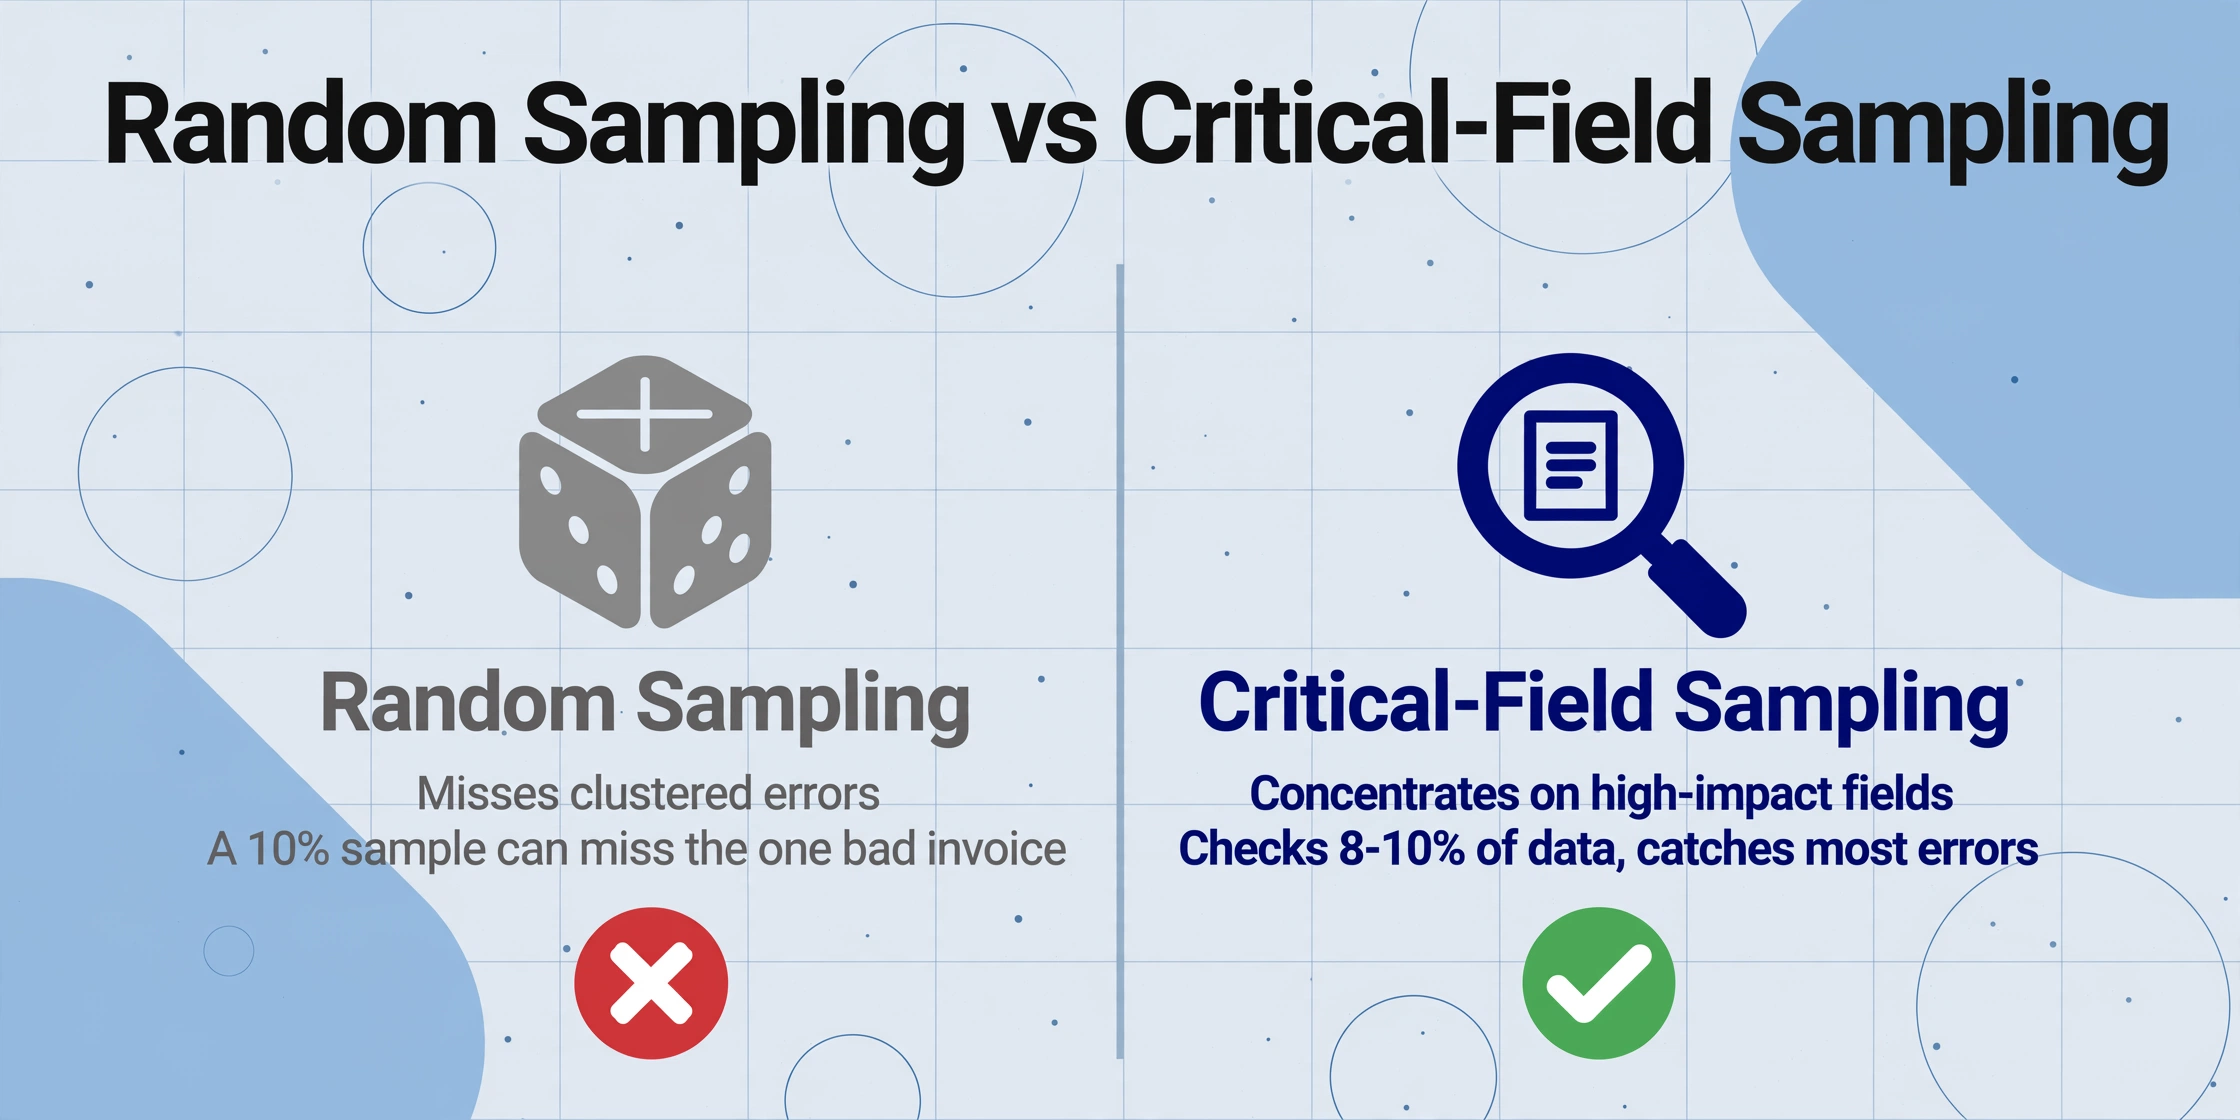
検出できる問題: エラーが下流で最も大きな損害(金銭的損失、コンプライアンス上のリスク、業務への連鎖的な影響)を引き起こすフィールドに絞ったスポットチェックです。
ランダムサンプリングが不十分な理由: ランダムサンプリングはエラーが均等に分布していることを前提としています。しかし実際には、エラーは数字、日付、識別子に集中する傾向があります。ランダムな10%のサンプルでは、請求書の合計金額を10倍誤って読み取ったベンダーを見逃す可能性があります。解決策は層別重要フィールドサンプリングです。チェックの予算を、誤りがあった場合の影響が最も大きいフィールドに集中させます。
- 金額フィールド: 最初の10件の請求書と、その後は10件ごとにチェックします。小数点のずれは、$1,000の過払いや、誤った金額でのVAT申告につながる可能性があります。
- 日付フィールド: 15件ごとにチェックします。支払期日が誤っていると延滞料金が発生し、請求日が誤っていると取引が誤った報告期間に計上されます。
- 税番号 / VAT番号: 最初の5件の文書と、新しいサプライヤーからの文書をチェックします。VAT番号の読み間違いは税務当局による控除の拒否につながります。EUでは、VAT指令2006/112/EC第226条に基づき、VAT IDが1つ誤っているだけで仕入税額控除が無効になる可能性があります。
- 請求書番号: 各ベンダーからの最初の数件の請求書で、番号形式がサプライヤーのパターンと一致しているか確認します。
このアプローチでは、全データのおよそ8〜10%(200件の請求書のバッチあたり約15〜20フィールド)をチェックしますが、重大な抽出エラーの大部分を占めるフィールドをカバーします。
実行方法: エクスポートをファイル名順に並べ替え、上記のサンプリング間隔を適用します。または、フィールド名でフィルタリングして列を縦にスキャンします。「金額」列を上から下に読む方が、行ごとにチェックするより速いです。
ステップ2:範囲ベースの検証 — 異常値を見つけ出す
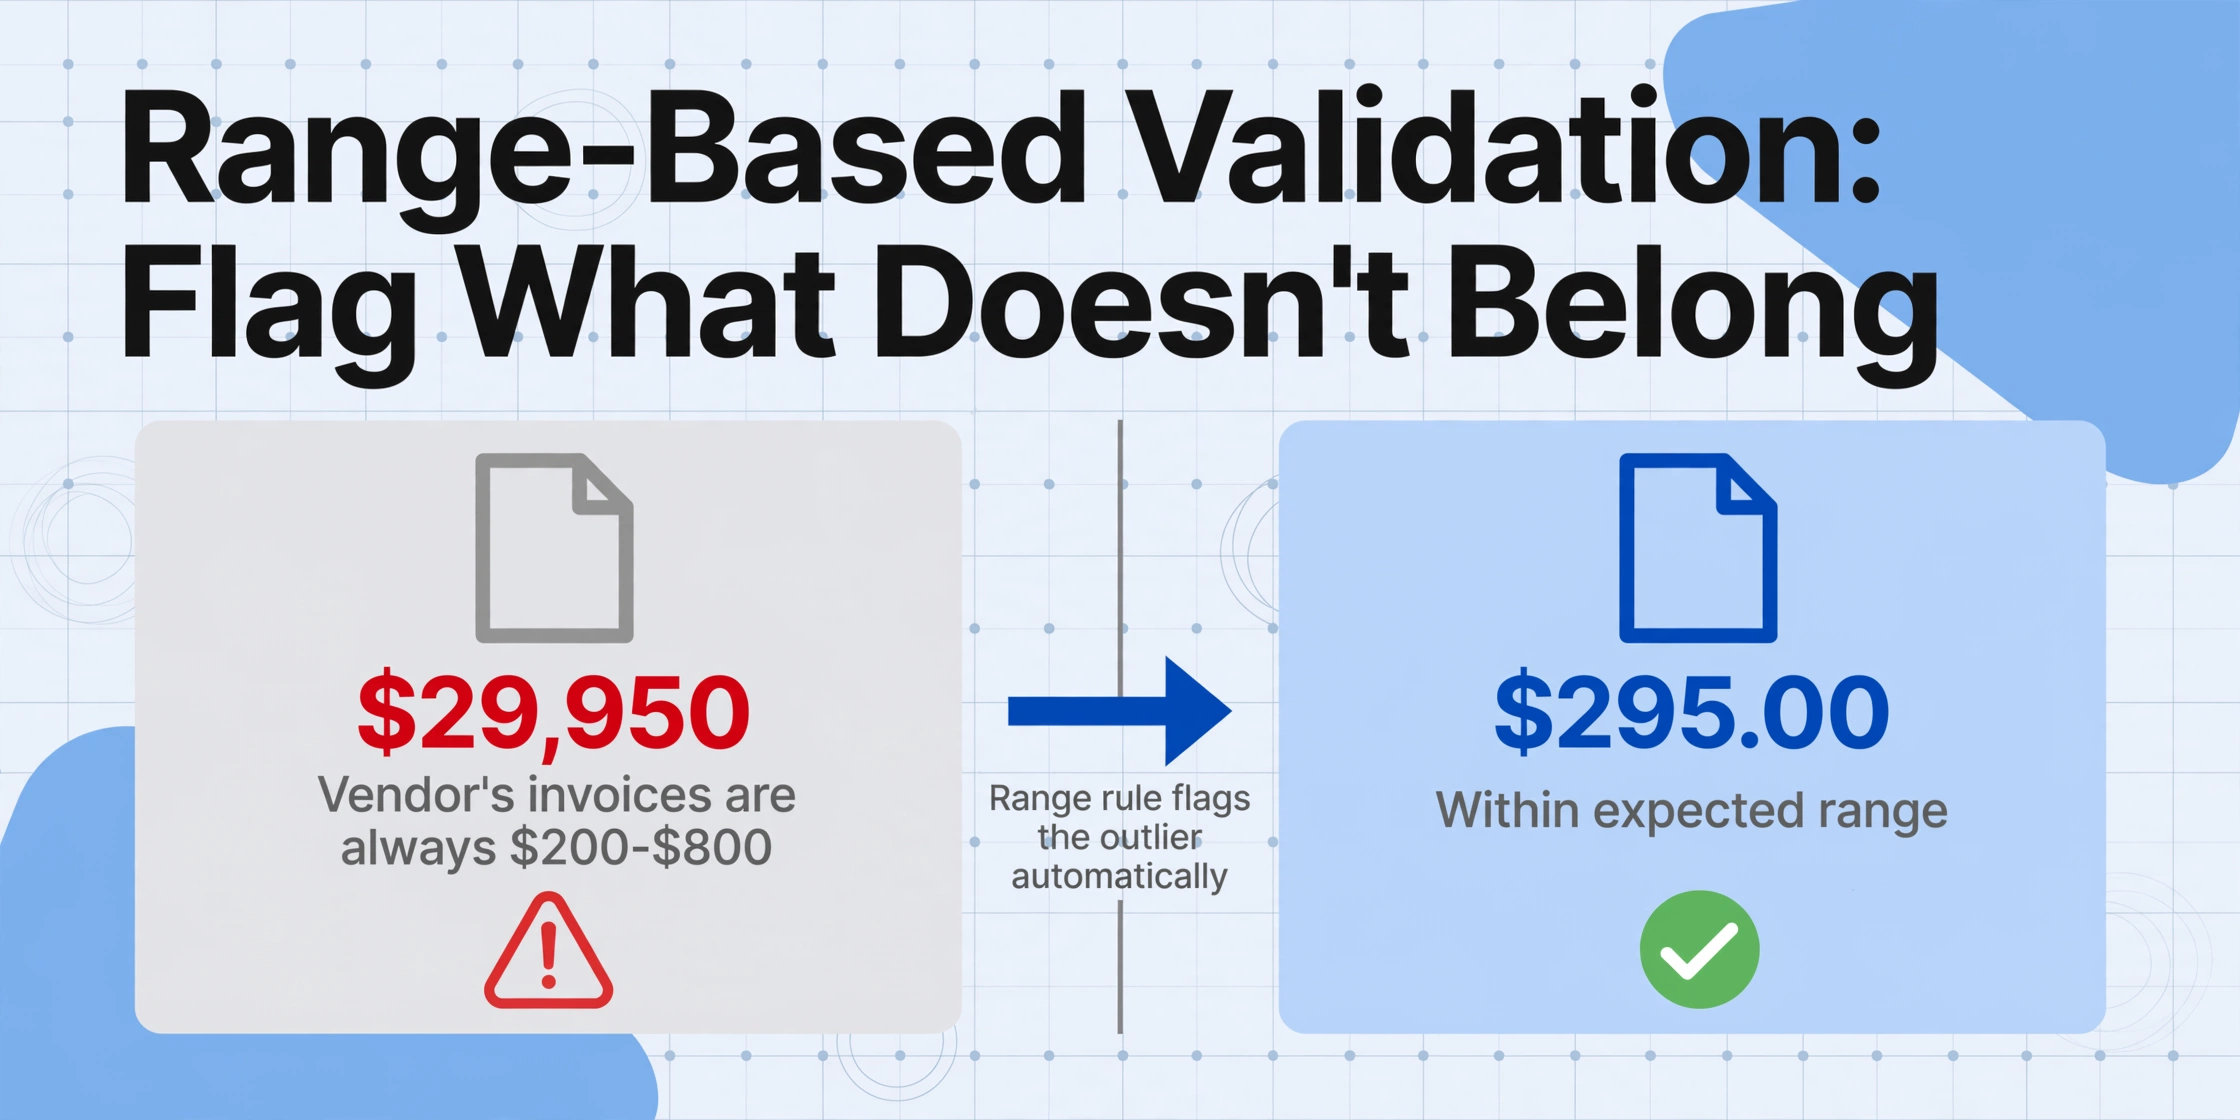
検出内容:技術的には妥当に見えるが、実際には誤っている値 — ベンダーの請求書が常に$200〜$800であるのに合計が$29,950になっている、またはフィールドが空白でツールがデフォルト値を返したことを示す日付01/01/1900など。
効果的な理由:ほとんどの抽出エラーは、ほぼ正しく見える値を生成します。文字の取り違えで「$295.00」が「$2,995.00」になっても、一目見ただけでは気づきません。しかし、範囲の境界(「このベンダーの請求書は常に$200〜$400」)と照合すれば、すぐに浮き彫りになります。
実行方法:スプレッドシートにフィールドごとの範囲ルールを設定します。金額については、ベンダーの過去平均から標準偏差3つ分を超える値をフラグします。日付については、90日以上先の日付、またはベンダーの既知の営業期間より古い日付をフラグします。数値IDについては、期待されるシーケンスから桁違いに外れる値をフラグします。設定には5分かかり、バッチごとの所要時間はゼロ — これは手動チェックではなく自動フィルターです。
範囲ベースの検証は、ROIが最も高い検証ステップです。一目で「本物」に見えるエラーを検出し、設定コストはほぼゼロ、レビュー対象を200行から3〜5件のフラグ付き外れ値に削減します。このフレームワークから1つだけ実装するなら、これを選んでください。
ステップ3:パターンベースの検証 — 形式の一貫性で誤抽出を検出
検出内容:範囲チェックは通過するが形式の期待に反する値 — 「INV-2026-xxxxx」という形式の文書で請求書番号が「INV-000」と抽出された、または「2026-13-01」(13月は存在しない)と読まれた日付など。
効果的な理由:同じサプライヤーの文書は一貫した形式規則に従います。AIは視覚的なコンテンツを読み取りますが、ソースの品質が低下している場合、形式レベルの一貫性を常に強制できるとは限りません。パターン検証は、正しい値が何であるかを知らなくても、これらの違反を検出します。
実行方法:フィールドごとのパターンを定義し、バッチ全体で一貫性をチェックします:
- 請求書番号:一貫したプレフィックス+数字パターンに従っていますか?逸脱があればフラグします。
- 日付:すべての日付が有効な暦月ですか?月は01〜12、日はその月に対して有効である必要があります。また、すべての日付が妥当な範囲内にあるかも確認します — 2026年6月の文書バッチに2025年12月の請求書があるのは危険信号です。
- メール、電話、通貨コード:必要な構造要素を含んでいますか?抽出された通貨が「USD」ではなく「USO」であれば、ほぼ確実に文字の読み間違いです。
ほとんどのスプレッドシートアプリケーションは、基本的な数式でこれらのチェックを実行できます。月 > 12 の行を強調表示する条件付き書式設定は、バッチ全体の日付違反を数秒で検出します。
ステップ4: クロスフィールド検証 — 計算チェック
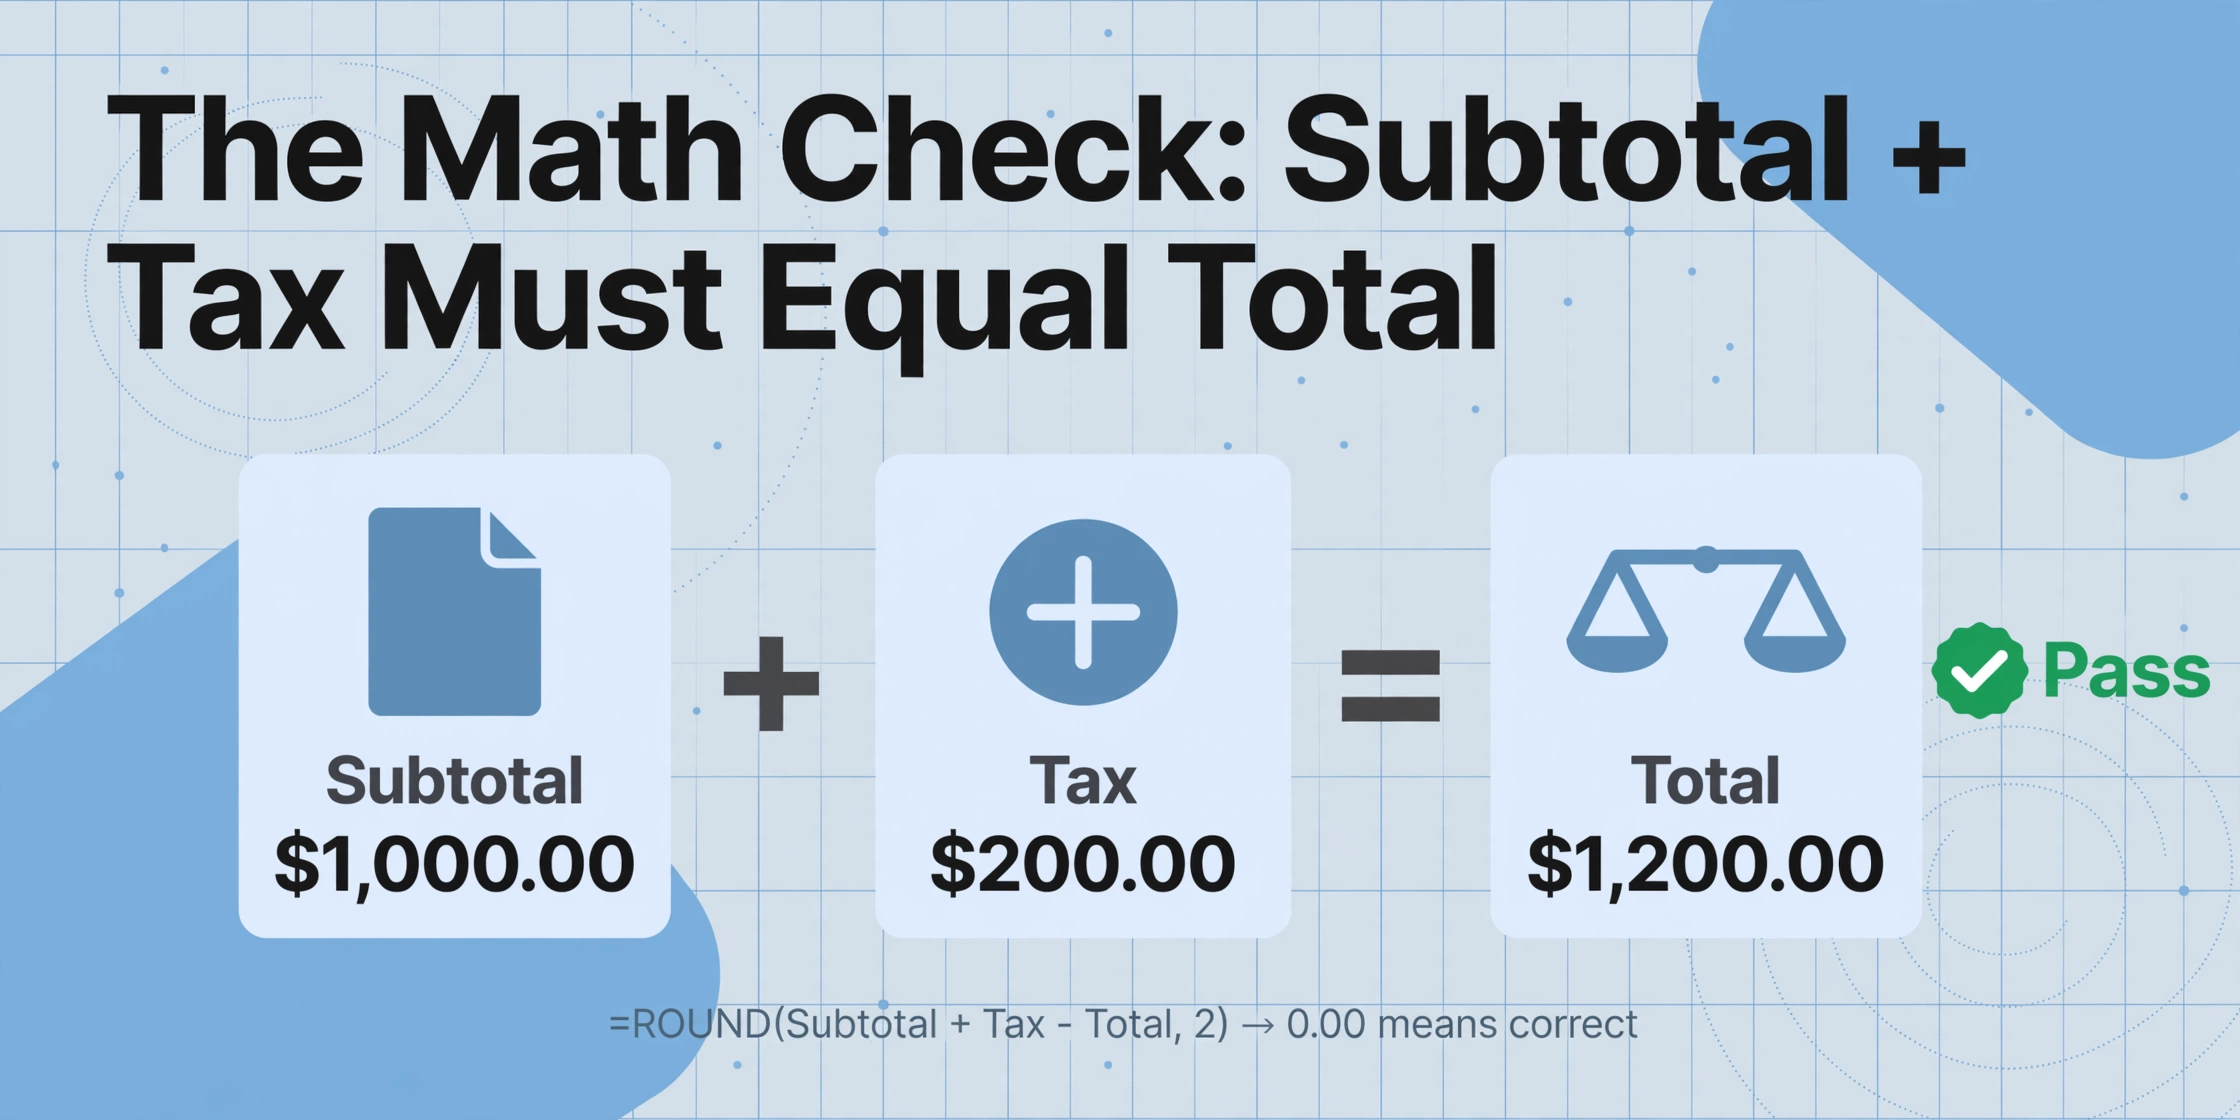
検出できる問題: 上記のチェックを通過しても、互いに対して誤っているフィールド — 小計、税、合計はそれぞれ単独では妥当に見えるが、小計 + 税が合計と一致しない場合。
有効な理由: フィールド間の算術関係は、外部データを必要としない組み込みの真実チェックです。クロスフィールドの計算チェックは、範囲検証やパターン検証では見逃すエラータイプを検出します。視覚的には正しいが誤った行を指している合計、請求書に20%と記載されているのに税率を15%と誤読したケース、数量を15ではなく50として抽出したケースなどです。
実行方法: 出力に算出カラムを追加します: =ROUND(Subtotal + Tax - Total, 2)。結果が0.00でない行はすべてレビューが必要です。明細項目の抽出には、Qty × Unit Price - Line Total を追加します。10 × $24.95 = $249.50 の行は正しく、10 × $24.95 = $2,495.00 は小数点のずれを示します。
このチェックは、関連記事で詳しく解説している誤って抽出された数値とその根本原因で取り上げるフォーマット差異エラーの検出に特に効果的です。小数点区切りの誤読は請求書上のすべての算術関係を壊し、クロスフィールドの計算チェックは毎回それを検出します。
ステップ5: バッチレベルの健全性チェック — 件数と重複の確認
検出できる問題: バッチ全体に影響する体系的な問題 — 行の欠落、重複エントリ、ファイルと行の対応不一致。
有効な理由: 全フィールドで完璧な抽出ができていても、スプレッドシートの行数が間違っていたり、重複レコードが含まれていれば無意味です。フィールドレベルの検査を必要としない3つのチェック:
- 行数とファイル数の比較: 行数をアップロードしたファイル数と比較します。30ファイルをアップロードしたのにエクスポートが28行の場合、パイプラインのどこかでファイルが失われています。一般的なバッチ抽出の失敗モードに関する記事では、各段階の診断手順を解説しています。
- 請求書番号の重複チェック: 請求書番号列で
COUNTIFを実行します。真正の重複は稀です — 多くの場合、重複は処理の不具合や誤った再アップロードを示します。 - 日付範囲の整合性: 最小日付と最大日付を確認します。2026年6月の請求書バッチに2027年8月の日付が含まれるべきではありません。範囲外の日付は通常、フィールドの誤読やこのバッチに含まれるべきでない文書を示します。
これら3つのチェックは約30秒で完了し、バッチを構造レベルで台無しにするエラーを検出します — 間違ったデータではなく、欠落または重複したデータです。
エスカレーションのタイミング — どのフレームワークもすべてを捕捉できるわけではない
この5層フレームワークは、抽出エラーの大部分を捕捉します。請求書、領収書、発注書のバッチにわたるテストでは、累積捕捉率が90%を超えていますが、すべてを捕捉できるわけではありません。
フレームワークのカバレッジが低下し、より徹底的なレビューを計画すべき3つの状況:
- 新しい文書タイプまたはベンダーからの最初のバッチ:範囲の境界とパターンの期待値を確立するまで、ステップ2と3は機能しません。最初の20〜30文書では、フィールドの30〜40%を手動で確認してください。
- 手書きまたは低品質の原本:手書きのエラー率は本質的に高くなります。重要フィールドのサンプリング密度を高め、より多くのフラグ付き外れ値を想定してください。
- 異種の文書タイプ:請求書、クレジットノート、発注書を混在させると、構造的な不整合が生じます。クロスフィールドの計算チェックは、小計+税=合計を前提としていますが、これは請求書には機能しますが、クレジットノートには機能しません。文書タイプを専用のバッチに分離してください。
フレームワークは判断力の代わりにはなりません。限られた検証時間を最も重要な場所に割り当て、十分にチェックしたことを定量的に把握するための体系的な方法です。
よくある質問
200件の請求書のバッチで、完全な5ステップのスポットチェックにはどのくらい時間がかかりますか?
約15〜20分です。ステップ2、3、5は自動化されたフィルターで、セットアップに合計5分かかり、バッチごとの時間はゼロです。ステップ1では、15〜20の対象フィールドに対して約10分の実践的な検証が必要です。ステップ4は単一の数式と、フラグ付きの行をレビューするための5分です。全200行の完全な手動チェック(6〜10時間)と比較すると、節約は大幅です。
確認した10%にエラーが見つかった場合、バッチ全体を再検証すべきですか?
必ずしもそうとは限りません。エラーが1つの文書に限られている場合は、その文書を修正して続行してください。ただし、同じベンダーの複数の文書で同じフィールドが誤っているといった体系的なパターンが見つかった場合は、根本原因の問題として扱ってください。根本原因は、確認した文書よりもはるかに多くの文書に影響している可能性があります。単発的な問題か体系的な問題かを判断するには、誤って抽出された数値の診断に関する記事が役立ちます。
バッチごとに5つのステップすべてを実行する必要がありますか?
ステップ2、3、5はすべてのバッチで実行してください。これらは自動化されており、一度設定すればコストはかかりません。ステップ1と4は手作業が必要な部分です。品質が安定している馴染みのあるベンダーからのバッチでは、ステップ1のサンプリング率を下げてもかまいません。初回のバッチでは、サンプリング密度をフルに保ってください。
ImageToTable.aiはこれらの検証を自動的に実行できますか?
はい。ImageToTable.aiのインテリジェントなデータ後処理は、日付の標準化、金額のフォーマット、小数点区切りの正規化に対応し、ステップ2と3の一部をカバーします。計算列機能は、抽出中にクロスフィールドの計算検証を実行し、データがスプレッドシートに到達する前に、小計+税が合計と一致しない行にフラグを立てます。バッチレベルの健全性チェックはエクスポート段階で実行されます。
検証とは、すべてをチェックすることではありません。重要なフィールドのサンプリング、範囲検証、パターンチェック、クロスフィールドの計算、バッチレベルの健全性チェックという階層的なフレームワークは、データの10%未満をチェックするだけで、抽出エラーの95%を検出します。秘訣は、より多く検証することではなく、重要なものを正しい順序で、各レイヤーに適したツールで検証することです。
次のバッチでこのフレームワークを試してみてください。一連の文書をアップロードし、結果をエクスポートして、5つのステップを順番に実行してみてください。15分間の的を絞った検証で、完全な手動レビューがもたらす確信の95%が得られることに気づくでしょう。バッチをアップロードして、検証フレームワークを自分で実行してみてください。
サインアップ不要 · JPG、PNG、PDFに対応