Wo ein manueller Review-Schritt hingehört in einen Dokumentextraktions-Workflow
Die meisten Dokumentautomatisierungs-Stacks behandeln Extraktion und Import als eine Bewegung: Die KI liest das Dokument, und das Ergebnis landet in Ihrem Buchhaltungssystem, Ihrer Datenbank oder Ihrem Webhook. Die Teams, die dies in Produktion betreiben, wissen, dass der riskante Schritt nicht die Extraktion ist. Es ist der Moment zwischen der extrahierten Tabelle und dem Import, denn in diesem Moment schaut niemand hin.
Diese Lücke ist messbar. In der Kreditorenbuchhaltung liegt die durchschnittliche Durchlaufquote ohne manuellen Eingriff bei 32,6 % (Ardent Partners 2025), was bedeutet, dass fast zwei Drittel der Rechnungen irgendwo im Zyklus noch einen manuellen Berührungspunkt erhalten. Die Teams, die die Extraktion zuverlässig halten, sind meist auf demselben Weg dorthin gekommen: Sie haben im Voraus entschieden, wo Personen die Ausgabe prüfen, diesen Schritt personell besetzt und ihn eingeplant, bevor etwas importiert wird.
Wichtige Erkenntnisse
- 49,2 % ist die Best-in-Class-Durchlaufquote ohne manuellen Eingriff, selbst die besten Teams geben also etwa die Hälfte ihrer Rechnungen an eine Person weiter.
- Selbst bei 95 % Feldgenauigkeit ist eine Rechnung mit 15 Feldern in weniger als der Hälfte der Fälle vollständig korrekt.
- Ein Review-Gate ist kein Zeichen dafür, dass die Automatisierung versagt hat, sondern das, was die Pipeline sicher im unbeaufsichtigten Betrieb macht.
Ein Automatisierungsprojekt beginnt normalerweise mit einer Zahl, die das Team erreichen möchte: 500 Rechnungen pro Tag verarbeiten, die Bankfeeds ohne erneutes Abtippen abschließen, jeden Lieferschein in das ERP laden. Dann wird die Extraktion aktiviert, die Tabelle füllt sich, und die erste echte Entscheidung taucht auf: Wer sieht sich diese Tabelle an, bevor irgendetwas davon nachgelagert weitergegeben wird? Dieser Artikel erläutert, warum diese Frage eine explizite Antwort verdient, wo der Review-Schritt in einen Dokumenteneingangsfluss passt und wie eine Zellprüfung gegen die Quelle dafür sorgt, dass das Gate nicht zum Flaschenhals wird.
Was ein fehlender Review-Schritt kostet
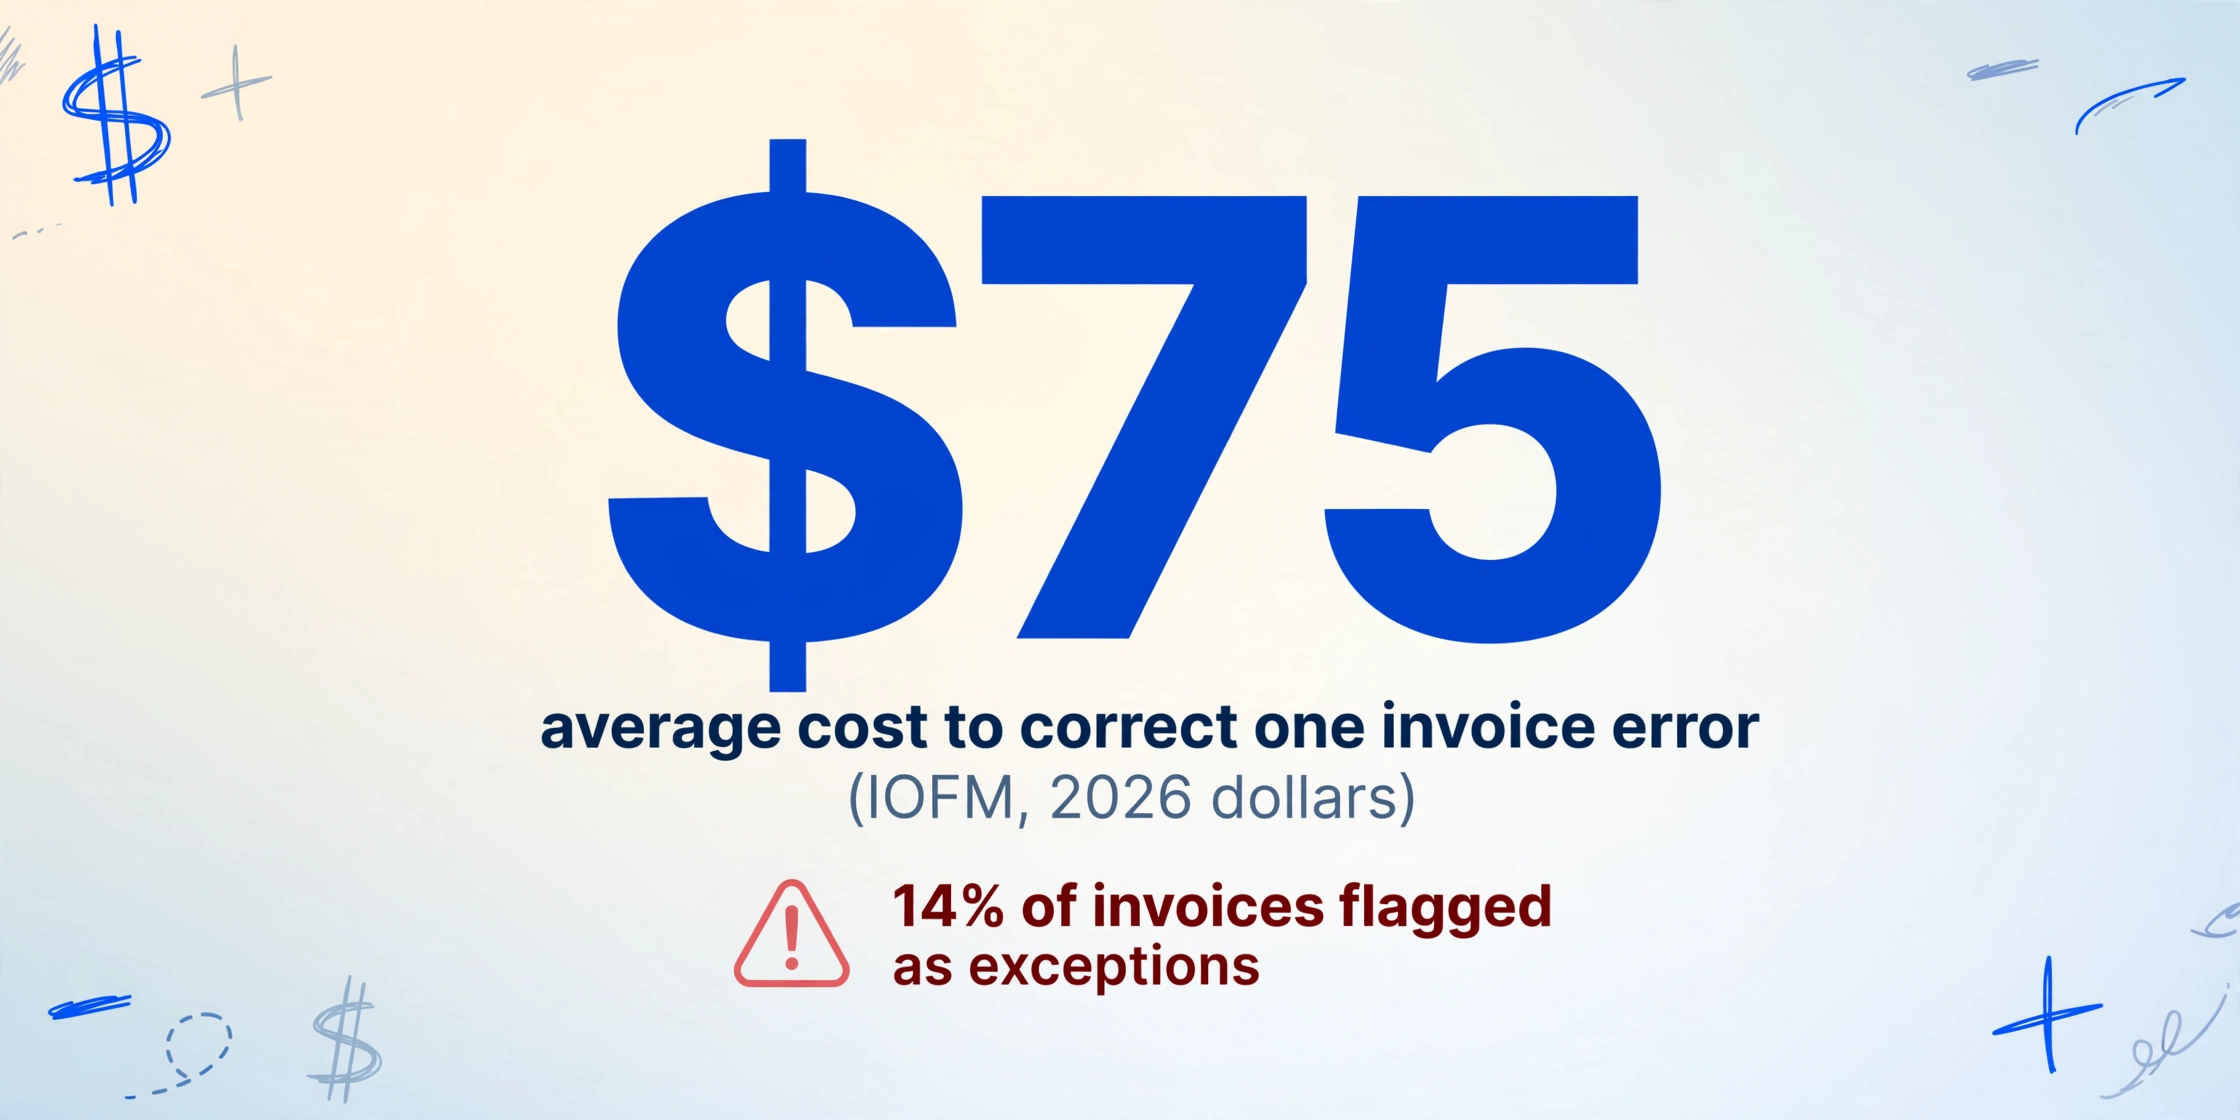
Überspringen Sie das Gate, und ein Extraktionsfehler wird zu einem Geschäftsfehler ohne Verantwortlichen. Eine Ziffernvertauschung ändert eine Rechnungssumme von 2.470 $ auf 2.740 $. Ein einmal falsch gelesener Lieferantenname führt zu einer Zahlung auf das falsche Konto. Eine Positionszeile von Seite zwei landet auf dem falschen Dokument, wenn ein mehrseitiger Satz zusammengeführt wird. Jeder dieser Fehler liegt innerhalb der 14 % der Rechnungen, die die Umfrage von Ardent Partners 2025 als Ausnahmen markiert, und jeder einzelne ist in der Tabelle kostengünstig zu beheben und nach der Buchung teuer.
Die Kostenseite ist gut dokumentiert. IOFM benchmarkt eine durchschnittliche manuelle Rechnungsbearbeitung mit 12,5 Minuten, wobei jede Ausnahme 15 bis 45 Minuten Sonderbehandlung obendrauf addiert. Die Korrektur eines einzelnen Rechnungsfehlers kostet etwa 75 $ in 2026-Dollar, sobald Untersuchung, Korrektur und Nachverfolgung einbezogen sind, und ein Fehler, der bis zur Abstimmung durchgeht, kann 25-50 % zu den ursprünglichen Rechnungskosten hinzufügen (IOFM; Ardent Partners 2025). Die Ausnahmewarteschlange ist die teure kleine Minderheit: Ausnahmen machen typischerweise 5-15 % des Dokumentvolumens aus, verursachen aber 30-50 % der gesamten Verarbeitungskosten, weil jede Ausnahme qualifizierte menschliche Aufmerksamkeit verbraucht.
Menschen, die damit leben, kennen das aus Erfahrung. In einem r/Accounting-Thread über automatisierte Rechnungsextraktion beschrieb ein AP-Praktiker, was ihr Team nach einem Jahr des Vertrauens in das Tool aufgebaut hat: "wir mussten so drei verschiedene Validierungsebenen einrichten, weil die KI immer wieder Zahlungsbedingungen übersah oder Positionszeilen bei mehrseitigen Rechnungen durcheinanderbrachte ... Sie brauchen trotzdem jemanden, der jede Extraktion beaufsichtigt" (r/Accounting). Was diese Geschichte zeigt, ist ein reaktives Gate: Die Menschen wurden nach dem ersten fehlerhaften Import hinzugefügt, während ein von vornherein geplanter Review-Schritt dieselben Fehler zu einem Bruchteil der Kosten erfasst hätte.
Der Eingangsfluss und wo ein Gate platziert werden kann
Der Dokumenteneingang hat in den meisten Betriebsteams eine erkennbare Struktur. Dokumente treffen ein (E-Mail-Weiterleitung, ein Sammlungslink, ein freigegebener Ordner, eine Upload-Seite). Eine Extraktionsengine liest jedes Dokument und erzeugt eine Tabelle. Diese Tabelle wird exportiert oder an das System of Record übergeben: Xero, QuickBooks, NetSuite, eine SQL-Datenbank, ein Webhook in eine breitere Automatisierung. Die Pipeline hat vier Zeitpunkte, an denen ein Review-Schritt platziert werden könnte:
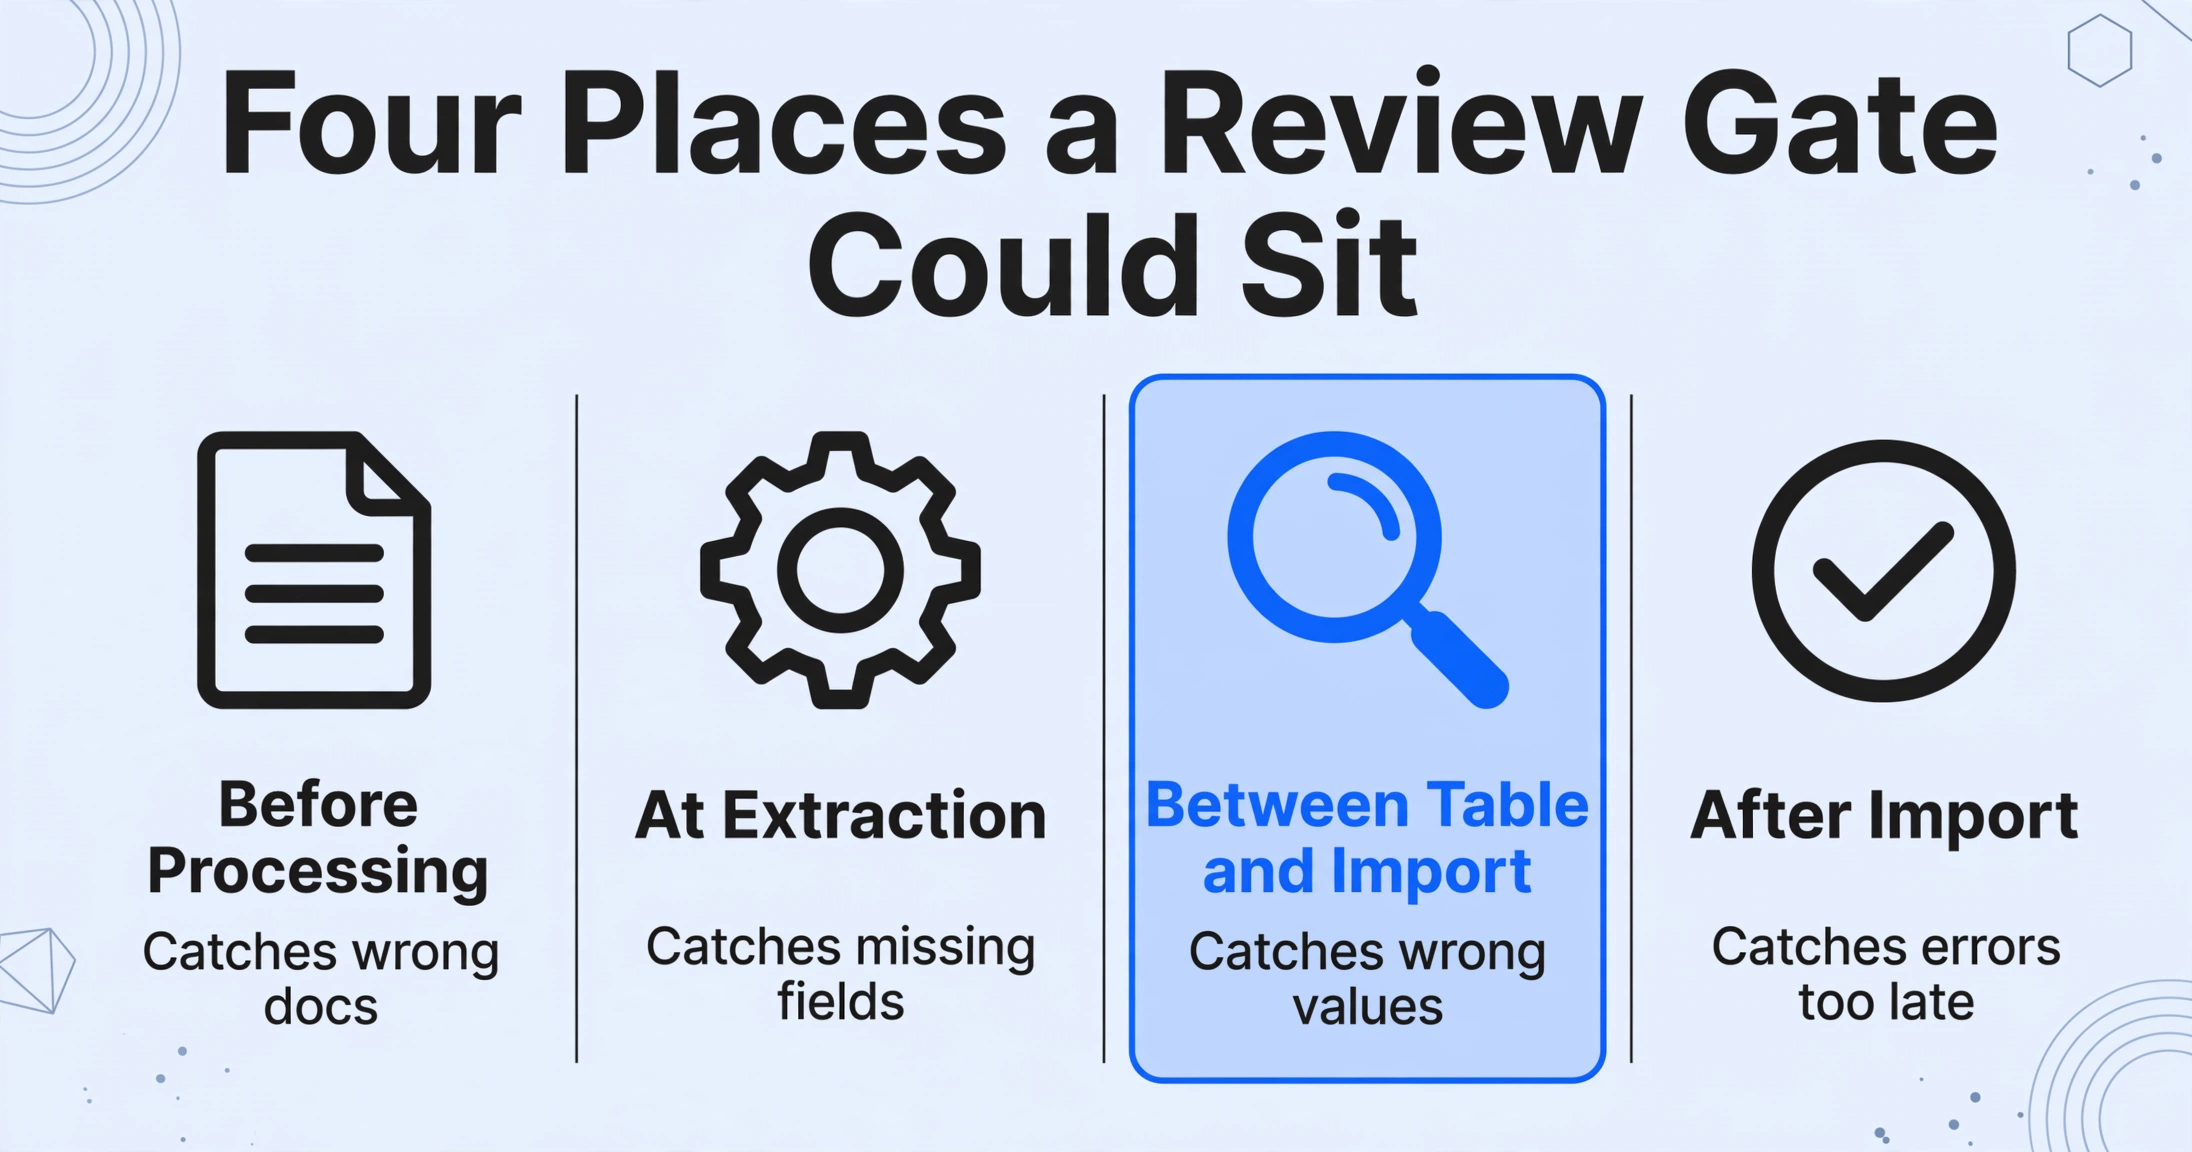
| Gate-Position | Was es erfasst | Was es übersieht |
|---|---|---|
| Vor der Verarbeitung (Warteschlangenfreigabe) | Falsche Dokumente, Duplikate beim Eingang | Nichts über die extrahierten Werte |
| Zum Zeitpunkt der Extraktion (Validierungsregeln) | Fehlende Felder, Summen, die nicht abgleichen | Vorhandene, aber falsche Werte |
| Zwischen Tabelle und Import (manuelle Prüfung) | Falsche, falsch gelesene oder mehrdeutige Werte | Fehler, wenn der Prüfer nicht hinsieht |
| Nach dem Import (Buchungsprüfung) | Fehler, die überlebt haben, nachdem die Kosten entstanden sind | Alles, bis jemand es bemerkt |
Die dritte Position ist die, die die meisten Teams unternutzen. Validierungsregeln erfassen strukturelle Probleme, aber sie können Ihnen nicht sagen, ob der extrahierte Betrag der auf der Seite gedruckte Betrag ist. Dieser Vergleich, extrahierter Wert gegen Quelle, ist eine für Menschen sichtbare Tatsache, und genau dafür ist ein Review-Schritt zwischen Tabelle und Import da.
Warum 100 % ohne manuellen Eingriff kein realistisches Ziel ist
Die Einrichtung eines Review-Gates fühlt sich an, als würde man zugeben, dass die Automatisierung unvollständig ist. Der ehrliche Rahmen ist das Gegenteil: Ein Gate macht die Automatisierung sicher im unbeaufsichtigten Betrieb für die Dokumente, die sie verarbeiten kann. Ohne manuellen Eingriff bedeutet, dass ein Dokument Erfassung, Extraktion, Validierung und Buchung mit null manuellem Eingriff durchläuft. Aus demselben Ardent-Partners-Datensatz laufen durchschnittlich nur 32,6 % der Rechnungen ohne manuellen Eingriff durch, und der Best-in-Class-Wert liegt bei 49,2 % (Ardent Partners 2025). Die Referenzseite zu Durchlaufquoten ohne manuellen Eingriff erklärt die Formel und warum Best-in-Class-Teams dennoch etwa die Hälfte ihrer Dokumente mit einem manuellen Berührungspunkt belassen.
Es gibt gute Gründe für diese Dokumente. Ein fehlendes Feld (die PO-Nummer ist nicht auf der Rechnung) ist eine Abwesenheit, die keine Extraktionsengine erfinden kann, und es als falsch gelesen zu behandeln, führt zu nichts. Handschrift, Scans geringer Qualität und europäische Datumsformate bringen Zeichenebenen-Leser durcheinander. Mehrseitige Rechnungen erhalten ihre Positionszeilen in inkonsistenter Reihenfolge zusammengeführt. Und die Feldgenauigkeit summiert sich: Selbst bei 95 % Feldgenauigkeit ist ein Dokument mit 15 Feldern weniger als die Hälfte der Zeit vollständig korrekt (0,95 hoch 15), weshalb eine Erwartung eines vollständig korrekten Dokuments scheitert, lange bevor ein Modell beschuldigt wird. Die Daten zur Ausnahmequote bei Dokumentenautomatisierung sammeln die unabhängigen Zahlen hinter all dem.
Die praktische Regel aus diesen Zahlen ist eine geteilte Warteschlange: Dokumente, deren extrahierte Felder Ihre Prüfungen bestehen, durchlaufen ohne Prüfung, und eine kleinere markierte Gruppe erhält eine manuelle Prüfung vor dem Import. In dieser Gruppe zu sein bedeutet nur, dass die Automatisierung ihre Aufgabe erfüllt, indem sie „Prüf mich“ sagt; es sagt nichts über die Qualität des Dokuments oder der Extraktion aus.
Welche Zeilen tatsächlich den menschlichen Blick benötigen
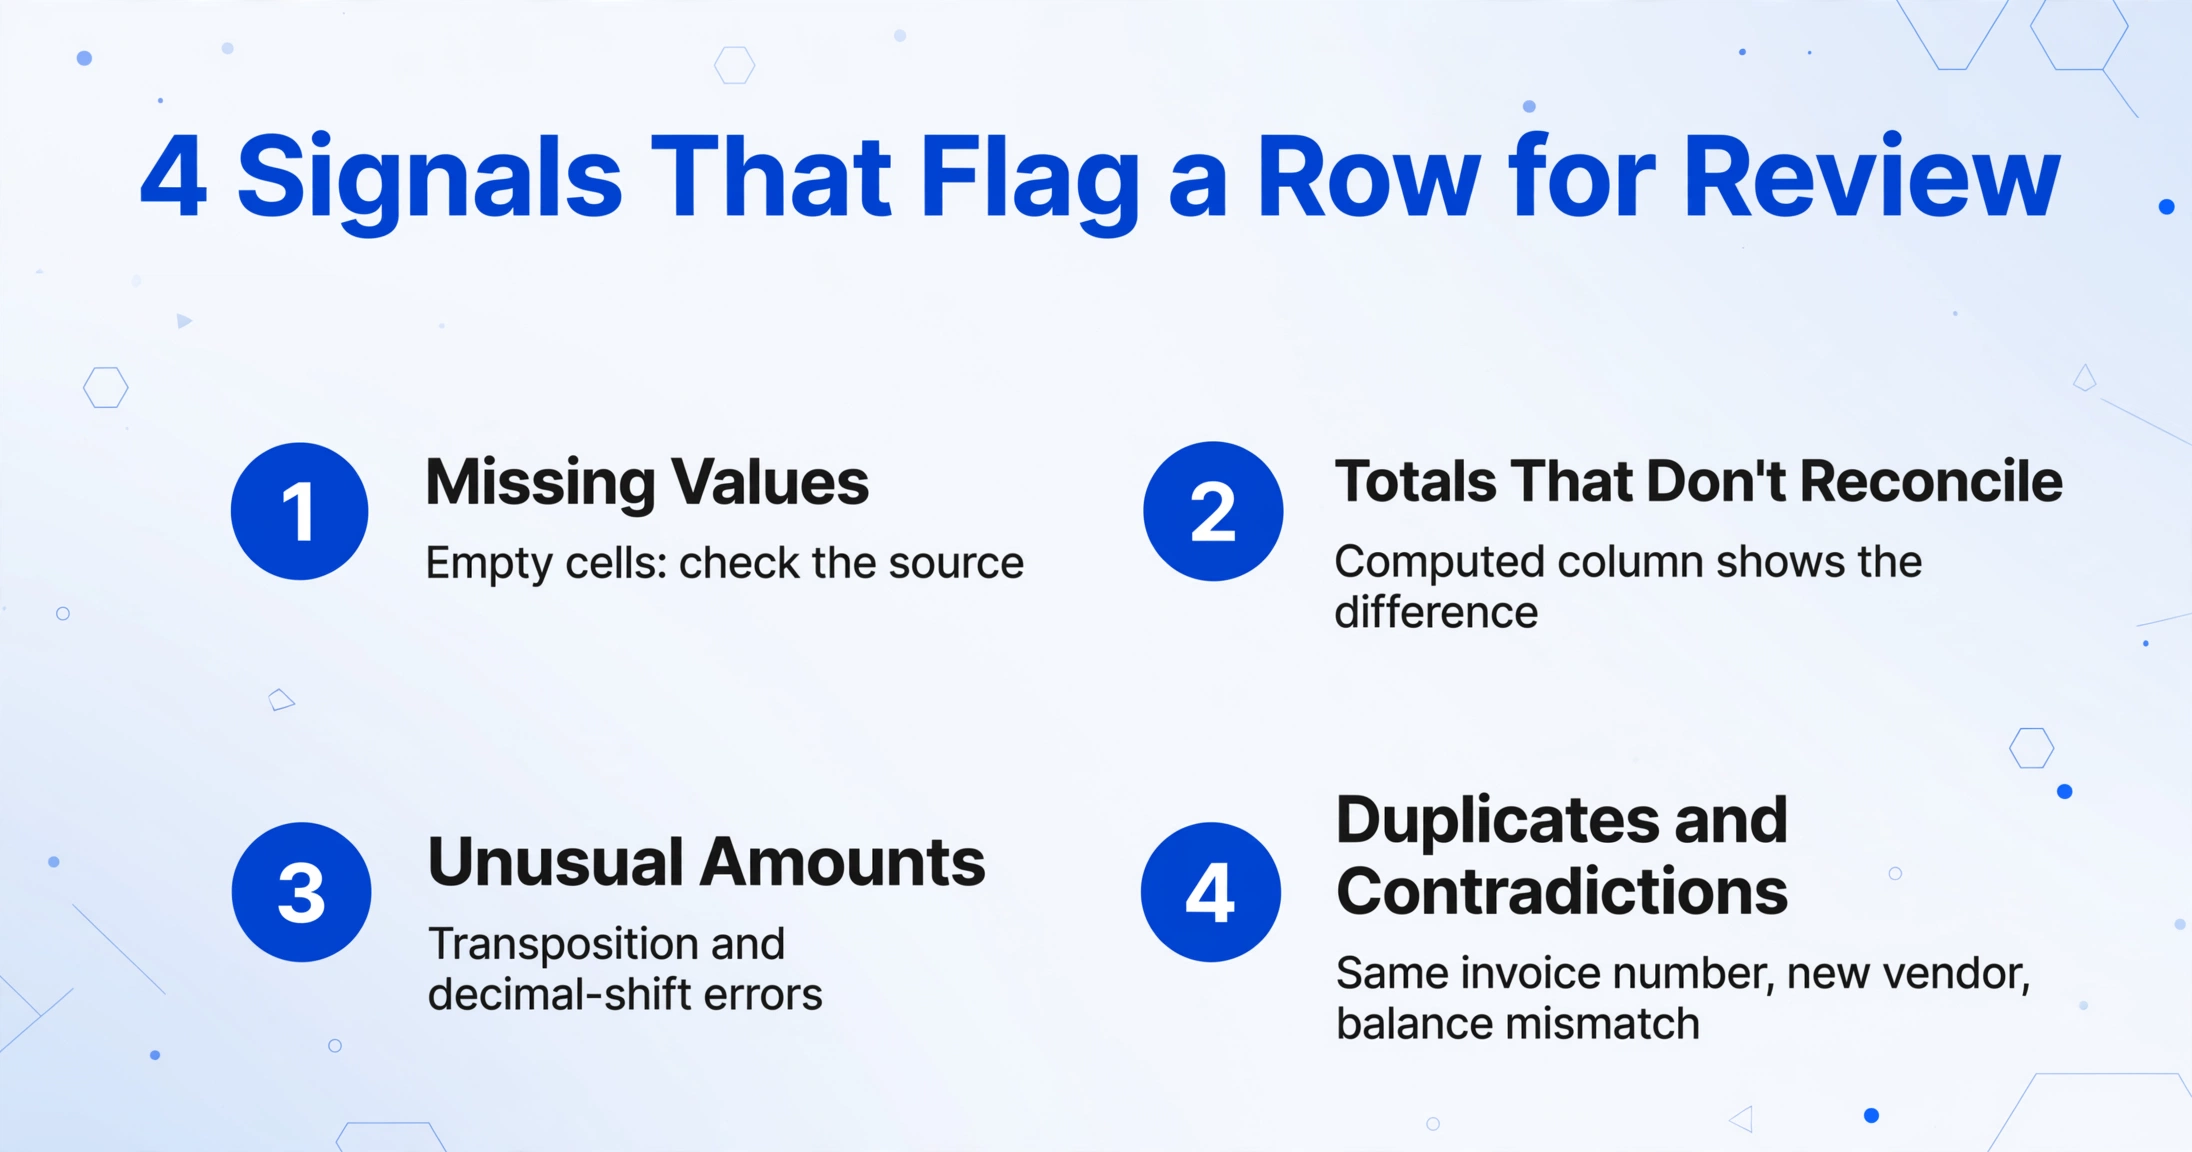
Jede Zeile zu prüfen ist genauso verschwenderisch wie keine zu prüfen. Die Designfrage ist, welche Zeilen das höchste Risiko tragen. In der Praxis decken vier Signaltypen den Großteil dessen ab, was ein Review-Gate erfassen sollte:
- Fehlende Werte. Ein Feld, das die Extraktion leer zurückgab (Rechnungsnummer, Datum, Gesamtbetrag). Sortieren Sie die Tabelle nach leeren Zellen und prüfen Sie die Quelle: Das Feld kann wirklich nicht vorhanden sein, oder die Engine könnte es übersehen haben.
- Werte, die nicht abgleichen. Eine Summe, die nicht mit der Summe ihrer Positionszeilen übereinstimmt. Wenn das Extraktionstool berechnete Spalten unterstützt, lassen Sie die Differenz als Prüfspalte ausgeben und sehen Sie sich die Zeilen an, in denen die Differenz nicht null ist.
- Ungewöhnliche Beträge. Werte außerhalb des Bereichs, den der Lieferant normalerweise berechnet, oder eine Summe, die um den Faktor zehn danebenliegt. Dies sind die Ziffernvertauschungs- und Dezimalverschiebungsfehler.
- Zwei Dokumente, die sich nicht identisch verhalten sollten. Doppelte Rechnungsnummern, Zahlungen an ein Lieferantenkonto, das Sie zuvor nicht gesehen haben, oder ein Kontoauszugssaldo, der der Vorperiode widerspricht.
Keines dieser Signale erfordert das Lesen jeder Zelle. Es sind Filter, die Sie zuerst auf die Tabelle anwenden – das hält den menschlichen Schritt bei Minuten statt Stunden. Unser Leitfaden zur Überprüfung von Extraktionsergebnissen mit gezielten Stichprobenprüfungen behandelt die Stichprobenlogik ausführlich, einschließlich der Frage, warum Stichprobenziehung Fehler übersieht, die sich in Beträgen, Daten und Kennungen häufen.
So wird der Review-Schritt auf eine Konfiguration abgebildet
ImageToTable.ai unterstützt die Prüfung, indem jede extrahierte Zelle mit dem Ort auf dem Originaldokument verknüpft wird, von dem sie stammt. Dadurch ist das Gate zwischen Tabelle und Import schnell genug für den Produktionsbetrieb. Die Einrichtung gliedert sich in vier Schritte.
Batch in eine Tabelle extrahieren
Benennen Sie die Spalten, die Sie möchten (Rechnungsnummer, PO-Nummer, Gesamtbetrag, Fälligkeitsdatum), und lassen Sie die Extraktionsengine sie füllen, indem sie jeden Wert an beliebiger Stelle auf der Seite findet. Der Batch-Upload führt alle Dokumente in einer einzigen Tabelle zusammen, sodass das Review-Gate über die gesamte Gruppe funktioniert und nicht Datei für Datei. Die API-Version des gleichen Ablaufs speist Ihre bestehenden nachgelagerten Systeme direkt.
Auto-Annotation für den Batch aktivieren
Aktivieren Sie „Auto-Annotate nach der Verarbeitung“, damit jede Extraktion mit angehängten Quellpositionen zurückkommt. Wenn Sie über eine beliebige Zelle im Review-Bildschirm schweben oder darauf klicken, hebt das Originalbild genau hervor, wo dieser Wert gelesen wurde. Wenn Sie auf einen markierten Bereich im Bild klicken, springt es zur passenden Tabellenzelle.
Markierte Zeilen gegen die Quelle prüfen
Sortieren Sie nach Ihren Risikosignalen: leere Zellen, Differenzen in berechneten Spalten, doppelte Kennungen. Prüfen Sie für jede markierte Zeile die Zelle gegen ihre hervorgehobene Quellposition. Wenn ein Wert falsch ist, bearbeiten Sie ihn direkt; ein Klick zeigt den ursprünglichen Wert der KI und ermöglicht es Ihnen, die Änderung rückgängig zu machen, falls Ihre Bearbeitung der Fehler war.
Nur nach Prüfung importieren
Exportieren Sie die geprüfte Tabelle oder pushen Sie sie über die v1-API, aber nur, wenn die markierten Zeilen geprüft wurden. Nichts im Tool sendet Daten automatisch an Ihr Buchhaltungssystem; der Import ist ein Schritt, den Sie auslösen, nachdem das Gate geschlossen wurde.
Dieser Ablauf ist bewusst klein. Er fügt eine Konfiguration (Auto-Annotate) und eine Gewohnheit (Prüfung vor Import) zu einem Ablauf hinzu, der sonst identisch mit einer blinden Pipeline ohne manuellen Eingriff aussieht. Der Unterschied ist, wo Fehler auftauchen: in der Tabelle, wo eine Korrektur Sekunden kostet, statt im ERP, wo die gleiche Korrektur 75 $ plus ein Nachgespräch kostet.
Was dieses Setup nicht tut
Präzise über die Grenzen des Gates zu sein, gehört zu seiner Zuverlässigkeit. Drei Grenzen sind hier wichtig.
Das Gate ist ein Schritt, den Sie ausführen, keine serverseitige Sperre auf einem Webhook. Einige Dokumentplattformen ermöglichen es Ihnen, eine Zustellbedingung zu konfigurieren, die Dokumente unter einem Konfidenzwert zurückhält, bis ein Mensch sie in einer separaten Warteschlange freigibt. ImageToTable.ai verhält sich nicht so: Die Prüfung erfolgt in der extrahierten Tabelle, bevor Sie exportieren oder die API aufrufen. Wenn Ihr Workflow eine harte technische Sperre an der Webhook-Grenze erfordert (nichts erreicht das nächste System, bis ein Freigabedatensatz existiert), vergleichen Sie die beiden Architekturen auf unserer Airparser-Vergleichsseite, bevor Sie sich festlegen.
Die Zelle-zu-Quelle-Prüfung ist kein Geschäftsurteil. Der Review-Bildschirm zeigt, woher ein Wert stammt, damit Sie bestätigen können, dass die Extraktion mit dem Dokument übereinstimmt. Er entscheidet nicht, ob der Betrag akzeptabel ist, ob die Vertragsbedingung günstig ist oder ob eine Zahlung freigegeben werden sollte. Für den Betrieb unter Funktionstrennung (die SOX-404-Kontrollumgebung oder jedes Prüfungsrahmenwerk) sollte die Person, die die Extraktion prüft, weiterhin eine andere Person sein als die, die die Zahlung freigibt.
Ein Review-Schritt ersetzt keine ausgabeseitige QA. Das Gate erfasst falsch gelesene Werte gegen die Quelle. Es ist kein Ersatz für die Prüfungen auf Tabellenebene, die stattfinden, bevor Daten in ein System gelangen: Spaltenausrichtung, Zeilenanzahl, die der Dateianzahl entspricht, sowie Datums- und Zahlenformatierung. Unsere 7-Punkte-QA-Checkliste für extrahierte Tabellen ist eine separate Ebene, neben der ein Review-Gate liegen sollte, nicht stattdessen.
Das Gate zu einem Prozess machen, nicht zu einer Hoffnung
Die Teams, die das richtig machen, behandeln den Review-Schritt als geplanten Teil des Tages, nicht als etwas, das passiert, wenn jemand Zeit hat. Weisen Sie eine Person pro Batch zu, definieren Sie, welche Dokumente die Prüfung vollständig umgehen, und vereinbaren Sie, was mit einem markierten Dokument passiert, das eine zweite Meinung benötigt. Der weithin geteilte Vertrauensaufbau passiert in den ersten paar hundert Dokumenten: Ihr Team erstellt eine Liste der Fehlermuster, die die Extraktion tatsächlich bei Ihrem Dokumentenmix erzeugt, und Ihre Markierungen werden schärfer, weil sie auf Beobachtung basieren, nicht auf einem generischen Schwellenwert.
Das ist das ehrliche Maß einer Extraktionsbereitstellung. Eine einzelne „99 % Genauigkeit“-Behauptung erfasst keine Betriebsrealität; was tatsächlich Vertrauen verdient, ist ein definierter menschlicher Schritt, der die wichtigen Zeilen betrachtet, bevor etwas nachgelagert weitergegeben wird.
Häufig gestellte Fragen
Kann ImageToTable.ai ein Dokument zurückhalten, bevor es meine Buchhaltungssoftware erreicht?
Nicht im Sinne einer Webhook-Bedingung. Das Tool extrahiert in eine Tabelle, und das Review-Gate ist der Schritt, den Sie im Review-Modus ausführen, bevor Sie exportieren oder über die API buchen. Es gibt keine automatische Sperre, die die Zustellung basierend auf einem Konfidenzwert blockiert. Wenn Sie diese genaue Kontrolle an der Systemgrenze benötigen, ist eine Plattform mit freigabegesteuerter Zustellung die Architektur zum Vergleich mit unserer Seite Airparser-Alternative.
Woher weiß ich, welche Zeilen ohne Konfidenzwert zu prüfen sind?
Bauen Sie die Signale in die Tabelle selbst ein: Sortieren Sie nach fehlenden Werten, fügen Sie eine berechnete Spalte hinzu, die die Differenz zwischen Gesamtbetrag und Summe der Positionszeilen ausgibt, und suchen Sie nach doppelten Kennungen oder Beträgen außerhalb des Bereichs. Der Review-Modus ermöglicht es Ihnen dann, genau diese Zellen gegen ihre Quellpositionen zu prüfen.
Muss ich jedes Dokument in einem Batch prüfen?
Nein. Die Absicht ist, dass die meisten Dokumente ihre Prüfungen unberührt bestehen. Wenn Ihre Ausnahmequote niedriger als erwartet aussieht, prüfen Sie, ob Ihre Filter nicht zu locker sind; eine Stichprobenprüfung der durchlaufenden Zeilen ist eine gute Sicherheitsmaßnahme und kann klein bleiben, sobald Sie das tatsächliche Fehlermuster Ihrer Dokumente kennen.
Funktioniert der Review-Bildschirm für jede Datei, die ich verarbeite?
Quellpositionen werden pro Datei durch Bbox-Annotation generiert. Lösen Sie sie bei Bedarf für eine einzelne Datei aus, oder aktivieren Sie Auto-Annotate nach der Verarbeitung, damit geprüfte Batches bereits ihre Hervorhebungen angehängt haben.
Was, wenn mein Prüfer einen Wert bearbeitet und falsch liegt?
Jede bearbeitete Zelle behält den ursprünglichen Wert der KI einen Klick entfernt, sodass ein Prüfer seine eigene Änderung rückgängig machen kann, anstatt einen Fehler zu verschlimmern. Fehler sind in beide Richtungen korrigierbar.
Testen Sie es mit Ihrem eigenen Batch und sehen Sie, ob die Prüfung markierter Zeilen in die Minuten passt, die Sie eingeplant haben. Das Gate ist eine kleine Gewohnheit und der Unterschied zwischen vertrauenswürdigen Extraktionsdaten und hoffnungsvoll importierten Extraktionsdaten.