Dónde pertenece un paso de revisión humana en un flujo de trabajo de extracción de documentos
La mayoría de las plataformas de automatización de documentos tratan la extracción y la importación como un solo movimiento: la IA lee el documento y el resultado llega a su sistema contable, base de datos o webhook. Los equipos que ejecutan esto en producción saben que el paso riesgoso no es la extracción. Es el momento entre la tabla extraída y la importación, porque ese es el momento en que nadie está mirando.
Esa brecha es medible. En cuentas por pagar, la tasa promedio de procesamiento directo es 32,6% (Ardent Partners 2025), lo que significa que casi dos tercios de las facturas aún reciben alguna intervención humana en algún punto del ciclo. Los equipos que mantienen la extracción confiable generalmente llegaron allí de la misma manera: decidieron de antemano dónde las personas verifican la salida, asignaron personal a ese paso y lo programaron antes de que se importe cualquier cosa.
Conclusiones clave
- 49,2% es la tasa de procesamiento directo de mejor en su clase, por lo que incluso los mejores equipos aún entregan aproximadamente la mitad de sus facturas a una persona.
- Incluso con 95% de precisión por campo, una factura de 15 campos sale completamente correcta menos de la mitad del tiempo.
- Una compuerta de revisión no es una señal de que la automatización falló; es lo que hace que la canalización sea segura para ejecutarse sin supervisión.
Un proyecto de automatización suele comenzar con un número que el equipo quiere alcanzar: procesar 500 facturas al día, cerrar las alimentaciones bancarias sin volver a teclear, cargar cada comprobante de entrega en el ERP. Luego se activa la extracción, la tabla se llena y aparece la primera decisión real: ¿quién revisa esta tabla antes de que algo se mueva aguas abajo? Este artículo explica por qué esa pregunta merece una respuesta explícita, dónde encaja el paso de revisión en un flujo de recepción de documentos y cómo una verificación de fuente a nivel de celda lo mantiene lo suficientemente rápido como para que la compuerta no se convierta en el cuello de botella.
Lo que Cuesta la Falta de un Paso de Revisión
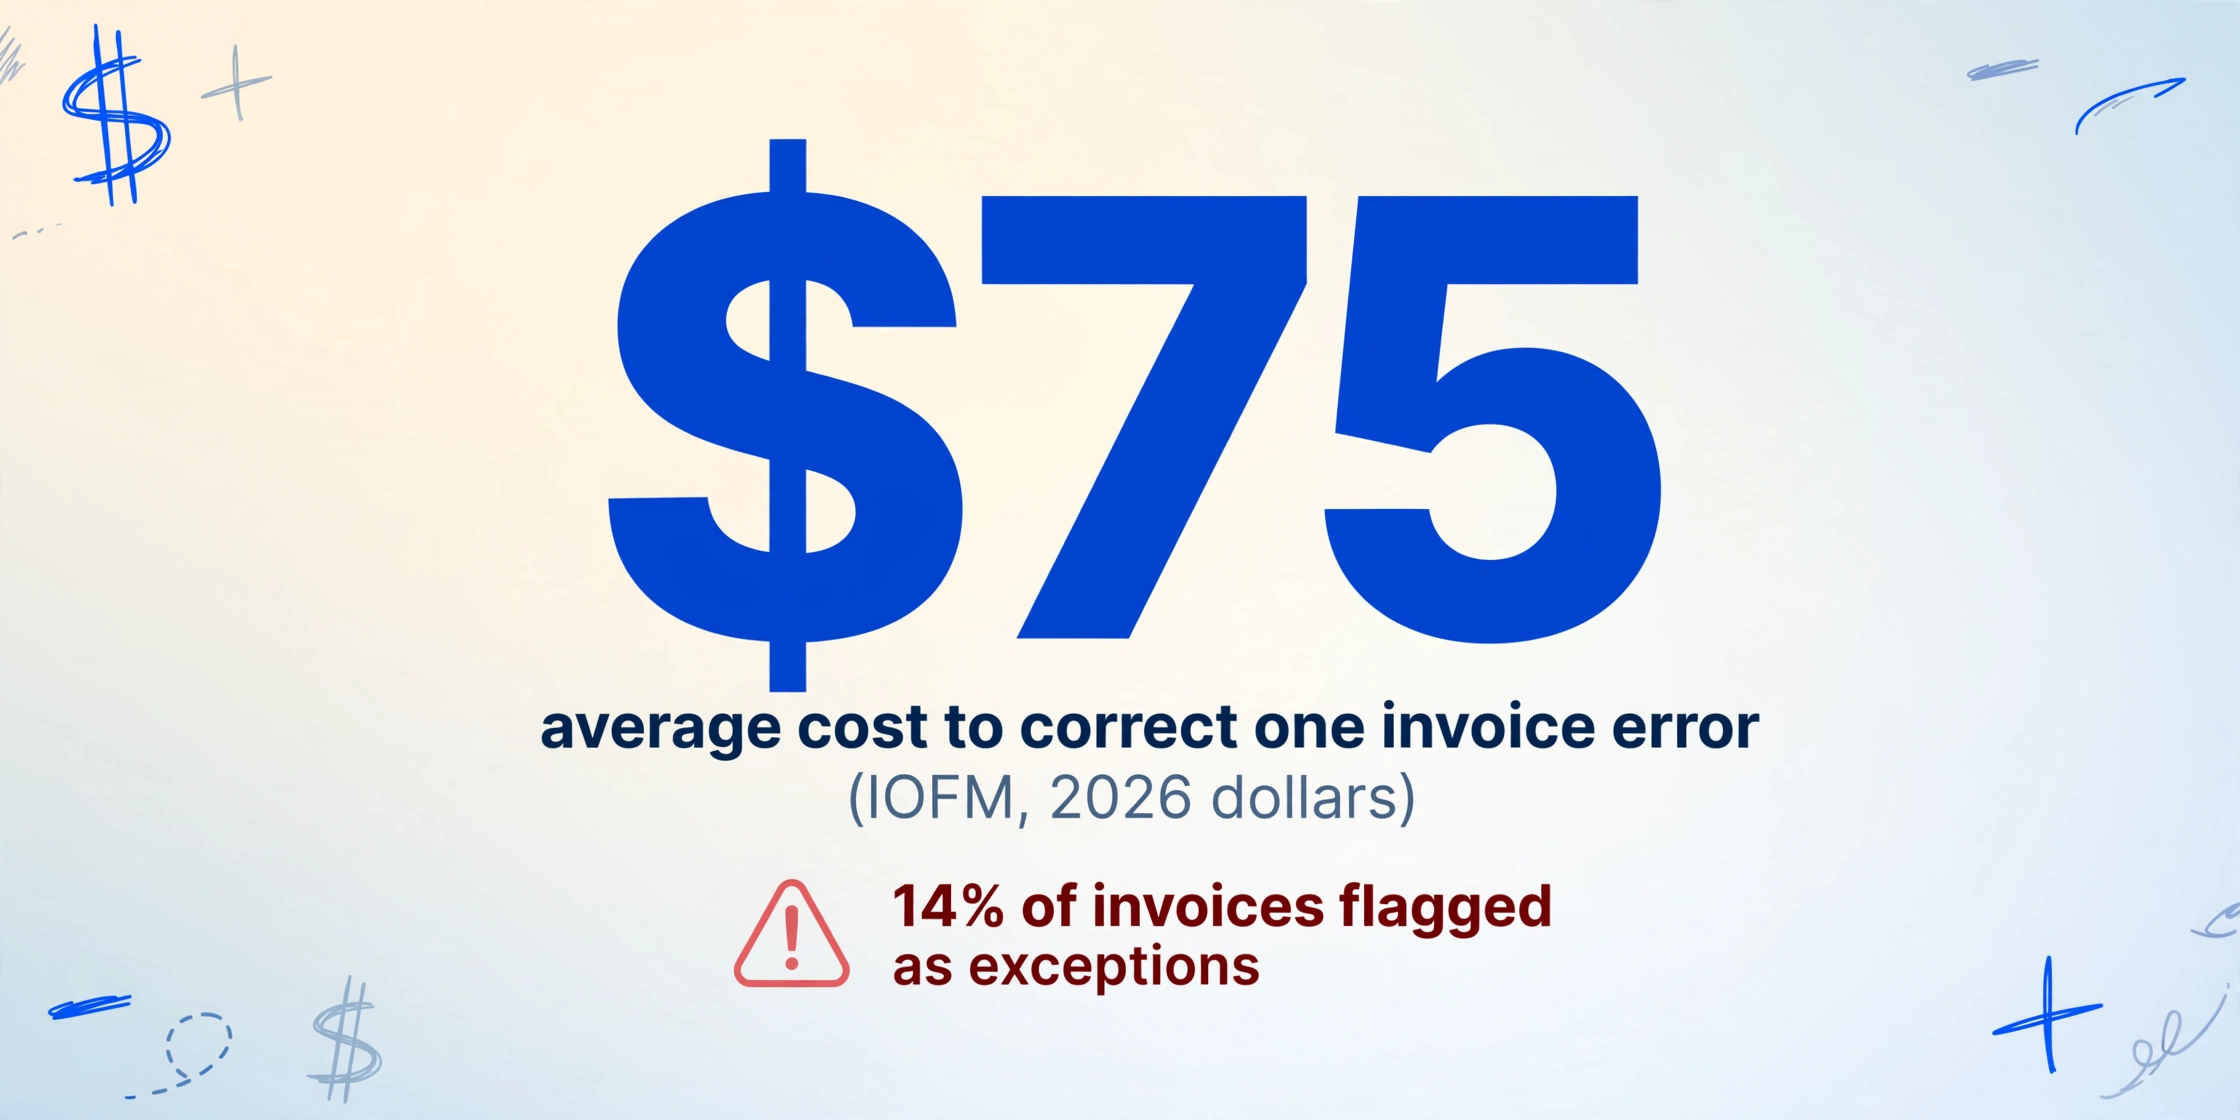
Omita la compuerta y un error de extracción se convierte en un error comercial sin dueño. Un dígito transpuesto cambia el total de una factura de $2,470 a $2,740. Un nombre de proveedor mal leído una vez significa un pago enviado a la cuenta equivocada. Una línea de artículo de la página dos aterriza en el documento equivocado cuando se fusiona un conjunto multipágina. Cada uno de estos casos se encuentra dentro del 14% de las facturas que la encuesta de 2025 de Ardent Partners marca como excepciones, y cada uno es barato de detectar dentro de la tabla y costoso de corregir después de contabilizarse.
El lado del costo está bien documentado. IOFM establece un promedio de manejo manual de facturas de 12.5 minutos, y cada excepción agrega de 15 a 45 minutos de manejo especial adicional. Corregir un solo error de factura cuesta alrededor de $75 en dólares de 2026 una vez que se incluyen la investigación, la corrección y el seguimiento, y un error que llega a la conciliación puede agregar un 25-50% al costo original de la factura (IOFM; Ardent Partners 2025). La cola de excepciones es la minoría pequeña y costosa: las excepciones suelen representar 5-15% del volumen de documentos pero 30-50% del costo total de procesamiento, porque cada excepción consume atención humana calificada.
Quienes viven con esto lo saben por experiencia. En un hilo de r/Accounting sobre extracción automatizada de facturas, un profesional de AP describió lo que su equipo construyó después de un año de confiar en la herramienta: "tuvimos que configurar como tres capas de validación diferentes porque la IA seguía omitiendo las condiciones de pago o mezclando líneas de artículo en facturas multipágina... todavía necesitas a alguien supervisando cada extracción" (r/Accounting). Lo que esa historia muestra es una compuerta reactiva: los humanos se agregaron después de la primera importación defectuosa, cuando un paso de revisión deliberado diseñado desde el principio habría detectado los mismos errores a una fracción del costo.
El Flujo de Entrada y Dónde Puede Ubicarse una Compuerta
La recepción de documentos tiene una forma reconocible en la mayoría de los equipos de operaciones. Los documentos llegan (reenvío de correo electrónico, un enlace de recopilación, una carpeta compartida, una página de carga). Un motor de extracción lee cada uno y produce una tabla. Esa tabla se exporta o se envía al sistema de registro: Xero, QuickBooks, NetSuite, una base de datos SQL, un webhook hacia una automatización más amplia. La canalización tiene cuatro momentos donde se podría colocar un paso de revisión:
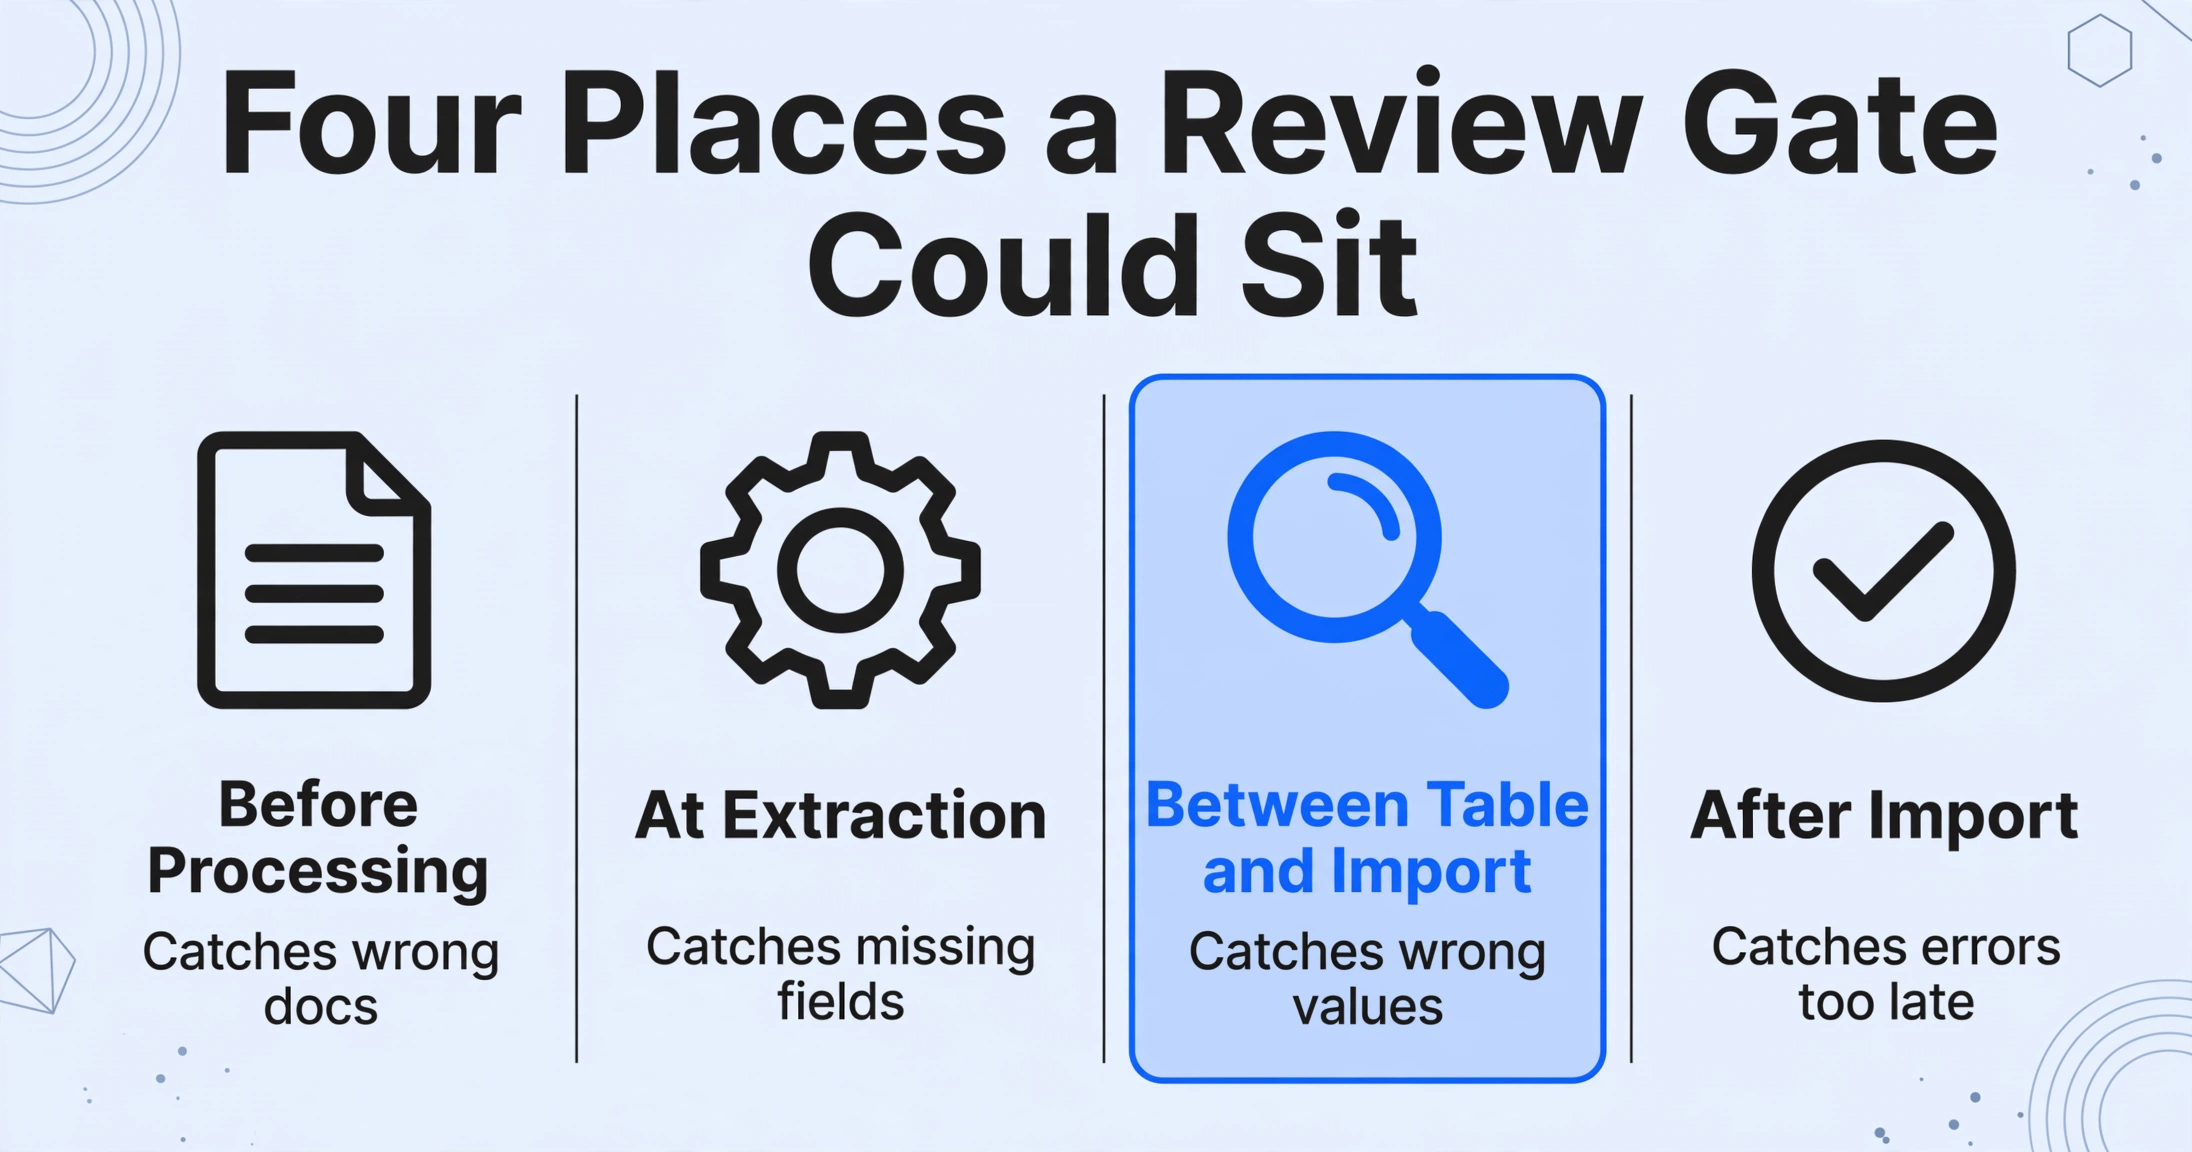
| Posición de la compuerta | Lo que captura | Lo que pierde |
|---|---|---|
| Antes del procesamiento (aprobación de cola) | Documentos incorrectos, duplicados en la recepción | Nada sobre los valores extraídos |
| En el momento de la extracción (reglas de validación) | Campos faltantes, totales que no concilian | Valores presentes pero incorrectos |
| Entre la tabla y la importación (revisión humana) | Valores incorrectos, mal leídos o ambiguos | Errores cuando el revisor no está mirando |
| Después de la importación (auditoría de contabilización) | Errores que sobrevivieron, después de que se incurre en el costo | Todo hasta que alguien lo note |
La tercera posición es la que la mayoría de los equipos subutilizan. Las reglas de validación capturan problemas estructurales, pero no pueden decirle si el monto extraído es el monto impreso en la página. Esa comparación, valor extraído contra la fuente, es un hecho visible para el humano, y es exactamente para lo que sirve un paso de revisión entre tabla e importación.
Por qué el 100% de procesamiento directo no es el objetivo realista
Configurar una compuerta de revisión parece admitir que la automatización está incompleta. El encuadre honesto es el opuesto: una compuerta es lo que hace que la automatización sea segura para ejecutar sin supervisión en los documentos que puede manejar. El procesamiento directo significa que un documento completa la ingesta, extracción, validación y contabilización con cero intervención humana. Del mismo conjunto de datos de Ardent Partners, solo el 32,6% de las facturas se procesan directamente en promedio, y la cifra de mejor en su clase es del 49,2% (Ardent Partners 2025). La página de referencia sobre tasas de procesamiento directo explica la fórmula y por qué los equipos de mejor en su clase aún dejan aproximadamente la mitad de sus documentos con un punto de contacto humano.
Hay buenas razones para que esos documentos existan. Un campo faltante (el número de PO no está en la factura) es una ausencia que ningún motor de extracción puede inventar, y tratarlo como un error de lectura no lleva a ninguna parte. La escritura a mano, los escaneos de baja calidad y los formatos de fecha europeos confunden a los lectores a nivel de caracteres. Las facturas multipágina fusionan sus líneas de artículo en un orden inconsistente. Y la precisión por campo se acumula: incluso con un 95% de precisión por campo, un documento de 15 campos es completamente correcto menos de la mitad del tiempo (0,95 a la 15ª potencia), por lo que una expectativa de documento completamente limpio falla mucho antes de que se culpe a cualquier modelo. Los datos de tasa de excepción de automatización de documentos recopilan los números independientes detrás de todo esto.
La regla práctica de estos números es una cola dividida: los documentos cuyos campos extraídos pasan sus comprobaciones pasan sin una mirada, y un conjunto marcado más pequeño recibe revisión humana antes de la importación. Estar en ese conjunto solo significa que la automatización está haciendo su trabajo al decir "revísame"; no dice nada sobre la calidad del documento o de la extracción.
Qué Filas Realmente Necesitan la Mirada Humana
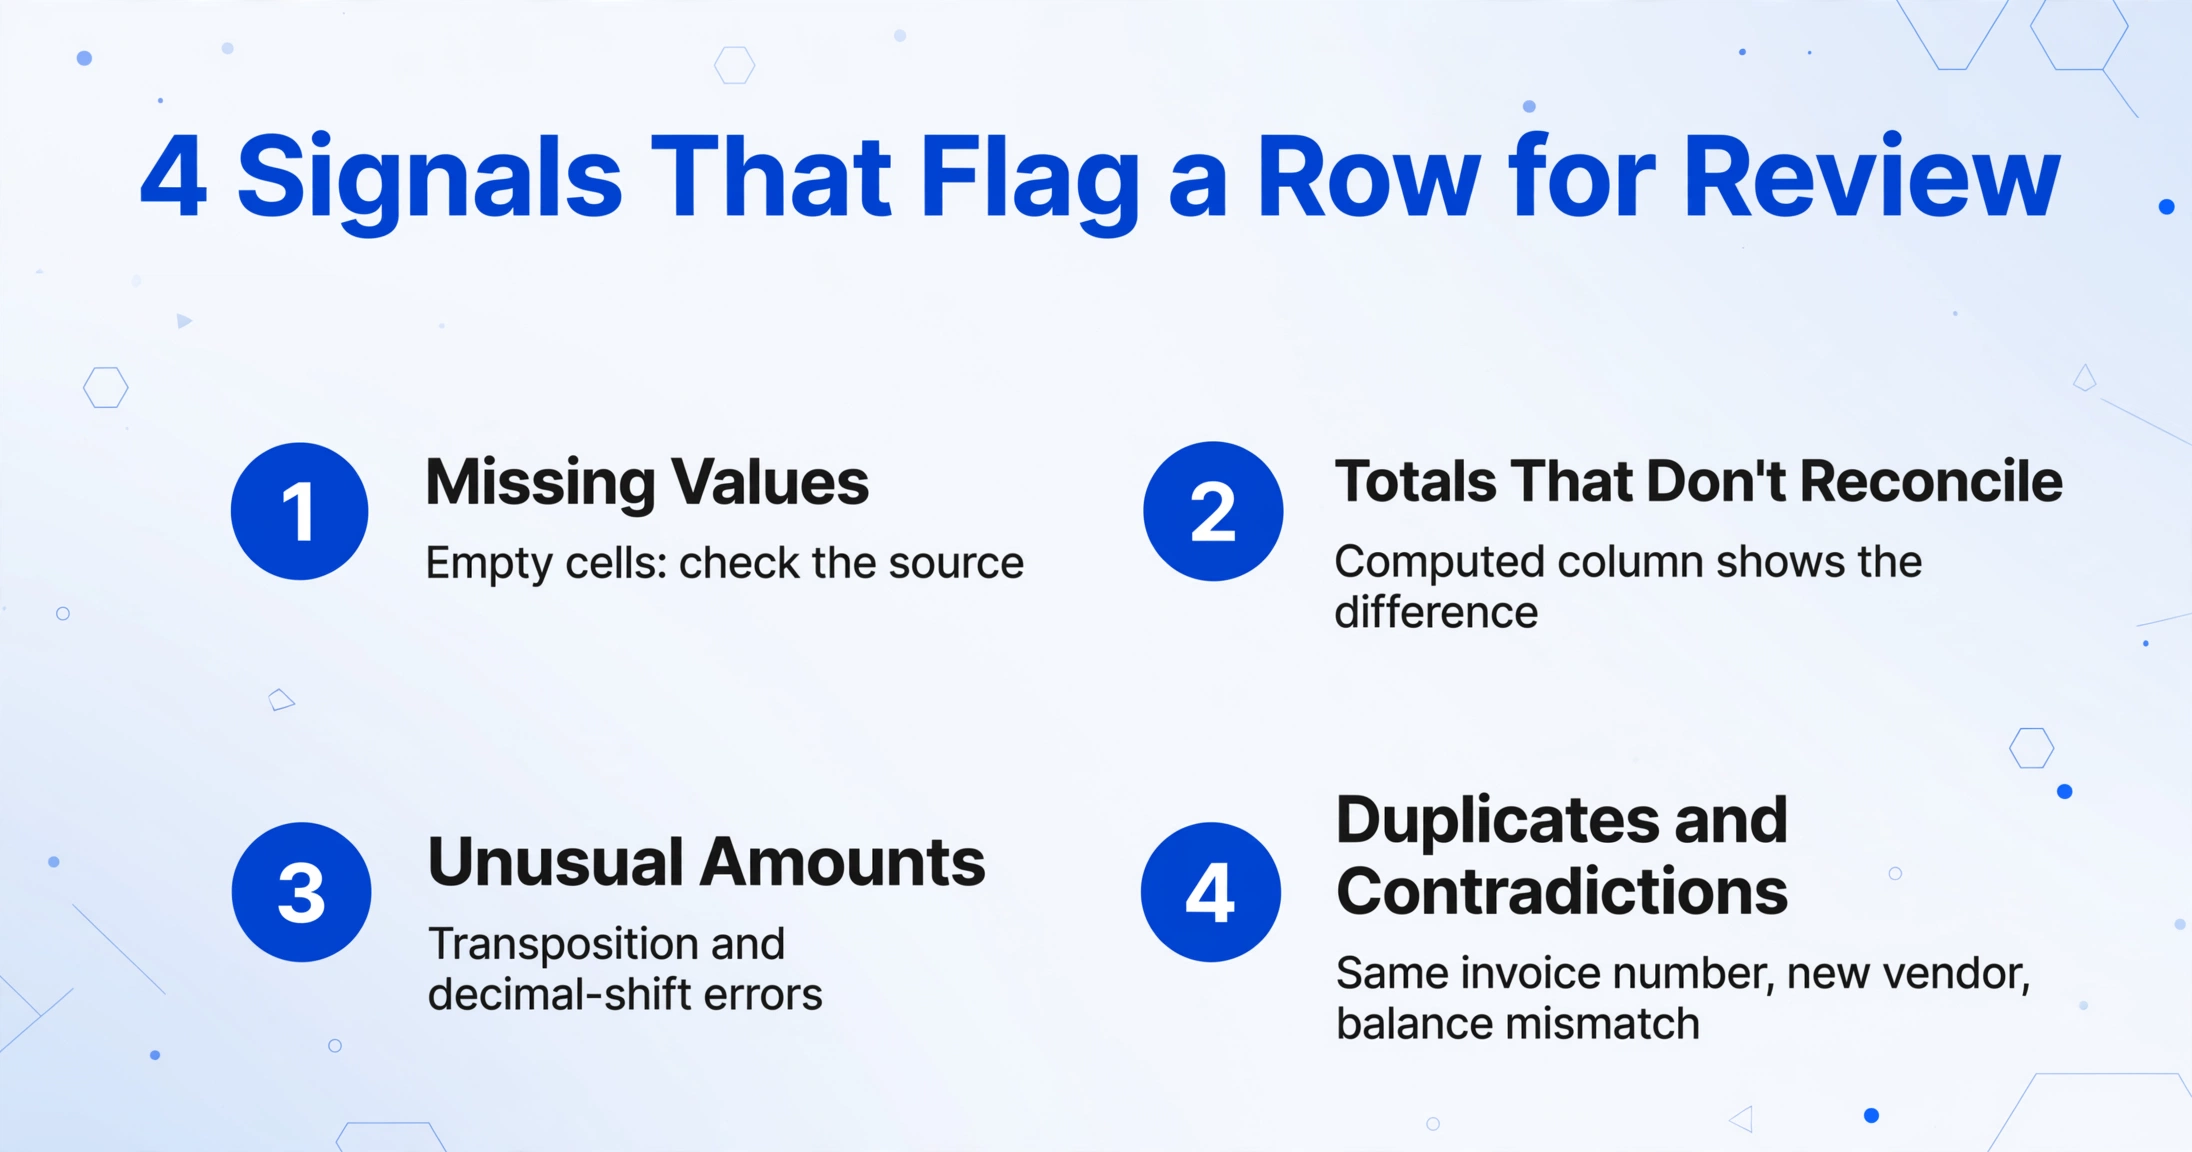
Revisar cada fila es tan inútil como no revisar ninguna. La pregunta de diseño es qué filas conllevan más riesgo. En la práctica, cuatro tipos de señales cubren la mayor parte de lo que una compuerta de revisión debería capturar:
- Valores faltantes. Un campo que la extracción devolvió vacío (número de factura, fecha, total). Ordene la tabla por celdas vacías y verifique la fuente: el campo puede estar realmente ausente, o el motor puede haberlo omitido.
- Valores que no concilian. Un total que no coincide con la suma de sus líneas de artículo. Si la herramienta de extracción admite columnas calculadas, pídale que genere la diferencia como columna de verificación y luego mire las filas donde la diferencia no es cero.
- Montos inusuales. Valores fuera del rango que el proveedor factura normalmente, o un total que parece desviado por un factor de diez. Estos son los errores de transposición de dígitos y de desplazamiento decimal.
- Dos documentos que no deberían comportarse de manera idéntica. Números de factura duplicados, pagos a una cuenta de proveedor que no ha visto antes, o un saldo de estado de cuenta que contradice el período anterior.
Ninguna de estas señales requiere leer cada celda. Son filtros que aplica primero a la tabla, lo que mantiene el paso humano en minutos en lugar de horas. Nuestra guía sobre verificación de resultados de extracción con comprobaciones puntuales dirigidas cubre la lógica de muestreo en profundidad, incluido por qué el muestreo aleatorio pierde los errores que se concentran en montos, fechas e identificadores.
Cómo se Asigna el Paso de Revisión a una Configuración
ImageToTable.ai admite la revisión vinculando cada celda extraída a la ubicación de origen en el documento original. Esto es lo que hace que la compuerta entre tabla e importación sea lo suficientemente rápida para ejecutarse en producción. La configuración se divide en cuatro pasos.
Extraer el lote en una tabla
Nombre las columnas que desee (número de factura, número de PO, total, fecha de vencimiento) y deje que el motor de extracción las llene encontrando cada valor en cualquier lugar de la página. La carga por lotes fusiona cada documento en una sola hoja de cálculo, por lo que la compuerta de revisión funciona en todo el conjunto en lugar de archivo por archivo. La versión de API del mismo flujo alimenta directamente sus sistemas posteriores existentes.
Activar la autoanotación para el lote
Habilite la "autoanotación después del procesamiento" para que cada extracción regrese con sus ubicaciones de origen adjuntas. Pase el cursor o haga clic en cualquier celda de la pantalla de revisión y la imagen original resalta exactamente dónde se leyó ese valor. Haga clic en una región ubicada en la imagen y salta a la celda de tabla correspondiente.
Verificar las filas marcadas contra la fuente
Ordene por sus señales de riesgo: celdas vacías, diferencias de columnas calculadas, identificadores duplicados. Para cada fila marcada, verifique la celda contra su ubicación de origen resaltada. Si un valor es incorrecto, edítelo en el lugar; un clic muestra el valor original de la IA y le permite revertir si su edición fue el error.
Importar solo después de la revisión
Exporte la tabla revisada, o envíela a través de la API v1, solo cuando las filas marcadas hayan sido verificadas. Nada en la herramienta envía datos a su sistema contable por sí solo; la importación es un paso que usted activa después de que la compuerta se haya cerrado.
Esta secuencia es deliberadamente pequeña. Agrega una configuración y un hábito (verificar antes de importar) a un flujo que de otro modo parece idéntico a una canalización de procesamiento directo a ciegas. La diferencia es dónde aparecen los errores: en la tabla, donde la corrección cuesta segundos, en lugar de en el ERP, donde la misma corrección cuesta $75 más una conversación de seguimiento.
Lo Que Esta Configuración No Hace
Ser preciso sobre los límites de la compuerta es parte de hacerla confiable. Tres límites importan aquí.
La compuerta es un paso que usted ejecuta, no una retención en el servidor en un webhook. Algunas plataformas de documentos le permiten configurar una condición de entrega que retiene documentos por debajo de una puntuación de confianza hasta que un humano los apruebe en una cola separada. ImageToTable.ai no se comporta de esa manera: la revisión ocurre dentro de la tabla extraída, antes de exportar o llamar a la API. Si su flujo de trabajo requiere un bloqueo técnico estricto en el límite del webhook (nada llega al siguiente sistema hasta que exista un registro de aprobación), compare las dos arquitecturas en nuestra página de comparación de Airparser antes de comprometerse.
La verificación de celda a fuente no es un juicio comercial. La pantalla de revisión le muestra de dónde proviene un valor, para que pueda confirmar que la extracción coincide con el documento. No decide si el monto es aceptable, si la condición contractual es favorable, ni si un pago debe ser aprobado. Para operaciones bajo segregación de funciones (el entorno de control SOX 404, o cualquier marco de auditoría), la persona que verifica la extracción debe seguir siendo una persona diferente de la que aprueba el pago.
Un paso de revisión no reemplaza la QA del lado de salida. La compuerta captura errores de lectura contra la fuente. No es un sustituto de las comprobaciones a nivel de hoja de cálculo que ocurren antes de que los datos entren en cualquier sistema: alineación de columnas, recuento de filas que coincida con el recuento de archivos, y formato de fechas y números. Nuestra lista de verificación de QA de 7 puntos para hojas de cálculo extraídas es una capa separada junto a la cual debe ubicarse una compuerta de revisión, no en lugar de ella.
Hacer de la Compuerta un Proceso, No una Esperanza
Los equipos que hacen esto correctamente tratan el paso de revisión como una parte programada del día, no como algo que sucede cuando alguien tiene tiempo. Asigne una persona por lote, defina qué documentos omiten la revisión por completo, y acuerde qué sucede con un documento marcado que necesita una segunda opinión. La mejora ampliamente compartida de la confianza ocurre en los primeros cientos de documentos: su equipo construye una lista de los patrones de error que la extracción realmente produce en su mezcla de documentos, y sus marcadores se vuelven más precisos porque están basados en la observación, no en un umbral genérico.
Esa es la medida honesta de una implementación de extracción. Una afirmación única de "99% de precisión" no captura ninguna realidad operativa; lo que realmente gana confianza es un paso humano definido que mira las filas importantes antes de que algo se mueva aguas abajo.
Preguntas frecuentes
¿Puede ImageToTable.ai retener un documento antes de que llegue a mi software contable?
No en el sentido de condición de webhook. La herramienta extrae en una tabla, y la compuerta de revisión es el paso que ejecuta en el modo de revisión antes de exportar o contabilizar a través de la API. No hay retención automática que bloquee la entrega basada en una puntuación de confianza. Si necesita ese control exacto en el límite del sistema, una plataforma con entrega sujeta a aprobación es la arquitectura para comparar con nuestra página de alternativa a Airparser.
¿Cómo sé qué filas revisar sin una puntuación de confianza?
Integre las señales en la propia tabla: ordene por valores faltantes, agregue una columna calculada que genere la diferencia entre el total y la suma de sus líneas de artículo, y busque identificadores duplicados o montos fuera de rango. El modo de revisión le permite verificar exactamente esas celdas contra sus ubicaciones de origen.
¿Tengo que revisar cada documento de un lote?
No. La intención es que la mayoría de los documentos pasen sus comprobaciones sin tocarse. Si su tasa de excepción parece más baja de lo esperado, verifique que sus filtros no sean demasiado flexibles; una auditoría por muestreo de las filas que pasan es una buena salvaguarda y puede mantenerse pequeña una vez que conozca el patrón de error real de sus documentos.
¿La pantalla de revisión funciona para cada archivo que proceso?
Las ubicaciones de origen se generan por archivo mediante anotación bbox. Actívela en un solo archivo cuando sea necesario, o habilite la autoanotación después del procesamiento para que los lotes revisados ya tengan sus resaltados adjuntos.
¿Qué pasa si mi revisor edita un valor y se equivoca?
Cada celda editada mantiene el valor original de la IA a un clic de distancia, por lo que el revisor puede revertir su propio cambio en lugar de agravar un error. Los errores son corregibles en ambas direcciones.
Pruébelo en su propio lote y vea si la revisión de filas marcadas cabe en los minutos que presupuestó. La compuerta es un pequeño hábito, y es la diferencia entre datos de extracción confiables y datos de extracción importados con esperanza.