Onde uma Etapa de Revisão Humana se Encaixa em um Fluxo de Trabalho de Extração de Documentos
A maioria das pilhas de automação de documentos trata extração e importação como um único movimento: a IA lê o documento e o resultado chega ao seu sistema contábil, banco de dados ou webhook. As equipes que executam isso em produção sabem que a etapa arriscada não é a extração. É o momento entre a tabela extraída e a importação, porque é o momento em que ninguém está olhando.
Essa lacuna é mensurável. Em contas a pagar, a taxa média de processamento direto é de 32,6% (Ardent Partners 2025), o que significa que quase dois terços das faturas ainda recebem alguma intervenção humana em algum lugar do ciclo. As equipes que mantêm a extração confiável geralmente chegaram lá da mesma forma: decidiram antecipadamente onde as pessoas verificam a saída, alocaram pessoal para essa etapa e a programaram antes que qualquer coisa seja importada.
Principais Conclusões
- 49,2% é a taxa de processamento direto da melhor da classe, então até as melhores equipes ainda entregam cerca de metade de suas faturas a uma pessoa.
- Mesmo com 95% de precisão por campo, uma fatura de 15 campos sai totalmente correta menos da metade das vezes.
- Uma porta de revisão não é um sinal de que a automação falhou; é o que torna o pipeline seguro para executar sem supervisão.
Um projeto de automação geralmente começa com um número que a equipe quer alcançar: processar 500 faturas por dia, fechar os feeds bancários sem redigitar, carregar cada comprovante de entrega no ERP. Então a extração é ativada, a tabela é preenchida e a primeira decisão real aparece: quem olha para esta tabela antes que qualquer coisa se mova downstream? Este artigo explica por que essa pergunta merece uma resposta explícita, onde a etapa de revisão se encaixa em um fluxo de recebimento de documentos e como uma verificação de fonte no nível da célula a mantém rápida o suficiente para que a porta não se torne o gargalo.
O Custo de uma Etapa de Revisão Ausente
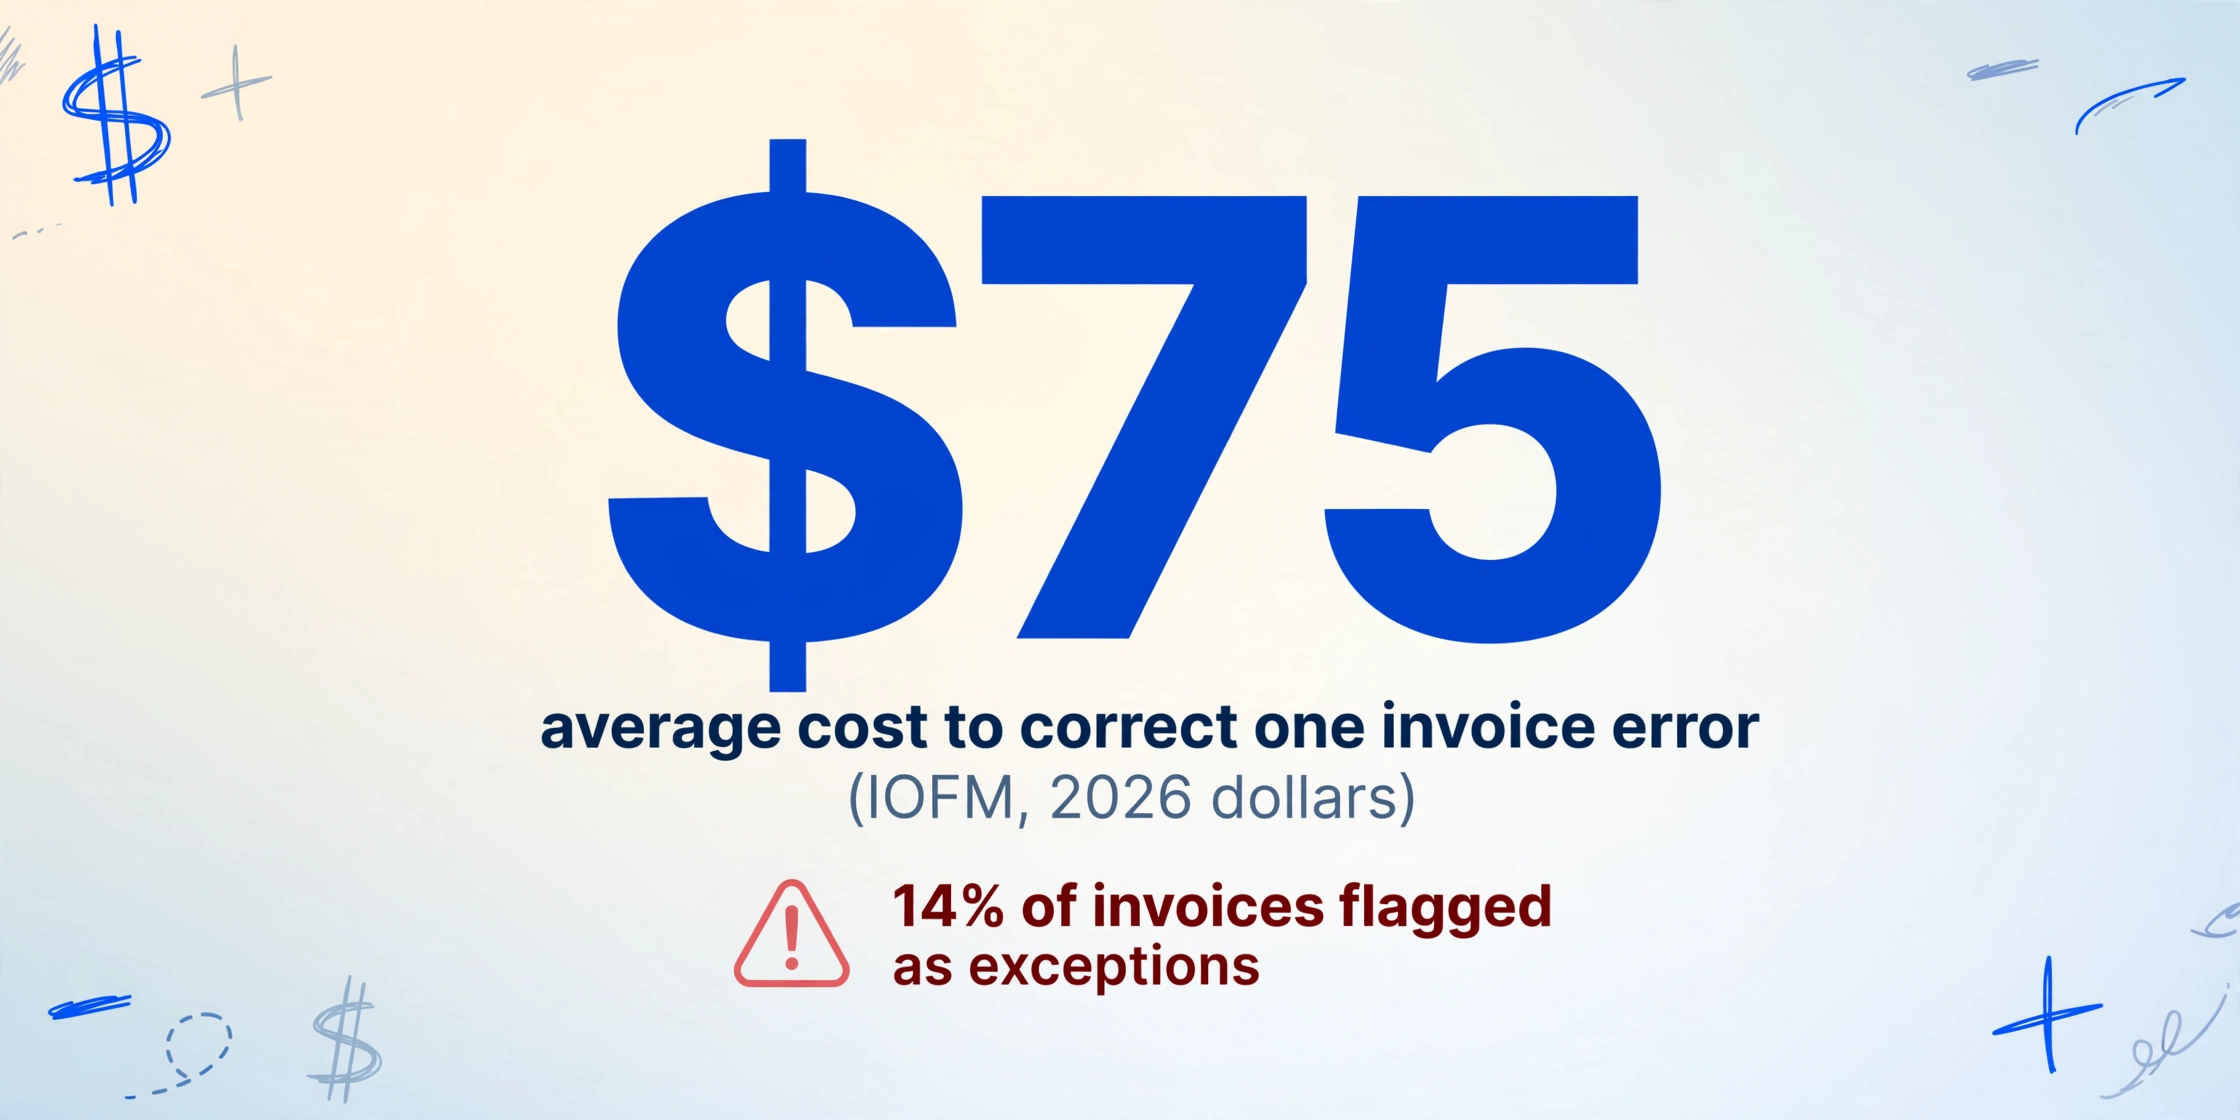
Pule a porta e um erro de extração se torna um erro de negócio sem dono. Uma transposição de dígitos muda o total de uma fatura de $2.470 para $2.740. Um nome de fornecedor mal lido uma vez significa um pagamento direcionado à conta errada. Uma linha de item da página dois cai no documento errado quando um conjunto multipágina é mesclado. Cada um desses casos está dentro dos 14% das faturas que a pesquisa de 2025 da Ardent Partners sinaliza como exceções, e cada um é barato de capturar dentro da tabela e caro de corrigir depois que é contabilizado.
O lado do custo é bem documentado. O IOFM avalia o manuseio manual médio de uma fatura em 12,5 minutos, com cada exceção adicionando de 15 a 45 minutos de tratamento especial por cima. Corrigir um único erro de fatura custa cerca de $75 em dólares de 2026, incluindo investigação, correção e acompanhamento, e um erro que chega à conciliação pode adicionar 25-50% ao custo original da fatura (IOFM; Ardent Partners 2025). A fila de exceções é a minoria cara: as exceções normalmente representam 5-15% do volume de documentos, mas 30-50% do custo total de processamento, porque cada exceção consome atenção humana qualificada.
As pessoas que convivem com isso sabem por experiência. Em um tópico do r/Accounting sobre extração automatizada de faturas, um profissional de AP descreveu o que sua equipe construiu depois de um ano confiando na ferramenta: "tivemos que configurar tipo três camadas de validação diferentes porque a IA continuava perdendo condições de pagamento ou misturando linhas de item em faturas multipágina... você ainda precisa de alguém supervisionando cada extração" (r/Accounting). O que essa história mostra é uma porta reativa: os humanos foram adicionados após a primeira importação ruim, quando uma etapa de revisão deliberada, projetada antecipadamente, teria capturado os mesmos erros a uma fração do custo.
O Fluxo de Recebimento e Onde uma Porta de Revisão Pode Ficar
O recebimento de documentos tem uma forma reconhecível na maioria das equipes de operações. Os documentos chegam (encaminhamento de e-mail, um link de coleta, uma pasta compartilhada, uma página de upload). Um mecanismo de extração lê cada um e produz uma tabela. Essa tabela é exportada ou enviada para o sistema de registro: Xero, QuickBooks, NetSuite, um banco de dados SQL, um webhook para uma automação mais ampla. O pipeline tem quatro momentos onde uma etapa de revisão poderia ser colocada:
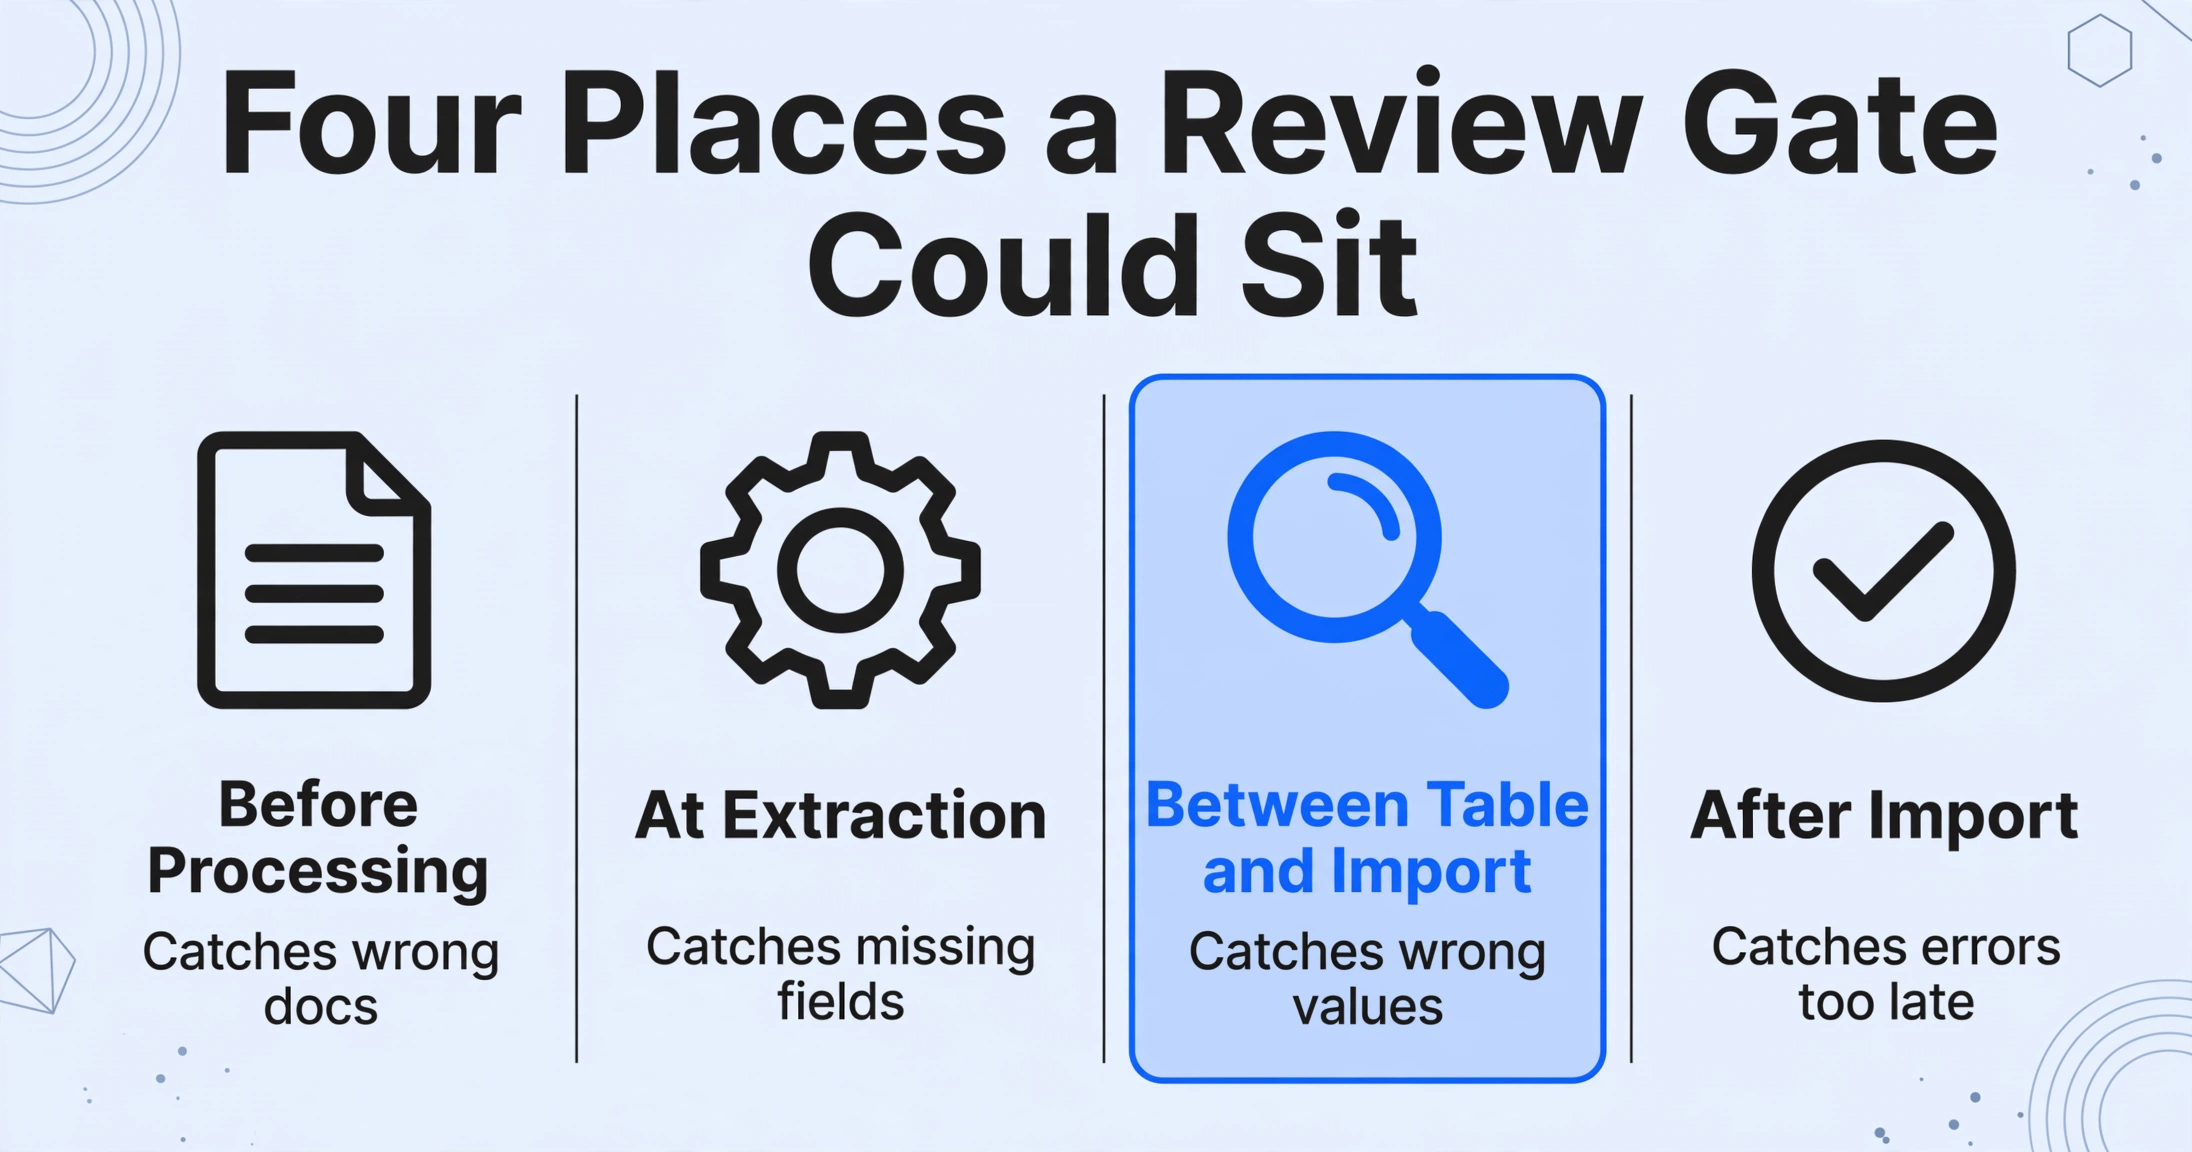
| Posição da porta | O que captura | O que perde |
|---|---|---|
| Antes do processamento (aprovação de fila) | Documentos errados, duplicados no recebimento | Nada sobre os valores extraídos |
| No momento da extração (regras de validação) | Campos ausentes, totais que não reconciliam | Valores presentes, mas errados |
| Entre a tabela e a importação (revisão humana) | Valores errados, mal lidos ou ambíguos | Erros quando o revisor não está olhando |
| Após a importação (auditoria de contabilização) | Erros que sobreviveram, depois que o custo é incorrido | Tudo até alguém notar |
A terceira posição é a que a maioria das equipes mais subutiliza. As regras de validação capturam problemas estruturais, mas não podem dizer se o valor extraído é o valor impresso na página. Essa comparação, valor extraído contra a fonte, é um fato visível para humanos, e é exatamente para isso que serve uma etapa de revisão entre a tabela e a importação.
Por que 100% de processamento direto não é a meta realista
Configurar uma porta de revisão parece admitir que a automação está incompleta. O enquadramento honesto é o oposto: uma porta é o que torna a automação segura para executar sem supervisão nos documentos que pode processar. Processamento direto significa que um documento conclui ingestão, extração, validação e contabilização com zero intervenção humana. Do mesmo conjunto de dados da Ardent Partners, apenas 32,6% das faturas passam diretamente em média, e o número da melhor da classe é 49,2% (Ardent Partners 2025). A página de referência sobre taxas de processamento direto explica a fórmula e por que as equipes da melhor da classe ainda deixam aproximadamente metade de seus documentos com um ponto de contato humano.
Há boas razões para esses documentos existirem. Um campo ausente (o número de PO não está na fatura) é uma ausência que nenhum mecanismo de extração pode inventar, e tratá-lo como mal lido não leva a lugar nenhum. Escrita manual, digitalizações de baixa qualidade e formatos de data europeus confundem leitores de nível de caractere. Faturas multipágina têm suas linhas de item mescladas em ordem inconsistente. E a precisão por campo se acumula: mesmo com 95% de precisão por campo, um documento de 15 campos está totalmente correto menos da metade do tempo (0,95 à 15ª potência), e é por isso que uma expectativa de documento totalmente limpo falha muito antes de qualquer modelo ser culpado. Os dados de taxa de exceção de automação de documentos coletam os números independentes por trás de tudo isso.
A regra prática desses números é uma fila dividida: documentos cujos campos extraídos passam nas suas verificações passam sem uma olhada, e um conjunto sinalizado menor recebe revisão humana antes da importação. Estar nesse conjunto apenas significa que a automação está fazendo seu trabalho ao dizer "verifique-me"; não diz nada sobre a qualidade do documento ou da extração.
Quais Linhas Realmente Precisam do Olhar Humano
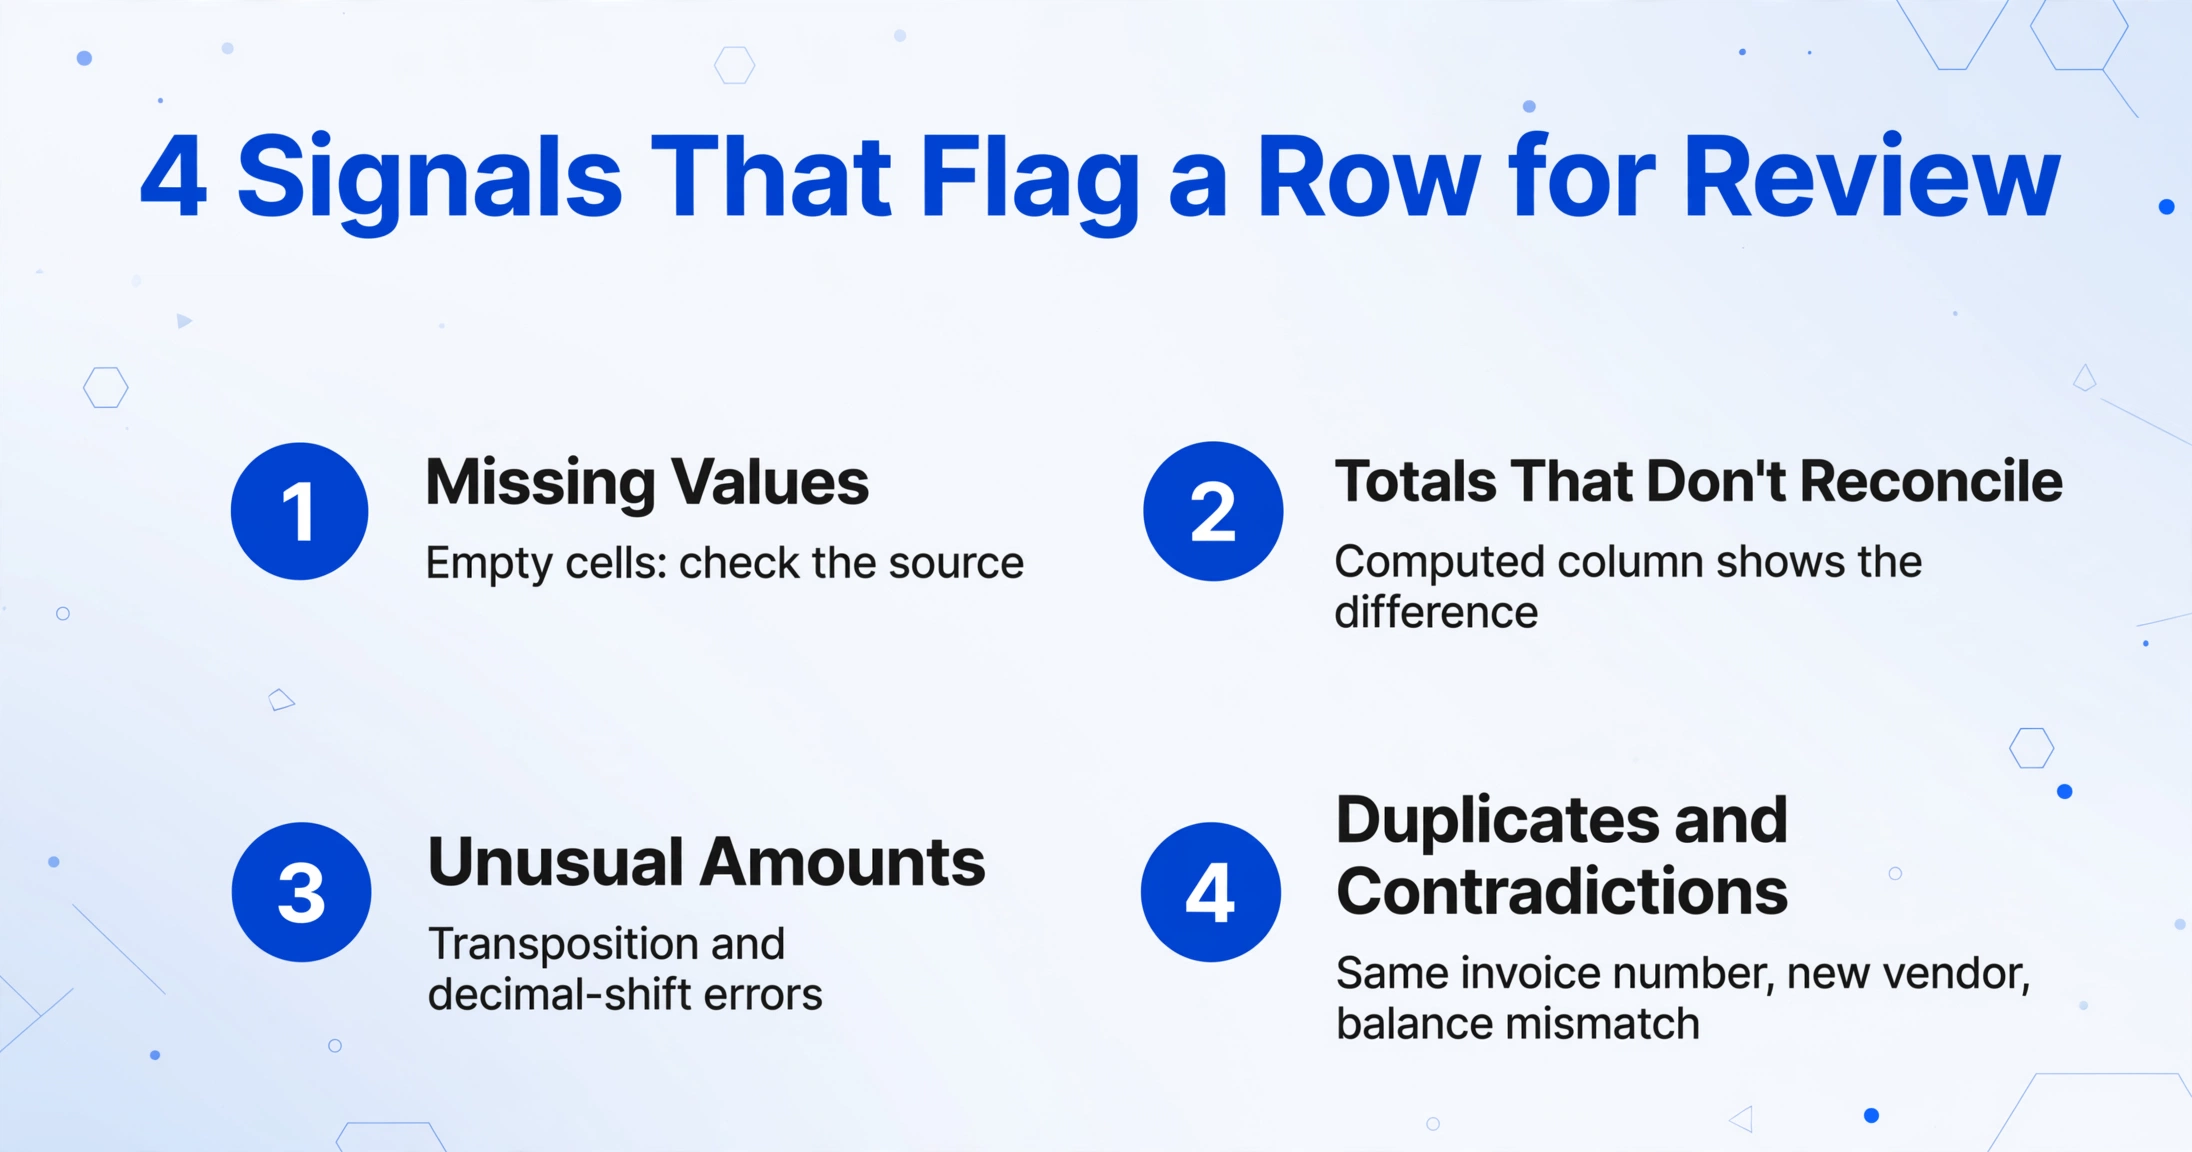
Revisar cada linha é tão inútil quanto não revisar nenhuma. A questão de design é quais linhas carregam mais risco. Na prática, quatro tipos de sinais cobrem a maior parte do que uma porta de revisão deve capturar:
- Valores ausentes. Um campo que a extração retornou vazio (número da fatura, data, total). Classifique a tabela por células vazias e verifique a fonte: o campo pode estar realmente ausente, ou o mecanismo pode ter perdido.
- Valores que não reconciliam. Um total que não corresponde à soma de suas linhas de item. Se a ferramenta de extração suportar colunas calculadas, peça a ela que gere a diferença como coluna de verificação, e depois olhe as linhas onde a diferença não é zero.
- Valores incomuns. Valores fora do intervalo que o fornecedor normalmente fatura, ou um total que parece desviado por um fator de dez. Esses são os erros de transposição de dígitos e deslocamento decimal.
- Dois documentos que não deveriam se comportar de forma idêntica. Números de fatura duplicados, pagamentos para uma conta de fornecedor que você não viu antes, ou um saldo de extrato bancário que contradiz o período anterior.
Nenhum desses sinais exige ler cada célula. Eles são filtros que você aplica primeiro à tabela, e é isso que mantém a etapa humana em minutos em vez de horas. Nosso guia sobre verificação de resultados de extração com verificações pontuais direcionadas cobre a lógica de amostragem em profundidade, incluindo por que a amostragem aleatória perde os erros que se concentram em valores, datas e identificadores.
Como a Etapa de Revisão se Mapea a uma Configuração
ImageToTable.ai suporta revisão vinculando cada célula extraída ao local de origem no documento original. Isso é o que torna a porta entre tabela e importação rápida o suficiente para rodar em produção. A configuração se divide em quatro etapas.
Extrair o lote em uma tabela
Nomear as colunas desejadas (número da fatura, número de PO, total, data de vencimento) e deixar que o mecanismo de extração as preencha encontrando cada valor em qualquer lugar da página. O upload em lote mescla cada documento em uma única planilha, para que a porta de revisão funcione em todo o conjunto, em vez de arquivo por arquivo. A versão da API do mesmo fluxo alimenta diretamente seus sistemas downstream existentes.
Ativar a autoanotação para o lote
Habilitar "autoanotação após o processamento" para que cada extração retorne com suas localizações de origem anexadas. Passar o mouse ou clicar em qualquer célula na tela de revisão e a imagem original destaca exatamente onde esse valor foi lido. Clicar em uma região localizada na imagem e ela salta para a célula correspondente da tabela.
Verificar as linhas sinalizadas contra a fonte
Classificar por seus sinais de risco: células vazias, diferenças de colunas calculadas, identificadores duplicados. Para cada linha sinalizada, verificar a célula contra sua localização de origem destacada. Se um valor estiver errado, editá-lo no local; um clique mostra o valor original da IA e permite reverter se sua edição foi o erro.
Importar somente após a revisão
Exportar a tabela revisada, ou enviá-la pela API v1, somente quando as linhas sinalizadas tiverem sido verificadas. Nada na ferramenta envia dados ao seu sistema contábil por conta própria; a importação é uma etapa que você aciona após a porta ter fechado.
Esta sequência é deliberadamente pequena. Adiciona uma configuração e um hábito (verificar antes de importar) a um fluxo que, de outra forma, parece idéntico a um pipeline de processamento direto cego. A diferença é onde os erros aparecem: na tabela, onde uma correção custa segundos, em vez de no ERP, onde a mesma correção custa $75 mais uma conversa de acompanhamento.
O Que Esta Configuração Não Faz
Ser preciso sobre os limites da porta é parte do que a torna confiável. Três limites importam aqui.
A porta é uma etapa que você executa, não uma retenção no servidor em um webhook. Algumas plataformas de documentos permitem configurar uma condição de entrega que retém documentos abaixo de uma pontuação de confiança até que um humano os aprove em uma fila separada. ImageToTable.ai não se comporta dessa maneira: a revisão acontece dentro da tabela extraída, antes de você exportar ou chamar a API. Se seu fluxo de trabalho exigir um bloqueio técnico rígido no limite do webhook (nada chega ao próximo sistema até que exista um registro de aprovação), compare as duas arquiteturas em nossa página de comparação do Airparser antes de se comprometer.
A verificação de célula para fonte não é um julgamento comercial. A tela de revisão mostra de onde veio um valor, para que você possa confirmar que a extração corresponde ao documento. Ela não decide se o valor é aceitável, se a condição contratual é favorável ou se um pagamento deve ser aprovado. Para operações sob segregação de funções (o ambiente de controle SOX 404, ou qualquer estrutura de auditoria), a pessoa que verifica a extração deve continuar sendo uma pessoa diferente daquela que aprova o pagamento.
Uma etapa de revisão não substitui a QA do lado de saída. A porta captura erros de leitura contra a fonte. Ela não é um substituto para as verificações no nível da planilha que ocorrem antes que os dados entrem em qualquer sistema: alinhamento de colunas, contagem de linhas correspondente à contagem de arquivos e formatação de datas e números. Nossa lista de verificação de QA de 7 pontos para planilhas extraídas é uma camada separada que deve ficar ao lado de uma porta de revisão, não em vez dela.
Tornar a Porta um Processo, Não uma Esperança
As equipes que fazem isso corretamente tratam a etapa de revisão como uma parte programada do dia, não como algo que acontece quando alguém tem tempo. Atribua uma pessoa por lote, defina quais documentos ignoram a revisão completamente e concorde sobre o que acontece com um documento sinalizado que precisa de uma segunda opinião. A melhoria amplamente compartilhada da confiança acontece nos primeiros centenas de documentos: sua equipe constrói uma lista dos padrões de erro que a extração realmente produz no seu mix de documentos, e seus sinalizadores ficam mais precisos porque são baseados na observação, não em um limite genérico.
Essa é a medida honesta de uma implantação de extração. Uma afirmação única de "99% de precisão" não captura nenhuma realidade operacional; o que realmente ganha confiança é uma etapa humana definida olhando as linhas importantes antes que qualquer coisa se mova downstream.
Perguntas Frequentes
O ImageToTable.ai pode reter um documento antes que ele chegue ao meu software contábil?
Não no sentido de condição de webhook. A ferramenta extrae em uma tabela, e a porta de revisão é a etapa que você executa no modo de revisão antes de exportar ou contabilizar via API. Não há retenção automática que bloqueie a entrega com base em uma pontuação de confiança. Se você precisar desse controle exato no limite do sistema, uma plataforma com entrega sujeta a aprovação é a arquitetura para comparar com nossa página de alternativa ao Airparser.
Como sei quais linhas revisar sem uma pontuação de confiança?
Incorpore os sinais na própria tabela: classifique por valores ausentes, adicione uma coluna calculada que gere a diferença entre o total e a soma de suas linhas de item e procure identificadores duplicados ou valores fora do intervalo. O modo de revisão permite verificar exatamente essas células contra suas localizações de origem.
Preciso revisar todos os documentos de um lote?
Não. A intenção é que a maioria dos documentos passe em suas verificações sem serem tocados. Se sua taxa de exceção parecer menor do que o esperado, verifique se seus filtros não estão muito flexíveis; uma auditoria por amostragem das linhas que passam é uma boa salvaguarda e pode permanecer pequena depois que você conhecer o padrão de erro real dos seus documentos.
A tela de revisão funciona para cada arquivo que processo?
As localizações de origem são geradas por arquivo por meio de anotação bbox. Acione-a em um único arquivo quando necessário, ou habilite a autoanotação após o processamento para que lotes revisados já tenham seus destaques anexados.
E se meu revisor editar um valor e errar?
Cada célula editada mantiene o valor original da IA a um clique de distância, para que um revisor possa reverter sua própria alteração em vez de agravar um erro. Os erros são corrigíveis em ambas as direções.
Teste-o em seu próprio lote e veja se a revisão de linhas sinalizadas cabe nos minutos que você orçou. A porta é um pequeno hábito, e é a diferença entre dados de extração confiáveis e dados de extração importados com esperança.