人間によるレビューステップの位置づけ in a Document Extraction Workflow
ほとんどのドキュメント自動化スタックは、抽出とインポートを1つの動作として扱います。AIがドキュメントを読み取り、その結果が会計システム、データベース、またはwebhookに届きます。本番でこれを運用しているチームは、リスクのあるステップが抽出ではないことを知っています。それは、抽出されたテーブルとインポートの間の瞬間です。なぜなら、その瞬間は誰も見ていないからです。
そのギャップは測定可能です。買掛金では、平均の完全自動処理率は32.6%(Ardent Partners 2025)であり、これは請求書の約3分の2がサイクルのどこかで依然として何らかの人的タッチを受けていることを意味します。抽出を確実に維持しているチームは、通常同じ方法でそこに到達しました。つまり、出力を人がチェックする場所を事前に決定し、そのステップに人員を配置し、何かをインポートする前にそれをスケジュールしたのです。
重要なポイント
- 49.2%はベストインクラスの完全自動処理率であり、トップチームでさえ請求書の約半分を人に渡しています。
- フィールド別精度が95%でも、15フィールドの請求書が完全に正しく出力されるのは半分未満の時間です。
- レビューゲートは自動化の失敗の兆候ではなく、パイプラインを無人で実行しても安全にするものです。
自動化プロジェクトは通常、チームが達成したい数値から始まります。1日500件の請求書を処理する、銀行フィードを再入力なしで締める、すべての納品証明書をERPに読み込む。その後、抽出が有効になり、テーブルが埋まり、最初の実際の決定が現れます:このテーブルを誰が確認するのか、何かが下流に移動する前に? この記事では、その質問に明確な回答が必要な理由、レビューステップがドキュメント取り込みフローにどこに適合するか、そしてセルレベルのソースチェックがゲートをボトルネックにしないほど高速に保つ方法について説明します。
レビューステップがない場合のコスト
ゲートをスキップすると、抽出エラーは所有者のいないビジネスエラーになります。桁の入れ替えにより、請求書の合計が$2,470から$2,740に変わります。ベンダー名の一度の誤読は、支払いが誤ったアカウントに送られることを意味します。複数ページのセットが結合されると、2ページ目の明細行が誤ったドキュメントに配置されます。これらはそれぞれ、Ardent Partnersの2025年調査が例外としてフラグ付けする請求書の14%の中に含まれており、それぞれテーブル内で捕捉するのは安価ですが、転記後に修正するのは高価です。
コスト面は十分に文書化されています。IOFMは平均的な手動請求書タッチを12.5分とベンチマークし、各例外はその上に特別処理を15〜45分追加します。調査、修正、フォローアップを含めると、単一の請求書エラーの修正には2026年ドルで約$75かかり、照合に到達したエラーは元の請求書コストに25〜50%追加される可能性があります(IOFM; Ardent Partners 2025)。例外キューは高価な少数派です:例外は通常ドキュメント量の5〜15%ですが、総処理コストの30〜50%を占めます。なぜなら、すべての例外が熟練した人的注意を消費するからです。
これを経験している人々はそれを感覚で知っています。自動化された請求書抽出に関するr/Accountingのスレッドで、あるAP実務者は、ツールを1年間信頼した後にチームが構築したものを説明しました:「AIが支払条件を見逃したり、複数ページの請求書で明細行を混同したりし続けたので、3つの異なる検証レイヤーを設定する必要がありました...それでも誰かがすべての抽出を監視する必要があります」(r/Accounting)。そのストーリーが示すのは反応的なゲートです:人間は最初の不良インポートの後に追加されました。事前に設計された意図的なレビューステップがあれば、同じエラーをわずかなコストで捕捉できたはずです。
取り込みフローとゲートを配置できる場所
ドキュメント取り込みは、ほとんどの運用チームで共通の形をしています。ドキュメントが到着し(メール転送、コレクションリンク、共有フォルダ、アップロードページ)、抽出エンジンが各ドキュメントを読み取ってテーブルを生成します。そのテーブルはエクスポートまたは記録システム(Xero、QuickBooks、NetSuite、SQLデータベース、より広範な自動化へのwebhook)にプッシュされます。パイプラインには、レビューステップを配置できる4つの瞬間があります:
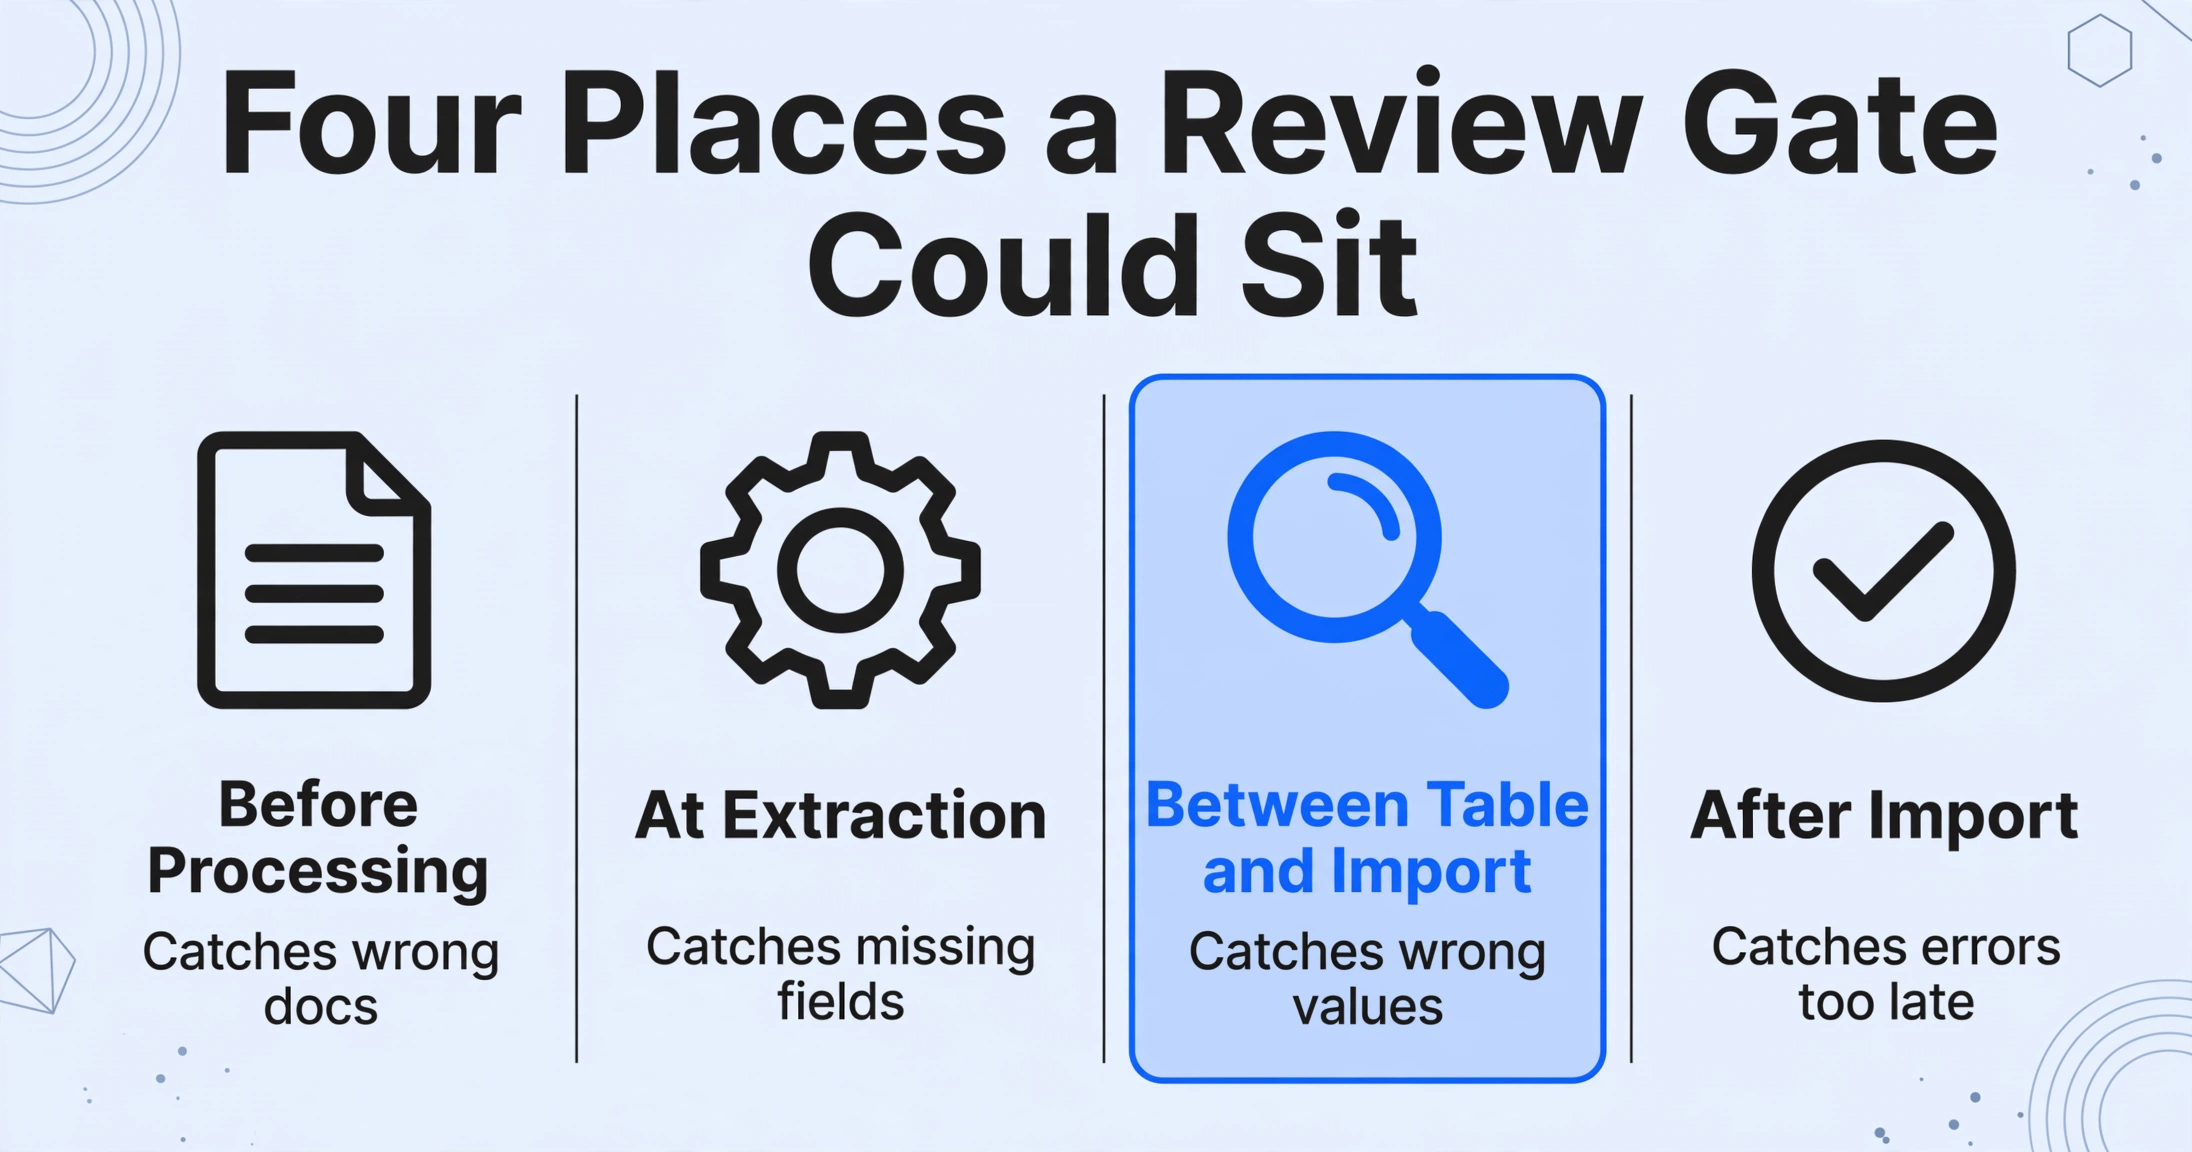
| ゲート位置 | 捕捉するもの | 見逃すもの |
|---|---|---|
| 処理前(キュー承認) | 誤ったドキュメント、取り込み時の重複 | 抽出値については何もない |
| 抽出時(検証ルール) | 欠落フィールド、整合しない合計 | 存在するが誤った値 |
| テーブルとインポートの間(人間によるレビュー) | 誤った、誤読された、または曖昧な値 | レビュー担当者が見ていないときのエラー |
| インポート後(転記監査) | コスト発生後に生き残ったエラー | 誰かが気づくまでのすべて |
3番目の位置は、ほとんどのチームが過小利用しているものです。検証ルールは構造的問題を捕捉しますが、抽出された金額がページに印刷された金額であるかどうかは判断できません。ソースに対する抽出値というこの比較は、人間が確認できる事実であり、テーブルとインポートの間のレビューステップがまさにそのためにあります。
100%完全自動処理が現実的な目標ではない理由
レビューゲートを設定することは、自動化が不完全であることを認めるように感じられます。正直な枠組みはその逆です。ゲートこそが、処理できるドキュメントに対して自動化を無人で安全に実行可能にするものです。完全自動処理とは、ドキュメントが人的タッチゼロで取り込み、抽出、検証、転記を完了することを意味します。同じArdent Partnersのデータセットによると、平均でわずか32.6%の請求書が完全自動処理され、ベストインクラスの数値は49.2%です(Ardent Partners 2025)。完全自動処理率に関するリファレンスページでは、計算式と、ベストインクラスのチームが依然として約半分のドキュメントに人的タッチポイントを残す理由を説明しています。
それらのドキュメントが存在するのには正当な理由があります。欠落フィールド(PO番号が請求書にない)は、抽出エンジンが発明できない欠如であり、誤読として扱ってもどこにもつながりません。手書き、低品質スキャン、ヨーロッパの日付形式は、文字レベルリーダーをつまずかせます。複数ページの請求書では、明細行が一貫性のない順序で結合されます。そしてフィールド別精度は複利のように効きます。フィールド別精度95%でも、15フィールドのドキュメントが完全に正しいのは半分未満の時間です(0.95の15乗)。そのため、ドキュメント全体がクリーンであるという期待は、モデルが非難されるずっと前に失敗します。ドキュメント自動化例外率データには、この背後にある独立した数値がまとめられています。
これらの数値から導かれる実用的なルールは分割キューです。抽出フィールドがチェックを通過したドキュメントは見ずに通過し、より小さなフラグ付きセットはインポート前に人間によるレビューを受けます。そのセットに含まれることは、自動化が「チェックして」と言ってその仕事をしていることを意味するだけであり、ドキュメントや抽出の品質については何も語りません。
実際に人間の目を必要とする行
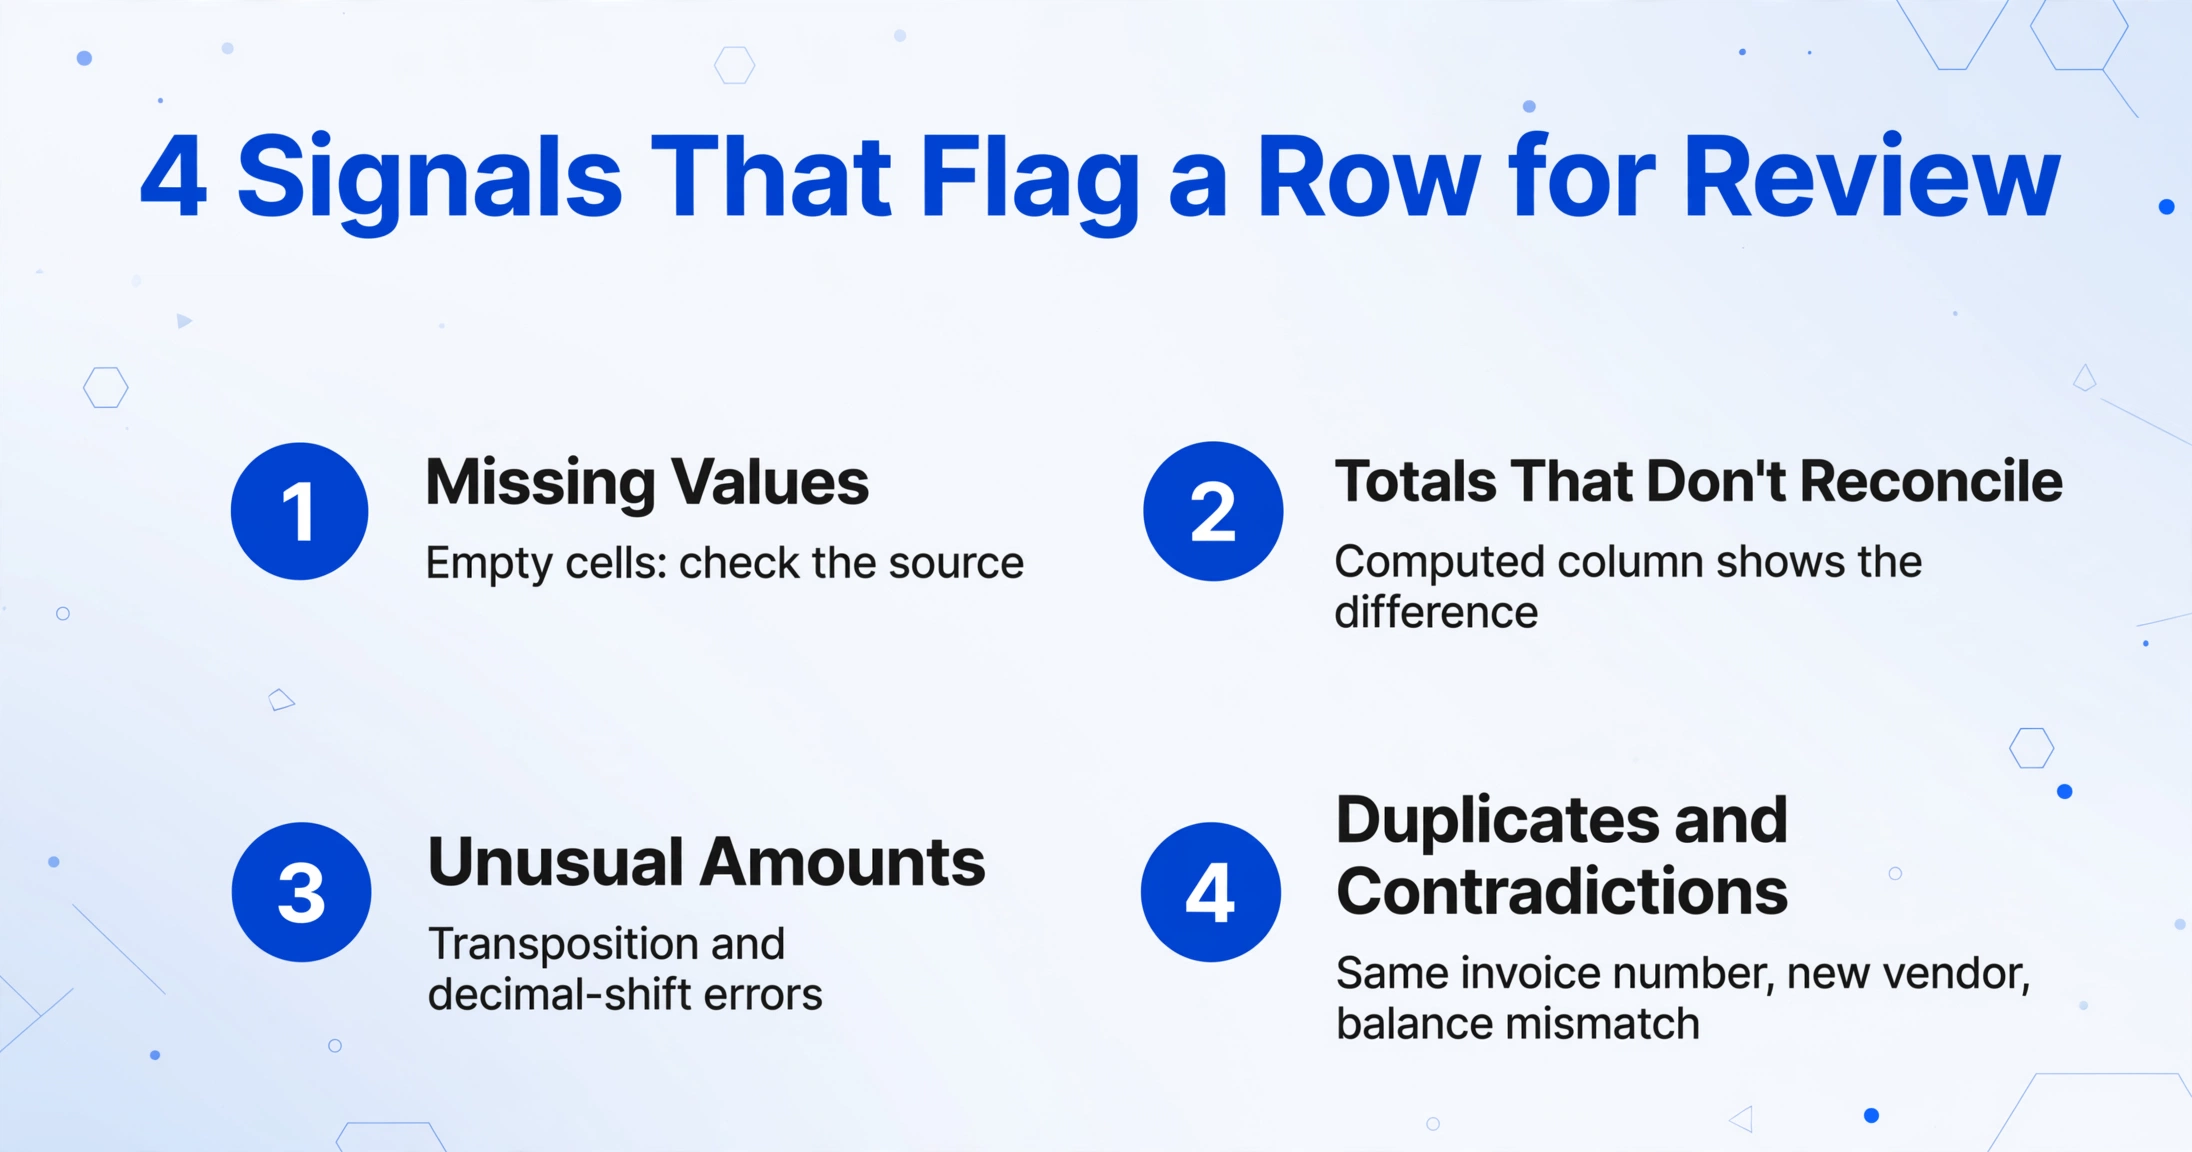
すべての行をレビューすることは、何もレビューしないのと同じくらい無駄です。設計上の問いは、どの行が最もリスクを負うかです。実際には、4つのシグナルタイプがレビューゲートが捕捉すべきもののほとんどをカバーします:
- 欠落値。 抽出が空で返したフィールド(請求書番号、日付、合計)。空セルでテーブルをソートし、ソースを確認します:フィールドが本当に存在しないか、エンジンが見逃した可能性があります。
- 整合しない値。 明細行の合計と一致しない合計。抽出ツールが計算列をサポートしている場合は、差分を検証列として出力し、差分がゼロでない行を確認します。
- 異常な金額。 ベンダーが通常請求する範囲外の値、または10倍ずれているように見える合計。これらは桁の入れ替えエラーと小数点ずれエラーです。
- 同一に動作すべきでない2つのドキュメント。 重複した請求書番号、以前に見たことのないベンダーアカウントへの支払い、または前期と矛盾する銀行明細残高。
これらのシグナルはすべてのセルを読むことを必要としません。最初にテーブルに適用するフィルターであり、それによって人間のステップを時間ではなく分に保てます。/ja/blog/verify-extraction-results-spot-checkでのターゲットを絞ったスポットチェックによる抽出結果の検証に関するガイドは、ランダムサンプリングが金額、日付、識別子に集中するエラーを見逃す理由を含め、サンプリングロジックを詳しく説明しています。
レビューステップの設定へのマッピング
ImageToTable.aiは、抽出された各セルを元のドキュメント上の取得元の場所にリンクすることでレビューをサポートします。これにより、テーブルとインポートの間のゲートが本番で実行するのに十分な速さになります。セットアップは4つのステップに分かれます。
バッチを1つのテーブルに抽出
必要な列に名前を付け(請求書番号、PO番号、合計、期日)、抽出エンジンがページ上の任意の場所で各値を見つけて埋めます。バッチアップロードはすべてのドキュメントを1つのスプレッドシートに結合するため、レビューゲートはファイルごとではなくセット全体で機能します。同じフローのAPIバージョンは、既存のダウンストリームシステムに直接フィードします。
バッチの自動アノテーションを有効にする
「処理後の自動アノテーションを有効にする」をオンにすると、すべての抽出がソース位置を添付して返されます。レビュー画面で任意のセルにホバーまたはクリックすると、元の画像がその値が読み取られた場所を正確にハイライトします。画像上の位置領域をクリックすると、一致するテーブルセルにジャンプします。
フラグ付き行をソースと照合して検証
リスクシグナルでソートします:空セル、計算列の差分、重複識別子。フラグ付きの各行について、セルをハイライトされたソース位置と照合します。値が間違っている場合はその場で編集します。ワンクリックでAIの元の値を表示し、編集が間違いだった場合に元に戻すことができます。
レビュー後にのみインポート
フラグ付き行がチェックされた場合のみ、レビュー済みテーブルをエクスポートするか、v1 APIを通じてプッシュします。ツール内の何も自動的に会計システムにデータを送信しません。インポートはゲートが閉じた後にトリガーするステップです。
このシーケンスは意図的に小さいものです。それ以外は盲目的な完全自動処理パイプラインと同一に見えるフローに、1つの設定(自動アノテーション)と1つの習慣(インポート前のチェック)を追加します。違いはエラーが表面化する場所です:テーブル内では修正に数秒かかりますが、ERP内では同じ修正に75ドルとフォローアップの会話がかかります。
このセットアップが行わないこと
ゲートの限界について正確であることは、ゲートを信頼できるものにするための一部です。ここでは3つの境界が重要です。
ゲートは実行するステップであり、webhookのサーバー側ホールドではありません。一部のドキュメントプラットフォームでは、信頼スコア未満のドキュメントを人間が別のキューで承認するまで保留する配信条件を設定できます。ImageToTable.aiはそのように動作しません。レビューは抽出されたテーブル内で、エクスポートまたはAPI呼び出しの前に行われます。ワークフローがwebhook境界でハードな技術的ブロック(承認レコードが存在するまで次のシステムに何も到達しない)を必要とする場合は、コミットする前に、当社のAirparser比較ページで2つのアーキテクチャを比較してください。
セルからソースへの検証はビジネス判断ではありません。レビュー画面は値の出所を示すため、抽出がドキュメントと一致することを確認できます。金額が許容可能かどうか、契約条件が有利かどうか、支払いを承認すべきかどうかを決定するものではありません。職務分離(SOX 404統制環境、またはあらゆる監査フレームワーク)の下での運用では、抽出を検証する人間は支払いを承認する人間とは別の人物であるべきです。
レビューステップは出力側QAを置き換えません。ゲートはソースに対する誤読を捕捉します。データがシステムに入る前に行われるスプレッドシートレベルのチェック(列の整列、行数がファイル数と一致すること、日付と数値の書式)の代わりにはなりません。当社の抽出されたスプレッドシートの7項目QAチェックリストは別のレイヤーであり、レビューゲートはその代わりではなく、並置されるべきです。
ゲートをプロセスにする、希望ではない
これを正しく行うチームは、レビューステップを1日の予定された一部として扱い、誰かに時間があるときに起こるものとはしません。バッチごとに1人を割り当て、どのドキュメントがレビューを完全にバイパスするかを定義し、セカンドオピニオンを必要とするフラグ付きドキュメントに何が起こるかに同意します。広く共有される信頼の向上は最初の数百のドキュメントで発生します。チームが抽出が実際にドキュメント構成で生成するエラーパターンのリストを作成し、フラグが観察に基づいてより鋭くなるため、一般的なしきい値に基づくものではありません。
それが抽出導入の正直な尺度です。単一の「99%正確」という主張は運用の現実をまったく捉えていません。実際に信頼を得るものは、何かがダウンストリームに移動する前に、重要度の高い行を見る定義された人間のステップです。
よくある質問
ImageToTable.aiはドキュメントが会計ソフトウェアに到達する前に保持できますか?
webhook条件の意味ではできません。ツールはテーブルに抽出し、レビューゲートはエクスポートまたはAPI経由で転記する前にレビューモードで実行するステップです。信頼スコアに基づいて配信をブロックする自動ホールドはありません。システム境界でその正確な制御が必要な場合は、承認ゲート付き配信を備えたプラットフォームが、Airparser代替ページと比較すべきアーキテクチャです。
信頼スコアなしでどの行をレビューするかをどうやって知るのですか?
シグナルをテーブル自体に組み込みます:欠落値でソートし、合計と明細行の合計の差を出力する計算列を追加し、重複識別子または範囲外の金額を探します。レビューモードでは、それらのセルをソース位置と正確に照合できます。
バッチ内のすべてのドキュメントをレビューする必要がありますか?
いいえ。意図はほとんどのドキュメントがチェックを通過して未処理のままであることです。例外率が予想より低い場合は、フィルターが緩すぎないか確認してください。通過行のサンプリング監査は良い安全策であり、ドキュメントの実際のエラーパターンがわかれば小さく保つことができます。
レビュー画面は処理するすべてのファイルで機能しますか?
ソース位置はbboxアノテーションを通じてファイルごとに生成されます。必要に応じて単一ファイルでトリガーするか、処理後の自動アノテーションを有効にして、レビュー済みバッチにハイライトが既に添付されるようにします。
レビュー担当者が値を編集して間違えた場合はどうなりますか?
編集されたすべてのセルはAIの元の値をワンクリックで保持するため、レビュー担当者は間違いを悪化させる代わりに自分の変更を元に戻せます。エラーは両方向で修正可能です。
自分のバッチでテストし、フラグ付き行のレビューが予算化した分数に収まるかどうかを確認してください。ゲートは小さな習慣であり、信頼される抽出データと希望を持ってインポートされる抽出データの違いです。