Warum KI in langen Rechtsdokumenten halluziniert
und wie Sie jedes Feld verifizieren
Allgemeine KI-Assistenten werden heute mit Kontextfenstern vermarktet, die groß genug sind, um eine 200-seitige Kreditvereinbarung aufzunehmen. Das Problem beginnt, wenn das Dokument länger ist als das Fenster – denn das Werkzeug greift dann zur Kompression, und eine Zusammenfassung eines Vertrags ist kein Vertrag. Ein Wert, der aus dieser Zusammenfassung fällt, kommt nicht leer zurück. Er kommt plausibel zurück.
Die Kluft zwischen „das Modell kann es lesen" und „dem Modell kann man vertrauen" ist messbar. Eine Evaluation des Stanford RegLab der führenden juristischen KI-Forschungstools, darunter Lexis+ AI und Westlaw's AI-Assisted Research, ergab, dass sie in 17 % bis 33 % der Anfragen weiterhin erfundene oder fehlverankerte Antworten lieferten – obwohl jeder Anbieter Retrieval als Heilmittel vermarktet (Stanford HAI). Diese Tools beantworten Fragen zum Recht. Der Mechanismus hinter ihren Fehlern ist derselbe, der ein aus Ihrem Vertrag extrahiertes Feld verfälscht.
Wichtigste Erkenntnisse
- Ein Kontextfenster, das groß genug ist, um eine 200-seitige Vereinbarung aufzunehmen, klingt so, als sei das Halluzinationsproblem gelöst – und jeder Anbieter vermarktet Retrieval als Heilmittel.
- Die führenden juristischen KI-Tools lieferten in einer Stanford-Evaluation in 17 % bis 33 % der Anfragen weiterhin erfundene oder fehlverankerte Antworten, denn ein Wert, der aus einem komprimierten Dokument fällt, liest sich exakt wie einer, den das Modell tatsächlich gelesen hat.
- Das erneute Lesen des Dokuments wird es nicht aufdecken. Verifizierung muss daher bedeuten, jede Zelle auf ihre Quelle zurückzuführen – genau das macht ImageToTable.ai im Review Mode.
Rechtsteams führen dieses Experiment bereits in großem Umfang durch. In der ILTA-Technologieumfrage 2024 gaben 37 % der Kanzleien an, generative KI für geschäftliche Aufgaben einzusetzen – 22 Prozentpunkte mehr als im Vorjahr. Die am häufigsten genannten Einsatzbereiche waren Recherche (73 %), Zusammenfassung (70 %) und erste Entwürfe (69 %) (ILTA). Zusammenfassung ist genau die Operation, die das Problem erzeugt, um das es in diesem Artikel geht. Hier entsteht der erfundene Wert, welche Felder er zuerst trifft und was „jedes Feld prüfen" tatsächlich bedeuten muss, wenn das Dokument zu lang ist, um es in einem Durchgang zu lesen.
Woher ein erfundener Wert kommt
Ein halluziniertes Feld ist ein Wert, den das Modell nie gelesen hat, sondern aus dem rekonstruiert hat, was an dieser Stelle üblicherweise steht – und es wird mit derselben Sicherheit ausgegeben wie ein Wert, den es tatsächlich gelesen hat. Bittet man einen Assistenten, die Haftungsobergrenze, die Kündigungsfrist und das anwendbare Recht aus einer 180-seitigen Vereinbarung zu ziehen, liefert er eine saubere Zeile zurück. Die Obergrenze sieht aus wie eine Obergrenze. Die Kündigungsfrist ist eine runde Zahl. Das anwendbare Recht ist das, was bei solchen Deals üblicherweise gewählt wird. Nichts davon beweist, dass die Werte auf der Seite stehen, denn ein Modell, das die Quelle aus den Augen verloren hat, weiß nicht, dass es sie aus den Augen verloren hat.
Käufer sind genau deshalb bereits verunsichert. In einem r/legaltech-Thread zur Due-Diligence-Prüfung von KI-Anbietern beschrieb ein Kommentator, dass er nach Belegen gefragt und keine erhalten habe: „Die Anbieter behaupten ‚99 % Genauigkeit', aber wenn wir im Rahmen der Due Diligence um Nachweise bitten, sagen sie im Grunde: ‚Testen Sie es selbst.'" (r/legaltech). Die Beschwerde ist nicht, dass die Tools nutzlos sind. Es ist, dass die Prüflast beim Käufer liegt, ohne dass er etwas zum Abgleichen hätte. Der Rest dieses Artikels dreht sich darum, diese Last in eine Prüfung zu verwandeln, die Sie tatsächlich durchführen können.
Wie ein langes Rechtsdokument tatsächlich verarbeitet wird
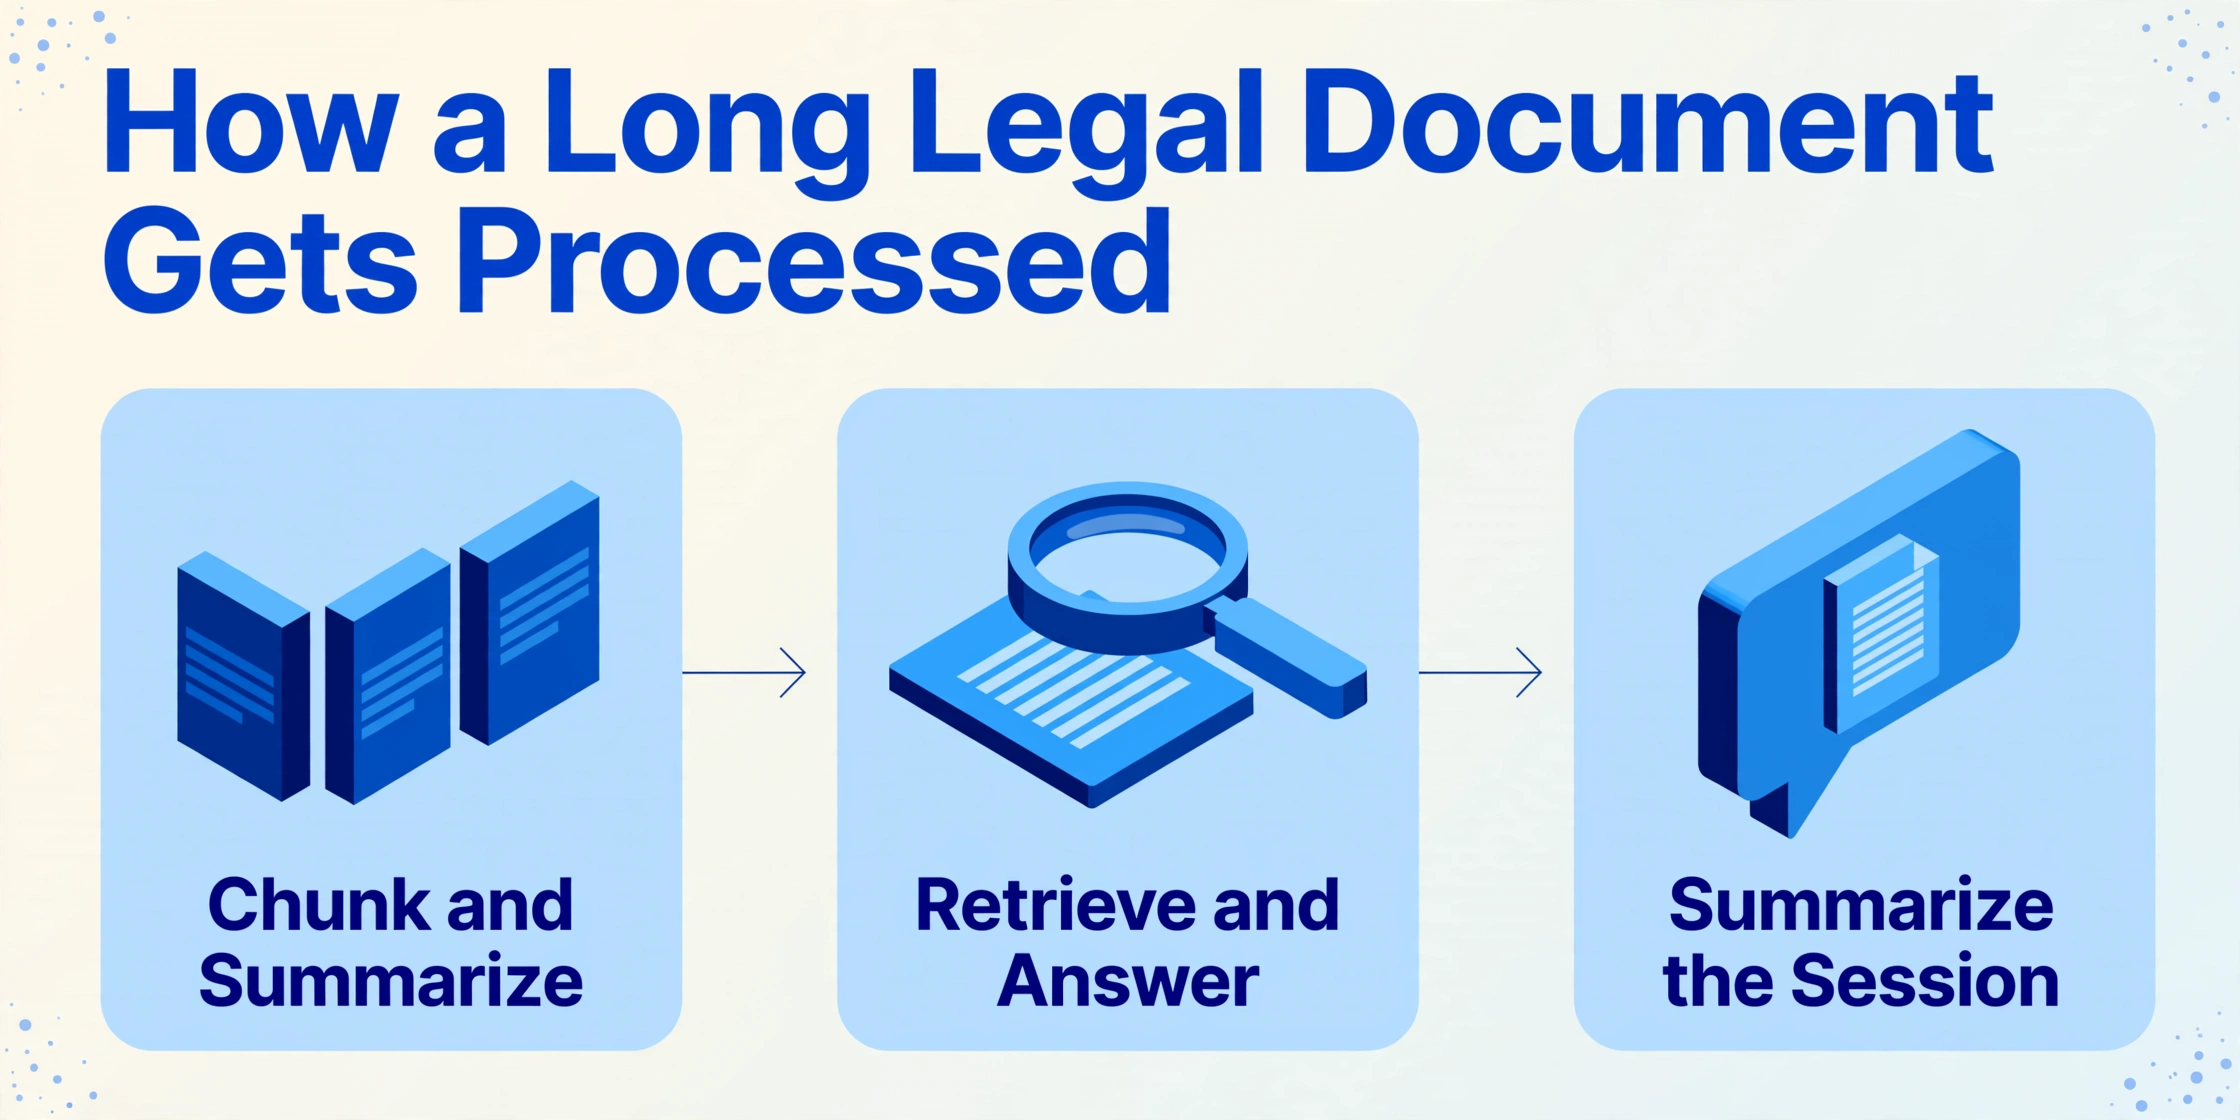
Ein Tool, das behauptet, ein 400-seitiges Dokument lesen zu können, beschreibt in der Regel eine Pipeline aus kleineren Lesevorgängen, die wieder zusammengesetzt werden – und genau an diesen Verbindungsstellen verändern sich Werte. Ein Modell liest nicht wie Sie. Text wird in Tokens zerlegt und in ein Kontextfenster eingefügt, die feste Textmenge, die das Modell gleichzeitig speichern und berücksichtigen kann. Wenn ein Dokument länger ist als dieses Fenster, greift das System auf einen von drei Workarounds zurück, und jeder davon ersetzt das vollständige Dokument durch eine kleinere Stellvertreterversion.
Chunk und zusammenfassen
Das Dokument wird in Abschnitte zerlegt, jeder Abschnitt wird zusammengefasst, und die Zusammenfassungen werden kombiniert. Feldwerte werden dann aus den Zusammenfassungen gezogen, nicht aus den Seiten, aus denen sie stammen.
Abrufen und beantworten
Das Dokument wird indexiert, und nur die Passagen, die für jedes Feld relevant erscheinen, werden abgerufen, um die Antwort zu erstellen. Das bedeutet Retrieval-Augmented Generation, kurz RAG, in der Praxis. Wenn die richtige Passage nicht abgerufen wird, antwortet das Modell ohne sie.
Sitzung zusammenfassen
Chat-basierte Assistenten fügen einen Pfad hinzu, der leicht übersehen wird. Wenn eine lange Sitzung das Kontextfenster füllt, fassen einige Tools die frühere Konversation zusammen und machen weiter. Für einen Chat ist das vertretbar. Bei einem Dokument, hinter dem Sie stehen müssen, ist die Zusammenfassung nun das, woraus das Tool seine Schlüsse zieht.
Keiner dieser Schritte ist ein Fehler. Sie sind die einzige Möglichkeit, lange Dokumente überhaupt zu verarbeiten. Der Punkt ist: Sobald einer davon aktiv ist, liest das Tool nicht mehr Ihren Vertrag. Es liest etwas Kleineres, das als Stellvertreter dient, und in den Lücken dieses Stellvertreters entstehen erfundene Werte. Die Grenzen des Lesens langer Dokumente werden ausführlicher in unserem Leitfaden zu den Fähigkeiten und Grenzen von KI bei mehrseitigen PDFs behandelt. Wenn Sie neu in der Kategorie sind, legt unser Erklärstück zu dem, was Vertragsdaten-Extraktion tatsächlich ist die Grundlage, bevor wir uns den Fehlermodi zuwenden.
Warum Kompression plausible Fehler erzeugt, keine zufälligen
Wenn ein Wert in der komprimierten Ansicht fehlt, hinterlässt das Modell keine Lücke. Es füllt die Stelle mit dem wahrscheinlichsten Wert für diese Art von Dokument – genau die Art von Fehler, die einem aufmerksamen Leser nicht auffällt. Forscher nennen dieses Muster Detail-Halluzination: Die Ausgabe bleibt in der Struktur weitgehend korrekt, während sie stillschweigend die Parameter korrumpiert, die über Ergebnisse entscheiden – darunter Schwellenwerte, Einheiten, Umfang, die Stärke einer Verpflichtung („shall" gegenüber „should") und die Bedingungen, die sie auslösen. Eine Studie zu langen Regulierungsdokumenten ergab, dass diese Detailtreue mit wachsendem Kontext nachlässt, wobei die Fehlerrate von 0,22 bei kurzen Eingaben auf 0,36 bei langen Eingaben ansteigt – eine Verschlechterung um 64 % (arXiv).
In der juristischen Arbeit sind das keine kosmetischen Fehler. „Shall" gegenüber „should" entscheidet darüber, ob eine Pflicht verbindlich ist. Ein weggelassener Zusatz wie „sofern nicht in Abschnitt 4.2 vorgesehen" macht aus einer engen Ausnahme eine allgemeine Regel. Ein ersetzter Höchstbetrag verändert das Risiko des Mandanten. Jeder dieser Fehler besteht die Prüfung, die er bekommt, weil jeder wie ein echter Wert aussieht. Die Stanford-Evaluierung zieht hier eine Grenze, die es wert ist, übernommen zu werden: Ein extrahierter Wert kann erfunden sein (er steht gar nicht im Dokument) oder fehlverankert (der Text existiert, sagt aber nicht das, was das Tool behauptet). Der zweite Fall ist schwerer zu erkennen, weil die Quelle echt ist und das Feld verankert wirkt.
Die Felder, die Kompression zuerst zerstört
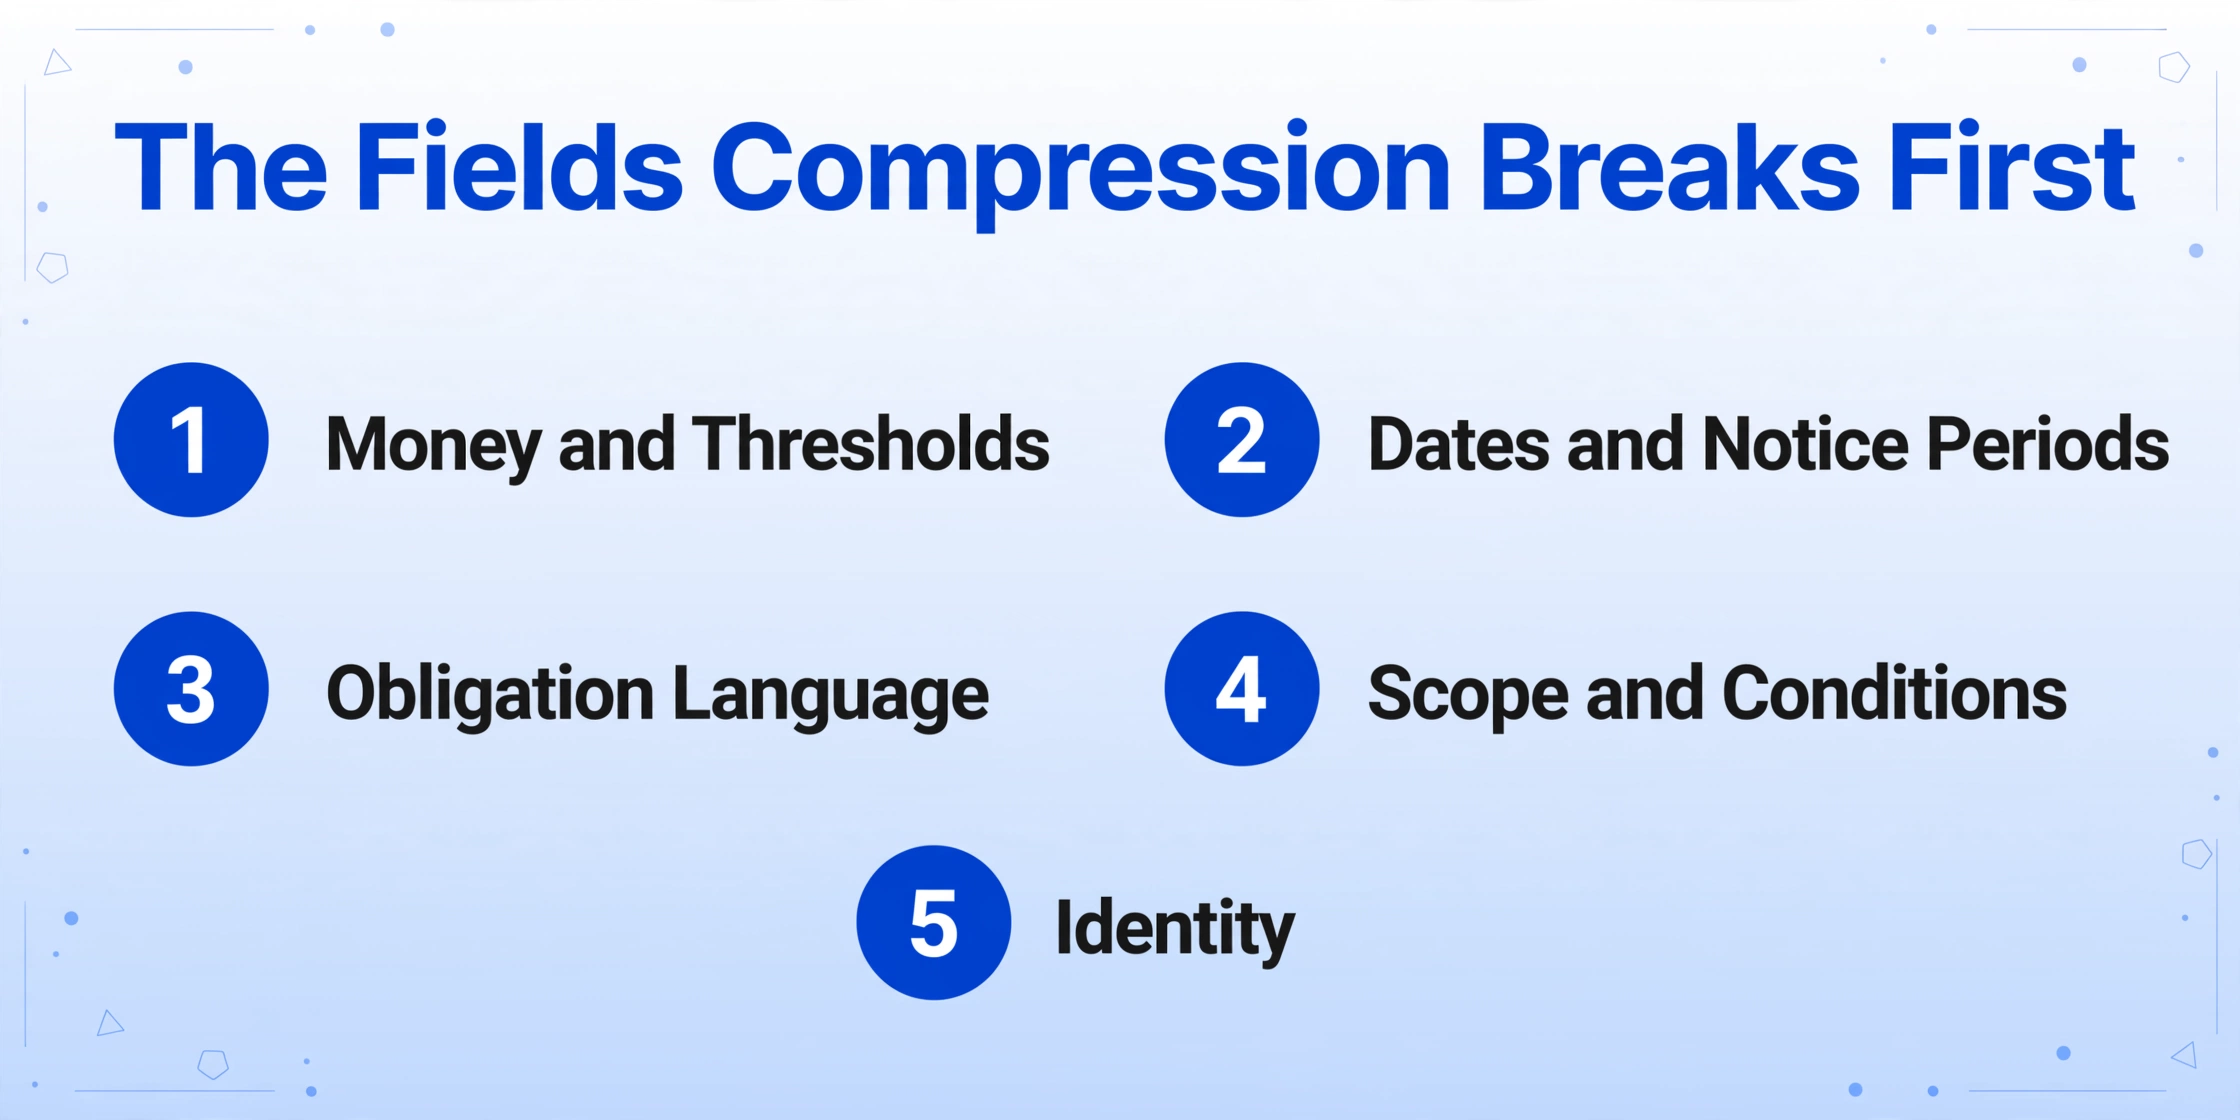
Kompression schädigt nicht jedes Feld gleichermaßen. Die Felder, die am wahrscheinlichsten falsch zurückkommen, sind diejenigen, bei denen ein plausibler Ersatz leicht zu erzeugen und mit dem Auge schwer zu erkennen ist. Das ist in Rechtsdokumenten eine kleine, vorhersehbare Gruppe.
| Feldtyp | Was die Kompression damit macht | Woran Sie prüfen sollten |
|---|---|---|
| Geldbeträge und Schwellenwerte (Haftungsobergrenze, Gebühr, Prozentsatz) | Füllt mit einem üblichen runden Wert auf oder verschiebt eine Ziffer; die Vorgabe des Modells für den Klauseltyp kann die Seite überstimmen | Die exakte Klausel und Zahl, Zeichen für Zeichen |
| Daten und Kündigungsfristen | Zieht Wirksamkeitsdatum, Änderungsdatum und Unterzeichnungsdatum zu einem zusammen | Welchen Meilenstein das Datum markiert und ob ein späteres Dokument es geändert hat |
| Verpflichtungssprache | Verliert „muss“ gegenüber „sollte“ und entfernt Ausnahmeregelungen | Den vollständigen Satz, einschließlich des Einschränkungsteils nach dem Komma |
| Geltungsbereich und Bedingungen („innerhalb von 50 Meilen“, „sofern nicht anders vorgesehen“) | Entfernt die Bedingung, die die Klausel einschränkt | Die Bedingungsklausel, nicht nur den Schlagwortbegriff |
| Identität (anzuwendendes Recht, Vertragspartner, Parteienrolle) | Standardisiert auf die Rechtsordnung oder den Namen, den das Modell am häufigsten gesehen hat | Die Präambel und die Rechtswahlklausel, wie sie geschrieben stehen |
Beachten Sie, was diese Felder gemeinsam haben. Jedes hat einen korrekten Wert, der langweilig ist, und einen falschen Wert, der ebenfalls langweilig ist. Deshalb überstehen sie einen schnellen Überblick. Und genau deshalb ist die Reihenfolge Ihrer Prüfungen wichtig: Beginnen Sie mit den numerischen Feldern und den Verpflichtungsfeldern, denn deren Fehler erzeugen ein Risiko.
Änderungen und Redlines verdienen eine eigene Durchsicht. Eine überholte Zahl kann auf einer gescannten unterzeichneten Kopie gut lesbar bleiben, und ein Modell, das nur eine Teilansicht hat, kann zuverlässig nicht wissen, welche Version maßgeblich ist. In einem Rechtsdokument erscheint dasselbe Feld berechtigterweise mehrfach, und wiederholte Vorkommen mit unterschiedlichen Werten sind genau das, womit die Kompression am schlechtesten umgeht.
Was „Jedes Feld überprüfen" tatsächlich erfordert
In einem langen Dokument bedeutet das Überprüfen jedes Feldes, jeden extrahierten Wert zurück an eine bestimmte Stelle in der Quelle zu verweisen, sodass ein falscher Wert dadurch auffällt, wohin er zeigt, und nicht dadurch, ob er sich gut liest. Das Dokument erneut zu lesen, macht den Zweck des Tools zunichte, und erneutes Lesen ist auch der Weg, auf dem ein fehlverankerter Wert durchrutscht, weil der Wert, der den Text ersetzt hat, genauso überzeugend aussieht wie der Text. Zwei Dinge müssen zutreffen, bevor diese Art der Überprüfung möglich ist: Sie wissen genau, welche Felder Sie wollten, und das Tool kann Ihnen zeigen, woher jedes einzelne stammt.
Benennen Sie die Felder, bevor Sie verarbeiten
Statt das Dokument über Ihre Spalten entscheiden zu lassen, geben Sie die benötigten Felder ein: „Liability Cap", „Notice Period", „Governing Law", „Effective Date". Das bedeutet Custom Column Extraction: Die KI liest das Dokument und findet jeden Wert über seine Bedeutung, nicht über eine feste Position auf der Seite, und die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle. Der Verifikationswert liegt darin, dass der Prüfumfang im Voraus festgelegt ist. Sie prüfen nicht alle 180 Seiten, sondern nur die von Ihnen benannten Felder.
Verlangen Sie eine Quellenposition für jede Zelle
Review Mode zeigt Ihnen, woher ein Wert stammt. Fahren Sie mit der Maus über eine extrahierte Zelle oder klicken Sie sie an, und der passende Bereich wird auf der Originalseite hervorgehoben; klicken Sie auf einen Bereich auf der Seite, und es springt zurück zur passenden Zelle. Wenn Sie ein Feld bearbeiten, behält das Tool den ursprünglichen KI-Wert, damit Sie vergleichen oder zurücksetzen können. In einem langen Dokument wird „Jedes Feld überprüfen" so von einer Absicht zu einer Handlung: Sie lesen nicht erneut, sondern bestätigen, dass der Wert dort sitzt, wo er vorgibt zu sitzen.
Aktivieren Sie die Karte, bevor Sie sie brauchen
Quellenpositionen können bei Bedarf für eine einzelne Datei erzeugt werden, oder das Konto kann so eingestellt werden, dass jedes verarbeitete Dokument automatisch annotiert wird. Die nachträgliche Erzeugung bedeutet, dass die Prüfdatei bereit ist, sobald die Extraktion abgeschlossen ist – wichtig, wenn Geschwindigkeit der Grund ist, warum Sie den Schritt überhaupt automatisiert haben.
Arbeiten Sie in Risikoreihenfolge
Klären Sie zuerst die numerischen, verpflichtenden und versionssensiblen Felder anhand der obigen Tabelle. Sobald diese stimmen, lassen sich die restlichen Metadaten schneller freigeben. Ein Verifikationsdurchlauf, der mit Namen und Daten beginnt, verbraucht Aufmerksamkeit, bevor er die Felder erreicht, die das Risiko tragen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die umfassendere Prüfroutine – einschließlich Spaltenausrichtung, Zeilenanzahl, Prüfung auf fehlende Felder, Zahlen- und Datumsvalidierung sowie der Frage, wann eine Neuextraktion statt einer manuellen Korrektur sinnvoll ist – ist in unserer Checkliste zur Extraktions-QA in sieben Punkten beschrieben. Wo ein Review-Gate in eine Pipeline gehört, behandelt der Human-in-the-Loop-Workflow. Und wenn die Prüfung mehrere Dokumente gleichzeitig umfasst, zeigt der Leitfaden zur dokumentübergreifenden Konsistenz, wie man sie auf einem Blatt vergleicht. Was all diesen Ansätzen zugrunde liegt – und was die Kompression dringlich macht – ist, dass sich jeder Wert auf seine Quelle zurückführen lässt.
Was diese Verifizierung weiterhin nicht leisten kann
Die Quellenverankerung zeigt Ihnen, woher ein Wert stammt. Sie sagt Ihnen nicht, ob die Klausel durchsetzbar ist, ob sie eine spätere Änderung übersteht oder was der Mandant dagegen tun sollte – und kein Extraktionstool ändert das. Eine Quellenangabe ist ein Beleg, keine rechtliche Schlussfolgerung. Das Tool kann zeigen, dass „90 Tage" in Abschnitt 12.3 steht. Es kann Ihnen nicht sagen, ob diese Kündigungsfrist nach dem Side Letter, den Sie nicht hochgeladen haben, weiterhin gilt.
Manche Fehler liegen vollständig außerhalb des Tools. Wenn die maßgebliche Zahl in einer Anlage, einer früheren Änderung oder einem Side Letter steht, der nie hochgeladen wurde, wird keine Quellenverankerung sie finden – denn sie ist nicht da, um gefunden zu werden. Senden Sie das vollständige Paket, und wenn dieselbe Vereinbarung als mehrere Dateien eintrifft, fassen Sie die Teile vor der Prüfung zu einem Datensatz zusammen. Wenn die Quelle selbst ein schlechter Scan ist, erbt jede darüberliegende Ebene das Problem – deshalb beginnt eine saubere Erfassung mit guter OCR; Rechtsdokumente haben eigene Anforderungen, die in unserem Leitfaden zur OCR für Rechtsdokumente behandelt werden. Und eine Leerstelle ist kein Fehler. Ein Feld, das als „nicht vorhanden" gemeldet wird, ist sicherer als ein plausibler Wert, der erfunden wurde, um die Zeile zu füllen – denn es sagt der nächsten Person, sie solle ins Dokument schauen, statt der Tabelle zu vertrauen.
Die Pflicht geht auch nicht auf das Tool über. ABA Model Rule 1.1, Comment 8, verortet Nutzen und Risiken relevanter Technologie innerhalb der beruflichen Sorgfaltspflicht eines Anwalts, und etwa 40 US-Gerichtsbarkeiten haben eine Version dieser Formulierung übernommen (ABA). Praktiker verstehen es genauso: „KI entbindet mich nicht von meiner Verantwortung als Anwalt. Wenn ein Fall mit Ihrem Namen versehen wird, finden Sie das Zitat. Lesen Sie es." (r/legaltech). Beim Vergleich von Tools ist die Frage, die einen Review-tauglichen Extraktor von einer Blackbox unterscheidet, ob er für jedes Feld eine Quellenangabe liefert. Ein Tool, das nur eine saubere Tabelle zurückgibt, bietet Ihnen nichts zum Prüfen – das sollten Sie im Hinterkopf behalten, wenn Sie E-Discovery-Plattformen gegen Feldextraktion abwägen oder Dokumentextraktionsoptionen für ein kleines Anwaltsteam bewerten.
Häufig gestellte Fragen
Warum halluzinieren KI-Tools bei langen Rechtsdokumenten häufiger als bei kurzen?
Weil ein langes Dokument die Textmenge überschreitet, die ein Modell gleichzeitig halten kann, sodass das System zusammenfasst oder abruft, statt das Ganze zu lesen. Jeder Wert, der in dieser komprimierten Ansicht fehlt, wird aus dem rekonstruiert, was üblicherweise an dieser Stelle erscheint. Forschung zu Langkontext-Dokumenten hat ergeben, dass die Detailgenauigkeit bei wachsendem Input schneller abnimmt als die Gesamtgenauigkeit.
Löst ein größeres Kontextfenster das Problem?
Es erhöht die Schwelle, beseitigt sie aber nicht. Dokumente können das Fenster weiterhin überschreiten, Chat-Assistenten fassen älteren Text weiterhin zusammen, um fortzufahren, und das Modellverhalten verschlechtert sich mit wachsendem Kontext, noch bevor das Limit erreicht ist. Behandeln Sie ein großes Fenster als Spielraum, nicht als Garantie.
Kann ich einfach die wichtigen Felder prüfen und den Rest überspringen?
Wählen Sie die Felder nach Risiko aus, statt alles oder nichts zu prüfen. Zahlen, Verpflichtungssprache und versionssensitive Felder wie Wirksamkeitsdatum gegenüber Änderungsdatum verdienen die genaue Prüfung; risikoarme Metadaten lassen sich schneller abhaken. Die Entscheidung, welche Felder wichtig sind, sollte im Voraus getroffen und schriftlich festgehalten werden, nicht dem Tool überlassen bleiben.
Wie prüfe ich einen extrahierten Vertragswert, ohne den ganzen Vertrag zu lesen?
Nutzen Sie Quellenverankerung. Lassen Sie sich vom Tool die Position jedes Werts auf der Originalseite anzeigen und bestätigen Sie dann, dass der Wert dort steht, wo er behauptet wird, statt das Dokument erneut zu lesen. Auf ImageToTable.ai hebt der Review Mode die Quellenregion für jede extrahierte Zelle hervor, und Dokumente können so eingestellt werden, dass sie nach der Verarbeitung automatisch annotiert werden.
Ist die KI-Vertragsextraktion genau genug, um ohne Prüfung verwendet zu werden?
Kein Tool, auch unseres nicht, macht die Prüfung der Feldausgabe bei Dokumenten mit rechtlicher oder finanzieller Tragweite überflüssig. Unsere Extraktion erreicht bis zu 99 % Genauigkeit bei gedruckten Tabellendaten, und der verantwortungsvolle Workflow bestätigt die risikoreichen Felder dennoch gegen die Quelle. Behandeln Sie jede „halluzinationsfreie" Behauptung eines Anbieters mit derselben Skepsis, die Sie einer Genauigkeitsangabe ohne dahinterstehendes Zitat entgegenbringen würden.
Was soll ich tun, wenn ein Feld leer zurückkommt?
Prüfen Sie, ob die Klausel tatsächlich fehlt, und lassen Sie das Feld in diesem Fall leer. Ein leeres Feld, das als „nicht vorhanden“ markiert ist, ist nützlicher als ein plausibler Wert, der nur erfunden wurde, um die Zeile zu füllen, denn es sagt der nächsten Person im Workflow, dass sie das Dokument prüfen soll, statt der Tabelle zu vertrauen.
Der Test, der zählt
Das entscheidende Maß für einen KI-Workflow im Rechtsbereich ist nicht, wie gut die Tabelle beim ersten Durchlauf aussieht. Entscheidend ist, ob Sie jede Zelle in dieser Tabelle nehmen und in einem einzigen Schritt genau zeigen können, wo auf der Seite sie herkommt. Kompression macht diesen Schritt notwendig, denn jeder Workaround für lange Dokumente ersetzt den Vertrag durch einen kleineren Stellvertreter. Quellenverankerung macht ihn möglich. Beginnen Sie mit dem Feld, bei dem Sie am wenigsten falsch liegen möchten, und prüfen Sie, ob das Tool Sie dorthin führen kann.
Wählen Sie einen Vertrag, den Sie bereits gut kennen, extrahieren Sie die vier Felder, bei denen Sie keine Fehler riskieren möchten, und prüfen Sie jedes gegen seine Quellenposition. Dieser einzige Durchlauf verrät Ihnen mehr über ein Tool als jede Genauigkeitsangabe auf der Marketingseite.