Por qué la IA alucina en documentos legales extensos
y cómo verificar cada campo
Los asistentes de IA de uso general ahora se venden con ventanas de contexto lo bastante grandes como para contener un contrato de crédito de 200 páginas. El problema comienza cuando el documento es más largo que la ventana, porque la solución que la herramienta adopta es resumir, y un resumen de un contrato no es un contrato. Un valor que se desprende de ese resumen no vuelve en blanco. Vuelve con apariencia de plausible.
La brecha entre "el modelo puede leerlo" y "se puede confiar en el modelo" es medible. Una evaluación de Stanford RegLab de las principales herramientas de investigación legal con IA, incluidas Lexis+ AI y AI-Assisted Research de Westlaw, encontró que seguían devolviendo respuestas fabricadas o mal fundamentadas en el 17% al 33% de las consultas, aunque todos los proveedores comercializan la recuperación como la cura (Stanford HAI). Esas herramientas responden preguntas sobre la ley. El mecanismo detrás de sus errores es el mismo que corrompe un campo extraído de su contrato.
Conclusiones clave
- Una ventana de contexto lo bastante grande como para contener un acuerdo de 200 páginas parece resolver el problema de la alucinación, y todos los proveedores comercializan la recuperación como la cura.
- Las principales herramientas legales con IA seguían devolviendo respuestas fabricadas o mal fundamentadas en el 17% al 33% de las consultas en una evaluación de Stanford, porque un valor que se desprende de un documento comprimido se lee exactamente igual que uno que el modelo realmente leyó.
- Volver a leer el documento no bastará para detectarlo, así que la verificación tiene que consistir en señalar cada celda de vuelta a su fuente, algo que ImageToTable.ai hace en Review Mode.
Los equipos legales ya están ejecutando este experimento a escala. En la Encuesta Tecnológica 2024 de ILTA, el 37% de los despachos informó usar IA generativa para tareas de negocio, 22 puntos más que el año anterior, y los usos principales que mencionaron fueron investigación (73%), resumen (70%) y primeros borradores (69%) (ILTA). El resumen es exactamente la operación que crea el problema del que trata este artículo. Aquí es donde nace el valor fabricado, qué campos afecta primero y qué debe significar realmente "verificar cada campo" cuando el documento es demasiado largo para leerlo de una sola pasada.
De dónde proviene un valor fabricado
Un campo alucinado es un valor que el modelo nunca leyó, reconstruido a partir de lo que suele aparecer en esa posición y devuelto con la misma confianza que un valor que sí leyó. Pida a un asistente que extraiga el límite de responsabilidad, el período de preaviso y la ley aplicable de un acuerdo de 180 páginas, y le devolverá una fila limpia. El límite parece un límite. El período de preaviso es un número redondo. La ley aplicable es la que este tipo de acuerdos suele elegir. Nada de eso demuestra que los valores estén en la página, porque un modelo que ha perdido de vista la fuente no sabe que la ha perdido.
Los compradores ya están inquietos precisamente por esto. En un hilo de r/legaltech sobre la diligencia debida de proveedores de IA, un revisor describió haber pedido evidencia y no haber recibido ninguna: "Los proveedores afirman tener '99% de precisión', pero cuando pedimos pruebas durante la diligencia debida, básicamente dicen: 'Pruébelo usted mismo'." (r/legaltech). La queja no es que las herramientas sean inútiles. Es que la carga de verificación recae sobre el comprador sin nada contra qué verificar. El resto de este artículo trata sobre convertir esa carga en una comprobación que realmente pueda ejecutar.
Cómo se procesa realmente un documento legal extenso
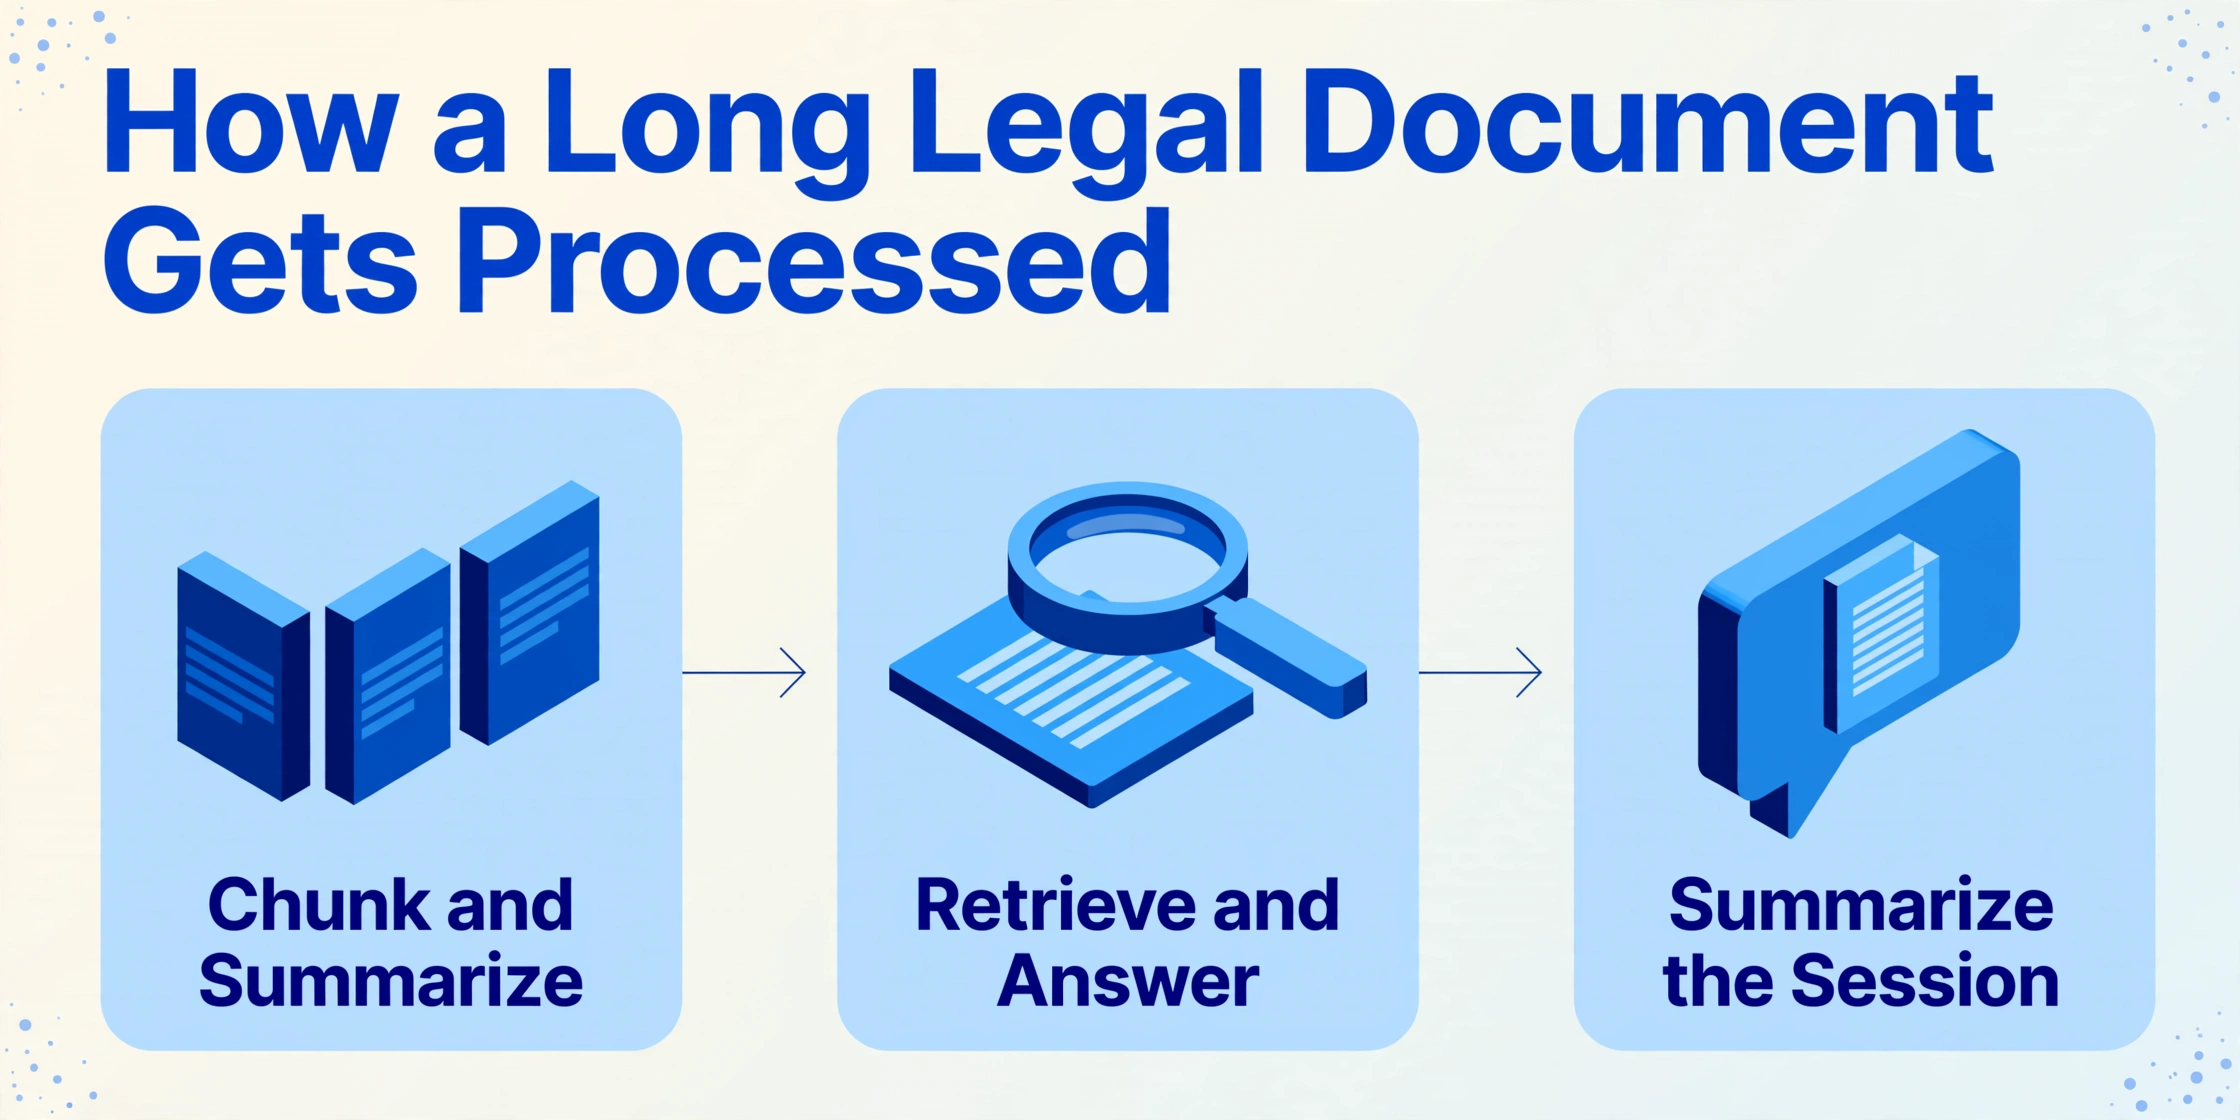
Una herramienta que dice poder leer un documento de 400 páginas suele estar describiendo un proceso de lecturas más pequeñas unidas entre sí, y es en esa unión donde los valores cambian. Un modelo no lee como usted. El texto se divide en tokens y se coloca en una ventana de contexto, la cantidad fija de texto que el modelo puede contener y considerar a la vez. Cuando un documento es más largo que esa ventana, el sistema recurre a una de tres soluciones, y cada una de ellas sustituye el documento completo por un sustituto más pequeño.
Dividir y resumir
El documento se divide en fragmentos, cada fragmento se resume y los resúmenes se combinan. Los valores de los campos se extraen entonces de los resúmenes, no de las páginas de las que provienen.
Recuperar y responder
El documento se indexa y solo se recuperan los pasajes que parecen relevantes para cada campo para construir la respuesta. Esto es lo que significa en la práctica la generación aumentada por recuperación, o RAG. Si el pasaje correcto no se recupera, el modelo responde sin él.
Resumir la sesión
Los asistentes tipo chat añaden una vía que es fácil pasar por alto. Cuando una sesión larga llena la ventana de contexto, algunas herramientas resumen la conversación anterior y continúan. Para un chat, eso es razonable. Para un documento del que usted debe responder, el resumen es ahora aquello desde lo que la herramienta razona.
Ninguno de estos pasos es un error. Así es como se manejan los documentos extensos en absoluto. El punto es que, una vez que cualquiera de ellos está en juego, la herramienta ya no está leyendo su contrato. Está leyendo algo más pequeño que lo representa, y los vacíos en ese sustituto son donde entran los valores fabricados. Los límites de la lectura de documentos extensos se tratan con más profundidad en nuestra guía sobre lo que la IA puede y no puede hacer con PDF de varias páginas. Si es nuevo en la categoría, nuestro explicador sobre qué es realmente la extracción de datos de contratos establece la base antes de los modos de fallo.
Por qué la compresión produce errores plausibles, no aleatorios
Cuando falta un valor en la vista comprimida, el modelo no deja un espacio en blanco. Rellena el hueco con el valor más probable para ese tipo de documento, que es exactamente el tipo de error que un lector atento no notará. Los investigadores llaman a este patrón alucinación de detalle: la salida se mantiene ampliamente correcta en estructura mientras corrompe silenciosamente los parámetros que deciden los resultados, incluidos los números umbral, las unidades, el alcance, la fuerza de una obligación ("shall" frente a "should") y las condiciones que la activan. Un estudio de documentos regulatorios extensos encontró que esta fidelidad a nivel de detalle se degrada a medida que crece el contexto, con una tasa de error que sube de 0,22 en entradas cortas a 0,36 en entradas largas, una degradación del 64% (arXiv).
En el trabajo legal, estos no son errores cosméticos. "Shall" frente a "should" decide si un deber es obligatorio. Un calificador omitido como "excepto lo dispuesto en la Sección 4.2" convierte una excepción limitada en una regla general. Un límite sustituido cambia la exposición del cliente. Cada uno supera la revisión que recibe, porque cada uno se lee como un valor real. La evaluación de Stanford traza una línea que vale la pena tomar prestada aquí: un valor extraído puede ser fabricado (no está en el documento en absoluto) o mal fundamentado (el texto existe, pero no dice lo que la herramienta afirma). El segundo es más difícil de detectar, porque la fuente es real y el campo parece fundamentado.
Los campos que la compresión rompe primero
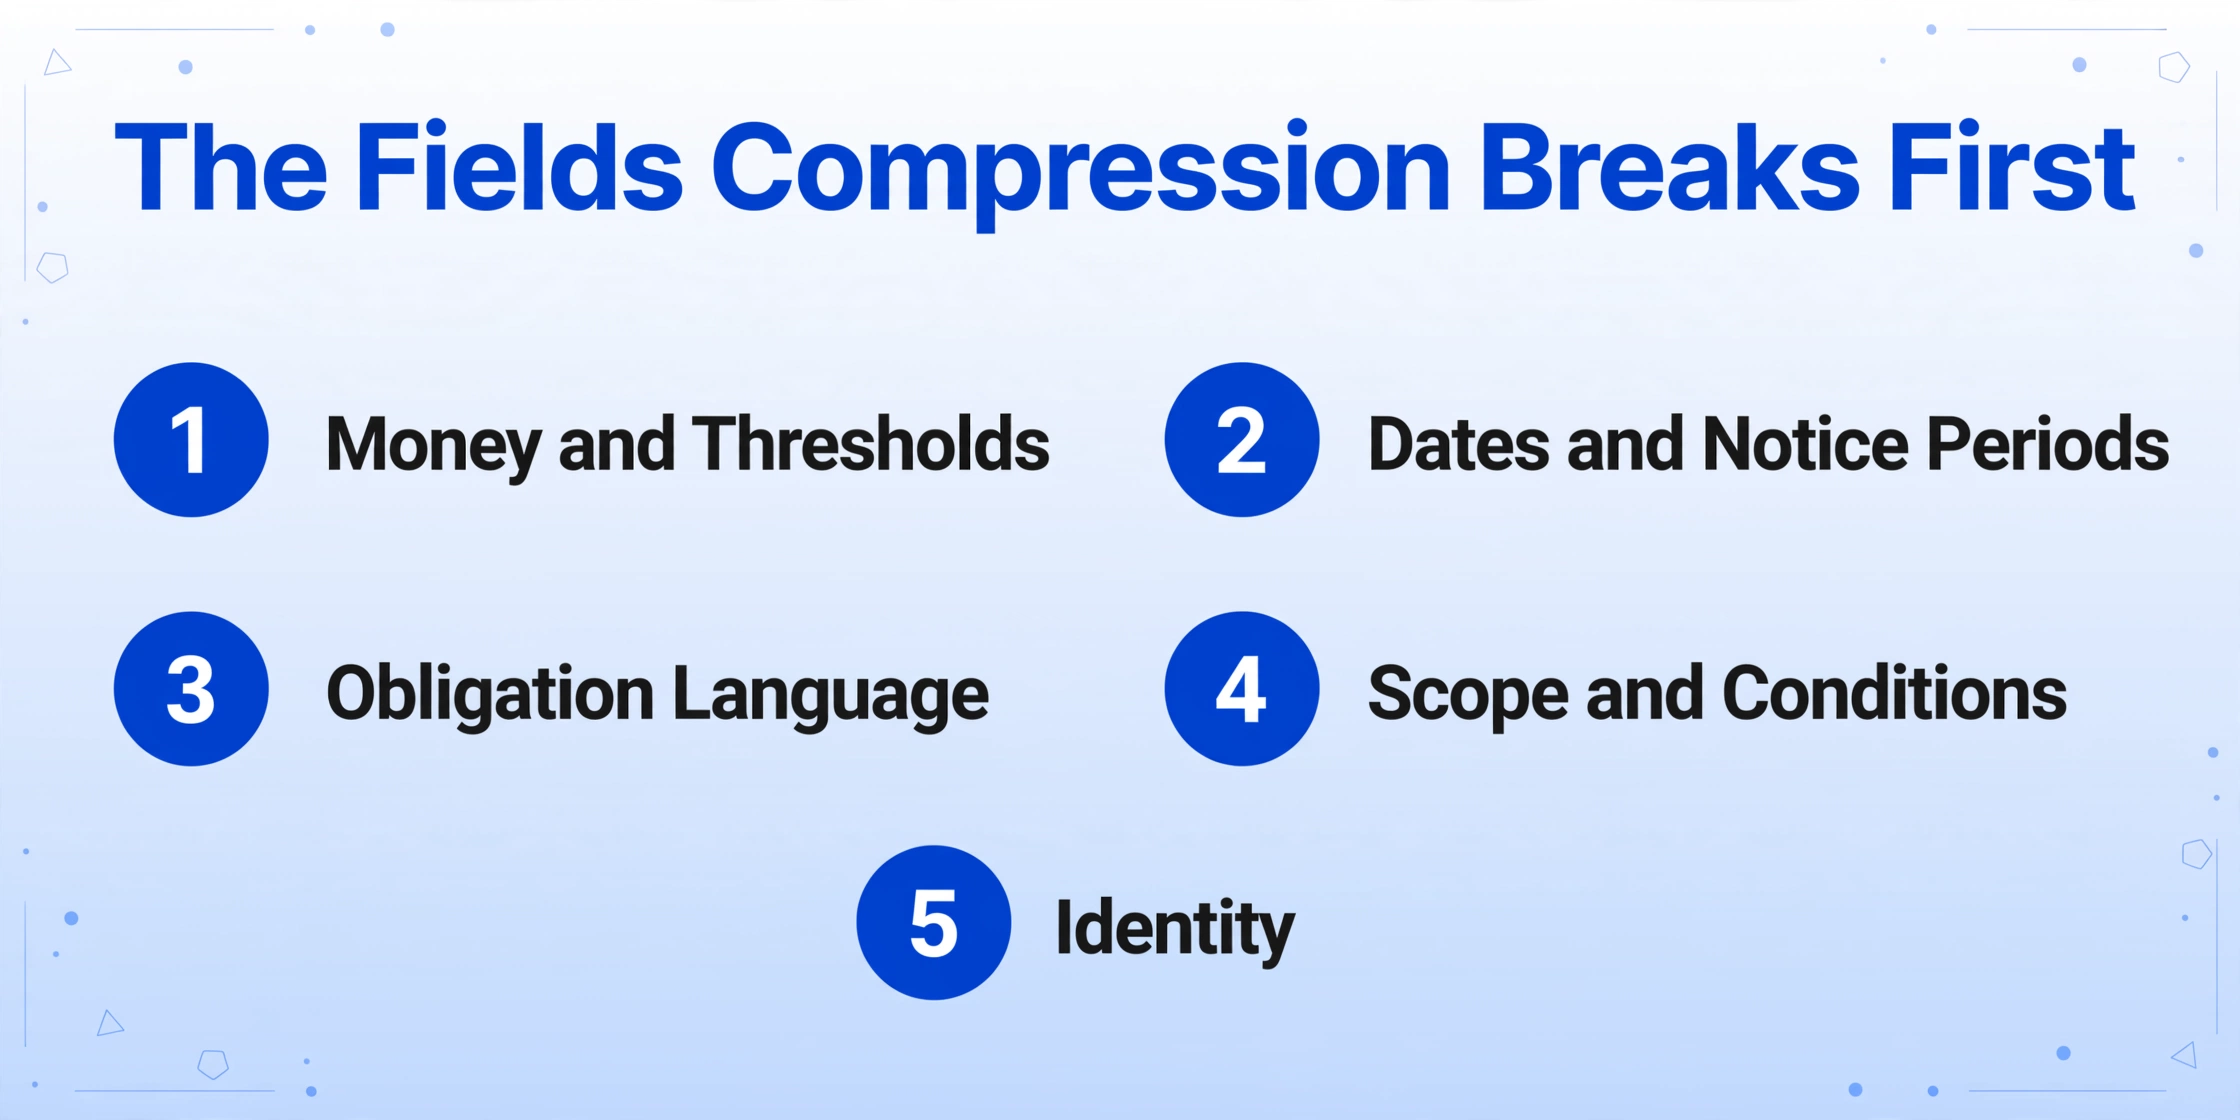
La compresión no daña todos los campos por igual. Los que tienen más probabilidades de salir mal son aquellos donde es fácil generar un sustituto plausible y difícil detectarlo a simple vista. Ese es un conjunto pequeño y predecible en los documentos legales.
| Tipo de campo | Qué le hace la compresión | Qué verificar |
|---|---|---|
| Dinero y umbrales (tope de responsabilidad, tarifa, porcentaje) | Se rellena con un valor redondo común, o desplaza un dígito; la prioridad del modelo para el tipo de cláusula puede anular la página | La cláusula y la cifra exactas, carácter por carácter |
| Fechas y períodos de aviso | Colapsa la fecha de vigencia, la fecha de enmienda y la fecha de firma en una sola | Qué hito marca la fecha, y si un documento posterior la cambió |
| Lenguaje de obligaciones | Pierde el matiz entre "shall" y "should", y elimina las salvedades | La oración completa, incluido el calificador después de la coma |
| Alcance y condiciones ("dentro de 50 millas", "salvo lo dispuesto") | Elimina la condición que limita la cláusula | La cláusula de condición, no solo el término principal |
| Identidad (ley aplicable, contraparte, rol de las partes) | Se decanta por la jurisdicción o el nombre que el modelo ha visto con más frecuencia | El preámbulo y la cláusula de ley aplicable tal como están escritos |
Observe qué tienen en común estos campos. Cada uno tiene un valor correcto que es aburrido, y un valor incorrecto que también es aburrido. Por eso sobreviven a una revisión rápida. También es la razón por la que el orden de sus verificaciones importa: comience con los campos numéricos y de obligaciones, porque son aquellos cuyos errores generan exposición.
Las enmiendas y los redlines merecen una revisión propia. Una cifra reemplazada puede permanecer muy legible en una copia ejecutada escaneada, y un modelo que trabaja con una vista parcial no tiene una forma confiable de saber qué versión controla. En un documento legal, el mismo campo aparece legítimamente varias veces, y las apariciones repetidas con valores diferentes son precisamente lo que la compresión maneja peor.
Lo que realmente exige «verificar cada campo»
En un documento largo, verificar cada campo tiene que significar forzar cada valor extraído a una ubicación específica en la fuente, de modo que un valor incorrecto se detecte por dónde apunta y no por si suena bien. Releer el documento anula el propósito de la herramienta, y releerlo es también la forma en que se cuela un valor mal fundamentado, porque el valor que sustituyó al texto parece tan convincente como el propio texto. Para que este tipo de verificación sea posible, deben cumplirse dos condiciones: sabes exactamente qué campos querías y la herramienta puede mostrarte de dónde proviene cada uno.
Nombra los campos antes de procesar
En lugar de dejar que el documento decida tus columnas, escribes los campos que necesitas: «Límite de responsabilidad», «Período de aviso», «Legislación aplicable», «Fecha de entrada en vigor». Esto es lo que significa Extracción de columnas personalizadas: la IA lee el documento y encuentra cada valor por lo que significa, no por una posición fija en la página, y los nombres de columna que introduces se convierten en los encabezados de la tabla de salida. El valor de la verificación es que el conjunto de comprobación queda fijado de antemano. No estás auditando las 180 páginas, solo los campos que nombraste.
Exige una ubicación de origen para cada celda
Review Mode te muestra de dónde proviene un valor. Pasa el cursor o haz clic en cualquier celda extraída y la región correspondiente se resalta en la página original; haz clic en una región de la página y saltará a la celda correspondiente. Si editas un campo, la herramienta conserva el valor original de la IA para que puedas comparar o revertir. En un documento largo, esto convierte «verificar cada campo» de una aspiración a una acción: no estás releyendo, estás confirmando que el valor se encuentra donde dice encontrarse.
Activa el mapa antes de necesitarlo
Las ubicaciones de origen pueden generarse bajo demanda para un solo archivo, o la cuenta puede configurarse para anotar automáticamente cada documento procesado. Generarlas a posteriori significa que el archivo de revisión está listo en cuanto termina la extracción, lo cual importa cuando la rapidez es la razón por la que automatizaste el paso en primer lugar.
Trabaja en orden de riesgo
Despeja primero los campos numéricos, de obligación y sensibles a la versión, usando la tabla anterior. Una vez que esos están correctos, la aprobación del resto de metadatos es más rápida. Una pasada de verificación que comienza con nombres y fechas consume la atención antes de llegar a los campos que concentran la exposición.
Los archivos se procesan de forma segura y no se almacenan.
El procedimiento de verificación más amplio, incluida la alineación de columnas, los recuentos de filas, las auditorías de campos faltantes, la validación numérica y de fechas, y cuándo volver a extraer en lugar de corregir manualmente, se detalla en nuestra lista de verificación de control de calidad de extracción en siete puntos. Dónde debe ubicarse un punto de revisión en un flujo de trabajo se cubre en el flujo de trabajo con supervisión humana. Y cuando la verificación abarca varios documentos a la vez, el tutorial de coherencia entre documentos muestra cómo compararlos en una sola hoja. Lo que cada uno de esos puntos presupone, y lo que la compresión hace urgente, es que cada valor pueda rastrearse hasta su fuente en primer lugar.
Lo que esta verificación aún no puede hacer
El anclaje a la fuente indica de dónde proviene un valor. No indica si la cláusula es ejecutable, si sobrevive a una enmienda posterior, ni qué debería hacer el cliente al respecto, y ninguna herramienta de extracción cambia eso. Una ubicación de fuente es evidencia, no una conclusión legal. La herramienta puede mostrar que "90 días" aparece en la Sección 12.3. No puede indicarle si ese plazo de notificación sigue aplicándose después de la carta adjunta que usted no subió.
Algunos fallos quedan fuera de la herramienta por completo. Si la cifra operativa se encuentra en un anexo, una enmienda anterior o una carta adjunta que nunca estuvo en la carga, ningún anclaje a la fuente la encontrará, porque no está allí para ser encontrada. Envíe el paquete completo y, cuando el mismo acuerdo llegue como varios archivos, combine las piezas en un solo registro antes de la revisión. Si la fuente en sí es un escaneo deficiente, cada capa superior hereda el problema, por lo que una lectura limpia comienza con un buen OCR; los documentos legales tienen sus propios requisitos, cubiertos en nuestra guía de OCR para documentos legales. Y un campo en blanco no es un fallo. Un campo informado como "no presente" es más seguro que un valor plausible inventado para llenar la fila, porque le indica a la siguiente persona que mire el documento en lugar de confiar en la tabla.
La obligación tampoco se transfiere a la herramienta. La Regla Modelo 1.1 de la ABA, Comentario 8, sitúa los beneficios y riesgos de la tecnología relevante dentro del deber de competencia del abogado, y aproximadamente 40 jurisdicciones de EE. UU. han adoptado una versión de ese lenguaje (ABA). Los profesionales lo interpretan de la misma manera: "La IA no elimina mi responsabilidad como abogado. Si un caso va a salir con su nombre, encuentre la cita. Léala." (r/legaltech). Al comparar herramientas, la pregunta que separa un extractor de grado de revisión de una caja negra es si devuelve una ubicación de fuente para cada campo. Una herramienta que solo entrega una tabla limpia no le da nada contra qué verificar, algo que vale la pena recordar cuando lea plataformas de e-discovery frente a la extracción de campos o evalúe opciones de extracción de documentos para un equipo legal pequeño.
Preguntas Frecuentes
¿Por qué las herramientas de IA alucinan más con documentos legales largos que con los cortos?
Porque un documento largo supera la cantidad de texto que un modelo puede retener a la vez, por lo que el sistema resume o recupera en lugar de leer todo. Cualquier valor que falte en esa vista comprimida se reconstruye a partir de lo que suele aparecer en ese lugar. La investigación sobre documentos de contexto largo encontró que la precisión a nivel de detalle se degrada más rápido que la precisión general a medida que crece la entrada.
¿Una ventana de contexto más grande resuelve el problema?
Eleva el umbral, pero no lo elimina. Los documentos aún pueden superar la ventana, los asistentes tipo chat aún resumen texto más antiguo para continuar, y el comportamiento del modelo se degrada a medida que crece el contexto incluso antes de alcanzar el límite. Trate una ventana grande como margen de maniobra, no como una garantía.
¿Puedo simplemente verificar los campos importantes y omitir el resto?
Elija los campos según el riesgo en lugar de verificar todo o nada. Los números, el lenguaje de obligaciones y los campos sensibles a la versión, como la fecha de vigencia frente a la fecha de enmienda, merecen una revisión minuciosa; los metadatos de bajo riesgo se pueden despachar más rápido. La decisión sobre qué campos son importantes debe tomarse de antemano y quedar por escrito, no dejarse a la herramienta.
¿Cómo verifico un valor extraído de un contrato sin leer todo el contrato?
Use el anclaje a la fuente. Haga que la herramienta muestre la ubicación de cada valor en la página original y luego confirme que el valor está donde afirma estar, en lugar de volver a leer el documento. En ImageToTable.ai, el Review Mode resalta la región de origen de cualquier celda extraída, y los documentos pueden configurarse para anotarse automáticamente después del procesamiento.
¿La extracción de contratos con IA es lo bastante precisa como para usarse sin revisión?
Ninguna herramienta, incluida la nuestra, elimina la necesidad de verificar la salida a nivel de campo en documentos que conllevan exposición legal o financiera. Nuestra extracción alcanza hasta un 99% de precisión en datos tabulares impresos, y el flujo de trabajo responsable aún confirma los campos de alto riesgo contra la fuente. Trate cualquier afirmación de "sin alucinaciones" de cualquier proveedor con el mismo escepticismo que aplicaría a una cifra de precisión sin cita que la respalde.
¿Qué debo hacer cuando un campo vuelve vacío?
Compruebe si la cláusula está realmente ausente y, si es así, déjela vacía. Una celda en blanco marcada como «no presente» es más útil que un valor plausible inventado para rellenar la fila, porque le indica a la siguiente persona en el flujo de trabajo que debe revisar el documento en lugar de confiar en la tabla.
La Prueba que Importa
La medida útil de un flujo de trabajo legal con IA no es lo bien que se ve la tabla en la primera ejecución. Es si usted puede tomar cualquier celda de esa tabla y mostrar, en un solo paso, exactamente de dónde proviene en la página. La compresión es lo que hace necesario ese paso, ya que toda solución para documentos extensos reemplaza el contrato con un sustituto más pequeño. El anclaje a la fuente es lo que lo hace posible. Comience con el campo en el que menos le gustaría equivocarse y compruebe si la herramienta puede llevarlo hasta él.
Elija un contrato que ya conozca bien, extraiga los cuatro campos que odiaría tener mal y verifique cada uno contra su ubicación en la fuente. Esa sola pasada le dice más sobre una herramienta que cualquier afirmación de precisión en su página de marketing.