文書間の契約データ照合 簡潔な例外レポートに集約
法務オペレーションチームが契約書からデータを抽出し始めると、最初のパスは通常、期待以上にうまくいきます。AIは当事者名、日付、金額、更新条件を読み取り、実用的なテーブルを構築します。その後、チームは読み取りとは無関係の部分に直面します。Redditの法務オペレーションスレッドで、あるレビュアーが明確に述べています。「苦労するのは、契約書から一度データを取り出すことではありません。抽出したデータが信頼できるほど一貫していることを証明することです」(r/legaltech)。
同じスレッドで、その問題の具体的な例が挙げられています。ある数値が「一方の別紙では技術的に正しいが、執行条項では誤っている」ことがあり、自動化ツールはどちらが制御しているかを示さずに両方を表示することがよくあります。そのため、レビュアーは2つのドキュメントを開いたまま、両方にわたって1つの値を追跡することになります。マスター契約、別紙、修正契約、更新レターはそれぞれ同じ事実を再記載しているからです。この記事では、その照合ステップを扱います。どのフィールドをチェックする必要があるか、手動のクロスチェックがなぜ破綻するか、そしてポートフォリオ全体を1つのテーブルで自己チェックする方法を説明し、出力を簡潔な例外レポート(これらのフィールドは正常に見える、これらはレビューが必要)にすることで、すべてを再度読む必要をなくします。
重要なポイント
- 契約レビューの苦労は最初の抽出ではなく、同じ値がマスター契約、別紙、修正契約の間で一致していることを証明することです。
- 6.57パーセントは、ソースドキュメントから値を読み取って手動でレコードに入力する際のエラー率であり、直接キー入力の0.29パーセントと比較されます。
- すべてのドキュメントから同じフィールドを1つの列に入れると、テーブルがチェックを実行し、レビューが必要な値の簡潔な例外レポートを返します。
契約データの照合で実際に行うこと
契約ポートフォリオは、互いを参照し合うドキュメントで構成されています。マスター契約が商業関係を定義し、別紙やスケジュールが詳細(料金表、作業明細書、価格表)を担い、修正契約が原本の一部を変更し、更新レターが契約を延長します。各ドキュメントは、他のドキュメントにも登場する事実(法人名、発効日、支払金額、通貨、通知期間、準拠法)を再記載しています。クロスドキュメント契約データ照合とは、抽出されたデータが報告または活用される前に、すべての再記載が互いに一致していることを確認するプロセスです。
単一の契約が信頼の単位になることはほとんどありません。信頼の単位はドキュメントセットであり、そのセットの信頼性は、最も整合性の低い構成要素によって決まります。
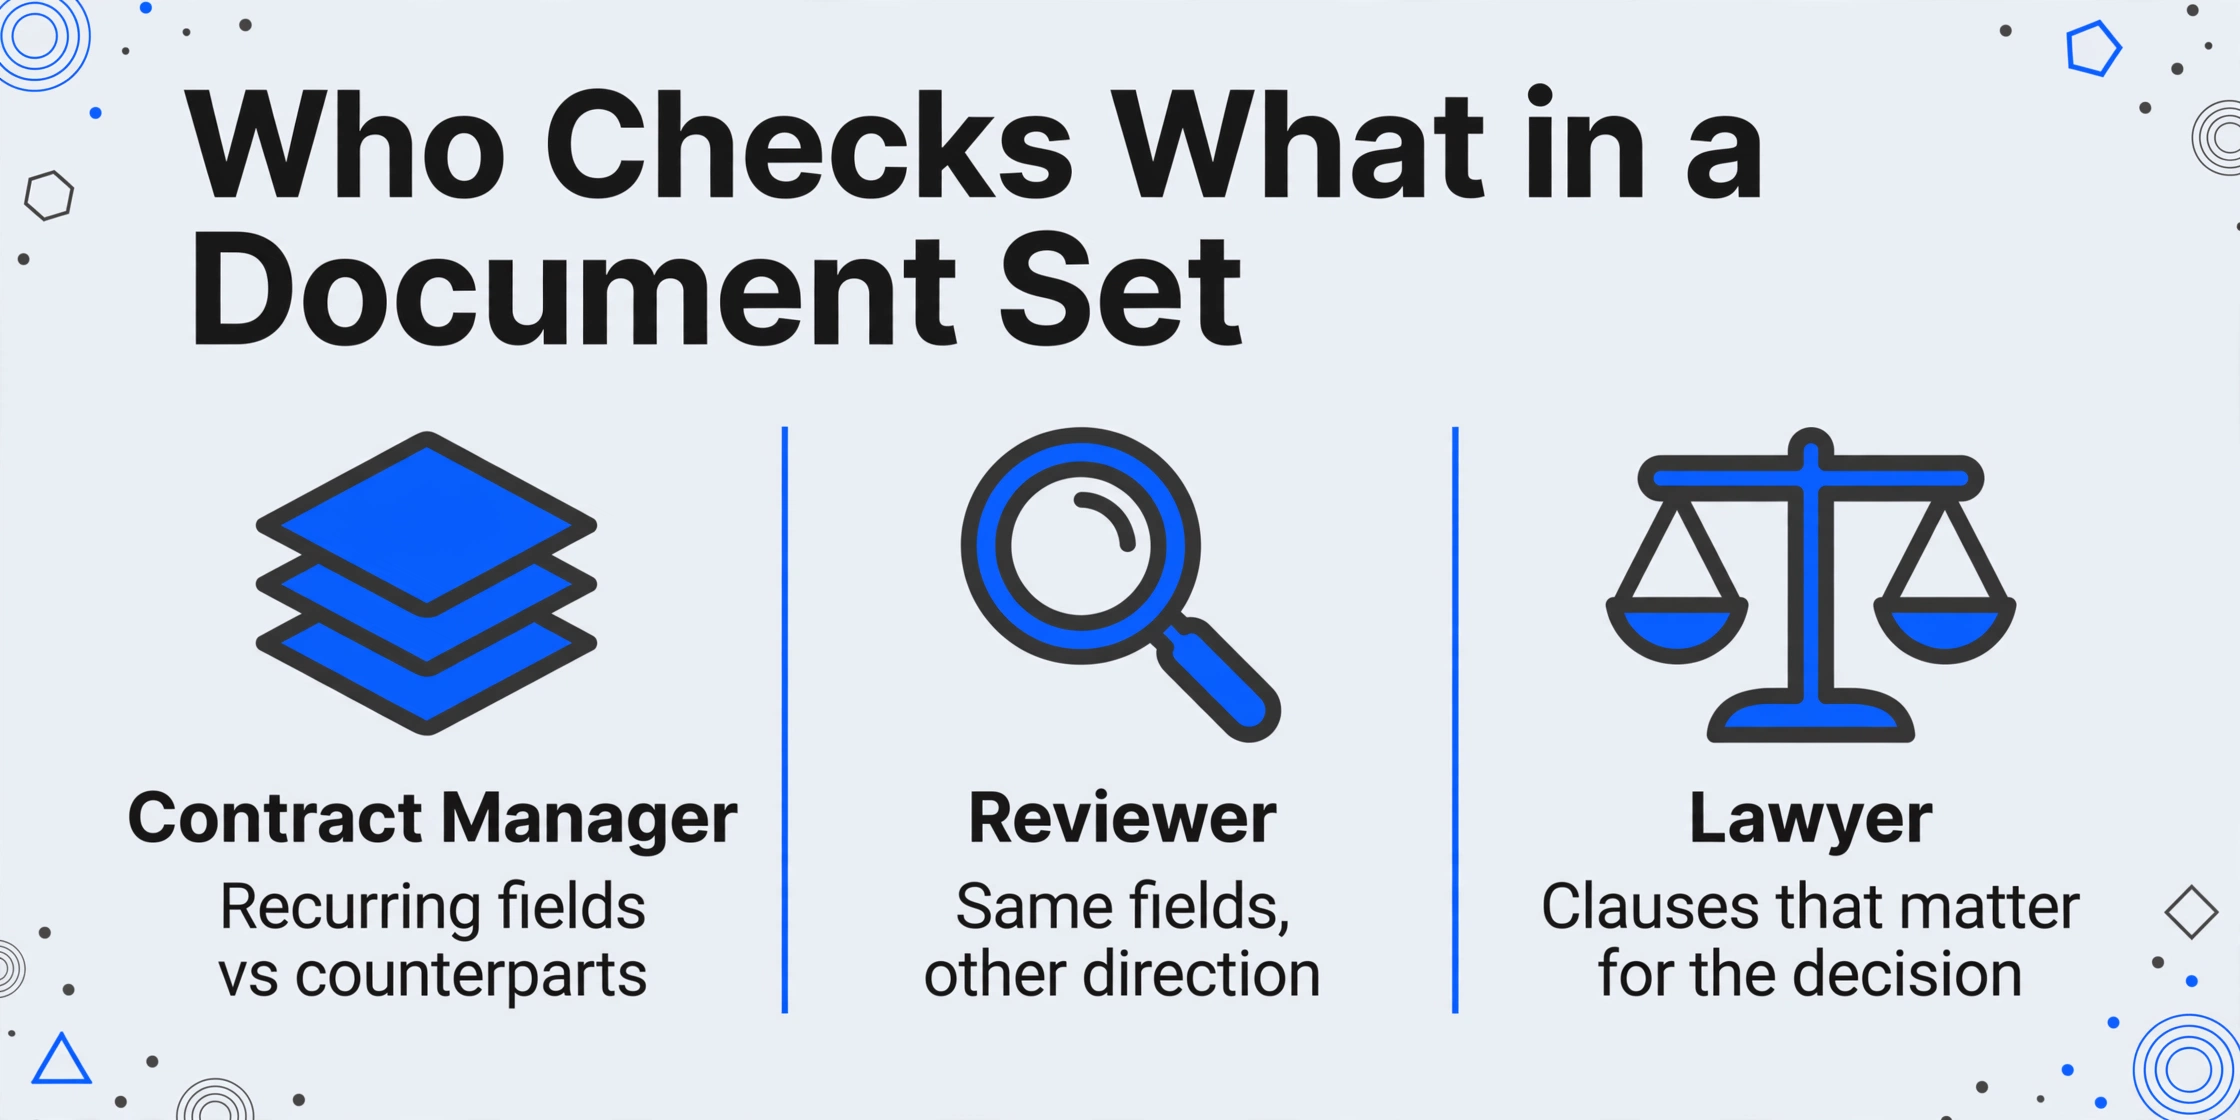
照合作業は、小規模なチームでも一定の形をとります。セットを組み立てた担当者(パラリーガル、契約管理者、またはリーガルオペレーションズアナリスト)は、各繰り返しフィールドを関連ドキュメントの対応するフィールドと照合します。データを利用するレビュー担当者は、同じフィールドを逆方向から確認します。そして、紛争や更新について助言する弁護士は、眼前の判断に重要な特定の条項を確認します。この3つの役割は、1つのサービス契約と40の別紙からなる全国展開でも、契約書、追補、譲渡契約からなる小規模事務所のリースファイルでも、同じように現れます。
| 確認する担当者 | 比較する内容 | 問題が発生する箇所 |
|---|---|---|
| 契約管理者またはリーガルオペレーションズアナリスト | マスター契約、別紙、修正契約にわたる法人名、発効日、金額、更新条件 | ドキュメントを1件ずつ読むため、2つの別紙間のずれが見えない |
| レビュー担当弁護士またはパラリーガル | 支払金額、通知期間、終了条件と運用条項の照合 | 記憶にあるドキュメントのみを確認し、セット全体は確認しない。別紙と運用条項は、疑問が生じたときにのみ比較される |
| データを利用するチーム | 報告された合計額と義務をソースドキュメントと照合 | 最初に開いたドキュメントを信頼する。支配的な条項は別のファイルにある |
この作業の規模はニッチな問題ではありません。ACCの2019年グローバル法務部門ベンチマーク調査によると、社内弁護士は年間平均173件の契約をレビューしており、平均契約サイクルタイムは30.9日です(ACC 2019 Benchmarking Report)。CLOC(Corporate Legal Operations Consortium)は、契約のターンアラウンドタイムを法務部門が報告する中核的な指標の一つと位置づけています(CLOC State of the Industry)。そして、各レビューサイクルのコストは大きな負担です。IACCMが700以上の組織を対象に行った調査では、基本的な日常契約の処理にかかる平均コストは$6,900で、契約1件あたり約5時間の法務時間と18時間の契約管理・調達時間が含まれています(WorldCC, The Cost of a Contract)。契約を一度ではなく二度読むことは、単なるマークアップではありません。それは、その時間単価で行う2回目のフルパスなのです。
ドキュメント間の手動照合が機能しない理由
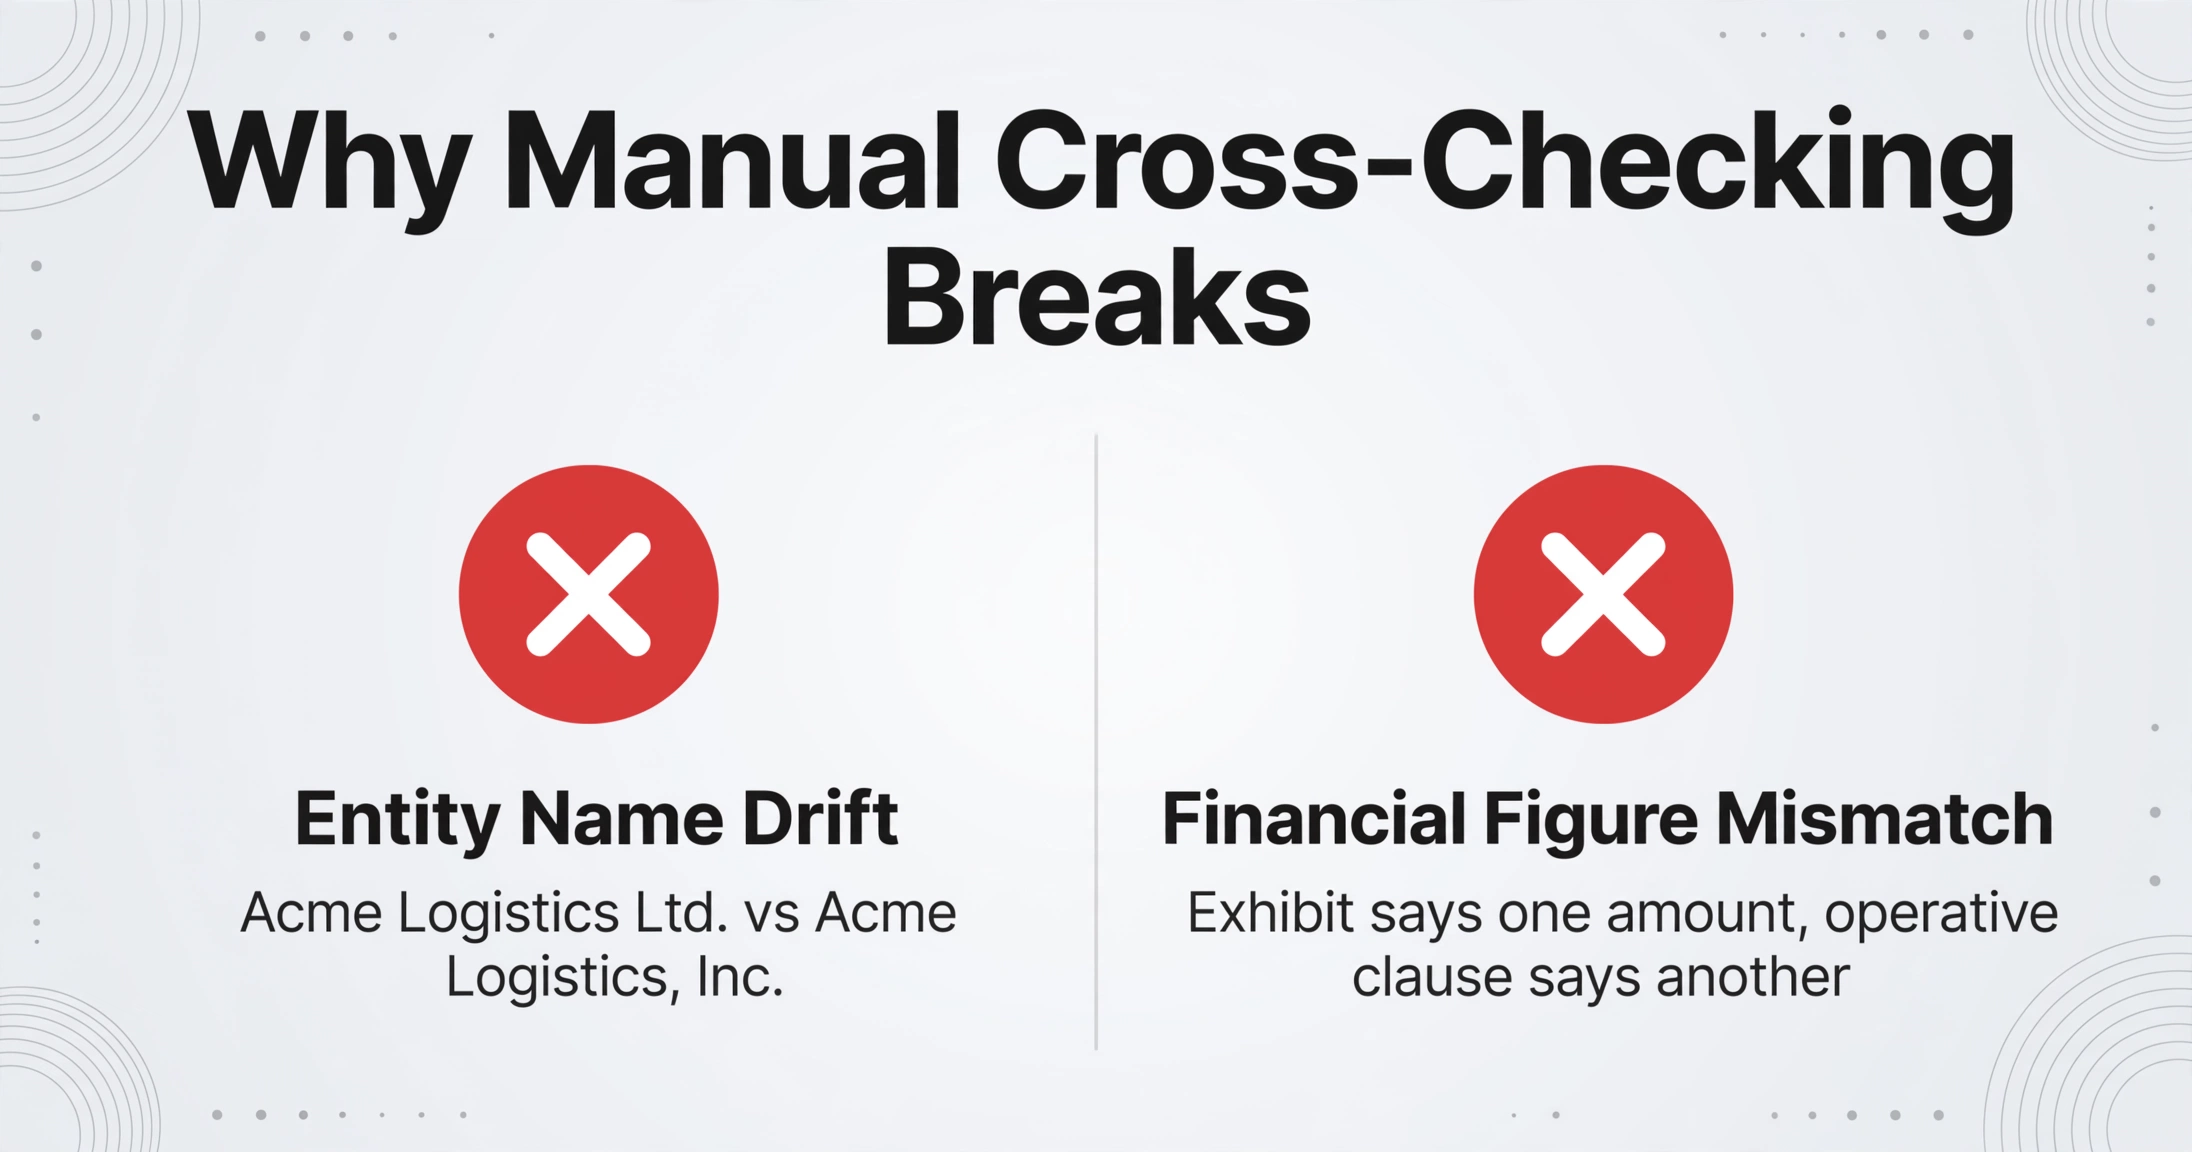
ドキュメント間の検証が失敗する理由は3つあり、それぞれ抽出が間違っているのではなく、ドキュメント同士が食い違っていることに起因します。
エンティティ名がドキュメント間でずれます。マスター契約では「Acme Logistics Ltd.」、作業明細書では「Acme Logistics, Inc.」、更新レターでは「Acme」と短縮されています。各ドキュメントは内部的には一貫しています。しかし、互いに比較すると、3つの異なる取引先になります。法人名のずれは、契約データプロジェクトで最も一般的な失敗モードの一つであり、レビュー中ではなく、レポートや署名欄の中で後になって表面化する傾向があります(一般的な契約抽出プロジェクトの落とし穴)。
財務数値は、それぞれ局所的には正しい場所に繰り返し出現します。支払金額は、執行条項、料金表の別紙、変更命令書、請求書に出現することがあります。別紙の金額は、別紙に記載されているとおり正しいものです。執行条項の金額も、執行条項に記載されているとおり正しいものです。不一致は2つのドキュメントの間に存在し、単独の読み取りでは明らかになりません。同じRedditスレッドのリーガルオプス担当コメンテーターは、まさにこの点を次のように述べています。「財務数値は最悪の原因の一つです。なぜなら、ある別紙では技術的に正しい数字が執行条項では間違っている可能性があり、自動化ツールはどちらが支配的かを教えずに両方を表面化することが多いからです。」
手動での二重チェックは、転記ミスが実際に発生する箇所です。レビュー担当者は、一方の文書から数値を読み取り、もう一方の文書でその数値を探して、目視で入力または照合します。手動によるデータ抽出に関する2023年の系統的レビューでは、ソース文書から値を読み取って構造化レコードに入力する際のプールされたエラー率は6.57%と測定され、オペレーターがソースを目の前にして直接キー入力する場合の0.29%と対比されました(Garza et al., 2023)。数値を再入力してポートフォリオを検証するレビュー担当者は、データが実際に使用され始めるまさにその時点で、利用可能な中で最も信頼性の低いプロセスの1つを実行していることになります。
これらは、実際に行っている弁護士にとっては何ら謎ではありません。2021年のEY Lawとハーバード・ロー・スクール法曹職業センターによる1,000人の契約専門家を対象とした調査では、組織の半数以上が契約の非効率性によってビジネスを失ったと回答し、99%がプロセス改善のためのデータとテクノロジーを欠いていると回答しました(EY × Harvard, 2021)。ギャップは、検証が重要であるという認識ではありません。すべてのファイルを再読込せずに比較を実行する方法です。
単一のスプレッドシートでの文書間の整合性
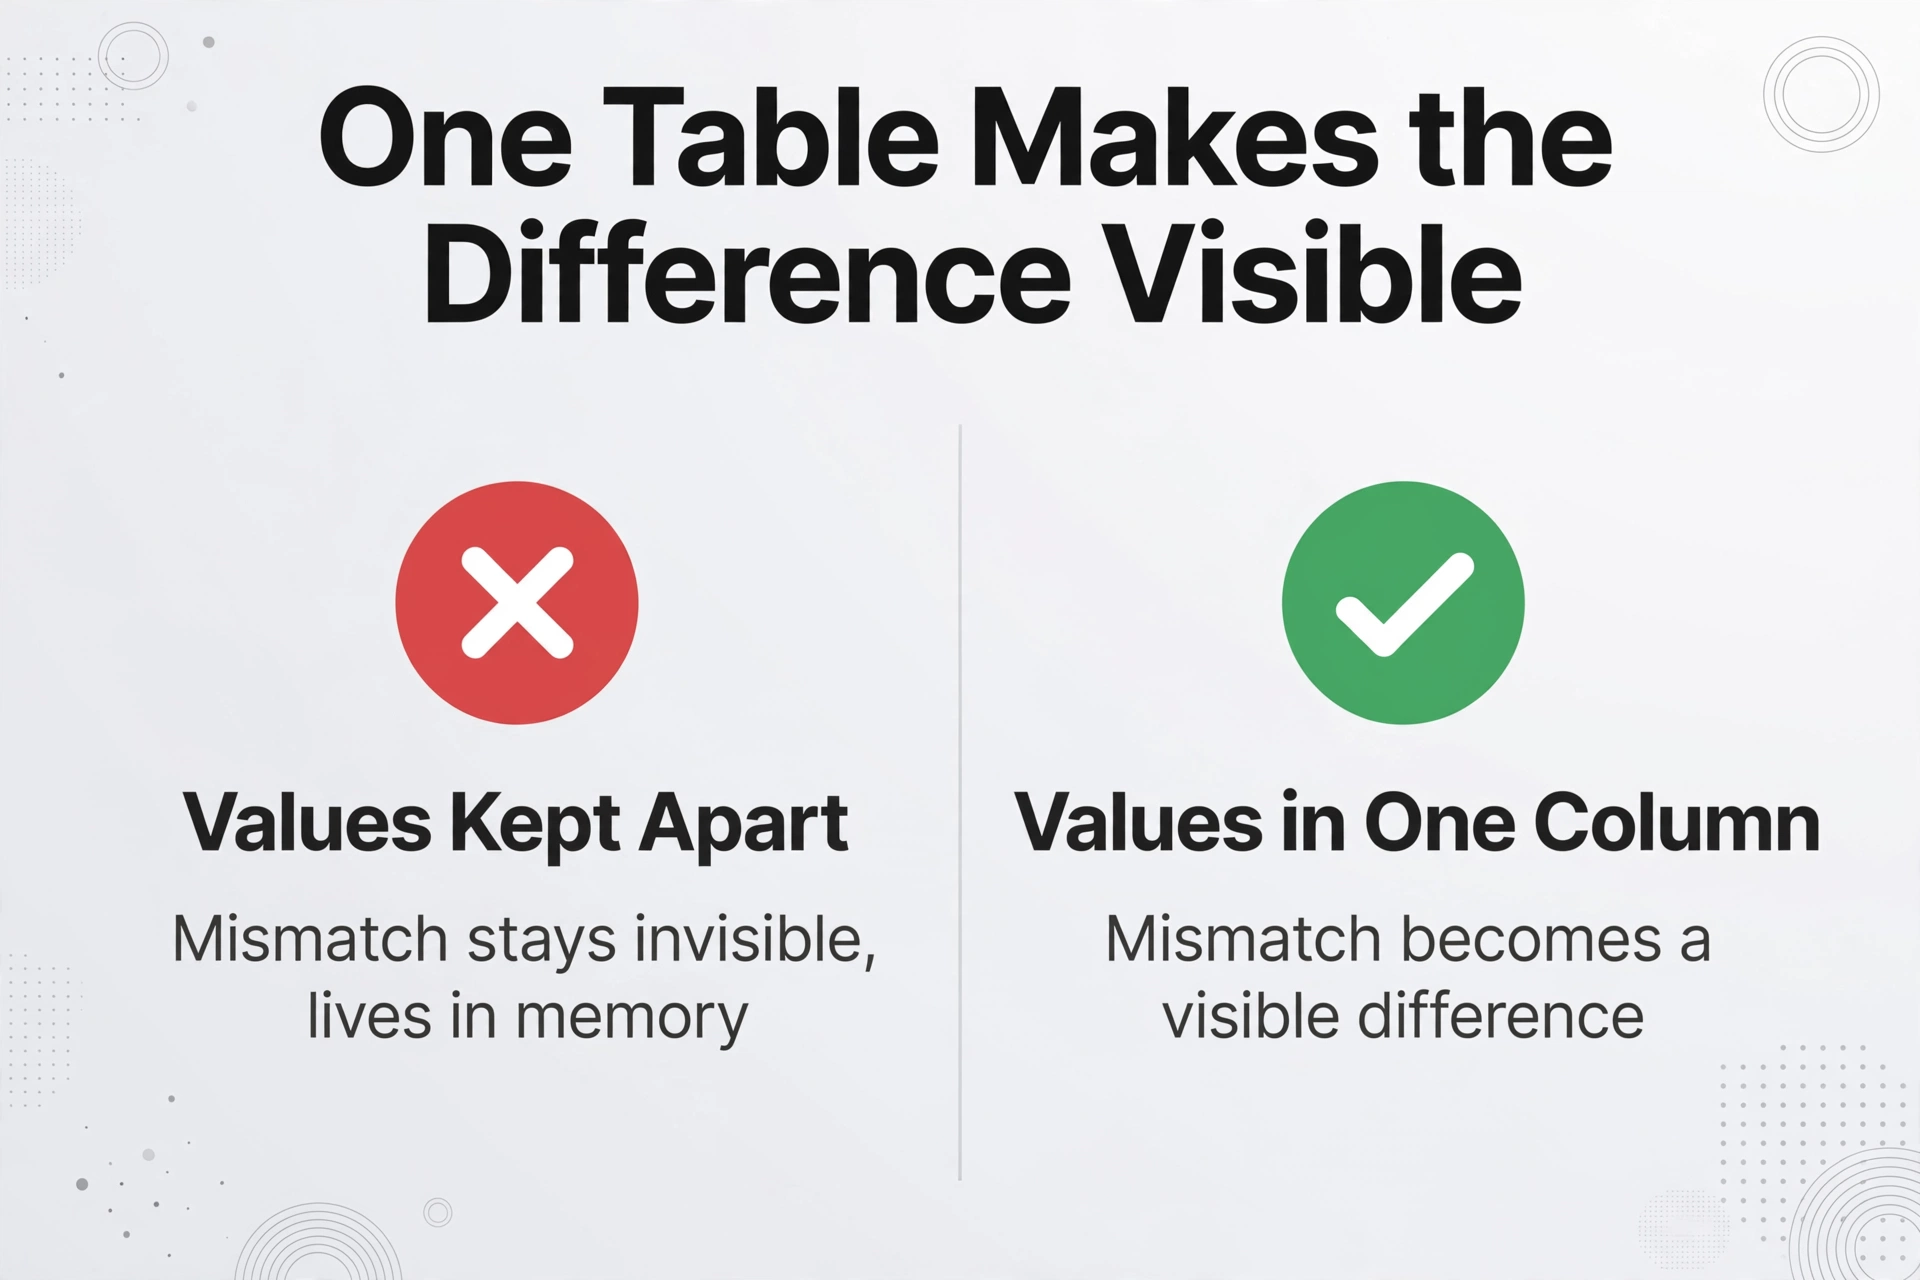
修正は、ある観察から始まります。文書は、その値が分離されている場合にのみ不一致になります。すべての文書から同じフィールドを1つのテーブルの同じ列に入れると、ある契約と次の契約の間の不一致は、記憶ではなく目に見える違いになります。これが、ほとんどの抽出プロジェクトが最初のパスで既に使用している契約からExcelへの変換ワークフローの中心にあるメカニズムです。
セットアップは、セット全体に対する1回のパスです。ImageToTable.aiでは、列名を一度だけ入力します。エンティティ名、発効日、支払金額、自動更新、通知期間、準拠法などです。このツールはカスタム列抽出を使用します。つまり、AIはテンプレートの位置を照合するのではなく、列名の意味を理解してページ上の任意の場所にある各値を特定します(契約抽出の仕組みの詳細)。マスター契約、すべての別紙、修正契約、更新レターを1つのバッチとしてアップロードすると、すべてのドキュメントが同じ列を持つ同じスプレッドシートの行として配置されます。セット全体で繰り返されるフィールドは、違いが簡単に確認できる1つの垂直列に配置されます。
次に、テーブルが比較を行います。すべてのドキュメントの同じフィールドが1つの列に配置されたため、別紙と運営条項の間の不一致は、その列を並べ替えるか、スプレッドシートの数式をそこに向けることで見つけられる行になります。抽出の役割は、値を1つの列に並べることです。比較はその後の並べ替えであり、どのドキュメントが優先されるかについてツール側のルールは必要ありません。
ファイルは安全に処理され、保存されることはありません。
フラグ付きセルは、レビューモードの出番です。結果テーブルでフラグ付きの値にカーソルを合わせるかクリックすると、ツールはその値が読み取られた元のドキュメント上の正確な位置をハイライト表示します。これにより、たとえば料金表の$4,250が「superseded」と書かれたテーブルタイトルの隣にあるかどうかを確認できます。ドキュメント上のハイライトされた領域をクリックすると、対応するセルに戻ります。値が編集された場合、ワンクリックでAIの元の読み取り値を表示し、復元できます。このレイヤーが、Redditのコメント投稿者が提起した疑問に答えます。同じ数字が別紙と効力条項の両方に登場する場合、レビューはどちらを信頼するのか。ツールの出力をそのまま信頼するのではなく、セルをページまで遡って確認します。
完成した出力は例外レポートです。共有列を並べ替えたりフィルタリングしたりすると、マスター契約と一致しない行が、一致する行から浮き彫りになります。これが、元のスレッドが求めていた「これらの40フィールドは正常、これらの8つは人間のレビューが必要」というレポートであり、ドキュメントセットを読み直すことなく生成されます。単一バッチ内で行が整合しているか、合計が妥当かという問題は、通常の抽出スポットチェック方法と、抽出されたスプレッドシートのための7項目の検証チェックリストで別途処理されます。これらは単一バッチの品質をチェックするものであり、共有列はドキュメント同士の比較を示します。フルレビュー日を設けずに同じ管理を必要とする小規模な事務所やチーム向けには、小規模法律事務所で使用されるバッチ条項抽出ワークフローが、より軽いボリュームで同じパイプラインを提供します。
整合性チェックでもまだ判断できないこと
例外レポートはレビューを絞り込むものであり、レビューを不要にするものではありません。別紙に記載された金額と運営条項に記載された金額が異なる場合、ツールは両方の記載を指し示すことができますが、どちらのドキュメントが優先されるかは、弁護士が関与する起草および交渉上の問題です。「Acme Logistics Ltd.」と「Acme Logistics, Inc.」の表記の違いは、単なる誤記である場合もあれば、正当な登録名称の変更である場合もあり、その違いは重要です。また、条項自体が義務なのか裁量なのか、上限なのか下限なのかという解釈は、どの列チェックでも実行できない解釈です。
最大手のプラットフォームでさえ、このように検証を扱っています。IroncladのAI提案による契約メタデータに関する公式ドキュメントには、AI予測は「完全に正確であることを保証できません。ビジネスに完全な正確性が求められる場合は、記録を検証することをお勧めします」と明記されています(Ironcladサポート)。Redditの会話から生まれた製品設計も、同じ境界線について正直です。ツールは値レベルの不一致とエンティティレベルの不一致を表面化し、判断はレビュー担当者に委ねられます。
目標は、弁護士をループから外すことではありません。ループを実際に異なるフィールドだけに縮小し、本当に不確かな8つの値に、48すべてではなくレビュー時間を割り当てることです。
FAQ
1つのツールで、異なるドキュメント間の契約データを本当に比較できますか?
はい、重要な意味で可能です。ドキュメントセット内のすべてのドキュメントに同じ列名を定義し、それらを1つのバッチとしてアップロードすると、各契約が同じスプレッドシートの1行になります。複数のドキュメントに出現するフィールドは1つの列に配置され、並べ替えやスプレッドシートの数式でどの行が不一致かを確認できます。ツールは値を並べるだけで、どちらのドキュメントが優先されるかを決定するものではありません。
クロスドキュメント検証では、どのような不一致が検出されますか?
値レベルの不一致とエンティティレベルの不一致を検出します。文書間で異なる当事者名、一致しない日付、ある別紙では正しくても効力条項では誤っている金額、本文と別紙で異なる通知期間などです。条項が執行可能かどうか、どのバージョンの条項が優先されるかは解釈しません。これらの判断は引き続き弁護士に委ねられます。
これは弁護士のレビューを置き換えるものですか?
いいえ。例外レポートはレビューの機械的な部分、つまり2つの文書間で同じ数値を繰り返し照合する作業を置き換え、人間の注意を不一致のあるセルに集中させます。どの値が正しいか、差異が重要かどうか、契約の意味が何かという判断は、引き続き法的作業です。このワークフローのきっかけとなったRedditのスレッドでも、まさにその分担が求められていました。40のフィールドが正常で8つは人間のレビューが必要と示す退屈なレポートであって、代わりに判断してくれるツールではありません。
単一の抽出バッチの検証とはどう違うのですか?
単一バッチの検証では、抽出されたテーブル自体をチェックします。列の整列、行数、範囲、ソース文書とのスポットチェックなどです。クロスドキュメント検証では、文書間の関係をチェックします。複数の契約に登場する同じエンティティ、日付、金額が一致しているかどうかです。テーブルがすべての文書の完璧な抽出結果であっても、矛盾を含む可能性があります。矛盾はファイルの内部ではなく、ファイルの間にあるからです。この2つのチェックは実際には一緒に実行されますが、異なる問いに答えています。
次にチームが契約書一式をスプレッドシートに取り込むとき、問うべきは抽出が正確かどうかではありません。抽出されたデータが、マスター契約、別紙、修正契約、更新レターの全体にわたって自己整合的かどうか、そしてその答えが、人間の判断を必要とする値の短いリストとして返ってくるかどうかです。そのリストこそが成果物全体です。ご自身の契約セットをアップロードして、何フィールドが「レビューが必要」と返ってくるかご確認ください。