문서 간 계약 데이터 검증 간결한 예외 보고서로 마무리
법무 운영 팀이 계약서에서 데이터를 추출하기 시작하면, 첫 번째 단계는 대개 예상보다 순조롭습니다. AI가 당사자 이름, 날짜, 금액, 갱신 조건을 읽고 활용 가능한 테이블을 구축합니다. 그런 다음 팀은 읽기와는 무관한 부분에 부딪힙니다. 법무 운영 관련 Reddit 스레드에서 한 검토자가 이렇게 명확히 말했습니다. "고통스러운 부분은 대개 계약서에서 데이터를 한 번 추출하는 것이 아닙니다. 추출된 데이터가 신뢰할 수 있을 만큼 일관적이라는 것을 입증하는 것입니다" (r/legaltech).
같은 스레드에서 이 문제의 구체적인 버전이 언급되었습니다. 숫자가 "한 부속서에서는 기술적으로 정확하지만 효력 조항에서는 틀릴 수 있으며, 자동화 도구는 종종 어느 쪽을 제어해야 하는지 알려주지 않은 채 둘 다 표시합니다." 따라서 검토자는 마스터 계약, 부속서, 수정 계약, 갱신 서한이 각각 동일한 사실을 다시 명시하기 때문에 두 문서를 나란히 열고 하나의 값을 양쪽에서 추적하게 됩니다. 이 글에서는 이러한 검증 단계를 다룹니다: 어떤 필드를 확인해야 하는지, 수동 교차 확인이 왜 실패하는지, 그리고 전체 포트폴리오를 하나의 테이블에서 자체적으로 대조하여 출력물이 간결한 예외 보고서(이 필드들은 정상, 이 필드들은 검토 필요)가 되도록 하는 방법을 설명합니다. 모든 것을 다시 읽는 대신 말입니다.
주요 요점
- 계약 검토에서 어려운 부분은 첫 추출이 아니라, 동일한 값이 마스터 계약, 부속서, 수정 계약 전반에 걸쳐 일치한다는 것을 입증하는 것입니다.
- 소스 문서에서 값을 읽어 수기로 기록에 입력할 때의 오류율은 6.57%인 반면, 직접 키 입력 시 오류율은 0.29%입니다.
- 모든 문서의 동일한 필드를 하나의 열에 배치하면 테이블이 자동으로 대조를 수행하여 검토가 필요한 값의 간결한 예외 보고서를 반환합니다.
계약 데이터 검증이 실제로 수반하는 작업
계약 포트폴리오는 서로를 참조하는 문서들로 구성됩니다. 마스터 계약이 상업적 관계를 정의하고, 부속서와 일정표가 세부 사항(수수료 일정, 작업 명세서, 가격표)을 담당하며, 수정 계약이 원본의 일부를 변경하고, 갱신 서한이 이를 연장합니다. 각 문서는 다른 문서에도 나타나는 사실(법적 엔티티 이름, 발효일, 지급 금액, 통화, 통지 기간, 준거법)을 재진술합니다. 문서 간 계약 데이터 검증은 추출된 데이터가 보고되거나 조치되기 전에 모든 재진술이 서로 일치하는지 확인하는 프로세스입니다.
단일 계약은 신뢰의 단위가 되기 어렵습니다. 신뢰의 단위는 문서 세트이며, 세트는 가장 일관성이 없는 구성원만큼만 신뢰할 수 있습니다.
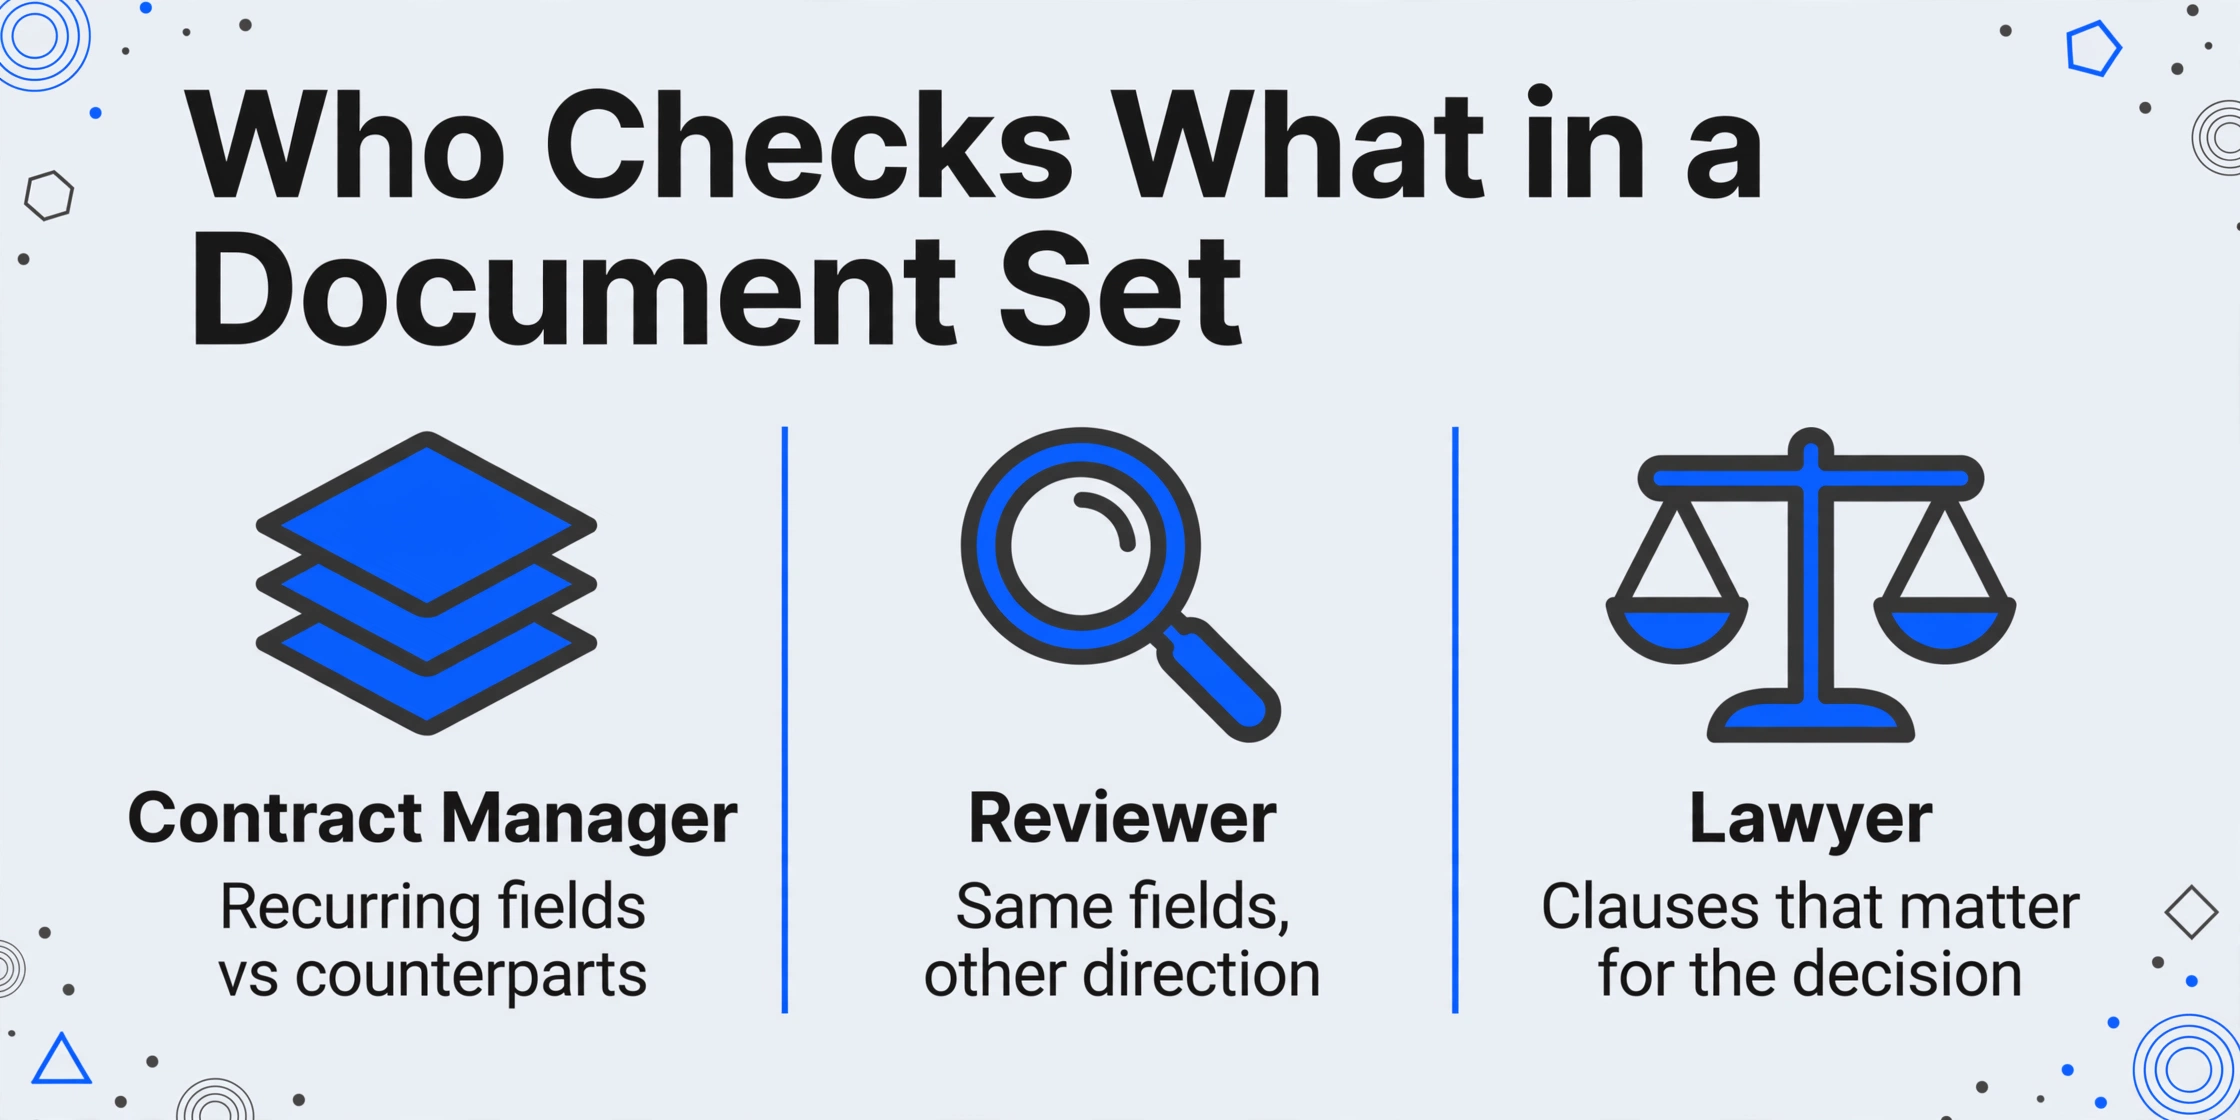
검증 작업은 소규모 팀에서도 일정한 형태를 띕니다. 세트를 구성한 사람(법률 비서, 계약 관리자 또는 법무 운영 분석가)은 각 반복 필드를 관련 문서의 대응 필드와 대조합니다. 데이터에 의존할 검토자는 반대 방향에서 동일한 필드를 확인합니다. 그리고 분쟁이나 갱신에 대해 자문하는 변호사는 당면한 결정에 중요한 특정 조항을 확인합니다. 국가 단위 롤아웃(서비스 계약 1건과 부속서 40건)이든 소규모 법인의 임대 파일(계약서, 부속서, 양도 계약서)이든 동일한 세 가지 역할이 나타납니다.
| 확인하는 사람 | 대조하는 항목 | 문제가 발생하는 지점 |
|---|---|---|
| 계약 관리자 또는 법무 운영 분석가 | 마스터 계약, 부속서, 수정 계약 전반의 엔티티 이름, 발효일, 금액, 갱신 조건 | 문서를 하나씩 읽으므로 두 부속서 간의 차이가 눈에 띄지 않음 |
| 검토 변호사 또는 법률 비서 | 지급 수치, 통지 기간, 종료 조건을 운영 조항과 대조 | 전체 세트가 아닌 기억나는 문서만 확인함. 부속서와 운영 조항은 질문이 생길 때만 비교됨 |
| 데이터에 의존하는 팀 | 보고된 합계와 의무를 원본 문서와 대조 | 가장 먼저 여는 문서를 신뢰함. 통제 조항은 다른 파일에 있음 |
이 작업의 규모는 틈새 문제가 아닙니다. ACC의 2019년 글로벌 법무 부서 벤치마킹 조사에 따르면 사내 변호사는 연평균 173건의 계약을 검토하며, 평균 계약 처리 주기는 30.9일입니다(ACC 2019 Benchmarking Report). CLOC(기업 법무 운영 컨소시엄)은 계약 처리 시간을 법무 부서가 보고하는 핵심 지표 중 하나로 간주합니다(CLOC State of the Industry). 그리고 모든 검토 주기의 비용은 상당합니다. IACCM이 700개 이상의 조직을 대상으로 실시한 연구에 따르면 기본적인 일상 계약 1건을 처리하는 평균 비용은 $6,900이며, 계약당 법무 시간 약 5시간과 계약 관리 및 조달 시간 18시간이 포함됩니다(WorldCC, The Cost of a Contract). 계약을 한 번이 아닌 두 번 읽는 것은 단순한 마크업이 아닙니다. 그 시간당 비용으로 두 번째 전체 검토를 수행하는 것입니다.
문서 간 수동 대조가 실패하는 이유
문서 간 대조 검증은 세 가지 이유로 실패하며, 각각은 추출이 잘못된 것이 아니라 문서 간 불일치에 관한 것입니다.
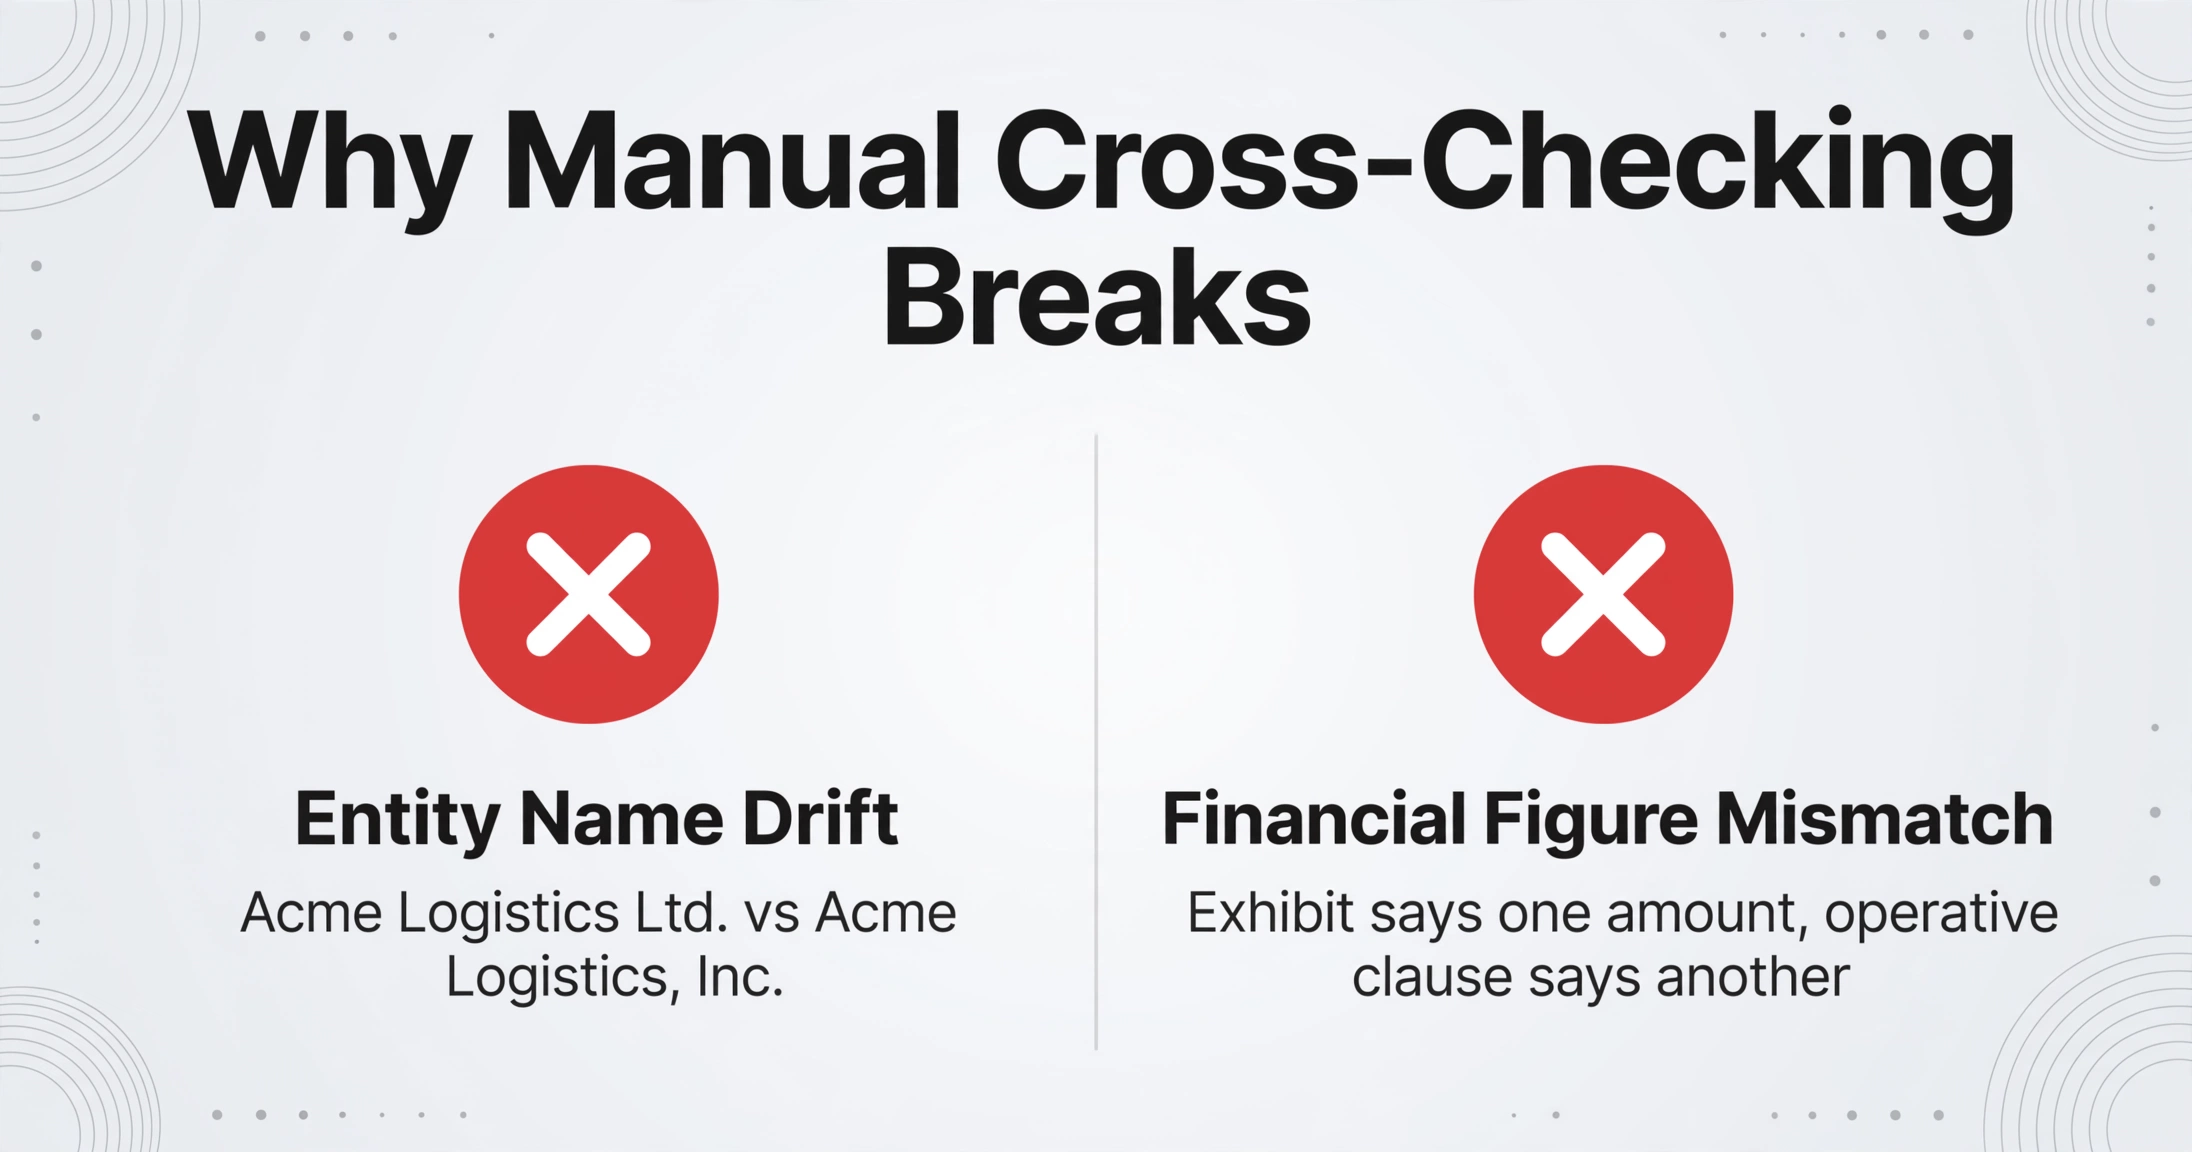
문서 간 엔티티 이름이 달라집니다. 마스터 계약에는 "Acme Logistics Ltd."로 명시되어 있고, 작업 명세서에는 "Acme Logistics, Inc."로 표시되며, 갱신 서한에서는 "Acme"로 줄여 씁니다. 각 문서는 내부적으로 일관성이 있습니다. 서로 비교하면 세 개의 서로 다른 상대방입니다. 법적 명칭 불일치는 계약 데이터 프로젝트에서 가장 흔한 실패 유형 중 하나이며, 검토 중이 아니라 보고서나 서명란에서 늦게 표면화되는 경향이 있습니다(일반적인 계약 추출 프로젝트 함정).
재무 수치는 각각 국지적으로 올바른 위치에 반복적으로 나타납니다. 지급 금액은 본문 지급 조항, 수수료 일정 부속서, 변경 지시서, 청구서에 나타날 수 있습니다. 부속서의 금액은 부속서에 명시된 대로 정확합니다. 본문 조항의 금액도 본문 조항에 명시된 대로 정확합니다. 불일치는 두 문서 사이에 있으며, 단일 문서를 읽는 것만으로는 드러나지 않습니다. 동일한 Reddit 스레드의 법무 운영 댓글 작성자는 이를 정확히 설명했습니다: "재무 수치는 가장 심각한 문제 중 하나입니다. 숫자가 한 부속서에서는 기술적으로 정확하지만 본문 조항에서는 틀릴 수 있고, 자동화 도구는 어느 것이 우선하는지 알려주지 않은 채 둘 다 표시하는 경우가 많기 때문입니다."
수동 재검토는 실제로 전사 오류가 발생하는 지점입니다. 검토자는 한 문서에서 숫자를 읽고 다른 문서에서 그 숫자를 찾아 입력하거나 눈으로 대조합니다. 수동 데이터 추출에 대한 2023년 체계적 문헌고찰에 따르면, 원본 문서에서 값을 읽어 구조화된 기록에 입력하는 과정의 통합 오류율은 6.57%로 측정된 반면, 운영자가 원본을 바로 앞에 두고 직접 입력하는 경우의 오류율은 0.29%였습니다(Garza et al., 2023). 포트폴리오를 숫자를 다시 입력해 검증하는 검토자는 데이터가 신뢰되기 시작하는 바로 그 지점에서 가장 신뢰할 수 없는 프로세스 중 하나를 실행하고 있는 셈입니다.
이를 수행하는 변호사들에게 이는 전혀 미스터리가 아닙니다. 2021년 EY Law와 Harvard Law School Center on the Legal Profession이 1,000명의 계약 전문가를 대상으로 실시한 설문조사에 따르면, 절반 이상의 조직이 계약 비효율성으로 인해 사업 기회를 상실했다고 답했으며, 99%는 프로세스 개선에 필요한 데이터와 기술이 부족하다고 응답했습니다(EY × Harvard, 2021). 문제는 검증이 중요하다는 인식의 부족이 아닙니다. 모든 파일을 다시 읽지 않고 비교를 실행할 수 있는 방법의 부족입니다.
단일 스프레드시트에서의 문서 간 일관성
해결책은 한 가지 관찰에서 시작합니다. 문서는 값이 분리되어 있을 때만 불일치합니다. 모든 문서의 동일한 필드를 하나의 테이블의 동일한 열에 넣으면, 계약서 간의 불일치는 기억이 아닌 눈에 보이는 차이가 됩니다. 이것이 대부분의 추출 프로젝트가 첫 번째 단계에서 이미 사용하는 계약서를 Excel로 변환 워크플로우의 핵심 메커니즘입니다.
설정은 전체 문서 세트를 한 번 처리하는 것입니다. ImageToTable.ai에서 원하는 열 이름을 한 번 입력합니다: 엔티티 이름, 발효일, 지급 금액, 자동 갱신, 통지 기간, 준거법. 이 도구는 맞춤 열 추출을 사용하는데, 이는 AI가 템플릿 위치를 매칭하는 대신 열 이름의 의미를 이해하여 페이지 어디서든 각 값을 찾아낸다는 뜻입니다(계약 추출이 작동하는 방식에 대한 자세한 설명). 마스터 계약, 모든 부속서, 수정 계약, 갱신 서한을 하나의 배치로 업로드하면, 모든 문서가 동일한 열을 가진 동일한 스프레드시트의 행으로 배치됩니다. 문서 세트 전체에 걸쳐 반복되는 필드는 이제 차이를 쉽게 발견할 수 있는 하나의 세로 열에 위치하게 됩니다.
이제 테이블이 비교 작업을 수행합니다. 모든 문서의 동일한 필드가 하나의 열에 있기 때문에, 부속서와 본문 조항 간의 불일치는 해당 열을 정렬하거나 스프레드시트 수식을 지정하여 찾을 수 있는 행이 됩니다. 추출의 역할은 값을 한 열에 나란히 배치하는 것이며, 비교는 정렬만 하면 되는 작업으로, 어떤 문서가 우선하는지에 대한 도구 측 규칙이 필요 없습니다.
파일은 안전하게 처리되며 저장되지 않습니다.
플래그된 셀은 검토 모드가 필요한 지점입니다. 결과 테이블에서 플래그된 값을 가리키거나 클릭하면 도구가 원본 문서에서 해당 값을 읽어낸 정확한 위치를 강조 표시하므로, 예를 들어 수수료 일정표의 $4,250이 "폐기됨"이라고 표시된 테이블 제목 옆에 있는지 확인할 수 있습니다. 문서에서 위치가 표시된 영역을 클릭하면 해당 셀로 다시 이동합니다. 값을 수정한 경우 한 번의 클릭으로 AI의 원래 판독값을 확인하고 복원할 수 있습니다. 이 계층이 Reddit 댓글 작성자가 제기한 질문, 즉 동일한 수치가 부속서와 본문 조항에 모두 나타날 때 검토가 어느 쪽을 신뢰할지에 대한 답을 제공합니다. 도구의 말을 그대로 믿는 것이 아니라 셀을 따라 페이지로 돌아가는 것입니다.
완성된 출력물은 예외 보고서입니다. 공유 열을 정렬하거나 필터링하면 기준 문서와 일치하지 않는 행이 일치하는 행과 구분되어 표시됩니다. 이것이 원래 스레드에서 요청한 "이 40개 필드는 정상, 이 8개는 사람의 검토 필요" 보고서이며, 문서 세트를 다시 읽지 않고 생성됩니다. 행 정렬과 합계의 타당성에 대한 단일 배치 문제는 일반적인 추출 스팟체크 방법과 추출된 스프레드시트를 위한 7가지 검증 체크리스트로 별도로 처리됩니다. 이러한 방법은 단일 배치의 품질을 확인하는 반면, 공유 열은 문서 간의 비교 결과를 보여줍니다. 전체 검토일 없이 동일한 통제가 필요한 소규모 법률 사무소와 팀을 위해 소규모 법률 사무소의 배치 조항 추출 워크플로는 더 가벼운 볼륨의 동일한 파이프라인입니다.
일관성 검사가 그래도 결정해 주지 못하는 것
예외 보고서는 검토 범위를 좁힐 뿐, 검토 자체를 없애지는 않습니다. 부속서에 한 금액이 명시되고 본문 조항에 다른 금액이 명시된 경우, 도구는 두 해석을 모두 지적할 수 있지만 어느 문서가 우선하는지는 초안 작성 및 협상의 문제로 법률 전문가의 몫입니다. "Acme Logistics Ltd."와 "Acme Logistics, Inc." 사이의 철자 변형은 실제 오류일 수도 있고 합법적인 등록 상호 변경일 수도 있으며, 그 차이는 중요합니다. 그리고 조항 자체—의무인지 재량인지, 상한인지 하한인지—는 어떤 열 검사도 수행하지 못하는 해석의 영역입니다.
가장 큰 플랫폼들조차 검증을 이런 방식으로 처리합니다. Ironclad의 AI 제안 계약 메타데이터에 관한 자체 문서는 AI 예측이 "완벽하게 정확하다고 보장할 수 없으므로, 비즈니스에 완전한 정확성이 요구된다면 기록을 검증할 것을 권장합니다"라고 명확히 밝히고 있습니다 (Ironclad Support). Reddit 대화에서 나온 제품 설계는 동일한 경계에 대해 솔직합니다. 도구는 값 수준 및 엔티티 수준 불일치를 표면화하고, 판단은 검토자에게 남아 있습니다.
목표는 법률 전문가를 루프에서 자동으로 배제하는 것이 아닙니다. 실제로 다른 필드로 루프를 축소하여, 진정으로 불확실한 여덟 개의 값이 마흔여덟 개 모두 대신 검토 시간을 받도록 하는 것입니다.
FAQ
한 도구로 서로 다른 문서 간의 계약 데이터를 정말 비교할 수 있나요?
네, 중요한 의미에서 그렇습니다. 문서 세트의 모든 문서에 대해 동일한 열 이름을 정의하고 하나의 배치로 업로드하면 각 계약이 동일한 스프레드시트의 행이 됩니다. 여러 문서에 나타나는 모든 필드는 하나의 열에 위치하게 되며, 정렬이나 스프레드시트 수식을 통해 어떤 행이 일치하지 않는지 확인할 수 있습니다. 도구는 값을 정렬할 뿐, 어느 문서가 우선하는지 결정하지는 않습니다.
교차 문서 검증은 어떤 종류의 불일치를 발견하나요?
값 수준 및 엔티티 수준의 불일치를 표면화합니다: 문서 간에 다른 당사자 이름, 일치하지 않는 날짜, 한 부속서에서는 맞지만 본문 조항에서는 틀린 금액, 본문과 일정표에서 다르게 명시된 통지 기간 등이 포함됩니다. 조항의 집행 가능성이나 어떤 버전의 조건이 우선하는지 해석하지는 않습니다. 이러한 질문은 여전히 변호사의 몫입니다.
이 기능이 변호사의 검토를 대체하나요?
아닙니다. 예외 보고서는 검토의 기계적 부분, 즉 두 문서에서 동일한 수치를 반복적으로 추적하는 작업을 대체하고, 불일치하는 셀에 인간의 주의를 집중시킵니다. 어떤 값이 올바른지, 차이가 중대한지, 계약이 의미하는 바가 무엇인지에 대한 판단은 여전히 법적 업무입니다. 이 워크플로우의 동기가 된 Reddit 스레드가 요청한 것은 정확히 그 분할입니다: 40개 필드는 정상으로, 8개는 인간의 검토가 필요하다고 말하는 지루한 보고서이지, 사용자를 대신해 결정하는 도구가 아닙니다.
단일 추출 배치 검증과 어떻게 다른가요?
단일 배치 검증은 추출된 테이블 자체를 확인합니다: 열 정렬, 행 수, 범위, 그리고 원본 문서에 대한 표본 검사입니다. 교차 문서 검증은 문서 간의 관계를 확인합니다: 동일한 엔티티, 날짜 또는 금액이 둘 이상의 계약에 나타나면서 불일치하는 경우입니다. 테이블은 모든 문서의 완벽한 추출일 수 있지만 여전히 모순을 포함할 수 있습니다. 모순은 파일 내부가 아니라 파일 사이에 존재하기 때문입니다. 두 검사는 실제로 함께 실행되지만 서로 다른 질문에 답합니다.
다음에 팀이 계약 포트폴리오를 스프레드시트로 가져올 때 물어야 할 질문은 추출이 정확한지 여부가 아닙니다. 추출된 데이터가 마스터 계약, 부속서, 수정 계약, 갱신 서한 전반에 걸쳐 자체적으로 일치하는지, 그리고 그 답이 인간의 결정이 필요한 값의 짧은 목록으로 돌아오는지 여부입니다. 그 목록이 바로 전체 산출물입니다. 자신의 계약 세트를 업로드하고 몇 개의 필드가 '검토 필요'로 반환되는지 확인하세요.