契約からデータを抽出する方法
完全ガイド
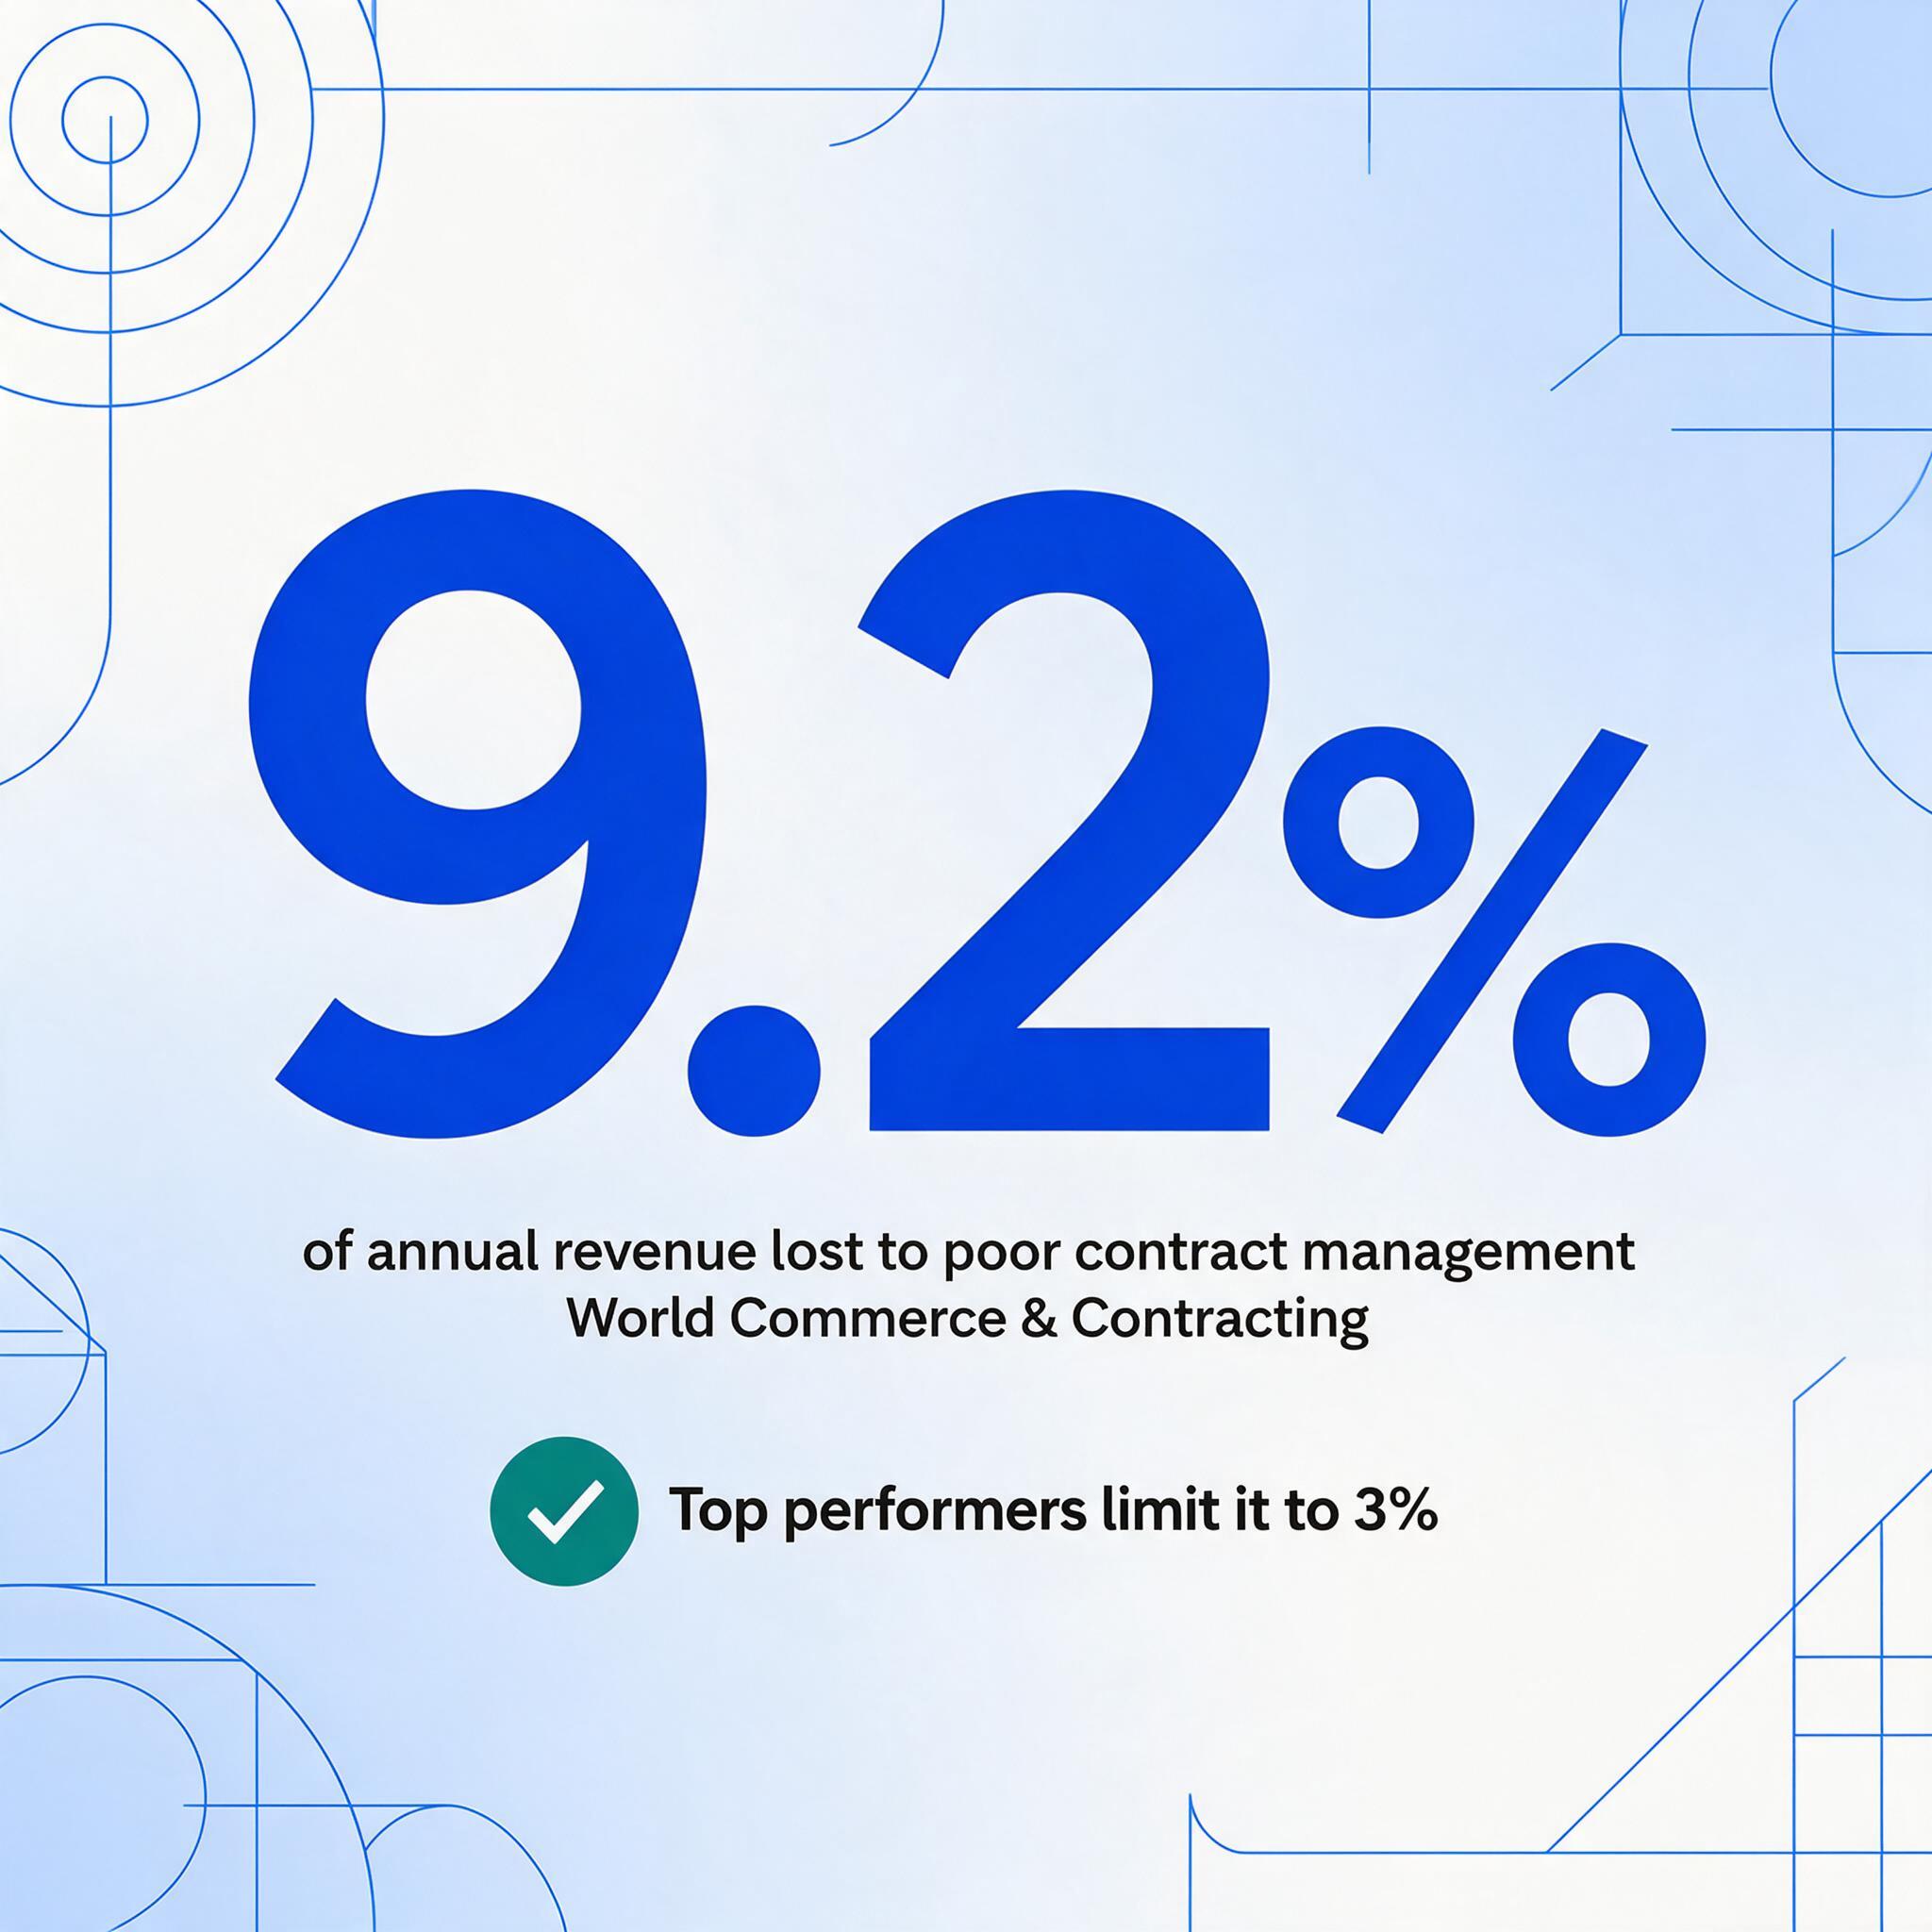
組織は、契約管理の不備により平均して年間収益の9.2%を失っています。これはWorld Commerce & Contractingの調査によるもので、悪い取引が原因ではなく、署名済み契約書の中に存在しながら、誰も並べ替え・フィルタリング・活用できるシステムに届かないデータが原因です。契約データ抽出は、そのギャップを埋めるステップです。契約書を読み取り、構造化されたフィールド(当事者、日付、金額、支払条件、更新トリガー、義務)をスプレッドシートに出力し、可視化して活用できるようにします。このガイドでは、契約書が最も抽出が難しい文書タイプである理由から、最も重要なフィールド、バッチ処理によってポートフォリオのレビューを数週間の作業から半日へと変える方法まで、プロセス全体を網羅します。
重要ポイント
- 1つの契約書内の1つの条項を見つけるのに平均129分かかります — 適切な文書の特定に45分、該当セクションの特定に84分 — そして500件の契約ポートフォリオでは、検索だけで250営業日中188日を消費します。
- World Commerce & Contractingは、契約管理の不備による損失を年間収益の9.2%と推定しています — 悪い取引が原因ではなく、署名済みPDF内に存在しながら、ソート可能でフィルタリング可能なスプレッドシートに届かないデータが原因です。
- 列名を一度12個定義し、契約ポートフォリオ全体をアップロードすれば、抽出によって1つのスプレッドシートが出力され、更新日でソートするだけで今後90日以内に期限切れとなるすべての契約が即座に表示されます — 取引先ごとのテンプレート設定は不要です。
契約データ抽出が重要な理由
数字は厳しい現実を物語っています。中堅から大企業は平均して24の異なるシステムにまたがって契約を管理しており、契約データは共有ドライブ、メール添付ファイル、レガシーリポジトリ、書類キャビネットに散在しています。「どのベンダー契約が来四半期に自動更新されるか」「上限なしの補償条項に対する総エクスポージャーはいくらか」といった疑問が生じたとき、答えを得るには各ファイルを開いてページごとに読む必要があります。1,300人の契約専門家を対象にしたCLOC調査によると、単一の契約書内の特定の文言を見つけるのに平均2時間以上かかります。適切な文書を特定するのに45分、関連セクションを特定するのにさらに84分かかります。年間500件の契約を扱う法務部門の場合、250営業日のうち188日が検索だけで消費されることになります。
下流でのコストも測定可能です。World Commerce & Contractingの調査によると、契約管理の不備により年間収益の9.2%が漏出し、上位企業は損失を3%に抑えている一方、後発企業は15〜20%もの損失を出しています。Juroの2026年調査では、自社の契約管理を「非常に効果的」と評価する企業はわずか11%で、Loioの2026年データでは、71%の企業が自社の契約の少なくとも10%を特定できないことが示されています。これらはテクノロジーの問題ではなく、データアクセスの問題です。情報は契約書の中に存在しています。ただ、構造化されておらず、検索可能でも可視化されてもいないだけです。
契約データ抽出は、このアクセス層を解決します。各契約書を読む代わりに、抽出機能は指定したフィールドと条項を読み取り、スプレッドシートの列に出力します。契約ごとに1行、要求された各データポイントがそれぞれのセルに入ります。かつて1件の契約につき2時間かけて更新日を見つけていたチームは、今では1つの列を並べ替えるだけで、今後90日以内に期限が切れるすべての契約を確認できます。ここでの根本的なスキルは読解ではありません。「2027年6月15日」が何を意味するかをAIに教えてもらう必要は誰にもありません。スキルとはスケールでの取得です。同じ12のフィールドについて50件、200件、500件の契約を読み取り、件数が増えても精度を落とさずに構造化された出力を提供することです。このプロセスの基礎となる概念については、契約データ抽出とは何か、および契約レビュー、OCR、CLMプラットフォームとの違いを参照してください。
契約書の抽出が特に難しい理由
請求書の抽出は比較的簡単です。合計金額は予測可能な場所にあり、請求書番号は認識しやすいラベルに従い、明細は一貫した列を持つ表を形成します。これらのパターンが成り立つのは、請求書ソフトが統一されたテンプレートを生成するからです。また、フォーマットが異なっても、請求書の構造(ヘッダー項目、明細、合計)はベンダーや国を問わず安定しています。
契約書は、これらの前提をすべて覆します。以下が、契約書が最も抽出困難な書類タイプである理由です。
長さと密度。 一般的な商用契約書は20~80ページです。雇用契約書は5~15ページ程度。複雑なベンダー基本契約書(MSA)に付属書や修正条項が加わると100ページを超えることもあります。請求書のように必要なデータが限られた場所に集中しているのとは異なり、契約データは文書全体に分散しており、その分布パターンは契約相手ごとに変わります。発効日は1ページ目の前文にあるかもしれません。更新条件は27ページの第14条にあるかもしれません。支払いスケジュールは付属書Bの3ページにわたる表かもしれません。最初の数ページだけを読んだり、各ページを独立した文書として扱うツールでは、本当に重要なデータを見逃してしまいます。
ページやセクションをまたぐフィールドの分散。 契約書のフィールドは密集しません。例えば準拠法という単一のデータポイントは、通常「雑則」または「一般条項」セクションの独立した条項に現れ、これは署名欄の前にある最後の実質的なセクションであることが多いです。つまり、40ページの契約書の35ページ目にあり、1ページ目の契約相手名から何百ものパラグラフも離れています。文書構造に対するフィールドの位置に依存するテンプレートベースの抽出ツール(「準拠法は『雑則』見出しの下にある」など)は、契約相手ごとに異なる起草慣行に対応できず、機能しません。
支払いスケジュールの表抽出。 多くの契約書には、散文テキストよりも抽出が難しい構造化された表が含まれています。料金スケジュール、マイルストーン支払いのタイムライン、関連金額付きの納品物リスト、リースの家賃 escalation 表などです。これらの表は複数ページにわたり、セル結合、不整合な列揃え、個々の項目を修飾する脚注があることがよくあります。従来のOCRは表の各ページを独立して扱うため、ページをまたぐ行が分割されます。契約書抽出ツールは、ページ区切りをまたいで読み取り、列の関連性を維持し、小計行とデータ行を区別する必要があります。これには、各セルの文字認識だけでなく、表の意味構造の理解が必要です。
相互参照を含む複雑な法律用語。 契約書の一文は次のようになることがあります:「第8.2条に別段の定めがある場合を除き、本条Xに基づく補償当事者の義務は、被補償当事者が第5.3条(b)(ii)項に基づく義務を遵守しなかったことに起因する損失には適用されないものとする。」この文は他の3つの条項を参照し、15ページ前で定義された用語を使用し、入れ子になった条件を含んでいます。「補償」のキーワード検索で該当セクションは見つかります。しかし、検索だけでは補償に上限があるか無制限かを判断できません。なぜなら、上限は別のセクションで異なる文言を使って定義されている可能性があるからです。抽出には、キーワードの存在を特定するだけでなく、相互参照構造を理解する必要があります。
取引先ごとに異なるフォーマット。 すべての契約書は異なる当事者によって作成されます。通常は取引先が作成するため、自社ではテンプレートを管理できません。Fortune 500企業のベンダーMSAは、ブティック企業のMSAとはまったく異なる形式です。カリフォルニアのテック企業が作成した雇用契約書は、テキサスの製造企業が作成したものとは構造と言葉が異なります。同じ組織内でも、3年前に締結した契約書と現在の契約書では、異なる法務チームが作成した異なるテンプレートが使われている可能性があります。ある契約書で機能した位置ベースの抽出アプローチは、次の契約書では黙って失敗します。信頼できる唯一のアーキテクチャは意味ベースの抽出です。つまり、テキストがページのどこにあるかではなく、テキストが何を意味するかを読む方法です。
従来のアプローチ vs AI抽出
この2年間の抽出技術の変化は、漸進的なものではなく、根本的なものです。それは、文書を理解するための2つのアーキテクチャの違いです。
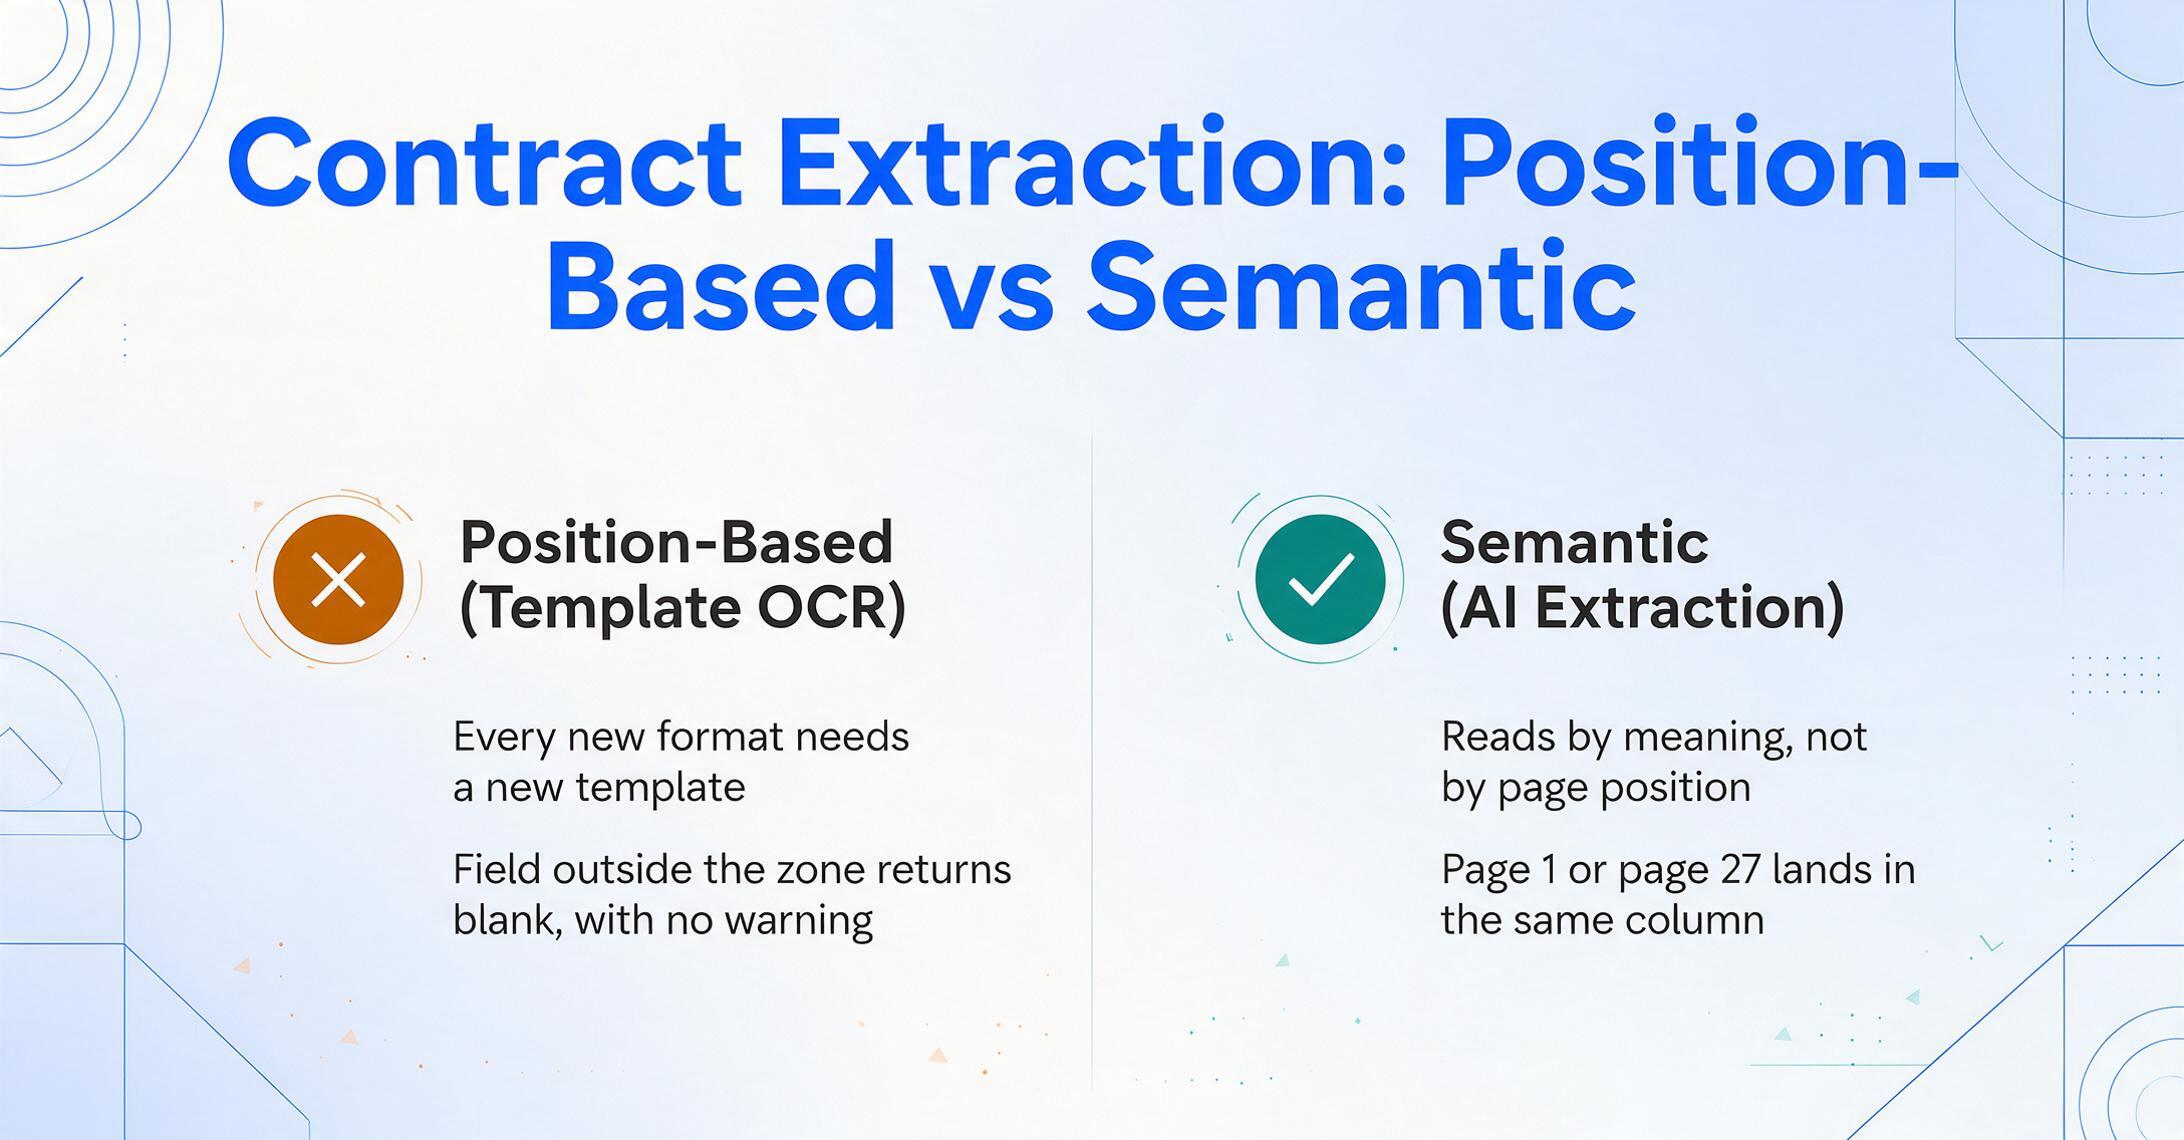
位置ベースの抽出 — 従来のアプローチ。 テンプレートOCRやゾーン抽出ツールは位置に基づいて動作します。「発効日」が表示されるページ上のゾーンを定義すると、ツールはそのゾーン内にあるテキストを読み取ります。このアプローチは、レイアウトが固定された文書(たとえば、単一のERPシステムからの標準化された請求書)には有効です。しかし、契約書の場合、2つの問題が発生します。第一に、新しい契約書フォーマットごとに新しいテンプレートが必要になり、フォーマットが変更されるとテンプレートのメンテナンスが必要になります。第二に、ツールは定義されたゾーン外のものはすべて認識できません。取引先が発効日を前文ではなくセクション1に置いた場合、ツールは何も返さず、何か問題が発生したという兆候もありません。
意味ベースの抽出 — AIアプローチ。 最新のAIベースの抽出は、位置ではなく意味で読み取ります。これがCustom Column Extractionです。出力に必要な列名を入力するだけです。「取引先」「発効日」「更新条件」「契約額」「準拠法」などと入力すると、AI(ビジョンベースの大規模言語モデル)が文書全体を読み取り、各フィールドの意味的役割を理解して対応するテキストブロックを特定し、各一致を正しい出力列にマッピングします。ある契約書の前文にある発効日も、別の契約書の27ページの修正条項に埋もれた発効日も、同じスプレッドシートの列に収まります。AIは発効日が何であるかを理解しており、通常どこにあるかではないからです。
パラダイムシフトは、「文書がデータの場所を定義する」から「あなたが欲しいものを定義し、AIがそれを見つける」へと移行しています。これは契約書にとって重要です。なぜなら、同じフォーマットを使う取引先は2つとないからです。テンプレートベースのツールは、テンプレートに一致する契約書のみを処理できます。意味ベースの抽出は、すべての契約書を処理できます。レイアウトではなく言語を読むからです。この技術シフトがさまざまな文書タイプにどのように適用されるかについて詳しくは、AI文書抽出の仕組みに関する解説をご覧ください。
実務上の違いは明確に測定できます。30社の異なる取引先との50件の契約をテンプレートベースのワークフローで処理する場合、30個のテンプレートの作成と維持が必要になり、テンプレートが完全に一致しない契約では抽出精度が低下します。セマンティック抽出ワークフローでは、12個の列名を一度定義するだけで、50件すべての契約を同じ抽出パスで処理できます。適応作業はユーザーではなくAIが契約ごとに行います。
契約抽出の課題のほとんどは、位置ベースかセマンティックかという1つのアーキテクチャ上の決定に起因します。位置ベースのツールは、契約の多様性に応じて拡大するメンテナンスが必要です。セマンティック抽出は多様性を自動的に処理しますが、AIがパターンマッチングだけでなく文書の文脈を真に理解することが求められます。評価対象のツールに、これまで取引したことのない取引先の契約を投入してテストしてください。新しいテンプレートが必要になるなら、それは抽出ではなくセットアップの負担を購入していることになります。
契約から抽出すべき主要フィールド
何を抽出するかは、なぜ抽出するかによって決まります。デューデリジェンスを行う法務チームは条項の有無と範囲を重視します。調達チームは支出コミットメントと更新日を重視します。人事チームは報酬、通知期間、競業避止義務を重視します。抽出スキーマはユースケースに合わせるべきであり、「念のため」すべてを抽出すると、誰も使わないノイズの多いスプレッドシートができあがります。
以下は、最も一般的な2つの契約カテゴリにわたって重要となるフィールドと、それぞれが列として価値を持つ理由です。
| 項目 | 重要性 | 商業契約/法的契約 | 雇用契約 |
|---|---|---|---|
| 当事者/契約相手方 | すべてのデータの基盤。契約相手が不明では、他の情報も活用不可。 | ベンダー名、クライアント法人、子会社の指定 | 従業員名、雇用主法人 |
| 発効日と契約期間 | 義務の開始・終了を確定。見逃すと期限切れを計算できない。 | 開始日、初期契約期間 | 入社日、試用期間終了日 |
| 契約金額/報酬 | 総コミット支出。財務は予測、調達は支出分析に必要。 | 総費用、年間契約額、単価 | 給与、賞与体系、株式報酬 |
| 支払条件とスケジュール | 資金移動の時期と方法。複数ページにわたる表が多く、抽出が最も困難。 | マイルストーン支払、ネット支払条件、請求頻度 | 給与支払頻度、経費精算ポリシー |
| 更新と解約 | 見逃しが最も高くつく項目。自動更新の見落としで不利な条件が1年延長。 | 自動更新トリガー、通知期間、都合解約 | 退職通知期間、解約条件、ガーデンリーブ |
| 準拠法と管轄 | 適用される州・国の法律と訴訟地を決定。ポートフォリオ全体のリスク集中分析に必要。 | 準拠法、裁判地、仲裁条項 | 準拠州法、紛争解決方法 |
| 主要義務と成果物 | 各当事者のコミットメント。義務の抽出で契約を説明責任ツールに。 | サービス範囲、SLA、期限付き成果物 | 職種、職務内容、報告体制 |
| 責任と補償 | リスクエクスポージャー。どの当事者がどのリスクを、上限いくらまで負うか。 | 責任上限、補償範囲、保険要件 | 競業避止範囲、秘密保持、知的財産権譲渡 |
商業契約と雇用契約の違いは、抽出対象が異なるため重要です。商業MSAと雇用契約書にはどちらも「日付」と「当事者」が含まれますが、意思決定を左右するフィールドは異なります。雇用契約には「責任制限の上限」はありませんが、「試用期間」や「競業避止の範囲」があり、これらは組織にとって同様に重要です。ヘッダーレベルではなく条項レベルのフィールドについては、法的契約抽出のガイドをご覧ください。これは、契約ポートフォリオ全体にわたって補償、不可抗力、仲裁条項などの特定の条項を識別することに焦点を当てています。また、多くの契約書から特定の個別フィールドを抽出する必要があるチームには、契約書からの特定フィールドの抽出が対象を絞ったアプローチを説明しています。
バッチ処理:ポートフォリオからスプレッドシートへ一括変換
単一契約の抽出は、署名前に1件の契約書を確認するのに役立ちます。しかし、抽出の真の価値はバッチ処理で発揮されます。契約書ポートフォリオをアップロードして、1つの統合スプレッドシートを受け取るという処理です。これこそが、契約データを見えないものから実行可能なものへと変えるワークフローです。
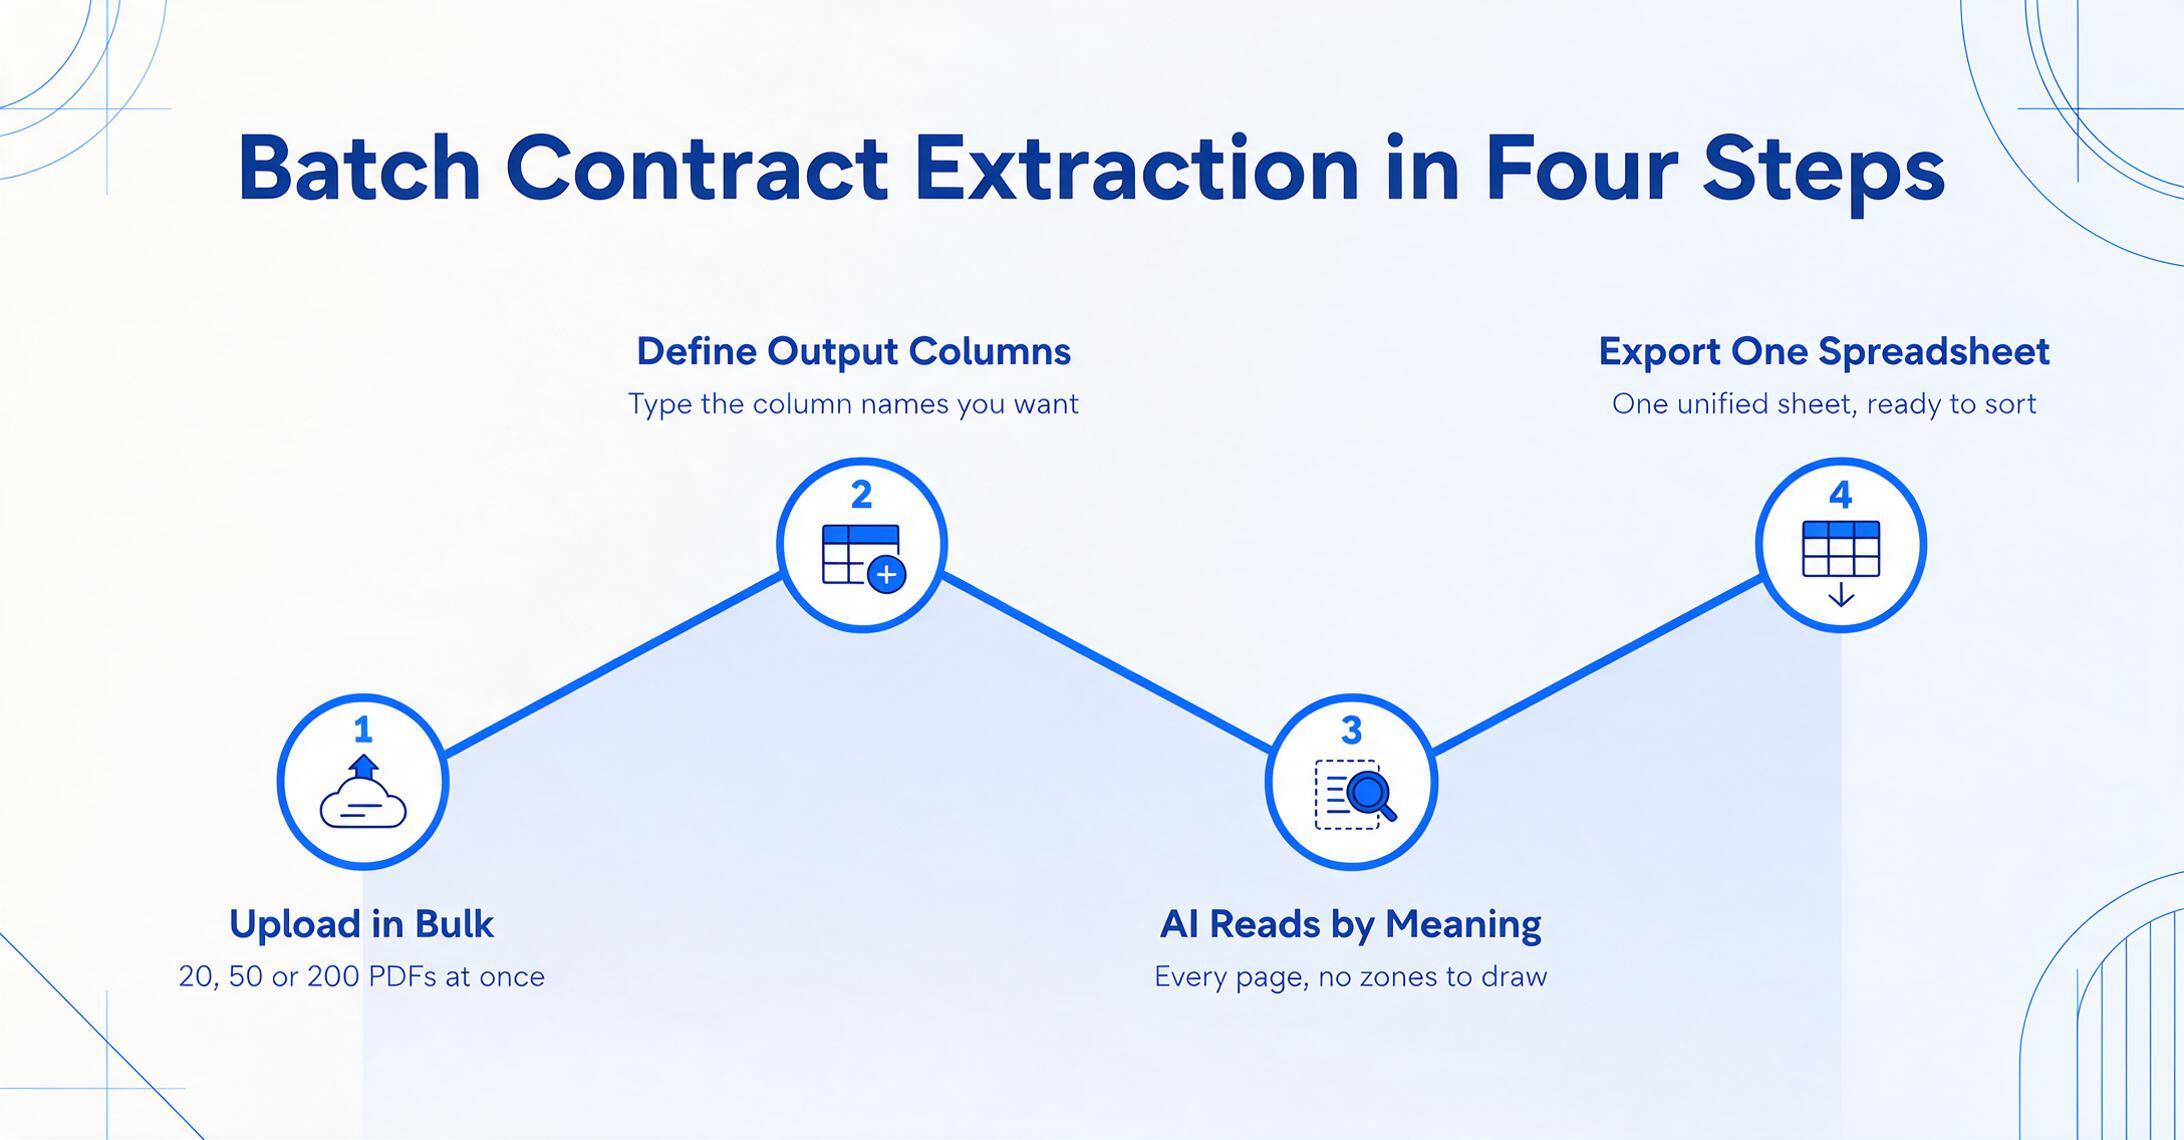
契約抽出のバッチワークフローは、次の4つのステップで構成されます。
契約書を一括アップロード
PDFをドラッグ&ドロップするだけ — 20件、50件、200件でも一度に処理できます。電子署名済みPDF、スキャンした契約書、Word文書をPDFに変換したもの — すべてまとめて取り込めます。ベンダーごとの事前仕分け、ファイル名の変更、フォルダ整理は一切不要です。ツールが各ファイルをフォーマットに関係なく個別に読み取ります。
出力列を定義
スプレッドシートに必要な列名を入力します:「契約相手」「発効日」「更新日」「契約金額」「準拠法」「支払条件」「責任上限」。これらが出力ファイルのヘッダーになります。契約タイプごとのテンプレート設定、サンプルページへの領域指定、ラベル付きデータでの学習は不要です。必要な項目を定義すれば、AIが各文書からそれを見つけ出します。
AIが意味を理解して全契約書を読み取る
ビジョンモデルが各契約書の全ページをスキャンし、各要求フィールドに一致するテキストを意味的役割を理解して特定し、正しい列にマッピングします — ページ位置、条項番号、作成スタイルに関係なく。準拠法条項がある契約書では3ページ目、別の契約書では42ページ目にあっても、両方の値が「準拠法」列に格納されます。別紙の3ページにまたがる支払スケジュールも、断片的なテキストブロックではなく、一貫したテーブル行として抽出されます。
エクスポートまたはスプレッドシートに書き込み
統合スプレッドシートをExcel(XLSX)、CSV、JSONとしてダウンロード — または結果をGoogle Sheetsに直接書き込みます。各契約書が1行になり、各フィールドが専用の列になります。更新日で並べ替えて次四半期に期限切れとなる契約を特定。準拠法でフィルタリングして特定の法域の契約を抽出。契約相手でピボットしてベンダー別の総支出を確認。複数の契約タイプが混在するポートフォリオでの契約書からExcelへの完全なワークフローについては、契約データ抽出からExcelへのページをご覧ください。継続的な契約ポートフォリオ管理と更新追跡を行うチーム向けには、一括契約更新・期限追跡をご参照ください。
ファイルは安全に処理され、保存されることはありません。
エクスポートと連携:抽出した契約データの活用法
抽出した契約データのスプレッドシートは、それ単体でも有用です。しかし、契約に関する意思決定が行われるシステムに取り込むことで、さらに価値が高まります。
ExcelやGoogle Sheetsでの即時分析。契約が行になり、項目が列になれば、あらゆるスプレッドシート操作が契約管理の操作になります。更新日で降順に並べ替えれば、最も早く期限を迎える契約がわかります。準拠法=「カリフォルニア」でフィルタリングすれば、管轄区域固有の義務を確認できます。取引先ごとのピボットテーブルを作成すれば、ベンダーごとの総コミット支出額を把握できます。これまで200件のPDFを開く必要があった作業が、他のデータセットと同じ操作で完了するようになります。
CLMや契約リポジトリへの取り込み。組織がContract Lifecycle Managementプラットフォームを利用している場合、抽出データは移行の燃料となります。CLM導入で最も一般的な障害は、既存の契約書からシステムにデータを投入することです。手作業でのデータ入力が代替手段となる場合、このステップがプロジェクトを停滞させます。抽出は、「フォルダに500件の契約がある」状態から「システムに構造化データがある」状態へのギャップを埋め、パラリーガルが入力作業を行う必要をなくします。本格的なCLMが必要かどうかを検討中の組織には、エンタープライズ契約プラットフォームなしの文書抽出が、軽量な抽出ツールで十分なケースを解説しています。
カレンダーとアラートの連携。抽出された日付(更新日、解約通知期限、料金改定時期など)は、カレンダーシステムや自動アラートに連携できます。更新を90日前に把握した場合と、自動更新の1週間後に気づいた場合の差は、多くの場合、年間契約額全体に相当します。小規模事務所や個人開業の弁護士向けには、個人弁護士向けの手頃な契約抽出で、日付管理の費用対効果の高いアプローチを紹介しています。
部門横断的なアクセス。契約データは法務部門だけの資産ではありません。調達部門は支払条件と支出コミットメントを確認する必要があります。経理部門は契約額を accrual 計算や予測に使用します。営業部門は、どの顧客契約に独占条項が含まれているかを把握する必要があります。抽出データがPDF内ではなくスプレッドシートに格納されていれば、契約に触れるすべての部門が、法務部門による要約を待つことなくアクセスできます。条項の特定を目的として契約を一括処理するチーム向けには、中小法律事務所向けの一括契約条項抽出で、条項レベルのワークフローを解説しています。
契約抽出ツールの選び方
抽出ツールは、基本的なOCRラッパーからAIネイティブなプラットフォームまで多岐にわたります。特に契約書——最も難しい文書タイプ——の場合、選定基準は請求書やフォームよりも厳しくなります。実際に機能するツールと、常に手助けが必要なツールを区別する5つの基準は次のとおりです。
評価基準ではなく特定のベンダー間で比較検討している場合は、9つの契約抽出ツールの比較をご覧ください。Kira、Ironclad、Juro、Docparserなどを取り上げ、ベンダーごとのテンプレート設定なしでフィールドデータをスプレッドシートに出力できるかどうかも解説しています。
1. テンプレート不要・トレーニング不要の運用。ベンダーごとにテンプレートを作成したり、サンプル契約書でモデルをトレーニングする必要がある契約抽出ツールは、抽出ではなくテンプレート管理です。そして、最も必要な瞬間——新しい取引先から見たこともない形式の契約書が届いたとき——に機能しなくなります。どのベンダーにもこう聞いてください。「これまで取引のない取引先から、見たこともない形式で作成されたMSAを渡した場合、セットアップなしで初回から取引先名、発効日、準拠法、契約終了条件を抽出できますか?」答えにテンプレート作成、モデルのトレーニング、抽出領域の定義が含まれているなら、それは設定のオーバーヘッドを買っていることになります。
2. 別紙や修正条項にも対応した全文書の読み取り。契約書は長文であり、必要なデータが1ページ目にあることはまれです。支払いスケジュールは別紙にあります。修正条項は本文の条項を上書きします。最初の数ページしか読まない、または各ページを独立して処理するツールは、別紙Bの料金表や修正条項1の更新された更新条項を見逃します。最も短い契約書ではなく、3つの別書と2つの修正条項が付いた最も長い契約書でテストしてください。
3. 複数ページにわたる支払いスケジュールを処理できる表抽出。料金表、マイルストーン支払い、賃料増額表は、ページをまたぎ、結合セルや不規則なレイアウトがあるため、最も難しい抽出課題です。多くのツールは契約金額を単一の数値として抽出できますが、その下にある12行の支払いスケジュールでは失敗します。表が最も多い契約書でこれをテストしてください。ツールが「契約金額:$150,000」を返しても、支払いスケジュールを構造化された行として出力できない場合、それはデータの一部しか提供していません。
4. 統一出力によるバッチ処理。ワークフローが重要です。50件の契約書を一度にアップロードして、1つのスプレッドシートを取得できますか?バッチ処理は、「このツールは契約書ごとに時間を節約する」と「このツールはポートフォリオ全体を処理する」の違いです。出力は単一のテーブル——契約書ごとに1行、すべてのフィールドが列に——で、手動での結合なしにすぐに分析できる状態であるべきです。
5. マーケティング数値ではなく、正直な精度。契約書における「99%の精度」は、通常、クリーンなデジタル生成PDFのTier 1ヘッダーフィールド(当事者、日付)を指します——最も簡単な抽出ケースです。条項レベルの抽出(補償範囲、不可抗力のトリガー)と表の抽出(支払いスケジュール)はより難しく、信頼できるベンダーは、どのフィールドタイプがどの精度で抽出されるかを伝えるべきです。唯一意味のある精度テストは、自社の契約書——特に厄介なもの:2015年のスキャン契約書、手書きの修正条項が付いた契約書、馴染みのない取引先からの複数別書のMSA——で実行することです。デモで最悪の文書でテストさせてくれないベンダーは、それが精度の上限です。
抽出ツールが多様な契約ポートフォリオ全体で条項識別という特定の課題にどう対応するかについて詳しくは、法的契約抽出の内容をご覧ください——フィールドレベルの契約抽出に対する条項レベルの対応です。
よくある質問
データ抽出はどのような種類の契約書に対応できますか?
最新の抽出ツールは、MSA、SOW、NDA、雇用契約、賃貸契約、ベンダー契約、SaaSサブスクリプション、販売店契約、エンゲージメントレターなど、あらゆる契約書に対応します。テンプレートではなく意味に基づいて読み取るため、契約の種類ごとに設定を変える必要はありません。実用上の制限は契約数ではなく多様性です。50種類の異なる契約を50社と交わしても、同じテンプレートの契約書を50件処理するのと同様に正確に抽出できます。
デジタルPDFだけでなく、スキャンしたPDFでも抽出できますか?
はい — 抽出ツールがテキストレイヤーのOCRだけでなく、ビジョンベースのAIを使用している場合に限ります。ビジョンベースのツールはページの見た目を読み取るため、2012年のスキャン契約書も、先週のデジタル署名付きPDFも、印刷された条件書のスマホ写真も、同様に処理できます。制限要因は画質です。人間が読むのも難しいほど薄い、歪んだ、低解像度のスキャンではAIも同様に困難です。ある程度読めるスキャンであれば、デジタルPDFと同等の精度が得られます。
契約書抽出は弁護士のレビューを代替できますか?
いいえ — その境界線を明確にすることが重要です。抽出は契約書を読み取り、当事者、日付、金額、条項内容などの構造化データを出力します。レビューはリスク評価、条件交渉、署名判断を行います。抽出が代替するのは「検索」のステップです — 分析を始める前に条項を探すのに費やす84分のことです。弁護士は依然として分析し、助言します。しかし、無制限の補償条項がある契約書を探すために50件の契約書を読む代わりに、抽出がその5件を事前に特定し、弁護士は文書検索ではなく法的判断に時間を使えるようになります。
契約書データ抽出の精度は人間のレビューと比べてどうですか?
第1層のヘッダーフィールド — 当事者名、発効日、準拠法 — では、最新のAI抽出は明確で読みやすい契約書で95~99%の精度を達成します。第2層の財務フィールド — 支払スケジュール、複雑な料金体系からの契約金額 — では、契約書ごとの表現の違いから精度は低く、通常85~95%です。条項レベルの抽出 — 補償条項に上限があるか無制限かの識別 — では精度は80~90%で、契約書の明確さに大きく依存します。高額または高リスクの契約書では、抽出結果を人間がレビューするのが適切な方法です。効率性の向上は、200件の契約書をゼロから読むのではなく、事前に入力されたスプレッドシートをレビューすることにあります。
1回のバッチで処理できる契約書の数は?
最新のバッチ処理ツールは、1回のアップロードで数十から数百の契約書を処理できます — ファイル数に厳密な上限はありません。実用的な制約は処理時間です。各契約書の処理に数秒かかるため、100件の契約書では長さにもよりますが10~20分かかる場合があります。出力は、1行が1契約書に対応する1つの統合スプレッドシートです。代替手段 — 各ファイルを開き、個別にデータを抽出し、手動で結果を統合する — は、自動化の目的を無効にするワークフローです。
修正条項や別紙がある契約書でも抽出は可能ですか?
はい、ツールが文書全体を1つの論理単位として読み取れる場合に限ります。複数文書の契約(MSA+SOW+2つの修正条項)では、ファイルをまたいで読み取り、修正条項を親契約に関連付ける必要があります。抽出時には、修正条項で更新された解約日が原本より優先されることや、別紙Bの料金表が同一契約の支払条件の一部であることを認識する必要があります。各ファイルを独立して処理し、文書間の関連性を考慮しないツールでは、矛盾する日付や不完全な支払データが出力されます。
契約データ抽出は契約ライフサイクル管理(CLM)と同じですか?
いいえ。CLMプラットフォームは、作成、交渉、締結、保管、義務追跡といった契約の全行程を管理し、通常は自社データベースへの入力のために抽出機能を備えています。抽出はデータ処理のステップであり、契約書を読み取り構造化フィールドを出力します。CLMはワークフローのステップであり、その前後のプロセスを管理します。抽出はCLMにデータを供給することも、完全なCLMプラットフォームを導入せずに構造化契約データを必要とするチームが独立して運用することも可能です。両者は補完関係にあり、競合するものではありません。
補償条項と責任制限条項のような類似条項を抽出で区別できますか?
一般的には、明確に異なる条項であれば可能です。補償条項(一方が相手方の損失を補償することに同意する)と責任制限条項(一方が回収できる金額に上限を設ける)は、異なる法的文言と目的を持ちます。最新のAI抽出ツールはこれらを区別できますが、両方の条項が同じセクションに含まれていたり、複雑な定型句に織り交ぜられていたり、契約書の他の部分の定義を相互参照している場合には精度が低下します。このようなケースでは、AIによる条項分類を人間が確認することが適切な方法です。
「フィールド」と「条項」の抽出の違いは何ですか?
フィールドは、スプレッドシートの1つのセルに収まる個別のデータポイントです。相手先名、発効日、契約金額などが該当します。条項は法的テキストのブロックであり、補償条項の全文、不可抗力の定義、支払条件セクション全体などが該当します。フィールドの抽出は「契約金額はいくらか?」という質問に答え、条項の抽出は「補償条項の正確な文言を見せて」という要求に応えます。ほとんどの抽出ツールは両方に対応できますが、条項抽出はより困難です。特に、関連する条項が複数のセクションにまたがって織り込まれている契約書では、AIが条項の開始位置と終了位置を判断する必要があるためです。
契約データを見える化する
データはすでに契約書の中にあります。問題は「存在しないこと」ではなく「アクセスできないこと」です。締結済みのすべての契約書には、取引先名、日付、金額、義務など、ビジネス上の意思決定を支える情報が含まれています。しかし、そのデータが共有ドライブのPDFの中に眠っている限り、それを必要とするシステムや人々からは見えません。World Commerce & Contractingの調査結果——契約管理の不備による収益漏れ9.2%——は、契約書自体が悪いという話ではありません。データがスプレッドシートに反映されなかった良い契約書の話なのです。
契約データ抽出は、そのギャップを埋めます。CLMの導入は不要です。数ヶ月にわたるテンプレート設定も不要です。必要なのは「どのフィールドが必要か」という問いだけ。それを構造化された列として提供し、並べ替え、フィルタリング、アクションに活用できます。チームが数十件以上の契約を管理し、ファイルを横断して特定の条項を探すのに日々時間を費やしているなら、抽出は「開いて読む」から「フィルタリングして判断する」へとワークフローを変える、たった一つのステップです。
まずは契約データ抽出の基礎ガイドで全体像を理解するか、サンプル契約書をアップロードして、自社の文書でフィールドレベルの抽出がどのように機能するかをご確認ください——テンプレートもトレーニングもセットアップも不要です。