WeChatチャットのスクリーンショットから
中国の配送先住所と電話番号を読み取る
WeChatで販売している方 — 微商(ウェイシャン)セラー、代購(ダイゴウ)の個人ショッパー、またはチャットで直接注文を受ける小規模ビジネスオーナー — なら、この瞬間をご存じでしょう。顧客が配送情報を1つのメッセージで送ってきます。「广东省深圳市南山区科技南路18号 李明 13800138000」— 省、市、区、路、建物番号、受取人名、携帯電話番号が、すべて途切れのない1行にまとめられています。注文を処理するために必要な情報はすべてそのメッセージに含まれています。唯一の問題は、それらが別々のフィールドに分かれて届かないことです。住所を読み、名前を覚え、電話番号をコピーし、それぞれを自分の注文システムに入力する — または手書きで荷物に書く。毎回の注文、毎回の顧客、毎回のことです。
重要なポイント
- 中国の配送先住所はWeChatでは1つの途切れない行として届く — 省、市、路、建物番号、受取人名、電話番号が、カンマも改行もフィールドラベルもなくすべて並んでいる。
- 従来のOCRは文字列全体を1つのテキストブロックとして出力する — 市名がどこで終わり、番地がどこから始まるのかを判別できない。なぜなら、エンジンにとってはすべてが漢字の文字だからだ。
- 配送先住所、受取人名、電話番号の列を定義する — AIは省、路などの構造マーカーと、メッセージの最後に必ず来る11桁の携帯電話番号パターンを認識して文字列を分割する。
WeChatの住所メッセージの実際の見え方
WeChatのチャットで送られる典型的な中国の配送先住所は、ビッグエンディアン方式の階層構造になっています。最も大きな地理単位が最初に、最も小さな単位が最後に来て、その後に受取人の名前と電話番号が続きます。完全なメッセージは次のようになります。
浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678
浙江省杭州市西湖区文三路478号华星科技大厦12階1208室 — 王芳 — 13812345678
この1つの文字列から、人間の読者は瞬時に6つの異なるデータポイントを識別します。省、市、区、番地と建物(路/号/楼/室)、受取人、携帯電話番号です。住所には構造があります。中国の住所形式は世界で最も一貫した階層型郵便システムの一つですが、その構造は完全に単語の意味の中に存在しており、視覚的な区切りは一切ありません。改行も、列の区切りも、フォームフィールドもありません。漢字と数字が連続した1つのブロックがあるだけです。
住所は完璧に構造化されています。ただ、構造化されて見えないだけです。そして、まさにそれが従来のOCRが最も苦手とする入力なのです。
同じ形式は、あらゆるWeChat注文シナリオで繰り返し現れます。WeChat販売者(微商(ウェイシャン))から服を購入する顧客は、住所を1つのメッセージで送ります。代購(ダイゴウ)の購入者は同じ方法で配送情報を確認します。WeChat経由で配送指示を受け取るレストランの仕入先も、同じ種類のテキスト(省から電話番号まで、すべて1つのブロック)を受け取ります。誰が送ったかに関わらず、内容は同じです。地理的階層+名前+電話番号、すべてが1つの文字列に連結されており、人間は0.5秒で解析できる一方、機械はそれを1つの未分化なテキストの塊として誤読します。
階層構造の問題 — フラットな文字列は住所ではない
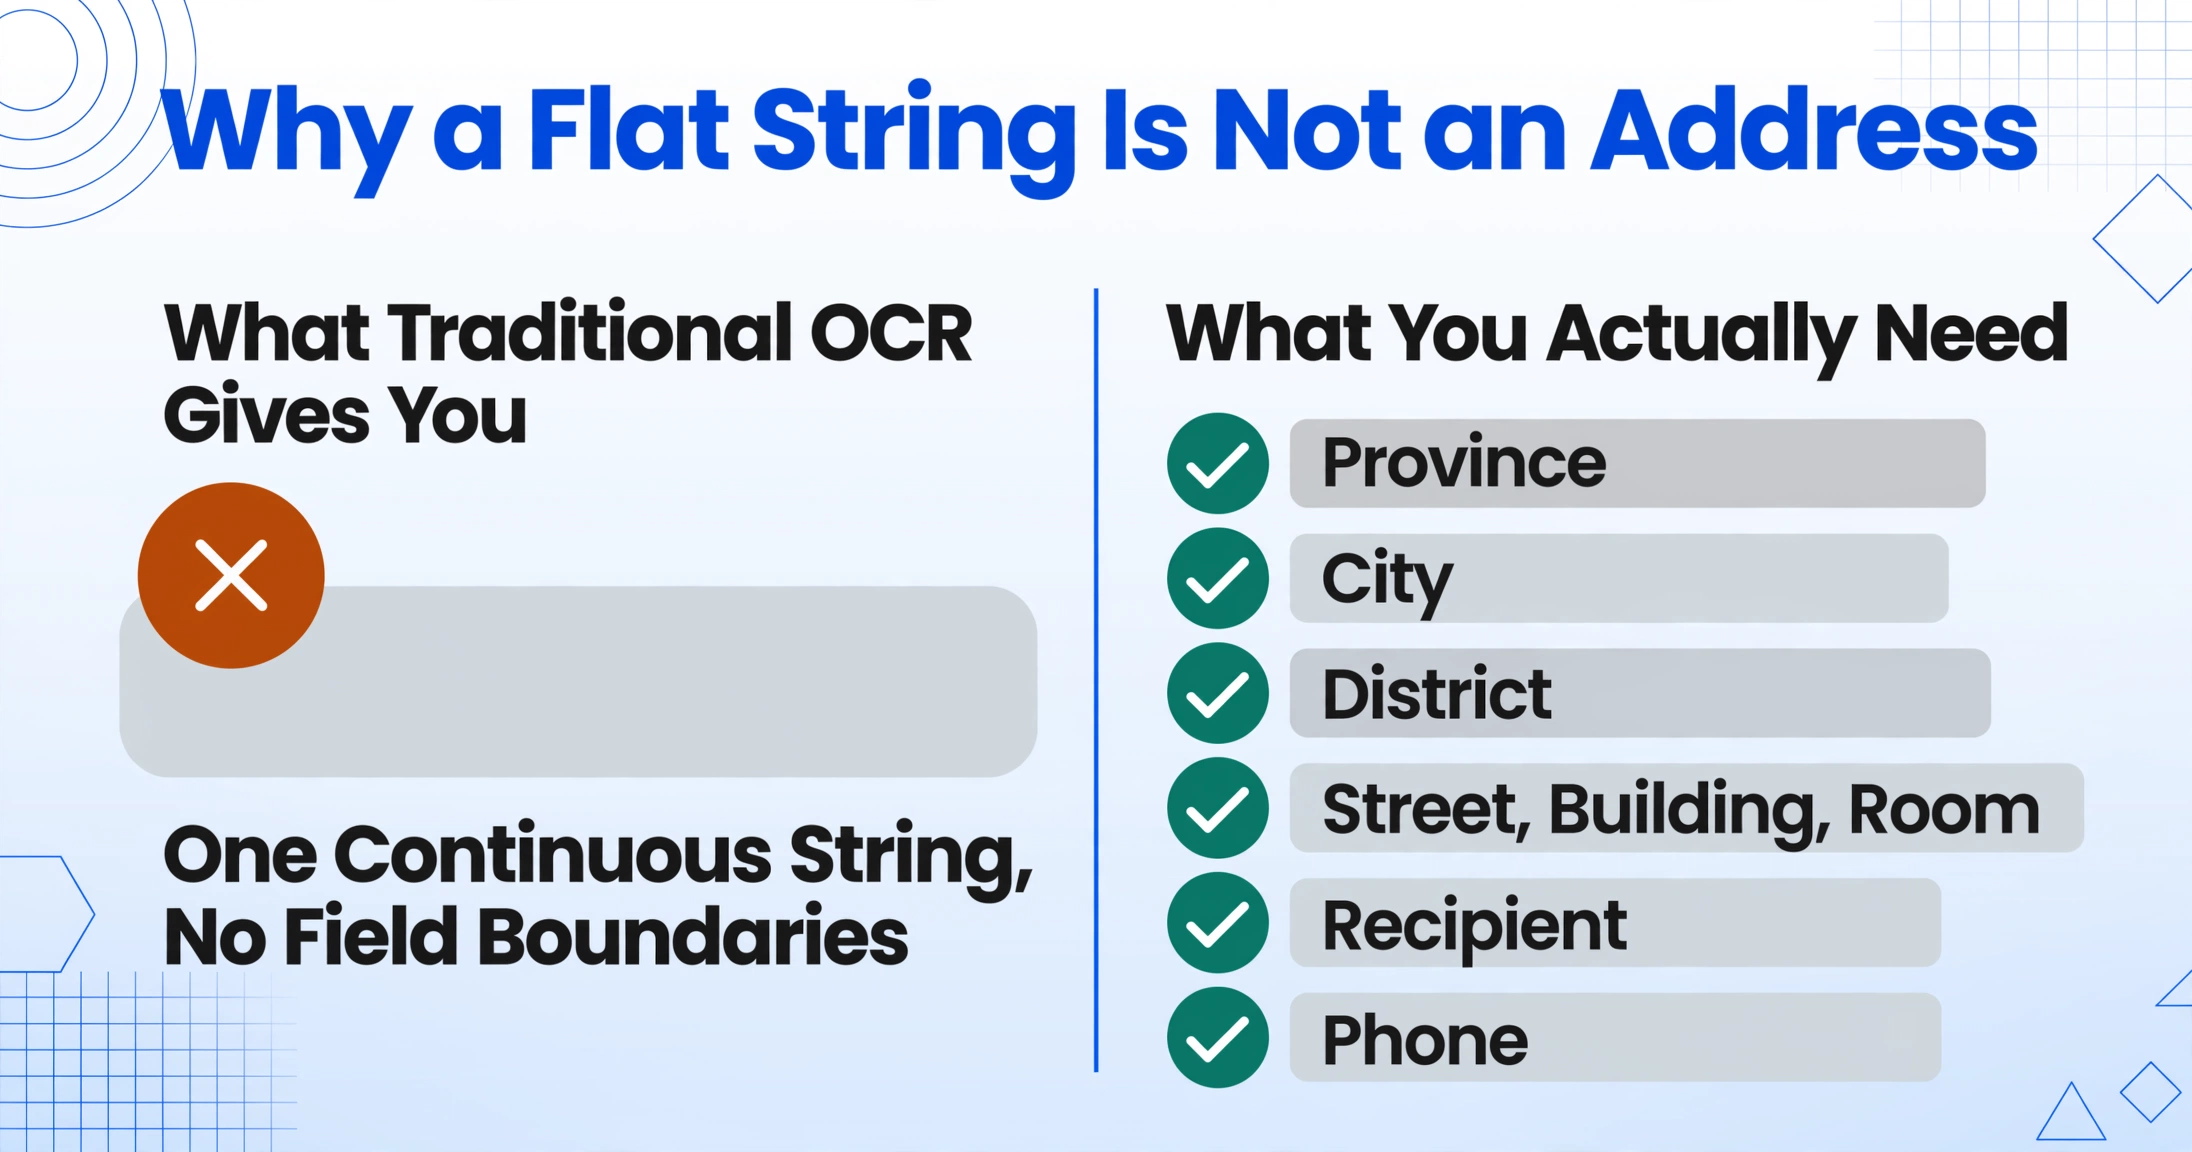
難しいのは、漢字の認識が困難なことではありません。最新のOCRは印刷された中国語を高い精度で読み取ります。文字認識の技術は何年も前から信頼性が高いものです。難しいのは、中国の住所が文字の並びではなく、文字の並びとして表現された階層構造であることです。従来のOCRは文字列全体を1行のテキストとして扱います。「浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678」を単一のフィールドとして出力します。つまり、意味的な区切りがない1つの連続した文字列です。
| 実際に必要なもの | 従来のOCRが出力するもの |
|---|---|
| 省: 浙江省 | 「浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678」 |
| 市: 杭州市 | |
| 区: 西湖区 | |
| 住所: 文三路478号华星科技大厦12楼1208室 | |
| 受取人: 王芳 | |
| 電話番号: 13812345678 |
住所が完全な形式でない場合、問題はさらに複雑になります。顧客が同じ省内の販売者から注文する場合、省を省略することがあります。「杭州市西湖区文三路478号」のように「浙江省」を省くケースです。また、市と区だけを記載する場合もあります。「深圳南山科技南路18号」— 省を省き、区のよく知られた略称を使用します。建物名を省略し、番地と近くのランドマークだけを記載する住所もあります。従来のOCRは、それが住所であること自体を認識しないため、これらのバリエーションを正規化する方法がありません。
最も分離しやすいように見える電話番号にも、住所ブロック内に独自の落とし穴があります。中国の携帯電話番号は1で始まる11桁です。単独では明確なパターンです。しかし、住所文字列の末尾にあり、その文字列に建物番号(「12楼」や「1208室」など)も含まれている場合、単純にすべての数字の並びを抽出するツールは、「478」(建物番号)、「12」(階数)、「1208」(部屋番号)、「13812345678」(実際の電話番号)をすべて取得してしまう可能性があります。どの数字グループが電話番号で、どれが住所の構成要素かを判断する方法がありません。
電話番号のパターン(11桁、1で始まる)は人間には簡単に見分けられますが、住所を見ていることを理解しないツールは、ページ上のすべての数字を取得して、すべてを「データ」と呼んでしまいます。
ビジュアルAIが同じスクリーンショットを異なる方法で読み取る仕組み
ここで抽出アプローチは文字認識から意味理解へと移行します。スクリーンショット内のすべてのテキストをスキャンしてフラットなブロックとして出力する代わりに、ビジュアルAIツールは「これはどのような情報で、各部分はどこに属するのか」と問いかけながら画像を読み取ります。
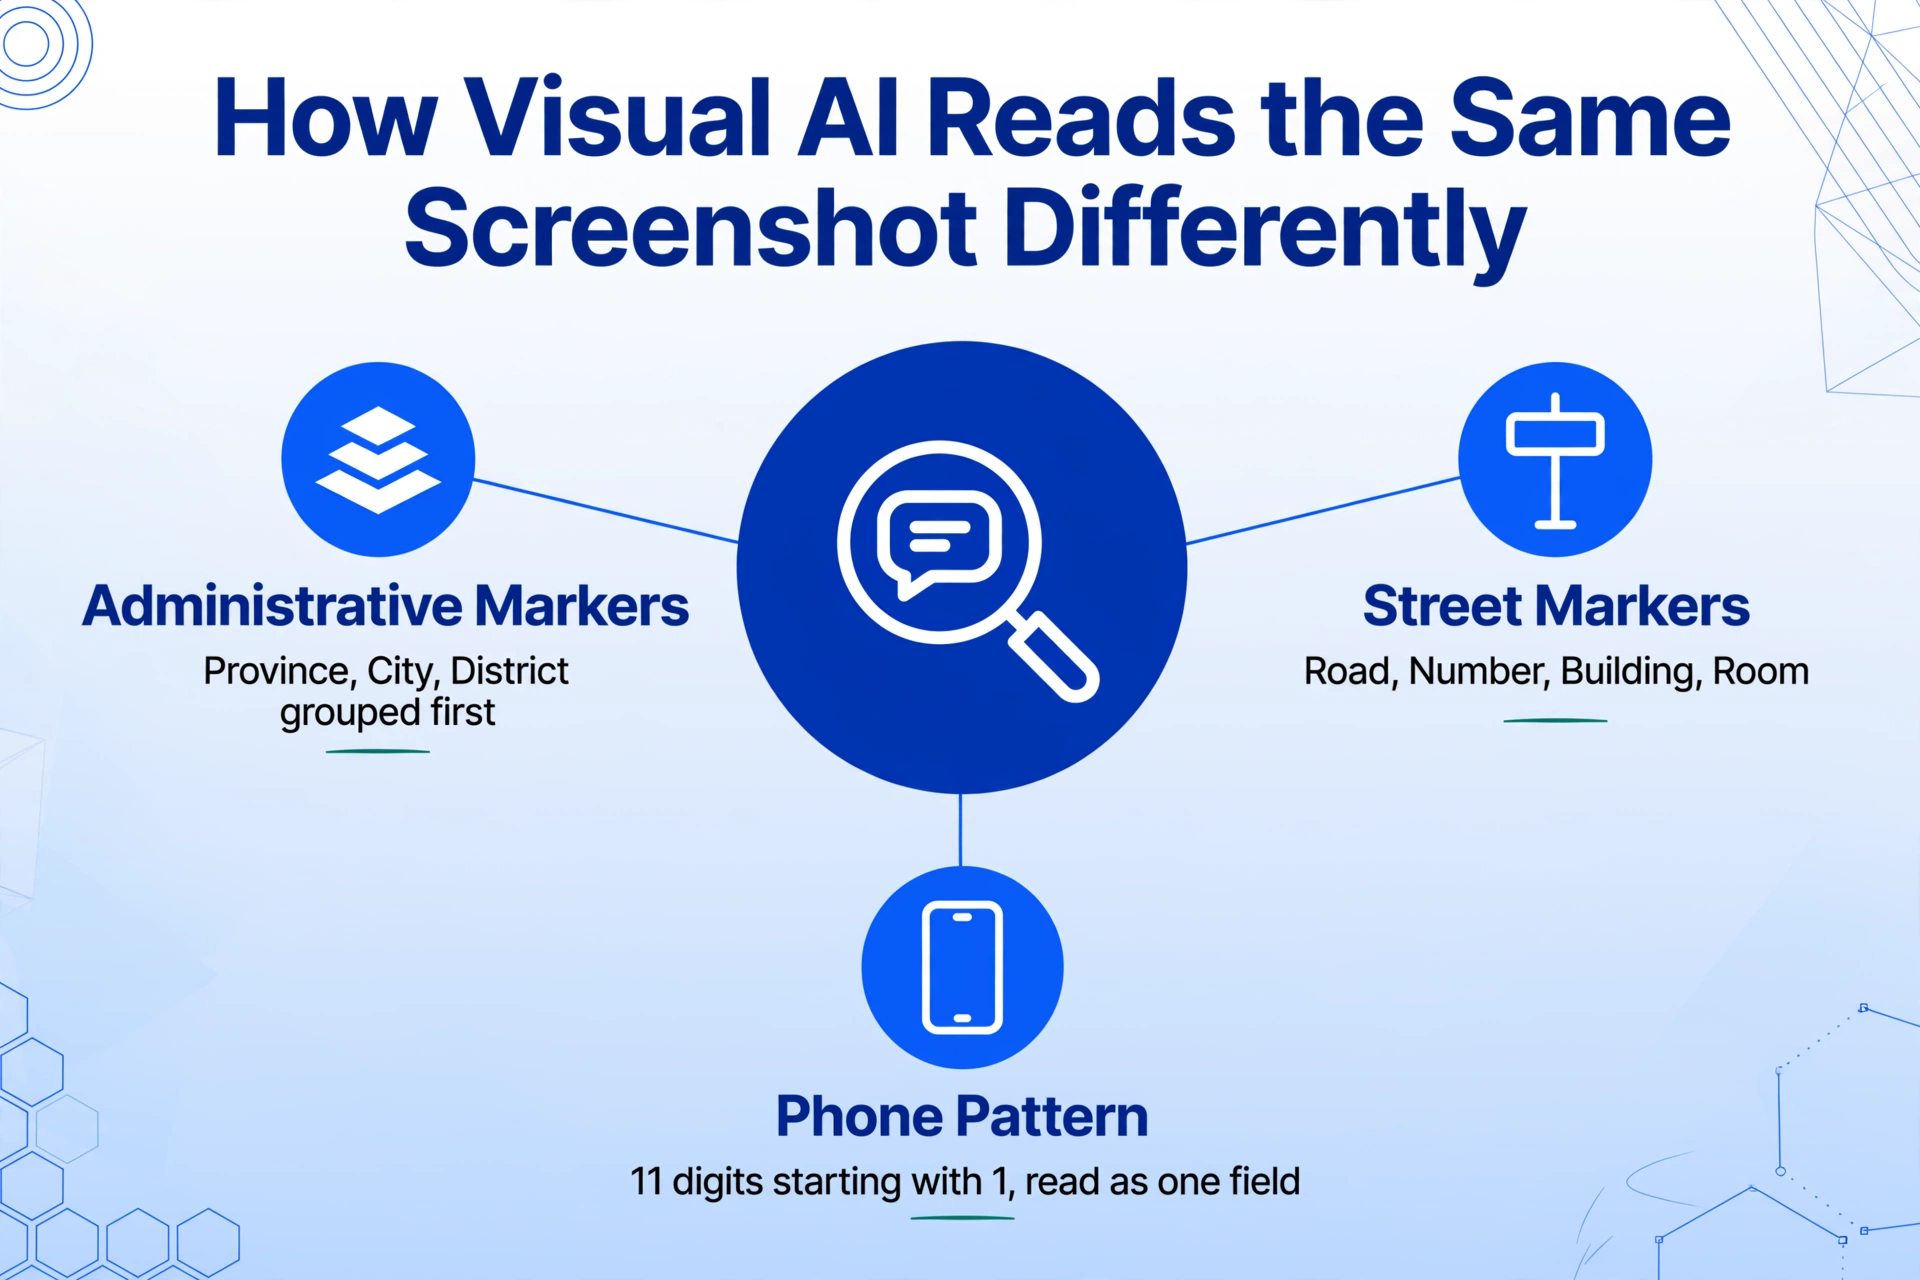
カスタム列抽出を使用すると、「配送先住所(收货地址)」「受取人(收件人)」「電話番号(联系电话)」など、必要な列を定義するだけで、AIは中国の住所形式の文脈における各部分の意味を理解して、一致する値を特定します。省が省を表し、路が道路名を表すことを教える必要はありません。中国の住所の構造文法を理解しているため、これらのマーカーを識別できるのです。中国の地理を学んだことがなくても「浙江省」が省だと直感的にわかるのと同じです。
意味ベースのアプローチが住所ブロックの各構成要素をどのように処理するかは次のとおりです。
AIは省・市・区/県を行政区分の境界キーワードとして識別します。認識された住所の先頭から最初の道路マーカーまでを上位の行政区域としてまとめます。省が省略されている場合(同一省内の注文でよくあるケース)は、市名を最上位の基準として使用します。
路(道路)、街(通り)、大道(大通り)、号(番号)、楼(建物)、幢(棟)、室(部屋)などのマーカーが詳細住所を区切ります。AIはこれらのマーカーの並びを読み取り、完全な番地レベルの住所を再構築します。形式が異なる場合でも対応可能です。「XX路XX号XX楼XX室」という形式もあれば、「XX路XX号XX大厦XX層」という形式もあります。
中国語の名前は通常2〜3文字で、住所の後、電話番号の直前に表示されます。AIは住所マーカーから名前ブロックへの移行を認識します。名前とは、最後の住所要素(室、号、または建物名)と11桁の電話番号の開始位置の間に残る部分です。
1で始まる11桁の携帯電話番号パターンは、文字列全体の中で最も信頼性の高い区切り目です。AIはパターンと位置の両方からこれを識別します。住所ブロック内で常に最後の数字列であり、建物番号(より短く、号や楼の隣の文字列中盤に現れる)とは明確に区別されます。
このアプローチが機能する理由は、AIがスクリーンショットに表示されている市名や道路名を正確に知る必要がないからです。その位置にある何かが市として機能し、何かが道路として機能し、何かが電話番号として機能することを理解すればよいのです。抽出は、中国の住所形式において各セグメントが果たす構造的な役割に基づいて行われます。この形式は、地域による違いはあるものの、世界で最も一貫性のある郵便住所の階層構造のひとつです。
正式な領収書ではない支払いスクリーンショットからデータを抽出する場合と同じ原則がここでも適用されます。出力列を定義すると、AIはテンプレートを照合するのではなく、意味を理解することでスクリーンショット上の該当する値を特定します。入力がWeChat Payの確認画面であれ、配送先住所が書かれたチャットメッセージであれ、方法は同じです — 意味による抽出は、位置ではなく意味を読み取ります。
WeChat注文の一括処理
WeChat販売者は、注文を一度に1件受け取るわけではありません。忙しい日には、チャットログに複数の顧客からの住所メッセージが並びます。それぞれ名前も都市も配送指示も異なります。10件の住所を手入力するということは、10件のメッセージを読み、10件の電話番号をコピーし、10件の名前を注文シートや荷札に入力することを意味します。その作業は毎回同じで、ミスのパターンも毎回同じです。電話番号の数字の打ち間違い、番地の読み間違い、区の取り違えなどです。
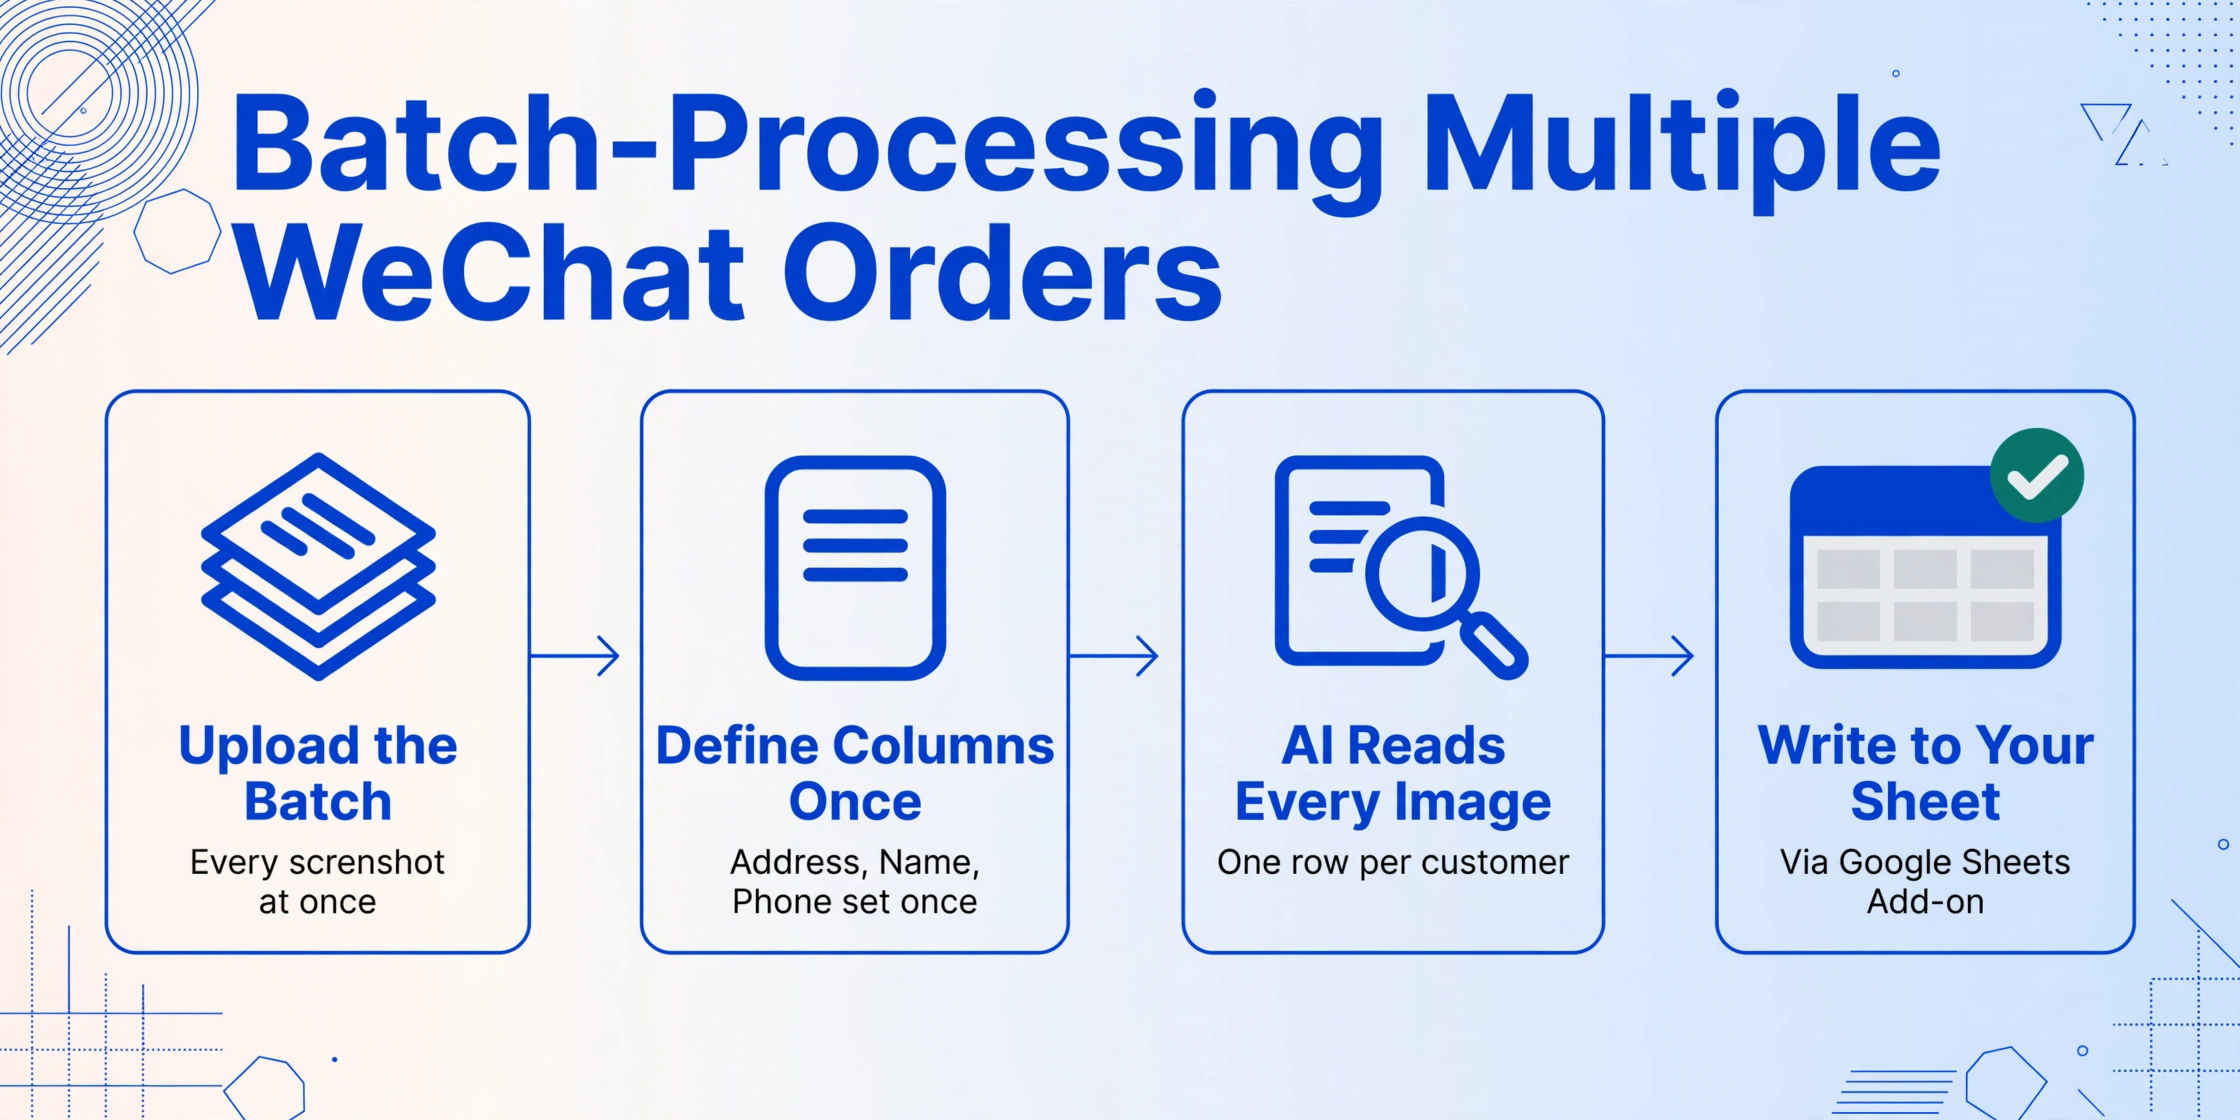
一括処理は、このワークフローを変えます。各顧客の住所メッセージが写ったスクリーンショットをすべてまとめてアップロードします。列定義(「配送先住所」「受取人」「電話番号」)は一度設定するだけです。AIがバッチ内のすべてのスクリーンショットを読み取り、統合されたテーブルを出力します。顧客ごとに1行、住所・名前・電話番号が3つのきれいな列に並びます。
出力されたテーブルは、Excelに直接エクスポートするか、ImageToTable.aiのGoogle Sheetsアドオンを使ってスプレッドシートから離れることなくGoogle Sheetsに直接書き込めます。各行が1件の注文であり、そのまま配送ラベルとして印刷したり、注文管理システムにインポートしたり、フルフィルメントチームと共有したりできます。1件あたりの作業時間は、読んで打ち込む約1分から、確認の数秒に短縮されます。
抽出の価値は、1件の住所で数秒を節約することではありません。1日10件の注文を、手作業を増やさずに30件へと拡大できることです。ボトルネックは住所を読むことではなく、毎回打ち直すことだからです。
同じ一括ワークフローは、前述した住所フォーマットのバリエーションにも適用できます。バッチには、完全に構造化された住所(省→市→区→路→名前→電話番号)のメッセージが10件、省が省略されたものが2件、通り名の代わりにランドマークを記載した顧客が1件、省レベルが存在しない直轄市(北京や上海)のものが1件含まれるかもしれません。AIは、各住所を構造的な構成要素で読むため、すべての住所がまったく同じテンプレートに従うと想定しません。そのため、すべてを同じパスで処理できます。
異なる市場の顧客に対応するなど、WhatsAppでも注文を処理している販売者は、同じアプローチをWhatsApp Businessで送信された住所メッセージにも拡張できます。抽出列は同じままで、変わるのはチャットインターフェースだけです。
よくある質問
中国語と英語が混在した住所でも処理できますか?
はい。国際物流を扱うお客様の中には、中国語の住所要素に英語の地名やホテル名を併記する場合があります — 「广东省深圳市南山区 深圳湾万丽酒店 张伟 13800138000」。AIは両方の文字を読み取り、英語テキストを住所文字列の一部として扱い、中国語の要素とともに出力に保持します。
住所が複数のチャットメッセージにまたがっている場合はどうなりますか?
各スクリーンショットは独立して処理されます。住所が2つのメッセージにまたがっている場合 — 顧客が1つのメッセージで住所を送り、続けて電話番号を送る場合 — 会話の全体像を含む1枚のスクリーンショットに両方を収めるか、2枚の別々のスクリーンショットを撮り、抽出後に列を結合してください。このツールは、アップロードされた各画像に表示されている内容に基づいて動作します。
棟、座、区などの複合的な建物名に含まれる特殊文字は処理できますか?
はい。中国語の住所表記には多様な語彙があります — 棟、座、区、層、号、单元、室 — そして「B棟1206室」や「3座2单元8层801」のような複合的な組み合わせもあります。AIはこれらを、使用される特定の文字の組み合わせに関係なく、住所構造のマーカーとして認識します。
完全な番地住所ではなく、市区町村と都道府県だけを抽出できますか?
はい。列を「省」「市」「受取人」と定義し — 「配送先住所」を除外すれば — AIは指定した行政レベルのみを抽出します。これは、完全な番地住所が不要な販売分析や顧客分布の追跡に役立ちます。