Chinesische Lieferadresse
und Telefonnummer aus einem WeChat-Chat-Screenshot auslesen
Wenn du auf WeChat verkaufst – als 微商 (wēishāng)-Händler, als Daigou-Einkaufsagent (代购) oder als Kleinunternehmer, der Bestellungen direkt im Chat annimmt – kennst du diesen Moment genau: Ein Kunde schickt dir seine Lieferdaten in einer einzigen Nachricht. „广东省深圳市南山区科技南路18号 李明 13800138000" – Provinz, Stadt, Bezirk, Straße, Gebäudenummer, Empfängername und Telefonnummer, alles in einer einzigen ununterbrochenen Zeile. Die Nachricht enthält alles, was du brauchst, um die Bestellung auszuführen. Das einzige Problem: Nichts davon kommt in getrennten Feldern an. Du liest die Adresse, merkst dir den Namen, kopierst die Telefonnummer und tippst jeden Teil in dein eigenes Bestellsystem – oder schreibst ihn von Hand auf das Paket. Bei jeder Bestellung, bei jedem Kunden, jedes Mal.
Die wichtigsten Erkenntnisse
- Eine chinesische Lieferadresse kommt in WeChat als eine einzige ununterbrochene Zeile an – Provinz, Stadt, Straße, Gebäude, Empfängername und Telefonnummer – ohne Kommas, ohne Zeilenumbrüche und ohne Feldbeschriftungen, die irgendetwas voneinander trennen.
- Traditionelle OCR gibt die gesamte Zeichenkette als einen einzigen Textblock aus – sie kann nicht erkennen, wo der Stadtname endet und die Straßennummer beginnt, weil beides für die Engine nur Hanzi-Zeichen sind.
- Definiere Spalten für Lieferadresse, Empfängername und Telefonnummer – die KI teilt die Zeichenkette auf, indem sie strukturelle Marker wie 省, 路 (Straße) und das 11-stellige Handymuster erkennt, das die Nachricht immer abschließt.
Wie eine WeChat-Adressnachricht tatsächlich aussieht
Eine typische chinesische Lieferadresse, die im WeChat-Chat verschickt wird, folgt einer Big-Endian-Hierarchie: Die größte geografische Einheit kommt zuerst, die kleinste zuletzt, gefolgt vom Namen des Empfängers und der Telefonnummer. Eine vollständige Nachricht sieht so aus:
浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678
Provinz Zhejiang, Stadt Hangzhou, Bezirk Xihu, Wensan-Straße Nr. 478, Huaxing-Technologiegebäude, 12. Stock, Raum 1208 — Wang Fang — 13812345678
In dieser einen Zeile erkennt ein menschlicher Leser sofort sechs verschiedene Datenpunkte: die Provinz (省), die Stadt (市), den Bezirk (区), die Straße und das Gebäude (路/号/楼/室), den Empfängernamen (收件人姓名) und die Handynummer (手机号). Die Adresse ist strukturiert – das chinesische Adressformat ist eines der konsistentesten hierarchischen Postsysteme der Welt – aber diese Struktur liegt vollständig in der Bedeutung der Wörter, nicht in einer visuellen Trennung. Es gibt keine Zeilenumbrüche, keine Spaltentrenner, keine Formularfelder. Nur einen einzigen durchgehenden Block aus chinesischen Schriftzeichen und Ziffern.
Die Adresse ist perfekt strukturiert. Sie sieht nur nicht strukturiert aus. Und genau das ist die Art von Eingabe, mit der herkömmliche OCR am schlechtesten umgeht.
Das gleiche Format wiederholt sich in jedem WeChat-Bestellszenario. Ein Kunde, der Kleidung bei einem WeChat-Händler (微商) kauft, sendet seine Adresse in einer Nachricht. Ein Daigou-Einkaufsagent bestätigt seine Versanddetails auf die gleiche Weise. Ein Restaurantlieferant, der Lieferanweisungen über WeChat erhält, bekommt die gleiche Art von Text – von der Provinz bis zur Handynummer, alles in einem Block. Der Inhalt ist identisch, unabhängig davon, wer ihn gesendet hat: geografische Hierarchie + Name + Telefonnummer, alles zu einer einzigen Zeichenkette zusammengefügt, die ein Mensch in einer halben Sekunde analysiert und die eine Maschine als einen einzigen undifferenzierten Textklumpen fehlinterpretiert.
Das Hierarchie-Problem – Warum ein flacher String keine Adresse ist
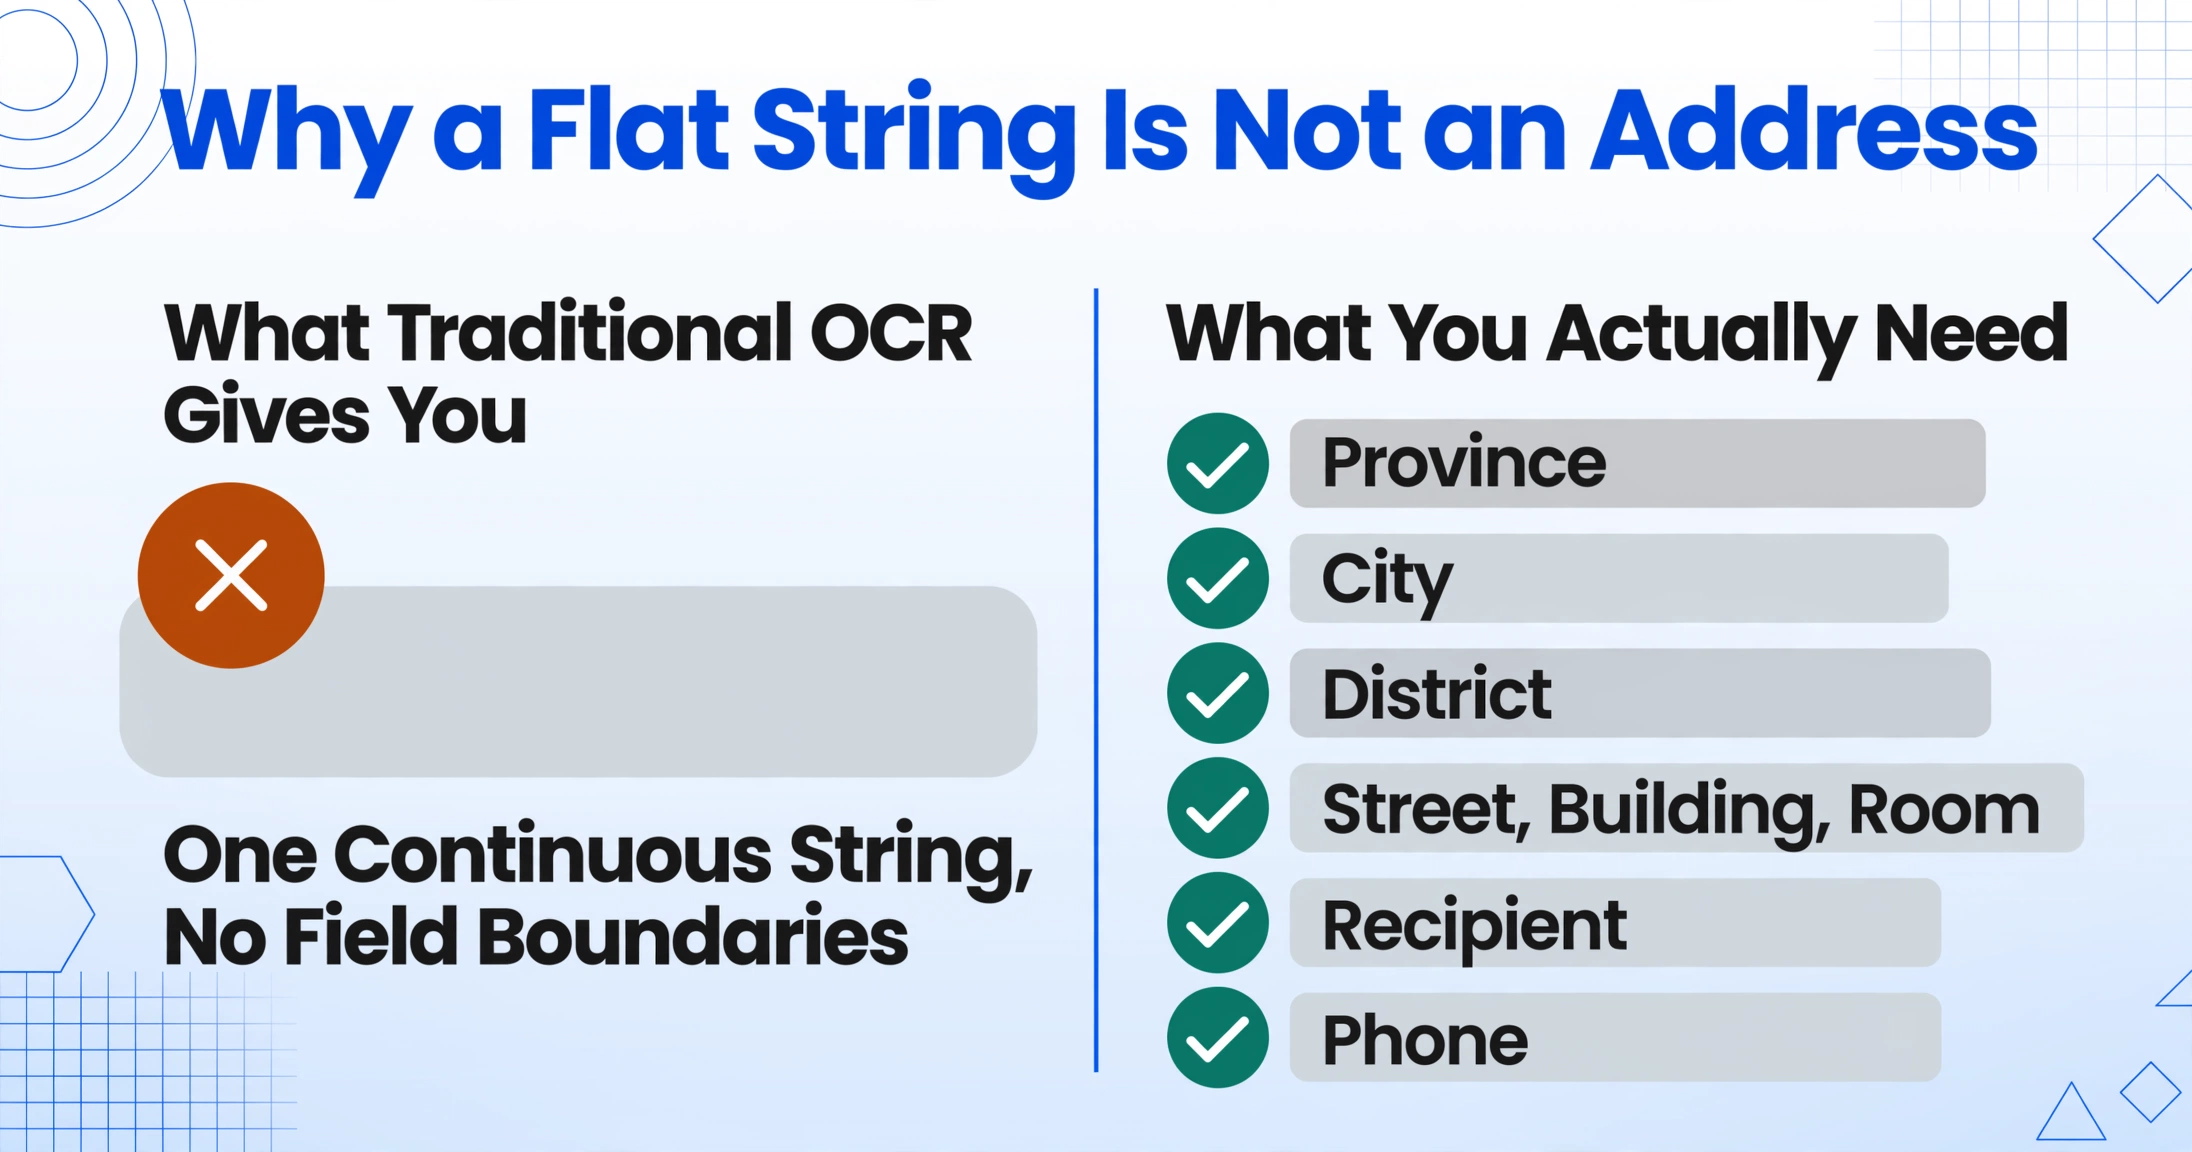
Die Schwierigkeit liegt nicht darin, dass chinesische Schriftzeichen schwer zu erkennen sind. Moderne OCR liest gedrucktes Chinesisch mit hoher Genauigkeit – die Technologie zur Zeichenerkennung ist seit Jahren zuverlässig. Die Schwierigkeit besteht darin, dass eine chinesische Adresse keine Zeichenfolge ist; sie ist eine Hierarchie, die als Zeichenfolge ausgedrückt wird. Traditionelle OCR behandelt die gesamte Zeichenfolge als eine Textzeile. Sie gibt "浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678" als ein einziges Feld aus – eine kontinuierliche Zeichenfolge ohne semantische Segmentierung.
| Was Sie tatsächlich benötigen | Was traditionelle OCR Ihnen liefert |
|---|---|
| Provinz: 浙江省 | "浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678" |
| Stadt: 杭州市 | |
| Bezirk: 西湖区 | |
| Adresse: 文三路478号华星科技大厦12楼1208室 | |
| Empfänger: 王芳 | |
| Telefon: 13812345678 |
Das Problem verschärft sich, wenn Adressen nicht perfekt formatiert sind. Ein Kunde könnte die Provinz ganz weglassen, wenn er bei einem Verkäufer in derselben Provinz bestellt: "杭州市西湖区文三路478号" ohne "浙江省" am Anfang. Ein anderer könnte nur Stadt und Bezirk angeben: "深圳南山科技南路18号" – die Provinz weglassen und eine bekannte Abkürzung für den Bezirk verwenden. Manche Adressen lassen den Gebäudenamen weg und geben nur die Straßennummer und ein nahegelegenes Wahrzeichen an. Traditionelle OCR hat keine Möglichkeit, diese Variationen zu normalisieren, weil sie nicht weiß, dass sie überhaupt auf eine Adresse schaut.
Die Telefonnummer, die wie das am einfachsten zu trennende Element aussieht, hat ihre eigenen Fallstricke innerhalb des Adressblocks. Eine chinesische Mobilnummer hat 11 Ziffern und beginnt mit 1 – ein klares Muster in Isolation. Aber wenn sie am Ende einer Adresszeichenfolge steht, die auch Gebäudenummern enthält (wie "12楼" oder "1208室"), könnte ein Tool, das naiv alle Ziffernfolgen extrahiert, "478" (die Gebäudenummer), "12" (die Etage), "1208" (die Raumnummer) und "13812345678" (die tatsächliche Telefonnummer) erfassen. Es hat keine Möglichkeit zu wissen, welche Zifferngruppe die Telefonnummer ist und welche Adressbestandteile sind.
Das Muster der Telefonnummer (11 Ziffern, beginnt mit 1) ist für einen Menschen leicht zu erkennen – aber ein Tool, das nicht versteht, dass es auf eine Adresse schaut, wird jede Zahl auf der Seite erfassen und sie alle "Daten" nennen.
So liest Visual AI denselben Screenshot anders
Hier verlagert sich der Extraktionsansatz von Zeichenerkennung zu semantischem Verständnis. Statt den Screenshot nach sämtlichem Text zu durchsuchen und als flachen Block auszugeben, liest ein Visual-AI-Tool das Bild, indem es fragt: „Um welche Art von Information handelt es sich, und wohin gehört jedes Element?"
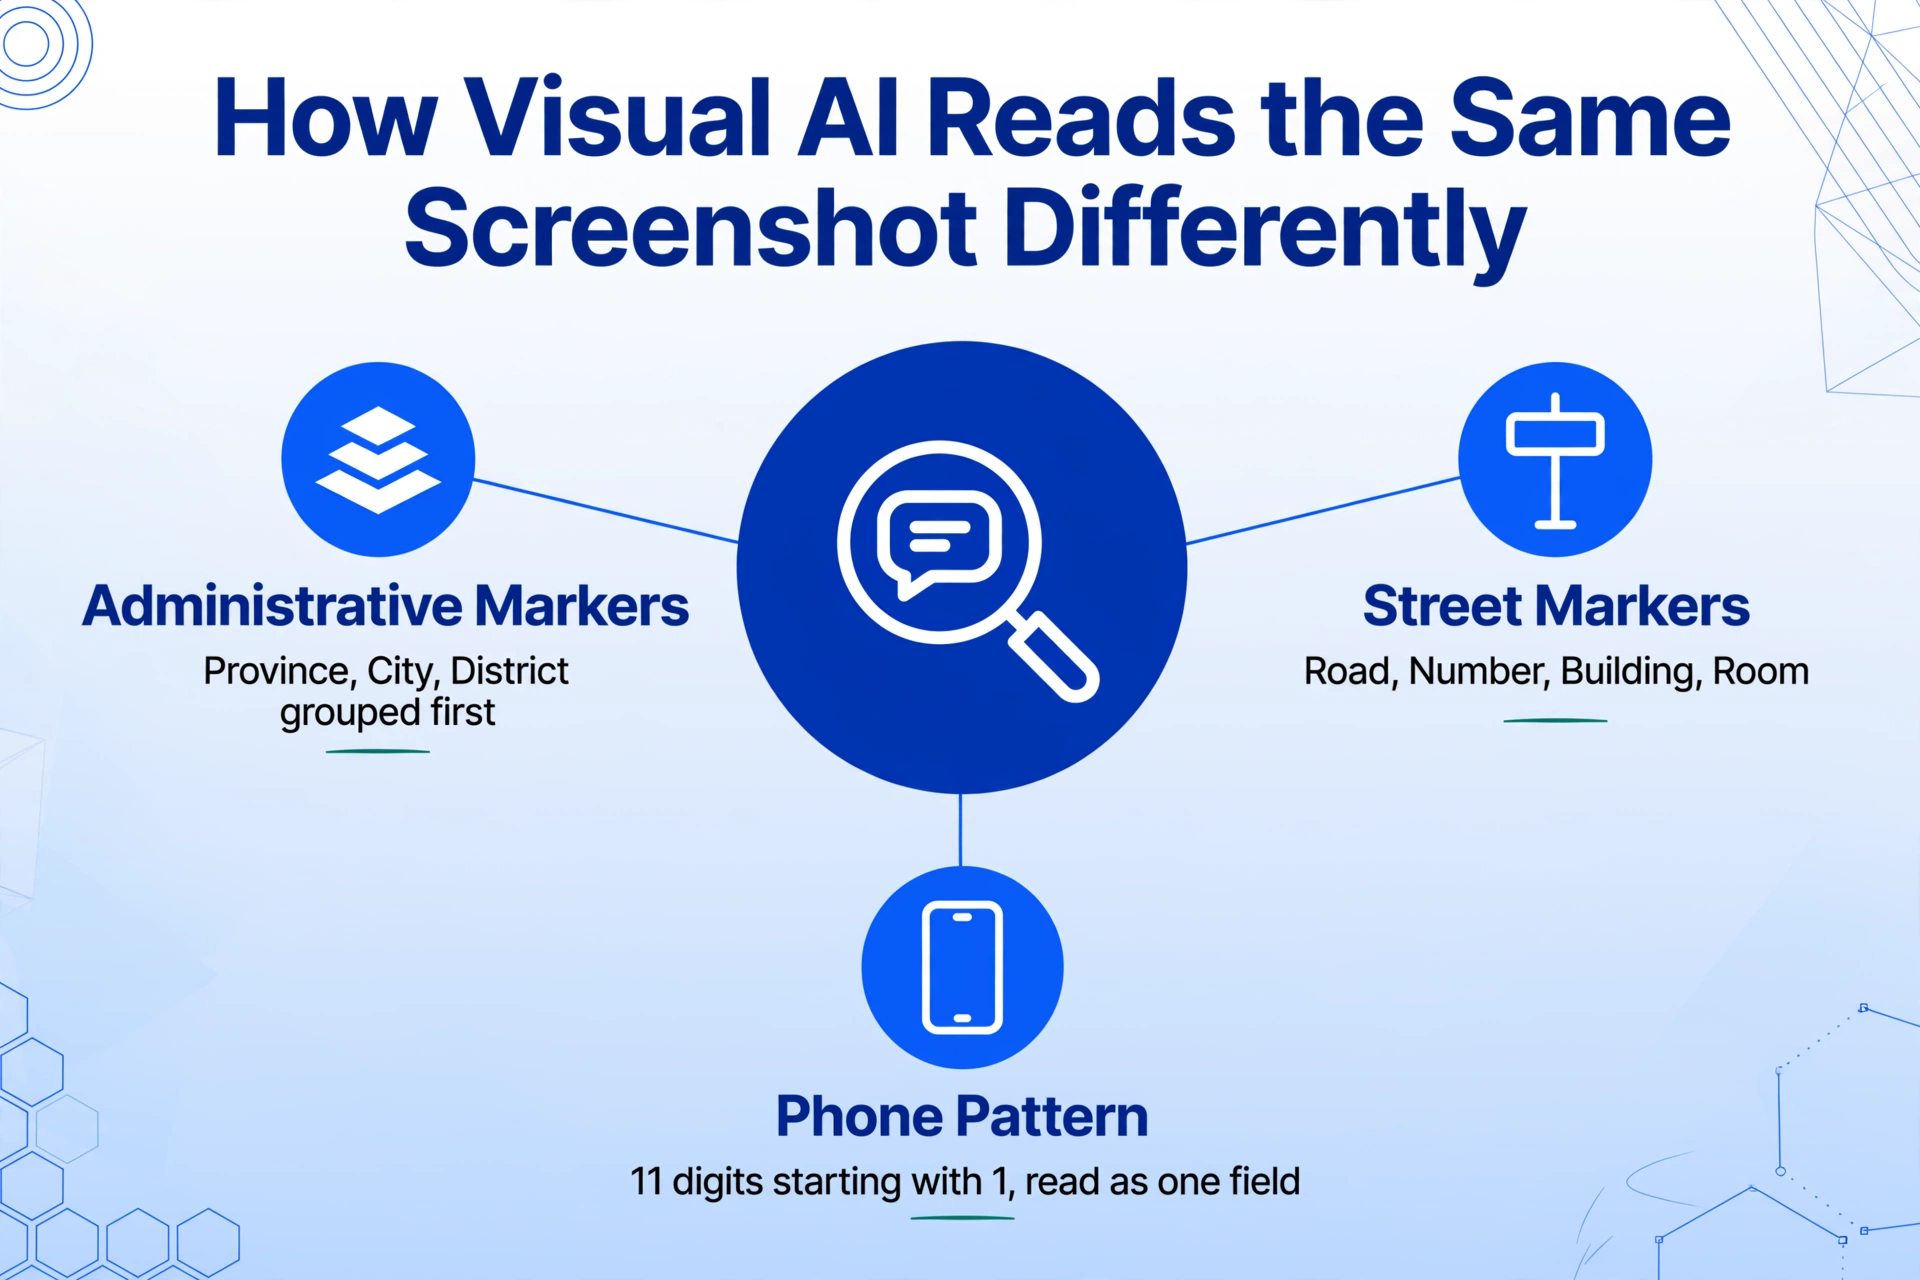
Mit der Benutzerdefinierten Spaltenextraktion definierst du die gewünschten Spalten – „Lieferadresse (收货地址)", „Empfänger (收件人)", „Telefonnummer (联系电话)" – und die KI findet die passenden Werte, indem sie versteht, was jedes Element im Kontext des chinesischen Adressformats bedeutet. Es muss ihr nicht gesagt werden, dass 省 die Provinz markiert oder dass 路 den Straßennamen kennzeichnet. Sie erkennt diese Marker, weil sie die strukturelle Grammatik chinesischer Adressen versteht – genauso wie du instinktiv weißt, dass „浙江省" die Provinz ist, selbst wenn du dich nie mit chinesischer Geografie beschäftigt hast.
So geht der semantische Ansatz mit jeder Komponente des Adressblocks um:
Die KI erkennt 省, 市 und 区/县 als Schlüsselwörter für Verwaltungsgrenzen. Sie gruppiert alles vom Anfang der erkannten Adresse bis zum ersten Straßenmarker als oberen Verwaltungsbereich. Wenn die Provinz weggelassen wird (häufig bei Bestellungen innerhalb derselben Provinz), verwendet sie den Stadtnamen als obersten Anker.
Marker wie 路 (Straße), 街 (Straße), 大道 (Allee), 号 (Nr.), 楼 (Gebäude), 幢 (Block) und 室 (Raum) grenzen die detaillierte Adresse ab. Die KI liest die Abfolge dieser Marker, um die vollständige Adresse auf Straßenebene zu rekonstruieren, auch wenn das Format variiert – manche Nachrichten verwenden „XX路XX号XX楼XX室", andere „XX路XX号XX大厦XX层".
Chinesische Namen bestehen typischerweise aus 2-3 Zeichen und stehen direkt vor der Telefonnummer, nach der Adresse. Die KI erkennt den Übergang von Adressmarkern zum Namensblock – der Name ist das, was zwischen der letzten Adresskomponente (室, 号 oder Gebäudename) und dem Beginn der 11-stelligen Telefonnummer übrig bleibt.
Das 11-stellige Handynummernmuster, das mit 1 beginnt, ist der zuverlässigste Trenner in der gesamten Zeichenkette. Die KI identifiziert es anhand von Muster und Position – es ist immer die letzte Zahlenfolge im Adressblock, anders als Gebäudenummern (die kürzer sind und in der Mitte der Zeichenkette neben 号 oder 楼 stehen).
Dieser Ansatz funktioniert, weil die KI nicht genau wissen muss, welche Stadt oder welche Straße im Screenshot erscheint. Sie muss nur wissen, dass etwas an dieser Position als Stadt fungiert, etwas als Straße und etwas als Telefonnummer. Die Extraktion wird durch die strukturelle Rolle gesteuert, die jedes Segment im chinesischen Adressformat spielt – ein Format, das trotz lokaler Abweichungen eine der konsistentesten Post-Hierarchien der Welt ist.
Das gleiche Prinzip, das für die Extraktion aus Zahlungs-Screenshots, die keine formellen Belege sind gilt, gilt auch hier: Du definierst die Ausgabespalten, und die KI findet die passenden Werte auf dem Screenshot, indem sie versteht, was sie bedeuten – nicht durch Abgleich mit einer Vorlage. Ob die Eingabe ein WeChat-Pay-Bestätigungsbildschirm oder eine Chat-Nachricht mit Lieferadresse ist, die Methode ist dieselbe – semantische Extraktion liest nach Bedeutung, nicht nach Position.
Batch-Verarbeitung mehrerer WeChat-Bestellungen
Ein WeChat-Händler erhält nicht nur eine Bestellung nach der anderen. An einem geschäftigen Tag füllt sich der Chatverlauf mit Adressnachrichten von mehreren Kunden – jede mit einem anderen Namen, einer anderen Stadt und anderen Lieferanweisungen. Das manuelle Übertragen von zehn Adressen bedeutet, zehn Nachrichten zu lesen, zehn Handynummern zu kopieren und zehn Namen in einen Bestellbogen oder ein Paketlabel zu tippen. Der Vorgang ist jedes Mal derselbe, und das Fehlermuster ist jedes Mal dasselbe: eine vertauschte Ziffer in der Handynummer, eine falsch gelesene Hausnummer, ein falsch identifizierter Bezirk.
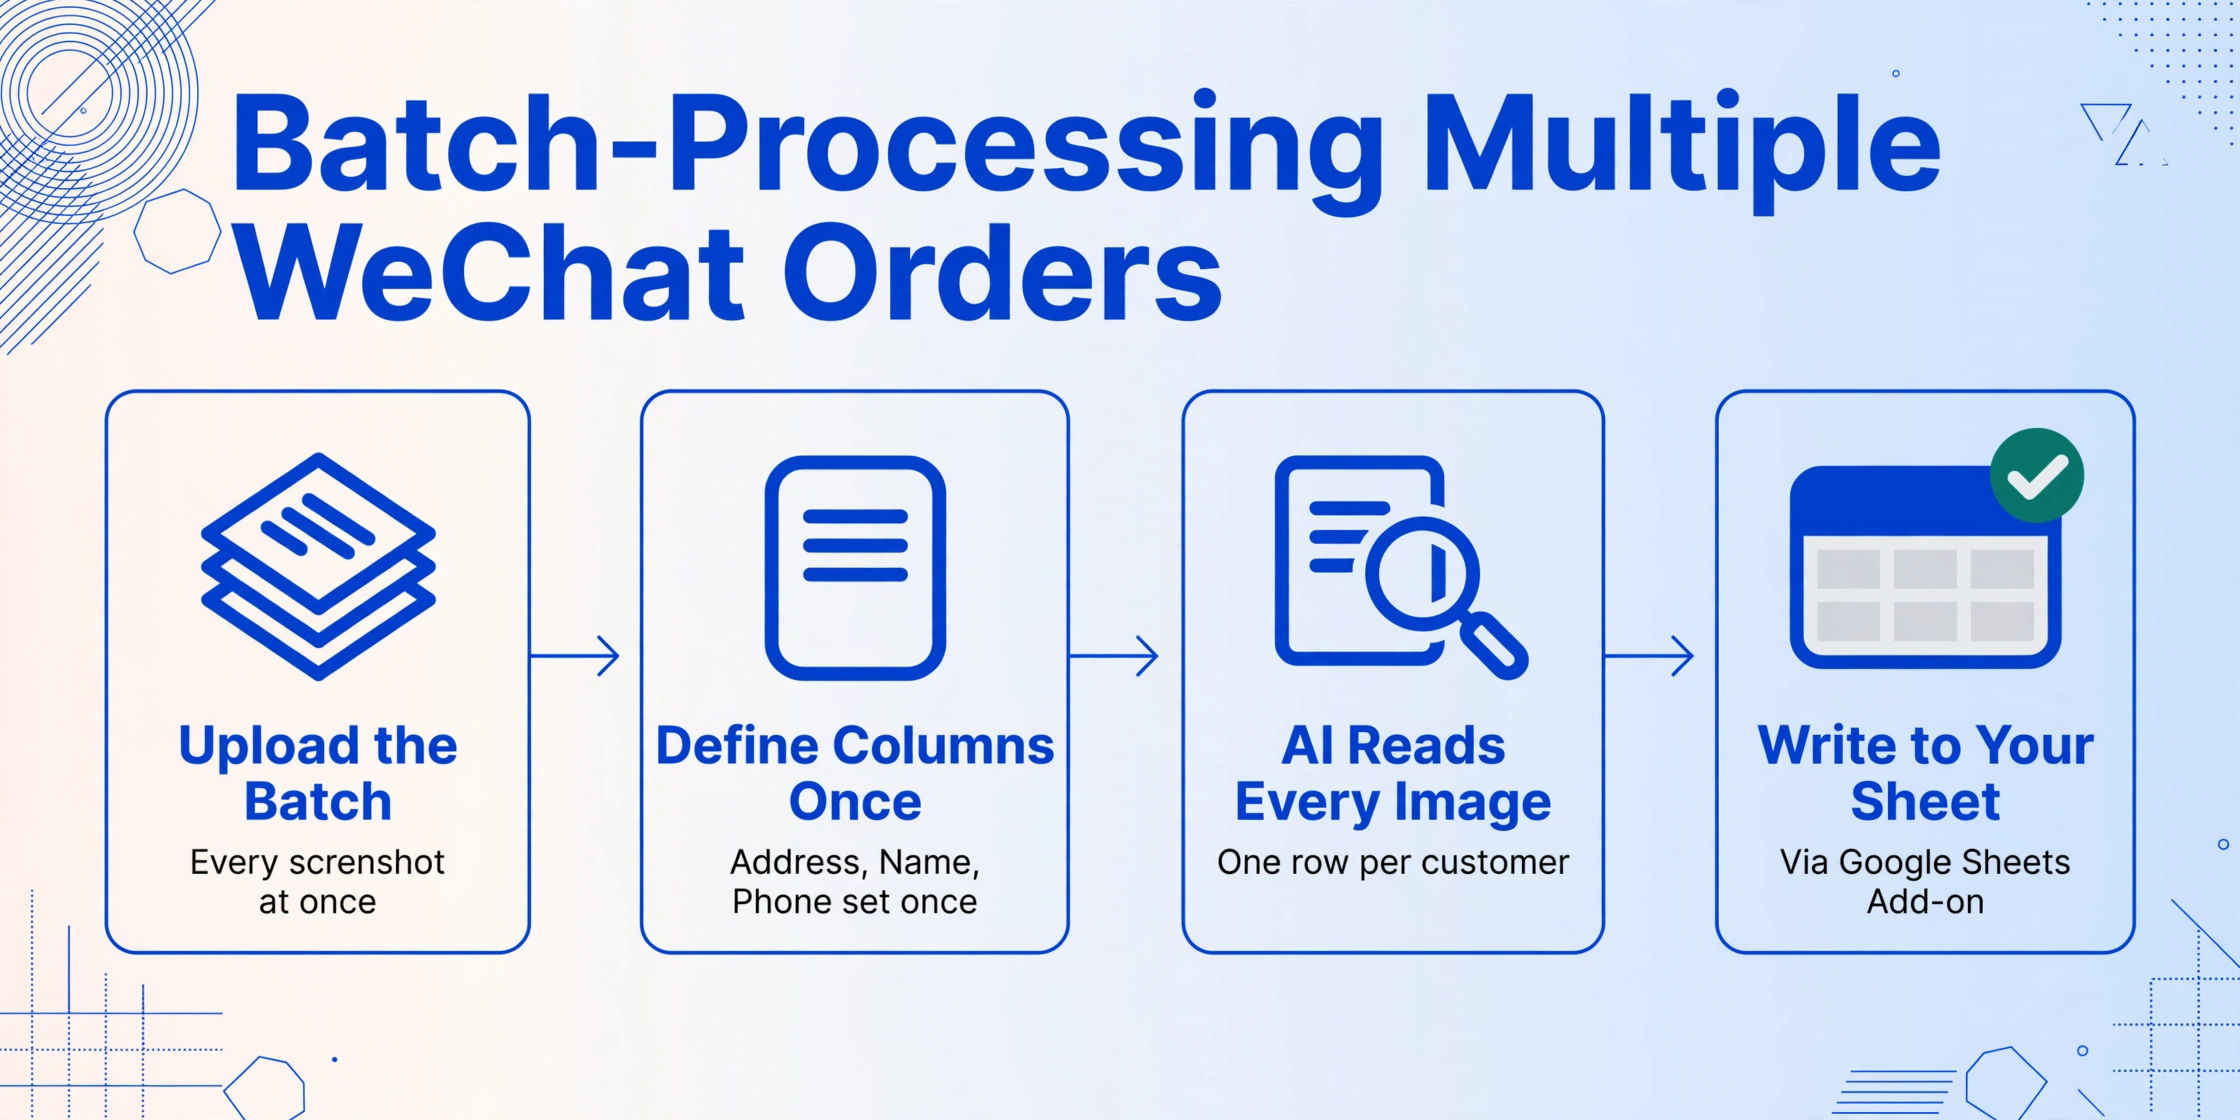
Die Batch-Verarbeitung ändert diesen Arbeitsablauf. Alle Screenshots – jeder zeigt die Adressnachricht eines Kunden im Chat – werden zusammen hochgeladen. Ein einziger Satz Spaltendefinitionen („Lieferadresse“, „Empfängername“, „Handynummer“) wird einmal angewendet. Die KI liest jeden Screenshot im Batch und gibt eine einheitliche Tabelle aus: eine Zeile pro Kunde, mit Adresse, Name und Handynummer in drei sauberen Spalten.
Die Ausgabetabelle kann direkt als Excel exportiert oder mithilfe des ImageToTable.ai-Google-Sheets-Add-ons direkt in Google Sheets geschrieben werden – ohne die Tabellenkalkulation zu verlassen. Jede Zeile ist eine Bestellung, bereit zum Drucken als Versandetikett, zum Importieren in dein Bestellverwaltungssystem oder zum Teilen mit deinem Fulfillment-Team. Der Aufwand pro Bestellung sinkt von etwa einer Minute Lesen und Tippen auf ein paar Sekunden Überprüfung.
Der Wert der Extraktion liegt nicht darin, ein paar Sekunden bei einer Adresse zu sparen. Es geht darum, von zehn Bestellungen pro Tag auf dreißig zu skalieren, ohne mehr manuelle Arbeit hinzuzufügen – denn der Engpass ist nicht das Lesen der Adresse, sondern das erneute Abtippen bei jedem einzelnen Mal.
Derselbe Batch-Workflow gilt für die zuvor besprochenen Adressformatvariationen. Ein Batch könnte zehn Nachrichten mit perfekt strukturierten Adressen (Provinz→Stadt→Bezirk→Straße→Name→Handynummer), zwei mit weggelassener Provinz, eine, bei der der Kunde ein Wahrzeichen statt eines Straßennamens angegeben hat, und eine in einer regierungsunmittelbaren Stadt (Peking oder Shanghai) ohne Provinzebene enthalten. Die KI verarbeitet alle in einem Durchgang, weil sie jede Adresse anhand ihrer strukturellen Bestandteile liest – nicht, indem sie annimmt, dass jede Adresse exakt derselben Vorlage folgt.
Für Händler, die auch Bestellungen über WhatsApp abwickeln – insbesondere solche, die Kunden in verschiedenen Märkten bedienen –, gilt derselbe Ansatz auch für Adressnachrichten, die über WhatsApp Business gesendet werden. Die Extraktionsspalten bleiben dieselben; nur die Chat-Oberfläche ändert sich.
Häufig gestellte Fragen
Kann es Adressen verarbeiten, die sowohl chinesischen als auch englischen Text enthalten?
Ja. Manche Kunden, die mit internationaler Logistik arbeiten, fügen englische Orts- oder Hotelnamen zu chinesischen Adressbestandteilen hinzu – „广东省深圳市南山区 深圳湾万丽酒店 张伟 13800138000". Die KI liest beide Schriften und behandelt den englischen Text als Teil der Adresszeichenfolge, wobei sie ihn zusammen mit den chinesischen Bestandteilen in der Ausgabe beibehält.
Was ist, wenn die Adresse auf mehrere Chat-Nachrichten verteilt ist?
Jeder Screenshot wird unabhängig verarbeitet. Wenn sich die Adresse über zwei Nachrichten erstreckt – der Kunde sendet die Adresse in einer Nachricht und die Telefonnummer in einer Folgenachricht – müsstest du beide in einem einzigen Screenshot erfassen, der den vollständigen Gesprächskontext zeigt, oder zwei separate Screenshots machen und die Zeilen nach der Extraktion zusammenführen. Das Tool arbeitet mit dem, was in jedem hochgeladenen Bild sichtbar ist.
Verarbeitet es Sonderzeichen in Adressnamen – wie 栋, 座, 区 in zusammengesetzten Gebäudenamen?
Ja. Chinesische Adressmarkierungen umfassen eine breite Vokabelpalette – 栋 (Block), 座 (Gebäude), 区 (Zone), 层 (Etage), 号 (Nummer), 单元 (Einheit), 室 (Raum) – und zusammengesetzte Kombinationen wie „B栋1206室" oder „3座2单元8层801". Die KI erkennt diese unabhängig von der verwendeten Zeichenkombination als Strukturmarkierungen von Adressen.
Kann ich nur die Stadt und die Provinz extrahieren, ohne die vollständige Straßenadresse?
Ja. Definiere deine Spalten als „Provinz (省)", „Stadt (市)" und „Empfängername (收件人)" – lasse „Lieferadresse (收货地址)" weg – und die KI extrahiert nur die von dir angegebenen Verwaltungsebenen. Dies ist nützlich für Verkaufsanalysen oder die Verfolgung der Kundenverteilung, bei denen die vollständige Straßenadresse nicht benötigt wird.