위챗 채팅 스크린샷에서 중국 배송 주소와
전화번호 읽기
위챗에서 판매하는 분이라면 — 微商(웨이샹) 판매자, 다이고우(구매 대행) 쇼퍼, 또는 채팅으로 직접 주문을 받는 소상공인 — 이런 순간을 정확히 아실 거예요. 고객이 배송 정보를 한 줄의 메시지로 보내는 경우요. "广东省深圳市南山区科技南路18号 李明 13800138000" — 성, 시, 구, 도로, 건물 번호, 수취인 이름, 전화번호가 모두 끊김 없이 한 줄에 담겨 있어요. 주문을 처리하는 데 필요한 모든 정보가 메시지에 들어 있죠. 문제는 그 어느 것도 별도의 필드로 나뉘어 오지 않는다는 거예요. 주소를 읽고, 이름을 기억하고, 전화번호를 복사해서 각 항목을 주문 시스템에 직접 입력하거나 패키지에 손으로 적어야 해요. 모든 주문, 모든 고객, 매번 말이죠.
핵심 요점
- 중국 배송 주소는 위챗에서 성, 시, 도로, 건물, 수취인 이름, 전화번호가 쉼표도, 줄 바꿈도, 필드 라벨도 없이 하나의 끊긴 없는 줄로 도착해요.
- 기존 OCR은 전체 문자열을 하나의 텍스트 블록으로 출력해요 — 도시 이름이 끝나고 도로 번호가 시작되는 지점을 구분하지 못하죠. 엔진에게 둘 다 한자 문자일 뿐이니까요.
- 배송 주소, 수취인 이름, 전화번호 열을 정의하세요 — AI가 省(성), 路(로), 그리고 항상 메시지를 끝내는 11자리 휴대폰 번호 패턴 같은 구조적 표식을 인식해 문자열을 분리해요.
위챗 주소 메시지의 실제 모습
위챗 채팅에서 보내는 일반적인 중국 배송 주소는 큰 행정 단위부터 작은 순서로 나열되는 빅엔디언 체계를 따릅니다. 가장 큰 지리적 단위가 먼저 오고, 가장 작은 단위가 마지막에 오며, 그 뒤에 수취인 이름과 전화번호가 이어집니다. 완전한 메시지는 다음과 같습니다:
浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678
저장성 항저우시 시후구 원산로 478호 화싱과학기술빌딩 12동 1208호 — 왕팡 — 13812345678
이 한 줄의 문자열에서 사람은 즉시 여섯 가지 데이터 포인트를 식별합니다: 성(省), 시(市), 구(区), 도로명과 건물(路/号/楼/室), 수취인 이름(收件人姓名), 휴대폰 번호(手机号). 주소는 구조화되어 있습니다. 중국 주소 형식은 세계에서 가장 일관되게 계층적인 우편 시스템 중 하나입니다. 하지만 그 구조는 전적으로 단어의 의미에 존재할 뿐, 시각적인 구분은 전혀 없습니다. 줄바꿈도, 열 구분자도, 입력 필드도 없습니다. 그저 중국어 문자와 숫자가 연속적으로 이어진 하나의 블록일 뿐입니다.
주소는 완벽하게 구조화되어 있습니다. 단지 구조화되어 보이지 않을 뿐입니다. 그리고 바로 그런 입력이 전통적인 OCR이 가장 취약하게 다루는 유형입니다.
동일한 형식은 모든 위챗 주문 시나리오에서 반복됩니다. 위챗 판매자(微商)에게서 옷을 사는 고객도 주소를 한 메시지로 보냅니다. 다이고우(구매 대행) 구매자도 배송 정보를 같은 방식으로 확인합니다. 위챗으로 배송 지시를 받는 식자재 공급업체도 똑같은 형식의 텍스트를 받습니다. 성부터 휴대폰 번호까지, 모두 하나의 블록으로 되어 있습니다. 누가 보냈든 내용은 동일합니다: 지리적 계층 구조 + 이름 + 전화번호, 모든 것이 하나의 문자열로 연결되어 있어 사람은 0.5초 만에 파싱하지만 기계는 하나의 구분되지 않은 텍스트 덩어리로 오인합니다.
계층 구조 문제 — 평면 문자열은 주소가 아닙니다
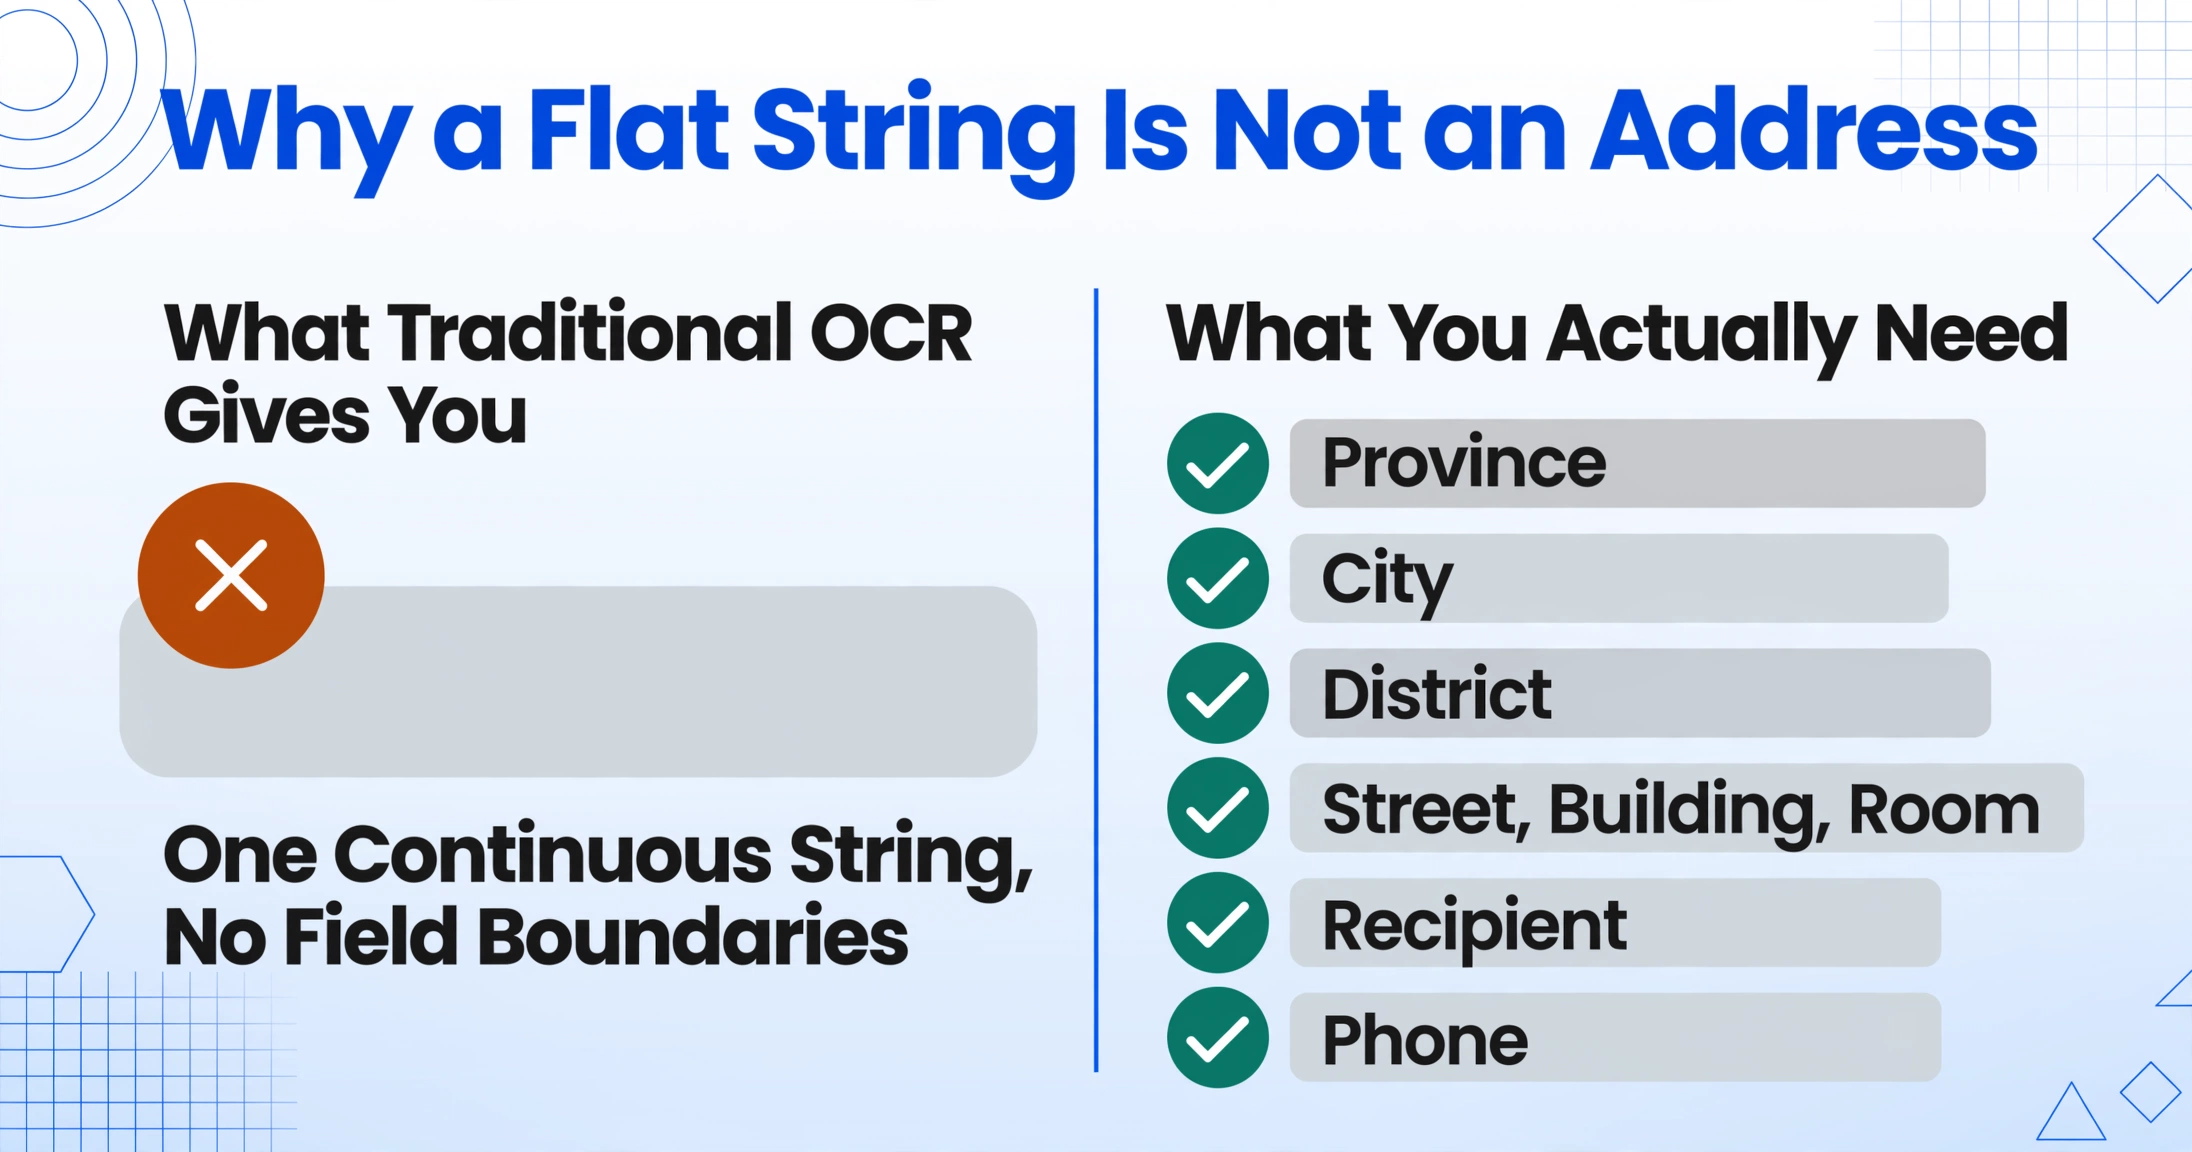
어려운 점은 한자를 인식하기 어렵다는 것이 아닙니다. 현대 OCR은 인쇄된 중국어를 높은 정확도로 읽어냅니다. 문자 인식 기술은 수년 동안 신뢰할 만했습니다. 어려운 점은 중국 주소가 문자의 나열이 아니라 문자의 나열로 표현된 계층 구조라는 것입니다. 전통적인 OCR은 전체 문자열을 한 줄의 텍스트로 취급합니다. "浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678"을 단일 필드로 출력합니다. 즉, 의미적 구분이 없는 하나의 연속된 문자열입니다.
| 실제로 필요한 것 | 전통적인 OCR이 제공하는 것 |
|---|---|
| 성: 浙江省 | "浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678" |
| 시: 杭州市 | |
| 구: 西湖区 | |
| 주소: 文三路478号华星科技大厦12楼1208室 | |
| 수취인: 王芳 | |
| 휴대폰 번호: 13812345678 |
주소가 완벽하게 형식화되지 않으면 문제는 더욱 복잡해집니다. 고객이 같은 성 내의 판매자에게 주문할 때 성을 생략할 수 있습니다. "浙江省" 없이 "杭州市西湖区文三路478号"만 쓰는 경우입니다. 또 다른 경우는 시와 구만 포함하는 경우입니다. "深圳南山科技南路18号" — 성을 생략하고 구의 잘 알려진 약칭을 사용합니다. 일부 주소는 건물 이름을 생략하고 거리 번호와 근처 랜드마크만 제공합니다. 전통적인 OCR은 이것이 주소라는 것을 전혀 알지 못하기 때문에 이러한 변형을 정규화할 방법이 없습니다.
가장 분리하기 쉬워 보이는 휴대폰 번호도 주소 블록 안에서 나름의 함정이 있습니다. 중국 휴대폰 번호는 1로 시작하는 11자리 숫자입니다. 단독으로는 명확한 패턴입니다. 그러나 건물 번호(예: "12楼" 또는 "1208室")도 포함하는 주소 문자열 끝에 위치할 때, 모든 숫자 시퀀스를 순진하게 추출하는 도구는 "478"(건물 번호), "12"(층), "1208"(방 번호), "13812345678"(실제 휴대폰 번호)을 모두 잡아낼 수 있습니다. 어떤 숫자 그룹이 휴대폰 번호이고 어떤 것이 주소 구성 요소인지 알 방법이 없습니다.
휴대폰 번호 패턴(11자리, 1로 시작)은 사람이 쉽게 알아볼 수 있습니다. 그러나 주소를 보고 있다는 것을 이해하지 못하는 도구는 페이지의 모든 숫자를 잡아 모두 "데이터"라고 부를 것입니다.
시각 AI가 동일한 스크린샷을 다르게 읽는 방식
여기서 추출 방식은 문자 인식에서 의미 이해로 전환됩니다. 스크린샷의 모든 텍스트를 스캔하여 평면 블록으로 출력하는 대신, 시각 AI 도구는 "이 정보는 어떤 종류인가, 각 항목은 어디에 속하는가?"라고 묻는 방식으로 이미지를 읽습니다.
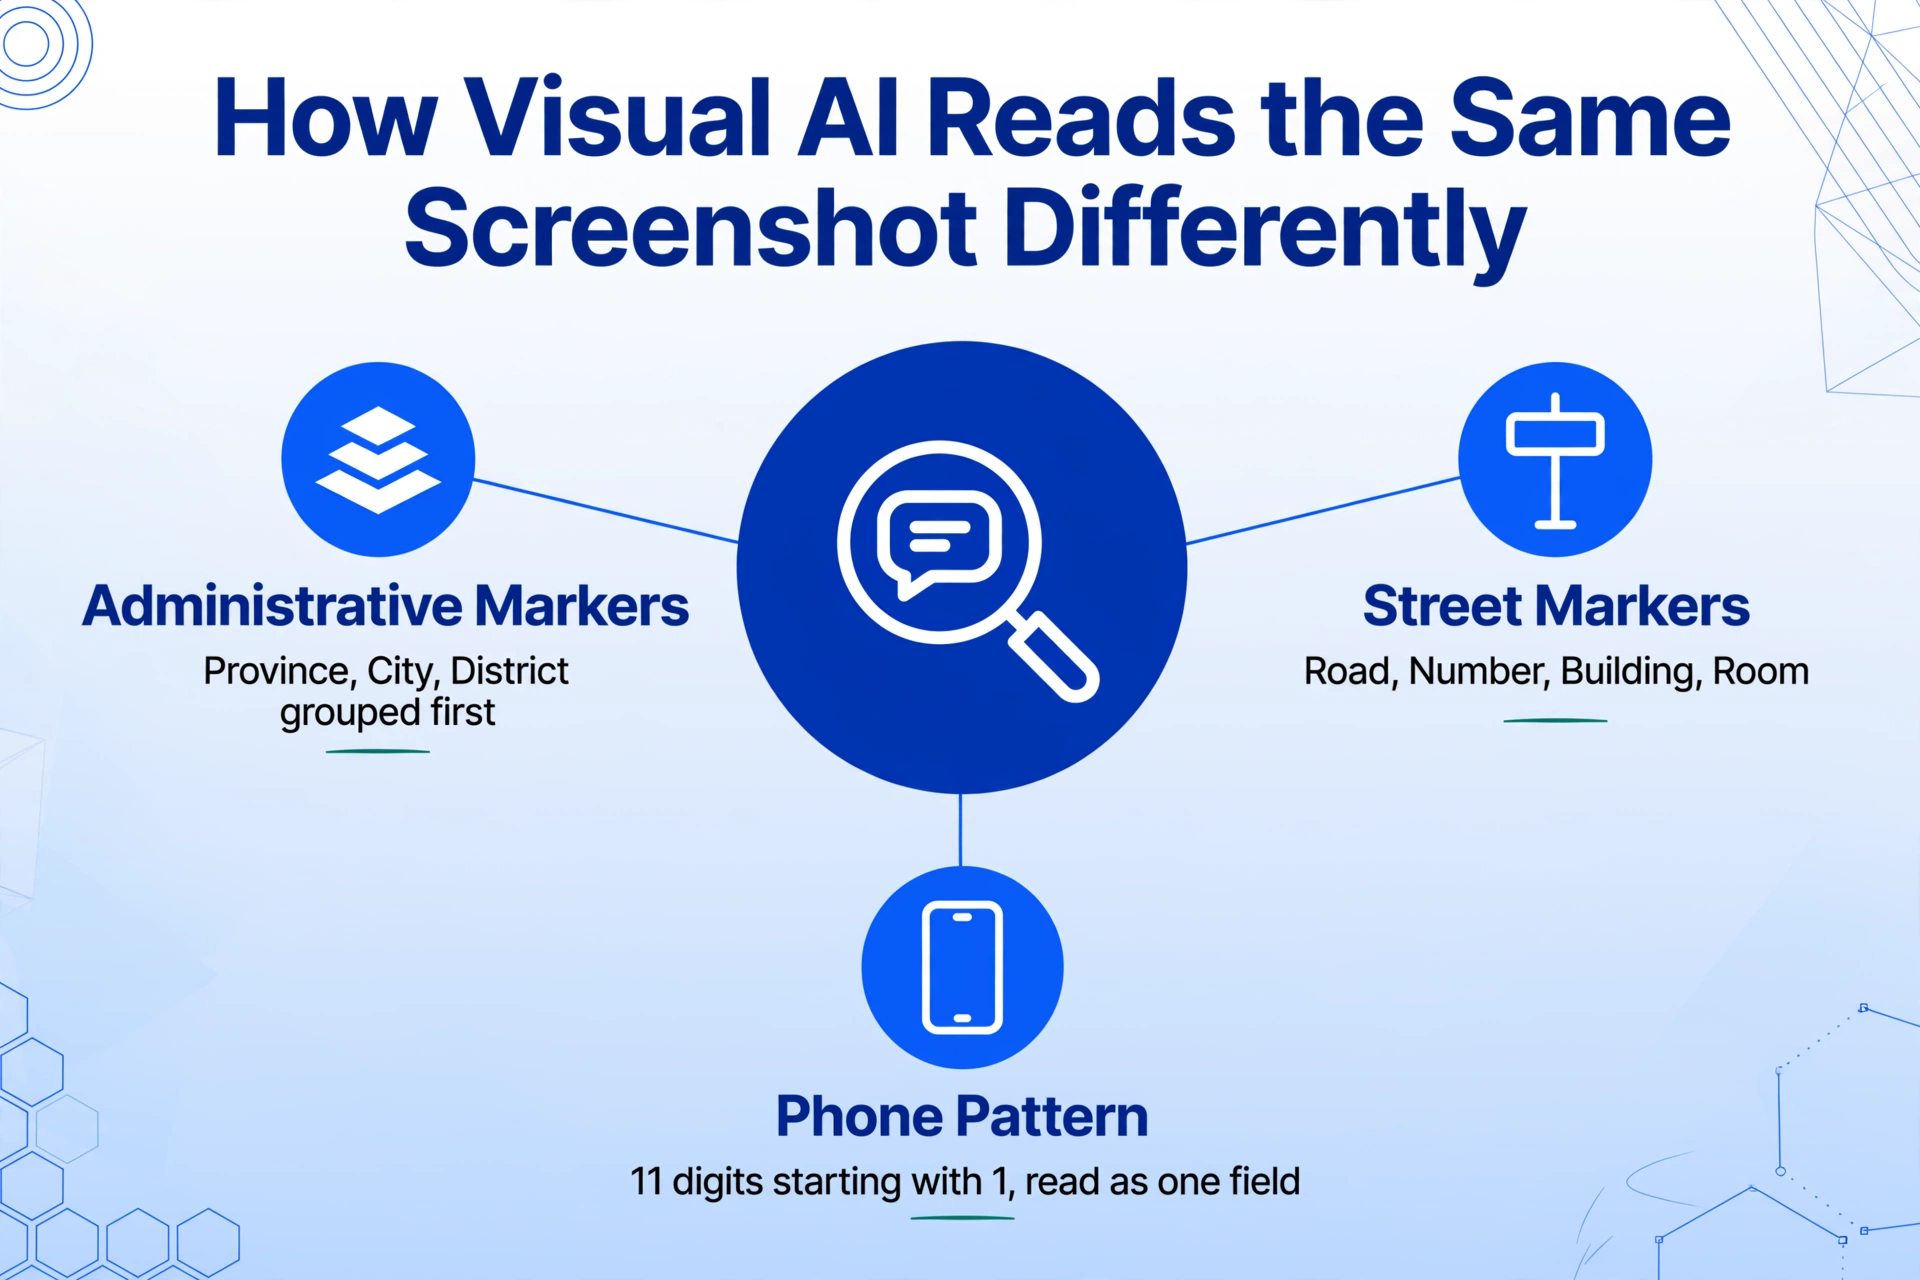
맞춤 열 추출을 사용하면 원하는 열을 정의합니다 — "배송 주소(收货地址)", "수취인 이름(收件人)", "휴대폰 번호(联系电话)" — 그러면 AI가 중국 주소 형식의 맥락에서 각 항목의 의미를 이해하여 일치하는 값을 찾습니다. 省이 성을 나타낸다거나 路가 도로명을 나타낸다는 것을 알려줄 필요가 없습니다. 중국 주소의 구조적 문법을 이해하기 때문에 이러한 표시를 식별합니다 — 중국 지리를 공부한 적이 없어도 "浙江省"이 성이라는 것을 본능적으로 아는 것과 같은 방식입니다.
의미 기반 접근 방식이 주소 블록의 각 구성 요소를 처리하는 방법은 다음과 같습니다.
AI는 省, 市, 区/县을 행정 구역 경계 키워드로 인식합니다. 인식된 주소의 시작부터 첫 번째 도로 표지판까지를 상위 행정 구역으로 묶습니다. 성이 생략된 경우(같은 성 내 주문에서 흔함), 시 이름을 최상위 기준점으로 사용합니다.
路(도로), 街(거리), 大道(대로), 号(번호), 楼(동), 幢(블록), 室(호) 같은 표지판이 상세 주소의 경계를 나눕니다. AI는 이 표지판들의 순서를 읽어 전체 도로명 주소를 재구성합니다. 형식이 달라도 말이죠 — 어떤 메시지는 "XX路XX号XX楼XX室"을 쓰고, 다른 메시지는 "XX路XX号XX大厦XX层"을 씁니다.
중국어 이름은 보통 2~3자이며, 주소 뒤, 휴대폰 번호 바로 앞에 나타납니다. AI는 주소 표지판에서 이름 블록으로의 전환을 인식합니다 — 이름은 마지막 주소 구성 요소(室, 号, 또는 건물 이름)와 11자리 휴대폰 번호 시작 사이에 남는 부분입니다.
1로 시작하는 11자리 휴대폰 번호 패턴은 전체 문자열에서 가장 신뢰할 수 있는 구분자입니다. AI는 패턴과 위치로 이를 식별합니다 — 주소 블록에서 항상 마지막 숫자 시퀀스이며, 건물 번호(더 짧고 号나 楼 옆 문자열 중간에 나타남)와 구별됩니다.
이 방식이 효과적인 이유는 AI가 스크린샷에 어떤 도시나 도로 이름이 나오는지 정확히 알 필요가 없기 때문입니다. 그 위치의 무언가가 도시 역할을 하고, 무언가가 도로 역할을 하며, 무언가가 휴대폰 번호 역할을 한다는 것만 알면 됩니다. 추출은 중국어 주소 형식에서 각 세그먼트가 수행하는 구조적 역할에 의해 이루어집니다 — 지역별 차이가 있음에도 세계에서 가장 일관된 우편 계층 구조 중 하나인 형식입니다.
공식 영수증이 아닌 결제 스크린샷에서 데이터를 추출할 때 적용되는 것과 같은 원리가 여기에도 적용됩니다: 출력 열을 정의하면 AI는 템플릿을 매칭하는 대신 의미를 이해하여 스크린샷에서 일치하는 값을 찾습니다. 입력이 WeChat Pay 확인 화면이든 배송 주소가 있는 채팅 메시지든, 방법은 동일합니다 — 의미 기반 추출은 위치가 아닌 의미로 읽습니다.
위챗 주문 일괄 처리
위챗 판매자는 주문을 한 건씩 받지 않아요. 바쁜 날에는 여러 고객의 주소 메시지로 채팅 로그가 가득 차요 — 각각 다른 이름, 다른 도시, 다른 배송 지시사항이 있죠. 주소 열 개를 수동으로 옮겨 적으려면 메시지 열 개를 읽고, 휴대폰 번호 열 개를 복사하고, 이름 열 개를 주문 시트나 포장 라벨에 입력해야 해요. 이 과정은 매번 똑같고, 실수 패턴도 매번 똑같아요: 휴대폰 번호의 숫자 하나가 바뀌거나, 번지수가 잘못 읽히거나, 구(區)를 잘못 식별하는 일이죠.
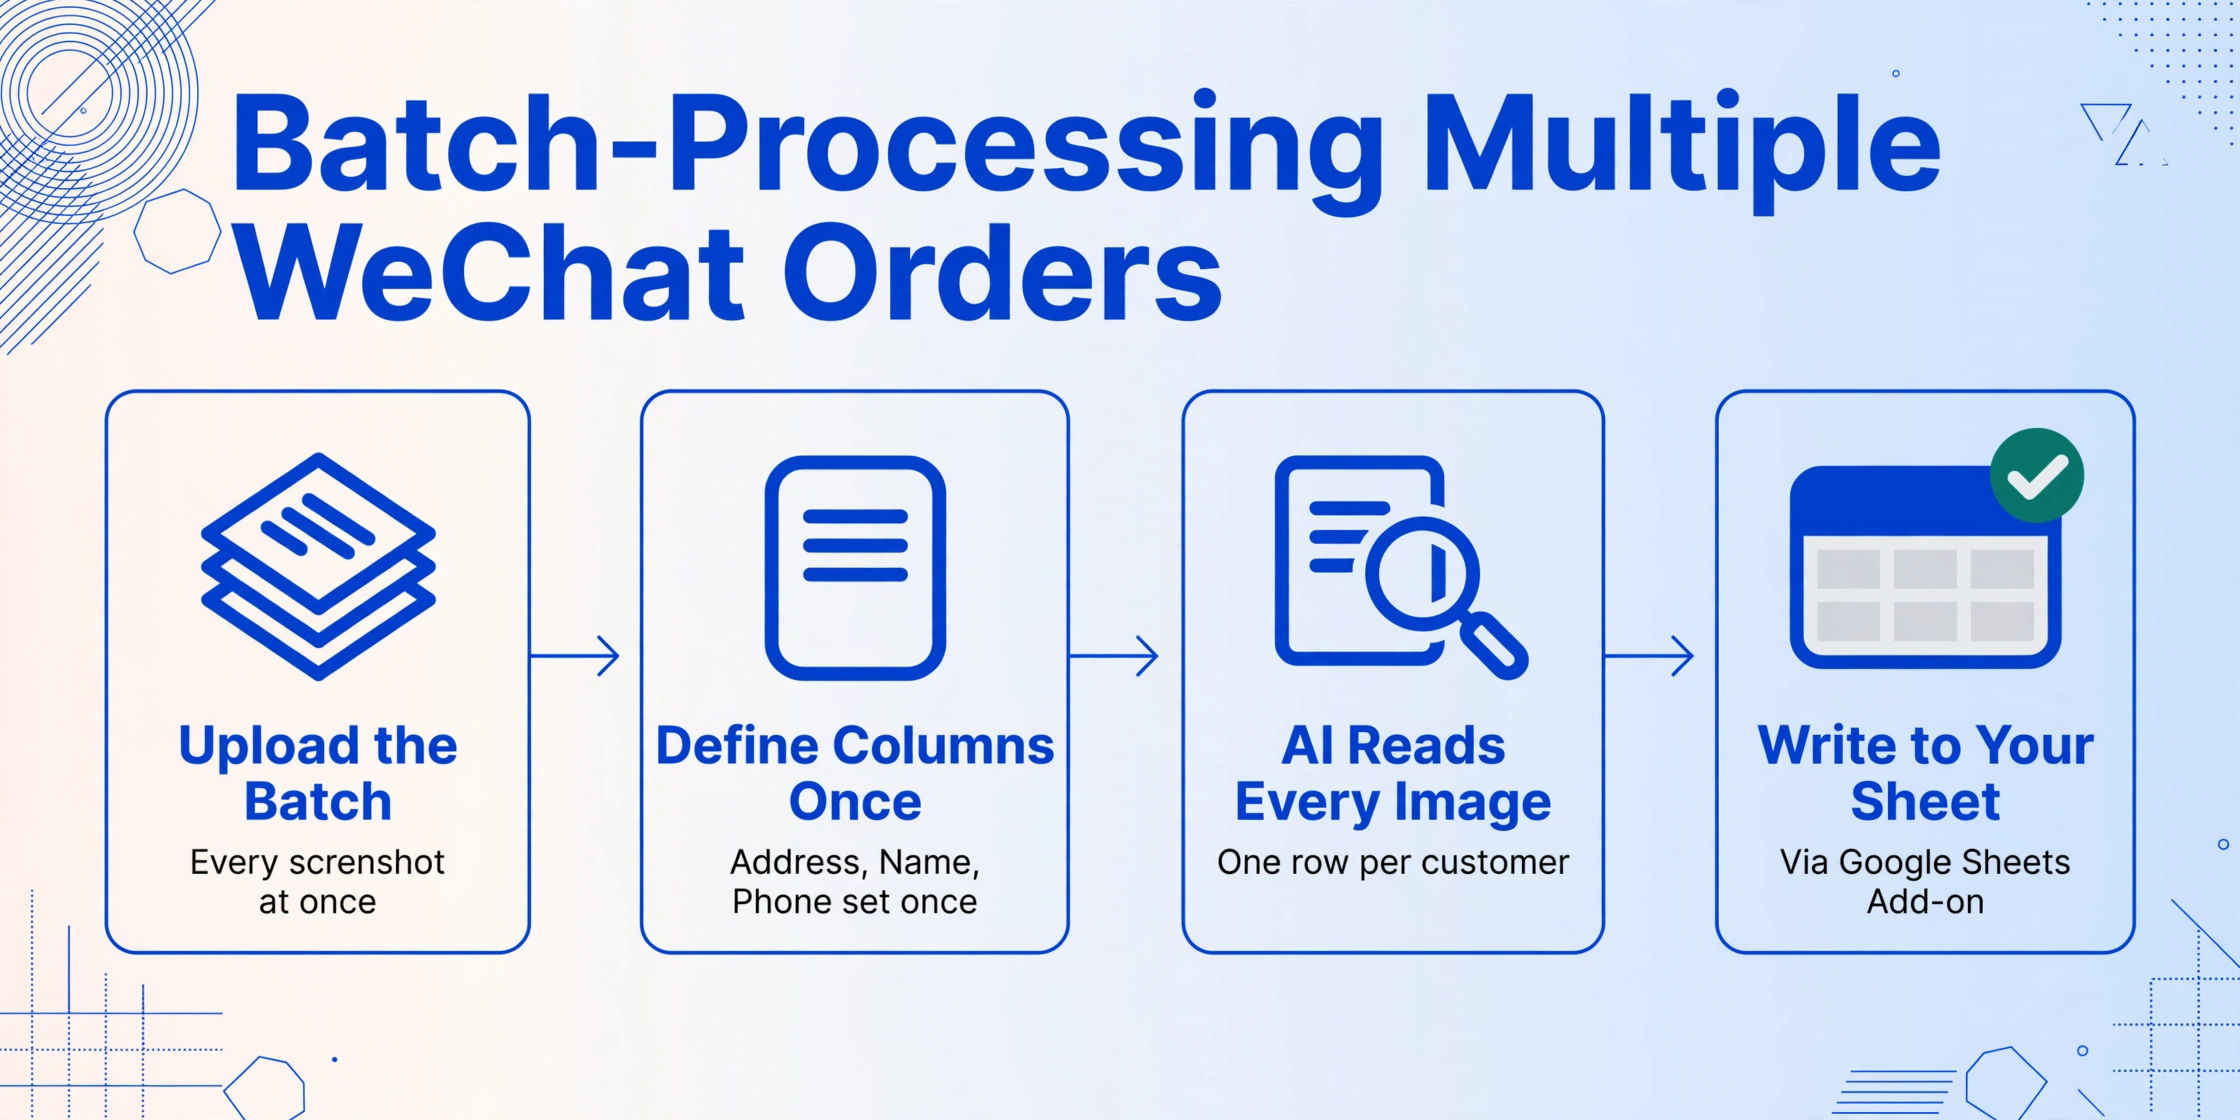
일괄 처리는 그 작업 흐름을 바꿔요. 각 고객의 채팅 주소 메시지가 담긴 스크린샷을 모두 한 번에 업로드해요. 열 정의 한 세트("배송 주소", "수취인 이름", "휴대폰 번호")를 한 번만 적용하면 돼요. AI가 배치의 모든 스크린샷을 읽고 통합된 표를 출력해요: 고객당 한 행씩, 주소·이름·휴대폰 번호가 세 개의 깔끔한 열로 정리되죠.
출력된 표는 Excel로 직접 내보내거나 ImageToTable.ai Google Sheets 애드온을 사용해 스프레드시트를 벗어나지 않고 Google Sheets에 바로 작성할 수 있어요. 각 행은 주문 하나로, 배송 라벨로 인쇄하거나 주문 관리 시스템에 가져오거나 물류 팀과 공유할 수 있어요. 주문당 작업 시간은 읽고 입력하는 데 약 1분에서 확인하는 데 몇 초로 줄어들어요.
추출의 가치는 주소 하나에서 몇 초를 아끼는 게 아니에요. 수작업을 늘리지 않고 하루 10건에서 30건으로 확장하는 것이 핵심이에요 — 병목은 주소를 읽는 게 아니라 매번 다시 입력하는 데 있으니까요.
동일한 일괄 작업 흐름은 앞서 논의한 주소 형식 변형에도 그대로 적용돼요. 한 배치에 완벽하게 구조화된 주소(성→시→구→로→이름→휴대폰)가 담긴 메시지 10개, 성(省)이 생략된 메시지 2개, 도로명 대신 랜드마크를 적은 고객 메시지 1개, 성(省) 단계가 아예 없는 직할시(베이징 또는 상하이) 메시지 1개가 섞여 있을 수 있어요. AI는 모든 주소를 구조적 구성 요소로 읽기 때문에 모든 주소가 동일한 템플릿을 따른다고 가정하지 않아요. 그래서 같은 패스로 모두 처리할 수 있어요.
여러 시장의 고객을 상대하며 WhatsApp으로도 주문을 처리하는 판매자라면, 같은 방식으로 WhatsApp Business로 보낸 주소 메시지에도 적용할 수 있어요. 추출 열은 동일하게 유지되고, 채팅 인터페이스만 달라질 뿐이에요.
자주 묻는 질문
중국어와 영어가 섞인 주소도 처리할 수 있나요?
네. 국제 물류를 다루는 일부 고객은 중국어 주소 구성 요소와 함께 영어 지명이나 호텔 이름을 포함하기도 합니다. 예: "广东省深圳市南山区 深圳湾万丽酒店 张伟 13800138000". AI는 두 언어를 모두 읽고 영어 텍스트를 주소 문자열의 일부로 처리하여 중국어 구성 요소와 함께 출력에 보존합니다.
주소가 여러 채팅 메시지에 나뉘어 있으면 어떻게 하나요?
각 스크린샷은 독립적으로 처리됩니다. 주소가 두 메시지에 걸쳐 있는 경우(고객이 한 메시지에 주소를 보내고 후속 메시지에 전화번호를 보내는 경우), 전체 대화 맥락이 포함된 단일 스크린샷에 둘 다 캡처하거나, 두 개의 개별 스크린샷을 캡처한 후 추출 후 행을 병합하면 됩니다. 이 도구는 업로드된 각 이미지에 보이는 내용을 기준으로 작동합니다.
복합 건물명에 있는 栋, 座, 区 같은 특수 문자도 처리하나요?
네. 중국어 주소 표시에는 栋(동), 座(좌), 区(구), 层(층), 号(호), 单元(유닛), 室(호) 등 다양한 어휘와 "B栋1206室" 또는 "3座2单元8层801" 같은 복합 조합이 사용됩니다. AI는 특정 문자 조합과 관계없이 이를 주소 구조 표시자로 인식합니다.
전체 도로명 주소 없이 시와 성(도)만 추출할 수 있나요?
네. 열을 "성(省)", "시(市)", "수취인(收件人)"으로 정의하고 "배송 주소(收货地址)"는 제외하면, AI는 지정한 행정 단위만 추출합니다. 전체 도로명 주소가 필요 없는 판매 분석이나 고객 분포 추적에 유용합니다.