Lire une adresse de livraison chinoise
et un numéro de téléphone à partir d'une capture d'écran de chat WeChat
Si vous vendez sur WeChat — en tant que vendeur 微商 (wēishāng), daigou (代购) acheteur personnel, ou propriétaire de petite entreprise qui prend des commandes directement dans le chat — vous connaissez exactement ce moment : un client vous envoie ses coordonnées de livraison en un seul message. « 广东省深圳市南山区科技南路18号 李明 13800138000 » — province, ville, district, rue, numéro de bâtiment, nom du destinataire et numéro de téléphone, tout cela sur une seule ligne ininterrompue. Le message contient tout ce dont vous avez besoin pour traiter la commande. Le seul problème, c'est que rien n'arrive dans des champs séparés. Vous lisez l'adresse, mémorisez le nom, copiez le numéro de téléphone et tapez chaque élément dans votre propre système de commandes — ou vous l'écrivez à la main sur le colis. À chaque commande, à chaque client, à chaque fois.
Points clés à retenir
- Une adresse de livraison chinoise arrive dans WeChat sous forme d'une seule ligne ininterrompue — province, ville, rue, bâtiment, nom du destinataire et numéro de téléphone — sans virgules, sans sauts de ligne et sans étiquettes de champ pour séparer le tout.
- L'OCR traditionnel renvoie la chaîne entière comme un seul bloc de texte — il ne peut pas dire où se termine le nom de la ville et où commence le numéro de rue, car ce ne sont que des caractères hanzi pour le moteur.
- Définissez des colonnes pour Adresse de livraison, Nom du destinataire et Numéro de téléphone — l'IA divise la chaîne en reconnaissant des marqueurs structurels comme 省, 路 (rue) et le modèle de numéro mobile à 11 chiffres qui termine toujours le message.
À quoi ressemble réellement un message d'adresse WeChat
Une adresse de livraison chinoise typique envoyée dans une conversation WeChat suit une hiérarchie décroissante : la plus grande unité géographique vient en premier, la plus petite en dernier, suivie du nom du destinataire et de son numéro de téléphone. Un message complet ressemble à ceci :
浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678
Province du Zhejiang, ville de Hangzhou, district de Xihu, rue Wensan n° 478, bâtiment Huaxing Technology, 12e étage appartement 1208 — Wang Fang — 13812345678
Dans cette seule chaîne de caractères, un lecteur humain identifie instantanément six points de données distincts : la province (省), la ville (市), le district (区), la rue et le bâtiment (路/号/楼/室), le nom du destinataire (收件人姓名) et le numéro de téléphone (手机号). L'adresse est structurée — le format d'adresse chinois est l'un des systèmes postaux les plus systématiquement hiérarchiques au monde — mais cette structure réside entièrement dans le sens des mots, et non dans une séparation visuelle. Il n'y a pas de sauts de ligne, pas de séparateurs de colonnes, pas de champs de formulaire. Juste un bloc continu de caractères chinois et de chiffres.
L'adresse est parfaitement structurée. Elle n'en a tout simplement pas l'air. Et c'est exactement le type de saisie que l'OCR traditionnel traite le moins bien.
Le même format se répète dans tous les scénarios de commande WeChat. Un client qui achète des vêtements à un vendeur WeChat (微商) envoie son adresse en un seul message. Un acheteur daigou confirme ses coordonnées de livraison de la même manière. Un fournisseur de restaurant qui reçoit des instructions de livraison via WeChat obtient le même type de texte — de la province au numéro de téléphone, le tout en un seul bloc. Le contenu est identique, quel que soit l'expéditeur : hiérarchie géographique + nom + téléphone, le tout concaténé en une seule chaîne qu'un humain analyse en une demi-seconde et qu'une machine interprète à tort comme un bloc de texte unique et indifférencié.
Le problème de hiérarchie — pourquoi une simple chaîne de caractères n'est pas une adresse
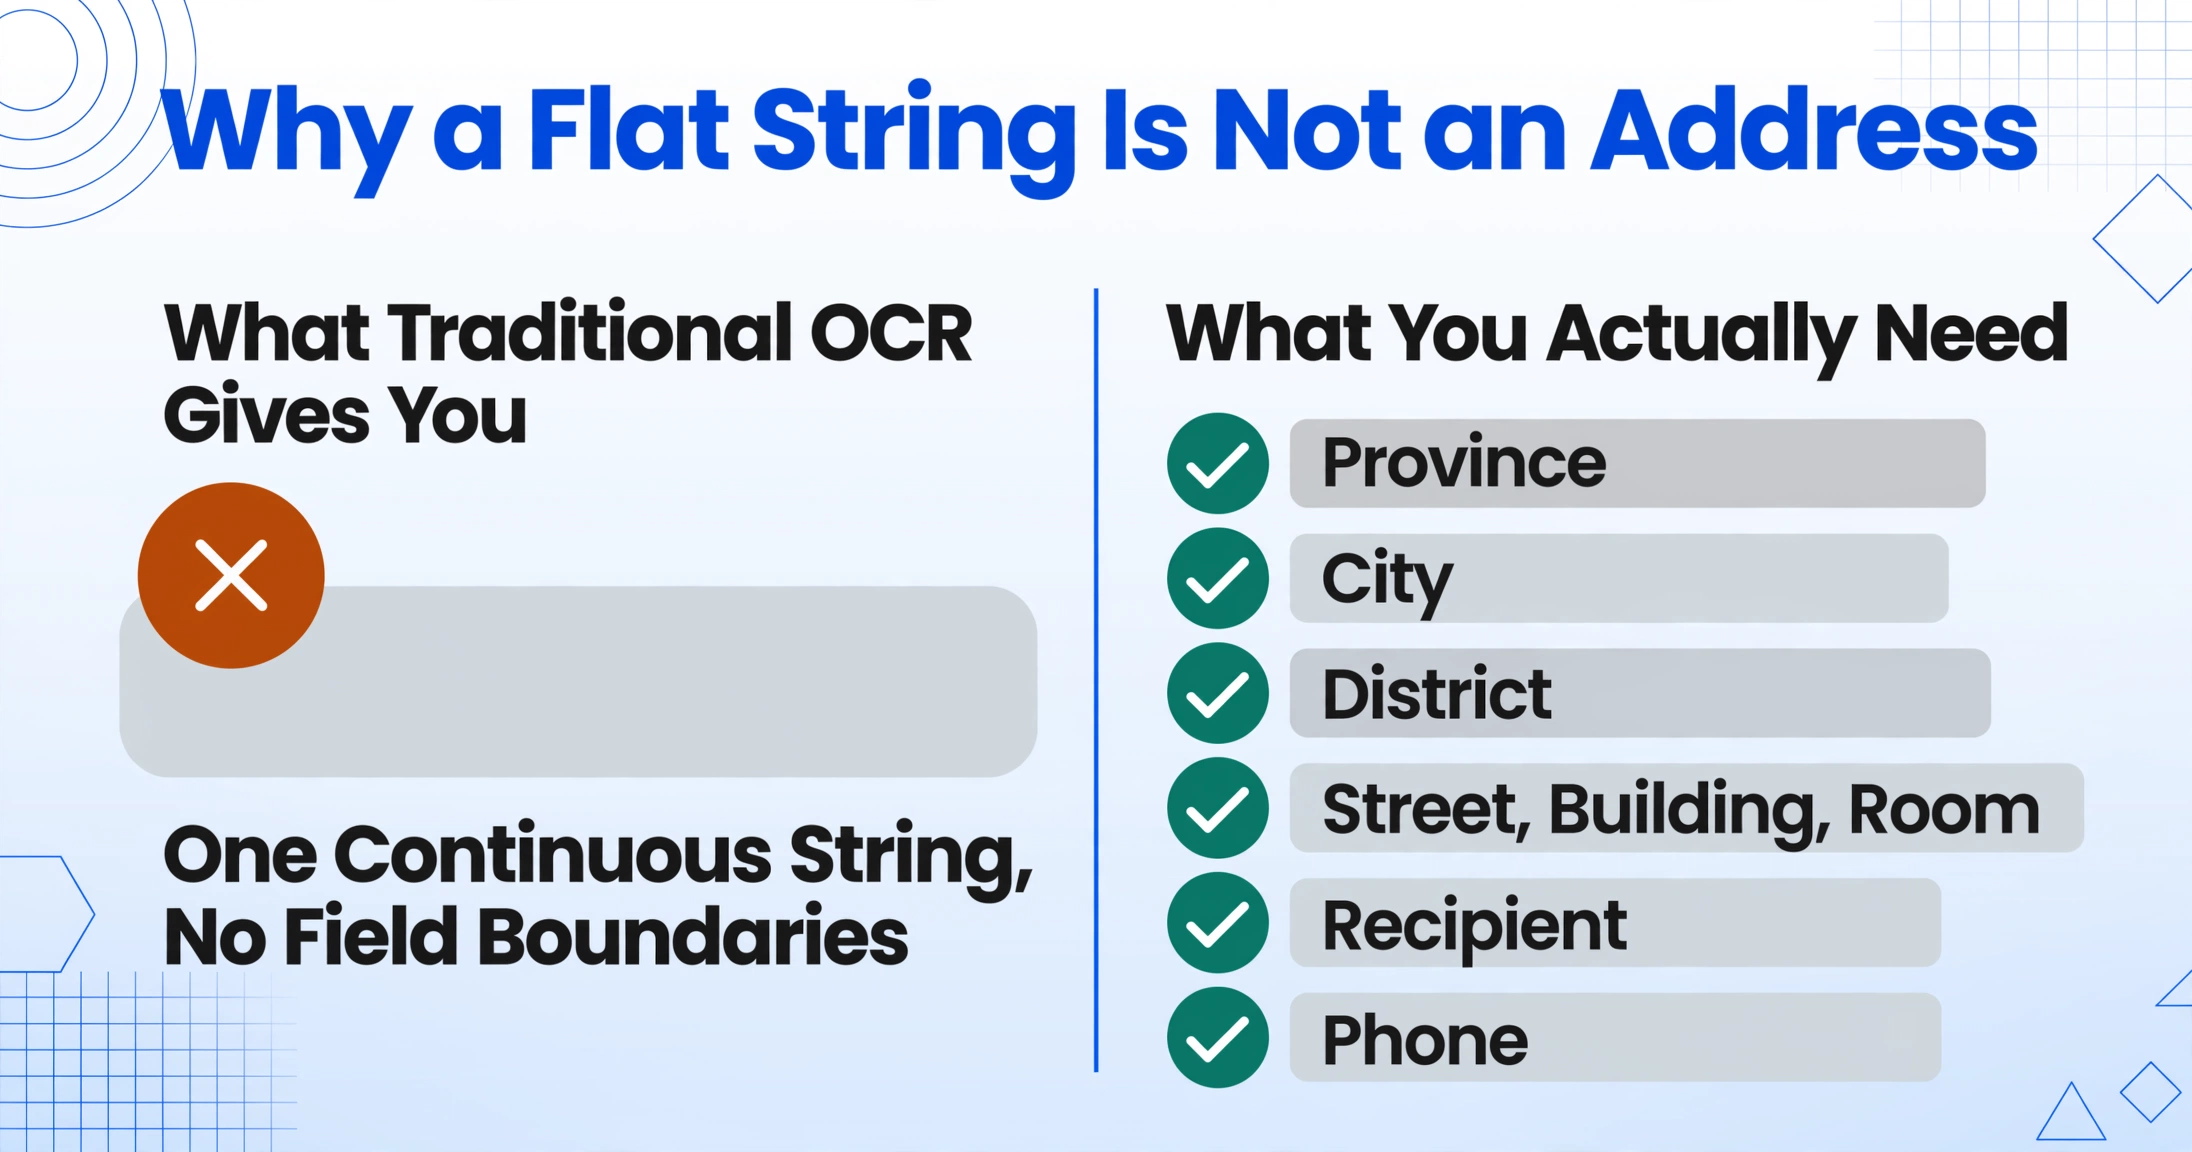
La difficulté ne vient pas du fait que les caractères chinois sont difficiles à reconnaître. L'OCR moderne lit le chinois imprimé avec une grande précision — la technologie de reconnaissance de caractères est fiable depuis des années. La difficulté vient du fait qu'une adresse chinoise n'est pas une séquence de caractères ; c'est une hiérarchie exprimée sous forme de séquence de caractères. L'OCR traditionnel traite la chaîne entière comme une seule ligne de texte. Il sort "浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678" comme un seul champ — une chaîne continue sans segmentation sémantique.
| Ce dont vous avez réellement besoin | Ce que vous donne l'OCR traditionnel |
|---|---|
| Province : 浙江省 | "浙江省杭州市西湖区文三路478号华星科技大厦12楼1208室 王芳 13812345678" |
| Ville : 杭州市 | |
| District : 西湖区 | |
| Adresse : 文三路478号华星科技大厦12楼1208室 | |
| Destinataire : 王芳 | |
| Téléphone : 13812345678 |
Le problème s'aggrave lorsque les adresses ne sont pas parfaitement formées. Un client peut omettre entièrement la province lorsqu'il commande auprès d'un vendeur de la même province : "杭州市西湖区文三路478号" sans "浙江省" au début. Un autre peut n'inclure que la ville et le district : "深圳南山科技南路18号" — en omettant la province et en utilisant une abréviation bien connue pour le district. Certaines adresses omettent le nom du bâtiment et ne donnent que le numéro de rue et un point de repère à proximité. L'OCR traditionnel n'a aucun moyen de normaliser ces variations car il ne sait même pas qu'il regarde une adresse.
Le numéro de téléphone, qui semble être l'élément le plus facile à séparer, a ses propres pièges dans le bloc d'adresse. Un numéro de portable chinois comporte 11 chiffres commençant par 1 — un schéma clair en isolation. Mais lorsqu'il se trouve à la fin d'une chaîne d'adresse qui contient aussi des numéros de bâtiment (comme "12楼" ou "1208室"), un outil qui extrait naïvement toutes les séquences de chiffres pourrait attraper "478" (le numéro du bâtiment), "12" (l'étage), "1208" (le numéro de l'appartement) et "13812345678" (le vrai téléphone). Il n'a aucun moyen de savoir quel groupe de chiffres est le numéro de téléphone et lesquels sont des composants de l'adresse.
Le schéma du numéro de téléphone (11 chiffres, commence par 1) est facile à repérer pour un humain — mais un outil qui ne comprend pas qu'il regarde une adresse attrapera tous les numéros de la page et les appellera tous « données ».
Comment l'IA visuelle lit différemment la même capture d'écran
C'est là que l'approche d'extraction passe de la reconnaissance de caractères à la compréhension sémantique. Au lieu de scanner la capture d'écran pour tout le texte et de le restituer sous forme de bloc plat, un outil d'IA visuelle lit l'image en se demandant : « quel type d'information est-ce, et où chaque élément a-t-il sa place ? »
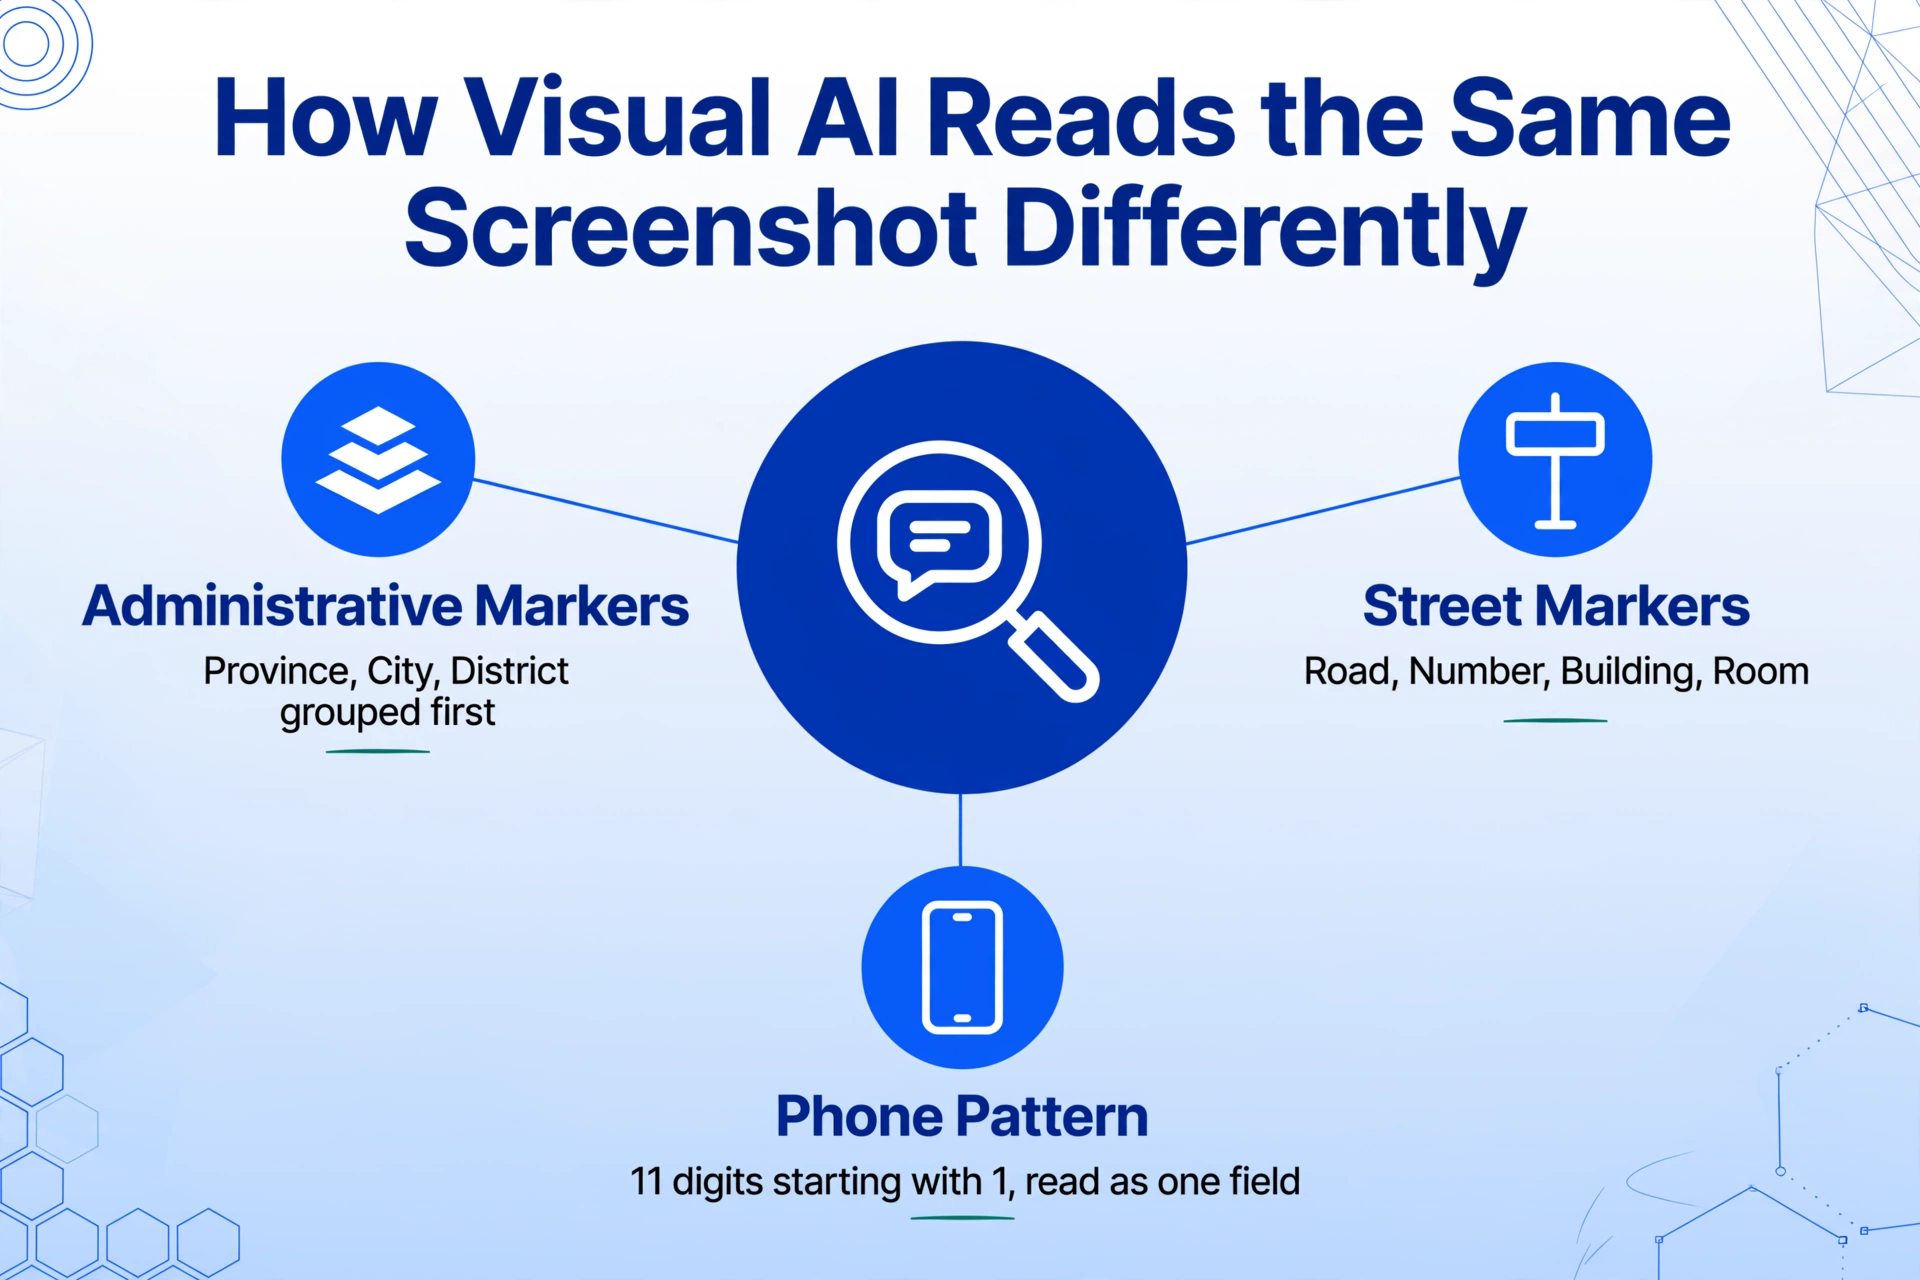
Avec l'Extraction de colonnes personnalisées, vous définissez les colonnes souhaitées — « Adresse de livraison (收货地址) », « Destinataire (收件人) », « Numéro de téléphone (联系电话) » — et l'IA localise les valeurs correspondantes en comprenant ce que chacune signifie dans le contexte du format d'adresse chinois. Elle n'a pas besoin qu'on lui dise que 省 marque la province ou que 路 marque le nom de la rue. Elle identifie ces marqueurs parce qu'elle comprend la grammaire structurelle des adresses chinoises — de la même manière que vous savez instinctivement que « 浙江省 » est la province, même si vous n'avez jamais étudié la géographie chinoise.
Voici comment l'approche sémantique traite chaque composant du bloc d'adresse :
L'IA identifie 省, 市 et 区/县 comme mots-clés de délimitation administrative. Elle regroupe tout ce qui se trouve entre le début de l'adresse reconnue et le premier repère de rue comme zone administrative supérieure. Si la province est omise (fréquent dans les commandes intra-province), elle utilise le nom de la ville comme ancrage de premier niveau.
Des repères comme 路 (rue), 街 (avenue), 大道 (boulevard), 号 (n°), 楼 (bâtiment), 幢 (immeuble) et 室 (appartement) délimitent l'adresse détaillée. L'IA lit la séquence de ces repères pour reconstituer l'adresse complète au niveau de la rue, même lorsque le format varie — certains messages utilisent « XX路XX号XX楼XX室 », d'autres « XX路XX号XX大厦XX层 ».
Les noms chinois comptent généralement 2 à 3 caractères et apparaissent juste avant le numéro de téléphone, après l'adresse. L'IA reconnaît la transition entre les repères d'adresse et le bloc du nom — le nom est ce qui reste entre le dernier composant d'adresse (室, 号 ou nom du bâtiment) et le début du numéro de téléphone à 11 chiffres.
Le motif mobile à 11 chiffres commençant par 1 est le délimiteur le plus fiable de toute la chaîne. L'IA l'identifie par son motif et sa position — il s'agit toujours de la dernière séquence numérique du bloc d'adresse, distincte des numéros de bâtiment (plus courts et situés au milieu de la chaîne, à côté de 号 ou 楼).
Cette approche fonctionne parce que l'IA n'a pas besoin de savoir exactement quelle ville ou quel nom de rue apparaît sur la capture d'écran. Elle doit savoir que quelque chose à cette position fait office de ville, que quelque chose fait office de rue, et que quelque chose fait office de numéro de téléphone. L'extraction est guidée par le rôle structurel que joue chaque segment dans le format d'adresse chinois — un format qui, malgré les variations locales, est l'une des hiérarchies postales les plus cohérentes au monde.
Le même principe que celui appliqué à l'extraction de données à partir de captures d'écran de paiement qui ne sont pas des reçus officiels s'applique ici : vous définissez les colonnes de sortie, et l'IA localise les valeurs correspondantes sur la capture d'écran en comprenant leur signification, et non en faisant correspondre un modèle. Que l'entrée soit un écran de confirmation WeChat Pay ou un message de chat avec une adresse de livraison, la méthode est la même — l'extraction sémantique lit par le sens, pas par la position.
Traitement par lots de plusieurs commandes WeChat
Un vendeur WeChat ne reçoit pas les commandes une par une. Lors d'une journée chargée, le journal de discussion se remplit de messages d'adresse provenant de plusieurs clients — chacun avec un nom différent, une ville différente, un ensemble d'instructions de livraison différent. Transcrire manuellement dix adresses signifie lire dix messages, copier dix numéros de portable et saisir dix noms dans une feuille de commande ou une étiquette de colis. Le processus est le même à chaque fois, et le schéma d'erreur est le même à chaque fois : un chiffre inversé dans le numéro de téléphone, un numéro de rue mal lu, un district mal identifié.
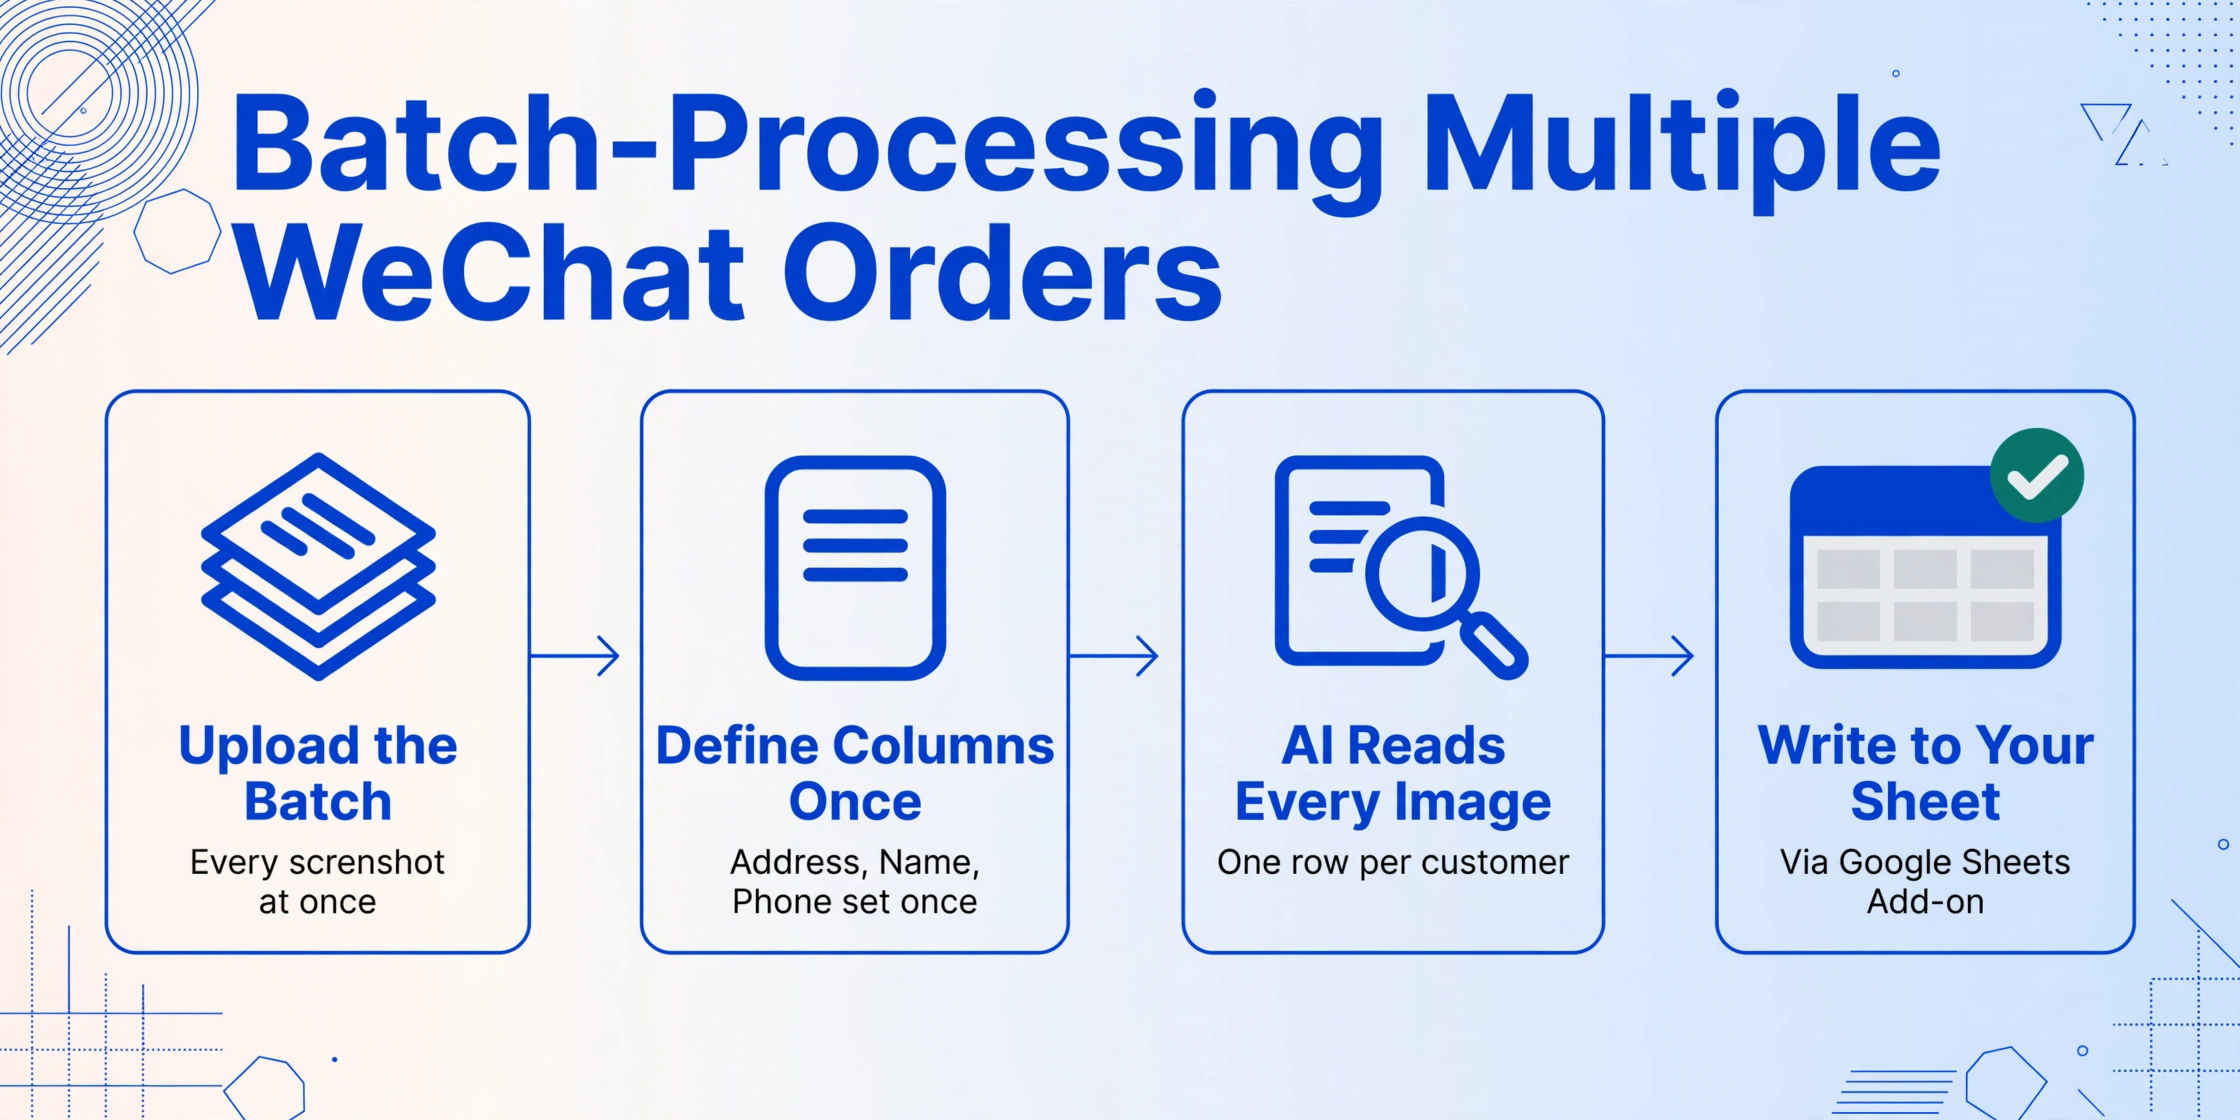
Le traitement par lots change ce flux de travail. Toutes les captures d'écran — chacune montrant le message d'adresse d'un client dans la discussion — sont téléchargées ensemble. Un seul ensemble de définitions de colonnes (« Adresse de livraison », « Nom du destinataire », « Numéro de téléphone ») est appliqué une fois. L'IA lit chaque capture d'écran du lot et génère un tableau unifié : une ligne par client, avec l'adresse, le nom et le numéro de téléphone dans trois colonnes propres.
Le tableau de sortie peut être exporté directement vers Excel ou écrit directement dans Google Sheets à l'aide de l'extension Google Sheets d'ImageToTable.ai — sans quitter la feuille de calcul. Chaque ligne correspond à une commande, prête à être imprimée comme étiquette d'expédition, importée dans votre système de gestion des commandes ou partagée avec votre équipe de traitement. L'effort par commande passe d'environ une minute de lecture et de saisie à quelques secondes de vérification.
La valeur de l'extraction ne consiste pas à gagner quelques secondes sur une seule adresse. Il s'agit de passer de dix commandes par jour à trente sans ajouter de travail manuel — car le goulot d'étranglement n'est pas la lecture de l'adresse, mais sa ressaisie à chaque fois.
Le même flux de travail par lots s'applique aux variations de format d'adresse évoquées précédemment. Un lot peut contenir dix messages avec des adresses parfaitement structurées (province→ville→district→rue→nom→téléphone), deux avec la province omise, un où le client a inclus un point de repère au lieu d'un nom de rue, et un dans une municipalité (Pékin ou Shanghai) qui n'a aucun niveau de province. L'IA les traite tous en une seule passe, car elle lit chaque adresse par ses composants structurels — et non en supposant que chaque adresse suit exactement le même modèle.
Pour les vendeurs qui gèrent également des commandes sur WhatsApp — en particulier ceux qui servent des clients sur différents marchés — la même approche s'étend aux messages d'adresse envoyés via WhatsApp Business. Les colonnes d'extraction restent les mêmes ; seule l'interface de discussion change.
Questions fréquentes
Peut-il gérer des adresses contenant à la fois du texte chinois et anglais ?
Oui. Certains clients travaillant avec la logistique internationale peuvent inclure des noms de lieux ou d'hôtels en anglais à côté des composants d'adresse chinois — par exemple « 广东省深圳市南山区 深圳湾万丽酒店 张伟 13800138000 ». L'IA lit les deux écritures et traite le texte anglais comme faisant partie de la chaîne d'adresse, le conservant dans le résultat aux côtés des composants chinois.
Que faire si l'adresse est répartie sur plusieurs messages dans une conversation ?
Chaque capture d'écran est traitée indépendamment. Si l'adresse s'étend sur deux messages — le client envoie l'adresse dans un message et le numéro de téléphone dans un autre — vous devez capturer les deux dans une seule capture qui inclut le contexte complet de la conversation, ou prendre deux captures distinctes et fusionner les lignes après l'extraction. L'outil fonctionne sur ce qui est visible dans chaque image téléchargée.
Gère-t-il les caractères spéciaux dans les noms d'adresse — comme 栋, 座, 区 dans les noms de bâtiments composés ?
Oui. Les marqueurs d'adresse chinois incluent un vocabulaire étendu — 栋 (bâtiment/bloc), 座 (immeuble), 区 (zone), 层 (étage), 号 (numéro), 单元 (unité), 室 (appartement) — et des combinaisons composées comme « B栋1206室 » ou « 3座2单元8层801 ». L'IA reconnaît ces marqueurs de structure d'adresse, quelle que soit la combinaison de caractères spécifique utilisée.
Puis-je extraire uniquement la ville et la province sans l'adresse complète ?
Oui. Définissez vos colonnes comme « Province (省) », « Ville (市) » et « Nom du destinataire (收件人) » — en omettant « Adresse de livraison (收货地址) » — et l'IA extrait uniquement les niveaux administratifs que vous spécifiez. Cela est utile pour l'analyse des ventes ou le suivi de la répartition des clients lorsque l'adresse complète n'est pas nécessaire.