「OCRが遅いのはなぜ?」
バッチ処理が遅くなる根本原因3つと、それぞれの修正方法
ほとんどのOCRベンチマークはスペックシート上では良好に見えます。Tesseractは1秒未満のページ処理を主張し、GPU上のEasyOCRは毎分190ページを記録します。ところが、実際に自分のバッチを実行すると—サプライヤーの請求書200枚、スマホ写真とスキャンPDFが混在—突然1ページあたり30秒かかります。週末は消え去ります。ボトルネックはほぼ常に3つのうちの1つです。ここではその見つけ方を説明します。
重要なポイント
- 同じOCRエンジンが1秒未満でベンチマークされるのに、200枚の請求書バッチで1ページあたり30秒かかるのは、バグではなく、パイプライン内で静かに複合する3つの独立した速度低下です。
- 3つの増倍要因がパイプライン内で複合します—GPUがないと3〜7倍遅くなり、過大な画像は4倍のペナルティを追加し、逐次処理はCPUの4分の3をアイドル状態にします—それぞれ数分で診断でき、独立して修正できます。
- 3つの修正をすべて最大限に活用してもバッチが1時間以上かかる場合、ボトルネックはもはやパイプライン内にはありません—最速の残された手段は、チューニングノブを回し続けるのではなく、アーキテクチャを交換することです。
原因1:計算負荷の高いパイプラインでGPUアクセラレーションが使われていない
症状。処理中にCPU使用率が100%に達し、クリーンなドキュメントでも1ページあたり1秒以上かかります。バッチにファイルを追加してもスループットは向上しません。パイプラインが飽和状態になっています。
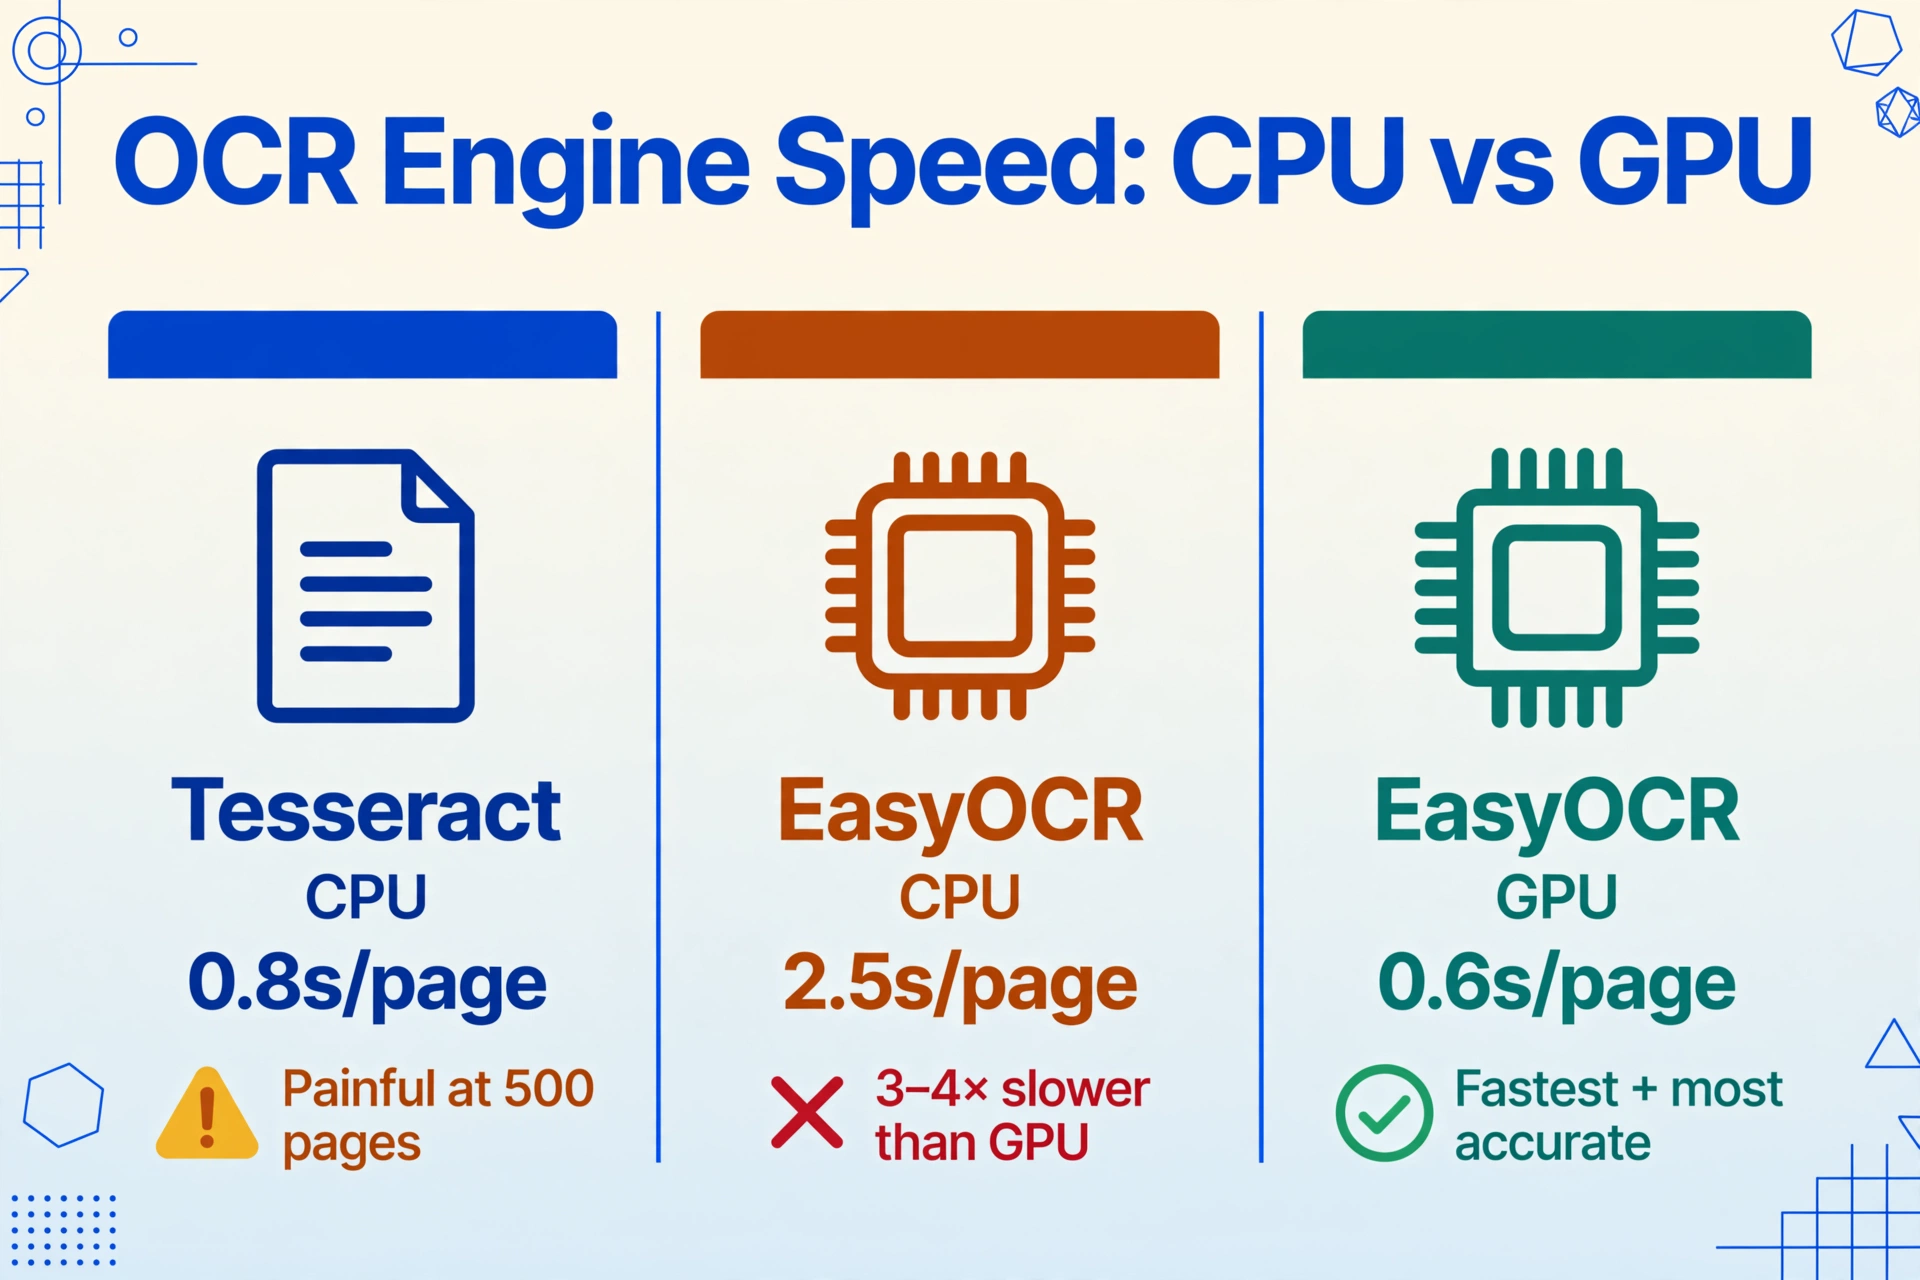
根本原因。すべてのOCRエンジンが内部で同等に作られているわけではありません。Tesseractは、Googleが保守するオープンソースのベンチマークであり、純粋にCPUベースのエンジンです。連結成分分析、ページレイアウト解析、LSTMベースの文字認識といった従来のコンピュータビジョンパイプラインを使用しており、いずれもGPU並列処理を活用していません。ある研究者のベンチマークでは、Tesseract 5は最新のCPUでクリーンな印刷テキストを約1ページあたり0.8秒で処理しました。数ページなら許容範囲ですが、500ページでは苦痛です。
EasyOCRは異なるアーキテクチャアプローチを採用しています。そのディープラーニングバックボーン(CRAFTテキスト検出+PyTorch認識ネットワーク)はGPUで実行でき、その場合、劇的に高速化します。しかし、多くの人が見落とす落とし穴があります。EasyOCRは、互換性のあるGPUが検出されない場合、自動的にCPUにフォールバックします。CPUでは、EasyOCRを高精度にしている同じディープラーニングパイプラインが、GPUモードよりも3〜4倍遅くなります。NVIDIA T4でのベンチマークでは、EasyOCR GPUはTesseractに匹敵する約0.6秒/ページを達成する一方、EasyOCR CPUは約2.5秒/ページにまで伸びます。
修正方法。OCRパイプラインが実際にGPUを使用しているか確認してください:
- EasyOCRの場合、
reader = easyocr.Reader(['en'], gpu=True)が実際にCUDAを検出するか確認します。ライブラリが静かにフォールバックすると、1ページあたりの時間は2倍以上になります。処理中にnvidia-smiを実行し、GPU使用率が0%の場合は、パイプラインがCPUで実行されています。 - Tesseractの場合、GPUトグルはありません。単にGPUアクセラレーションをサポートしていません。数百ページ以上を処理する場合は、GPU対応エンジンへの切り替えを検討してください。
- PaddleOCRのような専用OCRエンジンは、最初からGPU向けに構築されています。独立した速度ベンチマークでは、PaddleOCRはRTX 3090上で最適化されたバッチ推論とCUDA統合により、約毎分190ページ(1秒あたり3ページ以上)を達成しています。
ハードウェアが固定されている場合(ディスクリートGPUのないラップトップ、共有サーバー、GPUのないクラウドVM)、GPUパスを直接利用することはできません。その場合、GPUバックアップのインフラストラクチャでドキュメントを処理するクラウドベースのOCRサービス(ハードウェアを自分で用意する必要がない)が、問題を完全に回避します。
GPU対応OCRエンジンの比較については、最高のオープンソースOCRツールのまとめをご覧ください。
原因2:OCRが実際に必要とするよりもはるかに大きな画像
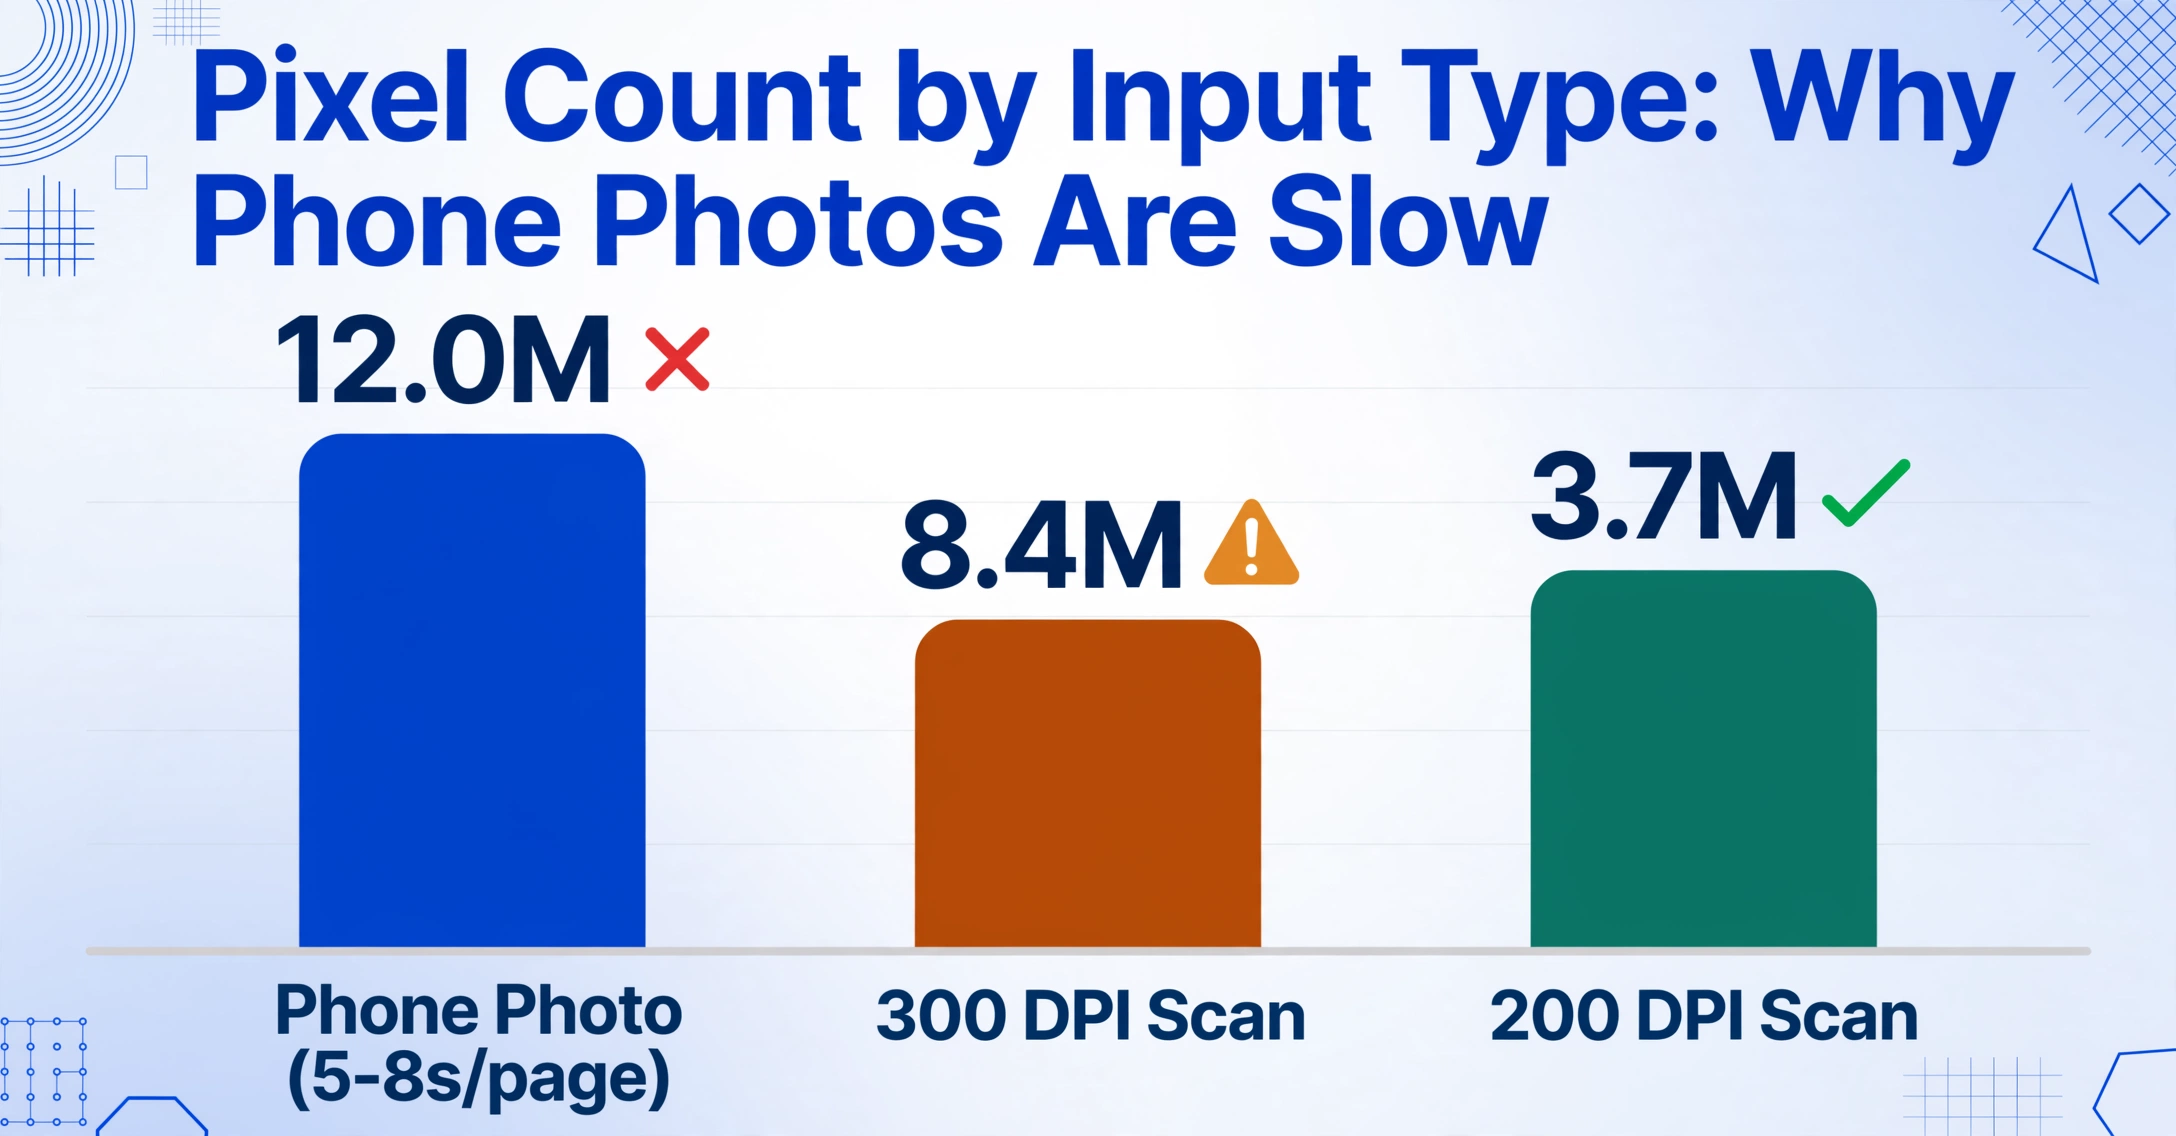
症状。 あなたには完全に読みやすく見えるページで処理が止まってしまうことがあります。レシートの1200万画素のスマホ写真は5〜8秒かかるのに、同じ文書のスキャンPDFは2秒未満で処理されます。
根本原因。 ほとんどのOCRエンジンは画像内のすべてのピクセルを処理します。各軸の解像度を2倍にする(150 DPIから300 DPIへ)と、ピクセル数は4倍になります。幅が2倍×高さが2倍だからです。入力が4倍になると、同じコンテンツに対して処理時間もおよそ4倍になります。4000×3000ピクセルのスマートフォン写真には1200万ピクセルが含まれています。同じ文書を300 DPI(レターサイズでおよそ2550×3300)でスキャンした場合、840万ピクセルです。200 DPIでスキャンした文書(ほとんどのOCRに十分な解像度)には、わずか370万ピクセルしか含まれていません。
OCRパフォーマンスチューニングに関する最も権威あるドキュメントの1つであるABBYY FineReader Engine Performance Guideは、推奨入力範囲として200〜400 DPIを指定しています。150 DPI未満では文字認識が低下します。400 DPIを超えると、測定可能な精度向上がないまま計算時間を支払うことになります。同じ原則は、オープンソースかプロプライエタリかを問わず、あらゆるOCRエンジンに適用されます。
修正方法。 OCRエンジンに画像を渡す前に画像をリサイズする前処理ステップを追加します。目標は出力画像で150〜300 DPI、一般的な文書では長辺がおよそ1200〜2500ピクセルです。
Pillowを使用したシンプルなPython前処理パイプライン:
from PIL import Image

def resize_for_ocr(image_path, max_dim=2000):
    img = Image.open(image_path)
    # 縮小のみ、拡大はしない
    if max(img.size) > max_dim:
        ratio = max_dim / max(img.size)
        new_size = (int(img.size[0] * ratio),
                    int(img.size[1] * ratio))
        img = img.resize(new_size, Image.LANCZOS)
return imgこの1つのステップだけで、ソース画像によっては1ページあたりの処理時間を40〜70%削減でき、抽出精度にはまったく影響しません。二値化、傾き補正、コントラスト正規化を含む画像準備の完全なガイドについては、OCR画像前処理ガイドをお読みください。
原因 #3: 並列処理が可能なのに逐次処理を行っている
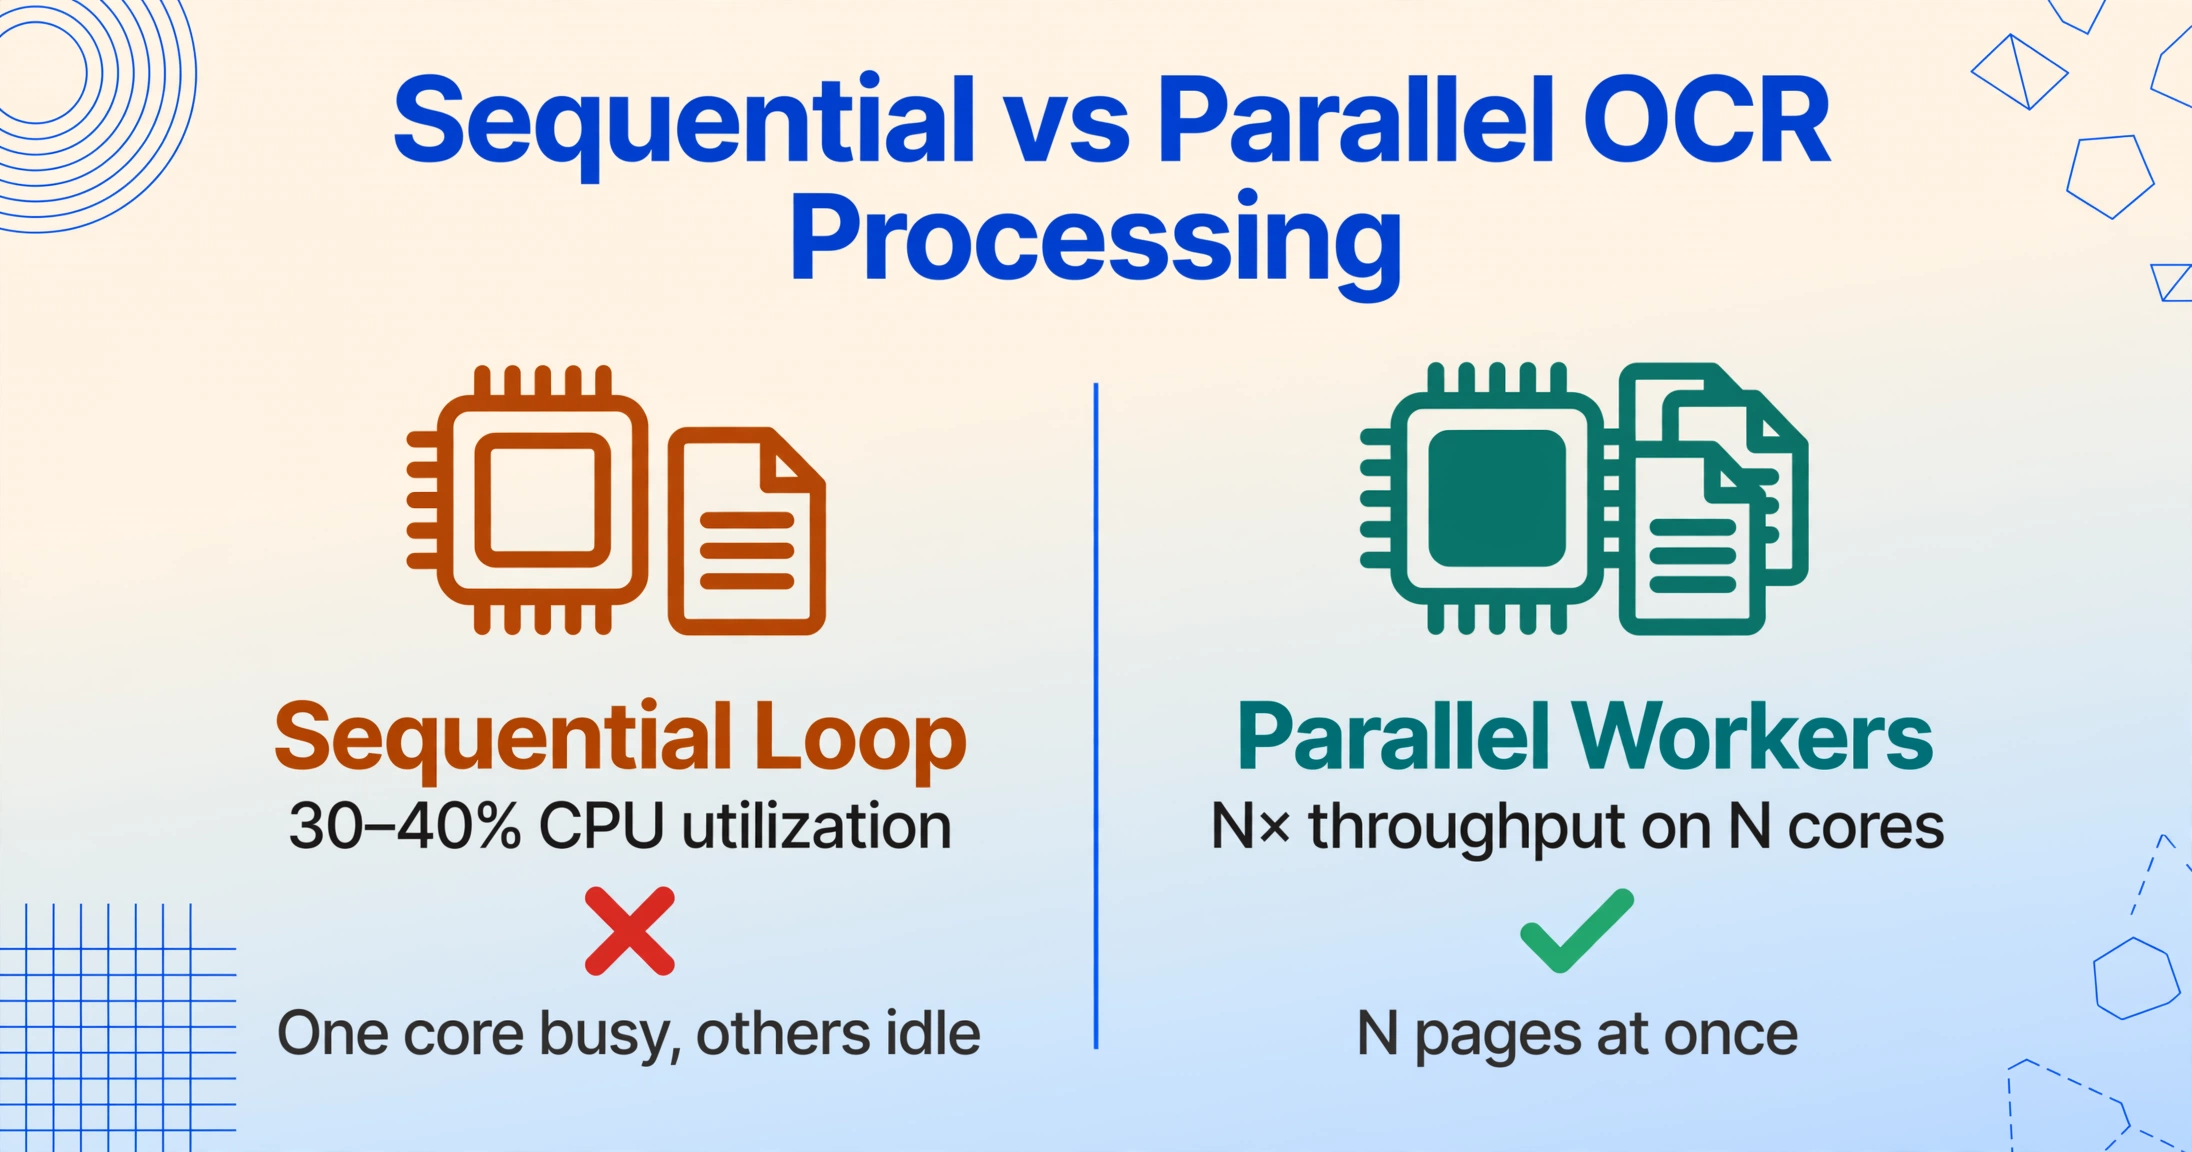
症状。バッチ実行中のCPU使用率が30〜40%前後で推移します。パイプラインがファイルを1つずつ処理するため、プログレスバーが1ファイルずつ進むのを見守るだけで、速度が向上することはありません。
根本原因。ほとんどのOCRパイプラインは単純なループ、つまりfor file in files: ocr(file)として書かれています。これはデフォルトでシングルスレッドです。最近のCPUには4コア、8コア、16コアがありますが、逐次ループはそのうちの1コアしか使用しません。ページが待ち行列に並んでいる間、他のコアはアイドル状態です。
この修正は非常に簡単な並列化です。あるページのOCR処理は他のページのOCR処理とは独立しています。同期すべき共有状態がありません。つまり、NコアのマシンでNページを同時に処理でき、理論上はN倍のスループットを達成できます。実際には、スケーリングは4〜8コアまでほぼ線形ですが、それを超えるとメモリ帯域幅とI/O競合により効果が減少します。
修正方法。OCR呼び出しを並列実行フレームワークでラップします:
- GNU Parallel (Linux/macOS): スクリプトベースのパイプラインには最も簡単な方法です。
parallel -j 4 ocrmypdf {} output/{} ::: *.pdfは4つのOCRプロセスを同時に実行します。 - Pythonのmultiprocessing:
multiprocessing.Poolを使用してファイルをワーカープロセスに分散します。各ワーカーは独自のOCRエンジンインスタンスを持ち、結果は完了次第収集されます。 - バッチ処理ツール: OCRmyPDFのような専用のバッチOCRツールは、組み込みの並列処理をサポートしています。その
--jobsパラメータが並列度を制御します。これをGNU Parallelと組み合わせて(I/O飽和を避けるために並列ジョブを2に制限)、実績のある本番環境のパターンとして使用します。
重要な実践的考慮事項: 各並列ワーカーは、ページの画像と中間バッファを保持するために十分なメモリを必要とします。8GBのRAMのマシンで8つのワーカーを実行すると、スワッピングが発生します。標準的なドキュメント画像の場合、安全な開始点は並列ワーカーあたり2GBのRAMです。CPUコア数に達する前に、メモリ予算に合わせて並列度を調整してください。
並列バッチパイプラインの設定に関する完全なチュートリアルは、複数ファイルのバッチ処理に関するガイドをご覧ください。
対応の判断基準 — チューニングではなくツールを切り替える
3つの原因すべてを確認した場合 — GPUが動作している、画像サイズが正しい、パイプラインが並列実行されている — それでも処理がワークロードに対して遅すぎるなら、ボトルネックは設定の問題ではなくアーキテクチャの問題かもしれません。
根本的に異なるアプローチを検討すべきタイミングを示すシグナルは3つあります:
1. ボリュームが一貫して多い場合。 毎日500ページ以上を処理し、バッチ完了時間が常に課題となっているなら、ローカルOCRパイプラインのチューニングでは、専用クラウドサービスが提供する性能には常に及ばないでしょう。クラウド抽出サービスは、自動負荷分散を備えたサーバーグレードのGPUクラスターで動作します — 単一のバッチを数十の並列ワーカーに分散でき、ハードウェアの調達は不要です。
2. ドキュメントが多様で未処理の場合。 クリーンなスキャンPDF向けに最適化されたパイプラインでは、スマートフォンの写真、くしゃくしゃのレシート、手書きを含むドキュメントには対応が難しいでしょう。入力タイプごとに異なる前処理パラメータが必要です。ImageToTable.aiはドキュメントを意味的に読み取るビジョン言語モデルを使用します — 人間と同じようにページレイアウトを解釈し、ドキュメントタイプごとのチューニングは不要です。解像度正規化のための個別の前処理ステップも不要です。クラウドパイプラインが推論前に自動的にスケーリングを処理するためです。
3. 結果が数時間ではなく数分で必要な場合。 300ページのバッチを昼休み中に処理してエクスポートする必要がある場合、シーケンシャルなローカルパイプライン — 高速化のためにチューニングされていても — では対応できません。クラウドのバッチ処理はドキュメント全体のボリュームにわたって並列化されます。単一CPU搭載マシンで3〜4時間かかる300ページのバッチも、20〜40の並列GPUワーカーで同じ作業を実行するクラウドインフラストラクチャでは5〜10分で完了します。
よくある質問
TesseractはEasyOCRより速いですか?
CPUの場合、Tesseractの方が一般的に速く、鮮明な印刷テキストで1ページあたり約0.8秒に対し、EasyOCRは約2.5秒です。GPUでは比較が逆転します。NVIDIA GPU上のEasyOCRは1ページあたり約0.6秒で動作し、Tesseractのスループットに匹敵またはそれを上回り、劣化画像、手書き注釈、混在レイアウトでは大幅に優れた精度を提供します。実用的な結論:GPUがある場合はEasyOCR(またはPaddleOCR)を使用してください。CPUのみの場合は、Tesseractが鮮明な文書でより良いスループットを提供しますが、複雑な入力では精度が低くなることが予想されます。
OCR速度に最適な画像解像度は?
200~300 DPIがほとんどのOCRエンジンにとって最適な範囲です。150 DPI未満では、特に小さなフォントサイズで文字認識精度が著しく低下します。400 DPIを超えると、精度の向上が無視できるかゼロであるにもかかわらず、処理時間が2~4倍になります。標準的なレターサイズ文書(8.5"×11")の場合、200 DPIで約1700×2200ピクセル(約3.7メガピクセル)の画像になります。これは一般的なスマートフォンの写真よりもはるかに小さく、処理時間もわずかです。
複数のGPUを使用してOCRを高速化できますか?
はい、OCRエンジンが対応しており、ワークロードが十分に大きい場合に可能です。PaddleOCRとEasyOCRは、異なる文書バッチを異なるGPUインスタンスに割り当てることで、複数のGPUに分散できます。実際には、1台の最新GPU(RTX 3090以上)で標準文書を毎分150~190ページ処理できるため、マルチGPU構成は非常に大量(1日あたり10,000ページ以上)の場合にのみ必要です。その規模では、主なボトルネックは計算からI/O(ファイルの読み取り、結果の書き込み)に移行するため、マルチGPU構成は高速ストレージ(NVMe SSD)と十分なRAMと組み合わせる必要があります。
GPUはCPUと比べてOCRがどのくらい速くなりますか?
EasyOCRやPaddleOCRのような深層学習ベースのOCRエンジンでは、GPUアクセラレーションにより、CPUのみの処理と比較して、GPUモデルや画像の特性にもよりますが、通常3~7倍の速度向上が得られます。一般的なクラウドGPUであるNVIDIA T4では、EasyOCRはCPUフォールバック時と比べて約4倍高速です。RTX 3090のようなコンシューマー向けGPUでは、PaddleOCRは毎分190ページ以上を処理し、同じパイプラインを実行する4コアCPUと比較して5~7倍の改善を示します。TesseractはGPUアクセラレーションをサポートしていないため、その速度はCPUの性能に完全に依存し、直接比較することはできません。
画像サイズを小さくするとOCR精度は低下しますか?
画像サイズの縮小は、OCRエンジンが小さな文字を読み取るために必要な最小解像度を下回った場合にのみ精度を低下させます。ほとんどの印刷文書では、200 DPIで99%以上の文字精度が十分に得られます。150 DPIを下回ると、8ptフォントの脚注、小数点、下付き文字などの細かい部分が失われ始める可能性があります。安全な方法は、200~300 DPIの目標解像度にリサイズすることです。これにより、読みやすさを維持しながら、処理を遅くするだけの4~5メガピクセルの冗長データを排除できます。文書に非常に小さな文字(例:6~8ptの法的な細則)が含まれている場合は、300 DPIを下限として設定してください。
いつチューニングをやめて別のツールに切り替えるべきですか?
バッチ処理時間が、OCRエンジン自体ではなく、前処理、ファイルI/O、シリアライズといったパイプラインのオーバーヘッドによって支配されている場合、ローカルでのチューニングの実用的な限界に達しています。切り替え時を示す兆候としては、GPUアクセラレーション、解像度の正規化、並列処理をすでに実装しているにもかかわらず、300ページのバッチ処理に依然として1時間以上かかる場合や、文書の種類が多様(スマートフォン写真、スキャン、スクリーンショット、手書き文字の混在など)で、ページごとに前処理パラメータを調整する必要がある場合などが挙げられます。このようなシナリオでは、GPUワーカー間で処理を並列化し、文書を意味的に読み取る(タイプごとのチューニングが不要な)クラウドベースの抽出サービスの方が、速度と精度の両方でローカルでチューニングされたパイプラインを上回ります。