"Por que o OCR é tão lento?"
3 causas raiz do processamento lento em lote — e como corrigir cada uma
A maioria dos benchmarks de OCR parece boa na ficha técnica. O Tesseract afirma páginas em menos de um segundo. O EasyOCR em uma GPU registra 190 páginas por minuto. Então você executa seu próprio lote — 200 notas fiscais de fornecedores, misturando fotos de celular e PDFs escaneados — e de repente cada página leva 30 segundos. O fim de semana se foi. O gargalo é quase sempre uma de três coisas. Veja como encontrar o seu.
Principais conclusões
- 30 segundos por página em um lote de 200 notas fiscais — quando o mesmo mecanismo de OCR tem benchmark de menos de um segundo — não é um bug, são três lentidões independentes se acumulando silenciosamente dentro do seu pipeline.
- Três multiplicadores se acumulam dentro do seu pipeline — sem GPU você fica 3 a 7 vezes mais lento, imagens superdimensionadas adicionam uma penalidade de 4×, e o processamento sequencial deixa três quartos da sua CPU ociosa — e cada um pode ser diagnosticado em minutos e corrigido de forma independente.
- Quando você esgotou as três correções e seu lote ainda leva mais de uma hora, o gargalo não está mais no pipeline — a jogada mais rápida restante é trocar a arquitetura, não continuar girando os botões de ajuste.
Causa nº 1: Sem aceleração de GPU em um pipeline de alto processamento
Sintoma. Sua CPU atinge 100% durante o processamento e cada página leva mais de um segundo em documentos limpos. A taxa de transferência não melhora quando você adiciona mais arquivos a um lote — o pipeline está saturado.
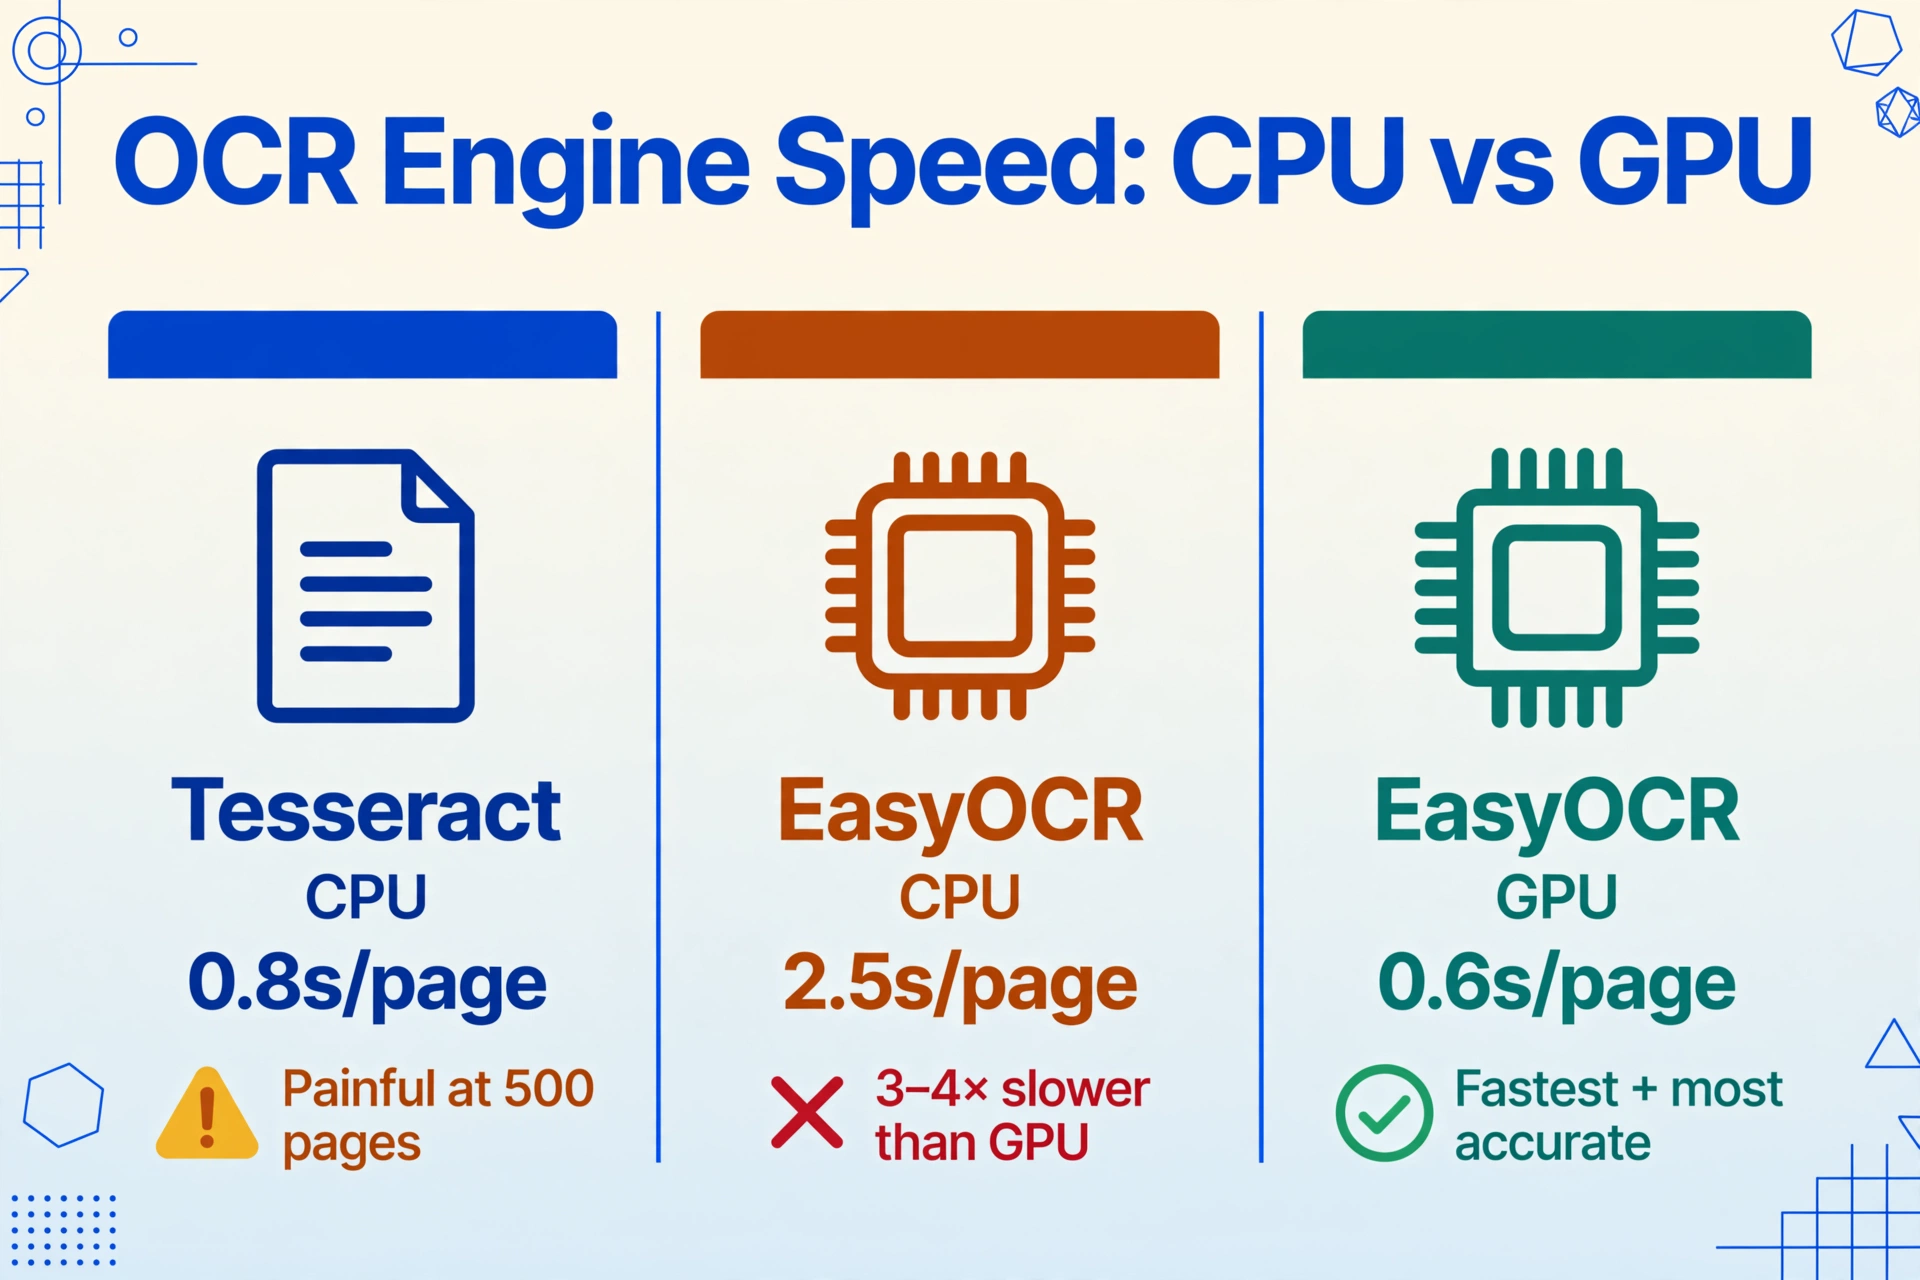
Causa raiz. Nem todos os mecanismos de OCR são criados iguais por baixo dos panos. Tesseract, o benchmark de código aberto mantido pelo Google, é um mecanismo puramente baseado em CPU. Ele usa pipelines tradicionais de visão computacional — análise de componentes conectados, análise de layout de página e reconhecimento de caracteres baseado em LSTM — nenhum dos quais aproveita o paralelismo de GPU. O benchmark de um pesquisador cronometrou o Tesseract 5 em aproximadamente 0,8 segundos por página em uma CPU moderna com texto impresso limpo. Aceitável para algumas páginas. Doloroso em 500.
EasyOCR adota uma abordagem arquitetônica diferente. Seu backbone de aprendizado profundo (detecção de texto CRAFT + uma rede de reconhecimento PyTorch) pode rodar em GPU — e quando roda, é dramaticamente mais rápido. Mas aqui está o detalhe que a maioria das pessoas perde: o EasyOCR volta para CPU automaticamente se nenhuma GPU compatível for detectada. Na CPU, o mesmo pipeline de aprendizado profundo que torna o EasyOCR preciso também o torna três a quatro vezes mais lento do que seu modo GPU. Benchmarks em uma NVIDIA T4 mostram o EasyOCR GPU atingindo ~0,6 segundos por página — comparável ao Tesseract — enquanto o EasyOCR CPU se estende para ~2,5 segundos por página.
A correção. Verifique se seu pipeline de OCR está realmente usando uma GPU:
- Para EasyOCR, verifique se
reader = easyocr.Reader(['en'], gpu=True)realmente detecta CUDA. Se a biblioteca voltar silenciosamente, seu tempo por página mais que dobrará. Executenvidia-smidurante o processamento — se a utilização da GPU mostrar 0%, seu pipeline está rodando na CPU. - Para Tesseract, não há alternância de GPU — ele simplesmente não suporta aceleração de GPU. Se você está processando mais do que algumas centenas de páginas, considere mudar para um mecanismo com capacidade de GPU.
- Mecanismos de OCR dedicados como PaddleOCR são construídos para GPU desde o início. Benchmarks de velocidade independentes colocam o PaddleOCR em uma RTX 3090 em aproximadamente 190 páginas por minuto — mais de 3 páginas por segundo — devido à inferência em lote otimizada e integração CUDA.
Se seu hardware for fixo (laptop sem GPU discreta, servidor compartilhado, VM em nuvem sem GPU), o caminho da GPU não está disponível para você diretamente. Nesse caso, um serviço de OCR em nuvem que processa documentos em infraestrutura com GPU — sem exigir que você provisione o hardware — contorna o problema completamente.
Para uma comparação lado a lado de mecanismos de OCR com capacidade de GPU, veja nosso resumo das melhores ferramentas de OCR de código aberto.
Causa nº 2: Imagens Muito Maiores do que o OCR Realmente Precisa
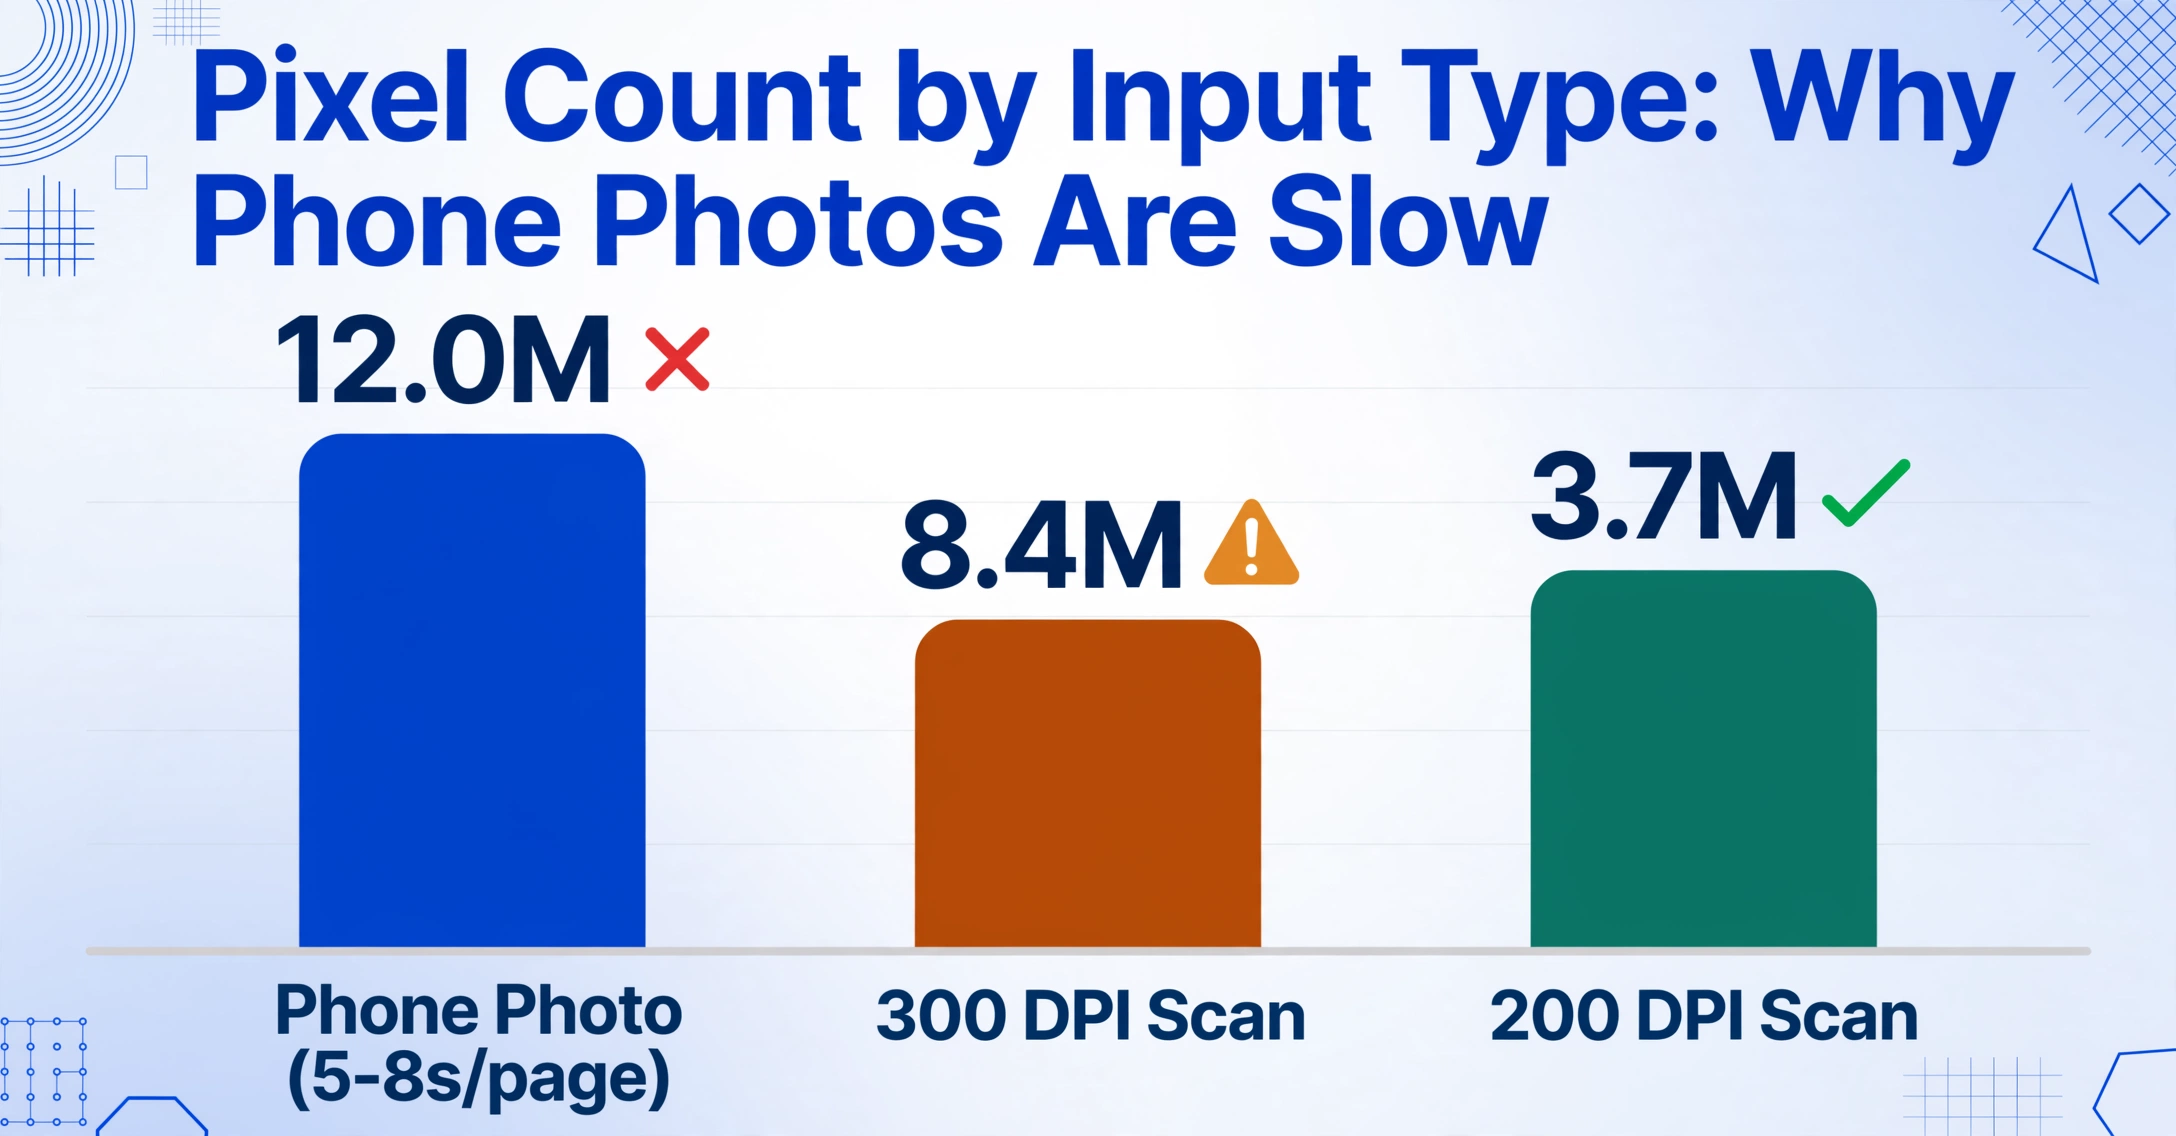
Sintoma. O processamento fica extremamente lento em páginas que parecem perfeitamente legíveis para você. Uma foto de 12 megapixels de um recibo tirada com celular leva de 5 a 8 segundos, enquanto um PDF digitalizado do mesmo documento leva menos de 2 segundos.
Causa raiz. A maioria dos mecanismos de OCR processa cada pixel da imagem. Dobre a resolução em cada eixo — de 150 DPI para 300 DPI — e você quadruplica a contagem de pixels: 2x a largura vezes 2x a altura. Quadruplicar a entrada significa aproximadamente 4x o tempo de processamento para o mesmo conteúdo. Uma foto de smartphone com 4000×3000 pixels contém 12 milhões de pixels. O mesmo documento digitalizado a 300 DPI (aproximadamente 2550×3300 para tamanho carta) contém 8,4 milhões. Um documento digitalizado a 200 DPI — perfeitamente adequado para a maioria dos OCRs — contém apenas 3,7 milhões de pixels.
O Guia de Desempenho do Mecanismo ABBYY FineReader, um dos documentos mais autoritativos sobre ajuste de desempenho de OCR, especifica 200–400 DPI como a faixa de entrada recomendada. Abaixo de 150 DPI, o reconhecimento de caracteres degrada. Acima de 400 DPI, você está pagando tempo de computação sem ganho mensurável de precisão. O mesmo princípio se aplica a qualquer mecanismo de OCR, de código aberto ou proprietário.
A correção. Adicione uma etapa de pré-processamento que redimensiona as imagens antes de enviá-las ao mecanismo de OCR. O alvo é 150–300 DPI na imagem de saída — aproximadamente 1200–2500 pixels no lado mais longo para um documento típico.
Um pipeline simples de pré-processamento em Python com Pillow:
from PIL import Image

def resize_for_ocr(image_path, max_dim=2000):
    img = Image.open(image_path)
    # Apenas reduzir, nunca ampliar
    if max(img.size) > max_dim:
        ratio = max_dim / max(img.size)
        new_size = (int(img.size[0] * ratio),
                    int(img.size[1] * ratio))
        img = img.resize(new_size, Image.LANCZOS)
    return img
Esta única etapa pode reduzir o tempo de processamento por página em 40–70% dependendo das suas imagens de origem, sem impacto na precisão da extração. Para um guia completo sobre preparação de imagens — incluindo binarização, correção de inclinação e normalização de contraste — leia nosso guia de pré-processamento de imagens para OCR.
Causa nº 3: Processamento Sequencial Quando Você Podría Executar em Paralelo
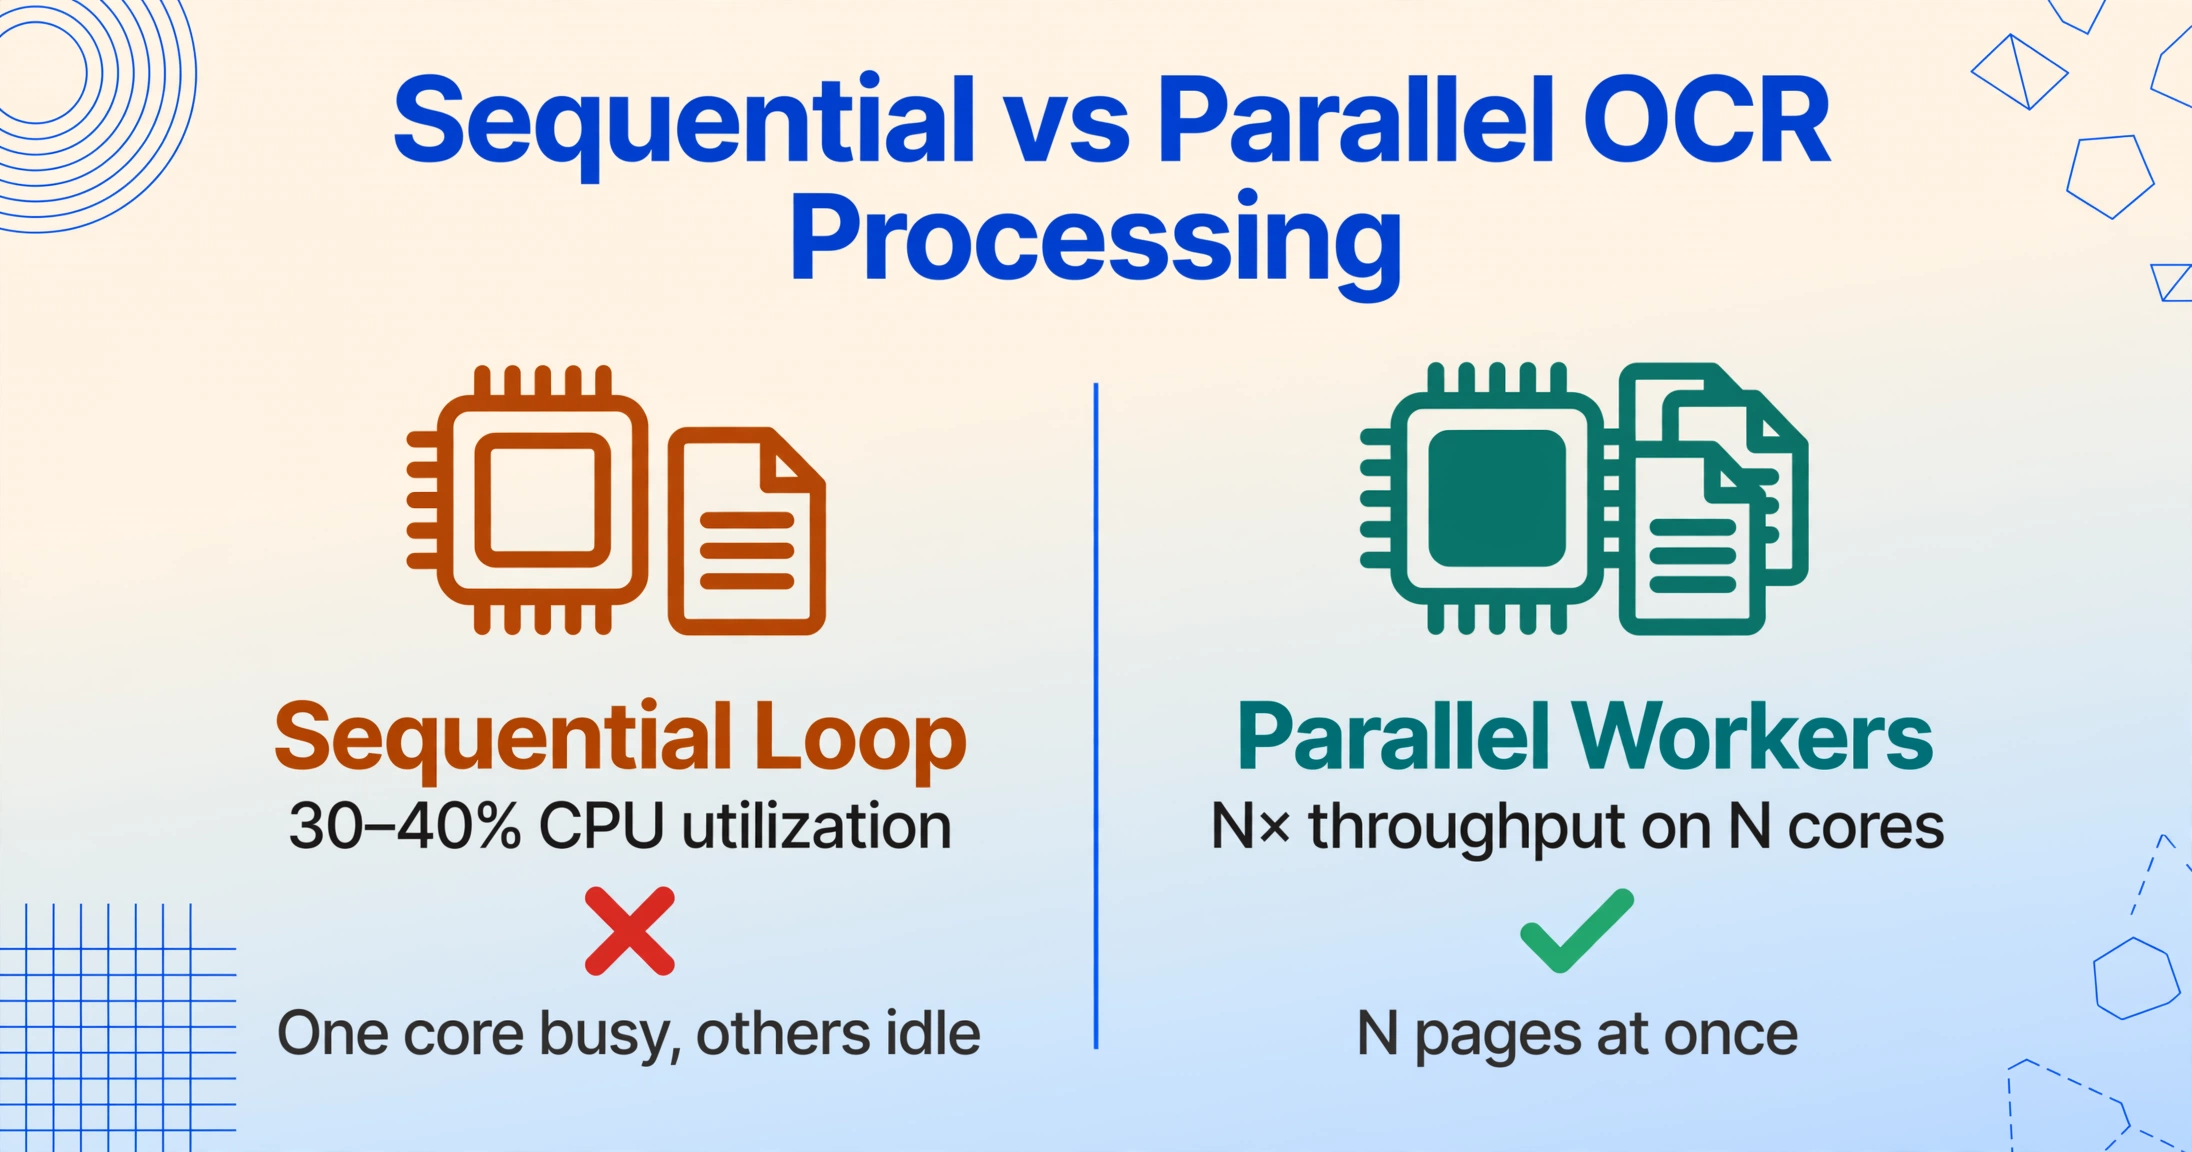
Sintoma. O uso da CPU fica em torno de 30–40% durante uma execução em lote. O pipeline processa os arquivos um a um — você observa a barra de progresso avançar, arquivo por arquivo, sem nunca acelerar.
Causa raiz. A maioria dos pipelines de OCR são escritos como loops simples: for file in files: ocr. Isso é single-threaded por padrão. CPUs modernas têm 4, 8 ou 16 núcleos, mas um loop sequencial usa exatamente um deles. Os outros núcleos ficam ociosos enquanto as páginas se acumulan na fila.
A correção é embaraçosamente paralela — o OCR em uma página é independente do OCR em qualquer outra página. Não há estado compartilhado para sincronizar. Isso significa que você pode processar N páginas simultáneamente em uma máquina de N núcleos e, na teoria, alcanzar N× de throughput. Na prática, o escalamento é quase linear até 4–8 núcleos, com retornos decrescentes além disso devido à largura de banda de memória e contenção de I/O.
A correção. Envolva sua chamada de OCR em um framework de execução paralela:
- GNU Parallel (Linux/macOS): A abordagem mais simples para pipelines baseados em scripts.
parallel -j 4 ocrmypdf {} output/{} ::: *.pdfexecuta quatro processos de OCR concorrentemente. - Python multiprocessing: Use
multiprocessing.Poolpara distribuir arquivos entre processos workers. Cada worker obtiene sua própria instância do motor de OCR, e os resultados são coletados conforme são completados. - Ferramentas de processamento em lote: Ferramentas dedicadas de OCR em lote como OCRmyPDF suportam processamento paralelo integrado. Seu parámetro
--jobscontrola a concorrencia. Combiná-lo com GNU Parallel (limitando parallel a 2 jobs para evitar saturação de I/O) é um padrão de produção documentado.
A consideración prática clave: cada worker paralelo necesita suficiente memória para manter a imagem de sua página e os buffers intermediários. Executar 8 workers em uma máquina com 8 GB de RAM provocará swapping. Um ponto de partida seguro é 2 GB de RAM por worker paralelo para imagens de documentos estándar. Escale o paralelismo para coincidir com seu orçamento de memória antes de alcanzar o número de núcleos de CPU.
Para um tutorial completo sobre como configurar pipelines de lote paralelos, veja nosso guía sobre processamento em lote de múltiples arquivos.
Quando Escalar — Troque as Ferramentas em Vez de Ajustar
Se você verificou todas as três causas — sua GPU está ativa, suas imagens estão dimensionadas corretamente e seu pipeline executa em paralelo — mas o processamento ainda está lento demais para sua carga de trabalho, o gargalo pode ser arquitetural, e não de configuração.
Três sinais sugerem que é hora de considerar uma abordagem fundamentalmente diferente:
1. Seu volume é consistentemente alto. Se você processa 500+ páginas diariamente e o tempo de conclusão do lote é um ponto de dor recorrente, ajustar um pipeline de OCR local sempre ficará atrás do que um serviço de nuvem especializado pode oferecer. Os serviços de extração em nuvem rodam em clusters de GPU de nível servidor com balanceamento de carga automático — um único lote pode ser distribuído entre dezenas de workers paralelos sem que você provisione qualquer hardware.
2. Seus documentos são diversos e não processados. Um pipeline otimizado para PDFs escaneados limpos terá dificuldades com fotos de celular, recibos amassados ou documentos com escrita manual. Cada novo tipo de entrada exige parâmetros de pré-processamento diferentes. O ImageToTable.ai usa modelos de visão-linguagem que leem documentos semanticamente — interpretando o layout da página da mesma forma que um humano faria, sem exigir ajustes por tipo de documento. Ele não precisa de uma etapa separada de pré-processamento para normalização de resolução, pois o pipeline em nuvem lida com o redimensionamento automaticamente antes da inferência.
3. Você precisa de resultados em minutos, não em horas. Se um lote de 300 páginas precisa ser processado e exportado durante uma pausa para o almoço, um pipeline local sequencial — mesmo otimizado para velocidade — não vai entregar. O processamento em lote na nuvem paraleliza todo o volume de documentos. Um lote de 300 páginas que leva 3–4 horas em uma única máquina com CPU pode ser concluído em 5–10 minutos em infraestrutura em nuvem que executa o mesmo trabalho em 20–40 workers de GPU paralelos.
Perguntas Frequentes
O Tesseract é mais rápido que o EasyOCR?
Na CPU, o Tesseract costuma ser mais rápido — cerca de 0,8 segundos por página contra 2,5 segundos do EasyOCR para texto impresso limpo. Na GPU, a comparação se inverte: o EasyOCR em uma GPU NVIDIA roda a aproximadamente 0,6 segundos por página, igualando ou superando a taxa do Tesseract, enquanto oferece precisão significativamente maior em imagens degradadas, anotações manuscritas e layouts mistos. A conclusão prática: se você tem GPU, use EasyOCR (ou PaddleOCR). Se for apenas CPU, o Tesseract oferece melhor taxa para documentos limpos, mas espere menor precisão em entradas complexas.
Qual resolução de imagem é melhor para velocidade de OCR?
200–300 DPI é o ponto ideal para a maioria dos mecanismos de OCR. Abaixo de 150 DPI, a precisão do reconhecimento de caracteres cai visivelmente, especialmente para fontes pequenas. Acima de 400 DPI, você paga 2–4× mais tempo de processamento para um ganho de precisão insignificante ou nulo. Para um documento tamanho carta padrão (8,5"×11"), 200 DPI produz uma imagem de aproximadamente 1700×2200 pixels — cerca de 3,7 megapixels. Isso é muito menor que uma foto típica de smartphone e será processado em uma fração do tempo.
Posso usar várias GPUs para acelerar o OCR?
Sim, se seu mecanismo de OCR suportar e sua carga de trabalho for grande o suficiente para se beneficiar. O PaddleOCR e o EasyOCR podem ser distribuídos entre várias GPUs atribuindo diferentes lotes de documentos a diferentes instâncias de GPU. Na prática, uma única GPU moderna (RTX 3090 ou superior) já processa 150–190 páginas por minuto para documentos padrão, então configurações com várias GPUs só são necessárias em volumes muito altos (10.000+ páginas por dia). O principal gargalo nessa escala muda de computação para E/S — leitura de arquivos, gravação de resultados — portanto, uma configuração com várias GPUs deve ser combinada com armazenamento rápido (SSDs NVMe) e RAM suficiente.
Quanto mais rápido é GPU vs CPU para OCR?
Para um mecanismo de OCR baseado em aprendizado profundo como EasyOCR ou PaddleOCR, a aceleração por GPU geralmente oferece um ganho de velocidade de 3 a 7 vezes em relação ao processamento apenas com CPU, dependendo do modelo de GPU e das características da imagem. Em uma NVIDIA T4 (uma GPU comum em nuvem), o EasyOCR é cerca de 4 vezes mais rápido que sua versão para CPU. Em GPUs de consumo como a RTX 3090, o PaddleOCR atinge mais de 190 páginas por minuto — uma melhoria de 5 a 7 vezes em relação a uma CPU de 4 núcleos executando o mesmo pipeline. O Tesseract não suporta aceleração por GPU, portanto sua velocidade é determinada exclusivamente pelo desempenho da CPU e não é diretamente comparável.
Reduzir o tamanho da imagem reduz a precisão do OCR?
Reduzir o tamanho da imagem só reduz a precisão se você ficar abaixo da resolução mínima que o mecanismo de OCR precisa para ler caracteres pequenos. Para a maioria dos documentos impressos, 200 DPI são suficientes para 99%+ de precisão de caracteres. Abaixo de 150 DPI, você pode começar a perder detalhes finos: notas de rodapé em fonte 8pt, pontos decimais e caracteres subscritos. A abordagem segura é redimensionar para uma resolução alvo de 200–300 DPI — isso preserva a legibilidade enquanto elimina os 4 a 5 megapixels de dados redundantes que só retardam o processamento. Se seus documentos contiverem texto muito pequeno (por exemplo, letras miúdas legais em 6–8pt), defina 300 DPI como seu mínimo.
Quando devo parar de ajustar e mudar para uma ferramenta diferente?
Quando o tempo de processamento em lote é dominado pela sobrecarga do pipeline — pré-processamento, E/S de arquivo e serialização — em vez do próprio mecanismo de OCR, você atingiu o limite prático do ajuste local. Sinais de que é hora de mudar: você já implementou aceleração por GPU, normalização de resolução e processamento paralelo, mas um lote de 300 páginas ainda leva mais de uma hora; ou seus documentos são tão diversos (fotos de celular, digitalizações, capturas de tela, manuscritos misturados) que os parâmetros de pré-processamento precisam de ajuste por página. Nesses cenários, um serviço de extração baseado em nuvem que paraleliza entre workers GPU e lê documentos semanticamente — sem ajuste por tipo — superará um pipeline ajustado localmente tanto em velocidade quanto em precisão.