"OCR이 왜 이렇게 느릴까?"
느린 일괄 처리의 3가지 근본 원인 — 그리고 각각의 해결 방법
대부분의 OCR 벤치마크는 사양서상으로는 훌륭해 보입니다. Tesseract는 페이지당 1초 미만을 주장하고, GPU에서 실행되는 EasyOCR은 분당 190페이지를 기록합니다. 그런데 직접 배치를 돌려보면 — 공급업체 인보이스 200장, 휴대폰 사진과 스캔 PDF가 섞인 경우 — 갑자기 페이지당 30초가 걸립니다. 주말이 사라집니다. 병목 현상은 거의 항상 세 가지 중 하나입니다. 자신의 문제를 찾는 방법은 다음과 같습니다.
핵심 요점
- 200장의 인보이스 배치에서 페이지당 30초 — 동일한 OCR 엔진이 1초 미만으로 벤치마크된 상황이라면 이는 버그가 아니라, 파이프라인 내부에서 조용히 누적되는 세 가지 독립적인 속도 저하가 복합된 결과입니다.
- 세 가지 배수가 파이프라인 내부에서 복합적으로 작용합니다 — GPU가 없으면 3~7배 느려지고, 과도한 이미지 크기는 4배의 페널티를 추가하며, 순차 처리는 CPU의 3/4를 유휴 상태로 만듭니다 — 각각은 몇 분 안에 진단하고 독립적으로 해결할 수 있습니다.
- 세 가지 해결책을 모두 적용했는데도 배치가 여전히 1시간 이상 걸린다면, 병목 현상은 더 이상 파이프라인에 있지 않습니다 — 가장 빠른 해결책은 조정 노브를 계속 돌리는 것이 아니라 아키텍처를 교체하는 것입니다.
원인 #1: 계산 집약적 파이프라인에 GPU 가속 미사용
증상. 처리 중 CPU 사용률이 100%에 도달하고, 깨끗한 문서에서도 페이지당 1초 이상이 소요됩니다. 배치에 파일을 추가해도 처리량이 개선되지 않습니다 — 파이프라인이 포화 상태입니다.
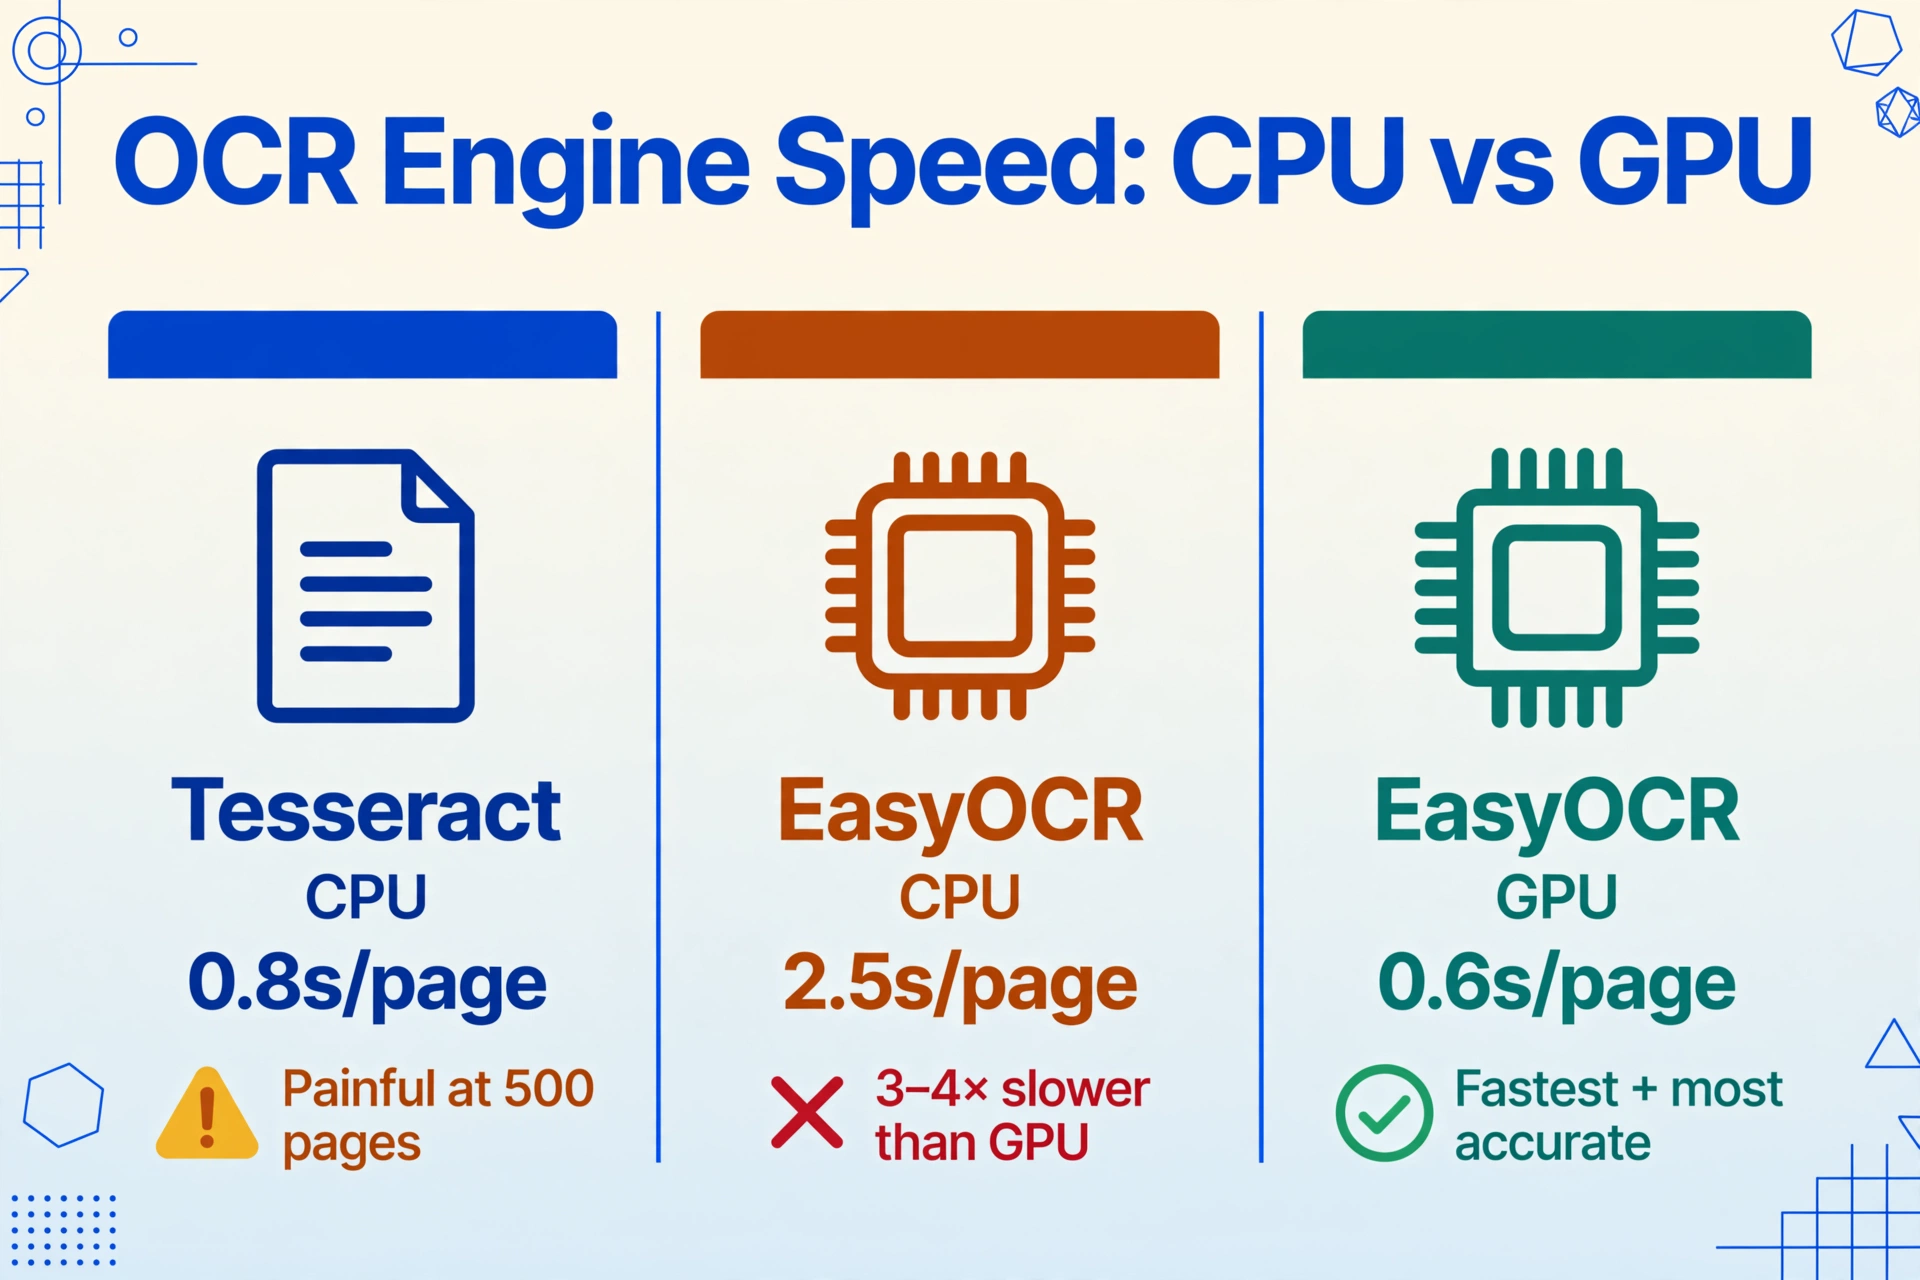
근본 원인. 모든 OCR 엔진이 내부적으로 동일하게 설계된 것은 아닙니다. Google이 유지 관리하는 오픈소스 표준인 Tesseract는 순수 CPU 기반 엔진입니다. 연결 요소 분석, 페이지 레이아웃 분석, LSTM 기반 문자 인식 등 전통적인 컴퓨터 비전 파이프라인을 사용하며, 이 중 어느 것도 GPU 병렬 처리를 활용하지 않습니다. 한 연구원의 벤치마크에 따르면 Tesseract 5는 최신 CPU에서 깨끗한 인쇄 텍스트를 기준으로 페이지당 약 0.8초가 소요됩니다. 몇 페이지는 괜찮지만 500페이지는 힘듭니다.
EasyOCR은 다른 아키텍처 방식을 사용합니다. 딥러닝 백본은 GPU에서 실행 가능하며, 실행 시 극적으로 빨라집니다. 하지만 대부분이 놓치는 핵심은 EasyOCR이 호환 GPU가 감지되지 않으면 자동으로 CPU로 대체된다는 점입니다. CPU에서는 EasyOCR을 정확하게 만드는 동일한 딥러닝 파이프라인이 GPU 모드보다 3~4배 느려집니다. NVIDIA T4에서의 벤치마크에 따르면 EasyOCR GPU는 페이지당 ~0.6초로 Tesseract와 비슷한 반면, EasyOCR CPU는 페이지당 ~2.5초까지 늘어납니다.
해결 방법. OCR 파이프라인이 실제로 GPU를 사용하고 있는지 확인하십시오:
- EasyOCR의 경우
reader = easyocr.Reader(['en'], gpu=True)가 실제로 CUDA를 감지하는지 확인하십시오. 라이브러리가 조용히 대체되면 페이지당 시간이 두 배 이상 늘어납니다. 처리 중nvidia-smi를 실행하십시오 — GPU 사용률이 0%로 표시되면 파이프라인이 CPU에서 실행 중입니다. - Tesseract에는 GPU 토글이 없습니다 — 단순히 GPU 가속을 지원하지 않습니다. 수백 페이지 이상을 처리하는 경우 GPU 지원 엔진으로 전환하는 것을 고려하십시오.
- PaddleOCR과 같은 전용 OCR 엔진은 처음부터 GPU용으로 설계되었습니다. 독립적인 속도 벤치마크에 따르면 PaddleOCR은 RTX 3090에서 최적화된 배치 추론과 CUDA 통합 덕분에 분당 약 190페이지 — 초당 3페이지 이상 —를 처리합니다.
하드웨어가 고정된 경우 GPU 경로를 직접 사용할 수 없습니다. 이 경우 GPU 기반 인프라에서 문서를 처리하는 클라우드 기반 OCR 서비스는 하드웨어를 직접 프로비저닝할 필요 없이 문제를 완전히 우회합니다.
GPU 지원 OCR 엔진의 비교를 보려면 최고의 오픈소스 OCR 도구 모음을 참조하십시오.
원인 #2: OCR이 실제로 필요로 하는 것보다 훨씬 큰 이미지
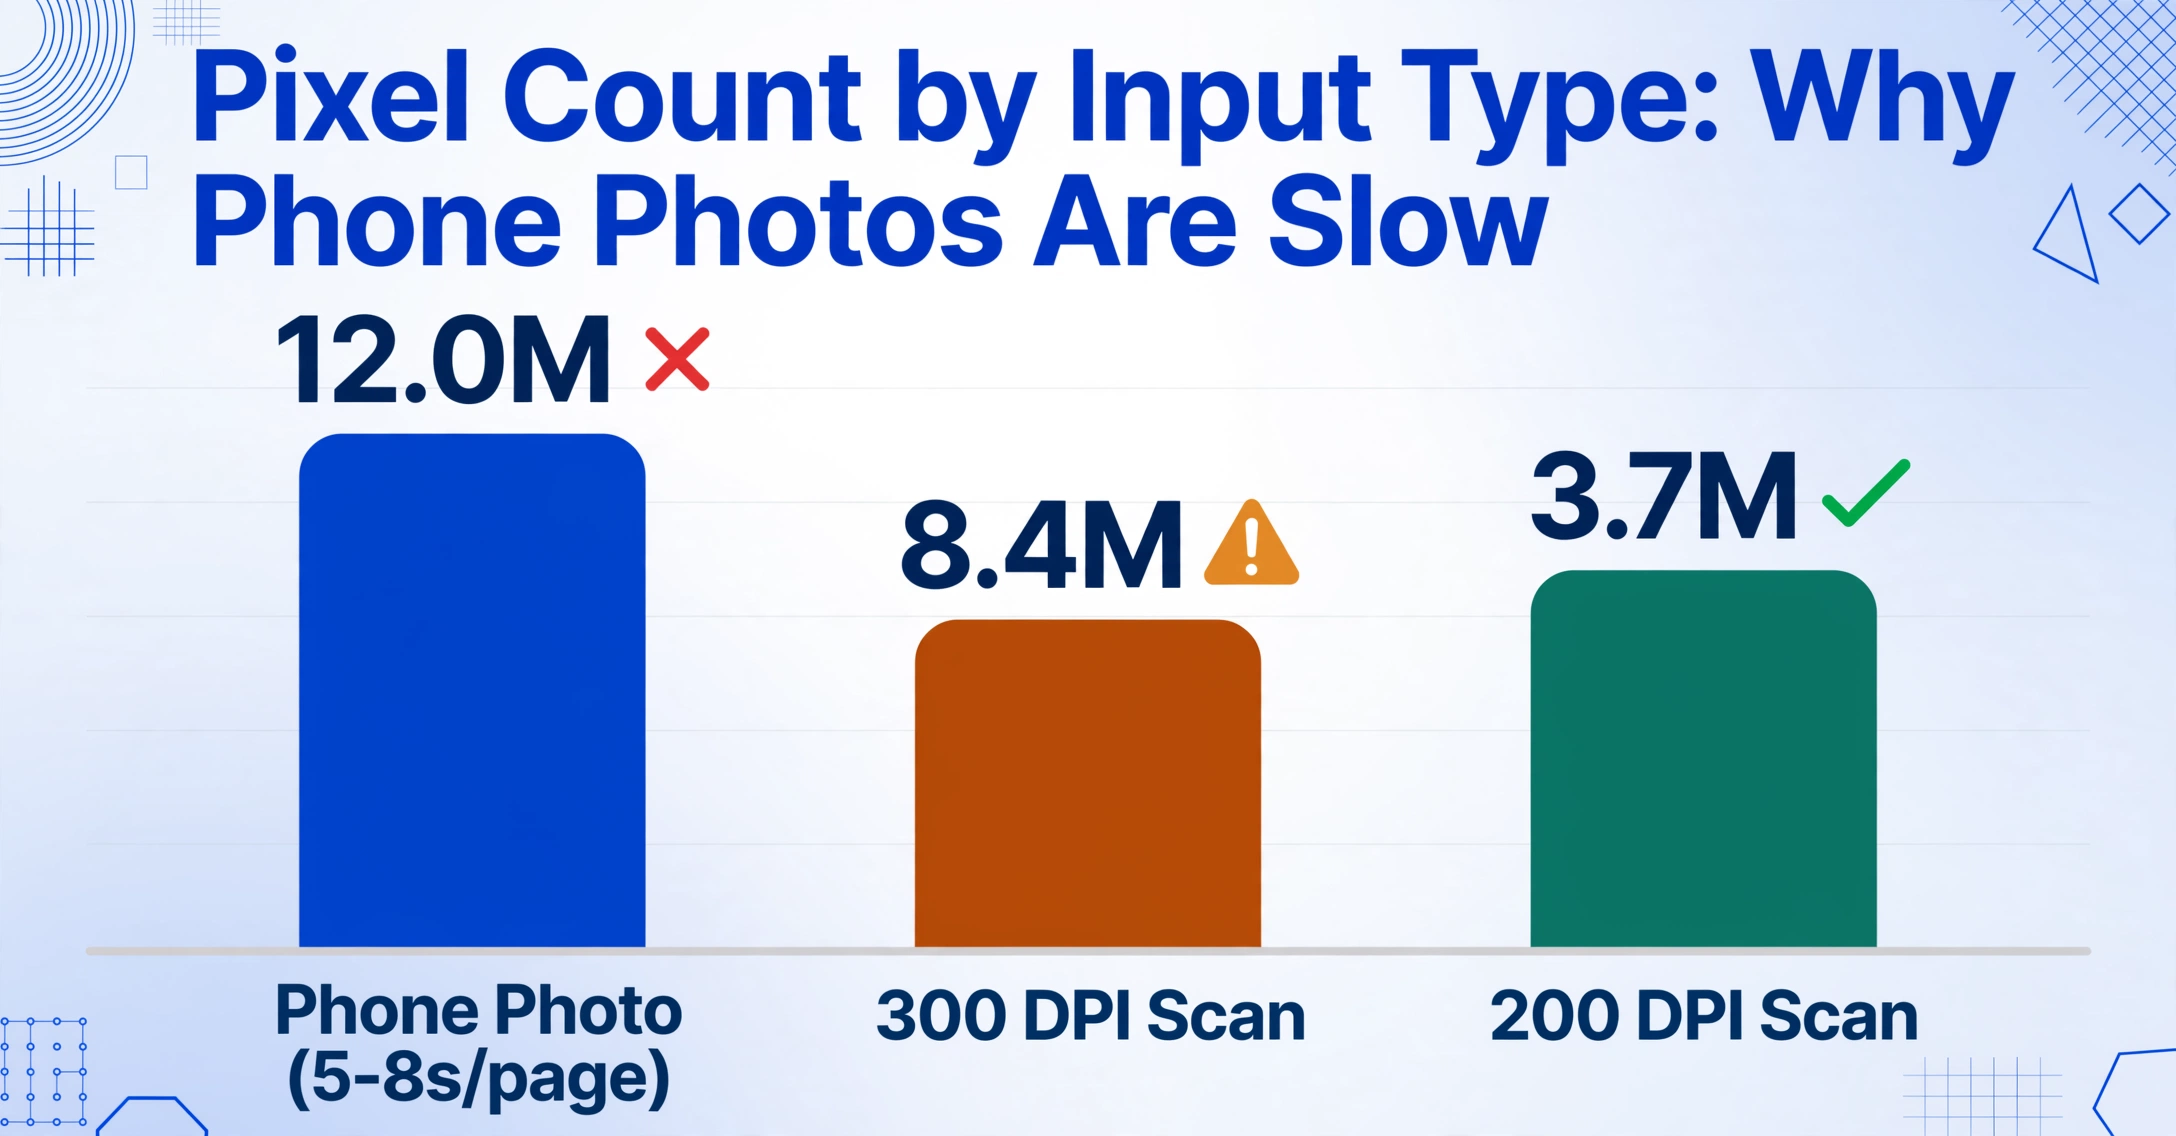
증상. 눈으로는 완벽하게 읽히는 페이지에서 처리 속도가 현저히 느려집니다. 영수증의 1,200만 화소 휴대폰 사진은 5~8초가 걸리는 반면, 같은 문서의 스캔 PDF는 2초 미만이 걸립니다.
근본 원인. 대부분의 OCR 엔진은 이미지의 모든 픽셀을 처리합니다. 각 축의 해상도를 150 DPI에서 300 DPI로 두 배로 늘리면 픽셀 수는 네 배가 됩니다: 가로 2배 곱하기 세로 2배. 입력이 네 배가 되면 동일한 콘텐츠에 대해 처리 시간도 약 4배가 됩니다. 4000×3000 픽셀의 스마트폰 사진에는 1,200만 픽셀이 포함되어 있습니다. 300 DPI로 스캔한 동일 문서에는 840만 픽셀이 포함됩니다. 200 DPI로 스캔한 문서 — 대부분의 OCR에 충분히 적합한 해상도 — 에는 370만 픽셀만 포함됩니다.
OCR 성능 튜닝에 관한 가장 권위 있는 문서 중 하나인 ABBYY FineReader 엔진 성능 가이드에서는 권장 입력 범위로 200–400 DPI를 명시합니다. 150 DPI 미만에서는 문자 인식 품질이 저하됩니다. 400 DPI를 초과하면 측정 가능한 정확도 향상 없이 계산 시간만 낭비하게 됩니다. 이 원칙은 오픈 소스든 독점이든 모든 OCR 엔진에 동일하게 적용됩니다.
해결 방법. OCR 엔진에 이미지를 입력하기 전에 크기를 조정하는 전처리 단계를 추가하십시오. 목표는 출력 이미지의 150–300 DPI — 일반적인 문서의 경우 긴 변 기준 약 1200–2500 픽셀입니다.
Pillow를 사용한 간단한 Python 전처리 파이프라인:
from PIL import Image

def resize_for_ocr(image_path, max_dim=2000):
    img = Image.open(image_path)
    # 축소만 수행, 확대는 하지 않음
    if max(img.size) > max_dim:
        ratio = max_dim / max(img.size)
        new_size = (int(img.size[0] * ratio),
                    int(img.size[1] * ratio))
        img = img.resize(new_size, Image.LANCZOS)
    return img
이 한 단계만으로도 소스 이미지에 따라 페이지당 처리 시간을 40–70% 단축할 수 있으며, 추출 정확도에는 전혀 영향을 미치지 않습니다. 이진화, 기울기 보정, 대비 정규화를 포함한 이미지 준비에 대한 전체 가이드는 OCR 이미지 전처리 가이드를 참조하십시오.
원인 #3: 병렬로 실행할 수 있는데 순차 처리하는 경우
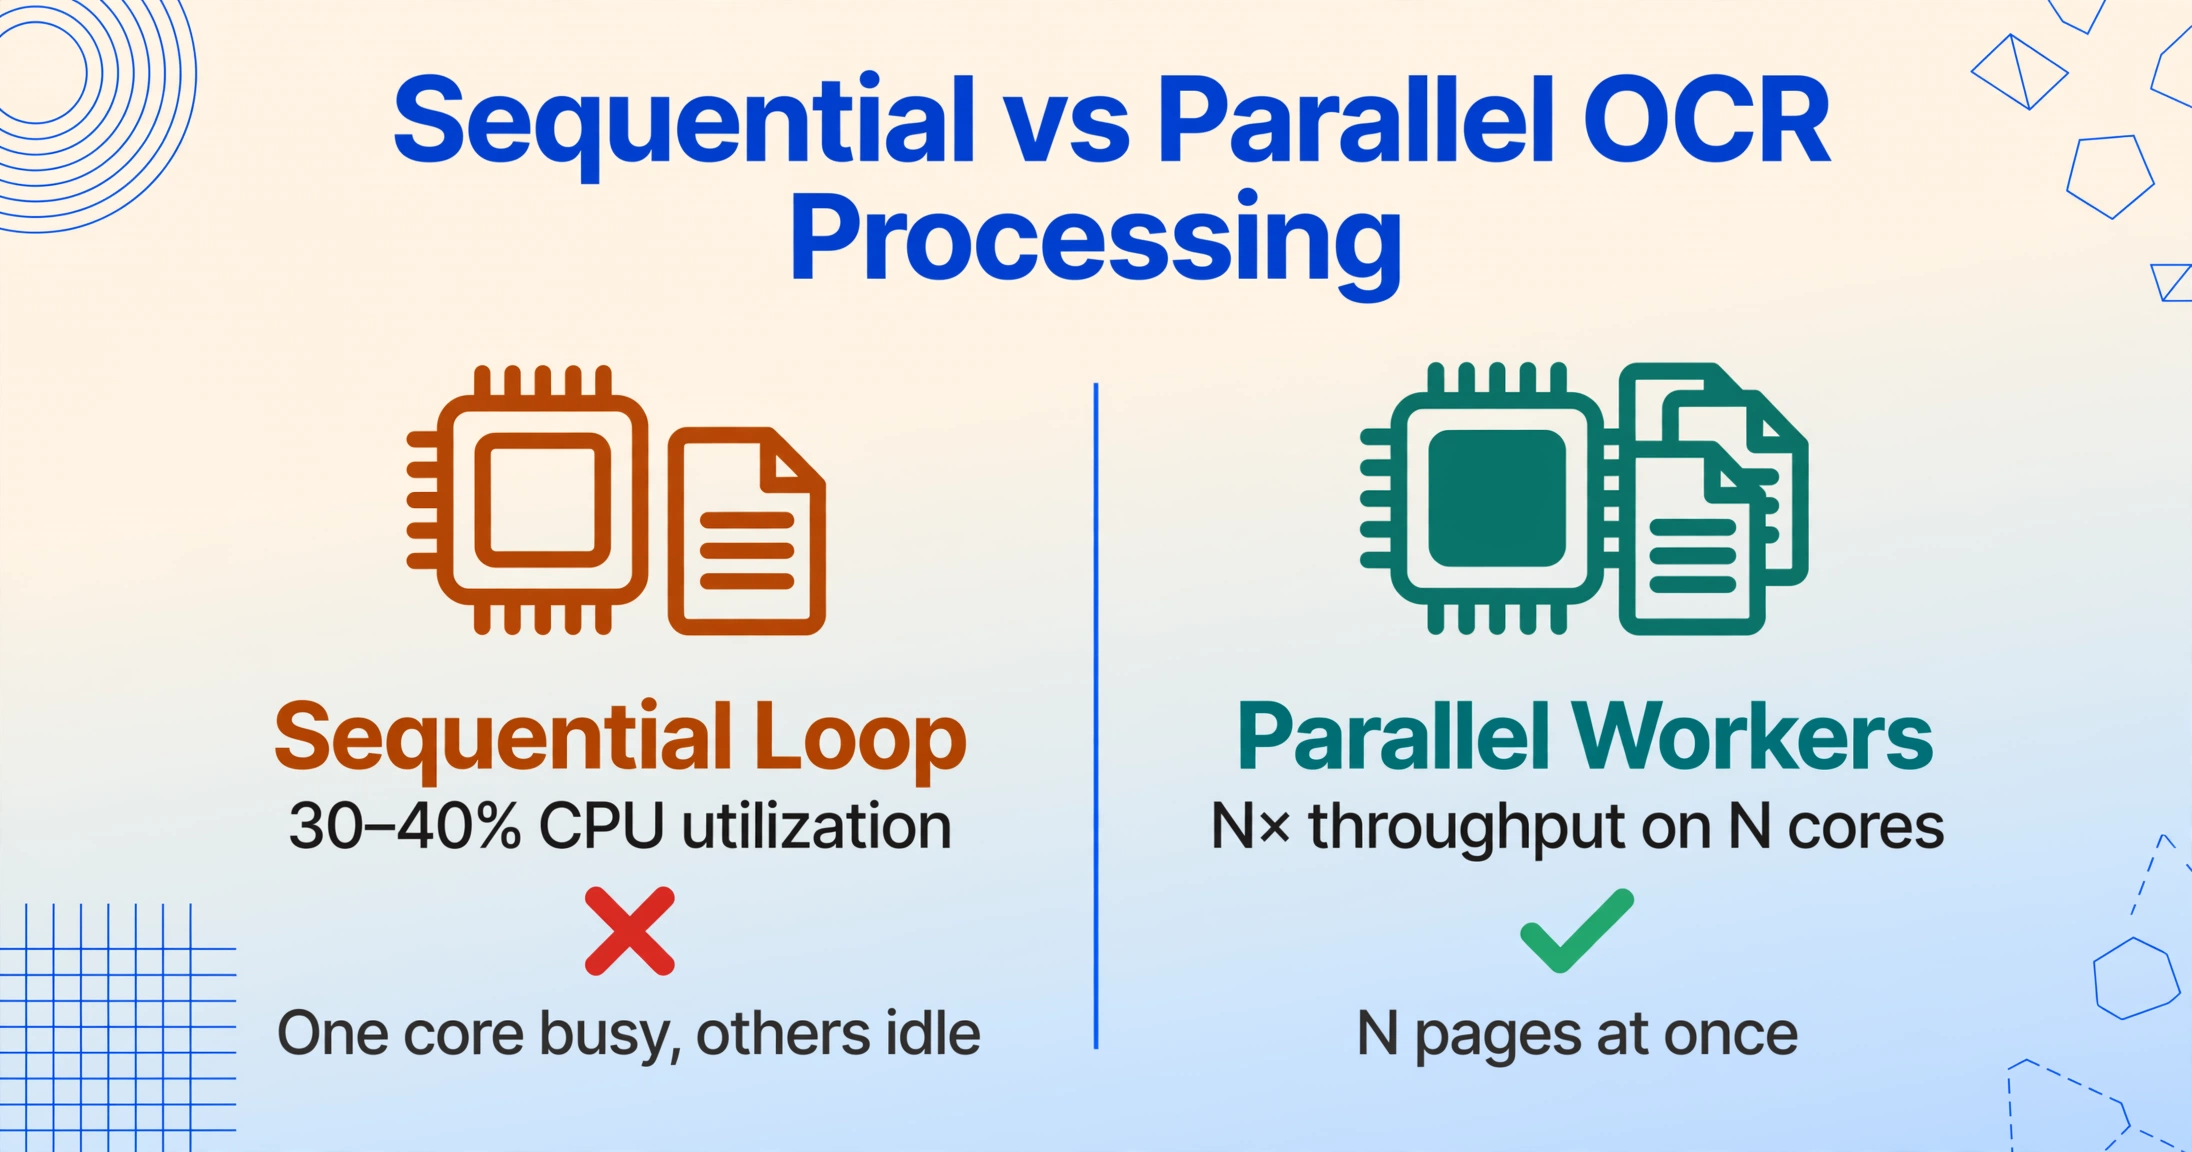
증상. 배치 실행 중 CPU 사용률이 30~40%에 머무릅니다. 파이프라인이 파일을 한 번에 하나씩 처리합니다. 진행 표시줄이 파일별로 하나씩 채워지며 속도가 빨라지지 않습니다.
근본 원인. 대부분의 OCR 파이프라인은 단순 루프로 작성됩니다: for file in files: ocr(file). 기본적으로 단일 스레드로 실행됩니다. 최신 CPU에는 4개, 8개 또는 16개의 코어가 있지만 순차 루프는 그중 정확히 하나만 사용합니다. 페이지가 대기열에 쌓이는 동안 나머지 코어는 유휴 상태로 남아 있습니다.
해결책은 매우 간단한 병렬화입니다. 한 페이지의 OCR은 다른 페이지의 OCR과 독립적입니다. 동기화할 공유 상태가 없습니다. 즉, N코어 머신에서 N개 페이지를 동시에 처리하여 이론적으로 N배의 처리량을 달성할 수 있습니다. 실제로는 4~8코어까지 거의 선형적으로 확장되며, 그 이후에는 메모리 대역폭과 I/O 경합으로 인해 수익이 감소합니다.
해결책. OCR 호출을 병렬 실행 프레임워크로 감싸십시오:
- GNU Parallel (Linux/macOS): 스크립트 기반 파이프라인에 가장 간단한 방법입니다.
parallel -j 4 ocrmypdf {} output/{} ::: *.pdf는 4개의 OCR 프로세스를 동시에 실행합니다. - Python multiprocessing:
multiprocessing.Pool을 사용하여 파일을 워커 프로세스에 분산하십시오. 각 워커는 자체 OCR 엔진 인스턴스를 가지며 결과는 완료되는 대로 수집됩니다. - 배치 처리 도구: OCRmyPDF와 같은 전용 배치 OCR 도구는 내장 병렬 처리를 지원합니다. 해당
--jobs매개변수는 동시성을 제어합니다. 이를 GNU Parallel과 함께 사용하는 것은 문서화된 프로덕션 패턴입니다.
핵심 실무 고려 사항: 각 병렬 워커는 페이지 이미지와 중간 버퍼를 보관할 충분한 메모리가 필요합니다. 8GB RAM 머신에서 8개의 워커를 실행하면 스와핑이 발생합니다. 표준 문서 이미지의 경우 안전한 시작점은 병렬 워커당 2GB RAM입니다. CPU 코어 수에 도달하기 전에 메모리 예산에 맞게 병렬 처리를 조정하십시오.
병렬 배치 파이프라인 설정에 대한 전체 가이드는 여러 파일 배치 처리에 대한 가이드를 참조하십시오.
언제 전환해야 하는가 — 튜닝 대신 도구 교체
세 가지 원인을 모두 확인했는데도 — GPU가 활성화되어 있고, 이미지 크기가 올바르며, 파이프라인이 병렬로 실행되는데 — 처리 속도가 여전히 워크로드에 비해 너무 느리다면, 병목 현상은 설정 문제가 아니라 구조적 문제일 수 있습니다.
근본적으로 다른 접근 방식을 고려해야 할 때라는 신호는 세 가지입니다:
1. 처리량이 지속적으로 많습니다. 매일 500페이지 이상을 처리하고 배치 완료 시간이 반복적인 문제라면, 로컬 OCR 파이프라인을 튜닝하는 것은 목적에 맞게 구축된 클라우드 서비스가 제공하는 성능에 항상 뒤처질 수밖에 없습니다. 클라우드 추출 서비스는 자동 로드 밸런싱을 갖춘 서버급 GPU 클러스터에서 실행되므로, 하드웨어를 직접 프로비저닝하지 않아도 단일 배치를 수십 개의 병렬 워커에 분산할 수 있습니다.
2. 문서가 다양하고 전처리되지 않은 상태입니다. 깨끗한 스캔 PDF에 최적화된 파이프라인은 휴대폰 사진, 구겨진 영수증, 손글씨가 포함된 문서에서는 어려움을 겪습니다. 입력 유형이 새로 추가될 때마다 다른 전처리 매개변수가 필요합니다. ImageToTable.ai는 문서를 의미적으로 읽는 비전-언어 모델을 사용합니다 — 문서 유형별 튜닝 없이 사람이 이해하는 방식으로 페이지 레이아웃을 해석합니다. 해상도 정규화를 위한 별도의 전처리 단계가 필요 없는 이유는 클라우드 파이프라인이 추론 전에 크기 조정을 자동으로 처리하기 때문입니다.
3. 결과가 몇 시간이 아니라 몇 분 안에 필요합니다. 300페이지 배치를 점심시간 동안 처리하고 내보내야 한다면, 순차 실행되는 로컬 파이프라인은 — 속도에 맞게 튜닝된 경우라도 — 요구를 충족하지 못합니다. 클라우드 배치 처리는 전체 문서 볼륨에 걸쳐 병렬화됩니다. 단일 CPU 장착 머신에서 3~4시간이 걸리는 300페이지 배치는 20~40개의 병렬 GPU 워커에서 동일한 작업을 실행하는 클라우드 인프라에서 5~10분 안에 완료될 수 있습니다.
자주 묻는 질문
Tesseract가 EasyOCR보다 빠른가요?
CPU 환경에서는 일반적으로 Tesseract가 더 빠릅니다. 깨끗한 인쇄 텍스트 기준으로 페이지당 약 0.8초인 반면, EasyOCR은 페이지당 약 2.5초가 소요됩니다. GPU 환경에서는 비교 결과가 달라집니다. NVIDIA GPU에서 EasyOCR은 페이지당 약 0.6초로 실행되어 Tesseract의 처리량과 비슷하거나 더 빠르면서, 손상된 이미지, 필기 주석, 혼합 레이아웃에서 훨씬 더 나은 정확도를 제공합니다. 실용적인 결론: GPU가 있다면 EasyOCR을 사용하세요. CPU만 사용하는 경우, 깨끗한 문서에서는 Tesseract가 더 나은 처리량을 제공하지만, 복잡한 입력에서는 정확도가 낮을 수 있습니다.
OCR 속도에 가장 적합한 이미지 해상도는 무엇인가요?
대부분의 OCR 엔진에서 200–300 DPI가 최적의 지점입니다. 150 DPI 미만에서는 특히 작은 글꼴 크기에서 문자 인식 정확도가 눈에 띄게 떨어집니다. 400 DPI 이상에서는 정확도 향상이 미미하거나 전혀 없음에도 불구하고 처리 시간이 2–4배 증가합니다. 표준 레터 크기 문서(8.5"×11")의 경우 200 DPI는 약 1700×2200 픽셀의 이미지를 생성합니다. 이는 일반 스마트폰 사진보다 훨씬 작으며, 훨씬 짧은 시간에 처리됩니다.
여러 GPU를 사용하여 OCR 속도를 높일 수 있나요?
네, OCR 엔진이 이를 지원하고 작업량이 충분히 많아 이점을 얻을 수 있다면 가능합니다. PaddleOCR과 EasyOCR은 서로 다른 문서 배치를 다른 GPU 인스턴스에 할당하여 여러 GPU에 분산할 수 있습니다. 실제로 단일 최신 GPU는 표준 문서의 경우 분당 150–190페이지를 이미 처리하므로, 다중 GPU 설정은 매우 많은 양에서만 필요합니다. 그 규모에서는 병목 현상이 계산에서 I/O로 이동하므로, 다중 GPU 설정은 빠른 저장 장치(NVMe SSD)와 충분한 RAM과 함께 사용해야 합니다.
GPU가 CPU보다 OCR 속도가 얼마나 빠른가요?
EasyOCR이나 PaddleOCR 같은 딥러닝 기반 OCR 엔진에서 GPU 가속은 일반적으로 CPU 전용 처리보다 3~7배 빠른 속도를 제공합니다. 이는 GPU 모델과 이미지 특성에 따라 다릅니다. NVIDIA T4에서 EasyOCR은 CPU 대비 약 4배 빠릅니다. RTX 3090 같은 소비자용 GPU에서 PaddleOCR은 분당 190페이지 이상을 처리하며, 동일한 파이프라인을 실행하는 4코어 CPU보다 5~7배 향상된 성능을 보입니다. Tesseract는 GPU 가속을 지원하지 않으므로 속도는 전적으로 CPU 성능에 의해 결정되며 직접 비교할 수 없습니다.
이미지 크기를 줄이면 OCR 정확도가 떨어지나요?
이미지 크기를 줄이는 것은 OCR 엔진이 작은 문자를 읽는 데 필요한 최소 해상도 이하로 내려갈 때만 정확도가 떨어집니다. 대부분의 인쇄 문서에서 200 DPI면 99% 이상의 문자 정확도를 얻을 수 있습니다. 150 DPI 미만에서는 8pt 글꼴의 각주, 소수점, 아래 첨자 문자 같은 미세한 부분이 손실될 수 있습니다. 안전한 방법은 대상 해상도를 200~300 DPI로 조정하는 것입니다. 이렇게 하면 가독성을 유지하면서 처리 속도만 늦추는 4~5메가픽셀의 중복 데이터를 제거할 수 있습니다. 문서에 아주 작은 텍스트가 포함된 경우 300 DPI를 최소 기준으로 삼으세요.
언제 튜닝을 중단하고 다른 도구로 전환해야 하나요?
배치 처리 시간이 OCR 엔진 자체보다는 파이프라인 오버헤드에 의해 결정될 때, 로컬 튜닝의 실질적 한계에 도달한 것입니다. 전환해야 할 신호는 다음과 같습니다: 이미 GPU 가속, 해상도 정규화, 병렬 처리를 구현했지만 300페이지 배치 처리에 여전히 1시간 이상 걸리는 경우; 또는 문서가 너무 다양해서 페이지마다 전처리 매개변수를 조정해야 하는 경우. 이러한 시나리오에서는 GPU 워커에서 병렬 처리되고 문서를 의미적으로 읽는 클라우드 기반 추출 서비스가 속도와 정확도 모두에서 로컬 튜닝 파이프라인을 능가합니다.