2026年政府向けOCR:
公文書・FOIA・コンプライアンスのデジタル化ガイド
NARA M-23-07の義務付け — 2024年6月30日に発効 — により、すべての永続的な連邦記録は電子形式で管理することが求められています。しかし、年間200万〜500万件の文書を処理し、各FOIAリクエストに15〜30時間のスタッフ時間を費やす州・地方自治体にとって、課題は紙をスキャンしてPDFにするだけではありません。それらのデジタル記録を検索可能にし、墨消し可能にし、WCAG 2.1基準に準拠したアクセシブルなものにし、数十年にわたってPDF/Aとして保存可能にし、取り込みから公開まで監査可能にする必要があります。本ガイドでは、文字認識を超えた、政府向けOCRに実際に求められることと、AI搭載の抽出がコンプライアンスライフサイクル全体で何を可能にするかについて解説します。
重要ポイント
- ブラックボックスオーバーレイ — 政府機関で最も一般的なFOIA墨消し方法 — では、墨消しされたすべての単語が抽出・復元・法的に開示可能な状態のまま残ります。
- テンプレートベースの抽出では、各部局のすべてのフォームレイアウトに対して個別のテンプレートが必要です — 500の機関があれば500のテンプレートが必要となり、フォームが更新されるたびに静かに機能しなくなります。
- セマンティックAI抽出は、フィールドがどこにあるかではなく、その意味を理解して文書を読み取ります — そのため、500の機関の異なるレイアウトでも、メンテナンスするテンプレートを1つも必要とせずに1つのワークフローで処理できます。
なぜ行政のデジタル化には単なるスキャン以上のものが必要なのか
中規模自治体は200万~500万件の文書(建築許可、不動産記録、警察報告書、裁判所提出書類、業者契約、議事録、税評価書)を管理しています。紙の保管コストは年間1平方フィートあたり25~40ドルです。1件のFOIA(情報公開)請求に対応するには、該当文書の特定、レビュー、墨消し、提出に15~30時間の職員作業が必要です。多くの機関が常時抱える数百件の未処理請求を考慮すると、業務上の負担は計り知れません。
基本的な文書スキャンは保管問題を解決します。紙をオフサイトに移動し、オフィススペースを解放します。しかし、検索可能なテキスト、構造化されたメタデータ、墨消し対応のフォーマット、アクセシビリティタグがないスキャンPDFは、実質的にロックされたままです。画像ベースのPDFでは、事件番号を検索できず、墨消しツールでPII(個人識別情報)をスクリーニングできず、スクリーンリーダーで読み取れず、永久保存記録に関するNARA 36 CFR § 1236 Subpart Eのデジタル化基準を満たしません。
OCR(光学文字認識)は、スキャン画像を使可能なデジタルコンテンツに変える層です。 しかし、OCRの種類が重要です。従来のOCRは文字の形状を読み取り、ラベルのない未分化なテキストを出力します。ページ上のすべての単語がラベルのない文字列として出力されます。請求書番号、裁判記録番号、許可証の有効期限、業者名など、すべてが同じテキストブロックに混在します。人間が各値を正しい列に手動でコピーする必要があります。これが、99.5%の文字認識率と、1件のFOIA請求に依然として15~30時間かかるワークフローが共存する理由です。テキストは認識されても、解析、ラベル付け、次のコンプライアンス手順への準備ができていないのです。
AI駆動の文書抽出(次世代OCR)は、意味理解を導入します。文字の形状を読む代わりに、ビジョンモデルは人間のように文書を読み取ります。裁判所提出書類の12行目の文字列が事件番号であることを、そのフィールドが果たす構造的な役割を理解して認識します。文字認識と文書理解のこの違いは、学術的なものではありません。公文書管理室がFOIA請求に2時間で対応できるか、2日かかるかを決定します。
行政OCRを定義する文書タイプ
政府機関が処理する文書は一種類ではありません。それぞれに異なるフィールド構造、レイアウト規則、規制要件があります。文書タイプの多様性こそが、テンプレートベースのOCRが公共部門で機能しない第一の理由です。
| 文書タイプ | 主要抽出フィールド | 固有のコンプライアンス要件 |
|---|---|---|
| 建築許可証 | 許可番号、申請者名、物件住所、評価額、発行日、有効期限 | 自治体条例参照、手数料表の適用 |
| 裁判所提出書類/事件記録 | 事件番号、当事者名、提出日、文書タイプ、担当判事 | ベイツ番号、ページ単位の完全性、FRCP準拠 |
| FOIA請求回答 | 請求番号、請求者名、受領日、適用免除コード、回答日 | 免除追跡(b)(1)-(b)(9)、NARAガイドラインに基づく墨消しコード |
| 警察報告書 | 事件番号、報告官、日時、場所、関係者、容疑 | CJISセキュリティポリシー、被害者/証人の個人情報墨消し |
| 税評価記録 | 区画ID、評価額、物件住所、課税年度、申告免除 | 州統一会計システムコード、GASB準拠 |
| ベンダー契約/調達 | 契約番号、ベンダー名、落札額、契約期間、更新条項 | 公共調達法、入札集計表の保管 |
| 戸籍記録 | 証明書番号、登録者名、事象発生日、管轄 | 州固有のプライバシー法、制限付きアクセス階層 |
| 助成金申請 | 助成金番号、申請団体、交付額、履行期間 | 2 CFR 200準拠、単一監査要件 |
各文書タイプは異なる部署、多くの場合異なるソフトウェアシステムや紙の書式から発生し、独自のレイアウト規則に従います。郡書記官の婚姻許可申請書と保安官事務所の事件報告書には構造上の類似性はありません。行政OCRの核心的な課題は、ページ上の文字を認識することではなく、多様で一貫性のない文書フォーマットを、記録管理システムに供給できる統一データ構造にマッピングすることです。
リダクションとOCR — 順序が重要な理由
FOIAは、機関に対し、免除情報をリダクションした上で応答文書を公開することを義務付けています。連邦機関向けの免除コード — (b)(1)から(b)(9)まで — は、国家安全保障(b)(1)から坑井に関する地質情報(b)(9)までを網羅し、最も一般的なものは(b)(6)個人のプライバシーと(b)(7)法執行です。単一のFOIA応答で、数千ページにわたって数十から数百件の個別リダクションが必要になることがあります。
以下は、多くの政府のデジタル化計画が見落としている技術的な順序です:
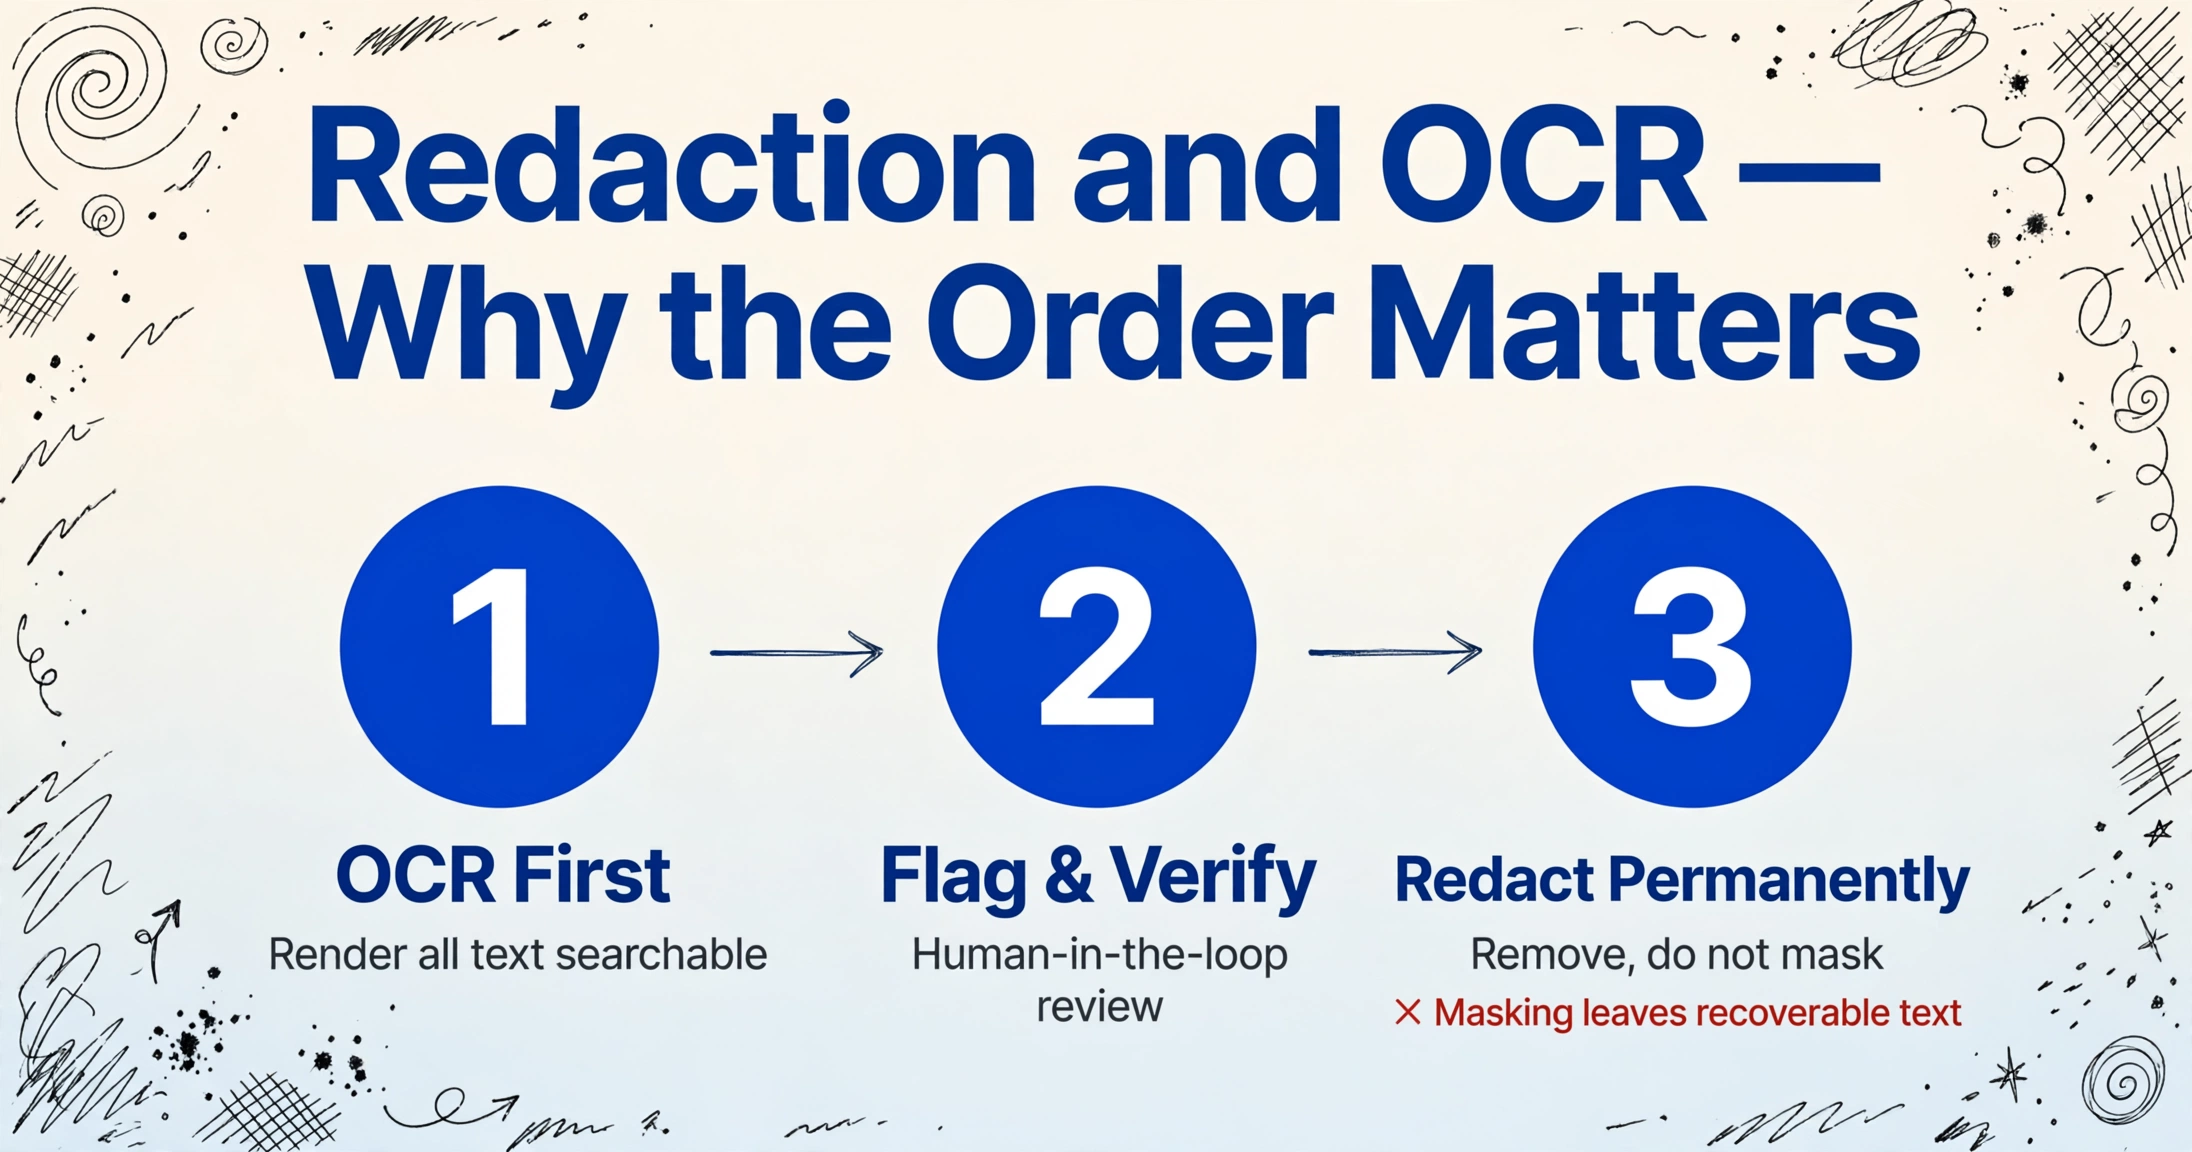
リダクションツールがPII(社会保障番号、生年月日、未成年の子供の名前、金融口座番号)を特定できるようにするには、その前に文書に機械可読なテキストレイヤーが必要です。ここで、固有表現認識(NER)機能を備えたAI OCRが価値を発揮します。数千ページにわたって候補となる機微なエンティティを自動的にフラグ付けし、手動検索の範囲を100%からレビュー対象のサブセットに減らすことができます。
AIが潜在的なPIIにフラグを立て、訓練されたレビュー担当者が各フラグを確認します。これは完全に自動化できるものではありません。文脈に依存する判断(この「John Smith」は名前を開示すべき公務員なのか、それとも身元を保護すべき証人なのか?)には人間の判断が必要です。レビューステップにより、検証済みのリダクションリストが作成されます。
完全なリダクションは、表示テキスト、非表示テキスト、メタデータ、注釈など、すべてのレイヤーから基になるテキストを削除します。黒いボックスのオーバーレイやハイライトカバーはリダクションではなく、その下のテキストは抽出可能なままです。出力は、復元可能なコンテンツのないクリーンなPDFでなければなりません。2002年の電子政府法(E-Government Act of 2002)とFOIA規制は、このレベルの徹底を要求しています。
公開された文書は、請求者がナビゲートして検索できる状態を維持する必要があります。非免除部分にはOCRテキストレイヤーが保持されます。ここで適切な順序が重要になります。リダクション後にOCRを実行すると、リダクションされた領域は完全に除外されます。リダクション前にOCRを実行してもOCRレイヤーをサニタイズしないと、テキストレイヤーでリダクション済みコンテンツが漏洩する可能性があります。
実践的な要点:OCRは自動PII検出を可能にするために十分早い段階で適用する必要がありますが、最終文書のリダクション領域からはOCR出力レイヤーを完全に削除する必要があります。すべてのOCRツールがこのサニタイズステップを正しく処理するわけではありません。政府向けOCRソリューションを評価する際は、ツールがリダクション領域からテキストレイヤーを削除するかどうかを具体的に尋ねてください — 黒いボックスで「リダクション」できるかどうかだけではありません。
PDF/Aと長期保存要件
NARAの36 CFR § 1236 Subpart Eでは、デジタル化された永久保存記録が特定の形式および品質基準を満たすことが求められています。文書保存に最も関連する基準はPDF/Aです。これは長期アーカイブ用に設計されたISO標準のPDFバージョンです。外部フォント、リンクされた画像、または時間の経過とともに劣化するソフトウェア固有の機能に依存する可能性がある標準PDFとは異なり、PDF/Aはフォント、カラープロファイル、メタデータ、デバイス非依存のレンダリング指示など、ファイルに必要なすべてをファイル自体に埋め込みます。
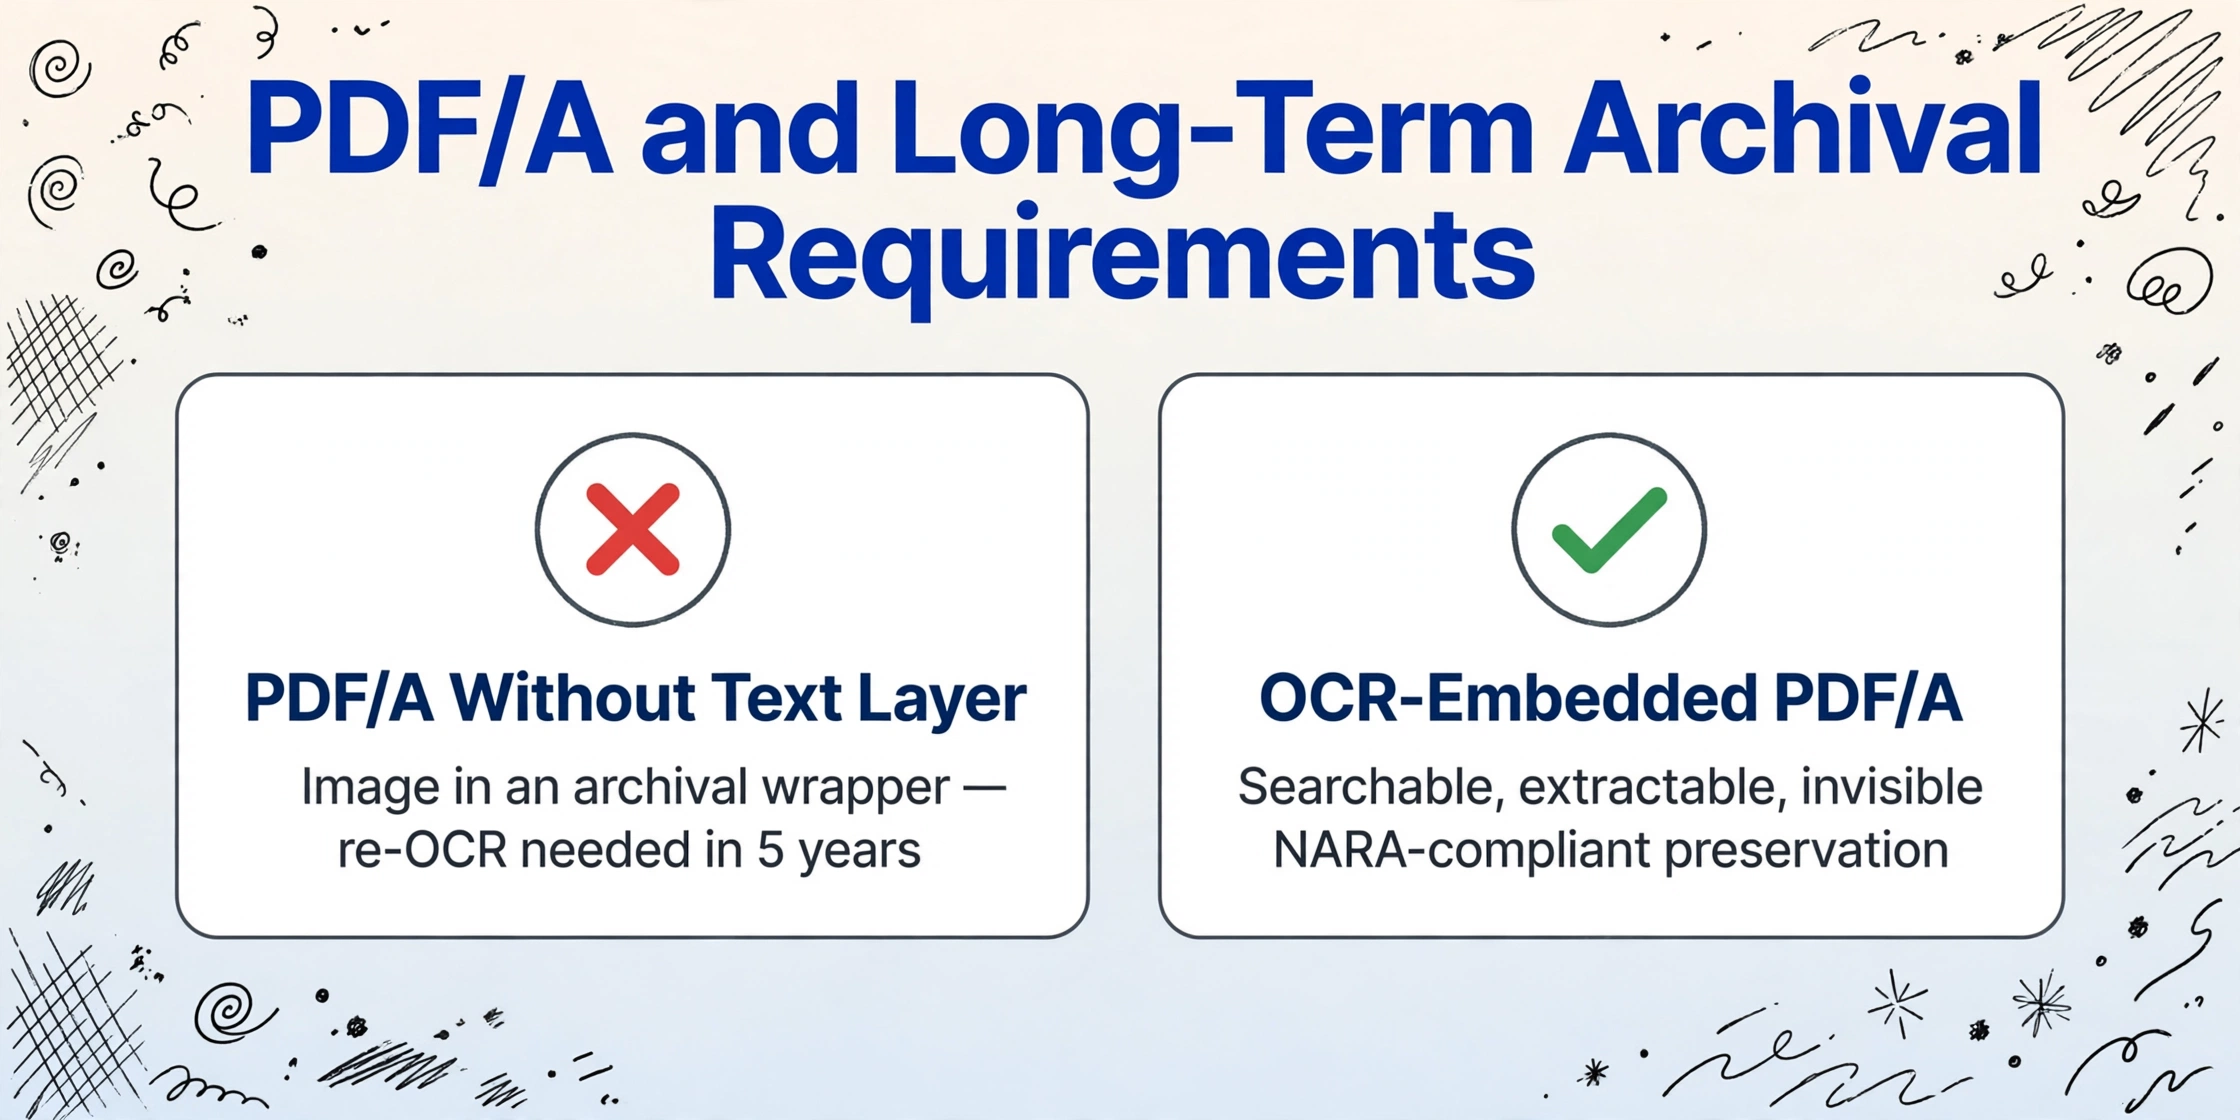
政府機関にとって、PDF/Aは永久保存記録には必須です。連邦機関デジタルガイドラインイニシアチブ(FADGI)が実装ベンチマークを設定し、NARAの移行ガイダンスではデジタル化された永久保存記録がこれに準拠することが指定されています。しかし、ここがOCRとの接点です。認識可能なテキストレイヤーのないPDF/Aファイルは、アーカイブ用ラッパーに入った画像にすぎません。形式テストは合格しますが、実用性テストには不合格です。5年後にその記録に対するFOIAリクエストが届いたとき、2026年のOCRテキストレイヤーが保存されていないため、スタッフは文書全体をゼロから再OCRする必要があります。
正しいアプローチはOCR埋め込みPDF/Aです。認識されたテキストはPDF/Aファイル自体の中に隠れたレイヤーとして保存されます。検索可能で抽出可能ですが、閲覧者には見えません。これにより、ビットーナル画像のアーカイブ完全性とテキストの機能的な検索可能性の両方が維持されます。埋め込みテキストレイヤーを持つPDF/Aを生成しない政府のOCRワークフローは、将来のFOIAバックログを生み出しています。将来のすべてのリクエストで同じ文書を再処理する必要があるからです。
政府利用のOCRソリューションを選択する際は、埋め込みOCRテキストレイヤーを備えたPDF/A-1またはPDF/A-2準拠の出力をサポートしていることを確認してください。PDF/A-2は圧縮と高度なグラフィックスのサポートが向上しており、テキストに加えて写真、地図、スキャンした署名を含む文書に重要です。
省庁間フォーマット差異 — テンプレートが機能しない理由
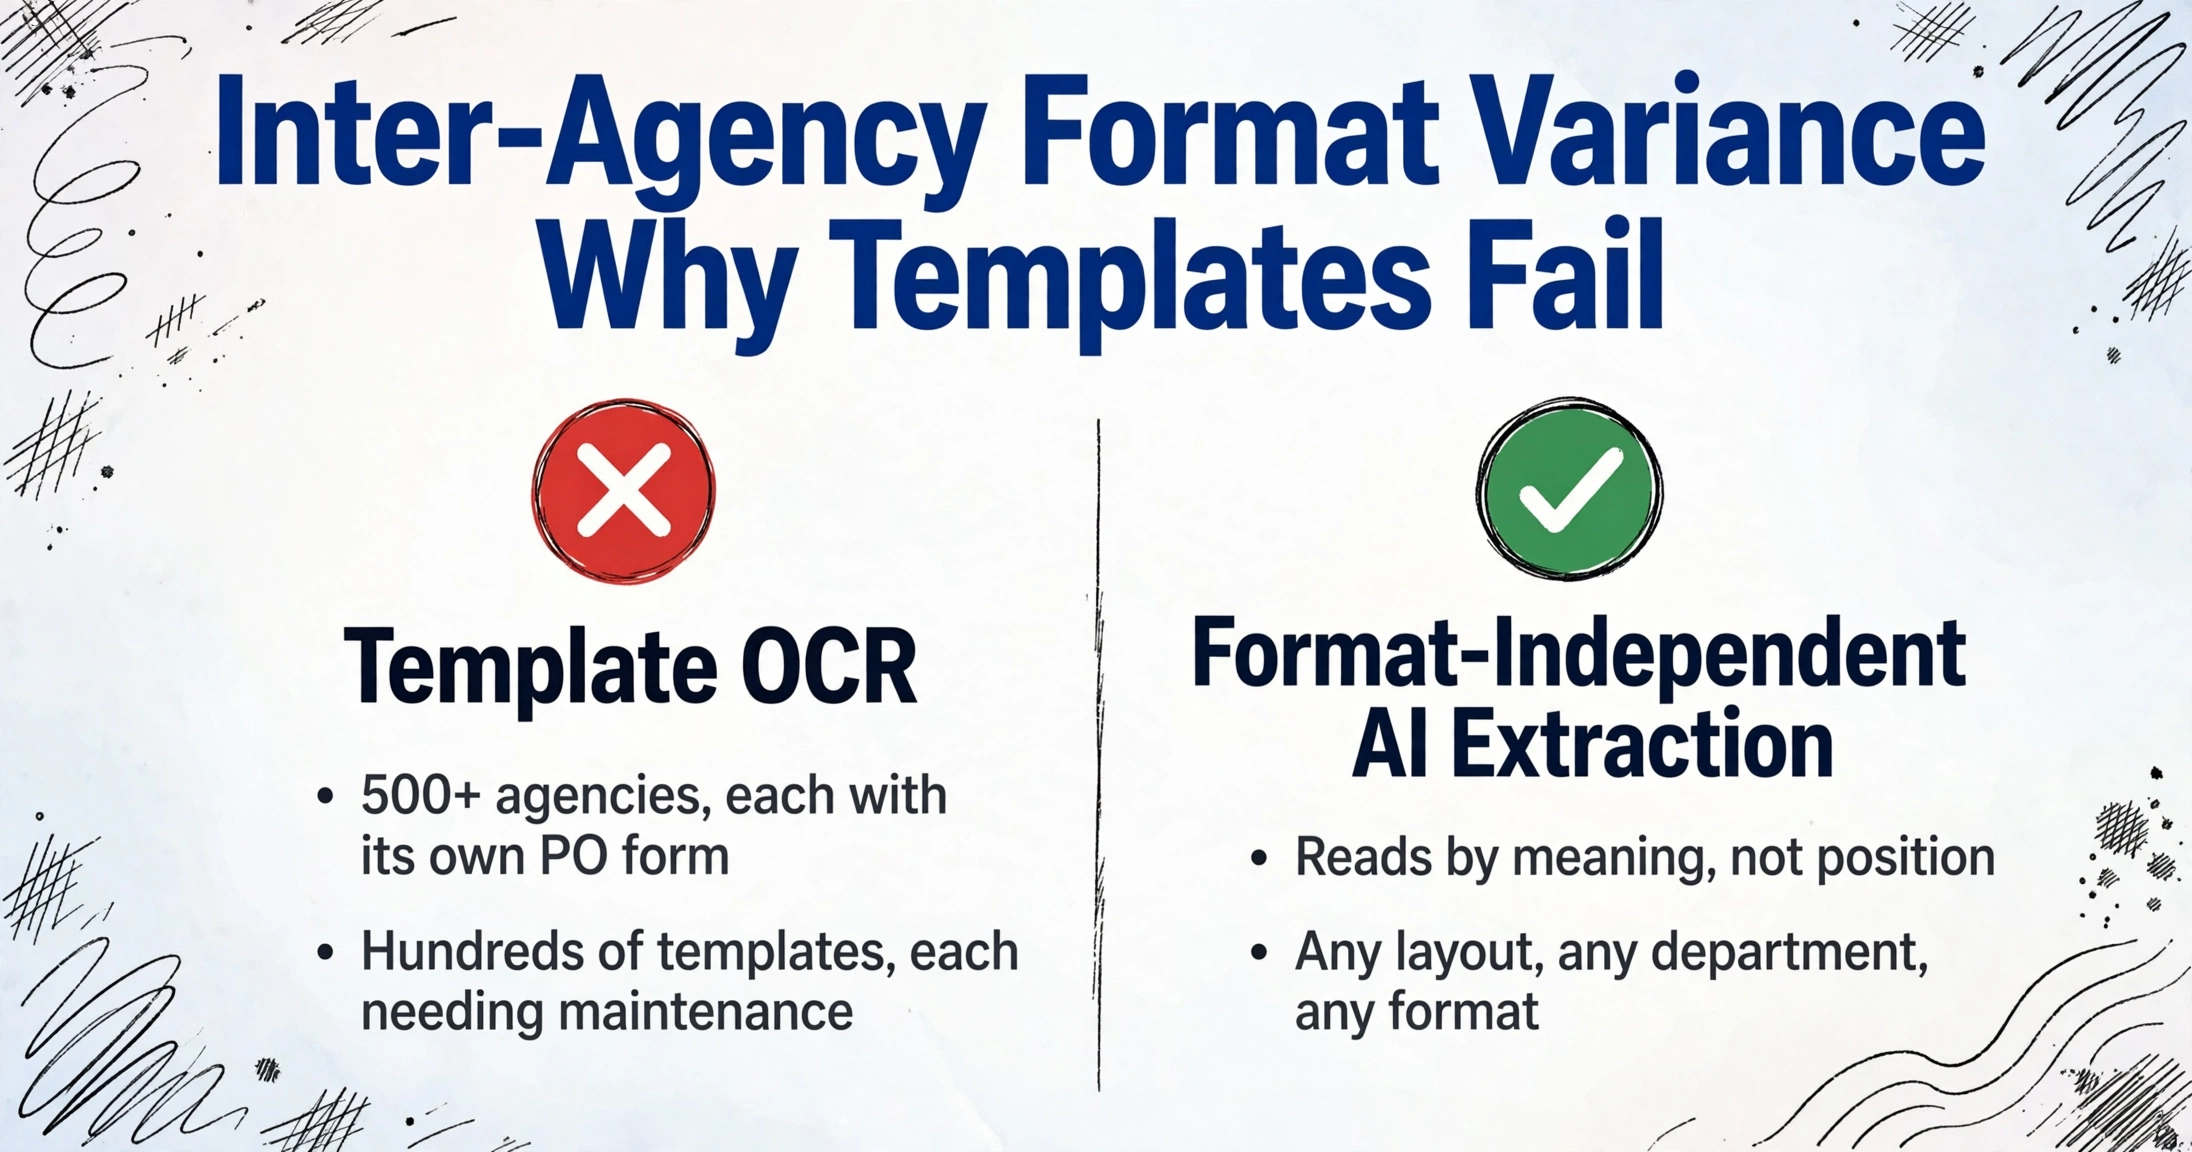
テンプレートベースのOCR — 従来のIDPプラットフォームで採用されている手法 — では、文書レイアウトごとに事前構築された抽出テンプレートが必要です。ユーザーは各フィールドの位置にゾーンを描き、ラベルを割り当て、テンプレートを展開します。次のベンダーが少し異なるフォーム — 異なるフォント、異なる列順序、異なるラベル用語 — を提出すると、テンプレートは機能しなくなり、手動での修正が必要になります。
政府機関はこの問題を大規模に直面しています。500以上の機関から発注書を処理する単一の州調達オフィスを考えてみてください。各機関には独自のPOフォームがあります。または、15の異なる判事室からの裁判書類を受け取る郡書記官。または、警察、計画、財務、公共事業、公園部門にまたがるリクエストを管理する市のFOIAオフィス — 各部門には独自の記録管理フォーマットがあります。テンプレートベースのOCRでは、数百または数千の個別テンプレートが必要となり、フォームが更新されるたびにメンテナンスが必要になります。
フォーマット非依存の抽出 — AIが位置ではなく意味理解によって文書を読み取る方式 — はテンプレートのボトルネックを排除します。データがページ上のどこにあるかをマッピングする代わりに、必要なデータを定義します:許可番号、申請者名、評価額、有効期限。AIはあらゆるレイアウト、あらゆる部門、あらゆるフォーマットでそれらの値を特定します。このアプローチは、政府の記録管理が実際に機能する方法を反映しています:データカテゴリは省庁間で安定しています(すべての許可証には許可番号があります)が、それらのカテゴリの視覚的表現は大きく異なります。同じフォーマット差異の課題は銀行文書処理にも現れており、金融機関は数百の異なる銀行からの明細書フォーマットを処理する必要があります。
これは、AI OCRが文書理解にもたらすパラダイムシフトと同じものです — 位置ベースの認識から意味ベースの抽出への移行です。多数のソースからの記録を管理する政府機関にとって、この移行は利便性の向上ではありません。それは、プロジェクトが拡張できるか、恒久的なテンプレート保守スタッフが必要になるかの違いです。
ADAおよびWCAGアクセシビリティ準拠
米国障害者法(ADA)第2編では、州政府および地方政府のサービス(デジタル記録を含む)が障害のある個人にとってアクセス可能であることを義務付けています。司法省は、一般に提供されるデジタル文書および記録に適用されるWebコンテンツアクセシビリティガイドライン(WCAG)2.1レベルAA基準を通じて、これを強化しています。
政府機関向けOCRにおいて、これは次の3つの具体的な成果物を意味します:
OCR処理されていないスキャン文書は画像です。スクリーンリーダー(JAWS、NVDA、VoiceOver)は画像ベースのテキストを解釈できません。OCRテキストレイヤーは、隠しオーバーレイではなく、タグ付けされたPDFコンテンツとして埋め込まれ、支援技術が論理的な読み上げ順序で読めるようにする必要があります。
政府文書は複数カラムであることが多いです(裁判所提出書類、立法報告書、助成金申請書など)。従来のOCRは、列を単一のテキストストリームに連結することがよくあります(1列目1行目、2列目1行目、1列目2行目...)。これにより、スクリーンリーダーにとって出力が理解不能になります。ページレイアウトを理解するAI OCRは、論理的な読み上げ順序を保持します。
表、チェックボックス(政府フォームで一般的)、署名欄には、アクセシビリティを確保するためのタグ注釈が必要です。これらの要素の自動検出と、タグ付けされたPDF構造への変換は、標準的なOCR機能ではありません。AIビジョンモデルは、表やフォームフィールドが何であるかを理解して識別できるため、文字レベルでは実現できない自動タグ付けが可能になります。
ADAアクセシビリティは、政府機関向けOCRにおける二次的な concerns ではありません。従来のOCRの基本機能(文字認識とテキスト出力)では、アクセシブルな文書は生成されません。WCAG 2.1 AA準拠の出力を生成するには、レイアウト分析、セマンティックタグ付け、読み上げ順序の保持を含む、より高度な文書理解が必要です。調達段階でこれを考慮しない機関は、デジタル化されたリポジトリ全体がアクセス不能となり、高額な是正措置が必要になる可能性があります。
チェーン・オブ・カストディと監査対応
デジタル化された政府記録は、真正性と非改ざん性を実証できなければなりません。FOIA、連邦証拠規則、および各州の公文書法では、政府機関がデジタル記録が主張どおりのものであること——つまり、元の紙文書から特定の時刻に、権限のあるオペレーターによって作成され、取り込み以降に変更されていないこと——を証明できることが求められます。
このチェーン・オブ・カストディ要件は、OCRワークフローに具体的な影響を及ぼします:
- 不変のソース画像: 元のスキャン画像は、OCR処理とは別に、ビトナルマスターとして保存する必要があります。OCRはコピーに対して実行し、原本を変更してはなりません。
- プロセスログ: すべてのOCR操作(実行時刻、ソフトウェアバージョン、設定、生成された出力)を記録し、保持する必要があります。このメタデータは、記録が異議申し立てされた場合の真正性の主張を裏付けます。
- チェックサム検証: ソース画像とOCR出力の暗号化ハッシュ(SHA-256)を計算し、保存する必要があります。将来の検証では、ハッシュを比較して未検出の改変が発生していないことを確認できます。
- 編集済み公開のバージョン管理: FOIA担当官が編集済み文書を公開する場合、政府機関は編集前の原本(チェーン・オブ・カストディ付き)と、どの免除コードに基づいて何を編集したかのログの両方を保持する必要があります。公開版のOCRテキストレイヤーには、編集されたコンテンツが一切含まれていないことを検証する必要があります。
ほとんどの商用OCRツールは、これらの監査要件を考慮して設計されていません。政府機関は、プロセスログへのAPIレベルのアクセスを提供し、チェックサム生成をサポートし、OCRワークフローをチェーン・オブ・カストディ追跡を処理するより広範な記録管理システムに統合できるソリューションを探す必要があります。
法的な文脈——特に法的文書および裁判所提出書類へのOCR適用——では、チェーン・オブ・カストディ要件はさらに厳格です。FRCP Rule 34では、電子的に保存された情報が「合理的に使用可能な」形式で提出されることが求められています。検証済みのソース画像から監査済みプロセスを通じてテキストレイヤーが生成されたことを示せるOCR処理文書は、その基準を満たします。ソースを追跡できない文書は異議申し立ての対象となる可能性があります。
部門間で処理を担当する機関や、外部ソースからの文書取り込みを統合する必要がある機関にとって、コレクションリンクのようなツール——第三者がファイルを処理キューに直接送信できる共有アップロードリンクを生成するツール——は、取り込みポイントを一元化し、アドホックなメール添付やUSB転送を排除することで、クリーンなチェーン・オブ・カストディの維持に役立ちます。
よくある質問
OCR処理結果は、NARAの永続記録に関するデジタル化基準を満たしますか?
はい、出力が36 CFR § 1236 Subpart Eの要件に準拠している場合に限ります。つまり、デジタル化画像はFADGI品質基準を満たし、規則で指定されたメタデータフィールドがファイルまたはアイテムレベルで取得され、OCRを使用する場合はテキストレイヤーが適切に埋め込まれている必要があります。NARAは永続記録にOCRを必須とはしていませんが、OCRを選択する機関は、OCR技術の適切な使用に関する最新の移行ガイダンスに従わなければなりません。重要なのは、OCR出力が元の二値画像を置き換えるものではなく、検索可能なレイヤーとして補完するものであることです。
文書をOCR処理した後に編集(墨消し)できますか?それとも再度OCR処理が必要ですか?
編集前に文書をOCR処理し、テキストレイヤーを使用してPIIを特定・確認し、編集領域から可視コンテンツとその下のテキストレイヤーの両方を除去する恒久的な編集を適用し、編集領域に復元可能なテキストが残っていないことを確認する必要があります。編集後にOCRを適用すると、編集されたコンテンツが自動検出のために検索可能になることはなく、FOIA処理にOCRを使用する効率性の利点が損なわれます。すでに不適切に編集された文書(例:テキストが復元可能な黒塗りオーバーレイ)を扱う場合は、物理的な編集済み文書を再スキャンし、新しいスキャンにOCRを適用することが、最も安全な是正方法となる場合があります。
政府文書のADAコンプライアンスにはOCRが必須ですか?
法律で明示されているわけではありませんが、実務上は必須です。WCAG 2.1 AA準拠では、非テキストコンテンツにテキストによる代替を提供することが求められます。画像としてのスキャンPDFには、スクリーンリーダーがアクセスできるテキストが含まれていません。OCRはそのテキストレイヤーを作成する唯一の実用的な方法です。ただし、高精度のOCRであっても、基本的なOCRだけではADAコンプライアンスを保証できません。出力は論理的な読み順を保持し、表やフォームフィールドを正しくタグ付けし、文書構造を維持する必要があります。レイアウト理解を備えたAI OCRは、従来の文字レベルOCRよりもWCAG準拠の出力を生成する可能性がはるかに高くなります。
異なるフォーム形式の複数機関からのドキュメントをOCRはどのように処理しますか?
従来のテンプレートベースのOCRでは、レイアウトごとに個別のテンプレートが必要です。これは、数百の情報源からドキュメントを受け取る機関にとっては非現実的です。フォーマット非依存のAI抽出がこの問題を解決します。必要なデータフィールド(許可番号、申請者名、発行日など)を定義すると、AIは各フィールドの意味を意味論的に理解することで、どのレイアウトでもそれらを特定します。テンプレートもフォームタイプごとのトレーニングも不要です。これは、異なる裁判所形式にわたる法務文書抽出に使用されているのと同じ技術であり、同様のフォーマットばらつきの課題が存在します。
政府記録に対するOCRの精度はどの程度期待できますか?
鮮明なタイプ文書(印刷フォーム、タイプされたレポート、コンピューター生成記録)では、最新のAI OCRは明確に定義された抽出フィールドに対して95〜99%のフィールドレベル精度を達成します。手書きフォーム(ブロック体で85〜95%、筆記体ではそれ以下)、カーボンコピーのフォームページ(古い政府記録で一般的)、損傷または退色した原本、テキストに重なるスタンプやシールのあるドキュメントでは精度が低下します。出生証明書や死亡証明書などの重要記録のように100%の忠実性が求められる場合は、AI抽出後の人間による検証ステップが推奨されます。国立公文書館のデジタル化品質管理ガイドは、記録タイプに基づく許容誤差率の枠組みを提供しています。
OCRは大規模なFOIA要求応答のバッチ処理に対応できますか?
はい。単一の要求が数百から数千ページに及ぶことが一般的であるため、バッチ処理はFOIA業務に不可欠です。バッチファースト処理ワークフローをサポートするAI OCRプラットフォームは、複数のドキュメントを同時に取り込み、全ページに一貫した抽出ルールを適用し、出力を単一の構造化ファイルにマージできます。これは、各ドキュメントを個別に処理するよりも大幅に効率的であり、特に同じFOIA要求が異なる形式の複数の部門からの記録をカバーする場合に有効です。注目すべき重要な機能は、バッチレベルの出力統合です。1つのFOIA要求は、個別ファイルのフォルダではなく、1つの検索可能な出力を生成する必要があります。