OCR für Behörden 2026:
Leitfaden zur Digitalisierung öffentlicher Aufzeichnungen, FOIA & Compliance
Das NARA M-23-07-Mandat – das am 30. Juni 2024 in Kraft trat – verlangt, dass alle dauerhaften Bundesunterlagen elektronisch verwaltet werden. Für staatliche und lokale Behörden, die jährlich 2–5 Millionen Dokumente verarbeiten und bei denen FOIA-Anfragen jeweils 15–30 Arbeitsstunden in Anspruch nehmen, besteht die Herausforderung nicht einfach darin, Papier in PDFs zu scannen. Es geht darum, diese digitalen Aufzeichnungen durchsuchbar, schwärzbar, gemäß WCAG 2.1 barrierefrei, über Jahrzehnte als PDF/A erhaltbar und von der Erfassung bis zur Freigabe prüfbar zu machen. Dieser Leitfaden behandelt, was OCR für Behörden tatsächlich erfordert – über die Zeichenerkennung hinaus – und wie KI-gestützte Extraktion das Machbare im gesamten Compliance-Lebenszyklus verändert.
Wichtigste Erkenntnisse
- Eine Black-Box-Überlagerung – die in Behörden am häufigsten verwendete Methode zur FOIA-Schwärzung – hinterlässt jedes geschwärzte Wort extrahierbar, wiederherstellbar und rechtlich auffindbar.
- Vorlagenbasierte Extraktion benötigt eine separate Vorlage für jedes Formularlayout jeder Abteilung – 500 Behörden bedeuten 500 Vorlagen, die jeweils stillschweigend brechen, wenn Formulare aktualisiert werden.
- Semantische KI-Extraktion liest Dokumente, indem sie versteht, was ein Feld bedeutet, statt wo es steht – so speisen 500 verschiedene Layouts verschiedener Behörden einen einzigen Workflow, ohne dass auch nur eine Vorlage gewartet werden muss.
Warum die Digitalisierung der Verwaltung mehr als einfaches Scannen erfordert
Eine mittelgroße Kommune verwaltet 2 bis 5 Millionen Dokumente — Baugenehmigungen, Grundbuchauszüge, Polizeiberichte, Gerichtsakten, Lieferantenverträge, Sitzungsprotokolle und Steuerbescheide. Die Papierlagerung kostet jährlich 25–40 Euro pro Quadratmeter. Eine einzige IFG-Anfrage kann 15–30 Mitarbeiterstunden für die Suche, Prüfung, Schwärzung und Bereitstellung der relevanten Unterlagen erfordern. Multipliziert mit den Hunderten offenen Anfragen, die viele Behörden gleichzeitig bearbeiten, entsteht eine enorme operative Belastung.
Einfaches Scannen löst das Speicherproblem — es lagert Papier aus und schafft Bürofläche. Doch ein gescanntes PDF ohne durchsuchbaren Text, ohne strukturierte Metadaten, ohne schwärzungsfähige Formatierung und ohne Barrierefreiheits-Tags bleibt faktisch verschlossen. Ein bildbasiertes PDF lässt sich weder nach einer Aktennummer durchsuchen, noch von einem Schwärzungstool auf personenbezogene Daten prüfen, noch von einem Screenreader vorlesen, und es erfüllt nicht die NARA 36 CFR § 1236 Subpart E Digitalisierungsstandards für dauerhafte Unterlagen.
OCR — optische Zeichenerkennung — ist die Schicht, die aus einem gescannten Bild nutzbare digitale Inhalte macht. Doch die Art der OCR ist entscheidend. Herkömmliche OCR erkennt Zeichenformen und gibt undifferenzierten Text aus: jedes Wort auf der Seite erscheint als Zeichenkette ohne Kennzeichnung. Die Rechnungsnummer, das Aktenzeichen, das Ablaufdatum der Genehmigung, der Lieferantenname — alles landet im selben Textblock. Ein Mensch muss jeden Wert manuell in die richtige Spalte kopieren. Deshalb kann eine Zeichengenauigkeit von 99,5 % mit einem Workflow koexistieren, der pro IFG-Anfrage immer noch 15–30 Stunden dauert: Der Text wird erkannt, aber nicht geparst, nicht gekennzeichnet und nicht für den nächsten Compliance-Schritt aufbereitet.
KI-gestützte Dokumentenextraktion — die nächste Generation der OCR — führt semantisches Verständnis ein. Statt Zeichenformen zu lesen, erfassen Bildmodelle ein Dokument wie ein Mensch: Sie erkennen, dass eine Zeichenkette in Zeile 12 einer Gerichtsakte das Aktenzeichen ist, weil sie die strukturelle Rolle dieses Feldes verstehen. Dieser Unterschied zwischen Zeichenerkennung und Dokumentenverständnis ist nicht akademisch. Er entscheidet darüber, ob ein öffentliches Archiv auf eine IFG-Anfrage in 2 Stunden oder 2 Tagen antworten kann.
Die Dokumenttypen, die behördliche OCR definieren
Behörden verarbeiten nicht nur einen Dokumenttyp. Sie verarbeiten Dutzende, jeder mit eigenen Feldstrukturen, Layoutkonventionen und regulatorischen Anforderungen. Die Vielfalt der Dokumenttypen ist der erste Grund, warum template-basierte OCR im öffentlichen Sektor scheitert.
| Dokumenttyp | Wichtige Extraktionsfelder | Besondere Compliance-Anforderung |
|---|---|---|
| Baugenehmigungen | Genehmigungsnummer, Antragstellername, Grundstücksadresse, Wert, Ausstellungsdatum, Ablaufdatum | Gemeindesatzungsverweise, Gebührenordnung |
| Gerichtsdokumente / Akten | Aktenzeichen, Parteinamen, Einreichungsdatum, Dokumenttyp, Richterzuweisung | Bates-Nummerierung, Seitenintegrität, FRCP-Konformität |
| FOIA-Antworten | Antragsnummer, Antragstellername, Eingangsdatum, angewandte Ausnahmeklauseln, Antwortdatum | Ausnahmenverfolgung (b)(1)-(b)(9), Schwärzungscodes nach NARA-Richtlinien |
| Polizeiberichte | Vorfallsnummer, meldender Beamter, Datum/Uhrzeit, Ort, Beteiligte, Anklagepunkte | CJIS-Sicherheitsrichtlinie, Schwärzung von Opfer-/Zeugen-PII |
| Steuerbescheide | Flurstückskennung, festgestellter Wert, Grundstücksadresse, Steuerjahr, geltend gemachte Ausnahmen | Landeseinheitliche Kontenrahmen, GASB-Konformität |
| Lieferantenverträge / Beschaffung | Vertragsnummer, Lieferantenname, Zuschlagsbetrag, Laufzeitdaten, Verlängerungsklausel | Öffentliches Vergaberecht, Aufbewahrung von Angebotstabellen |
| Personenstandsurkunden | Urkundennummer, Name des Registrierten, Ereignisdatum, Zuständigkeitsbereich | Landesspezifische Datenschutzgesetze, Zugriffsstufen |
| Förderanträge | Fördernummer, antragstellende Organisation, Zuwendungsbetrag, Leistungszeitraum | 2 CFR 200-Konformität, Single-Audit-Anforderungen |
Jeder Dokumenttyp stammt aus einer anderen Abteilung, oft aus einem anderen Softwaresystem oder Papierformular, und folgt eigenen Layoutkonventionen. Die Heiratsurkunde eines Standesbeamten hat strukturell keine Ähnlichkeit mit dem Vorfallsbericht einer Polizeidienststelle. Die Kernherausforderung der behördlichen OCR liegt nicht im Erkennen von Zeichen auf einer Seite – sondern darin, unterschiedliche, inkonsistente Dokumentformate in eine einheitliche Datenstruktur zu überführen, die ein Dokumentenmanagementsystem speisen kann.
Redaktion und OCR – Warum die Reihenfolge entscheidend ist
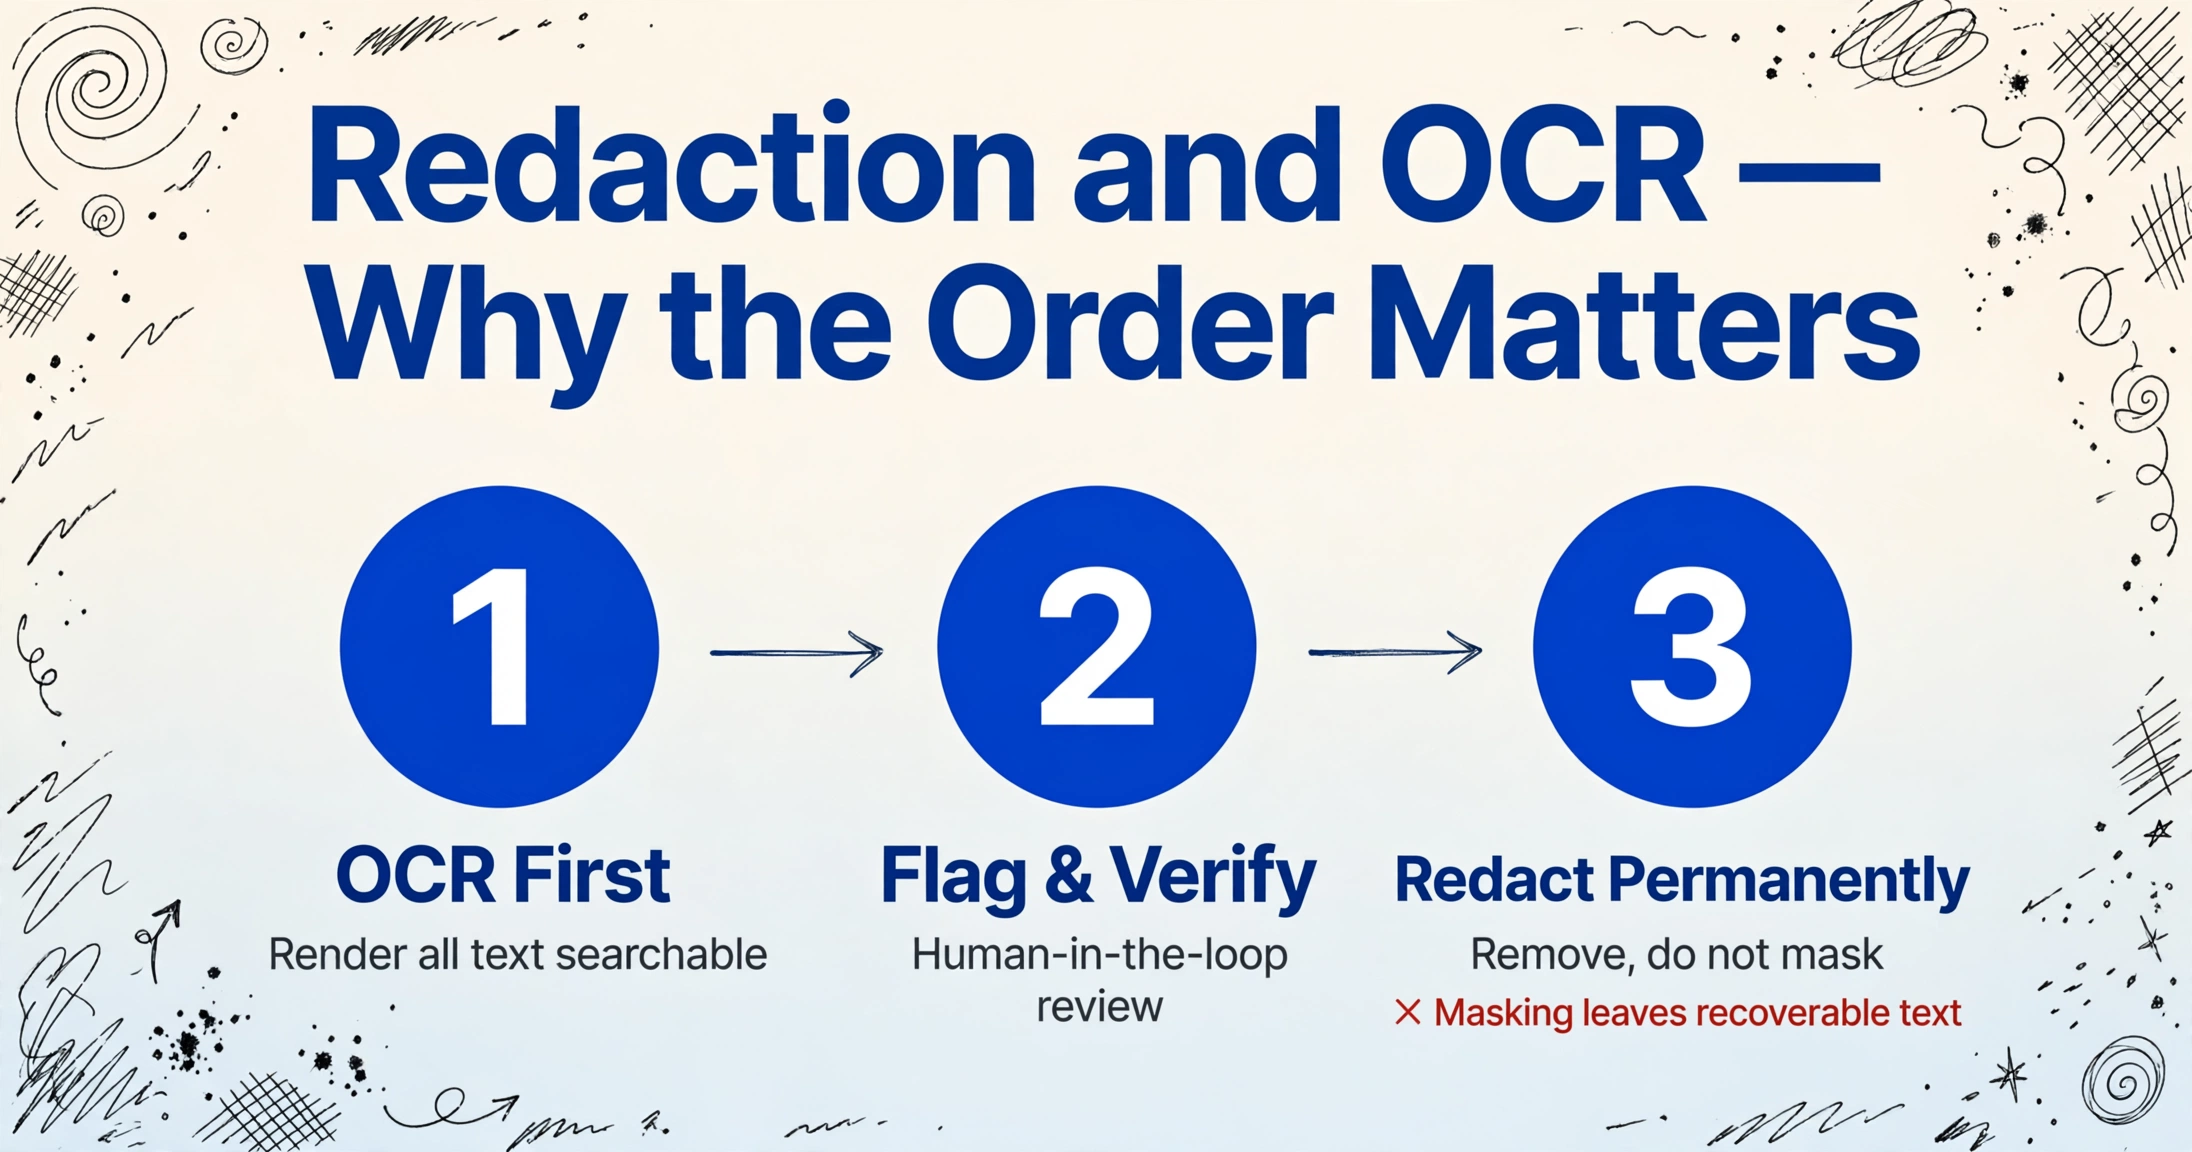
FOIA verlangt von Behörden, auf Anfragen reagierende Unterlagen freizugeben, wobei ausgenommene Informationen geschwärzt werden müssen. Die Ausnahmecodes – (b)(1) bis (b)(9) für Bundesbehörden – decken alles ab, von der nationalen Sicherheit (b)(1) bis zu geologischen Informationen über Bohrlöcher (b)(9), wobei die häufigsten (b)(6) Schutz der Privatsphäre und (b)(7) Strafverfolgung sind. Eine einzige FOIA-Antwort kann Dutzende oder Hunderte einzelner Schwärzungen über Tausende von Seiten erfordern.
Hier ist die technische Reihenfolge, die viele staatliche Digitalisierungspläne falsch umsetzen:
Bevor ein Schwärzungswerkzeug personenbezogene Daten (PII) – Sozialversicherungsnummern, Geburtsdaten, Namen minderjähriger Kinder, Finanzkontonummern – identifizieren kann, muss das Dokument eine maschinenlesbare Textebene haben. Hier bietet KI-OCR mit Named Entity Recognition (NER) einen Mehrwert: Es kann automatisch Kandidaten für sensible Entitäten über Tausende von Seiten hinweg kennzeichnen und so den manuellen Suchaufwand von 100 % auf eine überprüfte Teilmenge reduzieren.
KI kennzeichnet potenzielle PII; ein geschulter Prüfer bestätigt jede Kennzeichnung. Dies ist nicht vollständig automatisierbar – kontextabhängige Entscheidungen (ist dies „John Smith“, ein öffentlicher Amtsträger, dessen Name offengelegt werden muss, oder ein Zeuge, dessen Identität geschützt werden muss?) erfordern menschliches Urteilsvermögen. Der Überprüfungsschritt erzeugt eine verifizierte Schwärzungsliste.
Dauerhafte Schwärzung entfernt den zugrunde liegenden Text aus allen Ebenen – sichtbarer Text, versteckter Text, Metadaten und Anmerkungen. Schwarze Überlagerungen oder Hervorhebungsabdeckungen sind keine Schwärzung; der darunterliegende Text bleibt extrahierbar. Die Ausgabe muss ein sauberes PDF ohne wiederherstellbare Inhalte sein. Der E-Government Act von 2002 und die FOIA-Vorschriften verlangen diese Gründlichkeit.
Das freigegebene Dokument muss für den Antragsteller navigierbar und durchsuchbar bleiben. Nicht ausgenommene Teile behalten ihre OCR-Textebene. Hier ist die richtige Reihenfolge entscheidend: Wenn Sie nach der Schwärzung OCR durchführen, sind die geschwärzten Bereiche dauerhaft ausgeschlossen. Wenn Sie vor der Schwärzung OCR durchführen, aber die OCR-Ebene nicht bereinigen, können geschwärzte Inhalte in der Textebene durchsickern.
Die praktische Erkenntnis: OCR muss früh genug angewendet werden, um eine automatisierte PII-Erkennung zu ermöglichen, aber die OCR-Ausgabeschicht muss in den geschwärzten Bereichen des endgültigen Dokuments dauerhaft entfernt werden. Nicht alle OCR-Werkzeuge führen diesen Bereinigungsschritt korrekt durch. Fragen Sie bei der Bewertung von OCR-Lösungen für Behörden ausdrücklich, ob das Werkzeug Textebenen aus geschwärzten Bereichen entfernt – nicht nur, ob es mit schwarzen Kästen „schwärzen“ kann.
PDF/A und Anforderungen an die langfristige Archivierung
Die Anforderungen von NARA in 36 CFR § 1236 Subpart E schreiben vor, dass digitalisierte dauerhaft aufzubewahrende Unterlagen bestimmte Format- und Qualitätsstandards erfüllen. Der relevanteste Standard für die Dokumentenerhaltung ist PDF/A – eine ISO-standardisierte Version von PDF, die für die langfristige Archivierung entwickelt wurde. Im Gegensatz zu Standard-PDFs, die von externen Schriftarten, verlinkten Bildern oder softwarespezifischen Funktionen abhängen können, die mit der Zeit an Qualität verlieren, bettet PDF/A alles, was die Datei benötigt, in sich selbst ein: Schriftarten, Farbprofile, Metadaten und geräteunabhängige Rendering-Anweisungen.
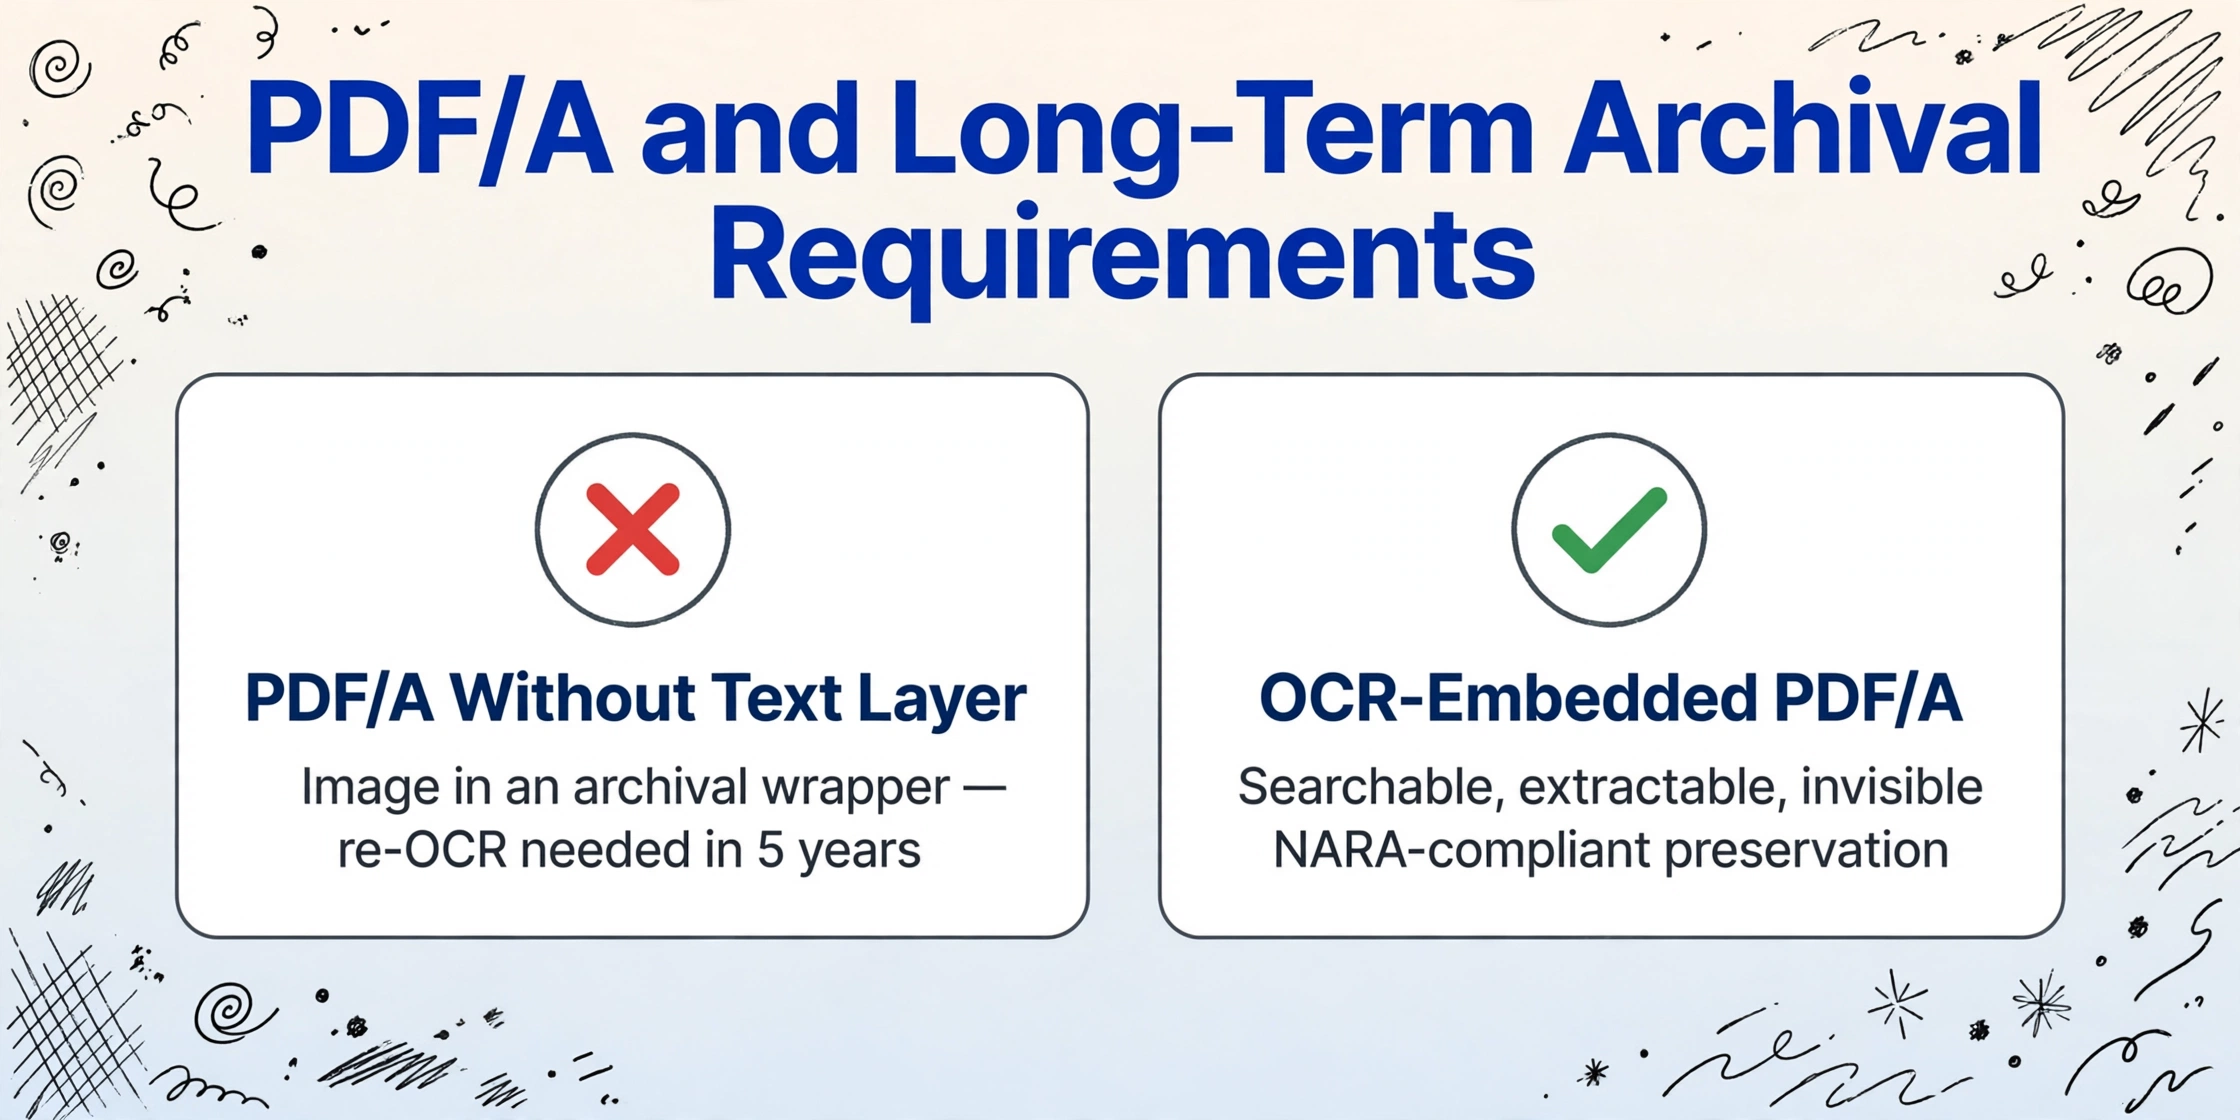
Für Regierungsbehörden ist PDF/A für dauerhaft aufzubewahrende Unterlagen nicht optional. Die Federal Agencies Digital Guidelines Initiative (FADGI) legt die Umsetzungsbenchmarks fest, und die Übertragungsrichtlinien von NARA spezifizieren, dass digitalisierte dauerhaft aufzubewahrende Unterlagen konform sein müssen. Hier liegt jedoch die Überschneidung mit OCR: Eine PDF/A-Datei ohne erkennbare Textebene ist ein Bild in einem Archivierungsrahmen. Sie besteht den Formattest, scheitert jedoch am Nutzungstest. Wenn in fünf Jahren eine FOIA-Anfrage für diese Unterlage eingeht, müssen die Mitarbeiter das gesamte Dokument von Grund auf neu mit OCR erfassen, weil die OCR-Textebene von 2026 nicht erhalten wurde.
Der richtige Ansatz ist OCR-eingebettetes PDF/A: Der erkannte Text wird als versteckte Ebene innerhalb der PDF/A-Datei selbst gespeichert – durchsuchbar, extrahierbar, aber für den Betrachter unsichtbar. Dies bewahrt sowohl die Archivintegrität des bitonalen Bildes als auch die funktionale Durchsuchbarkeit des Textes. Jeder behördliche OCR-Workflow, der kein PDF/A mit eingebetteten Textebenen erzeugt, schafft einen zukünftigen FOIA-Rückstau, da jede zukünftige Anfrage eine erneute Verarbeitung derselben Dokumente erfordert.
Bei der Auswahl einer OCR-Lösung für den behördlichen Einsatz sollten Sie bestätigen, dass die Ausgabe die Konformität mit PDF/A-1 oder PDF/A-2 mit eingebetteten OCR-Textebenen unterstützt. PDF/A-2 bietet eine verbesserte Komprimierung und Unterstützung für erweiterte Grafiken, was für Dokumente relevant ist, die neben Text auch Fotografien, Karten oder gescannte Unterschriften enthalten.
Behördenübergreifende Formatabweichungen — warum Vorlagen scheitern
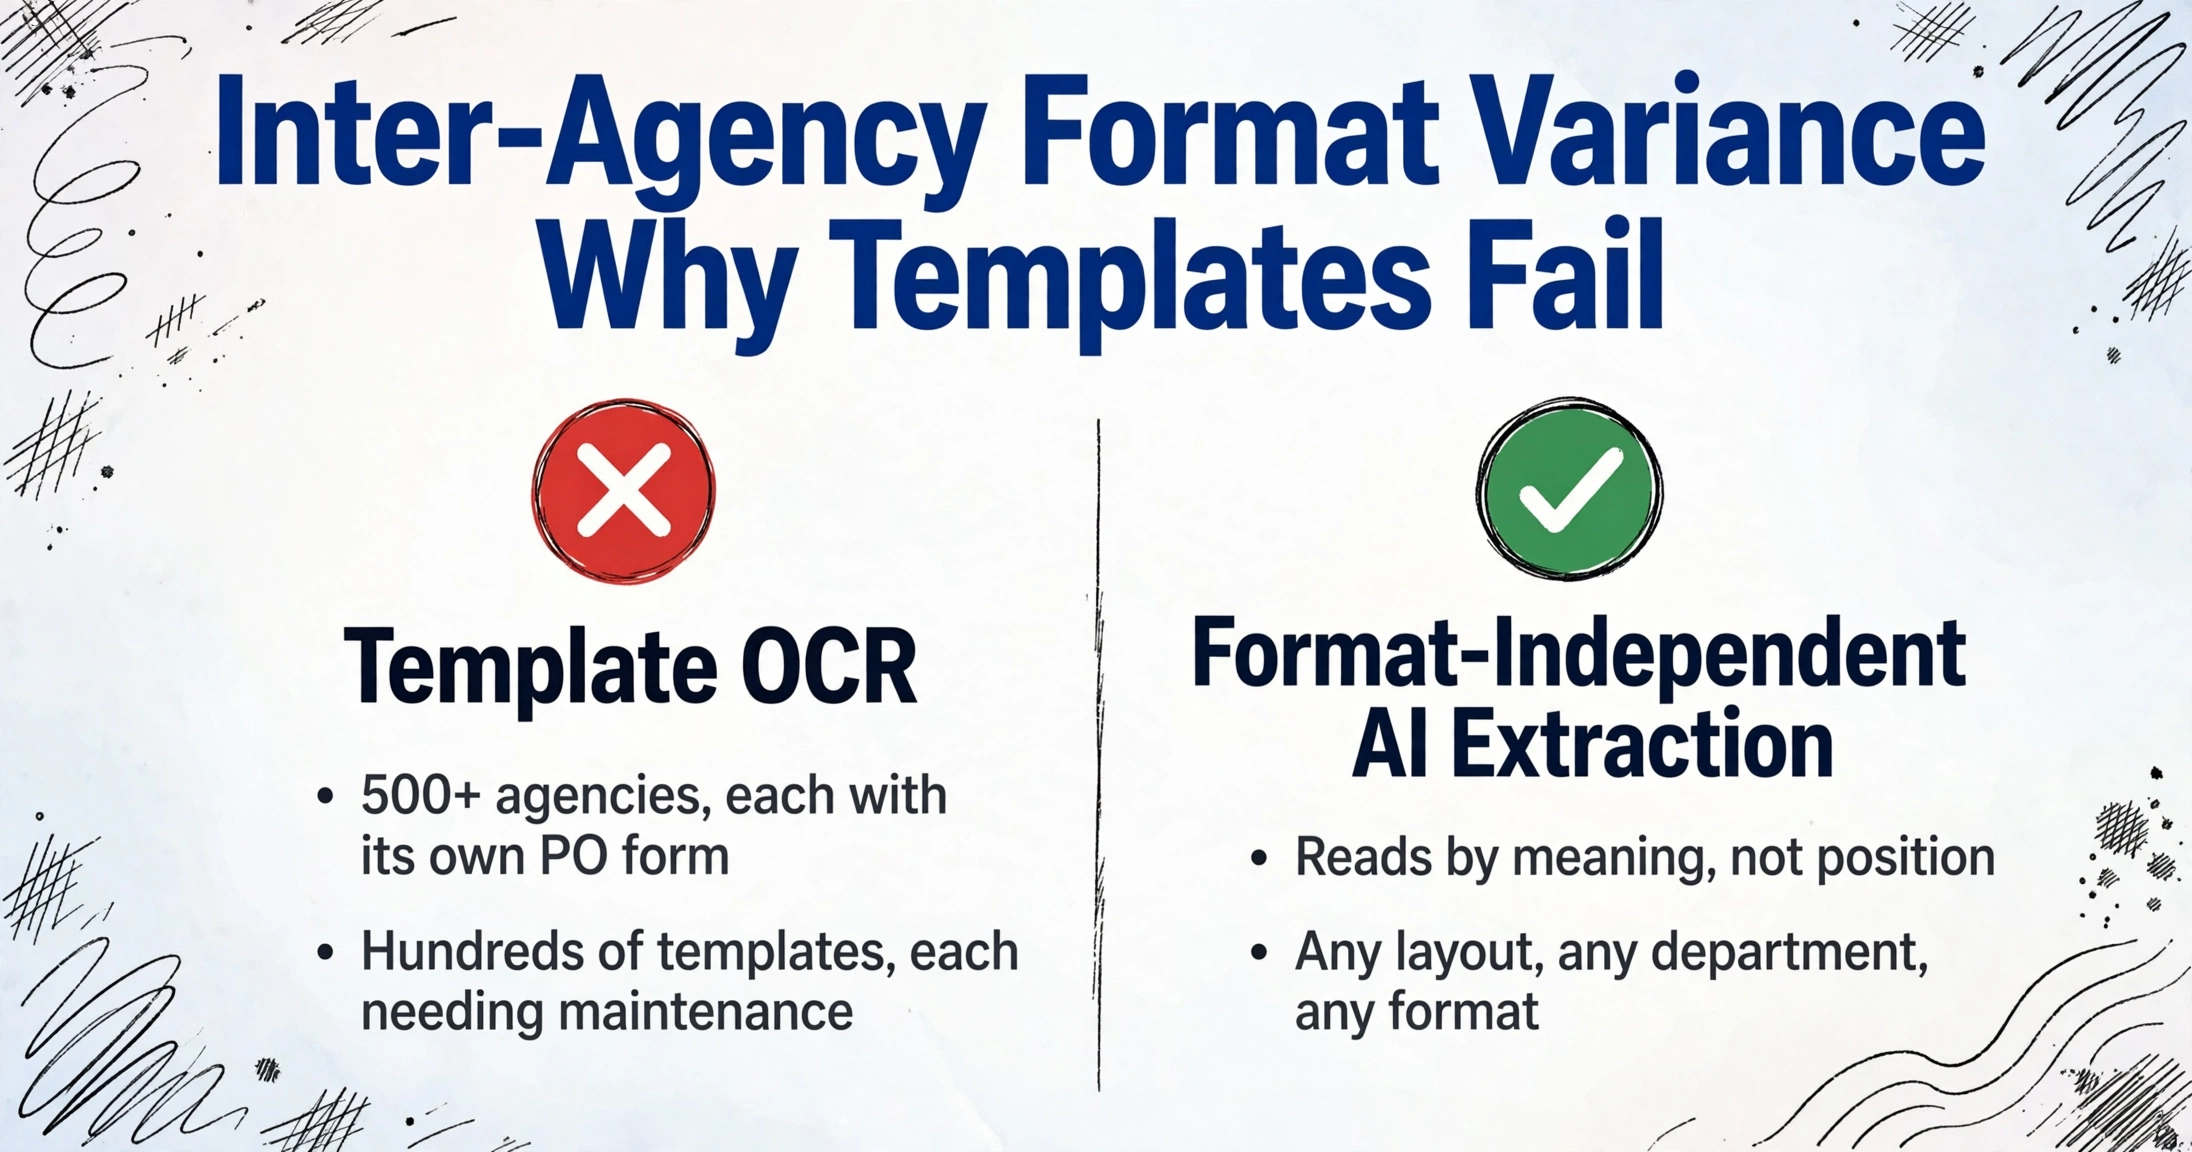
Vorlagenbasiertes OCR — der Ansatz traditioneller IDP-Plattformen — erfordert eine vorgefertigte Extraktionsvorlage für jedes einzigartige Dokumentlayout. Der Benutzer zeichnet Zonen um jede Feldposition, weist eine Bezeichnung zu und stellt die Vorlage bereit. Wenn der nächste Anbieter ein leicht abweichendes Formular einreicht — andere Schriftart, andere Spaltenreihenfolge, andere Feldbezeichnungen — bricht die Vorlage und erfordert manuelle Nacharbeit.
Regierungsbehörden stehen in großem Umfang vor diesem Problem. Betrachten Sie ein einzelnes staatliches Beschaffungsamt, das Bestellungen von über 500 Behörden verarbeitet, jede mit ihrem eigenen Bestellformular. Oder einen Kreisbeamten, der Gerichtseingaben aus 15 verschiedenen Richterkanzleien erhält. Oder ein städtisches FOIA-Büro, das Anfragen aus Polizei-, Planungs-, Finanz-, Bau- und Parkabteilungen verwaltet — jede mit ihren eigenen Aufzeichnungsformaten. Vorlagenbasiertes OCR würde Hunderte oder Tausende einzelner Vorlagen erfordern, die jeweils bei Formularänderungen gewartet werden müssen.
Formatunabhängige Extraktion — bei der die KI Dokumente durch semantisches Verständnis statt durch Position liest — beseitigt den Vorlagen-Engpass. Statt abzubilden, wo Daten auf einer Seite stehen, definieren Sie, welche Daten Sie benötigen: Genehmigungsnummer, Antragstellername, Bewertung, Ablaufdatum. Die KI lokalisiert diese Werte in jedem Layout, aus jeder Abteilung, in jedem Format. Dieser Ansatz spiegelt wider, wie die Aktenverwaltung der Regierung tatsächlich funktioniert: Die Datenkategorien sind über Behörden hinweg stabil (jede Genehmigung hat eine Genehmigungsnummer), aber die visuelle Darstellung dieser Kategorien variiert stark. Dieselbe Herausforderung der Formatabweichungen tritt bei der Verarbeitung von Bankdokumenten auf, wo Finanzinstitute Kontoauszugsformate von Hunderten verschiedener Banken verarbeiten müssen.
Dies ist derselbe Paradigmenwechsel, den KI-OCR für das Dokumentverständnis allgemein mit sich bringt — von positionsbasierter Erkennung zu semantischer Extraktion. Für Regierungsbehörden, die Aufzeichnungen aus Dutzenden von Quellen verwalten, ist dieser Wandel kein Komfort-Upgrade; er ist der Unterschied zwischen einem Projekt, das skaliert, und einem, das dauerhaft Personal für die Vorlagenwartung erfordert.
ADA- und WCAG-Barrierefreiheitskonformität
Titel II des Americans with Disabilities Act verlangt, dass staatliche und lokale Behördendienste – einschließlich digitaler Aufzeichnungen – für Menschen mit Behinderungen zugänglich sind. Das Justizministerium hat dies durch den Web Content Accessibility Guidelines (WCAG) 2.1 Level AA-Standard bekräftigt, der für digitale Dokumente und Aufzeichnungen gilt, die der Öffentlichkeit bereitgestellt werden.
Für OCR in der Regierung bedeutet dies drei konkrete Leistungen:
Ein gescanntes Dokument ohne OCR ist ein Bild. Screenreader (JAWS, NVDA, VoiceOver) können bildbasierten Text nicht interpretieren. Die OCR-Textebene muss als getaggter PDF-Inhalt eingebettet sein – nicht nur als versteckte Überlagerung – damit assistive Technologien sie in logischer Lesereihenfolge lesen können.
Behördendokumente sind oft mehrspaltig (Gerichtsdokumente, Gesetzesberichte, Förderanträge). Herkömmliche OCR verkettet Spalten häufig zu einem einzigen Textstrom – Spalte 1 Zeile 1, Spalte 2 Zeile 1, Spalte 1 Zeile 2 – wodurch die Ausgabe für einen Screenreader unverständlich wird. KI-OCR, die das Seitenlayout versteht, bewahrt die logische Lesereihenfolge.
Tabellen, Kontrollkästchen (häufig in behördlichen Formularen) und Signaturzeilen erfordern Tag-Anmerkungen, um zugänglich zu sein. Die automatische Erkennung dieser Elemente – und die Umwandlung in getaggte PDF-Strukturen – ist kein Standardmerkmal von OCR. KI-Visionsmodelle können Tabellen und Formularfelder identifizieren, indem sie verstehen, was sie sind, und so eine automatisierte Tagging ermöglichen, die zeichenbasierte OCR nicht leisten kann.
ADA-Barrierefreiheit ist in der behördlichen OCR kein nachrangiges Anliegen. Die Grundfunktion herkömmlicher OCR – das Erkennen von Zeichen und die Ausgabe von Text – erzeugt keine zugänglichen Dokumente. Die Erstellung WCAG 2.1 AA-konformer Ausgaben erfordert ein höheres Maß an Dokumentverständnis, das Layoutanalyse, semantische Auszeichnung und die Bewahrung der Lesereihenfolge umfasst. Behörden, die dies in der Beschaffungsphase nicht berücksichtigen, könnten feststellen, dass ihr gesamtes digitalisiertes Archiv unzugänglich ist und kostspielige Sanierungsmaßnahmen erfordert.
Chain of Custody und Prüfungsbereitschaft
Digitalisierte Regierungsunterlagen müssen nachweislich authentisch und unverändert sein. FOIA, die Federal Rules of Evidence und staatliche Gesetze zu öffentlichen Unterlagen verlangen, dass Behörden nachweisen können, dass ein digitales Dokument das ist, was es vorgibt zu sein – dass es zu einem bestimmten Zeitpunkt von einem autorisierten Bediener aus dem ursprünglichen Papierdokument erstellt wurde und seit der Erfassung nicht verändert wurde.
Diese Anforderung an die Chain of Custody hat konkrete Auswirkungen auf OCR-Workflows:
- Unveränderliches Quellbild: Das ursprünglich gescannte Bild muss als bitonales Master getrennt von jeglicher OCR-Verarbeitung aufbewahrt werden. OCR sollte auf einer Kopie arbeiten und das Original nicht verändern.
- Prozessprotokollierung: Jeder OCR-Vorgang – wann er ausgeführt wurde, welche Softwareversion, welche Einstellungen, welche Ausgabe erzeugt wurde – muss protokolliert und aufbewahrt werden. Diese Metadaten stützen den Authentizitätsanspruch, falls das Dokument angefochten wird.
- Prüfsummenverifizierung: Kryptografische Hashes (SHA-256) des Quellbilds und der OCR-Ausgabe sollten berechnet und gespeichert werden. Jede zukünftige Verifizierung kann Hashes vergleichen, um zu bestätigen, dass keine unerkannte Änderung stattgefunden hat.
- Versionskontrolle für geschwärzte Veröffentlichungen: Wenn ein FOIA-Beauftragter ein geschwärztes Dokument veröffentlicht, muss die Behörde sowohl das ungeschwärzte Original (mit Chain of Custody) als auch ein Protokoll darüber aufbewahren, was unter welchem Ausnahmecode geschwärzt wurde. Die OCR-Textschicht in der veröffentlichten Version muss verifiziert werden, damit sie keine der geschwärzten Inhalte enthält.
Die meisten kommerziellen OCR-Tools sind nicht im Hinblick auf diese Prüfungsanforderungen konzipiert. Regierungsbehörden sollten nach Lösungen suchen, die API-Zugriff auf Prozessprotokolle bieten, die Generierung von Prüfsummen unterstützen und die Integration des OCR-Workflows in ein umfassenderes Dokumentenmanagementsystem ermöglichen, das die Chain-of-Custody-Verfolgung übernimmt.
Für rechtliche Kontexte – insbesondere OCR für Rechtsdokumente und Gerichtseinreichungen – sind die Anforderungen an die Chain of Custody noch strenger. FRCP Rule 34 verlangt, dass elektronisch gespeicherte Informationen in einem „vernünftig nutzbaren“ Format bereitgestellt werden. Ein OCR-verarbeitetes Dokument, bei dem nachgewiesen werden kann, dass die Textschicht aus einem verifizierten Quellbild durch einen geprüften Prozess erzeugt wurde, erfüllt diesen Standard. Eines, bei dem die Quelle nicht zurückverfolgt werden kann, kann angefochten werden.
Für Behörden, die die Verarbeitung über Abteilungen hinweg abwickeln oder den Dokumenteneingang aus externen Quellen konsolidieren müssen, helfen Tools wie der Sammellink – der einen teilbaren Upload-Link generiert, sodass Dritte Dateien direkt in eine Verarbeitungswarteschlange einreichen können –, eine saubere Chain of Custody aufrechtzuerhalten, indem der Eingangspunkt zentralisiert und Ad-hoc-E-Mail-Anhänge oder USB-Übertragungen eliminiert werden.
Häufig gestellte Fragen
Erfüllt die OCR-Ausgabe die Digitalisierungsstandards der NARA für dauerhafte Aufzeichnungen?
Ja, sofern die Ausgabe den Anforderungen des 36 CFR § 1236 Subpart E entspricht. Das bedeutet, dass das digitalisierte Bild die FADGI-Qualitätskriterien erfüllen muss, die in der Verordnung festgelegten Metadatenfelder auf Datei- oder Einzelebene erfasst werden müssen und bei Verwendung von OCR die Textebene ordnungsgemäß eingebettet sein muss. Die NARA schreibt OCR für dauerhafte Aufzeichnungen nicht vor, aber Behörden, die sie einsetzen, müssen die aktualisierten Übergabeanleitungen zur angemessenen Nutzung der OCR-Technologie befolgen. Entscheidend ist, dass die OCR-Ausgabe das ursprüngliche bitonale Bild nicht ersetzt, sondern als durchsuchbare Ebene ergänzt.
Kann ich ein Dokument nach der OCR schwärzen oder muss ich es erneut mit OCR bearbeiten?
Sie müssen das Dokument vor der Schwärzung mit OCR bearbeiten, die Textebene zur Identifizierung und Markierung von PII für die Prüfung nutzen, eine dauerhafte Schwärzung anwenden, die sowohl den sichtbaren Inhalt als auch die darunterliegende Textebene in den geschwärzten Bereichen entfernt, und dann überprüfen, ob in den geschwärzten Regionen kein wiederherstellbarer Text mehr vorhanden ist. Eine OCR nach der Schwärzung würde bedeuten, dass der geschwärzte Inhalt nie für die automatisierte Erkennung durchsuchbar war – was den Effizienzgewinn durch den Einsatz von OCR für die FOIA-Bearbeitung zunichtemacht. Wenn Sie mit Dokumenten arbeiten, die bereits falsch geschwärzt wurden (z. B. mit schwarzen Überlagerungen, die Text wiederherstellbar lassen), ist das erneute Scannen des physisch geschwärzten Dokuments und die anschließende OCR des neuen Scans manchmal der sicherste Weg zur Korrektur.
Ist OCR für die ADA-Konformität von Regierungsdokumenten erforderlich?
Nicht explizit gesetzlich vorgeschrieben, aber in der Praxis ja. Die WCAG-2.1-AA-Konformität verlangt, dass Nicht-Text-Inhalte eine Textalternative haben. Eine gescannte PDF-Seite als Bild enthält keinen Text, den ein Screenreader erfassen kann. OCR ist der einzig praktikable Weg, um diese Textebene zu erstellen. Eine einfache OCR allein – selbst mit hoher Genauigkeit – garantiert jedoch keine ADA-Konformität. Die Ausgabe muss auch die logische Lesereihenfolge bewahren, Tabellen und Formularfelder korrekt auszeichnen und die Dokumentenstruktur erhalten. KI-OCR mit Layoutverständnis erzeugt mit deutlich höherer Wahrscheinlichkeit WCAG-konforme Ausgaben als herkömmliche zeichenbasierte OCR.
Wie handhabt OCR Dokumente mehrerer Behörden mit unterschiedlichen Formularlayouts?
Herkömmliche OCR auf Vorlagenbasis erfordert eine separate Vorlage für jedes einzigartige Layout – unpraktisch, wenn eine Behörde Dokumente von Hunderten von Quellen erhält. Formatunabhängige KI-Extraktion löst dieses Problem: Sie definieren die benötigten Datenfelder (Genehmigungsnummer, Antragstellername, Ausstellungsdatum usw.) und die KI findet sie in jedem Layout, indem sie versteht, was jedes Feld semantisch bedeutet. Keine Vorlagen, kein Training pro Formulartyp. Dies ist dieselbe Technologie, die auch für die Extraktion juristischer Dokumente aus verschiedenen Gerichtsformaten verwendet wird, wo ähnliche Formatvarianz-Herausforderungen bestehen.
Welche Genauigkeit sollte ich bei OCR für Behördenunterlagen erwarten?
Bei sauberen, getippten Dokumenten – gedruckten Formularen, getippten Berichten, computergenerierten Aufzeichnungen – erreicht moderne KI-OCR eine Feldgenauigkeit von 95–99 % für klar definierte Extraktionsfelder. Die Genauigkeit sinkt bei handschriftlichen Formularen (85–95 % bei Druckschrift, niedriger bei Schreibschrift), bei Durchschlagseiten (häufig in älteren Behördenunterlagen), bei beschädigten oder verblassten Originalen sowie bei Dokumenten mit Stempeln oder Siegeln, die den Text überlagern. Für dauerhaft aufzubewahrende Unterlagen, bei denen 100 % Genauigkeit erforderlich ist – etwa bei Personenstandsurkunden (Geburts-/Sterbeurkunden) – wird nach der KI-Extraktion ein menschlicher Prüfschritt empfohlen. Der Quality Management Guide des National Archives zur Digitalisierung bietet einen Rahmen für akzeptable Fehlerraten je nach Unterlagenart.
Kann OCR die Stapelverarbeitung für große FOIA-Antworten bewältigen?
Ja – die Stapelverarbeitung ist für die FOIA-Arbeit unerlässlich, da einzelne Anfragen routinemäßig Hunderte oder Tausende von Seiten umfassen. KI-OCR-Plattformen, die Batch-First-Workflows unterstützen, können mehrere Dokumente gleichzeitig erfassen, einheitliche Extraktionsregeln auf alle Seiten anwenden und die Ergebnisse in einer einzigen strukturierten Datei zusammenführen. Dies ist wesentlich effizienter als die Einzelverarbeitung jedes Dokuments, insbesondere wenn dieselbe FOIA-Anfrage Unterlagen aus mehreren Abteilungen mit unterschiedlichen Formaten umfasst. Die wichtigste Funktion, auf die Sie achten sollten, ist die Konsolidierung der Ausgabe auf Batchebene: Eine FOIA-Anfrage sollte eine durchsuchbare Ausgabe erzeugen, nicht einen Ordner mit einzelnen Dateien.