OCR para Governo 2026:
Guia de Digitalização de Registros Públicos, FOIA e Conformidade
A diretriz NARA M-23-07 — que entrou em vigor em 30 de junho de 2024 — exige que todos os registros federais permanentes sejam gerenciados eletronicamente. Mas para agências estaduais e locais que processam de 2 a 5 milhões de documentos anualmente, com solicitações FOIA consumindo de 15 a 30 horas de equipe cada, o desafio não é simplesmente digitalizar papel em PDFs. É tornar esses registros digitais pesquisáveis, redigíveis, acessíveis de acordo com os padrões WCAG 2.1, preserváveis como PDF/A por décadas e auditáveis desde a ingestão até a divulgação. Este guia aborda o que o OCR para governo realmente exige — além do reconhecimento de caracteres — e como a extração com IA muda o que é possível em todo o ciclo de vida da conformidade.
Principais Conclusões
- Uma sobreposição de caixa preta — o método de redação FOIA mais comum no governo — deixa cada palavra redigida extraível, recuperável e legalmente descobrível.
- A extração baseada em modelo exige um modelo separado para cada layout de formulário de cada departamento — 500 agências significam 500 modelos, cada um falhando silenciosamente quando os formulários são atualizados.
- A extração semântica com IA lê documentos entendendo o que um campo significa, em vez de onde ele está — assim, os layouts diferentes de 500 agências alimentam um único fluxo de trabalho sem um único modelo para manter.
Por que a digitalização governamental exige mais que escaneamento básico
Uma prefeitura de médio porte gerencia de 2 a 5 milhões de documentos — alvarás de construção, registros de propriedade, boletins de ocorrência, processos judiciais, contratos de fornecedores, atas de reuniões e avaliações fiscais. O armazenamento de papel custa de US$ 25 a US$ 40 por metro quadrado ao ano. Um único pedido da Lei de Acesso à Informação pode exigir de 15 a 30 horas de trabalho para localizar, revisar, tarjar e produzir os documentos solicitados. Multiplique isso pelas centenas de pedidos abertos que muitos órgãos carregam a qualquer momento, e o impacto operacional é enorme.
O escaneamento básico de documentos resolve o problema de armazenamento — tira o papel do local e libera espaço no escritório. Mas um PDF escaneado sem texto pesquisável, sem metadados estruturados, sem formatação pronta para tarja e sem tags de acessibilidade ainda está efetivamente bloqueado. Um PDF baseado em imagem não pode ser pesquisado por número de processo, não pode ser analisado por uma ferramenta de tarja para dados pessoais, não pode ser lido por um leitor de tela e não atende aos padrões de digitalização do NARA 36 CFR § 1236 Subpart E para registros permanentes.
OCR — Reconhecimento Óptico de Caracteres — é a camada que transforma uma imagem escaneada em conteúdo digital utilizável. Mas o tipo de OCR importa. O OCR tradicional lê formas de caracteres e gera texto indiferenciado: cada palavra na página sai como uma string sem rótulos. O número da nota fiscal, o número do processo judicial, a data de validade da licença, o nome do fornecedor — tudo cai no mesmo bloco de texto. Um humano ainda precisa copiar cada valor para a coluna correta. É por isso que uma taxa de precisão de caracteres de 99,5% pode coexistir com um fluxo de trabalho que ainda leva de 15 a 30 horas por pedido da Lei de Acesso à Informação: o texto é reconhecido, mas não é analisado, rotulado ou preparado para a próxima etapa de conformidade.
A extração de documentos com IA — a próxima geração do OCR — introduz compreensão semântica. Em vez de ler formas de caracteres, os modelos de visão leem um documento como um humano faria: eles reconhecem que uma string na linha 12 de um processo judicial é o número do caso porque entendem o papel estrutural que aquele campo desempenha. Essa distinção entre reconhecimento de caracteres e compreensão de documentos não é acadêmica. Ela determina se um arquivo público pode responder a um pedido da Lei de Acesso à Informação em 2 horas ou em 2 dias.
Os Tipos de Documentos Que Definem o OCR Governamental
Agências governamentais não processam um único tipo de documento. Elas processam dezenas, cada um com estruturas de campos distintas, convenções de layout e requisitos regulatórios. A variação entre os tipos de documento é a primeira razão pela qual o OCR baseado em modelos falha no setor público.
| Tipo de Documento | Campos-Chave para Extração | Exigência de Conformidade Específica |
|---|---|---|
| Alvarás de Construção | Número do alvará, nome do requerente, endereço do imóvel, valor, data de emissão, data de validade | Referências ao código municipal, aplicabilidade da tabela de taxas |
| Petições Judiciais / Pautas | Número do processo, nomes das partes, data de protocolo, tipo de documento, juiz designado | Numeração Bates, integridade por página, conformidade com o FRCP |
| Respostas a Pedidos FOIA | Número do pedido, nome do solicitante, data de recebimento, códigos de isenção aplicados, data da resposta | Rastreamento de isenções (b)(1)-(b)(9), códigos de ocultação conforme diretrizes do NARA |
| Boletins de Ocorrência Policial | Número do incidente, policial responsável, data/hora, local, partes envolvidas, acusações | Política de Segurança CJIS, ocultação de PII de vítimas/testemunhas |
| Registros de Avaliação de Imóveis | ID do lote, valor avaliado, endereço do imóvel, ano fiscal, isenções declaradas | Códigos do Sistema de Contabilidade Uniforme Estadual, conformidade com GASB |
| Contratos com Fornecedores / Compras | Número do contrato, nome do fornecedor, valor da adjudicação, prazos, cláusula de renovação | Lei de licitações públicas, retenção de tabelas de propostas |
| Registros Civis | Número da certidão, nome do registrado, data do evento, jurisdição | Leis estaduais específicas de privacidade, níveis de acesso restrito |
| Solicitações de Subsídios | Número do subsídio, organização requerente, valor da adjudicação, período de execução | Conformidade com 2 CFR 200, requisitos de auditoria única |
Cada tipo de documento vem de um departamento diferente, muitas vezes de um sistema de software ou formulário de papel distinto, e segue sua própria convenção de layout. O pedido de licença de casamento de um escrivão municipal não tem semelhança estrutural com o boletim de ocorrência de um xerife. O desafio central do OCR governamental não é reconhecer caracteres em uma página — é mapear formatos de documentos diversos e inconsistentes em uma estrutura de dados unificada que possa alimentar um sistema de gerenciamento de registros.
Redação e OCR — Por Que a Ordem Importa
A FOIA exige que as agências divulguem registros responsivos com informações isentas redigidas. Os códigos de isenção — (b)(1) a (b)(9) para agências federais — abrangem desde segurança nacional (b)(1) até informações geológicas sobre poços (b)(9), sendo os mais comuns (b)(6) privacidade pessoal e (b)(7) aplicação da lei. Uma única resposta FOIA pode exigir dezenas ou centenas de redações individuais em milhares de páginas.
Esta é a sequência técnica que muitos planos de digitalização governamental erram:
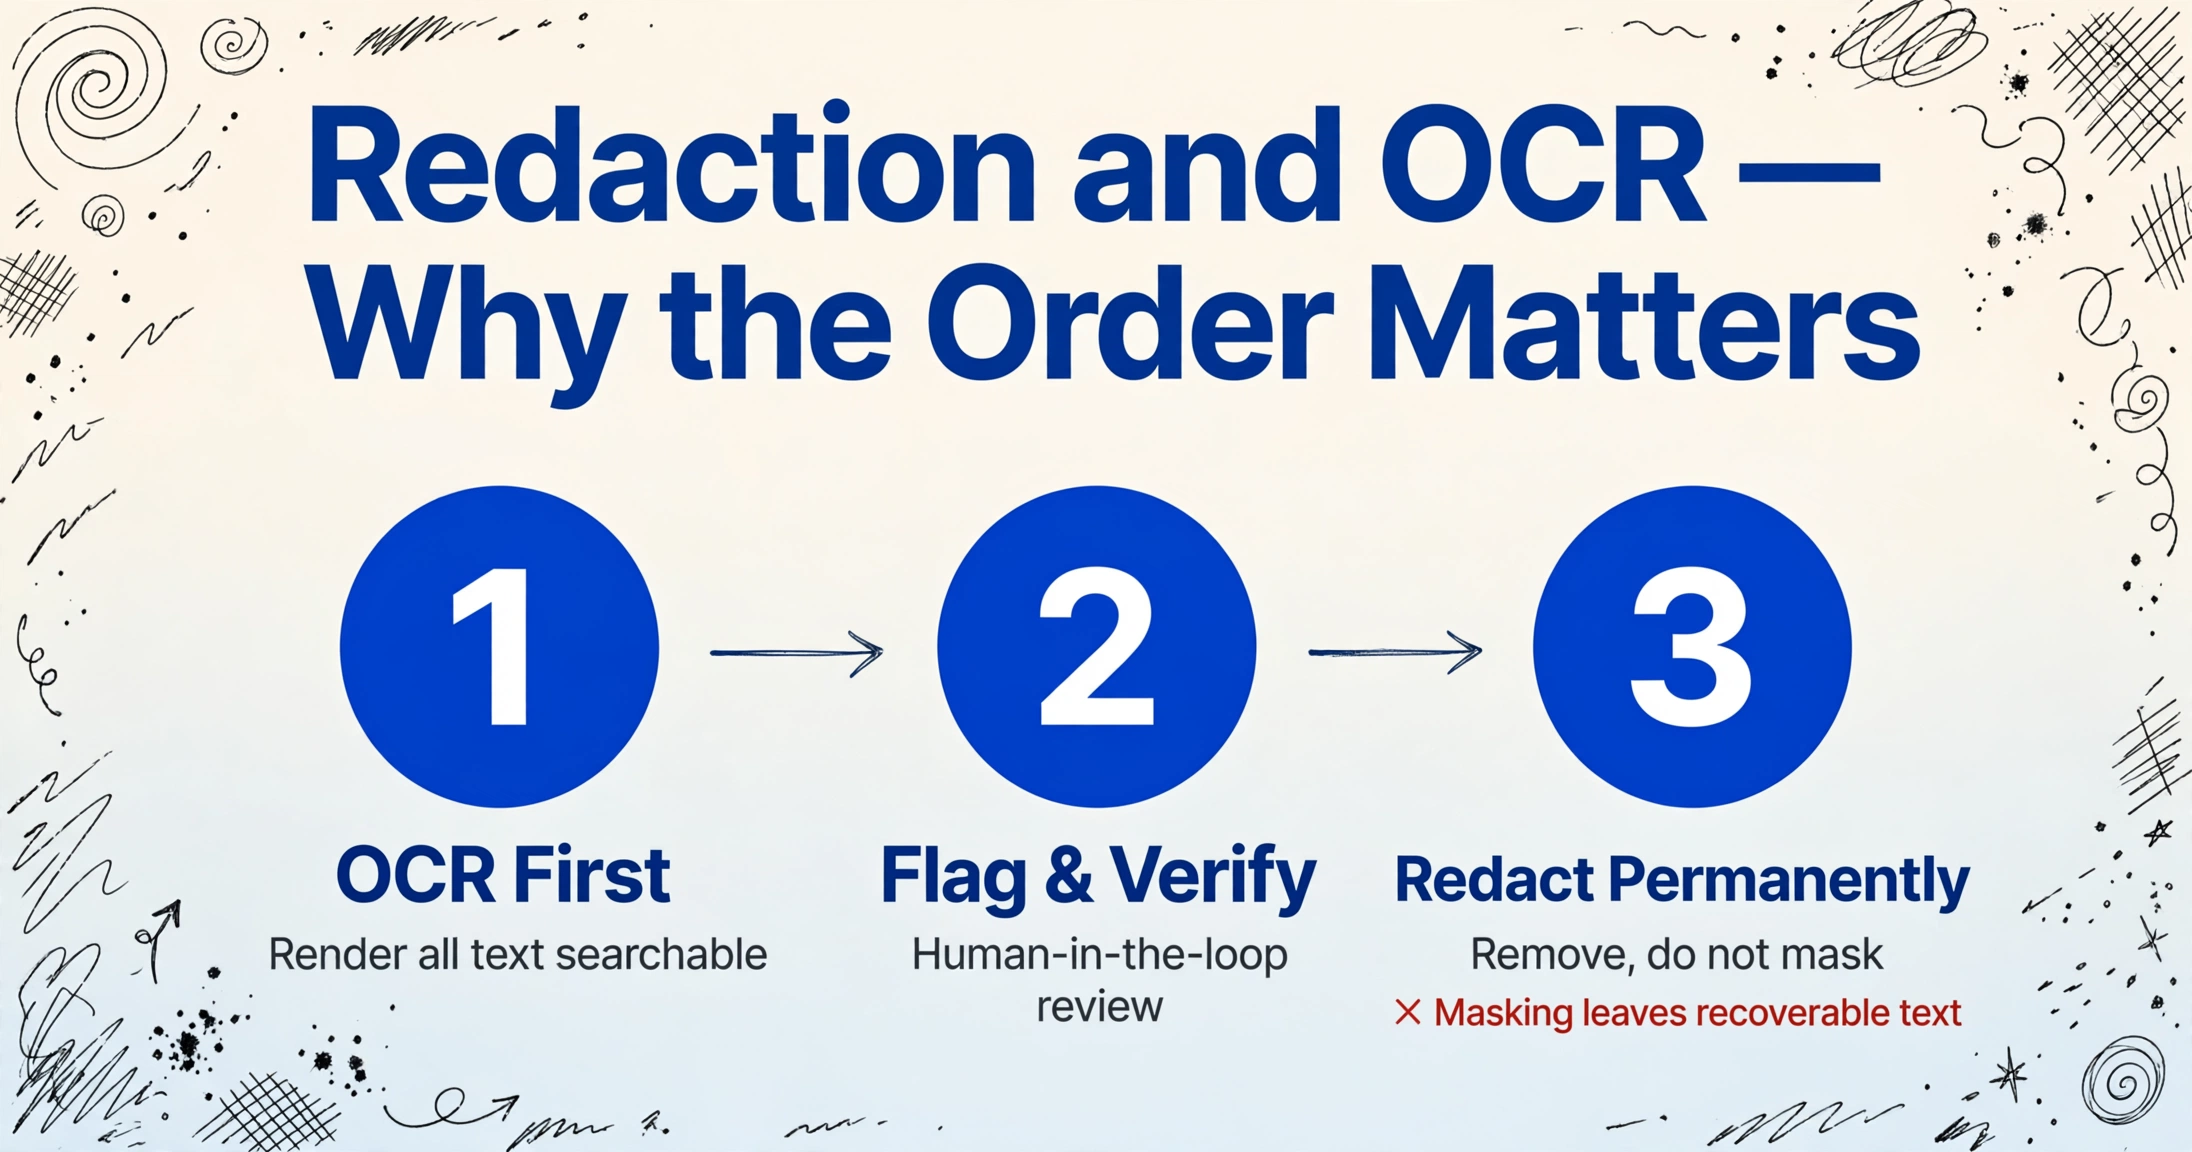
Antes que qualquer ferramenta de redação possa identificar PII — números de seguro social, datas de nascimento, nomes de menores, números de contas financeiras — o documento deve ter uma camada de texto legível por máquina. É aqui que o OCR com IA com capacidade de Reconhecimento de Entidades Nomeadas (NER) agrega valor: ele pode sinalizar automaticamente entidades sensíveis candidatas em milhares de páginas, reduzindo a superfície de busca manual de 100% para um subconjunto revisado.
A IA sinaliza PII potencial; um revisor treinado confirma cada sinalização. Isso não é totalmente automatizável — decisões dependentes de contexto (este "João Silva" é um funcionário público cujo nome deve ser divulgado, ou uma testemunha cuja identidade deve ser protegida?) exigem julgamento humano. A etapa de revisão produz uma lista de redações verificada.
A redação permanente remove o texto subjacente de todas as camadas — texto visível, texto oculto, metadados e anotações. Sobreposições de caixa preta ou coberturas de destaque não são redação; o texto abaixo permanece extraível. A saída deve ser um PDF limpo, sem conteúdo recuperável. A Lei de Governo Eletrônico de 2002 e os regulamentos da FOIA exigem esse nível de rigor.
O documento divulgado deve permanecer navegável e pesquisável para o solicitante. As porções não isentas mantêm sua camada de texto OCR. É aqui que a sequência correta importa: se você aplicar OCR após a redação, as áreas redigidas são permanentemente excluídas. Se você aplicar OCR antes da redação, mas não higienizar a camada OCR, poderá vazar conteúdo redigido na camada de texto.
A conclusão prática: o OCR deve ser aplicado cedo o suficiente para permitir a detecção automatizada de PII, mas a camada de saída do OCR deve ser permanentemente removida das regiões redigidas no documento final. Nem todas as ferramentas de OCR lidam corretamente com essa etapa de higienização. Ao avaliar soluções de OCR governamentais, pergunte especificamente se a ferramenta remove camadas de texto de regiões redigidas — não apenas se ela consegue "redigir" com caixas pretas.
PDF/A e Requisitos de Arquivamento de Longo Prazo
A Subparte E do 36 CFR § 1236 da NARA exige que registros permanentes digitalizados atendam a padrões específicos de formato e qualidade. O padrão mais relevante para preservação de documentos é o PDF/A — uma versão do PDF padronizada pela ISO, projetada para arquivamento de longo prazo. Diferentemente dos PDFs comuns, que podem depender de fontes externas, imagens vinculadas ou recursos específicos de software que se degradam com o tempo, o PDF/A incorpora tudo o que o arquivo precisa: fontes, perfis de cores, metadados e instruções de renderização independentes de dispositivo.
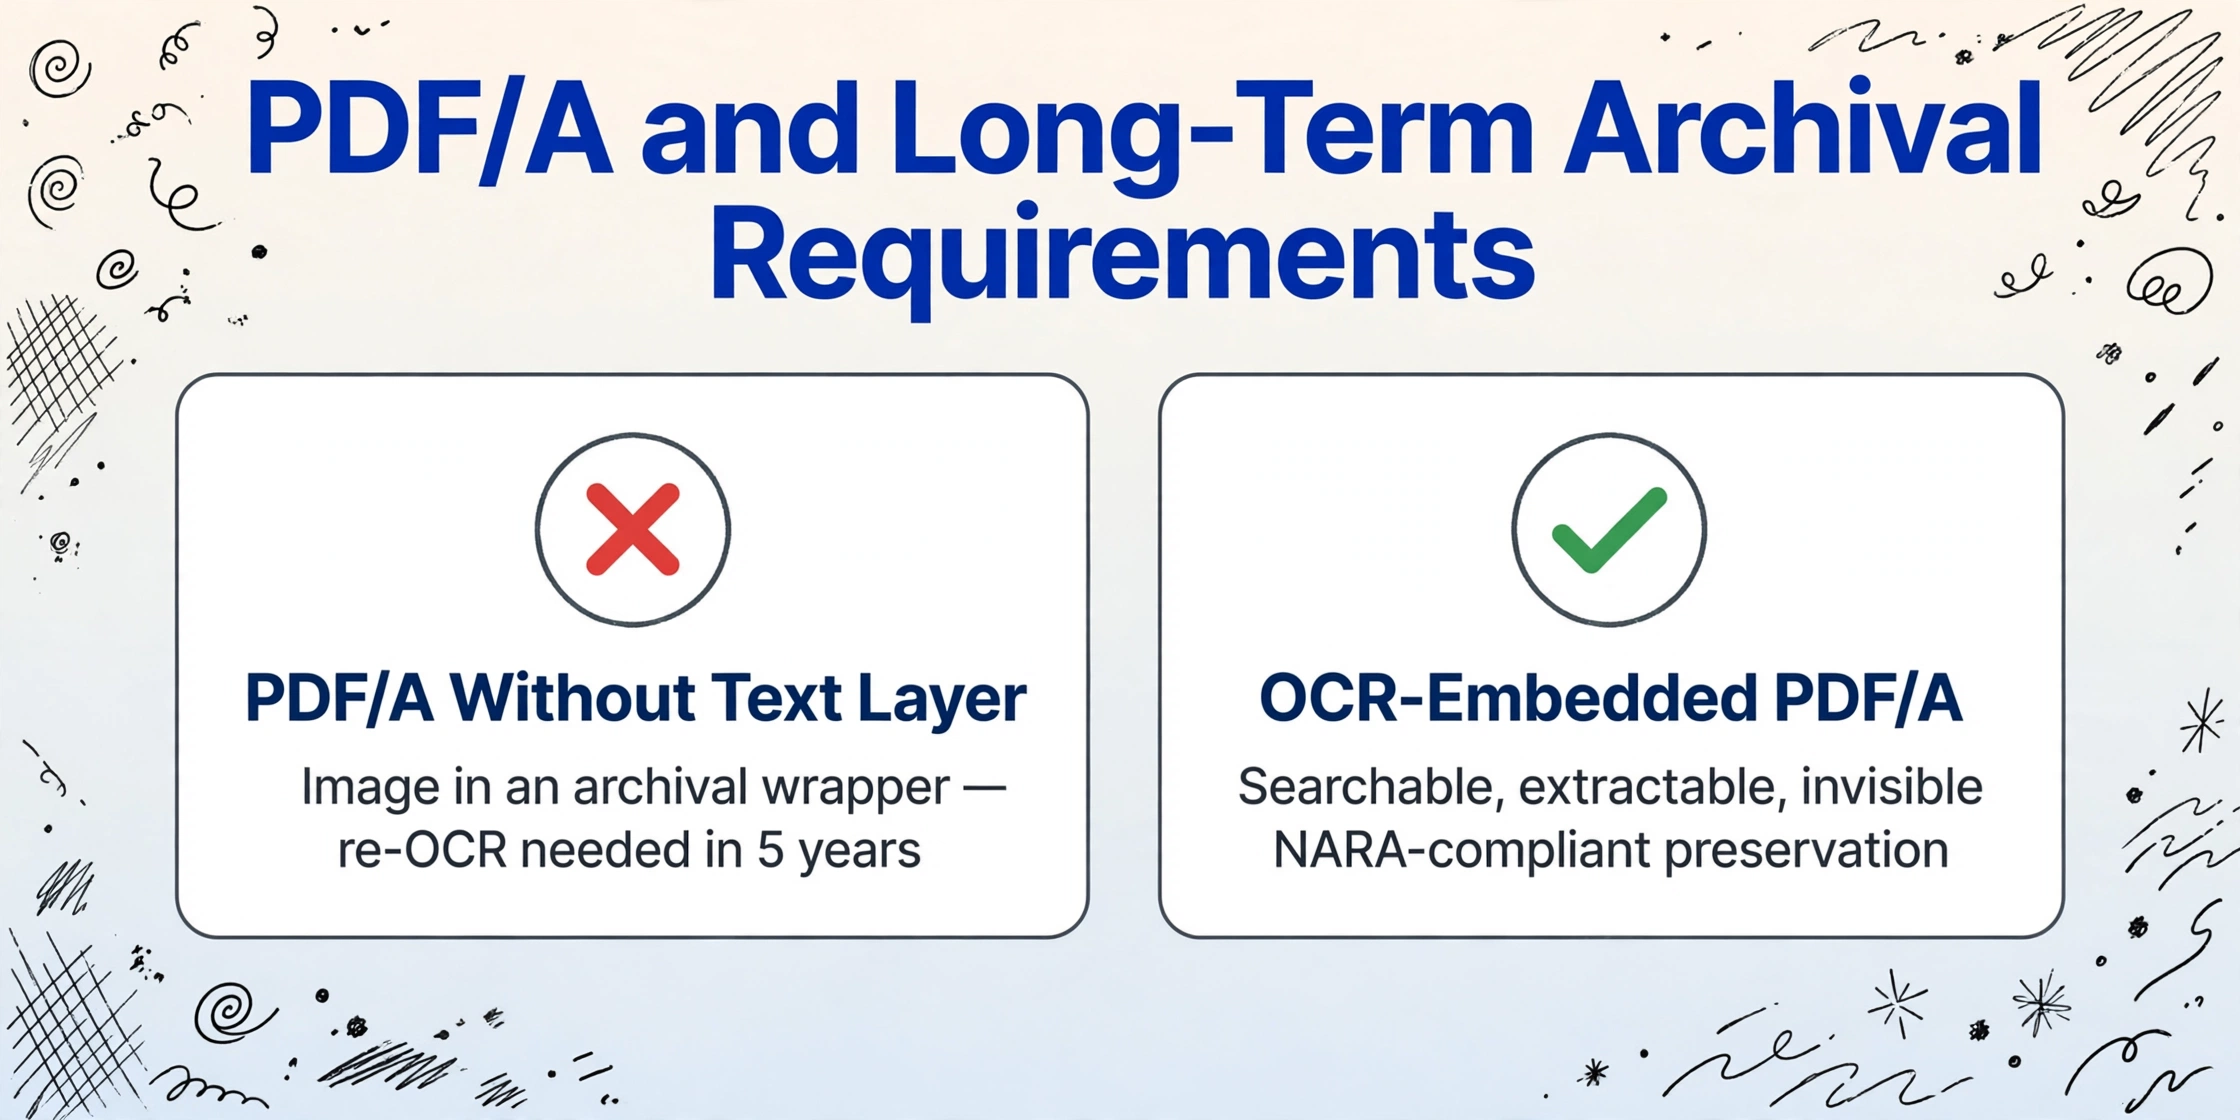
Para agências governamentais, o PDF/A não é opcional para registros permanentes. A Iniciativa de Diretrizes Digitais de Agências Federais (FADGI) define os parâmetros de implementação, e a orientação de transferência da NARA especifica que registros permanentes digitalizados devem estar em conformidade. Mas aqui está a interseção com o OCR: um arquivo PDF/A sem uma camada de texto reconhecida é uma imagem em um invólucro de arquivamento. Ele passa no teste de formato, mas falha no teste de usabilidade. Quando uma solicitação FOIA chegar daqui a cinco anos para esse registro, a equipe precisará refazer o OCR do documento inteiro do zero, porque a camada de texto OCR de 2026 não foi preservada.
A abordagem correta é o PDF/A com OCR incorporado: o texto reconhecido é armazenado como uma camada oculta dentro do próprio arquivo PDF/A — pesquisável, extraível, mas invisível para o visualizador. Isso preserva tanto a integridade arquivística da imagem bitonal quanto a funcionalidade de pesquisa do texto. Qualquer fluxo de trabalho de OCR governamental que não produza PDF/A com camadas de texto incorporadas está criando um acúmulo futuro de solicitações FOIA, porque toda solicitação futura exigirá o reprocessamento dos mesmos documentos.
Ao selecionar uma solução de OCR para uso governamental, confirme que a saída suporta conformidade com PDF/A-1 ou PDF/A-2 com camadas de texto OCR incorporadas. O PDF/A-2 oferece melhor compressão e suporte a gráficos avançados, o que importa para documentos que contêm fotografias, mapas ou assinaturas digitalizadas junto com texto.
Variação de Formato Entre Agências — Por Que Modelos Falham
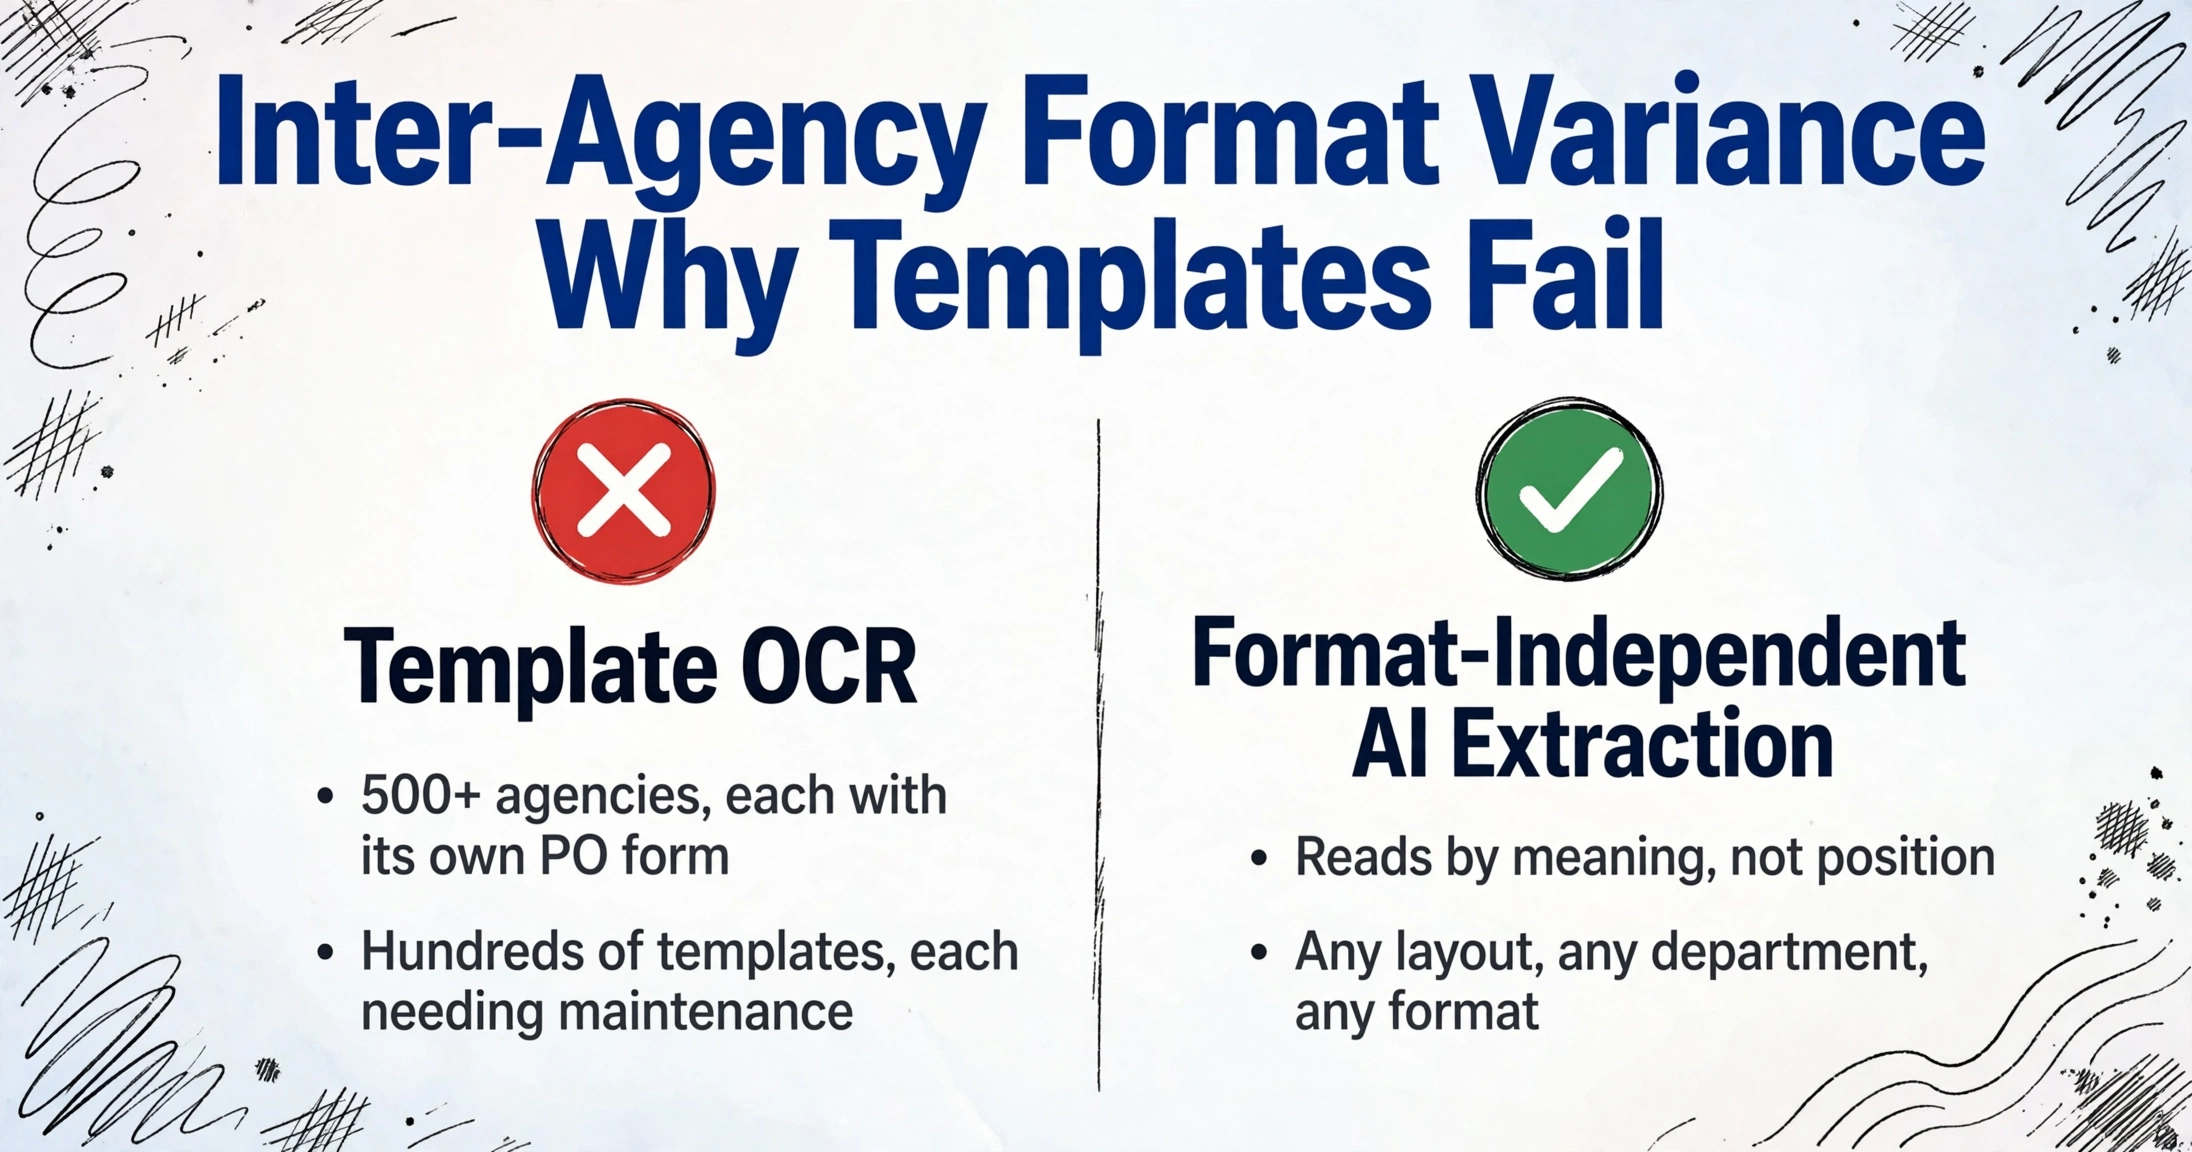
OCR baseado em modelo — a abordagem usada por plataformas tradicionais de IDP — exige um modelo de extração pré-construído para cada layout de documento exclusivo. O usuário desenha zonas ao redor de cada posição de campo, atribui um rótulo e implanta o modelo. Quando o próximo fornecedor envia um formulário ligeiramente diferente — fonte diferente, ordem de colunas diferente, terminologia de rótulos diferente — o modelo quebra e exige retrabalho manual.
Agências governamentais enfrentam esse problema em escala. Considere um único escritório estadual de compras que processa ordens de compra de mais de 500 agências, cada uma com seu próprio formulário de OC. Ou um escrivão de condado recebendo petições judiciais de 15 câmaras de juízes diferentes. Ou um escritório municipal de FOIA gerenciando solicitações que abrangem departamentos de polícia, planejamento, finanças, obras públicas e parques — cada um com seus próprios formatos de registro. OCR baseado em modelo exigiria centenas ou milhares de modelos individuais, cada um precisando de manutenção quando os formulários são atualizados.
Extração independente de formato — onde a IA lê documentos por compreensão semântica, não por posição — elimina o gargalo dos modelos. Em vez de mapear onde os dados estão na página, você define quais dados precisa: número de licença, nome do solicitante, avaliação, data de validade. A IA localiza esses valores em qualquer layout, de qualquer departamento, em qualquer formato. Essa abordagem espelha como o gerenciamento de registros governamentais realmente funciona: as categorias de dados são estáveis entre agências (toda licença tem um número de licença), mas a apresentação visual dessas categorias varia enormemente. O mesmo desafio de variação de formato aparece no processamento de documentos bancários, onde instituições financeiras precisam lidar com formatos de extratos de centenas de bancos diferentes.
Essa é a mesma mudança de paradigma que o OCR com IA traz para a compreensão de documentos de forma mais ampla — passando do reconhecimento baseado em posição para a extração baseada em semântica. Para agências governamentais gerenciando registros de dezenas de fontes, essa mudança não é uma atualização de conveniência; é a diferença entre um projeto que escala e um que exige equipe permanente de manutenção de modelos.
Conformidade de Acessibilidade ADA e WCAG
O Título II da Lei de Americanos com Deficiências exige que os serviços de governos estaduais e locais — incluindo registros digitais — sejam acessíveis a pessoas com deficiências. O Departamento de Justiça reforçou isso por meio do padrão Web Content Accessibility Guidelines (WCAG) 2.1 Nível AA, que se aplica a documentos e registros digitais fornecidos ao público.
Para OCR no governo, isso significa três entregas específicas:
Um documento digitalizado sem OCR é uma imagem. Leitores de tela (JAWS, NVDA, VoiceOver) não conseguem interpretar texto baseado em imagem. A camada de texto do OCR deve ser incorporada como conteúdo PDF com tags — não apenas como uma sobreposição oculta — para que a tecnologia assistiva possa lê-la em ordem lógica de leitura.
Documentos governamentais frequentemente têm múltiplas colunas (petições judiciais, relatórios legislativos, solicitações de subsídios). O OCR tradicional frequentemente concatena colunas em um único fluxo de texto — coluna 1 linha 1, coluna 2 linha 1, coluna 1 linha 2 — tornando a saída ininteligível para um leitor de tela. O OCR com IA que entende o layout da página preserva a ordem lógica de leitura.
Tabelas, caixas de seleção (comuns em formulários governamentais) e linhas de assinatura exigem anotações com tags para serem acessíveis. A detecção automatizada desses elementos — e a conversão em estruturas PDF com tags — não é um recurso padrão de OCR. Modelos de visão por IA podem identificar tabelas e campos de formulário ao compreender o que são, tornando possível a marcação automatizada de uma forma que o OCR em nível de caractere não consegue alcançar.
A acessibilidade ADA não é uma preocupação secundária no OCR governamental. A capacidade básica do OCR tradicional — reconhecer caracteres e gerar texto — não produz documentos acessíveis. Produzir saída em conformidade com WCAG 2.1 AA exige um nível mais alto de compreensão de documentos que inclui análise de layout, marcação semântica e preservação da ordem de leitura. Agências que não considerarem isso na fase de aquisição podem descobrir que todo o seu repositório digitalizado está inacessível e exige correção dispendiosa.
Cadeia de Custódia e Prontidão para Auditoria
Registros governamentais digitalizados devem ser comprovadamente autênticos e inalterados. A FOIA, as Regras Federais de Evidência e as leis estaduais de registros públicos exigem que as agências possam comprovar que um registro digital é o que afirma ser — que foi criado a partir do documento original em papel em um momento específico, por um operador autorizado, e não foi modificado desde a captura.
Esse requisito de cadeia de custódia tem implicações concretas para fluxos de trabalho de OCR:
- Imagem de origem imutável: A imagem digitalizada original deve ser preservada como mestre bitonal, separada de qualquer processamento de OCR. O OCR deve operar sobre uma cópia, sem alterar o original.
- Registro de processo: Toda operação de OCR — quando foi executada, qual versão de software, quais configurações, qual saída foi gerada — deve ser registrada e retida. Esses metadados sustentam a alegação de autenticidade se o registro for contestado.
- Verificação de checksum: Hashes criptográficos (SHA-256) da imagem de origem e da saída do OCR devem ser calculados e armazenados. Qualquer verificação futura pode comparar os hashes para confirmar que nenhuma modificação não detectada ocorreu.
- Controle de versão para divulgações com redação: Quando um oficial de FOIA divulga um documento com redação, a agência deve reter tanto o original sem redação (com cadeia de custódia) quanto um registro do que foi redigido e sob qual código de isenção. A camada de texto do OCR na versão divulgada deve ser verificada para garantir que não contenha nenhum conteúdo redigido.
A maioria das ferramentas comerciais de OCR não é projetada com esses requisitos de auditoria em mente. Agências governamentais devem buscar soluções que ofereçam acesso em nível de API aos registros de processo, suporte à geração de checksum e permitam que o fluxo de trabalho de OCR seja integrado a um sistema mais amplo de gestão de registros que gerencie o rastreamento da cadeia de custódia.
Para contextos legais — particularmente OCR aplicado a documentos legais e petições judiciais — os requisitos de cadeia de custódia são ainda mais rigorosos. A Regra 34 do FRCP exige que informações armazenadas eletronicamente sejam produzidas em formato "razoavelmente utilizável". Um documento processado por OCR cuja camada de texto possa ser comprovadamente gerada a partir de uma imagem de origem verificada, por meio de um processo auditado, atende a esse padrão. Um documento cuja origem não possa ser rastreada pode ser contestado.
Para agências que gerenciam processamento entre departamentos ou precisam consolidar a recepção de documentos de fontes externas, ferramentas como o Link de Coleta — que geram um link de upload compartilhável para que terceiros enviem arquivos diretamente para uma fila de processamento — ajudam a manter uma cadeia de custódia limpa ao centralizar o ponto de recepção e eliminar anexos de e-mail ad-hoc ou transferências via USB.
Perguntas Frequentes
A saída processada por OCR atende aos padrões de digitalização do NARA para registros permanentes?
Sim, desde que a saída esteja em conformidade com os requisitos da Subparte E do 36 CFR § 1236. Isso significa que a imagem digitalizada deve atender aos padrões de qualidade FADGI, os campos de metadados especificados na regulamentação devem ser capturados no nível do arquivo ou item e, se o OCR for usado, a camada de texto deve ser incorporada adequadamente. O NARA não exige OCR para registros permanentes, mas as agências que optarem por usá-lo devem seguir as orientações de transferência atualizadas sobre o uso apropriado da tecnologia OCR. O ponto principal é que a saída do OCR não substitui a imagem bitonal original — ela a complementa como uma camada pesquisável.
Posso redigir um documento após o OCR ou preciso executar o OCR novamente?
Você deve executar o OCR no documento antes da redação, usar a camada de texto para identificar e sinalizar PII para revisão, aplicar a redação permanente que remove tanto o conteúdo visível quanto a camada de texto subjacente nas áreas redigidas e, em seguida, verificar se nenhum texto recuperável permanece nas regiões redigidas. Aplicar o OCR após a redação significaria que o conteúdo redigido nunca foi pesquisável para detecção automatizada — o que prejudica o ganho de eficiência do uso de OCR no processamento de FOIA. Se você estiver trabalhando com documentos que já foram redigidos incorretamente (por exemplo, com sobreposições de caixa preta que deixam o texto recuperável), a redigitalização do documento físico redigido e a aplicação de OCR à nova digitalização às vezes é o caminho de remediação mais seguro.
O OCR é um requisito para conformidade com a ADA em documentos governamentais?
Não explicitamente por lei, mas na prática sim. A conformidade com WCAG 2.1 AA exige que o conteúdo não textual tenha uma alternativa textual. Uma página PDF digitalizada como imagem não contém texto que um leitor de tela possa acessar. O OCR é a única maneira prática de criar essa camada de texto. No entanto, apenas o OCR básico — mesmo com alta precisão — não garante a conformidade com a ADA. A saída também deve preservar a ordem de leitura lógica, marcar tabelas e campos de formulário corretamente e manter a estrutura do documento. O OCR com IA e compreensão de layout tem significativamente mais chances de produzir uma saída compatível com WCAG do que o OCR tradicional em nível de caractere.
Como o OCR lida com documentos de múltiplas agências com diferentes layouts de formulários?
O OCR tradicional baseado em modelo exige um modelo separado para cada layout exclusivo — algo impraticável quando uma agência recebe documentos de centenas de fontes. A extração de IA independente de formato resolve isso: você define os campos de dados necessários (número de licença, nome do requerente, data de emissão etc.) e a IA os localiza em qualquer layout ao compreender o significado semântico de cada campo. Sem modelos, sem treinamento por tipo de formulário. Essa é a mesma tecnologia usada para extração de documentos legais em diferentes formatos de tribunais, onde existem desafios semelhantes de variação de formato.
Qual precisão devo esperar do OCR em registros governamentais?
Em documentos limpos e datilografados — formulários impressos, relatórios digitados, registros gerados por computador — o OCR moderno com IA alcança 95-99% de precisão em nível de campo para campos de extração bem definidos. A precisão cai em formulários manuscritos (85-95% para letra de forma, menor para cursiva), páginas de formulários com carbono (comuns em registros governamentais mais antigos), originais danificados ou desbotados e documentos com carimbos ou selos sobrepostos ao texto. Para registros permanentes que exigem fidelidade de 100% — como registros vitais (certidões de nascimento/óbito) — recomenda-se uma etapa de verificação humana após a extração por IA. O Guia de Gestão de Qualidade do Arquivo Nacional para digitalização fornece uma estrutura para taxas de erro aceitáveis com base no tipo de registro.
O OCR pode lidar com processamento em lote para grandes respostas a solicitações FOIA?
Sim — o processamento em lote é essencial para o trabalho com FOIA, pois solicitações individuais rotineiramente abrangem centenas ou milhares de páginas. Plataformas de OCR com IA que suportam fluxos de trabalho prioritários em lote podem ingerir múltiplos documentos simultaneamente, aplicar regras de extração consistentes em todas as páginas e mesclar as saídas em um único arquivo estruturado. Isso é significativamente mais eficiente do que processar cada documento individualmente, especialmente quando a mesma solicitação FOIA abrange registros de vários departamentos com formatos diferentes. A principal capacidade a se buscar é a consolidação de saída em nível de lote: uma solicitação FOIA deve produzir uma saída pesquisável, não uma pasta de arquivos individuais.