銀行明細データをExcelに抽出する方法
— 従来のOCRが失敗する理由とAIがどう解決するか
請求書の抽出は、ほとんどのデータツールにとって解決済みの問題です。請求書は、ベンダー名、金額、日付といった個別のラベル付きフィールドを持つ1ページのドキュメントであり、各フィールドはそれぞれの枠内にあります。銀行明細はその逆です。複数ページにわたる取引明細表であり、各行はその上の行に依存し、現在残高は1ページ目から12ページ目まで連続している必要があります。また、抽出が正しいことを検証する唯一の方法は、会計における最も古いテスト、つまり「期首残高 + 貸方 − 借方 = 期末残高」が成立するかどうかです。ツールが1行を落としたり、列を1行ずらしたりすると、明細はもはや照合できなくなり、出力は役に立たないどころか、正しく見えて計算が合わないという最悪の結果になります。ラベル付きフィールドの抽出と、連続した取引台帳の保持との間のこの違いこそ、ほとんどのOCRが銀行明細で失敗する点であり、セマンティックAI抽出が根本的に異なるアプローチを取る点です。
重要なポイント
- 銀行明細における実際の抽出障壁は文字精度ではなく、複数ページの取引明細表がリンクリストであり、1行でもずれると照合が崩れることです。文字がどれだけ正確に読み取られても関係ありません。
- 12ページの業務明細では、ページヘッダーと小計が各ページに繰り返し表示されます。147行の取引明細表が160行のExcelファイルになり、13行の構造ノイズが実際のデータと区別できなくなります。
- 抽出がピクセル座標ではなくドキュメント構造を読み取る場合、出力は検証済みの台帳となり、期首残高 + 貸方 − 借方 = 期末残高が、会計システムに入る前に証明されます。
銀行明細書が請求書よりも構造的に難しい理由
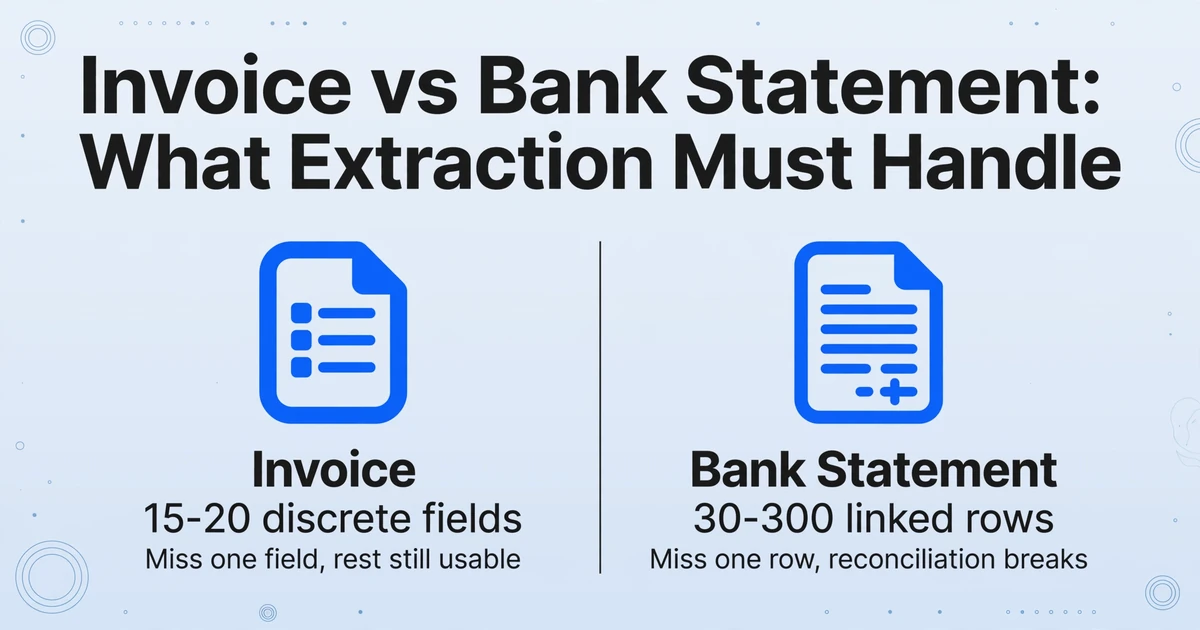
銀行明細書はフィールドの集合ではない — それは時系列の台帳であり、各行の位置が重要で、計算が一致しなければならない。請求書と同じように扱うことが、ほとんどの抽出失敗の根本原因である。
請求書には、1ページのラベル付き領域に分散した15〜20のデータポイントがある。ここに請求書番号、そこに支払期日、下部に合計金額。これらは個別フィールドであり、抽出は検索して取得する操作である。ツールが1つのフィールドを見逃しても、1つの情報を見逃すだけである。出力の残りはまだ使用可能である。
銀行明細書はまったく異なるデータ構造である。そこには取引明細表が含まれており、通常は月あたり30〜300行で、各行には日付、説明、借方または貸方の金額、現在残高がある。47行目の残高列は46行目の残高に依存し、46行目は45行目に依存し、期首残高まで遡る。これは印刷されたテーブルとして表現されたリンクリストデータ構造である。ツールが1行を見逃したり、列を1つずらしたりすると、計算チェーンが壊れ、照合全体が失敗する — 単なる1フィールドの問題ではない。投資明細書は、取引行の上に保有テーブルを重ね、数量・価格・時価評価額が各行内で整合している必要がある — これは列命名が銀行固有のテンプレートなしで読み取る構造である。
さらに、銀行明細書は複数ページにまたがることが一般的であり(月次事業用口座では多くの場合3〜12ページ)、取引明細表がページ途中で繰越小計とともに途切れることもある。これらを考慮すると、銀行明細書の抽出が根本的に異なる問題であることがわかる。「より高度なOCR」ではない。これはフィールド抽出ではなく、継続的な台帳再構築という別のクラスの抽出である。
さらに複雑なのは、銀行明細書フォーマットの多様性である。世界中に数千種類もの異なる銀行明細書レイアウトが存在すると推定されている — 米国のChaseやBank of Americaから、英国のHSBCやBarclays、ドイツのDeutsche Bank、ブラジルのCaixaまで。各銀行は取引列の配置が異なり、借方と貸方に異なる用語を使用し、異なるページレベルの書式を適用している。ある銀行のPDFで機能するテンプレートベースのツールは、別の銀行の明細書にはまったく新しいテンプレートが必要である。複数の銀行の顧客を扱う会計事務所にとって、これは一般的なフォーマットをカバーするだけで数十のテンプレートを維持することを意味し、銀行が明細書デザインを更新するたびに別のテンプレートが壊れる。
初めてこれに遭遇するほとんどの人は、解決策はより優れたOCR — より高い文字レベルの精度 — だと思い込む。しかし、本当の問題は文字を読むことではない。問題はどの文字が取引行を構成し、どの文字がヘッダーを構成し、どの文字が残高を構成し、それらがページをまたいでどのように接続されているかを理解することである。それは光学認識ではない。それはドキュメント理解である。
汎用OCRが銀行明細書で間違える点
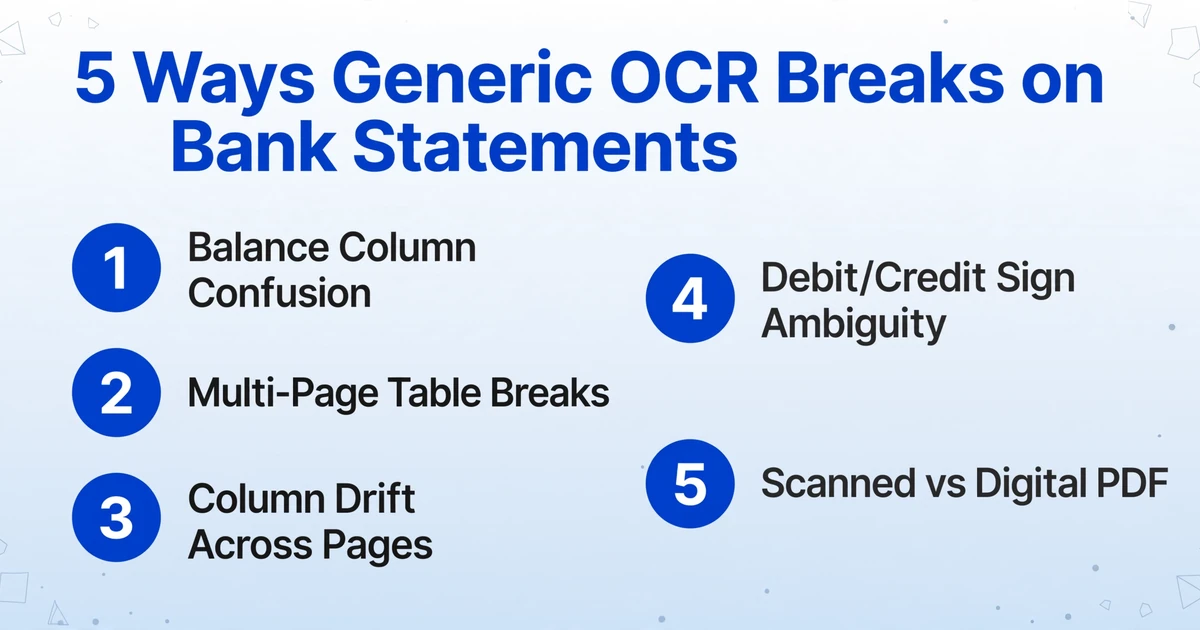
汎用OCRはページ上のすべての文字を均等に読み取ります。取引金額と現在残高とページヘッダーを区別できません。銀行明細書の場合、最初の行から構造的なノイズがExcel出力に混入することになります。
銀行明細書のPDFを標準的なOCRやAdobeの内蔵エクスポートのようなPDFからExcelへの変換ツールに通すと、おおよそ正しい文字がおおよそ正しい位置に配置された結果が得られます。しかし「おおよそ正しい位置」は、銀行明細書では次の5つの点で崩れます。
1. 残高列の混乱。 現在残高の列は、OCRにとっては単なる数値列のひとつに見えます。OCRエンジンは、N行目の残高が導出値であることを理解しません。つまり、前の残高にN行目の取引金額を加算または減算した結果であるべきものであり、独立して抽出される数値ではありません。明細書が4列構成(日付|説明|借方|貸方|残高)の場合、OCRは残高値を借方・貸方の列に統合したり、その逆を行ったりすることがよくあります。結果として得られるスプレッドシートは一見すべてのデータが揃っているように見えますが、数字が合いません。そしてユーザーは、最初から手入力するよりも抽出結果の修正に多くの時間を費やすことになります。これはr/Bookkeepingで簿記担当者が述べたとおりです。「銀行明細書のPDFはExcelにきれいに変換されますか?私の場合は変換されません…」
2. 複数ページにわたるテーブルの断裂。 6ページの銀行明細書は、ページをまたいで続くひとつの取引明細表です。ページ区切りにより、繰り返しの列ヘッダー(「日付|説明|借方|貸方|残高」)、ページ番号、そして繰り越し小計行が挿入されます。OCRは各ページを独立したテーブルとして扱います。その結果、ヘッダー行と小計行が取引行の間に混在し、行の順序が崩れ、データが汚染されます。実際の取引が147件だった明細書が、Excelでは160行以上になることがあります。そのうち13行は取引データを装ったページヘッダーと小計です。
3. ページ間の列ずれ。 同じ銀行内でも、取引の列はページごとに位置が変わることがあります。1ページ目では「残高」列がないため(期首残高として上部にのみ表示)、説明列がページ幅の60%を占めることがあります。2ページ目では現在残高が5番目の列として追加され、説明列の幅は40%に圧縮されます。固定の列座標を使用するOCR(ゾーンOCR)は、列がずれた後のすべての行を誤読します。説明があるべき場所に口座番号が抽出されたり、取引金額があるべき場所に残高金額が抽出されたりします。
4. 借方・貸方の符号の曖昧さ。一部の銀行では、借方と貸方を別々の列に分け、それぞれ正の数値で記載します。別の銀行では、1つの金額列に借方の場合は負の数値で記載します。さらに別の銀行では、1つの金額列で借方に「Dr」、貸方に「Cr」の接尾辞を付ける方式もあります。OCRはこれらを会計エントリではなくテキスト文字列として読み取ります。そのため、照合を開始する前に、「500.00Dr」を-500.00に変換する、または2つの列を1つの符号付き列に統合するといった手動でのクリーンアップが必要になります。AICPAの2025年業務効率ベンチマークによると、平均的な会計事務所は銀行取引の照合にクライアント1社あたり月11.3時間を費やしており、その時間の78%が、予測可能で自動化可能なパターンに従う取引マッチングに費やされています。
5. スキャン済みPDFとデジタルPDFの混同。デジタルPDF(銀行のシステムが直接生成)には、選択可能で機械可読なテキストがあります。スキャン済みPDF(紙の明細書を撮影またはスキャンしたもの)はテキストの画像であり、写真と変わりません。多くのPDFからExcelへの変換チュートリアルはデジタルPDFを前提としており、スキャン済み明細書では静かに失敗します。クリーンなデジタルテキスト用に設計されたOCRエンジンは、折りたたまれた紙の明細書の150dpiスキャンでは意味不明な出力を生成します。それでもスキャン済み明細書は一般的なままであり、28のアップボートが付いた最近のr/Accountingスレッドでは、「何でもスキャン済みPDFで送ってくる」クライアントの現実が今も続いていることが議論されています。
AI抽出による銀行明細書の読み取り方の違い
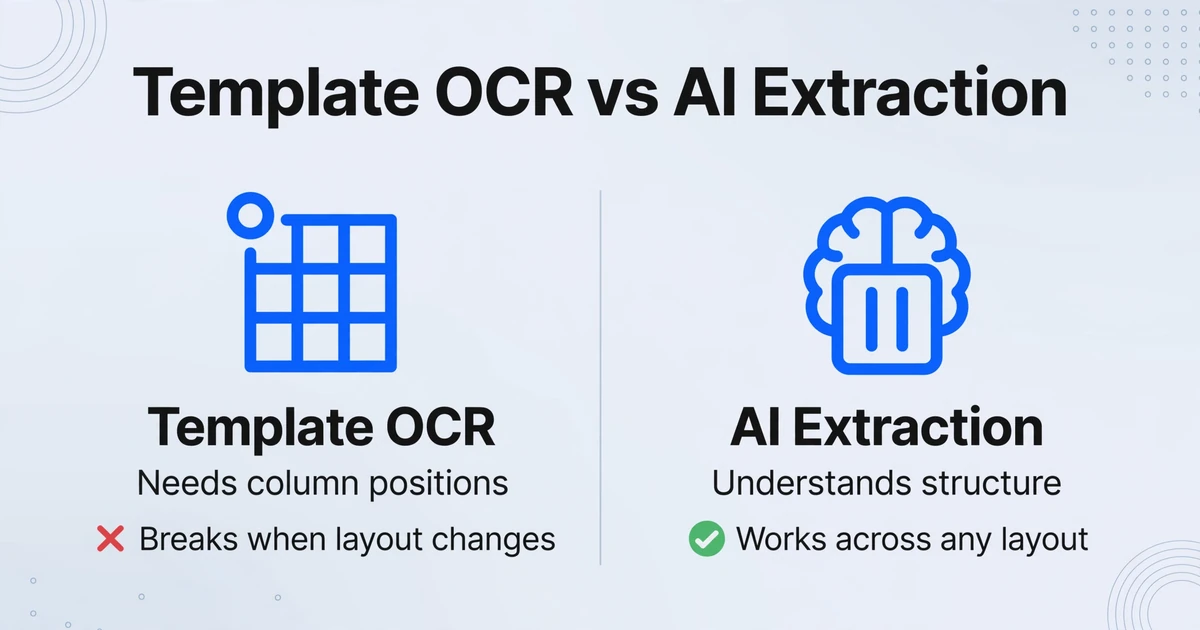
OCRからAI抽出への根本的な移行は、文字を読むことから文書構造を理解することへの移行です。つまり、残高列が単なる数値列ではなく、取引行が単なるテキスト行ではないことを認識することです。
従来のOCRは「これらの座標にある文字は何か」という1つの問いに答えます。AI抽出(特に大規模ビジョンモデルによるもの)は、「この文書には何が含まれ、どのように構成されているか」という別の問いに答えます。
これは、位置ベースの抽出と意味ベースの抽出の違いです。位置ベースのツール(ゾーンOCR、テンプレートベースのパーサー)は、各フィールドがページ上のどこにあるかを指定する必要があります。「取引金額は常に4列目にあり、左端から73mmの位置から始まる」といった具合です。Chaseが来四半期に明細書のレイアウトを変更したり、まったく異なる列構成のWells Fargoの明細書を受け取ったりすると、そのテンプレートは破綻します。新しいテンプレートを作成する必要があります。
カスタム列抽出 — ImageToTable.ai の核となる仕組み — は、逆のアプローチを取ります。システムにデータがページ上のどこにあるかを伝える代わりに、必要なデータを伝えます。「取引日」「説明」「借方金額」「貸方金額」「残高」などの列名です。AI はページ全体を読み取り、どの部分がヘッダーで、どの部分が取引行で、どの部分が残高行で、どの部分がフッターかを理解し、定義した列にすべての取引行を抽出し、行の順序を最初から最後まで保持します。各銀行がどの列位置を使用するかは関係ありません。AI は座標ではなく意味を読み取ります。
これは特に現在残高にとって重要です。「残高」列を定義すると、AI はこの列が派生フィールドであることを認識します。値はそのまま抽出されますが、実際の検証は計算列(後述)によって行われ、算術を検証します。AI に印刷された残高を無視して取引金額から再計算するよう指示することもできれば、組み込みの検証が得られます。計算された残高と明細書に印刷された残高との間に不一致があれば、レビューが必要な行にフラグが立てられます。ローン返済スケジュールも同じ種類の連鎖です。各支払いの期末残高が次の支払いの期首残高にならなければならないため、1 行の読み取りミスで最終的な返済額が狂ってしまいます。
これを可能にする仕組みは、ビジョン言語モデルを OCR エンジンと根本的に異なるものにするのと同じものです。ページを文字の境界ボックスのグリッドとしてではなく、全体の視覚シーンとして処理します。「テーブルに 5 つの列があり、5 番目は現在残高で、データはページ区切りをまたいで続き、中央のセクションには取引ではない小計行がある」ことを認識します。従来の OCR はこれらを一切認識しません。ピクセルがグリッドに配置されたものとしてしか見ません。
ステップバイステップ: 銀行明細書データを Excel に抽出する
PDF の銀行明細書から、クリーンで照合可能なスプレッドシートへの道のりは 4 つのステップです。テンプレートも、銀行ごとの設定も、列位置のトレーニングデータもありません。
銀行明細書をアップロード
PDF、JPG、PNGをドラッグ&ドロップするだけ。どの銀行でも、何ページでも、デジタルでもスキャンでも対応。フォーマットの事前加工は不要です。
列を定義する
必要な列名を入力します:取引日、説明、借方金額、貸方金額、残高、参照番号/小切手番号、取引種別。これらがExcelの列ヘッダーになります。
AIがすべての取引行を抽出
AIが文書全体を読み取り、全ページにわたって取引明細表を特定し、定義した列にすべての行を抽出して行順を保持します。ヘッダー行、小計、ページフッターは自動的に除外されます。
エクスポートして照合
Excel(XLSX)またはCSVとしてダウンロード。データは構造化され、クリーンな状態で、QuickBooks、Xero、Sage、または照合用スプレッドシートにそのままインポートできます。
上記の4ステップのワークフロー(アップロード、列定義、抽出、エクスポート)は、まさに銀行明細書からExcelへの変換ツールが1回の処理で実行する内容です。テンプレートも銀行ごとの設定も不要です。ご自身の明細書で無料でお試しください:PDFをアップロードして列名を指定すれば、抽出された行が数秒で返され、照合チェックにすぐ使えます。
ファイルは安全に処理され、保存されることはありません。
このワークフローがテンプレートベースのパーサーと異なる点は、システムにデータがどこにあるかを指定する必要がなく、何を欲しいのかだけを指定する点です。これこそがテンプレート不要の所以であり、AIがレイアウトとは独立してドキュメントの構造を理解します。新しい銀行から明細書を受け取った場合でも、既存の銀行がフォーマットを変更した場合でも、再設定の必要はありません。同じ列名が、ページ上のどこに表示されていても同じデータを見つけ出します。
複数ページの明細書とバッチ処理への対応
月末の照合1回で、3つの異なる銀行からの12件のPDFが関わることもあります。バッチ処理はこれらすべてを1回の処理で扱い、明細書ごとの行順序を保持したまま、すべての取引を単一の出力スプレッドシートに統合します。
銀行明細書の抽出は、1ファイルずつ処理するだけの問題であることはまれです。Q1の帳簿を締める簿記担当者は、3ヶ月×3銀行口座=9件のPDFに直面するかもしれません。50社の簿記クライアントを担当する会計事務所は、月に200件以上の明細書を処理する可能性があります。手作業のアプローチ(各PDFを開き、各行を読み、Excelに入力する)は取引数に比例して拡張され、AICPAのデータがその結果を裏付けています:銀行照合だけで、クライアント1社あたり月11.3時間、50社の事務所ではフルタイム換算3.5名分のスタッフが必要です。
バッチファースト処理とは、複数のファイルを一度に受け入れ、それらを1つの出力テーブルに統合するように設計されたツールのことです。Chaseの1月、Chaseの2月、Chaseの3月、Wells Fargoの1月、Wells Fargoの2月、Wells Fargoの3月——6つのファイルを1つのバッチでアップロードし、6つの明細書すべての取引を含む単一のExcelスプレッドシートを受け取ることができます。各取引にはトレーサビリティのためソースファイル名がタグ付けされます。各明細書内の行順序は保持され、出力には必要に応じてソースファイル列を追加でき、どの取引がどの明細書からのものかを常に把握できます。
複数ページの明細書の場合、AIは単一のPDFの1ページ目から6ページ目が、6つの別々のテーブルではなく、1つの連続した取引明細表であることを理解します。3ページ目の28行目に表示される現在残高は、2ページ目からの取引シーケンスの継続として認識されます。各ページで繰り返されるヘッダー、ページ番号、繰り越し小計、銀行の定型文は、Excel出力に到達する前にフィルタリングされます。
ここで、バッチと複数ページの組み合わせが、手入力に対する複合的な利点を生み出します。200件の取引がある12ページの法人当座明細書は、手入力では約1時間かかりますが(1ページあたり3分の手入力として)、1ページあたり5〜10秒で処理されます。Sageの2025年会計テクノロジーレポートによると、銀行照合を自動化した事務所は処理時間を75%削減し、初回一致精度を94.2%から99.6%に向上させました。重要な洞察は単なる時間節約ではなく、人間の入力からAI抽出への移行が、最も一般的なエラーカテゴリである転記ミスを排除することです。人間が「2,847.31」を「2,487.31」と読み間違えたり、金額を誤った行に入力したりするミスです。
ダウンロードしたExcelファイルではなく、Google Sheetsで直接データを必要とする実務者のために、Google Sheetsアドオンはサイドバーインターフェースを提供し、明細書をアップロードして抽出された取引行をアクティブなシートに直接追加します——ファイルのダウンロードもインポート手順も不要です。さまざまな明細書ボリュームにわたる手入力との比較の全体像については、手入力とAIによる銀行明細書入力の比較をご覧ください。
抽出データを照合可能な状態にする
取引をExcelに取り込むことは第一歩にすぎません。取引を自動的に照合できる状態にする—期首残高+貸方−借方=期末残高を検証すること—こそが、計算列によって抽出データを検証済みデータへと変える部分です。
取引行が完璧に抽出できたとしても、照合には算術チェックが必要です。銀行明細書は期首残高と期末残高を宣言しており、その間にある全取引の合計が両者を橋渡ししなければなりません。手作業のワークフローでは、インポート後に別のExcel列で計算を行うことで対応します。AI抽出ワークフローでは、計算列を使用して抽出中に処理できます。
計算列を使用すると、AIが各明細書を処理する際に実行される計算を定義できます。銀行明細書の照合には、特に有用な計算列が2つあります。
現在残高の検証:各取引後の期待残高(期首残高+その行までの全借方・貸方の合計)を計算し、明細書に記載された残高と比較する計算列を定義できます。不一致があればフラグが立てられ、算術が崩れる行が人間によるレビューを必要とする行です。
借方・貸方の相殺:借方と貸方が別々の列になっている明細書の場合、計算列で各行の純額(貸方−借方)と全行の累計純額を計算できます。最終的な累計純額を期首残高に加えると、期末残高と一致するはずです。一致しない場合、その差額が抽出のずれがどの程度かを正確に示し、通常は誤読された特定の1〜2行を指し示します。
これらの計算チェックは、照合を行う人にとって任意のものではありません。「データが正しく見える」と「データが正しいと証明される」の違いを生むものです。公認不正検査士協会は、金融不正事件の約22%が銀行照合を通じて発見されると報告しており、算術検証のステップを省略できないことを裏付けています。
抽出と検証の後、構造化されたExcel出力は会計ソフトウェア—QuickBooks Online、Xero、Sage、NetSuite、またはCSV/XLSXインポートに対応するあらゆるプラットフォーム—に、すでにクリーン化・標準化・検証済みの取引データとして流し込むことができます。財務ドキュメント全体のワークフローで使用するツールを評価している場合は、銀行明細書抽出ツールの比較で、精度、価格、会計連携の観点から全体像を把握できます。
異なる銀行・異なる国における銀行明細書
フォーマット非依存の抽出システムは、Chaseの明細書も、Deutsche Bankの明細書も、Caixaの明細書も同じ問題として扱います。それぞれが日付、説明、金額を含む取引明細表であり、視覚的なレイアウトの違いは抽出ロジックを変えません。
テンプレートベースの抽出に伴う見えないコストのひとつが、銀行ごとのメンテナンス負担です。解析ツールが銀行フォーマットごとにトレーニングやテンプレート作成を必要とし、貴社が顧客基盤全体で15の異なる銀行の明細書を処理している場合、15の解析設定を維持することになります。いずれかの銀行が明細書のレイアウトを変更した場合(フォント変更、列の並べ替え、ロゴ位置の変更など)、テンプレートのひとつが機能しなくなります。これは、クライアントの明細書を処理しようとしたときに出力が乱れていることで気づきますが、通常は最も時間に追われる月末に発生します。
フォーマット非依存のAI抽出は、この問題を完全に回避します。銀行が2列レイアウト(日付+説明、続いて借方+貸方)を使用していても、5列レイアウト(日付+説明+借方+貸方+残高)を使用していても、現地の用語を使用した地域バリアント(フランス語の明細書では「借方」の代わりに「Retraits」、「貸方」の代わりに「Versements」)であっても、AIは構造パターンによって取引明細表を識別します。つまり、日付、テキスト説明、数値金額の繰り返しシーケンスです。そのパターン内の具体的な配置は重要ではありません。
このフォーマット非依存性は、基盤となるデータ標準が異なる国際的な明細書にも対応します。欧州の銀行は、銀行から顧客への明細書用のISO 20022 XMLフォーマットであるcamt.053形式の明細書を発行することが増えています。これは構造化された機械可読形式で、取引レベルの明示的なメタデータを含みます。しかし、多くの銀行はcamt.053ファイルに加えて、またはその代わりにPDF明細書を発行し続けており、一部の国ではISO 20022の採用まで数年かかります。ほとんどの会計チームが直面する現実は、CSVエクスポートを提供するクライアントもいれば、PDFを提供するクライアントもおり、解析できないXML明細書を転送するクライアントもいるという混在状況です。3つの形式すべてを処理できる単一のツールがあれば、形式ごとに個別の処理経路を用意する必要がなくなります。
単一国内でも、レイアウトの多様性は大きいものです。Wells Fargoのビジネス当座預金明細書は、Chaseのビジネス当座預金明細書とは異なるテーブル構造を持ち、地元の信用組合の明細書とも異なります。フォーマット非依存のアプローチでは、簿記担当者が列を一度だけ定義します(「取引日、説明、金額、残高」)。そして、どの銀行が発行したかにかかわらず、すべてのクライアントの明細書で同じ列定義を使用します。これが1年分のバッチ照合に具体的にどのように適用されるかについて詳しくは、12か月分の銀行明細書を1つのスプレッドシートにバッチ処理するガイドをご覧ください。
よくある質問
複数ページの銀行取引明細書にも対応していますか?
はい。AIは明細書をページ数に関係なく、1つの連続した取引テーブルとして読み取ります。250件の取引がある12ページの明細書も1つの単位として処理され、ページヘッダー、繰り返しの列ラベル、繰越小計、フッターテキストは自動的に識別・除外されるため、Excel出力が汚染されることはありません。行の順序は元の明細書の通り、ページをまたいで保持されます。
スキャンや撮影した銀行取引明細書からもデータを抽出できますか?
はい。視覚言語モデルはデジタルPDFだけでなく、画像からもテキストを読み取ります。フラットベッドスキャナー、スマートフォン撮影、銀行による過去の紙記録のスキャンなど、スキャンされた紙の明細書もネイティブPDFと同様に処理されます。画質は重要ですが(150dpiで傾きのあるスキャンは、300dpiのクリーンなスキャンより精度が低下します)、デジタル生成でテキスト選択可能なPDFである必要はありません。
残高欄はどのように処理されますか?
AIは明細書に表示されている残高をそのまま抽出します。ただし、印刷された残高に誤りがあったり、抽出時に数字を誤読する可能性があるため、抽出された借方・貸方金額から残高を再計算する計算列を定義することを推奨します。計算された残高が印刷された残高と一致すれば、相互検証が完了します。乖離があれば、どの行を確認すべきかが正確にわかります。これにより、残高は受動的な抽出項目から能動的な検証メカニズムへと変わります。
レイアウトの異なる複数の銀行の明細書でも使えますか?
はい — これがフォーマットに依存しない抽出の最大の利点です。Chase、Wells Fargo、Barclays、地元の信用組合の明細書はすべて、日付付き取引、テキスト説明、数値金額という同じ基本構造を共有しています。AIは列の順序、フォント、間隔、ページレイアウトに関係なく、その構造を識別します。すべての銀行で同じ列名(「取引日」「説明」「金額」)を使用します。銀行ごとのテンプレートを作成・維持する必要はありません。
銀行によって借方・貸方の表記形式が異なる場合、どのように処理されますか?
一部の銀行では、借方と貸方を別々の列に分け、両方とも正の値で表示します。別の銀行では、1つの金額列を使用し、借方には負の数値を用います。さらに別の銀行では、金額に「Dr」または「Cr」の接尾辞を付ける場合もあります。AIは明細書に存在する任意の列構造を抽出でき、必要に応じて計算列を定義し、値を単一の符号付き金額列(借方=負、貸方=正)に正規化することも可能です。これにより、各銀行の明細書の形式に関係なく、統一された出力が得られます。
銀行明細書の取引抽出の精度はどの程度ですか?
印刷された(デジタル)銀行明細書のPDFで、文字が明瞭な場合、フィールドレベルの精度は最大99%に達します。スキャンまたは撮影された明細書の場合、精度は画像品質に依存します。クリーンな300-dpiスキャンでは同様の結果に近づきますが、低解像度のスマートフォンで撮影した、しわくちゃな紙の明細書では精度は低下します。重要な安全策は照合チェックです。すべての銀行明細書には検証可能な期末残高があり、抽出された取引をそれに対して検証できるため、照合に影響を与えるような抽出エラーは、データが会計システムに入る前に残高検証ステップで検出されます。
結論
銀行明細書の抽出は、ほとんどのデータツールが別々に解決している2つの問題、すなわち正確な文字認識と構造的なドキュメント理解の交差点に位置します。OCRだけでは文字は得られますが、構造は得られません。取引行とヘッダー行を区別できず、現在残高と取引金額を区別できず、1ページ目の表と2ページ目に続く同じ表の続きを区別することもできません。テンプレートベースの解析は構造を追加しますが、銀行ごとの設定が必要となり、レイアウトが変更されると脆弱になります。
ビジョン言語モデルによるAI抽出は、これらを1つのステップに統合します。AIはドキュメント全体を読み取り、その構造を理解し、要求された内容を抽出します。行の順序を保持し、構造上のノイズを除去し、データが会計システムに到達する前に算術検証を可能にします。出力は「おおよそ正しいデータがおおよそ正しい順序で並んだもの」ではありません。明細書の期末残高と一致する取引台帳であり、照合にとって唯一重要な基準です。ご自身の銀行明細書でお試しください。
無料で開始 — クレジットカードは不要です