Cómo extraer datos de estados de cuenta bancarios a Excel
— por qué el OCR tradicional falla y cómo la IA lo soluciona
La extracción de facturas es un problema resuelto para la mayoría de las herramientas de datos. Una factura es un documento de una página con campos etiquetados y discretos — nombre del proveedor, importe, fecha — cada uno en su propia casilla. Un estado de cuenta bancario es lo contrario: una tabla de transacciones de varias páginas donde cada fila depende de la fila anterior, donde un saldo corriente debe mantenerse continuo de la página uno a la página doce, y donde la única forma de verificar que la extracción es correcta es la prueba más antigua de la contabilidad: ¿saldo inicial + créditos − débitos = saldo final? Si la herramienta pierde una línea o desplaza una columna una fila, el estado de cuenta ya no cuadra y el resultado es peor que inútil: parece correcto pero falla la aritmética. Esta diferencia — entre extraer campos etiquetados y conservar un libro mayor de transacciones continuo — es donde la mayoría de los OCR fallan con los estados de cuenta bancarios, y donde la extracción semántica con IA adopta un enfoque fundamentalmente distinto.
Conclusiones clave
- La verdadera barrera de extracción en los estados de cuenta bancarios no es la precisión de caracteres — es que una tabla de transacciones de varias páginas es una lista enlazada donde una fila mal colocada rompe la conciliación, sin importar cuán limpiamente se haya leído cada carácter.
- En un estado de cuenta empresarial de 12 páginas, los encabezados de página y los subtotales se repiten en cada página — una tabla de transacciones de 147 filas se convierte en un archivo de Excel de 160 filas donde 13 filas de ruido estructural son indistinguibles de datos reales.
- Cuando la extracción lee la estructura del documento en lugar de las coordenadas de píxeles, el resultado es un libro mayor verificado donde saldo inicial + créditos − débitos es igual al saldo final — comprobado antes de que entre en tu sistema contable.
Por qué los extractos bancarios son estructuralmente más difíciles que las facturas
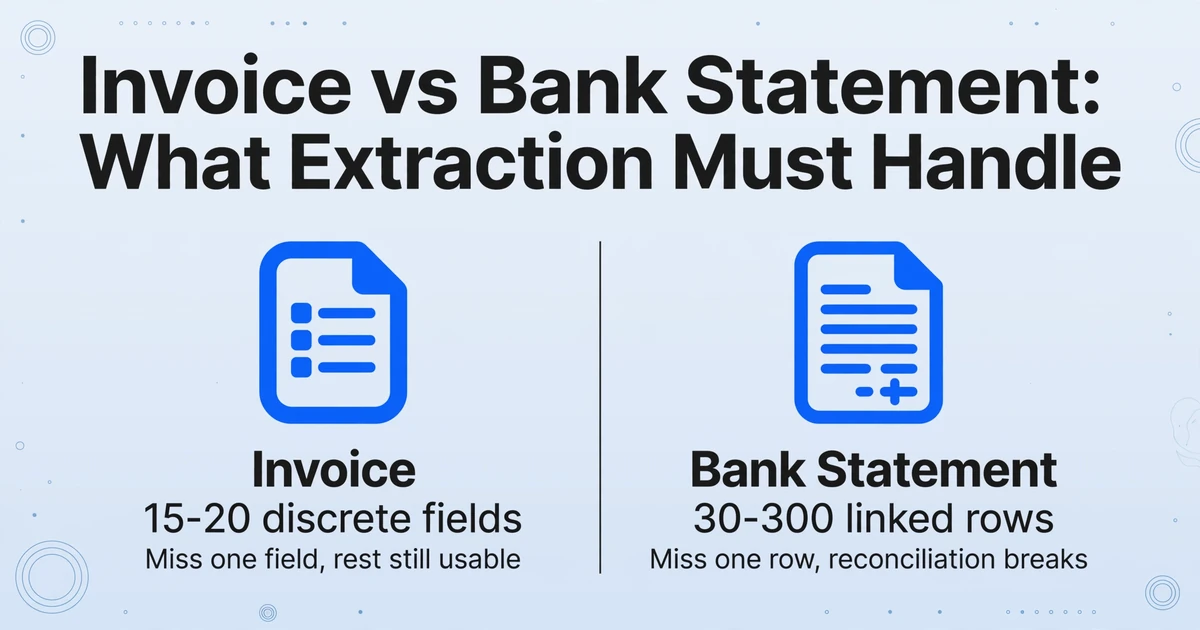
Un extracto bancario no es una colección de campos — es un libro mayor ordenado por tiempo donde la posición de cada fila importa y la aritmética debe cuadrar. Tratarlo como una factura es la causa raíz de la mayoría de los fallos de extracción.
Una factura tiene quizás de 15 a 20 puntos de datos distribuidos en regiones etiquetadas en una sola página: un número de factura aquí, una fecha de vencimiento allá, un total al final. Estos son campos discretos — extraerlos es una operación de buscar y recuperar. Si la herramienta omite un campo, omite una pieza de información. El resto del resultado sigue siendo utilizable.
Un extracto bancario es una estructura de datos completamente diferente. Contiene una tabla de transacciones — normalmente de 30 a 300 filas por mes — donde cada fila tiene una fecha, una descripción, un monto de débito o crédito, y un saldo corriente. La columna de saldo en la fila 47 depende del saldo en la fila 46, que depende de la fila 45, hasta llegar al saldo inicial. Esta es una estructura de datos de lista enlazada representada como una tabla impresa. Si la herramienta omite una fila o desplaza una columna una posición, la cadena aritmética se rompe y toda la conciliación falla — no solo un campo. Un estado de inversión superpone una tabla de tenencias sobre las filas de transacciones, donde Cantidad, Precio y Valor de Mercado deben mantenerse consistentes dentro de cada línea — una estructura que la lectura de nombres de columnas maneja sin una plantilla específica del bróker.
Añade el hecho de que los extractos bancarios suelen abarcar varias páginas (a menudo de 3 a 12 páginas para una cuenta empresarial mensual), y que la tabla de transacciones puede interrumpirse a mitad de página con un subtotal trasladado, y podrás ver por qué extraer un extracto bancario es un problema fundamentalmente diferente. No es "OCR más difícil". Es una clase distinta de extracción: reconstrucción continua del libro mayor en lugar de extracción de campos.
Agravando esto está la gran variedad de formatos de extractos bancarios. Se estima que existen miles de diseños distintos de extractos bancarios a nivel mundial — desde Chase y Bank of America en EE. UU. hasta HSBC y Barclays en el Reino Unido, desde Deutsche Bank en Alemania hasta Caixa en Brasil. Cada banco organiza sus columnas de transacciones de manera diferente, usa terminología distinta para débitos y créditos, y aplica un formato de página diferente. Una herramienta basada en plantillas que funciona para el PDF de un banco necesita una plantilla completamente nueva para el extracto de otro banco. Para una firma contable que maneja clientes en múltiples bancos, eso significa mantener docenas de plantillas solo para cubrir los formatos comunes — y cada vez que un banco actualiza el diseño de su extracto, otra plantilla se rompe.
La mayoría de las personas que se enfrentan a esto por primera vez asumen que la solución es un mejor OCR — mayor precisión a nivel de caracteres. Pero el problema real no es leer los caracteres. El problema es entender qué caracteres forman una fila de transacción, cuáles forman un encabezado, cuáles forman un saldo, y cómo se conectan todos entre páginas. Eso no es reconocimiento óptico. Eso es comprensión de documentos.
Lo que el OCR genérico falla en los estados de cuenta bancarios
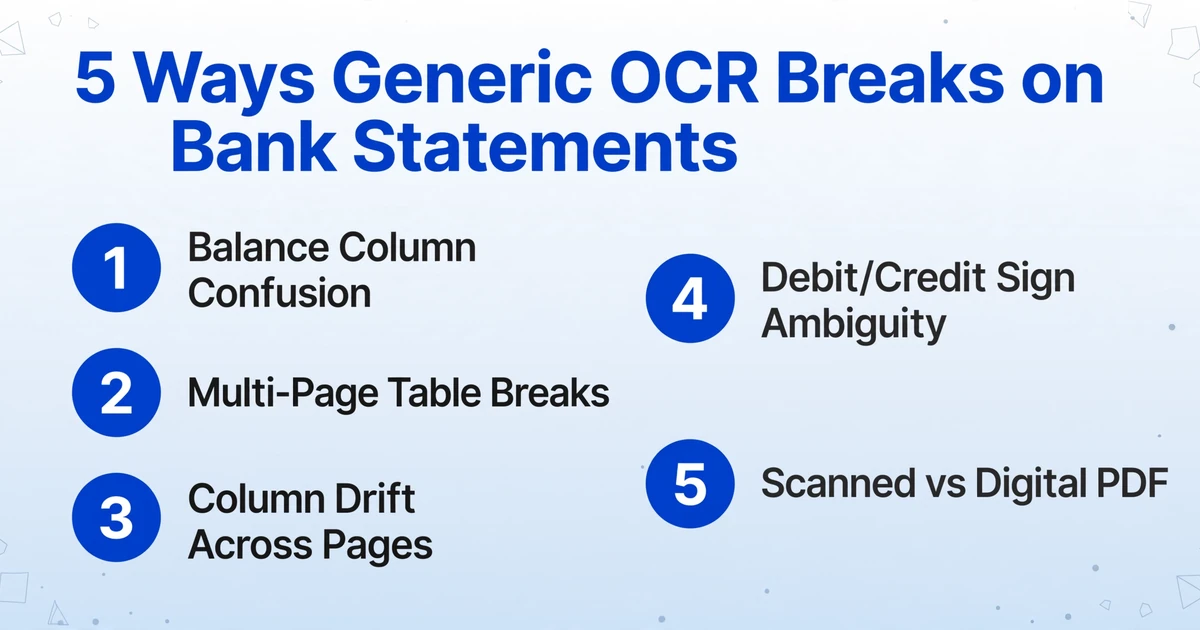
El OCR genérico lee cada carácter de la página por igual: no puede distinguir un monto de transacción de un saldo corriente de un encabezado de página. En un estado de cuenta bancario, eso significa que tu salida de Excel está contaminada con ruido estructural desde la primera fila.
Cuando introduces un PDF de estado de cuenta bancario a través de un OCR estándar o de un convertidor de PDF a Excel como la exportación integrada de Adobe, obtienes caracteres aproximadamente correctos dispuestos en posiciones aproximadamente correctas. Pero las "posiciones aproximadamente correctas" fallan de cinco maneras específicas en los estados de cuenta bancarios:
1. Confusión de la columna de saldo. Una columna de saldo corriente parece otra columna de números para el OCR. El motor de OCR no entiende que el saldo en la fila N es un valor derivado — debería ser el resultado de sumar o restar el monto de la transacción de la fila N al saldo anterior, no un número extraído de forma independiente. Cuando un estado de cuenta tiene un diseño de cuatro columnas (Fecha | Descripción | Débito | Crédito | Saldo), el OCR a menudo fusiona los valores de saldo en las columnas de débito/crédito o viceversa. La hoja de cálculo resultante parece tener todos sus datos, pero los números no cuadran — y el usuario pasa más tiempo corrigiendo la extracción del que habría pasado escribiéndola desde cero, como describió un tenedor de libros en r/Bookkeeping: "¿Tus PDFs de estados de cuenta bancarios se convierten limpiamente a Excel? Los míos no…"
2. Rupturas de tablas multipágina. Un estado de cuenta bancario de 6 páginas es una tabla de transacciones continua dividida en páginas. Los saltos de página introducen encabezados de columna repetidos ("Fecha | Descripción | Débito | Crédito | Saldo"), números de página y, a menudo, una fila de subtotal trasladado. El OCR trata cada página como una tabla independiente. El resultado: filas de encabezado y filas de subtotal se intercalan con filas de transacciones en la salida, rompiendo el orden de las filas y contaminando los datos. Un estado de cuenta que tenía 147 transacciones reales puede terminar con más de 160 filas en Excel — 13 de las cuales son encabezados de página y subtotales que se hacen pasar por datos de transacciones.
3. Desplazamiento de columnas entre páginas. Incluso dentro del mismo banco, las columnas de transacciones pueden cambiar de posición de página a página. La página uno podría tener columnas de Descripción que abarcan el 60% del ancho de la página porque no hay columna de "Saldo" (aparece solo como saldo inicial en la parte superior). La página dos introduce el saldo corriente como quinta columna, comprimiendo el ancho de Descripción al 40%. El OCR que usa coordenadas de columna fijas (OCR zonal) leerá mal cada fila después del cambio de columna — extrayendo números de cuenta donde deberían estar las descripciones, o montos de saldo donde deberían estar los montos de transacción.
4. Ambigüedad del signo de débito/crédito. Algunos bancos usan columnas separadas de Débito y Crédito con números positivos en cada una. Otros usan una sola columna de Monto con números negativos para los débitos. Otros más usan una sola columna de Monto donde los débitos se marcan con un sufijo "Dr" y los créditos con "Cr". El OCR lee estos como cadenas de texto, no como asientos contables. La salida requiere limpieza manual — convertir "500.00Dr" a -500.00, o combinar columnas dobles en una sola columna con signo — antes de que pueda comenzar cualquier conciliación. Según el Benchmark de Eficiencia de Práctica 2025 del AICPA, la firma contable promedio gasta 11.3 horas por cliente al mes en conciliación bancaria, con el 78% de ese tiempo consumido por el emparejamiento de transacciones que sigue patrones predecibles y automatizables.
5. Confusión entre PDF escaneado y digital. Un PDF digital (generado directamente por el sistema del banco) tiene texto seleccionable y legible por máquina. Un PDF escaneado (un estado de cuenta físico fotografiado o escaneado) es una imagen de texto — no diferente de una foto. Muchos tutoriales de PDF a Excel asumen PDFs digitales y fallan silenciosamente con estados de cuenta escaneados. Los motores de OCR diseñados para texto digital limpio producen galimatías en un escaneo de 150 dpi de un estado de cuenta doblado. Sin embargo, los estados de cuenta escaneados siguen siendo comunes: un hilo reciente en r/Accounting con 28 votos a favor discute la realidad continua de clientes que "envían PDFs escaneados para todo."
Cómo la Extracción con IA Lee los Estados de Cuenta Bancarios de Manera Diferente
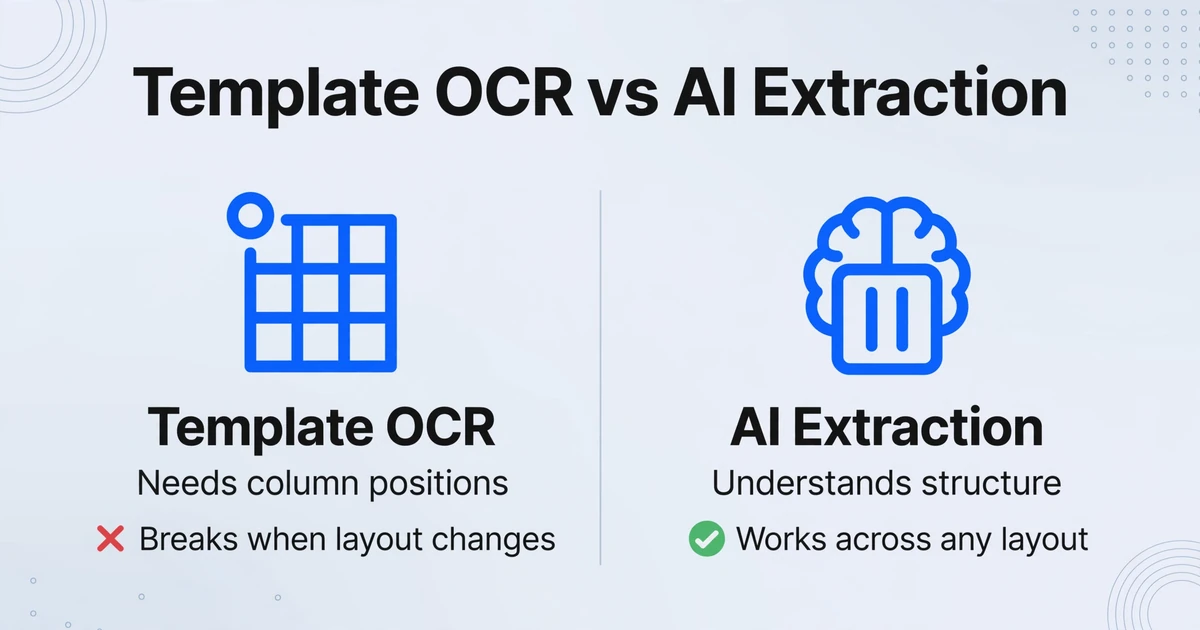
El cambio fundamental del OCR a la extracción con IA es el paso de leer caracteres a entender la estructura del documento — reconocer que una columna de saldo no es solo una columna de números, y que una fila de transacción no es solo una línea de texto.
El OCR tradicional responde una pregunta: "¿Qué caracteres hay en estas coordenadas?" La extracción con IA — específicamente a través de grandes modelos de visión — responde una pregunta diferente: "¿Qué contiene este documento y cómo está organizado?"
Esta es la diferencia entre la extracción basada en posición y la extracción basada en semántica. Una herramienta basada en posición (OCR zonal, analizadores basados en plantillas) necesita que se le diga dónde se encuentra cada campo en la página — "el monto de la transacción siempre está en la cuarta columna, comenzando a 73 mm del borde izquierdo." Cuando Chase cambie el diseño de su estado de cuenta el próximo trimestre o cuando reciba un estado de cuenta de Wells Fargo con una disposición de columnas completamente diferente, esa plantilla se rompe. Usted crea una nueva.
Extracción de Columnas Personalizadas — el mecanismo central de ImageToTable.ai — adopta el enfoque opuesto. En lugar de indicar al sistema dónde se encuentran los datos en la página, le indicas qué datos quieres: nombres de columnas como "Fecha de Transacción", "Descripción", "Monto de Débito", "Monto de Crédito" y "Saldo". La IA lee toda la página, comprende qué partes son encabezados, cuáles son filas de transacciones, cuáles son filas de saldo y cuáles son pies de página — y luego extrae cada fila de transacción en las columnas que definiste, preservando el orden de las filas de principio a fin. No importa qué posición de columna use cada banco; la IA lee el significado semántico, no las coordenadas.
Esto es especialmente importante para los saldos corrientes. Cuando defines una columna "Saldo", la IA reconoce que esta columna es un campo derivado — extrae el valor tal cual, pero la verificación real proviene de una columna calculada (ver más abajo) que valida la aritmética. Si además se le puede indicar a la IA que ignore el saldo impreso y lo recalcule a partir de los montos de las transacciones, obtienes una validación integrada: cualquier discrepancia entre el saldo calculado y el saldo impreso del estado de cuenta señala una fila que necesita revisión. Un cronograma de amortización de préstamo es el mismo tipo de cadena — el saldo final de cada pago debe convertirse en el saldo inicial del siguiente pago — por lo que una sola fila mal leída altera el saldo final.
El mecanismo que hace posible esto es lo mismo que hace que un modelo de visión-lenguaje sea fundamentalmente diferente de un motor OCR: procesa la página como una escena visual completa, no como una cuadrícula de cuadros delimitadores de caracteres. Ve que "la tabla tiene 5 columnas, la quinta es un saldo corriente, los datos continúan a través de los saltos de página, y la sección central tiene una fila de subtotal que no es una transacción". El OCR tradicional no ve nada de esto — ve píxeles organizados en una cuadrícula.
Paso a Paso: Extracción de Datos de Estados de Cuenta Bancarios a Excel
El camino desde el estado de cuenta bancario en PDF hasta una hoja de cálculo limpia y lista para conciliación consta de cuatro pasos. Sin plantillas, sin configuración por banco, sin datos de entrenamiento de posición de columnas.
Sube tu extracto bancario
Arrastra un PDF, JPG o PNG: cualquier banco, cualquier número de páginas, digital o escaneado. Sin preprocesamiento de formato.
Define tus columnas
Escribe los nombres de columna que quieras: Fecha de Transacción, Descripción, Monto de Débito, Monto de Crédito, Saldo, Referencia/N.º de Cheque, Tipo de Transacción. Estos se convierten en los encabezados de tus columnas de Excel.
La IA extrae cada fila de transacciones
La IA lee todo el documento, identifica la tabla de transacciones en todas las páginas, extrae cada fila en tus columnas definidas y conserva el orden de las filas. Los encabezados, subtotales y pies de página se filtran automáticamente.
Exporta y concilia
Descarga como Excel (XLSX) o CSV. Los datos están estructurados, limpios y listos para importar en QuickBooks, Xero, Sage o tu hoja de conciliación.
El flujo de cuatro pasos anterior — subir, definir columnas, extraer, exportar — es exactamente lo que hace nuestro conversor de extractos bancarios a Excel en una sola pasada, sin plantillas y sin configuración por banco. Pruébalo gratis con tu propio extracto: sube un PDF, nombra tus columnas y las filas extraídas vuelven en segundos, listas para la verificación de conciliación.
Los archivos se procesan de forma segura y no se almacenan.
Lo que hace diferente a este flujo de trabajo de un analizador basado en plantillas es que nunca le dices al sistema dónde están los datos — solo le dices qué quieres. Esto es lo que lo hace sin plantilla: la IA entiende la estructura del documento de forma independiente a su diseño. Cuando recibes un estado de cuenta de un banco nuevo — o cuando tu banco actual rediseña su formato — no hay nada que reconfigurar. Los mismos nombres de columnas encuentran los mismos datos sin importar dónde aparezcan en la página.
Gestión de estados de cuenta de varias páginas y procesamiento por lotes
Una conciliación de fin de mes puede implicar 12 PDFs de 3 bancos diferentes. El procesamiento por lotes los maneja todos de una vez, fusionando cada transacción en una sola hoja de cálculo de salida con el orden de las filas preservado por estado de cuenta.
La extracción de estados de cuenta bancarios rara vez es un problema de un archivo a la vez. Un contador cerrando los libros del primer trimestre puede enfrentar 3 meses × 3 cuentas bancarias = 9 PDFs. Una firma contable que maneja 50 clientes de teneduría de libros puede procesar más de 200 estados de cuenta al mes. El enfoque manual — abrir cada PDF, leer cada fila, escribir en Excel — escala linealmente con la cantidad de transacciones, y los datos del AICPA confirman el resultado: 11.3 horas por cliente por mes, 3.5 empleados equivalentes a tiempo completo para una firma con 50 clientes, solo en conciliación bancaria.
Procesamiento por lotes prioritario significa que la herramienta está diseñada para aceptar múltiples archivos a la vez y fusionarlos en una sola tabla de salida. Puedes subir Chase enero, Chase febrero, Chase marzo, Wells Fargo enero, Wells Fargo febrero y Wells Fargo marzo — seis archivos en un solo lote — y recibir una sola hoja de cálculo de Excel con todas las transacciones de los seis estados de cuenta, cada una etiquetada con su nombre de archivo de origen para trazabilidad. El orden de las filas dentro de cada estado de cuenta se preserva, y la salida puede opcionalmente añadir una columna de archivo fuente para que siempre sepas qué transacción vino de qué estado de cuenta.
Para estados de cuenta de varias páginas, la IA entiende que las páginas 1 a 6 de un solo PDF representan una tabla de transacciones continua — no seis tablas separadas. El saldo corriente que aparece en la página 3, fila 28, se reconoce como la continuación de la secuencia de transacciones de la página 2. Encabezados, números de página, subtotales arrastrados y texto legal bancario que se repite en cada página se filtran antes de llegar a tu salida de Excel.
Aquí es donde la combinación de lote + varias páginas crea un beneficio compuesto frente a la entrada manual. Un estado de cuenta comercial de 12 páginas con 200 transacciones que tomaría aproximadamente una hora de tipeo (a 3 minutos por página de entrada manual) se procesa en 5–10 segundos por página. El Informe de Tecnología Contable 2025 de Sage encontró que las firmas que automatizaron la conciliación bancaria redujeron el tiempo de procesamiento en un 75% mientras mejoraban la precisión de coincidencia de primera pasada del 94.2% al 99.6%. La idea clave no es solo el ahorro de tiempo — es que pasar de la entrada humana a la extracción con IA elimina la categoría más común de error: los errores de transposición donde una persona lee mal "2,847.31" como "2,487.31" o escribe un monto en la fila equivocada.
Para profesionales que necesitan datos directamente en Google Sheets en lugar de un archivo de Excel descargado, el complemento de Google Sheets proporciona una interfaz de panel lateral que sube estados de cuenta y añade las filas de transacciones extraídas directamente a la hoja activa — sin descarga de archivos, sin paso de importación. Para una visión más completa de cómo esto se compara con la entrada manual en una variedad de volúmenes de estados de cuenta, consulta nuestra comparación de entrada manual vs. IA para estados de cuenta bancarios.
Haciendo que los Datos Extraídos Estén Listos para la Conciliación
Llevar las transacciones a Excel es el primer paso. Hacer que se concilien automáticamente — verificar que el saldo inicial + créditos − débitos sea igual al saldo final — es donde las columnas calculadas convierten los datos extraídos en datos verificados.
Incluso con filas de transacciones perfectamente extraídas, la conciliación requiere una verificación aritmética. El extracto bancario declara un saldo inicial y un saldo final; la suma de todas las transacciones intermedias debe conectar ambos. Un flujo de trabajo manual maneja esto haciendo los cálculos en una columna separada de Excel después de la importación. Un flujo de trabajo con extracción por IA puede manejarlo durante la extracción, usando columnas calculadas.
Columnas calculadas le permiten definir cálculos que se ejecutan mientras la IA procesa cada extracto. Para la conciliación de extractos bancarios, dos columnas calculadas son particularmente útiles:
Verificación del saldo corriente: Puede definir una columna calculada que calcule el saldo esperado después de cada transacción (saldo inicial + suma de todos los débitos y créditos hasta esa fila) y lo compare con el saldo impreso en el extracto. Cualquier discrepancia genera una marca — la fila donde la aritmética falla es la fila que necesita revisión humana.
Compensación de débitos/créditos: Para extractos con columnas separadas de débitos y créditos, una columna calculada puede calcular el monto neto de cada fila (Crédito − Débito) y el neto acumulado en todas las filas. El neto acumulado final, sumado al saldo inicial, debe ser igual al saldo final. Si no lo es, el monto de la discrepancia le indica exactamente qué tan lejos está la extracción — y generalmente apunta a una o dos filas específicas que fueron mal leídas.
Estas verificaciones calculadas no son opcionales para quien hace conciliación — son la diferencia entre "los datos parecen correctos" y "los datos están comprobados como correctos". La Association of Certified Fraud Examiners informa que aproximadamente el 22% de los casos de fraude en estados financieros se descubren mediante la conciliación bancaria, lo que subraya por qué el paso de validación aritmética no puede omitirse.
Después de la extracción y validación, el resultado estructurado en Excel puede fluir hacia su software de contabilidad — QuickBooks Online, Xero, Sage, NetSuite, o cualquier plataforma que acepte importaciones CSV/XLSX — con los datos de transacciones ya limpios, estandarizados y verificados. Si está evaluando qué herramienta usar en todo su flujo de trabajo de documentos financieros, nuestra comparación de herramientas de extracción de extractos bancarios mapea el panorama por precisión, precios e integración contable.
Extractos Bancarios de Diferentes Bancos y Países
Un sistema de extracción independiente del formato trata un extracto de Chase, un extracto de Deutsche Bank y un extracto de Caixa como el mismo problema: cada uno es una tabla de transacciones con fechas, descripciones y montos. Las diferencias en el diseño visual no cambian la lógica de extracción.
Uno de los costos silenciosos de la extracción basada en plantillas es el mantenimiento por banco. Si tu herramienta de análisis requiere capacitación o la creación de plantillas para cada formato bancario, y tu firma procesa extractos de 15 bancos diferentes entre tus clientes, mantienes 15 configuraciones de análisis. Cuando cualquiera de esos bancos actualiza el diseño de su extracto — un cambio de fuente, una reorganización de columnas, una nueva ubicación del logotipo — una de tus plantillas deja de funcionar. Lo descubres cuando intentas procesar el extracto de un cliente y el resultado sale distorsionado, generalmente a fin de mes, cuando el tiempo es más escaso.
La extracción con IA que es independiente del formato evita esto por completo. Ya sea que el banco use un diseño de dos columnas (Fecha + Descripción seguido de Débito + Crédito), un diseño de cinco columnas (Fecha + Descripción + Débito + Crédito + Saldo), o una variante regional con terminología local — "Retraits" en lugar de "Débitos", "Versements" en lugar de "Créditos" en extractos en francés — la IA identifica la tabla de transacciones por su patrón estructural: una secuencia repetida de fecha, descripción de texto y montos numéricos. La disposición específica dentro de ese patrón no importa.
Esta independencia del formato también maneja extractos internacionales donde el estándar de datos subyacente difiere. Los bancos europeos emiten cada vez más extractos en camt.053 — el formato XML ISO 20022 para extractos bancarios a clientes — que es un formato estructurado y legible por máquina con metadatos explícitos a nivel de transacción. Pero muchos bancos aún emiten extractos en PDF junto con o en lugar de archivos camt.053, y algunos países están a años de adoptar ISO 20022. La realidad para la mayoría de los equipos de contabilidad es que reciben una mezcla: algunos clientes proporcionan exportaciones CSV, algunos proporcionan PDF, y unos pocos envían extractos XML que no pueden analizar. Una sola herramienta que maneje los tres formatos elimina la necesidad de una ruta de procesamiento separada por formato.
Incluso dentro de un solo país, la diversidad de diseños es considerable. Un extracto de cuenta corriente empresarial de Wells Fargo tiene una estructura de tabla diferente a la de un extracto de cuenta corriente empresarial de Chase, que a su vez difiere de un extracto de una cooperativa de crédito local. El enfoque independiente del formato significa que el contable define las columnas una sola vez — "Fecha de Transacción, Descripción, Monto, Saldo" — y usa la misma definición de columnas en los extractos de todos los clientes, sin importar qué banco los emitió. Para una mirada más profunda sobre cómo esto se aplica específicamente a la conciliación por lotes de un año completo, consulta nuestra guía sobre procesamiento por lotes de 12 meses de extractos bancarios en una sola hoja de cálculo.
Preguntas frecuentes
¿Funciona con estados de cuenta de varias páginas?
Sí. La IA lee el estado de cuenta como una tabla de transacciones continua, sin importar la cantidad de páginas. Un estado de 12 páginas con 250 transacciones se procesa como una sola unidad: los encabezados de página, las etiquetas de columna repetidas, los subtotales acumulados y el texto de pie de página se identifican y filtran automáticamente para que no contaminen su archivo de Excel. El orden de las filas se conserva entre páginas exactamente como aparece en el estado de cuenta original.
¿Puede extraer datos de estados de cuenta escaneados o fotografiados?
Sí. El modelo de lenguaje visual lee texto de imágenes, no solo de PDF digitales. Un estado de cuenta en papel escaneado —ya sea con un escáner de cama plana, una foto de teléfono o el escaneo bancario de un registro antiguo— se procesa igual que un PDF nativo. La calidad de la imagen importa (un escaneo de 150 ppp con inclinación visible dará menor precisión que uno limpio de 300 ppp), pero no se requiere un PDF generado digitalmente con texto seleccionable.
¿Cómo maneja la columna de saldo corriente?
La IA extrae el saldo corriente tal como aparece en el estado de cuenta. Sin embargo, como los saldos impresos pueden contener errores o la extracción puede leer mal un dígito, la práctica recomendada es definir una Columna Calculada que recalcule el saldo corriente a partir de los montos de débito y crédito extraídos. Si el saldo calculado coincide con el impreso, tiene una verificación cruzada. Si divergen, sabe exactamente qué fila revisar. Esto convierte el saldo corriente de un campo extraído pasivo a un mecanismo de validación activo.
¿Funciona con estados de cuenta de diferentes bancos con distintos diseños?
Sí — esta es la ventaja principal de la extracción independiente del formato. Un estado de Chase, Wells Fargo, Barclays o una cooperativa de crédito local comparten la misma estructura fundamental: una tabla de transacciones fechadas con descripciones de texto y montos numéricos. La IA identifica esa estructura sin importar el orden de las columnas, la fuente, el espaciado o el diseño de página. Usted usa los mismos nombres de columna ("Fecha de transacción", "Descripción", "Monto") en todos los bancos. No es necesario crear ni mantener plantillas por banco.
¿Cómo se manejan los débitos y créditos cuando los bancos los formatean de manera diferente?
Algunos bancos usan columnas separadas de Débito y Crédito con valores positivos en ambas. Otros usan una sola columna de Monto con números negativos para los débitos. Otros añaden sufijos "Dr" o "Cr" a los montos. La IA puede extraer cualquier estructura de columnas que exista en el estado de cuenta, y opcionalmente puedes definir una columna calculada que normalice los valores en una sola columna de monto con signo (negativo para débitos, positivo para créditos), produciendo una salida uniforme sin importar cómo cada banco formatee su estado de cuenta.
¿Cuál es la precisión en la extracción de transacciones de estados de cuenta bancarios?
Para PDFs de estados de cuenta bancarios impresos (digitales) con tipografía clara, la precisión a nivel de campo alcanza hasta el 99%. Para estados de cuenta escaneados o fotografiados, la precisión depende de la calidad de la imagen: un escaneo limpio de 300 dpi se acerca a resultados similares, mientras que una foto de baja resolución tomada con un teléfono de un estado de cuenta arrugado será menor. La salvaguarda clave es la verificación de conciliación: como cada estado de cuenta bancario tiene un saldo de cierre verificable contra el cual se pueden validar las transacciones extraídas, cualquier error de extracción lo suficientemente grande como para afectar la conciliación será detectado por el paso de verificación de saldo antes de que los datos entren en tu sistema contable.
El Resultado Final
La extracción de estados de cuenta bancarios se sitúa en la intersección de dos problemas que la mayoría de las herramientas de datos resuelven por separado: la lectura precisa de caracteres y la comprensión estructural del documento. El OCR solo te da los caracteres pero no la estructura: no puede distinguir una fila de transacción de una fila de encabezado, un saldo corriente de un monto de transacción, o la tabla de la página uno de la continuación de la misma tabla en la página dos. El análisis basado en plantillas añade estructura pero a costa de configuración por banco y fragilidad cuando los diseños cambian.
La extracción con IA a través de modelos de visión-lenguaje colapsa estos en un solo paso: la IA lee el documento como un todo, entiende su estructura y extrae lo que pediste, preservando el orden de las filas, filtrando el ruido estructural y permitiendo la verificación aritmética antes de que los datos lleguen a tu sistema contable. La salida no es "aproximadamente los datos correctos en aproximadamente el orden correcto". Es un libro de transacciones que cuadra con el saldo de cierre del estado de cuenta, el único estándar que importa para la conciliación. Pruébalo con tu propio estado de cuenta bancario.
Extrae tu Estado de Cuenta Bancario Ahora →
Gratis para empezar — no se requiere tarjeta de crédito